文档(金鹏): 2026-08-20 章节 26 篇文章摘要归档
- 26 篇微信公众号文章原文+摘要归档至 知识/微信公众平台/{公众号}/
- 9 个主题分组:Skill工程/Agent运行时/数据基础设施/交互工具/产品服务/大模型前沿/产业开源/制造业AI/军事社会
- 生成 9 组配图(2560x1440 大图 + 160x90 thumb)至 知识/金鹏/20260820/
- 知识/金鹏.md 2026-08-20 章节改写为结构化索引(主题标签+配图+金句+分层子条目)
- 1 个小红书视频链接以视频笔记条目保留(内容无法文本化)

Co-Authored-By: Claude <noreply@anthropic.com>
This commit is contained in:

 Claude
@@ -0,0 +1,188 @@
|
||||
# 过去一周,模型在下饺子,价格在下刀子,人才在跑路,AI厂商卷入生死时速!
|
||||
|
||||
> **来源**:微信公众平台(祖哥)
|
||||
> **作者**:祖哥(e-works 祖哥综合报道)
|
||||
> **发布日期**:2026-08-20(原文未标注明确日期,文中覆盖 8 月 8 日至 14 日动态,按下载日占位)
|
||||
> **原文链接**:https://mp.weixin.qq.com/s/tRwcm21YyiiMU-HxgysinQ
|
||||
|
||||
---
|
||||
|
||||
|
||||
|
||||
快看看过去这一周都发生了什么?从8月8日到14日,全球AI圈像集体被按了快进键:阿里、智谱、MiniMax、谷歌、OpenAI、DeepSeek、xAI、Meta、LTX——你能叫得出名字的厂商,几乎个个都在这周放了大招。最夸张的是8月14日,一天之内五家厂商轮番上阵,你方唱罢我登场。这一周,没有一家敢歇脚,谁也不愿意当那个掉队的人。这周AI下料真的太猛,AI厂商已进入生死时速!
|
||||
|
||||
内容提要/OVERVIEW
|
||||
|
||||
**- 文章信息 -**
|
||||
|
||||
本文由e-works祖哥综合报道。
|
||||
|
||||
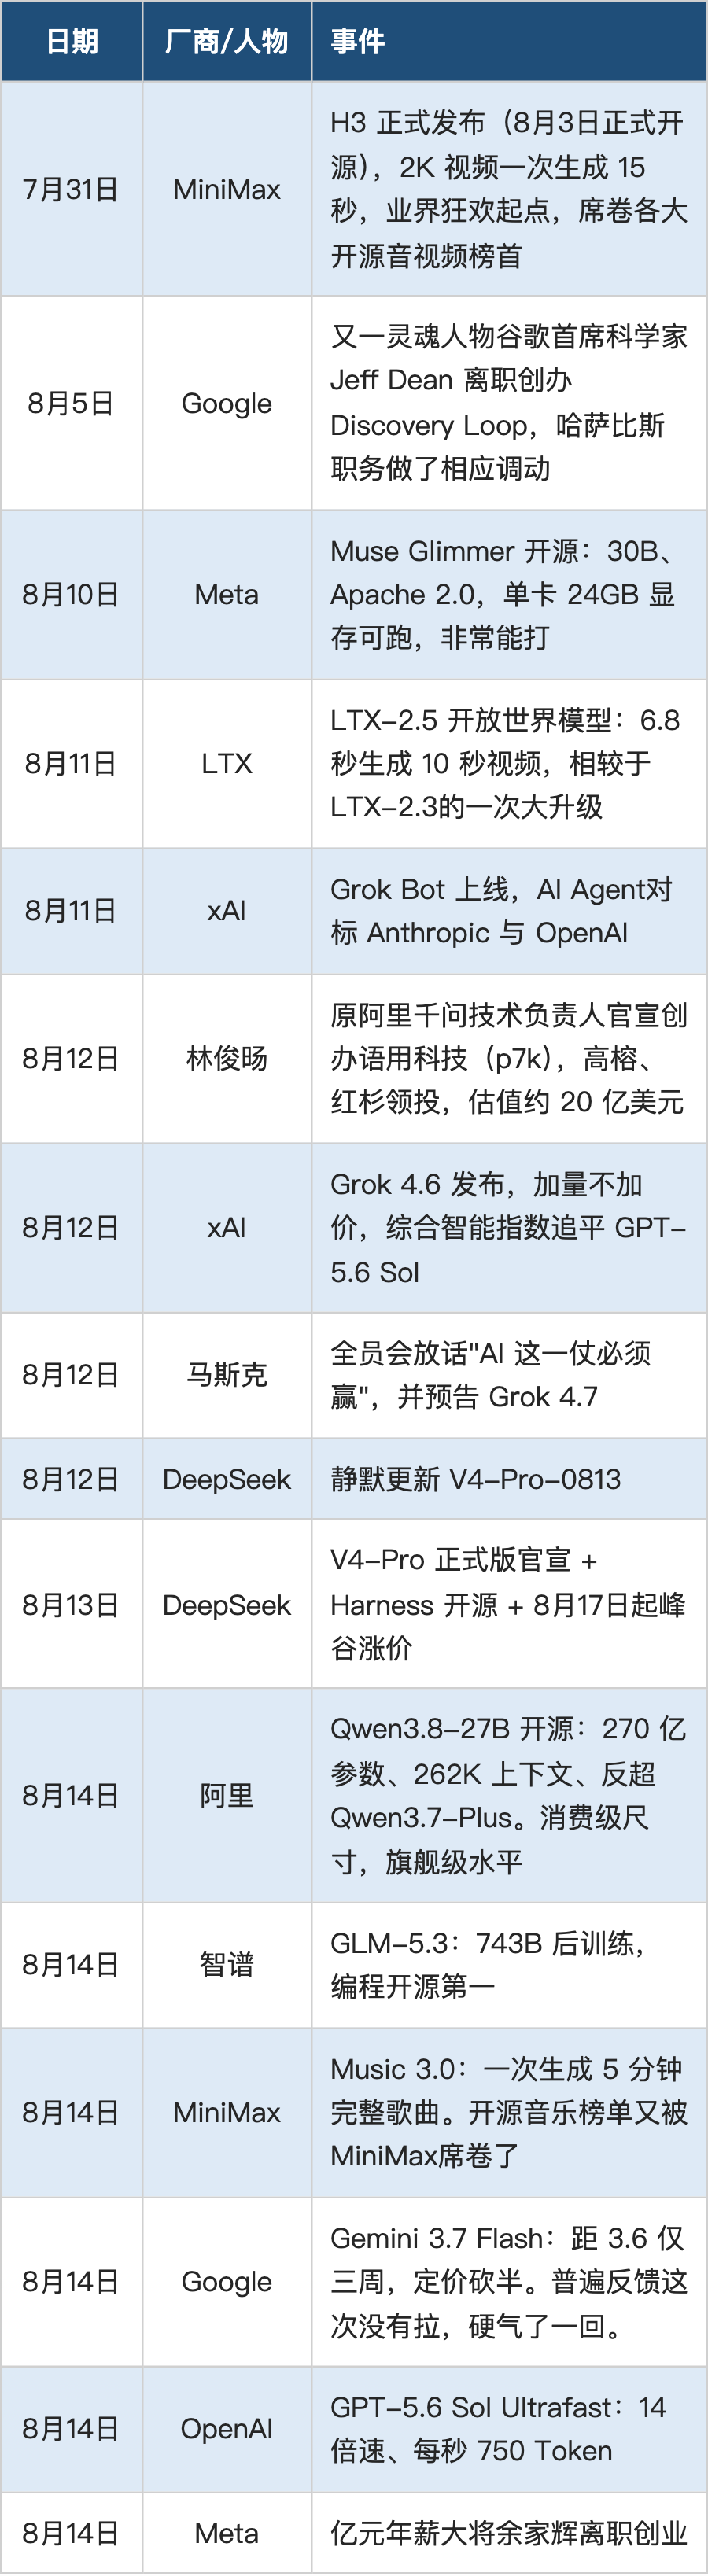
先上张全貌图表,看看这一周的发布节奏有多密,我把8月8日之前的两个重要的前序事件(MiniMax-H3以及Jeff Dean)也加入了列表:
|
||||
|
||||
|
||||
|
||||
下文我们用倒序的手法,更加详细的给大家唠唠一些细节:
|
||||
|
||||
**01**
|
||||
|
||||
**8月14日**
|
||||
|
||||
**一天五连发,火药味拉满**
|
||||
|
||||
如果把这周拍成一部电影,8月14日就是全片高潮——一天之内,五家厂商先后登台,放个响炮就走,绝不多耽误一秒。
|
||||
|
||||
🔷 先是阿里千问,当晚正式开源Qwen3.8-27B。270亿参数,原生多模态稠密模型,是开发者社区呼声最高的"黄金尺寸";原生支持262K超长上下文,再用YaRN技术轻轻一推,直接拉到100万Token。最狠的是,它明明比自家大哥Qwen3.7-Plus小一大圈,编程和办公场景的表现却反超了大哥,还被不少开发者拿来和Claude 4.6正面硬刚,社区直呼"小钢炮"。
|
||||
|
||||

|
||||
|
||||
🔷 紧接着,智谱甩出GLM-5.3,一句话概括它的定位:"为写代码而生,为网络防御而备。"这次智谱没换基座,还是在743B参数的大模型上做后训练,但打法换了:把长程任务环境扩了数十倍、环境类型更丰富、后训练时间拉到超长。效果立竿见影——官方称编程能力较上一代提升50%,在Terminal Bench 3.0、Agents' Last Exam这些公开榜单上拿下"开源第一",网络安全更是被官方视为"开源模型的新标准"。不过它留了个小心思:完整权重要等两周后才放出来,吊足了开源社区的胃口。
|
||||
|
||||

|
||||
|
||||
🔷 同一天,MiniMax发布了Music 3.0——一个开放权重、生产级、全能的音乐生成模型。给它一个创意和可选歌词,它一次性给你生成最长5分钟、32kHz立体声的完整歌曲,词曲配唱一条龙,堪称"AI界的音乐制作人"。继 AI 视频自由(MiniMax H3)后,AI 音乐也自由了。Music 3.0目前在开源社区极度受欢迎。
|
||||
|
||||
Minimax Music 3 chill R&B 样例演示
|
||||
|
||||

|
||||
|
||||
🔷 谷歌这天也没闲着,火速上线Gemini 3.7 Flash。这个版本有多赶?距离上一代3.6 Flash发布才过去三周,短短两三个月内,Flash系列已经迭代了三次。这次依然没有Pro压阵,只有Flash单刀赴会,主打编程和智能体场景,官方称它是"迄今最智能的主力工作模型",还把价格直接砍半——2026年底前,输入每百万Token只要0.75美元。业内解读很直白:谷歌这是要靠密集发版对冲DeepMind人事地震的冲击,用产品说话,比什么都实在。业界普遍风评,对于3.7 Flash印象不错,"谷大爷"终于从前面的阴影中稍微走了出来!
|
||||
|
||||

|
||||
|
||||

|
||||
|
||||
🔷 压轴的OpenAI则祭出"速度杀招"——为旗舰模型GPT-5.6 Sol推出Ultrafast超高速模式(预览版),推理速度是标准版的14倍,最高每秒输出750个Token,由Cerebras硬件提供支持。GPT-5.6 Sol本来就是OpenAI在"法律文书、金融模型、工程报告"这些场景上表现最好的模型,现在配上14倍速,在衡量经济价值知识工作的GDP-Val基准上实现了5.6倍的端到端提速,质量一点没掉。官方表示先在API对选定客户开放,等算力跟上再放量——典型的高端产品"饥饿营销"。
|
||||
|
||||

|
||||
|
||||
Ultrafast和Standard代码生成
|
||||
|
||||
与实时 3D/仿真模拟对比
|
||||
|
||||
**02**
|
||||
|
||||
**8月13日:DeepSeek深夜悄悄交卷**
|
||||
|
||||
**还捎带涨了个价**
|
||||
|
||||
如果说8月14日是明火执仗,那8月13日的DeepSeek就是深夜偷家——没有发布会、没有海报,8月12日晚上悄悄把官网API文档里的模型版本号更新成V4-Pro-0813,凌晨在群里轻描淡写发了句公告。大哥,你依然还是太低调了。但是社区的狂热粉丝不允许它低调。
|
||||
|
||||
正式版主打的就一件事:补齐Agent(智能体)能力。官方给的几组数据非常夸张:软件工程基准DeepSWE从12.8直接飙到62.7,涨了近5倍;网络安全Cybergym从52.7涨到83.3;Terminal Bench 2.1更是从72.1冲到87.9——而海外顶级模型Claude Fable 5是88.0,就差0.1分,多项基准直指Fable 5。实测下来,1M Token上下文、最大384K输出,明显是奔着多文件、长任务的老手编程场景去的。
|
||||
|
||||

|
||||
|
||||

|
||||
|
||||
不过,大家更关心的可能是钱的事。DeepSeek这次不只是发模型,还宣布了一波涨价:8月17日零时起实行"峰谷分时定价",高峰时段V4-Pro每百万Token输出从6元涨到27元,涨幅350%;V4-Flash高峰输出也从2元涨到9元;闲时价格则打对折。翻译一下:以后想用便宜的DeepSeek,得学会"错峰用电"。
|
||||
|
||||

|
||||
|
||||
涨价消息一出,评论区立刻玩起了"滑动变阻器"的梗——网友把物理课上的滑动变阻器谐音成"滑动变祖器",调侃梁文锋的"调参强度"就像拨动变阻器,刻度从"小难梁"一路滑到"梁祖"。这个梗火到什么程度?有人干脆把它做成了DeepSeek Harness的皮肤。没错,DeepSeek这次还顺带开源了自家Agent框架Harness v0.1(内部代号"黑鲸"团队出品),用MIT协议面向全球开发者开放——模型涨价、框架开源,一紧一松,路子玩得明明白白。
|
||||
|
||||
来源X社区网友@chen du
|
||||
|
||||
说到梁文锋,就不得不提"买芯片"这档子事。此前一场闭门会议的实录流出:梁文锋直言英伟达CUDA的护城河正在瓦解,华为超节点可以"完全平替",在买不到英伟达卡的情况下,DeepSeek干脆"壮士断腕",把宝押在了华为昇腾950等国产芯片上。模型涨价要养算力,算力底座又赌在国产芯片上——DeepSeek这盘棋,下得比谁都大。
|
||||
|
||||

|
||||
|
||||
不过实话实说,这次V4-Pro正式版带来的轰动,确实不如7月31日的V4-Flash 0731那一波。原因也简单:Flash版本刚炸过场,Pro版是"虚晃一枪后正式交卷",大家阈值被抬高了。
|
||||
|
||||
**03**
|
||||
|
||||
**8月12日**
|
||||
|
||||
**马斯克的"AI战役"宣言**
|
||||
|
||||
8月12日这天,主角只有一个:埃隆·马斯克。他的AI部门一口气放了三件套。
|
||||
|
||||
🔷 第一件,Grok 4.6正式发布。官方原话:"它交付了前沿智能,且在同一价格下比Grok 4.5有显著提升。"翻译过来就是:加量不加价——输入每百万Token仍是2美元、输出6美元,价格直接挂在竞品的一半。这代模型背后有个秘密武器:SpaceX此前以600亿美元全股票收购了AI编程工具Cursor,Grok 4.6深度吸收了Cursor的海量真实编程工作流数据(还是匿名化的),这让它在写代码这件事上突飞猛进,在综合9项基准的Artificial Analysis智能指数上追平GPT-5.6 Sol(同为61分),部分单项甚至反超,稳坐第一梯队。
|
||||
|
||||

|
||||
|
||||

|
||||
|
||||
用Grok 4.6进行代理构建CAD的工作
|
||||
|
||||
用Grok 4.6通过Three.js
|
||||
|
||||
做的一个喷气发动机爆炸图视角
|
||||
|
||||
各大厂商开始把"工业设计、工业应用"当成新的吹嘘资本,因为能搞定发动机、能画CAD,才代表模型真正理解了物理世界。
|
||||
|
||||
🔷 第二件,Grok Bot率先上线(8月11日放出,比Grok 4.6还早一天)。官方介绍很带感:"Bot就是帮你干实事的AI队友。它们登录你的工具,像你一样使用它们,然后把干完的活交给你。"早期用户评价:体验不像给客服下指令,更像把活儿交给一个能力出众的同事。摆明了要对标Anthropic和OpenAI的智能体产品。
|
||||
|
||||

|
||||
|
||||
🔷 第三件,马斯克在SpaceX全员大会上的"战前动员"(一段约30分钟的视频被公开)。他的核心台词只有一句:AI这一仗,必须赢。马老师还放了大预言:AI业务收入最快今年9月就能超过SpaceX其他所有业务,5年后AI将占公司估值的99%,明年底建成10GW算力。翻译一下就是:以后SpaceX不是造火箭的公司,是披着火箭壳子的AI公司。
|
||||
|
||||

|
||||
|
||||
还没完,马斯克顺手又发了条推,预告Grok 4.7"马上就要来"——4.6的余温还没散,4.7的预告就来了,这速度,卷得让人头皮发麻。
|
||||
|
||||

|
||||
|
||||
有人说——马斯克很神奇的地方在于,短期经常失败,但长期来看几乎都是成功的,比如最近的 xAI,本来以为不行了,结果 Grok4.6 几个版本发出来,再配合 SpaceX 数据中心土建狂魔,一下子又变成头部玩家了。
|
||||
|
||||
**04**
|
||||
|
||||
**8月11日**
|
||||
|
||||
**开源界扔下两颗炸弹**
|
||||
|
||||
这周最"分裂"的厂商,非Meta莫属。
|
||||
|
||||
五天前才刚以闭源姿态发布旗舰Muse Spark 1.2,一个字没提开源;五天后(美国时间8月10日,北京时间8月11日),Meta超级智能实验室却冷不丁甩出Muse Glimmer——继Llama 4之后首次开源的重磅炸弹:300亿参数,史上最宽松的Apache 2.0协议(这是Meta第一次用Apache 2.0发模型),在Artificial Analysis智能指数上拿到35分,还专门为"全天候常驻运行的本地智能体"做了深度优化——4bit量化之后,一张24GB或32GB显存的消费级显卡就能本地跑,普通Mac和PC都能玩。
|
||||
|
||||

|
||||
|
||||
有意思的是,扎克伯格同一天发了6500字长文谈开源生态,Meta还放话说Muse Spark 1.2的权重"很快也会开源"。五天前闭源、五天后开源,一收一放之间,把小扎"打不过就加入"的心态暴露得明明白白。有媒体点评:Meta回开源赛道,是带着"悔过书"回来的。
|
||||
|
||||
同一天,开源视频领域也炸了:由Lightricks分拆出来的LTX公司发布了LTX-2.5。这可不是普通的文生视频模型,官方管它叫"开放世界模型"——视频、音频、世界模拟一把抓。效率更是离谱:在英伟达旗舰双卡GB200上,单张图生成10秒720p视频只要6.8秒,比视频播放本身还快,生成成本只有同类模型的八分之一。而且它原生集成进了ComfyUI,面向中小企业直接免费——开源视频模型的"价格屠夫",出现了。
|
||||
|
||||

|
||||
|
||||
**05**
|
||||
|
||||
**在此之前**
|
||||
|
||||
**MiniMax-H3的狂欢余波**
|
||||
|
||||
严格来说,MiniMax-H3是7月31日发布、8月3日开源的,赶在这周之前,但它的热度一直烧到了这周。这款通用全模态生成模型当时引起业界狂欢:统一理解文本、图像、视频、音频,最高2K分辨率、一次生成15秒、自带原生立体声音效,24fps的流畅画面,直接对标字节的Seedance 2.5。价格更是"白菜":768p每秒只要0.23元,2K也只要0.4元。社区实测,一张12GB显存的RTX 3060就能跑,开源24小时内就完成了对华为昇腾、AMD、Intel的适配——开源视频模型的性价比天花板,被它捅了个大窟窿。这也是为什么网友说,这周的LTX-2.5,是"狂欢的延续"。
|
||||
|
||||

|
||||
|
||||
**06**
|
||||
|
||||
**人比模型更抢手**
|
||||
|
||||
**AI人才大逃亡**
|
||||
|
||||
模型在下饺子,人在跑路。这周的AI人才动向,比发布会还精彩。
|
||||
|
||||
🔷 8月14日,Meta超级智能实验室核心研究员余家辉宣布离职创业。他是被小扎用天价薪酬挖来的——此前《连线》杂志报道,Meta为顶级AI人才开出的薪酬包最高四年3亿美元,第一年就可能超过1亿美元(约合7亿元人民币)。可就是这样"亿元年薪"也留不住人:他加入Meta才一年出头,带队做出Muse Spark,离职前刚更新到1.2版本,转头就宣布要"探索对人类未来至关重要的事"。在他之前,华人科学家田渊栋、图灵奖得主杨立昆已经先后出走创业,据媒体统计,Meta出走的AI骨干已近千人。
|
||||
|
||||

|
||||
|
||||
🔷 8月12日凌晨,原阿里千问技术负责人林俊旸在X平台发文官宣:在上海创办AI公司Pragmatik Labs(语用科技,简称p7k),方向是"横跨数字世界和物理世界的下一代Agent",高榕创投和红杉中国联合领投,腾讯和上海未来产业基金也下场支持,市场传闻估值已达20亿美元。阿里出身的顶级人才,一转身就成了新贵公司的创始人。
|
||||
|
||||

|
||||
|
||||
🔷 再把时间往前拨:8月5日,谷歌AI迎来史上最大人事地震——在谷歌工作27年的首席科学家Jeff Dean正式离职,与三位技术元老一起创办Discovery Loop;DeepMind CEO哈萨比斯卸任,转任DeepMind董事长兼Alphabet首席科学家,据说他原本也想打包走人,是被谷歌连夜拦下、"架"上董事长位置的。
|
||||
|
||||
再往前,7月底,人称"AI圈最会追风的男人"的贾扬清离开英伟达,创办Intent Lab,押注自主AI软件工程。
|
||||
|
||||

|
||||
|
||||
一句话总结这周的人才局面:巨头们一边在台上发布新模型,一边在台下目送自己的技术大牛离职创业。模型可以靠后训练,人才可没法靠后训练——这,才是巨头们最头疼的护城河问题。
|
||||
|
||||
**结语**
|
||||
|
||||
回过头看这疯狂的一周:8月14日一天五连发,DeepSeek深夜悄悄交卷顺便涨了价,马斯克放话"AI这一仗必须赢"还顺手预告了4.7,Meta时隔大半年重回开源、LTX把视频生成成本打到八分之一……模型在下饺子,价格在下刀子,人才在跑路。
|
||||
|
||||
2026下半年的AI竞争,已经不是什么"军备竞赛",而是实实在在的"生死时速"——没有人敢掉队,没有人敢歇口气。下一周会有什么?没人知道。但可以肯定的是,这群厂商,一刻都不会停。
|
||||
|
||||

|
||||
|
||||

|
||||
|
||||

|
||||
@@ -0,0 +1,73 @@
|
||||
# 📊 文章摘要:过去一周,模型在下饺子,价格在下刀子,人才在跑路,AI厂商卷入生死时速!
|
||||
|
||||
> **原文**:[2026-08-20_过去一周_模型在下饺子_价格在下刀子_人才在跑路_AI厂商卷入生死时速.md](./2026-08-20_过去一周_模型在下饺子_价格在下刀子_人才在跑路_AI厂商卷入生死时速.md)
|
||||
> **原文链接**:https://mp.weixin.qq.com/s/tRwcm21YyiiMU-HxgysinQ
|
||||
> **来源**:微信公众平台
|
||||
> **作者**:祖哥(e-works 综合报道)
|
||||
> **发布日期**:2026-08-20
|
||||
> **摘要日期**:2026-08-20
|
||||
> **价值评级**:⭐⭐ 中
|
||||
|
||||
---
|
||||
|
||||
## 核心命题
|
||||
|
||||
> **生死时速** — 以 2026 年 8 月 8 日至 14 日一周为窗口,记录全球 AI 厂商密集发布、价格策略转向与顶级人才外流三条并行主线,呈现行业竞争从"军备竞赛"升级为"无人敢掉队"的消耗战。
|
||||
|
||||
---
|
||||
|
||||
## 文章概要
|
||||
|
||||
本文是 e-works 的 AI 行业周报,倒序盘点一周动态:8 月 14 日阿里 Qwen3.8-27B、智谱 GLM-5.3、MiniMax Music 3.0、谷歌 Gemini 3.7 Flash、OpenAI GPT-5.6 Sol Ultrafast 五连发;8 月 13 日 DeepSeek V4-Pro-0813 深夜上线并宣布峰谷分时涨价(高峰输出涨 350%);8 月 12 日马斯克 xAI 三件套(Grok 4.6、Grok Bot、战前动员);8 月 11 日 Meta 重回开源(Muse Glimmer,首个 Apache 2.0)与 LTX-2.5 开源视频;并汇总余家辉、林俊旸、Jeff Dean、哈萨比斯、贾扬清等人才大流动。其价值是高密度的时间线索引与可引用事实清单(发布节奏、定价、参数);局限是汇编转述,官方宣传、社区传闻与玩梗混排,无独立核查,情绪化修辞较多。
|
||||
|
||||
---
|
||||
|
||||
## 关键要点
|
||||
|
||||
1. **8 月 14 日一天五连发** — Qwen3.8-27B 开源(262K 原生上下文,YaRN 拉至 1M Token);GLM-5.3(743B 后训练,官方称编程提升 50%,完整权重两周后放出);Music 3.0(开放权重,最长 5 分钟 32kHz 立体声);Gemini 3.7 Flash(三周迭代一次,价格砍半至 0.75 美元/百万输入 Token);GPT-5.6 Sol Ultrafast(Cerebras 支撑,推理 14 倍速、750 Token/秒)。 `[分类: 共识]`
|
||||
2. **DeepSeek V4-Pro 补齐 Agent 能力** — DeepSWE 12.8→62.7(近 5 倍)、Cybergym 52.7→83.3、Terminal Bench 2.1 72.1→87.9(对比 Claude Fable 5 的 88.0 仅差 0.1),1M 上下文/384K 输出,指向多文件长任务编程。 `[分类: 共识]`(数据为官方口径)
|
||||
3. **DeepSeek 峰谷分时定价** — 8 月 17 日起 V4-Pro 高峰输出 6→27 元/百万 Token(+350%),V4-Flash 2→9 元,闲时减半。"错峰用电"式定价是头部低价厂商定价范式松动的信号。 `[分类: 争议]`
|
||||
4. **模型涨价与框架开源并行** — 同步开源 Agent 框架 Harness v0.1(MIT 协议,"黑鲸"团队出品),"一紧一松"的生态策略。 `[分类: 共识]`
|
||||
5. **DeepSeek 押注国产芯片** — 引梁文锋闭门会议流出实录:CUDA 护城河正在瓦解、华为超节点可"完全平替"、算力底座押华为昇腾 950 等国产芯片。 `[分类: 争议]`(单一信源流出实录,未获证实)
|
||||
6. **Meta 五天内闭源转开源** — 8 月 6 日闭源发布 Muse Spark 1.2 后,8 月 11 日以史上首个 Apache 2.0 协议开源 Muse Glimmer(30B,4bit 量化后 24/32GB 消费级显卡可跑本地常驻 Agent),扎克伯格同日发 6500 字开源长文。 `[分类: 共识]`
|
||||
7. **开源视频成本击穿** — LTX-2.5("开放世界模型",视频+音频+世界模拟):GB200 双卡生成 10 秒 720p 视频仅 6.8 秒(快于播放本身),成本为同类 1/8,原生集成 ComfyUI 并对中小企业免费;承接 7 月底 MiniMax-H3 的性价比狂欢(768p 每秒 0.23 元)。 `[分类: 共识]`
|
||||
8. **Grok 4.6 与 Cursor 数据** — 依托 SpaceX 600 亿美元收购 Cursor 获得匿名化真实编程工作流数据,Artificial Analysis 智能指数 61 分追平 GPT-5.6 Sol;马斯克预言 AI 业务 5 年后占 SpaceX 估值 99%、明年底建成 10GW 算力。 `[分类: 争议]`(预言部分)
|
||||
9. **顶级人才大逃亡** — Meta 余家辉(亿元级薪酬仍离职创业,累计出走骨干近千人)、阿里林俊旸创 Pragmatik Labs(传估值 20 亿美元)、谷歌 Jeff Dean 离职创 Discovery Loop、哈萨比斯被"架"上董事长、贾扬清创 Intent Lab。作者论断:人才是无法靠后训练补齐的护城河。 `[分类: 争议]`(作者观点)
|
||||
|
||||
---
|
||||
|
||||
## 批判性分析
|
||||
|
||||
### 假设前提
|
||||
- 默认各厂商自报的榜单成绩、能力提升幅度与定价策略均如实且可信,未做交叉核验。
|
||||
- 以发布节奏密度直接推断竞争烈度("生死时速"),预设发版速度等于竞争力。
|
||||
|
||||
### 论据与逻辑
|
||||
- 官方数据、媒体报道(如《连线》薪酬报道)、社区传闻("市场传闻估值已达 20 亿美元")、流出实录(梁文锋闭门会)与网络玩梗(滑动变阻器)混排,信源可信度分层缺失。
|
||||
- 修辞驱动("下饺子""下刀子""跑路"),结论性判断("生死时速""没有一家敢歇脚")缺乏商业数据支撑(收入、份额、利用率)。
|
||||
|
||||
### 边界与局限
|
||||
- 观察窗口仅一周,趋势判断的外推风险高;所有基准成绩均为厂商口径。
|
||||
- 对发布物的能力边界(榜单之外的失效场景)无任何检验或保留。
|
||||
|
||||
---
|
||||
|
||||
## 可引用金句
|
||||
|
||||
> "模型可以靠后训练,人才可没法靠后训练——这,才是巨头们最头疼的护城河问题。"
|
||||
|
||||
> "2026下半年的AI竞争,已经不是什么'军备竞赛',而是实实在在的'生死时速'——没有人敢掉队,没有人敢歇口气。"
|
||||
|
||||
> "以后想用便宜的DeepSeek,得学会'错峰用电'。"
|
||||
|
||||
---
|
||||
|
||||
## 总体评价
|
||||
|
||||
**亮点**:一周时间线 + 全部关键发布参数/定价的高密度汇编,配有发布节奏总览图,是 2026 年 8 月中旬 AI 产业动态的优质索引与事实清单来源。
|
||||
|
||||
**不足**:无独立核查、无信源分级、传闻与事实混排;情绪化标题与修辞先行,批判距离不足。
|
||||
|
||||
**适用场景**:行业动态时间线归档、竞品发布与定价追踪的线索入口(引用具体数字前建议回溯各厂商官方公告核实)。
|
||||
|
||||
**关联建议**:与已归档的模型发布类文章互链;DeepSeek 涨价与国产芯片押注两条线索值得单独开档跟踪验证。
|
||||
Reference in New Issue
Block a user