文档(金鹏): 2026-08-20 章节 26 篇文章摘要归档
- 26 篇微信公众号文章原文+摘要归档至 知识/微信公众平台/{公众号}/
- 9 个主题分组:Skill工程/Agent运行时/数据基础设施/交互工具/产品服务/大模型前沿/产业开源/制造业AI/军事社会
- 生成 9 组配图(2560x1440 大图 + 160x90 thumb)至 知识/金鹏/20260820/
- 知识/金鹏.md 2026-08-20 章节改写为结构化索引(主题标签+配图+金句+分层子条目)
- 1 个小红书视频链接以视频笔记条目保留(内容无法文本化)
Co-Authored-By: Claude <noreply@anthropic.com>

 Claude
@@ -0,0 +1,202 @@
|
|||||||
|
# 硅谷CEO: Grok Bot诞生,震撼程度堪比Claude Code时刻!
|
||||||
|
|
||||||
|
> **来源**:微信公众平台(ASI启示录)
|
||||||
|
> **作者**:ASI启示录
|
||||||
|
> **发布日期**:2026-08-20(原文未标注明确日期,按下载日占位)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/Suq0Z4bseQHEzL42s18Nbw
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
最近,一个神级工具,震撼了硅谷。
|
||||||
|
|
||||||
|
「我认为Grok Bot是AI的又一个『Claude Code』时刻。我估计我个人对AI的使用量增长了大约100倍!」
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
这是硅谷知名投资人Gavin Baker在X上发出的惊叹。
|
||||||
|
|
||||||
|
为了证明Grok Bot的离谱效率,他分享了一个极其反直觉的案例——
|
||||||
|
|
||||||
|
这段时间,有无数人向他请教如何从零构建一个复杂的「播客摘要器」。
|
||||||
|
|
||||||
|
按照传统的开发流程,你需要懂得API对接、大模型Prompt调优、音频转写、前后端部署等一连串复杂的动作。但Gavin是怎么做的?
|
||||||
|
|
||||||
|
「我在Grok Bot里大约只花了15秒就完成了,而且效果比我之前用的所有旧版工具都要好!」
|
||||||
|
|
||||||
|
15秒,就能手搓一个高可用的AI级应用。
|
||||||
|
|
||||||
|
不仅是Gavin,知名连续创业者Andrew Wilkinson也公开发表了力挺——
|
||||||
|
|
||||||
|
「100%赞同!我觉得它如此迷人的原因,80%在于它的速度和响应实在太快了,简直快得惊人!我开始使用它之后,几乎立刻就关掉了我原本在用的OpenClaw和Hermes智能体。」
|
||||||
|
|
||||||
|
是的,Grok Bot的诞生,可能是对现有的AI Agent生态的降维打击。
|
||||||
|
|
||||||
|
## 它凭什么干掉过去的「AI天花板」?
|
||||||
|
|
||||||
|
AI创作者、多项AI初创公司创始人Alex Finn在连续重度使用Grok Bot一周后,得出了一个结论:「它是目前市面上绝对最好的开箱即用AI智能体体验,没有之一。」
|
||||||
|
|
||||||
|
过去的AI智能体(比如Hermes、Codex等)往往陷入了一个怪圈:配置地狱。
|
||||||
|
|
||||||
|
每当你想要完成一个任务,你需要像个工程师一样去选择底层模型、调整上下文窗口大小、设定推理级别、配置本地还是云端运行、开启或关闭一堆复杂的插件权限……
|
||||||
|
|
||||||
|
对于95%的普通用户来说,这种体验简直令人抓狂。
|
||||||
|
|
||||||
|
但Grok Bot走了一条完全不同的道路——「极度主见的工作流」。
|
||||||
|
|
||||||
|
它是极致的「零配置」。
|
||||||
|
|
||||||
|
Grok Bot会替你做出了所有决定。你不需要选模型,不需要调参数,下载、安装、打开,直接告诉它你要干什么。它就像苹果产品一样,把复杂的底层逻辑全部封装,呈现给你的就是「它直接就能跑,而且跑得最好」。
|
||||||
|
|
||||||
|
而且,它还有强制的「云原生虚拟机」。
|
||||||
|
|
||||||
|
起初,很多人(包括Alex Finn自己)对这一点感到抗拒,大家更习惯让AI在自己的本地电脑上操作。
|
||||||
|
|
||||||
|
但Grok Bot强制要求:所有Bot都在云端拥有自己独立的虚拟电脑(VM)。
|
||||||
|
|
||||||
|
用了一周后,所有人都会大喊「真香」。为什么?因为安全隔离。
|
||||||
|
|
||||||
|
你不需要把自己的个人账号、敏感文件暴露给AI。想让AI管理某个账号?直接去它那个云端虚拟机的浏览器里登录就行了。
|
||||||
|
|
||||||
|
它在你看不见的云端24小时不间断地工作,丝毫不会让本地设备卡顿。
|
||||||
|
|
||||||
|
最后,就是史诗级的「多智能体原生协同」。
|
||||||
|
|
||||||
|
这是Grok Bot最可怕的护城河。Grok Bot的界面非常像苹果的iMessage,左边是你建立的一排Bot,右边是对线框。
|
||||||
|
|
||||||
|
当你给某个Bot下达任务时,它们居然会自动在后台互相发消息沟通!
|
||||||
|
|
||||||
|
比如,你让「写代码Bot」去开发一个功能,它会自动给「内容Bot」发消息:「嘿,老板前天在X上发了什么需求?把上下文给我发一下。」
|
||||||
|
|
||||||
|
你不需要居中调度,它们自己组成了一个团队,自动找人、传上下文、接力完成工作。
|
||||||
|
|
||||||
|
## 终极实操:如何用Grok Bot打造「一人公司」?
|
||||||
|
|
||||||
|
网友Evanpunk2077在深度体验后,一语道破天机:「Grok Bot比OpenClaw、Herms Agent好用太多了。」
|
||||||
|
|
||||||
|
没错,只要配置得当,你将拥有一整支为你全年无休打工的赛博AI团队。
|
||||||
|
|
||||||
|
以下是基于Alex Finn实战经验的保姆级配置指南,建议立刻收藏:
|
||||||
|
|
||||||
|
### 第一步:设立你的「赛博CEO」
|
||||||
|
|
||||||
|
打开Grok Bot,你拥有的第一个Bot,不要叫它「助手」,把它置顶,重命名为一个真实的人名),职位设定为:Chief of Staff(幕僚长)或 CEO。
|
||||||
|
|
||||||
|
为什么要这么做?因为当你拥有几十个Bot时,你根本记不住该把任务分给谁。你只需要把任务丢给CEO,比如:「我需要研究一下最近的AI趋势并写一封邮件发出去」。
|
||||||
|
|
||||||
|
CEO Bot会自动分析:「研究工作分给Barry,写邮件分给Cindy」,然后替你把活儿全派下去。
|
||||||
|
|
||||||
|
### 第二步:「大脑倾倒」与「逆向提示词」大法
|
||||||
|
|
||||||
|
不要自己去痛苦地写Bot的System Prompt。用这个首创的流程:
|
||||||
|
|
||||||
|
**1.大脑倾倒**
|
||||||
|
|
||||||
|
在对话框里疯狂输入关于你的一切。你是谁?你的公司叫什么?你的目标是什么?你讨厌做什么事?你想搞什么方向的钱?
|
||||||
|
|
||||||
|
**2.逆向提示词**
|
||||||
|
|
||||||
|
接着对它说:「基于你对我的了解,如果是你,你会如何设置这个Grok Bot工作台?我们应该建立哪些Bot?它们的职位、职责和日常例行工作应该是什么?请帮我配置以实现生产力最大化。」
|
||||||
|
|
||||||
|
指令发出后,奇迹就会发生。你的CEO Bot会自己控制自己,自动在左侧栏为你创建出一排排分工明确的打工人Bot,连头像和描述都给你写好了!
|
||||||
|
|
||||||
|
### 第三步:装配「神级插件(Plugins/MCPs)」
|
||||||
|
|
||||||
|
Grok Bot的强大离不开工具库,以下几个是必装神器:
|
||||||
|
|
||||||
|
**1 Agent Mail:** 这是强烈推荐的杀手锏。
|
||||||
|
|
||||||
|
不要把你的私人Gmail密码给AI!用免费的Agent Mail给你的每一个Bot创建一个专属的邮箱地址。然后用这个邮箱把它们作为「员工」邀请进你的各种后台(比如社区管理员、网站运营)。它们从此有了独立的「数字身份证」。
|
||||||
|
|
||||||
|
**2 Vercel & Cursor Origin:** 程序员必备,AI写完代码直接自动推送到Vercel部署,一气呵成。
|
||||||
|
|
||||||
|
**3 Tailscale:** 局域网穿透神器。装上它,你的云端Bot就能跨设备控制你的手机、iPad、Mac台式机,实现全终端制霸。
|
||||||
|
|
||||||
|
**4 Last 30 Days:** 一款信息挖掘插件,能逆向调用全网社交媒体API,做趋势深挖和背景调研的神器。
|
||||||
|
|
||||||
|
## 抄作业!大佬的「AI舰队」都在干什么?
|
||||||
|
|
||||||
|
我们来看看Alex Finn自己日常是如何压榨这群「赛博打工人」的。
|
||||||
|
|
||||||
|
他的Grok Bot后台主要养了这5员大将,覆盖了技术、内容、社区、商务和创新。
|
||||||
|
|
||||||
|
**1 Build(首席技术官 CTO)**
|
||||||
|
|
||||||
|
Build是整个团队的技术大拿。Alex的设备很多,甚至有一台搭载了顶级RTX 5090显卡的超级主机。
|
||||||
|
|
||||||
|
通过Tailscale,Build可以在云端直接控制这台5090主机,在上面部署一个拥有380亿参数的Qwen本地大模型,并在这个环境下从零手搓一款游戏。任何代码报错、个人网站更新,直接喊Build,秒修复。
|
||||||
|
|
||||||
|
**2 Barry(全天候公关与内容总监)**
|
||||||
|
|
||||||
|
如果你也做自媒体或关注行业前沿,你必须拥有一个Barry。
|
||||||
|
|
||||||
|
Barry被设置了一个强大的Routine:每天从早上7点到晚上11点半,每隔30分钟,Barry就会自动去扫一遍SpaceX、OpenAI、Anthropic等科技巨头的X账号。
|
||||||
|
|
||||||
|
只要有重量级产品发布,Barry会立刻将快讯推给老板,同时自动抓取老板过去的视频素材,洗稿拼接成最新的爆款订阅邮件,永远快人一步。
|
||||||
|
|
||||||
|
**3 Dusty(不知疲倦的社群运营)**
|
||||||
|
|
||||||
|
Dusty通过Agent Mail拥有了自己的账号,被邀请成为了Alex社群的管理员。
|
||||||
|
|
||||||
|
它24小时巡视论坛。有人发了技术求助帖?Dusty秒回专业解答。
|
||||||
|
|
||||||
|
有新用户潜水好几天没动静?Dusty会通过调研该用户的背景,主动私信他:「嘿,看你的资料,建议你可以试着开发一个XX小工具哦!」
|
||||||
|
|
||||||
|
把社群活跃度拉得满满的,而老板Alex完全不用插手。
|
||||||
|
|
||||||
|
**4 Cindy(反垃圾邮件与商务总监 BD)**
|
||||||
|
|
||||||
|
Alex本人极度讨厌看邮件,这导致他错过了无数商业赞助。Cindy完美填补了这个空缺。
|
||||||
|
|
||||||
|
Cindy被授权接入商务邮箱,每天对付数以百计的邮件。Cindy会仔细背调每一个发件人的公司背景,甄别出骗子和真实的赞助商。
|
||||||
|
|
||||||
|
每天下班前,Cindy会给老板提交一份干净清爽的Excel表格:「老板,今天有这3个真金白银的商务合作可以聊,请过目。」
|
||||||
|
|
||||||
|
**5 Reed(疯狂的黑客增长实验员)**
|
||||||
|
|
||||||
|
这是最具有赛博朋克色彩的一个Bot。老板CEO会指派Reed整天在互联网上「游荡」。
|
||||||
|
|
||||||
|
Reed的任务是到处看帖子,分析网民最近在抱怨什么、缺什么工具。一旦发现痛点,Reed就会自己快速写一个小产品,扔到网上去测试有没有人点、有没有人付费。Reed就像一个不知疲倦的找雷达,全天候在互联网的汪洋大海里替老板寻找搞钱的机会。
|
||||||
|
|
||||||
|
CEO统揽大局,五个高管各司其职,全部在云端虚拟机里全自动闭环。
|
||||||
|
|
||||||
|
这,就是生产力跃升100倍的真相!
|
||||||
|
|
||||||
|
## Grok Bot能一统天下吗?
|
||||||
|
|
||||||
|
虽然Grok Bot带来了无与伦比的震撼,但在这场狂欢中,业内依然存在一些冷静的声音。
|
||||||
|
|
||||||
|
科技大V Mckay Wrigley一针见血地指出:「Grok Bot这样的产品,最大的问题在于它们作为『生产力工具』,显得还不够严肃。」
|
||||||
|
|
||||||
|
他认为,虽然「云端智能体+虚拟机」绝对是正确的方向,但目前业内跟风的「iMessage短信式聊天界面」其实是错误的方向。
|
||||||
|
|
||||||
|
如果开发团队(传闻背后有SpaceX和Cursor团队的影子)想要真正让企业买单,就必须抛弃聊天框,进化出更符合企业级SaaS交互的管理界面。
|
||||||
|
|
||||||
|
Mckay还提醒大家,当年「Claude Code时刻」之所以伟大,不仅仅是因为外壳好用,更是因为Claude大模型本身极其逆天。目前Grok Bot的底层模型虽然很强,但还没到独孤求败的地步。
|
||||||
|
|
||||||
|
「我们得等看Grok 4.7版本到底有多聪明。工具再好,如果模型不够聪明,一切都是零。」
|
||||||
|
|
||||||
|
而且,并不是所有人都能无痛享受这场盛宴。
|
||||||
|
|
||||||
|
网友Dave Evans抱怨道:「自从5月份Grok加上了额度限制后,我的使用量反而下降了100倍。哪怕我买了Supergrok+年度会员,我常常还没跑出一个有用的结果,周度调用限额就爆了,再买算力又太贵。这几乎成了富人的游戏。」
|
||||||
|
|
||||||
|
残酷的现实就是:超级Agent在后台疯狂交互、调用工具的背后,燃烧的是巨量的Token。想要驱动一个「一人公司」,每个月的算力账单绝不是一笔小数目。
|
||||||
|
|
||||||
|
所以,Grok Bot真的能干掉Hermes和OpenClaw吗?
|
||||||
|
|
||||||
|
答案是:它们可以共存,而非立刻取代。
|
||||||
|
|
||||||
|
正如Alex Finn所说,Grok Bot是极其封闭、有主见的系统,你不能自由更换底层大模型。
|
||||||
|
|
||||||
|
如果你需要让AI直接干预你的本地系统底层文件,或者你想用一些极其便宜的开源模型(比如用本地显卡跑Qwen 38B)来省钱,高度可定制的Hermes和OpenClaw依然是不可替代的。
|
||||||
|
|
||||||
|
Grok Bot负责全天候的通用脑力劳动与云端协同,而Hermes负责深度的本地定制与极客操作。
|
||||||
|
|
||||||
|
两者的结合,才是当下的终极答案。
|
||||||
|
|
||||||
|
参考资料:
|
||||||
|
|
||||||
|
https://x.com/GavinSBaker/status/2089379355692527813
|
||||||
|
|
||||||
|
https://www.youtube.com/watch?v=vrgO4D_mUlA
|
||||||
|
|
||||||
|
编辑:Aeneas
|
||||||
@@ -0,0 +1,78 @@
|
|||||||
|
# 📊 文章摘要:硅谷CEO: Grok Bot诞生,震撼程度堪比Claude Code时刻!
|
||||||
|
|
||||||
|
> **原文**:[2026-08-20_硅谷CEO_Grok_Bot诞生_震撼程度堪比Claude_Code时刻](./2026-08-20_硅谷CEO_Grok_Bot诞生_震撼程度堪比Claude_Code时刻.md)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/Suq0Z4bseQHEzL42s18Nbw
|
||||||
|
> **来源**:微信公众平台
|
||||||
|
> **作者**:ASI启示录
|
||||||
|
> **发布日期**:2026-08-20
|
||||||
|
> **摘要日期**:2026-08-20
|
||||||
|
> **价值评级**:⭐⭐ 中
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 核心命题
|
||||||
|
|
||||||
|
> **零配置舰队** — Grok Bot 以"零配置 + 强制云端 VM + 多智能体原生协同"把 Agent 使用门槛降到普通用户可用,代表开箱即用路线对可定制路线的冲击。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 文章概要
|
||||||
|
|
||||||
|
本文是新能源媒体式的产品资讯汇编:Grok Bot 被硅谷投资人称为"又一个 Claude Code 时刻",其核心卖点为零配置(替用户做所有决定)、强制云端虚拟机(安全隔离、不占本地)与多智能体原生协同(Bot 之间自动互发消息接力工作)。文章主体转载 Alex Finn 的"一人公司"配置实战(CEO Bot + 大脑倾倒/逆向提示词 + Agent Mail/Tailscale 等插件 + 五员大将分工),文末保留了冷静声音:聊天界面不够严肃、模型能力才是上限、Token 成本高昂,结论是与 Hermes/OpenClaw 共存而非替代。价值在于实操配置参考与多方观点并存,但整体为二手转述、无独立验证。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 关键要点
|
||||||
|
|
||||||
|
1. **Grok Bot 三大产品特征** — 极致零配置(不选模型不调参数)、强制云原生虚拟机(安全隔离、24 小时云端运行)、多智能体原生协同(Bot 自动互发消息、传上下文、接力工作)`[分类: 共识]`
|
||||||
|
2. **15 秒构建播客摘要器** — 投资人 Gavin Baker 称其个人 AI 使用量增长约 100 倍;此类惊人性说法来自推主自述,无独立验证 `[分类: 争议]`
|
||||||
|
3. **"一人公司"五 Bot 舰队配置** — Build(CTO)/Barry(内容)/Dusty(社群)/Cindy(商务)/Reed(增长) 各司其职,CEO Bot 统一派活,覆盖技术-内容-社区-商务-创新 `[分类: 共识]`
|
||||||
|
4. **大脑倾倒 + 逆向提示词配置法** — 先倾倒个人/公司信息,再让 CEO Bot 反向为你设计 Bot 组织架构与职责,避免手写 System Prompt `[分类: 共识]`
|
||||||
|
5. **必装插件四件套** — Agent Mail(数字身份证)、Vercel/Cursor(部署)、Tailscale(跨设备控制)、Last 30 Days(趋势挖掘)`[分类: 共识]`
|
||||||
|
6. **冷静声音:模型决定上限** — Mckay Wrigley 指出聊天式界面不适合企业级 SaaS;"工具再好,如果模型不够聪明,一切都是零" `[分类: 争议]`
|
||||||
|
7. **额度限制成富人游戏** — 5 月起 Grok 限额后重度用户使用量反降,超级 Agent 燃烧巨量 Token,算力账单是"一人公司"的真实门槛 `[分类: 争议]`
|
||||||
|
8. **共存而非替代** — Grok Bot 封闭有主见(不能换模型),本地深度定制与便宜开源模型场景仍是 Hermes/OpenClaw 的地盘 `[分类: 共识]`
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 批判性分析
|
||||||
|
|
||||||
|
### 假设前提
|
||||||
|
|
||||||
|
文章默认:(1) 硅谷 KOL 的使用体验可代表产品真实能力——传播链(X 推文→YouTube→公众号)层层转述放大;(2) "Bot 自动协同"比人工调度更优——但自动互发消息的上下文损耗与失控风险未被讨论;(3) 一人公司范式可直接套用——个案成功不构成普遍性。
|
||||||
|
|
||||||
|
### 论据与逻辑
|
||||||
|
|
||||||
|
全部论据为名人引语与个人体验,无基准测试、成本数据、失败案例。文章结构是"惊叹→功能介绍→保姆教程→唱反调→折中"的媒体套路,逻辑上无硬伤但论证强度低。值得肯定的是保留了反对观点(Wrigley 的批评、额度限制抱怨),未做成单方面软文。
|
||||||
|
|
||||||
|
### 边界与局限
|
||||||
|
|
||||||
|
适用于了解 Grok Bot 产品形态与个人多 Bot 协作配置思路;对产品选型决策参考价值有限(无与竞品的系统对比)。文中"生产力跃升 100 倍"等表述为传播话术。时效性强,产品迭代可能很快使细节过时。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 可引用金句
|
||||||
|
|
||||||
|
> "工具再好,如果模型不够聪明,一切都是零。"
|
||||||
|
|
||||||
|
> "Grok Bot负责全天候的通用脑力劳动与云端协同,而Hermes负责深度的本地定制与极客操作。两者的结合,才是当下的终极答案。"
|
||||||
|
|
||||||
|
> "残酷的现实就是:超级Agent在后台疯狂交互、调用工具的背后,燃烧的是巨量的Token。"
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 总体评价
|
||||||
|
|
||||||
|
**亮点**:
|
||||||
|
- 完整搬运了 Alex Finn 的多 Bot 组织配置实操,有直接参考价值
|
||||||
|
- 保留了多方冷静声音,避免单边吹捧
|
||||||
|
- 对零配置 vs 可定制两条路线的共存判断清醒
|
||||||
|
|
||||||
|
**不足**:
|
||||||
|
- 二手转述,无独立验证与数据
|
||||||
|
- 标题党色彩浓("震撼""降维打击")
|
||||||
|
- 对多智能体自动协同的风险面(失控、成本、安全)几乎未讨论
|
||||||
|
|
||||||
|
**适用场景**:了解 Agent 消费级产品趋势;设计个人多 Bot 工作流时的配置参考
|
||||||
|
|
||||||
|
**关联建议**:与《万字长文:做了些爆款 Skills 以后》(本批归档)对读——Grok Bot 的零配置厚产品路线 vs Skill 生态的开放能力商品路线,是 Agent 普及的两种范式
|
||||||
@@ -0,0 +1,198 @@
|
|||||||
|
# 2026CSDI:AGI前夜,属于懂Agent、更懂模型的长期深耕企业
|
||||||
|
|
||||||
|
> **来源**:微信公众平台(CSDIsummit)
|
||||||
|
> **作者**:CSDIsummit
|
||||||
|
> **发布日期**:2026-08-20(原文未标注明确日期,按下载日占位)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/oNIIz2OmoV7Mk1zo87cBjA
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
|
||||||
|
|
||||||
|
WAIC 2026上,大模型与生成式AI赛道共有130家参展主体,其中83家将AI Agent或智能应用作为主要标签,基础大模型企业仅剩18家。模型发布少了,Agent演示多了。行业讨论的焦点也从"模型有多聪明"转向"究竟能创造多少真实价值"。AI竞争的基本单位,正在从"一个模型"变成"一套体系"。
|
||||||
|
|
||||||
|
**01 从模型到体系:AGI组织目标与AI核心发展要素**
|
||||||
|
|
||||||
|
2026年,全球人工智能产业正站在一个微妙而关键的路口。模型能力持续突破、智能体加速落地实体场景、企业AI战略从分散探索走向系统整合。与此同时,关于AGI(通用人工智能)的讨论,也正从"能不能实现"转向"如何实现"——以及更关键的是,"什么样的组织才能实现"。
|
||||||
|
|
||||||
|
对于当前的研发组织而言,这不再是一道选择题,而是一道生存题。
|
||||||
|
|
||||||
|
**AGI作为组织目标:从愿景共识到战略锚点**
|
||||||
|
|
||||||
|
AGI不是简单的问答工具,而是能够理解复杂目标、拆解任务、调用工具、持续学习,并在科研、工程、金融、制造和社会治理中承担高阶工作的智能系统。OpenAI、Anthropic、Google DeepMind等全球AI领导企业均将其视为AI发展的终极目标。
|
||||||
|
|
||||||
|
然而,2026年最显著的变化在于:AGI不再只是少数前沿实验室的"诗与远方",它正在成为越来越多研发组织的核心战略锚点。
|
||||||
|
|
||||||
|
今年7月,DeepSeek创始人梁文锋在长达四小时的闭门交流中,系统阐述了公司的AGI路线图:一个六阶梯的递进结构:语言模型→思维链(CoT)→Agent→持续学习→自我迭代(奇点)→具身智能。梁文锋强调:"Agent要用到CoT,然后CoT也要用到前面的阶梯,所以它并没有一步是白走的。"
|
||||||
|
|
||||||
|
这些信号揭示了一个共识:AGI不是一蹴而就的跳跃,而是一条必须步步为营的技术演进路径。
|
||||||
|
|
||||||
|
更重要的是,AGI正在成为组织决策的"第一性原理"。DeepSeek属于典型的愿景驱动型组织——组织运转、技术取舍、商业决策,均围绕AGI研发共识推进,依靠长期目标凝聚核心研发人才。唐杰同样指出,本轮人工智能变革的核心本质不是一次产品创新或商业模式创新,而是技术革命本身抬高了"智能上界";谁能率先将该上界向上推升一寸,谁就能重新定义千行百业的能力边界。
|
||||||
|
|
||||||
|
**AI核心发展要素:从"三驾马车"到系统算力**
|
||||||
|
|
||||||
|
如果说AGI定义了"去哪里",那么算力、数据、算法、人才与组织架构则共同决定了"能走多远"。
|
||||||
|
|
||||||
|
**算力:从单卡竞赛到系统竞赛**
|
||||||
|
|
||||||
|
算力是支撑人工智能持续演进的基础底座和关键引擎。工信部数据显示,截至2026年6月底,我国智能算力规模已达2185 EFLOPS。但算力的竞争逻辑正在发生根本性变化。
|
||||||
|
|
||||||
|
过去谈算力,大家总追问单颗芯片的水平如何。但大模型训练和推理不是单卡比赛——互联、内存共享和任务调度决定了大规模集群能否形成有效算力。AI算力需求的重心正从训练转向推理,存储、先进制程和先进封装产能层层吃紧。揭示了:**算力提供底座,模型提供智能**,**Agent负责执行**,**终端和机器人进入真实场景**——**AI竞争的基本单位,正在从"一个模型"变成"一套体系"。**
|
||||||
|
|
||||||
|
**数据:从"管好"到"用好"**
|
||||||
|
|
||||||
|
数据是人工智能的关键"燃料"。2025年,我国用于人工智能训练和推理的数据总量为199.48艾字节,同比增长42.86%,推理数据量首次超过训练数据量。截至今年6月底,全国已建成行业高质量数据集总体量超1565拍字节。
|
||||||
|
|
||||||
|
但数据的价值不在于"多",而在于"活"。国家数据局局长刘烈宏指出,数据合作的话题正从"管好数据"迈向"用好数据"。对于研发组织而言,打通产业链数据壁垒、推动数据归集与共享治理,才能让AI精准扎根产业场景。
|
||||||
|
|
||||||
|
**算法:从微创新到底层突破"**
|
||||||
|
|
||||||
|
算法领域,我国已达到国际先进水平。但真正的挑战在于:未来大模型企业的竞争着力点,不能仅仅停留在现有技术框架的微创新,而是要在模型的认知能力、推理能力、世界知识的整合能力上实现底层突破。
|
||||||
|
|
||||||
|
2026年,行业共识正从语言模型转向能理解物理规律的多模态世界模型。"长程任务"能力--让AI从"即时问答"走向"宏大工程",将宏大目标自主拆解为数千个可执行子任务---正是算法突破的前沿方向。
|
||||||
|
|
||||||
|
**人才:最稀缺的资源**
|
||||||
|
|
||||||
|
再强的算力、再多的数据,最终要靠人来驾驭。数据显示,高性能计算工程师的人才供需比低至0.15---每1个合格求职者面临7家公司的争夺。AI科学家以平均月薪13.2万元断层领先。
|
||||||
|
|
||||||
|
但人才竞争已不只是"抢人"那么简单。全球顶尖AI研究人员中,中国籍专家占比高达47%。如何留住人才、激发人才的创造力,考验的是组织的制度与文化。DeepSeek的做法是用AGI的长期目标凝聚核心研发人才;
|
||||||
|
|
||||||
|
组织架构:从"赛马"到"合兵"。
|
||||||
|
|
||||||
|
2026年最值得关注的趋势之一,还有AI研发组织架构的系统性重构。
|
||||||
|
|
||||||
|
过去两年,互联网大厂奉行内部赛马,多条AI产品线分头试错、持续消耗算力与人力。但2026年年中,巨头们集体按下整合键——字节将飞书产品团队并入豆包,阿里整合多条Agent产品线推出千问办公,腾讯收敛研发资源。
|
||||||
|
|
||||||
|
这并非中国独有。亚马逊关停了AGI Lab研究团队,将AGI部门、自研芯片团队、量子计算团队合并为统一组织,打通从基础设施到模型研发的全链路。Google DeepMind实施组织架构调整,优化科研与运营分工,集中资源推进AGI技术攻关。
|
||||||
|
|
||||||
|
这些调整折射出一个深刻判断:AI竞争的核心,从单点技术突破转向基础模型能力。一个领先的模型需要同时具备算法、数据、算力、训练、工程、产品反馈等多维能力——这种能力提升不再依赖某一个实验室,而依赖整个组织形成高速循环。
|
||||||
|
|
||||||
|
**从"获得智能"到"组织智能"**
|
||||||
|
|
||||||
|
AI产业正在从"获得智能"进入"组织智能"的阶段。模型仍然决定AI能力的上限,但单靠一个领先模型,已经越来越难构成完整的产业优势。
|
||||||
|
|
||||||
|
对于今天的研发组织而言,AGI不是一句口号,而是一套需要系统性构建的能力体系——它要求组织在算力、数据、算法、人才和架构上同步进化,要求决策者有足够的战略定力在短期变现与长期突破之间做出选择,也要求每一个参与者理解:通往AGI的路,不能跳步。
|
||||||
|
|
||||||
|
正如DeepSeek那张招聘海报上所写的——当今人类正处于AGI的前夜。但"前夜"不等于"黎明"。能够穿越这个长夜的组织,注定是那些既有清晰目标、又能扎实构建核心发展要素的长期主义者。
|
||||||
|
|
||||||
|
**02 为什么Agent终将回归模型核心,预训练为天花板**
|
||||||
|
|
||||||
|
2026年,AI行业最清晰的一条主线,无疑是Agent从"会聊天"到"能干活"的全面跃迁。基础模型综合水平已从20多分跃升至七八十分,长程任务稳定执行时间每8个月翻一番,最高纪录已达16小时。Agent不再"问一句答一句",而是在每一步自主完成"观察→思考→行动"的闭环,让大模型作为推理中枢,自主拆解任务、调用工具、评估结果。
|
||||||
|
|
||||||
|
WAIC 2026上,大模型与生成式AI赛道共有130家参展主体,其中83家将AI Agent或智能应用作为主要标签,基础大模型企业仅剩18家。模型发布少了,Agent演示多了。行业讨论的焦点也从"模型有多聪明"转向"究竟能创造多少真实价值"。
|
||||||
|
|
||||||
|
然而,Agent热潮之下,一个更深层的技术命题正在浮现:Agent的能力上限,本质上由预训练大模型决定。
|
||||||
|
|
||||||
|
**预训练:不可绕过的"天花板"**
|
||||||
|
|
||||||
|
如果说预训练决定模型的天花板,**后训练就决定它能不能摸到天花板**。清华教授唐杰明确指出,预训练使得大模型已经掌握世界常识知识,并且具备简单推理能力——更多数据、更大参数和更饱和的计算,仍然是scaling基座模型最高效的办法。
|
||||||
|
|
||||||
|
这一判断并非孤例。行业正在形成共识:预训练大模型是大模型推理能力的天花板。无论后训练阶段的强化学习如何精调、Agent框架如何编排,模型的推理深度、知识广度和泛化能力,根本上受限于预训练阶段所注入的世界知识和基础认知能力。
|
||||||
|
|
||||||
|
蚂蚁百灵Ling & Ring 2.6的技术报告给出了精准概括:"大模型正在从聊天机器人变成智能体。这个转变听起来只是换了个用法,实际上把模型的优化目标彻底改写了——一个实用的Agent,必须同时推理得好。"而推理能力的根基,恰恰来自预训练。
|
||||||
|
|
||||||
|
腾讯云副总裁李强有一个精妙的比喻:"大模型是引擎,工程化链路是把引擎变成整车的工程。发动机决定上限,工程决定能不能跑、跑多远、跑多稳。"Agent框架、工具调用、记忆管理——所有这些工程化能力,都是在"发动机"之上构建的整车。发动机不行,整车再精致也跑不远。
|
||||||
|
|
||||||
|
**Agent的繁荣,不能掩盖对基座的依赖**
|
||||||
|
|
||||||
|
当前Agent的能力演进,正在验证一个核心命题:Agent能做多复杂的事,取决于基座模型能理解多深的世界。
|
||||||
|
|
||||||
|
上海AI Lab开源的Agents-A1模型,使用多领域、多任务的高质量长程轨迹数据进行训练,增强模型在长上下文条件下的理解、推理和指令遵循能力。研究团队没有选择"小模型+复杂编排"的取巧路径,而是回到预训练本身——用更好的数据、更优的训练策略,从根基上提升模型的Agent能力。
|
||||||
|
|
||||||
|
这些实践指向同一个方向:**Agent能力的竞争,最终是基座模型能力的竞争**。
|
||||||
|
|
||||||
|
**编排式Agent的局限与模型原生Agent的崛起**
|
||||||
|
|
||||||
|
当前Agent开发存在两条技术路线:一是编排式Agent,即通用大模型加上LangGraph、Dify等调度框架,通过工程化手段实现任务拆解与工具调用;二是模型原生Agent,在训练阶段直接内置规划、反思逻辑,连贯性强。
|
||||||
|
|
||||||
|
编排式Agent灵活易部署,但面临一个根本性困境:超长任务容易出现逻辑漂移。当任务链条拉长到数十步甚至上百步时,基座模型的推理能力不足会导致Agent"走着走着就偏了"。这不是编排框架能解决的问题——框架只能组织流程,不能提升模型的判断力。
|
||||||
|
|
||||||
|
更深刻的变化正在发生。随着模型快速迭代,企业投入大量工程资源搭建的Agent,可能在下一个模型版本发布后,就被模型新增的原生能力覆盖。这意味着,单纯依靠工程编排构建的Agent壁垒,正在被模型能力的持续进化不断瓦解。
|
||||||
|
|
||||||
|
行业正在从训练模型的时代走向训练智能体的时代,但"模型架构和训练数据当然还重要"——环境设计、基础设施、评估器只是进入了核心圈,并未取代模型本身的核心地位。
|
||||||
|
|
||||||
|
**回归模型核心:Agent的终局形态**
|
||||||
|
|
||||||
|
未来的Agent应用形态,**终将回归以模型为核心的结构**。这不是否定Agent工程的价值,而是对技术本质的清醒认知。
|
||||||
|
|
||||||
|
**发动机决定上限**,无论Agent框架如何演进、工具调用如何丰富、记忆系统如何复杂,Agent的推理能力、规划能力和世界理解能力,永远受限于其背后的基座模型。预训练大模型投入的数据规模、计算资源和架构创新,直接决定了Agent能够触及的智能高度。
|
||||||
|
|
||||||
|
这意味着,对于创造者和应用者而言,最值得投入的方向不是追逐Agent框架的短期热点,而是深入理解并持续投资于基座模型的能力建设。无论是模型的原生Agent能力训练,还是针对Agent场景的持续预训练,都比在表层做工程包装更具长期价值。
|
||||||
|
|
||||||
|
2026年,AI行业正在从"获得智能"走向"组织智能"。但无论组织形态如何变化,模型始终是智能的源头。Agent让模型进入环境、形成生产力,但模型才是那个"能思考的大脑"。没有Agent能力,大模型终将停留在理论学习阶段——反过来说,没有强大的预训练基座,Agent也将止步于浅层执行,无法触及真正的智能。
|
||||||
|
|
||||||
|
**03 从Copilot到Agentic:AI-Native转型下的编程新范式**
|
||||||
|
|
||||||
|
**软件开发也经历着一场自图形界面发明以来最为重大的范式转移。根据Gartner的定义,企业级AI编码智能体是能够感知上下文、将人类意图转化为多步骤计划、并在代码、测试和相关工程产物中执行和验证这些步骤的自主或半自主软件工程解决方案。从"AI辅助编程"到"Agentic编程"——AI不再是被动的代码补全插件,而是具备环境感知、自主规划、工具调用与自我纠错能力的独立开发者。**
|
||||||
|
|
||||||
|
**企业价值:从个人提效到组织级生产力**
|
||||||
|
|
||||||
|
Agentic编程对企业而言,绝不仅是"让工程师写代码更快一点"。它的真正价值在于重构整个软件生产体系。
|
||||||
|
|
||||||
|
Gartner预测,到2028年,异步AI编码智能体工作流将使软件工程团队的生产效率提升30%至50%,远超2025年AI代码助手0%到20%的提升。截至2026年4月,全球企业级AI代码智能体市场的年化规模已达98亿至110亿美元。Anthropic的报告进一步印证了这一趋势:80%的领导者表示智能体投资已带来可衡量的财务影响,88%的人期望未来会带来更多回报。
|
||||||
|
|
||||||
|
真正的企业级价值,来自组织级而非个人级的Agentic部署。2025年底到2026年初,Stripe、Ramp、Coinbase三家公司几乎同时公开了各自的内部Coding Agent——Minions、Inspect、Cloudbot。三家公司独立开发,最终却不约而同地收敛到几乎相同的架构上:Agent不再只是"一个人在终端里用",而是"整个团队通过Slack或GitHub Issue随时触发"。你需要沙箱隔离执行环境,需要让Agent在中断后能续上之前的工作,需要防止一个用户的失控循环烧光全公司的模型额度。
|
||||||
|
|
||||||
|
正如IDC所指出的:**真正拉开差距的,不是是否引入AI编码工具,而是企业是否具备平台工程、治理能力和开发者角色转型的整体规划**。那些仅在局部场景试点智能体的组织,将很难释放规模化价值;而**将Agentic AI作为企业级能力来建设的组织,更有可能在速度、质量和创新能力上形成长期优势。**
|
||||||
|
|
||||||
|
Delivery Hero推出的内部AI编程智能体Herogen,年编码能力相当于130名工程师。TCL实业软工中心与腾讯云CodeBuddy合作,CodeBuddy覆盖了其90%以上的研发工程师,贯穿从需求拆解、代码编写、测试修复到部署上线的全链路。正如TCL软工中心应用开发总监所言:"我都有点不敢相信,两天把整个功能交付了,开发模式真的被颠覆了。"
|
||||||
|
|
||||||
|
**模型技术:Agentic编程的底层驱动力**
|
||||||
|
|
||||||
|
Agentic编程能力的跃升,本质来自模型技术的持续突破。
|
||||||
|
|
||||||
|
OpenAI发布的GPT-5.3 Codex主打"代理式编码",可以像开发者一样自主判断并推进任务,覆盖代码编写、运行测试、修复错误、更新Jira工单、撰写技术文档以及管理部署流程。该模型在多语言软件工程评测SWE-bench Pro中得分56.8%。
|
||||||
|
|
||||||
|
Cohere发布的North Mini Code采用300亿参数MoE架构(每次仅激活30亿参数),专为智能体软件工程设计。亚马逊、美团等企业开源万亿参数大模型LongCat-2.0(总参数1.6万亿),为真实的Agentic Coding任务而生,架构上创新引入稀疏注意力和N-gram Embedding。Poolside开源Laguna S 2.1,1M超长上下文+118B MoE模型。
|
||||||
|
|
||||||
|
行业共识正在形成:**Coding Agent的智力,越来越体现为长程任务能力**。它不只是"智能"本身,而是智能×可靠性的乘积。单步推理再强,如果第20轮开始忘目标、第50轮开始乱改文件、第100轮无法解释自己做过什么,它就仍然不能被托付。
|
||||||
|
|
||||||
|
**业务架构:从"+AI"到"AI+"的全链路重构**
|
||||||
|
|
||||||
|
Agentic编程对业务架构的冲击,远比想象中更深刻。
|
||||||
|
|
||||||
|
传统的研发流程是"人写代码→测试→部署",AI只是附着在某个环节上的工具。而在AI-Native转型下,整条研发线被拖到大太阳底下重新审视——每个业务节点都要回答"为什么这步不能由AI来做?"。这正是TCL团队从"+AI"走向"AI+"的关键一步。
|
||||||
|
|
||||||
|
阿里云正式提出"Agent Native Cloud",让Agent成为云的一等公民——产品、API、计费、文档、官网全部围绕Agent重新设计。无问芯穹发布Agentic Infra"前店后厂一中心"战略。云的主要用户,开始从人变成Agent——阿里云透露,过去五年PostgreSQL累计创建约4万个实例,而最近几个月仅由Agent自主创建的数据库实例便达到12万,环比增长约300%。
|
||||||
|
|
||||||
|
秒悟团队版让用户通过自然语言生成网站、小程序、App,每天有上万名用户在上面创作和发布,大部分没有技术背景。Agent要做的不只是把网页做出来,还要把数据库搭起来、域名分配好、网站部署完——"Coding Agent更关注代码,而Delivery Agent更关注全局"。
|
||||||
|
|
||||||
|
**开发者:从"码农"到"智能体指挥官"**
|
||||||
|
|
||||||
|
范式转移最深刻的冲击,落在开发者身上。Anthropic的报告揭示了一个核心结论:**软件工程师的角色正从"代码编写者"转变为"智能体指挥官"。**做软件不再等于写代码——工程师越来越多地变成"编排智能体写代码"的角色:评估智能体的输出、提供战略方向、确保系统解决了正确的问题。
|
||||||
|
|
||||||
|
Claude Code负责人直言,"software engineer"这个职衔最快今年就会开始消失,转向更接近"builder"(构建者)的新角色。程序员的角色将从手动编写代码,转型为AI代理群的指挥官。"只会写代码"的程序员将逐渐被淘汰,而具备架构设计、战略决策能力的从业者将更具竞争力。
|
||||||
|
|
||||||
|
会用AI的前提,是你先得懂行。未来的开发者更像是系统编排者、架构设计者与决策者。他们不再逐行敲击代码,而是指挥多个AI代理协作完成开发,同时保留人类独有的判断力与对品质的"品味"。
|
||||||
|
|
||||||
|
**AI-Native时代的新规则**
|
||||||
|
|
||||||
|
AI-Native转型不是"给研发团队增加一个AI工具",而是重构软件生产方式。Agentic编程的崛起,意味着软件开发的核心瓶颈正在从"怎么写出来"变成"该写什么、为什么要写、如何验证写对了"。**软件开发正经历着自图形界面发明以来最为重大的范式转移,"人人都能成为开发者"的时代已然拉开帷幕。**
|
||||||
|
|
||||||
|
**为此,第十届2026CSDI 峰会,于深圳10月16-18日召开**
|
||||||
|
|
||||||
|
帮助IT与会者,共探Agentic AI数字代理世界
|
||||||
|
|
||||||
|
正值Agentic AI时代,对于科技企业运营来说,大模型能力需聚焦于创造性任务、战略规划、业务结合,软件研发的技术范式、大数据技术都向模型自主化驱动,大量的智能软件研发工具和框架应运而生。数据成为了智能软件研发的核心。AI产业也从"模型能力驱动"转向"算力组织与效率驱动",大量的数据+海量智能场景在AI可持续发展中起到关键作用。智算资源的需求与训练部署复杂的模型,开发者需要应用高性能的硬件(如GPU、TPU等)和分布式计算技术(如云计算、集群计算、数据库等)。这些技术应用仍然是IT组织探寻与研究的课题。
|
||||||
|
|
||||||
|
2026CSDI第十届届中国软件研发智能创新科技峰会,将以数智+智管为主旨,于深圳10月16-18日召开,携手100+国内外顶尖创新先锋,一起迎接"数智融合、决策智能"这一个企业确定性的长期趋势,推动AI走向自进化,拥抱Agentic AI 应用前沿自主探索实践。
|
||||||
|
|
||||||
|
**总结:AI是一次革命:AI Agent时代已然到来,要快、要应用闭环数据**
|
||||||
|
|
||||||
|
大模型已经成熟的演变为文理工三全的技术,同时具备了文科的创意、记忆力、知识,理科的逻辑思维、推理能力,还具备了工科解决问题的能力,融合将带来的,我们称它为AI Agent时代,当用户发号指令、表达意图,AI不但能理解指令,而且拆解、分解成为任务,将其完成。标志着AI定位从辅助工具向核心执行者的跨越。它既能定下组织战略、重构公司结构、AI也能辅助战略与降本增效,这是人工智能定性为人类史上最重要的革命。
|
||||||
|
|
||||||
|
AI不仅是技术变革,更是思维方式的重塑,未来大部队的工作会有Agent来做,正如OpenAI CEO 说到"以后会有一个人的独角兽",当我们拥有了一个超级员工(数字员工),将减少信息不对称、提升整体运营效率、秒级复制,专项Agent处理不同任务,可以国际的扩张,随着架构中Agent的增多,沟通的瓶颈将变少,推理成本也会变少,每个Agent也都有它独特的业务目标,企业未来的核心竞争力需尽早采用AI Agent、使用最聪明的AI Agent、并拥有自己的闭环数据来强化AI能力,拥抱自身领域使用AI工具,让企业抢占先机,技术杠杆将彻底打破传统的人力规模壁垒。
|
||||||
|
|
||||||
|
**第十届2026CSDI 即将开幕,诚邀各界IT英雄,引峥嵘**
|
||||||
|
|
||||||
|
扎实的专业+前瞻性的思考+优秀的实践,带给业界同仁们精彩视角、卓越思维。秉持科技向善理念,推动IT行业交流与传播。渴望追求卓越、才华横溢的同道中人,渴望在前沿AI领域有着丰富实践的嘉宾,加入我们,携手并肩,探寻知识革命的未来!
|
||||||
|
|
||||||
|
精彩瞬间
|
||||||
|
|
||||||
|
微软、阿里巴巴、小米、腾讯、华为、360、平安集团、渣打银行、工商银行、招商银行、随行付、易方达、长亮科技、南方电网、广州银联、穆迪信息、拍拍贷、宇信集团、投哪儿金融、天维信息、萨摩耶、华泰证券、招商证券、国信证券、陆金所、广发基金、中国银联、恒天软件、天阳宏业、中数通、电信规划设计院、oppo、步步高、vivo、爱立信、百富计算机、厦门航空、福建联迪、网易、星网视易、升腾科技、视睿电子、飞利浦、金山软件、金山游戏、欧特克、顺丰、深信服、欢聚时代、虎牙、珠海健康云、优视科技(UC)、52TT、天翼云、凯米网络、电信设计院、ADmaster、博思软件、网宿科技、珍爱网、金蝶、唯品会、中国联通、中国移动、传动数码、无限极、中电、珠海网博、中软、同盾科技、杭州顺网、蓝凌软件、长园深瑞、中南民航、远光软件、广联达、中国电信、传音、利通、物理研究所、国家电网等。
|
||||||
|
|
||||||
|
END
|
||||||
|
|
||||||
|
点击阅读原文,随时关注峰会,日程最新上线内容
|
||||||
|
|
||||||
|
作者提示:个人观点,仅供参考
|
||||||
@@ -0,0 +1,73 @@
|
|||||||
|
# 📊 文章摘要:2026CSDI:AGI前夜,属于懂Agent、更懂模型的长期深耕企业
|
||||||
|
|
||||||
|
> **原文**:[2026-08-20_2026CSDI_AGI前夜_属于懂Agent_更懂模型的长期深耕企业](./2026-08-20_2026CSDI_AGI前夜_属于懂Agent_更懂模型的长期深耕企业.md)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/oNIIz2OmoV7Mk1zo87cBjA
|
||||||
|
> **来源**:微信公众平台
|
||||||
|
> **作者**:CSDIsummit
|
||||||
|
> **发布日期**:2026-08-20
|
||||||
|
> **摘要日期**:2026-08-20
|
||||||
|
> **价值评级**:⭐⭐ 中
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 核心命题
|
||||||
|
|
||||||
|
> **预训练天花板** — Agent 能力的上限由预训练基座模型决定,Agent 竞争终将回归模型核心竞争;AI 竞争的基本单位正从"一个模型"变成"一套体系"。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 文章概要
|
||||||
|
|
||||||
|
这是一篇 CSDI 峰会(2026年10月深圳)的会前产业综述,汇编了 2026 年 AI 行业的三大叙事:其一,AGI 从前沿实验室愿景变为研发组织的战略锚点,算力/数据/算法/人才/组织架构五要素需同步进化,行业从"获得智能"进入"组织智能"阶段;其二(全文最有观点的部分),Agent 能力上限本质由预训练大模型决定,编排式 Agent 在超长任务中逻辑漂移、且工程壁垒会被模型原生能力迭代不断瓦解;其三,Agentic 编程引发软件生产范式转移,开发者角色转向"智能体指挥官"。文章价值在于密集的数据点与多源观点汇编,但属二次加工而非原创研究,且后半部分混入明显的大会营销内容。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 关键要点
|
||||||
|
|
||||||
|
1. **AI 竞争单位从"一个模型"变成"一套体系"** — WAIC 2026 上 130 家参展主体中 83 家主打 Agent、基础大模型企业仅剩 18 家;算力提供底座、模型提供智能、Agent 负责执行、终端进入真实场景。 `[分类: 共识]`
|
||||||
|
2. **预训练是 Agent 能力的天花板,后训练决定能否摸到天花板** — 引唐杰观点:预训练注入世界常识与简单推理,更多数据/更大参数/更饱和计算仍是 scaling 最高效办法;引用腾讯云李强"引擎与整车"比喻。 `[分类: 争议]`
|
||||||
|
3. **编排式 Agent 将被模型原生 Agent 瓦解** — 超长任务(数十至上百步)中编排式 Agent 逻辑漂移,框架只能组织流程不能提升模型判断力;企业重投入搭建的 Agent 可能被下一个模型版本的原生能力覆盖。 `[分类: 争议]`
|
||||||
|
4. **AGI 六阶梯路线图(DeepSeek 梁文锋)** — 语言模型→思维链(CoT)→Agent→持续学习→自我迭代(奇点)→具身智能,"并没有一步是白走的";愿景驱动型组织靠长期目标凝聚人才。 `[分类: 共识]`
|
||||||
|
5. **组织架构从"赛马"到"合兵"** — 字节并飞书入豆包、阿里推千问办公、腾讯收敛资源;亚马逊合并 AGI/自研芯片/量子团队,Google DeepMind 架构调整——领先模型需要全组织多维能力高速循环。 `[分类: 共识]`
|
||||||
|
6. **开发者从"码农"到"智能体指挥官"** — 引 Anthropic 报告与 Claude Code 负责人观点:"software engineer"职衔最快今年开始消失;Gartner 预测 2028 年异步 AI 编码智能体使团队效率提升 30%-50%。 `[分类: 共识]`
|
||||||
|
7. **云的主要用户开始从人变成 Agent** — 阿里云"Agent Native Cloud";过去五年 PostgreSQL 人工累计创建约 4 万实例,近几个月 Agent 自主创建达 12 万,环比增长约 300%。 `[分类: 共识]`
|
||||||
|
8. **人才结构性稀缺** — 高性能计算工程师供需比 0.15(1 名求职者对 7 家公司),AI 科学家平均月薪 13.2 万;全球顶尖 AI 研究人员中中国籍占 47%。 `[分类: 共识]`
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 批判性分析
|
||||||
|
|
||||||
|
### 假设前提
|
||||||
|
- "预训练天花板论"被表述为"行业正在形成共识",实为业内分歧点(工程派认为上下文工程、记忆、工具生态同样决定上限),文章选择性采信了模型派观点而未呈现对立证据。
|
||||||
|
- 默认 Agentic 编程的效率提升数据(Gartner 30%-50%、Anthropic 80%/88%)可直接映射到中国企业场景,未讨论本土交付环境的差异。
|
||||||
|
|
||||||
|
### 论据与逻辑
|
||||||
|
- 几乎全部论据为二手引用(梁文锋闭门交流、唐杰、李强、蚂蚁技术报告、Gartner/IDC/Anthropic 报告),无一处给出可核查来源链接。
|
||||||
|
- 关键图表均为失效 blob 链接;存在笔误("从微创新到底层突破""、"第十届届中国")和段落结构混乱("组织架构"小节格式脱离),显示编辑加工粗糙。
|
||||||
|
- 结尾从产业分析突变为峰会宣传("诚邀各界IT英雄"+超长企业名单),文章实质是会议营销长文,观点服务引流。
|
||||||
|
|
||||||
|
### 边界与局限
|
||||||
|
- 三个章节(组织体系/模型核心/Agentic 编程)间缺乏内在论证连接,更像是三个独立素材的拼接。
|
||||||
|
- "Agent 终将回归模型核心"是对 2026 年时点的强预测,未讨论反例(如长上下文、记忆系统、环境设计对上限的抬升作用)。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 可引用金句
|
||||||
|
|
||||||
|
> "大模型是引擎,工程化链路是把引擎变成整车的工程。发动机决定上限,工程决定能不能跑、跑多远、跑多稳。"(腾讯云副总裁李强,文中引述)
|
||||||
|
|
||||||
|
> "Agent 能做多复杂的事,取决于基座模型能理解多深的世界。"
|
||||||
|
|
||||||
|
> "AI竞争的基本单位,正在从'一个模型'变成'一套体系'。"
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 总体评价
|
||||||
|
|
||||||
|
**亮点**:数据点密集且新(WAIC 结构、算力 2185 EFLOPS、数据 199.48 EB、供需比 0.15、PostgreSQL 实例 300% 增长),适合作为 2026 年 AI 产业综述素材库;"编排式 vs 模型原生"之争的梳理清晰。
|
||||||
|
|
||||||
|
**不足**:无原创观点与可核查引用;"预训练天花板"单一立场遮蔽行业分歧;后半篇为峰会软广;编辑粗糙(错字、断链、结构混乱)。
|
||||||
|
|
||||||
|
**适用场景**:快速了解 2026 年中国 AI 产业叙事框架与数据口径;作为"模型派 vs 工程派"争论中模型派立场的代表性表述引用;峰会参会决策参考。
|
||||||
|
|
||||||
|
**关联建议**:与《评估 GitHub Copilot 智能体运行框架》(微软Reactor)形成正反对照——后者实证运行框架层(编排层)的 Token 效率价值,本文则断言编排壁垒终将被模型原生能力瓦解;两文合读可完整呈现"编排 vs 原生"争论双方论据。
|
||||||
@@ -0,0 +1,298 @@
|
|||||||
|
# 重磅!Graph Engineering 实操手册公开
|
||||||
|
|
||||||
|
> **来源**:微信公众平台(Datawhale)
|
||||||
|
> **作者**:Datawhale
|
||||||
|
> **发布日期**:2026-08-20(原文未标注明确日期,按下载日占位)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/GZrKCHJaG5g7Ua-ZiEP-fQ
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
Datawhale干货 **作者:Codez,X博主**
|
||||||
|
|
||||||
|
上个月我们才发过一篇 Loop Engineering 的实操手册,现在新词就已经来了。
|
||||||
|
|
||||||
|
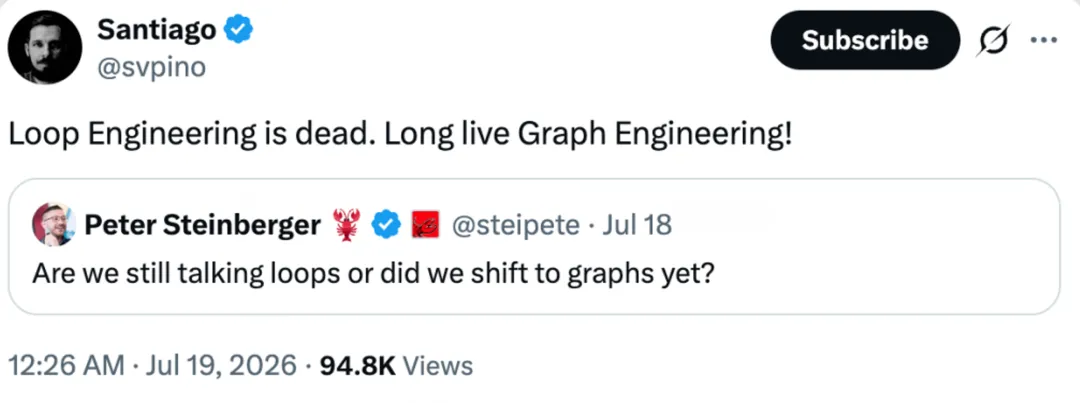
7月初,OpenClaw 创始人,在 X 上说:我们还在聊 loop,还是已经切到 graph 了?没过多久,就有人跟帖喊出「Loop Engineering 已死,Graph Engineering 永生」。
|
||||||
|
|
||||||
|
|
||||||
|
|
||||||
|
所以 Graph Engineering 到底是什么?
|
||||||
|
|
||||||
|
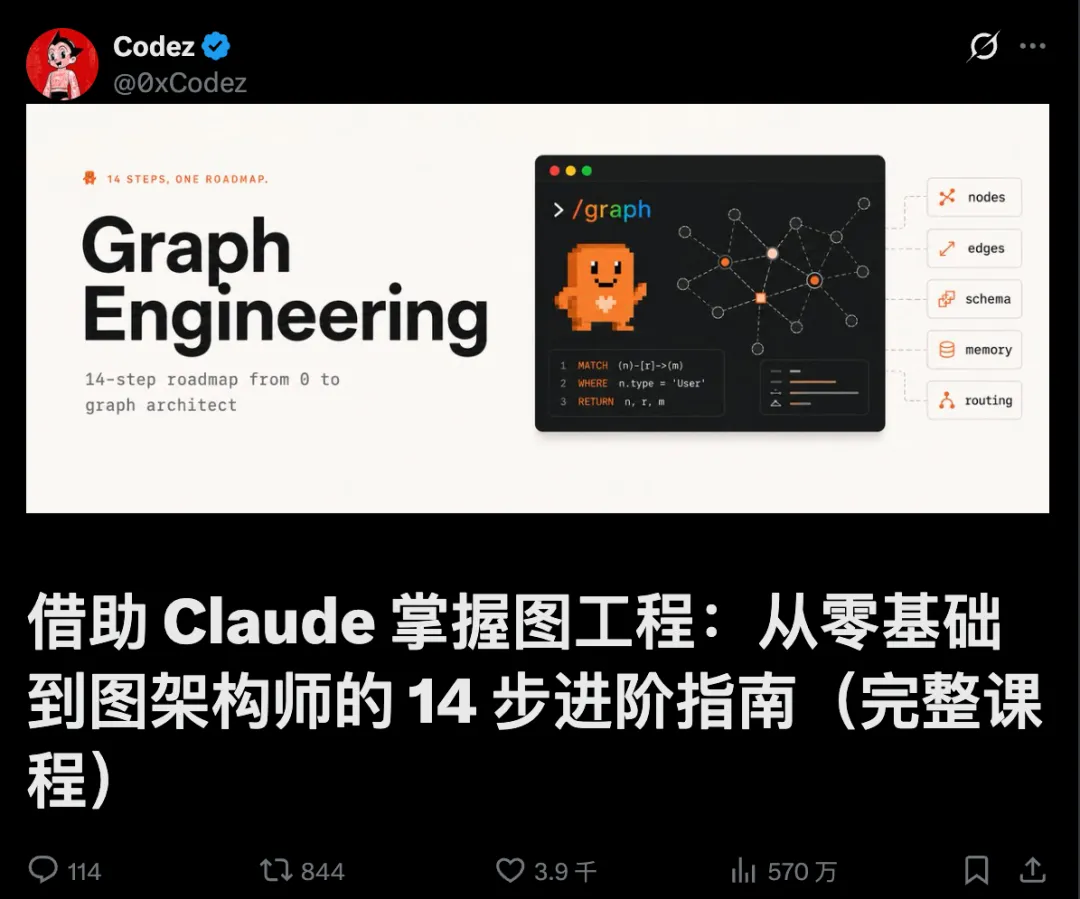
我们把 Codez 总结的 14 步整理了出来,全网570w人看过,讲的就是怎么从一个人的 loop,走到一张能自己路由的 graph。
|
||||||
|
|
||||||
|
|
||||||
|
|
||||||
|
## 动手前:四个问题,决定你要不要 Graph Engineering
|
||||||
|
|
||||||
|
Graph 不是 loop 的升级版,是 loop 的组织方式。它烧的 token 比单个 loop 更多,协调开销也更高,出了问题你要 debug 的是一整张你没亲眼看着跑的路由图。所以先问自己四个问题,都想清楚之后,再动手。
|
||||||
|
|
||||||
|
一、这个任务真的能拆成不同角色吗?拆不出清晰的"谁负责什么",那就还是一个 loop,加节点只是加成本。
|
||||||
|
|
||||||
|
二、有没有真正能并行的子任务?没有独立并行的活,图比循环贵,却不比循环快。
|
||||||
|
|
||||||
|
三、单个 agent 的上下文装得下全部背景吗?装得下,就别急着拆,拆分是为了腾出上下文,不是为了好看。
|
||||||
|
|
||||||
|
四、失败之后,你负担得起跳转分支的成本吗?没想清楚重试耗尽后去哪,图会在你看不见的地方卡死或者乱跑。
|
||||||
|
|
||||||
|
还有个附加题,比上面四个都重要:**你已经有一个跑得稳的单体 loop 了吗?**没有,先别建图。图是循环的组织方式,不是循环的替代品。
|
||||||
|
|
||||||
|
谁适合上手
|
||||||
|
|
||||||
|
已经把至少一个 loop 跑稳的团队,任务里有明确能拆开的角色(调研、撰写、复核),也接受更高的 token 成本换质量和并行度。
|
||||||
|
|
||||||
|
谁不适合上手
|
||||||
|
|
||||||
|
还没让一个 loop 稳定跑起来的个人开发者、线性依赖强拆不开的任务、瓶颈在协调开销而不在单节点能力的团队。
|
||||||
|
|
||||||
|
所以,graph engineering 真有用,但大部分人现在还用不上,因为大部分人的 loop 都还没跑稳,更别提图。
|
||||||
|
|
||||||
|
先答完四个问题,再决定要不要建图
|
||||||
|
|
||||||
|
## Graph Engineering 的四个核心构件
|
||||||
|
|
||||||
|
一张能跑的图,拆开来看,就是四个能各自单独验证的部分。
|
||||||
|
|
||||||
|
**Nodes:图的最小单位。**一个节点就是一个跑着自己 loop 的 agent 或确定性步骤,只认一件事,也只对一件事负责。节点判断不出"完了",就不是节点,是隐藏依赖。
|
||||||
|
|
||||||
|
**Edges:决定谁接下一棒。**顺序边永远触发,条件边看检查结果,并行边一次分给多个节点,再汇到一个节点合并。边留给模型运行时判断得越多,图越灵活,但也越难预判。
|
||||||
|
|
||||||
|
**Shared State:大家都要读写的那份数据。**下游节点要用的字段,必须有上游节点写进去。这个对象会逼你承认,这活儿里到底还有多少环节没被真正想清楚。
|
||||||
|
|
||||||
|
**Failure Routing:失败之后的退路。**一个节点的重试耗尽了,控制权去哪:退回上一步、转给备用节点,还是转人工。没有失败边的图,只是一张流程图,不是一个能跑的系统。
|
||||||
|
|
||||||
|
## 第一步:先分清节点和边
|
||||||
|
|
||||||
|
01 节点是任务,边负责传数据
|
||||||
|
|
||||||
|
一张图其实只有两样东西,搞清楚这两样,大部分困惑就没了。节点是一个工作单元:一个 agent,一份边界明确的活,一个输入,一个输出。边是一种依赖关系:它表示这个节点的输出会喂给那个节点做输入,仅此而已。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
最容易犯的错,是把"然后"当成边。"总结这个文件,然后告诉我天气",这两步之间没有边,天气根本用不到那份总结。这其实是两个互不相干的节点,被一段线性脚本硬凑成了先后顺序。没真用上数据,就没有边。
|
||||||
|
|
||||||
|
02 你的线性脚本,其实是一张退化的图
|
||||||
|
|
||||||
|
当你把一个 agent 写成"先做 A,再做 B,再做 C,再做 D",其实你已经画出了一张图,只不过是一条不分岔的单链,每个节点都只有一条边进、一条边出。这样跑是能跑对的,但慢,也脆,因为一条链没有任何冗余:C 卡住了,D 就永远轮不到,A 的产出也被困在上游,没地方去。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
图工程的第一项真本事,是重新画这条链。拿着这个线性 agent,对每一根箭头问上一步的那个问题。大多数链里都有两三根箭头根本没有携带数据,它们只是当初写的时候顺手打的顺序。把这些箭头剪掉,链就会塌缩成更宽的东西:几个可以同时跑的独立节点,喂给一个需要它们全部到齐的节点。
|
||||||
|
|
||||||
|
## 第二步:给节点和边定契约
|
||||||
|
|
||||||
|
03 给每个节点定一份契约
|
||||||
|
|
||||||
|
一个你没法推理的节点,就没法拿去并行。解决办法是给它定一份契约:输入有边界,输出有边界,只干一件事。输入是节点要读的东西,必须显式传进去,不能指望它从共享窗口里蹭到什么。输出是一个定义好的形状,最好能校验,这样下一个节点不用猜也能直接用。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
在 workflow 里,这份契约靠 schema 强制执行。给 Claude 的 agent() 调用配一份 JSON schema,Claude 派出去的 subagent 就只能返回校验过的结构化数据,校验发生在工具调用这一层,格式不对 Claude 会自己重试,不会甩给你一堆自由文本让你自己解析、自己祈祷。这就是"能接进图里的节点"和"只有人读得懂才行的节点"的区别。
|
||||||
|
|
||||||
|
```javascript
|
||||||
|
// 一个有真契约的节点:输入有边界,输出经过校验,只干一件事
|
||||||
|
const ITEM = {
|
||||||
|
type: 'object', additionalProperties: false,
|
||||||
|
properties: {
|
||||||
|
title: { type: 'string' },
|
||||||
|
url: { type: 'string' },
|
||||||
|
impact: { type: 'string', enum: ['high', 'medium', 'low'] },
|
||||||
|
},
|
||||||
|
required: ['title', 'url', 'impact'],
|
||||||
|
};
|
||||||
|
const result = await agent(source.prompt, {
|
||||||
|
label: `research:${source.key}`,
|
||||||
|
schema: ITEM, // 强制返回校验过的结构化数据
|
||||||
|
agentType: 'general-purpose',
|
||||||
|
});
|
||||||
|
// result 现在是下一个节点能信任的形状,不用再靠人工解析
|
||||||
|
```
|
||||||
|
|
||||||
|
04 把边也当成一份数据契约
|
||||||
|
|
||||||
|
边不只是"B 排在 A 后面",它是一个关于"传的是什么"的承诺:A 产出这个形状,B 就是照着这个形状设计来消费它的。按数据给边命名,而不是按顺序命名,两件事会立刻变简单:能一眼看出这条边是不是真的存在(有没有数据真的传过去),也能在形状不变的前提下换掉边两端的节点,不会弄坏整张图。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
实际写的时候,边就活在普通的 JavaScript 里。派活和合成之间那一步归约,压平、去重、过滤,就是代码在处理节点返回的形状,不需要 agent。图思维一个不太起眼但很重要的收获是:很多人花模型 token 去做的事,其实就是一条边,而边是免费的。
|
||||||
|
|
||||||
|
## 第三步:构建扇出、扇入与菱形:最常用的拓扑
|
||||||
|
|
||||||
|
05 用 parallel() 扇出:把活儿一次性派出去
|
||||||
|
|
||||||
|
这一步能把前面的投入都赚回来。手上有 N 个独立节点,N 个要核实的信源、N 个要审的文件、N 条要查的路由,不要把它们串起来跑,让 Claude 把它们一次性派出去一起跑。在 workflow 里对应的是 parallel():Claude 拿到一个函数数组,给每个函数派一个 subagent,全部并发执行,最后把结果数组一次性还给你。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
有两个细节决定它稳不稳。第一,parallel() 是一道屏障,会等所有函数都跑完才返回,下一阶段看到的是完整的结果集合。第二,一个抛错的函数会被解析成 null,而不是拖垮整个批次,一个状态不好的 agent 也拖累不了其他人,记得对结果做 .filter(Boolean)。并发数大致按核数封顶,多出来的会排队,扔进去一百个函数它们都会跑完,只是每次跑一小批。
|
||||||
|
|
||||||
|
```javascript
|
||||||
|
phase('Research');
|
||||||
|
// 九个信源,九个 agent,同时开工
|
||||||
|
const raw = await parallel(
|
||||||
|
SOURCES.map((s) => () =>
|
||||||
|
agent(s.prompt, {
|
||||||
|
label: `research:${s.key}`,
|
||||||
|
phase: 'Research',
|
||||||
|
schema: ITEM_SCHEMA, // 每个节点都返回校验过的 JSON
|
||||||
|
agentType: 'general-purpose',
|
||||||
|
}),
|
||||||
|
),
|
||||||
|
);
|
||||||
|
const collected = raw.filter(Boolean); // 把失败 agent 留下的 null 过滤掉
|
||||||
|
```
|
||||||
|
|
||||||
|
派活这一步是活在 Claude 写的代码里,不是活在一轮模型对话里。Claude 自己的上下文从来不会同时装着九个信源,每个 subagent 带着自己的一份,只有最终答案会传回来。这就是 Claude 能把一次 workflow 扩展到几十上百个 subagent、却不会把这次会话淹没的原因,编排这一层不花 token,因为它不是 Claude 又想了一轮。
|
||||||
|
|
||||||
|
06 在屏障处做汇入
|
||||||
|
|
||||||
|
活儿派出去,得有东西能收拢它才有意义。拢回来的这个节点,就是边汇聚的地方:一个 agent(或一段代码)一次性看到全部上游结果,去做一件必须看到全集才能做的事,比如跨信源去重、按影响力排序、总数为零就提前退出。这是整张图里唯一值得让屏障付出等待成本的地方。
|
||||||
|
|
||||||
|
```javascript
|
||||||
|
// 这条边就是普通 JS,没有 agent,零 token
|
||||||
|
const flat = collected.flatMap((c) => c.items);
|
||||||
|
log(`Collected ${flat.length} items`);
|
||||||
|
phase('Curate');
|
||||||
|
// 这个屏障节点需要全部结果凑齐才能去重排序
|
||||||
|
const curated = await agent(
|
||||||
|
`Dedupe and rank these by impact:\n${JSON.stringify(flat)}`,
|
||||||
|
{ phase: 'Curate', schema: CURATED_SCHEMA },
|
||||||
|
);
|
||||||
|
```
|
||||||
|
|
||||||
|
只是把一个列表压平?那是一条边,直接写在行内就好。判断方法很简单粗暴:如果写成了 parallel → transform → parallel,中间那个 transform 又没有跨条目的依赖,那本该用流水线,完全不需要屏障。
|
||||||
|
|
||||||
|
07 菱形:拆分 → 工作 → 合并
|
||||||
|
|
||||||
|
把"派出去"和"拢回来"拼在一起,就得到了几乎每张正经 agent 图里都会出现的主力拓扑:菱形。一个节点拆任务,多个节点并行干活,一个节点合并。市场扫描、依赖审计、代码评审、研究报告,背后都是这个形状,换个信源和提示词,同一副骨架照样能用。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
它的标准写法有个值得记住的名字:派发 → 归约 → 合成。先派出去收集广度,用普通代码归约压缩,再用最后一个 agent 合成写出答案。看懂这颗菱形之后,就不会再问"怎么让 agent 多做几步",而是会问"拆分点在哪,合并点在哪",这才是真正能扩展的问题。
|
||||||
|
|
||||||
|
## 第四步:路由、验证与隔离
|
||||||
|
|
||||||
|
08 用条件语句在运行时给边选路
|
||||||
|
|
||||||
|
不是每张图都是固定的。有时候走哪条边,取决于某个节点发现了什么。路由节点检查结果,决定走哪条下游路径:给工单分类后分流到对应处理节点,或者看 diff 大小,决定走快速评审还是完整审计。在 workflow 里这就是一个普通的 if 或 switch,判断依据是某个节点校验过的输出,因为控制流本来就活在代码里。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
这正好是确定性变成优点而不是限制的地方。路由的判断可以由 Claude 完成(一个 subagent 负责分类),但路由本身是 Claude 写的代码,同样的分类结果每次都走同一条路。节点上拿到 Claude 的判断力,边上拿到脚本的可靠性,不会出现"Claude 自己决定跳过审计"这种意外,因为跳过这件事必须写进图里才会发生,而它没有被写进去。
|
||||||
|
|
||||||
|
```javascript
|
||||||
|
// 路由节点:agent 负责分类,代码负责选边
|
||||||
|
const { severity } = await agent(
|
||||||
|
`Classify this diff's risk:\n${diff}`,
|
||||||
|
{ schema: { type: 'object',
|
||||||
|
properties: { severity: { enum: ['low', 'high'] } },
|
||||||
|
required: ['severity'] } },
|
||||||
|
);
|
||||||
|
let review;
|
||||||
|
if (severity === 'high') {
|
||||||
|
// 高风险路径:完整并行审计
|
||||||
|
review = await parallel(FILES.map((f) => () => agent(`Audit ${f}`)));
|
||||||
|
} else {
|
||||||
|
// 低风险路径:一次快速评审
|
||||||
|
review = await agent(`Quick review of ${diff}`);
|
||||||
|
}
|
||||||
|
```
|
||||||
|
|
||||||
|
09 在边上放一个验证器
|
||||||
|
|
||||||
|
一张图真正的杠杆不是塞了更多 agent,而是能围绕结果搭起多少确定性。验证器节点蹲在一个结果被放行到下游之前,它唯一的工作就是试图推翻这个发现。扛住了就放行,扛不住就到不了最终答案。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
三种模式值得掌握:
|
||||||
|
|
||||||
|
- **对抗式验证:**给每个发现派 N 个独立的怀疑者,专门去反驳它,多数没被驳倒才算站得住。
|
||||||
|
- **多视角验证:**让每个验证者盯不同的方面,正确性、安全性、能不能复现,角度越分散,越能揪出 N 个一样的检查都发现不了的问题。
|
||||||
|
- **评委制:**从不同角度生成 N 个方案,用并行的评委打分,挑最好的一版作为主线,再把其他几版里的亮点揉进去。
|
||||||
|
|
||||||
|
真实团队在移植 Bun 运行时的时候,就是靠这套对抗式代码评审焊进循环,才做成的。
|
||||||
|
|
||||||
|
10 把节点隔离开,别让一个失败污染整张图
|
||||||
|
|
||||||
|
在一条链里,失败会级联:C 死了,D 就跑不起来,整条链停摆。在一张图里,失败本该被限制在它自己的节点里。这一点已经部分成立:parallel() 里一个抛错的函数会被解析成 null,八个正常的 agent 照样能返回结果,一个坏的自己掉队,.filter(Boolean) 就是那道防线。把每一次汇入都设计成能容忍缺失的输入,而不是假设总能凑齐全集。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
更隐蔽的失败,是节点之间互相踩到对方。多个 agent 并行写文件时可能会撞车,解法是隔离:用 git worktree,让每个 agent 在自己的一份工作区里干活,在沙盒里完成,再干净地合并回去。只在节点真的会并行写入的时候才用它,它是那种拓扑真正需要的安全带,不是每次运行都要交的税。
|
||||||
|
|
||||||
|
## 第五步:循环、模型分层与拓扑
|
||||||
|
|
||||||
|
11 可以加一个循环,但一定要让它收敛
|
||||||
|
|
||||||
|
要是压根不知道这活儿有多大呢?只有真的做下去才知道:规模未知的探索,一次漏洞排查发现一个 bug 又带出三个新的。这时候需要一个循环,一条指回更早节点的、受控的边。危险也很明显:一个不收敛的循环,就是一台不停派 agent 出去、直到预算耗尽才停的死循环机。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
能收敛的写法叫"跑到干为止":持续派出发现者,直到连续 K 轮都没发现新东西,才停下来。真正决定成败的细节,也是几乎每个人第一次都会踩的坑,是拿什么去做去重比对。要对着"见过的一切"去重,而不是只对着"已确认的结果"去重。不然被否掉的发现每一轮都会重新冒出来,循环永远跑不干,最后搭出的是一台专门花钱去反复发现同一批死胡同的机器。
|
||||||
|
|
||||||
|
```javascript
|
||||||
|
const seen = new Set();
|
||||||
|
const confirmed = [];
|
||||||
|
let dry = 0;
|
||||||
|
while (dry < 2) { // 连续两轮空手而归就停下
|
||||||
|
const found = (await parallel(
|
||||||
|
FINDERS.map((f) => () => agent(f.prompt, { schema: BUGS }))
|
||||||
|
)).filter(Boolean).flatMap((r) => r.bugs);
|
||||||
|
const fresh = found.filter((b) => !seen.has(key(b)));
|
||||||
|
if (!fresh.length) { dry++; continue; }
|
||||||
|
dry = 0;
|
||||||
|
fresh.forEach((b) => seen.add(key(b))); // 对"见过的一切"去重,不是只对已确认的
|
||||||
|
// 每个新发现都要过一轮多视角验证才算数
|
||||||
|
const judged = await parallel(fresh.map((b) => () =>
|
||||||
|
parallel(['correctness', 'security', 'repro'].map((lens) => () =>
|
||||||
|
agent(`Judge "${b.desc}" via ${lens} — real?`, { schema: VERDICT })))
|
||||||
|
.then((v) => ({ b, real: v.filter(Boolean).filter((x) => x.real).length >= 2 }))));
|
||||||
|
confirmed.push(...judged.filter((v) => v.real).map((v) => v.b));
|
||||||
|
}
|
||||||
|
```
|
||||||
|
|
||||||
|
12 给不同节点分配不同档位的模型
|
||||||
|
|
||||||
|
不是每个节点都需要最好的模型。一张图会用单个 agent 永远做不到的方式,把这件事摆明白:有些节点干的是有边界、会重复的活,比如抽取一个字段、给工单分类;有些节点承载真正的判断力,比如合成报告、裁定一个发现是否成立。干重复活的节点放到便宜模型上跑,token 留着花在真正需要判断力的地方。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
在 workflow 里,Claude 派出去的每个 subagent 默认继承这次会话的模型,除非脚本里显式覆盖,所以默认情况下一次大规模运行的账单会全按会话档位算。单次 agent() 调用上的 model 选项,能让 Claude 单独把这一个节点换到别的模型上跑。大规模运行前先看一眼 /model,让 Claude 把派出去的那些重复性节点降到便宜模型,合并节点留在高档位,这个办法能把一张烧 token 的图从贵变便宜,还完全不用动它的形状。
|
||||||
|
|
||||||
|
13 拓扑结构,就是你的成本和延迟
|
||||||
|
|
||||||
|
图的形状不是装饰,它是决定运行时间的最大杠杆。最容易踩坑的选择是 parallel() 还是 pipeline()。parallel() 这道屏障会让所有东西都等最慢的那个节点,才进入下一阶段。pipeline() 让每条数据各自独立地依次经过所有阶段,没有屏障,条目 A 可能已经在第三阶段了,条目 B 还在第一阶段,跑得快的提前结束,不用在慢的后面干等。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
默认用 pipeline()。只有一个阶段真的需要全部前置结果同时到齐时才用屏障,比如跨集合去重、按总数提前退出、需要对照"其他发现"来写的 prompt。"代码更干净"和"这些阶段感觉是分开的"都不是理由,屏障带来的延迟是真实的、可测量的、被浪费掉的时间,分开不代表必须同步。
|
||||||
|
|
||||||
|
## 最后一步:让 Claude 自己画图
|
||||||
|
|
||||||
|
14 让 Claude 自己画图,自我路由
|
||||||
|
|
||||||
|
最后一步,是对那些没法提前规划的活儿,不再自己动手画图。用 dynamic workflows,只要描述目标,Claude 会自己写编排脚本:拆解任务、决定怎么把活儿派出去、派出一队 subagent、再合成结果。拿到的是一张为这次运行量身定做的图,而不是一张你希望它恰好合适的固定图。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
有三种用法。在 prompt 里说出"workflow"这个词,Claude 就会为这个任务写一份。跑一个已经存好或内置的,比如 /deep-research,就是一张已经在生产里跑着的真实图:定范围 → 并行搜索 → 抓取 → 对抗式验证 → 合成,正是这门课从头到尾讲的那副骨架。或者打开 ultracode,Claude 会给这次会话里每个像样的任务都规划一次 workflow。跑得好的时候按 s 把脚本存进 .claude/workflows/,从此可以版本控制、按名字重新运行,谁 clone 了这个仓库都能直接跑起来。
|
||||||
|
|
||||||
|
```
|
||||||
|
› Run a workflow to audit every route under src/routes/ for missing
|
||||||
|
auth. Spawn one agent per route file, then verify each finding before
|
||||||
|
reporting.
|
||||||
|
|
||||||
|
● Claude wrote an orchestration script · launching in background…
|
||||||
|
|
||||||
|
/workflows — auth-audit · running
|
||||||
|
✓ Scope 1/1 2.1k tok
|
||||||
|
Fan-out 18/18 one agent per route file
|
||||||
|
Verify 11/18 3-vote skeptics per finding…
|
||||||
|
Synthesize 0/1 waiting on verify
|
||||||
|
|
||||||
|
// 会话保持响应,队伍在后台继续跑
|
||||||
|
```
|
||||||
|
|
||||||
|
两年来,多 agent 协作的杠杆一直在单个 loop 上:更好的 verifier,更稳的退出条件,更干净的状态文件。
|
||||||
|
|
||||||
|
而现在,把这些 loop 怎么连起来,成了新的护城河。
|
||||||
|
|
||||||
|

|
||||||
@@ -0,0 +1,80 @@
|
|||||||
|
# 📊 文章摘要:重磅!Graph Engineering 实操手册公开
|
||||||
|
|
||||||
|
> **原文**:[2026-08-20_重磅_Graph_Engineering_实操手册公开](./2026-08-20_重磅_Graph_Engineering_实操手册公开.md)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/GZrKCHJaG5g7Ua-ZiEP-fQ
|
||||||
|
> **来源**:微信公众平台
|
||||||
|
> **作者**:Datawhale(原作者:Codez,X 博主)
|
||||||
|
> **发布日期**:2026-08-20
|
||||||
|
> **摘要日期**:2026-08-20
|
||||||
|
> **价值评级**:⭐⭐⭐ 高
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 核心命题
|
||||||
|
|
||||||
|
> **图即组织** — Graph 不是 loop 的升级版或替代品,而是 loop 的组织方式;把多 Agent 协作从单个循环的优化转向图拓扑的设计,是新的护城河。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 文章概要
|
||||||
|
|
||||||
|
本文是 Datawhale 对 X 博主 Codez 所总结"Graph Engineering 14 步"的中文整理,回应"Loop Engineering 已死,Graph Engineering 永生"的舆论,系统讲解如何从单个 agent loop 走到一张能自我路由的多 Agent 图。内容覆盖动手前的四个自检问题、图的四构件(节点/边/共享状态/失败路由)、节点与边的数据契约、扇出扇入与菱形拓扑、验证器三模式、收敛循环、模型分层与 parallel/pipeline 选型,并附可直接复用的 JavaScript 代码。价值在于把图论概念转译为一组可操作、可验证的工程判断(如"没传数据就没有边""边是免费的");局限是围绕 Claude Code workflow 特定 API 展开,且"14 步"的划分带有课程营销色彩,部分结论为个人工程经验未经系统验证。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 关键要点
|
||||||
|
|
||||||
|
1. **动手前四问 + 附加题** — 任务能否拆角色、有无真并行、单 Agent 上下文是否装得下、失败跳转成本是否负担得起;核心附加题是"你是否已有跑得稳的单体 loop",没有就先别建图。 `[分类: 共识]`
|
||||||
|
2. **图不是 loop 的升级版,是组织方式** — 图烧更多 token、协调开销更高、debug 对象是整张没亲眼看着跑的路由图,大部分人现在用不上。 `[分类: 范式突破]`
|
||||||
|
3. **四构件** — Nodes(只对一件事负责的最小单位)、Edges(决定接棒者)、Shared State(逼你想清未明环节)、Failure Routing(重试耗尽后的退路);没有失败边的图只是流程图。 `[分类: 共识]`
|
||||||
|
4. **"然后"不是边** — 没有真正传递数据的两步是互不相干的节点被线性脚本硬凑;线性脚本是一张退化的单链图,剪掉不携数据的箭头,链会塌缩成可并行的更宽结构。 `[分类: 范式突破]`
|
||||||
|
5. **节点与边都是数据契约** — 节点输入输出有边界、schema 校验发生在工具调用层;边按数据命名而非按顺序命名;很多人花模型 token 做的事其实是一条边,而边(普通代码)是免费的。 `[分类: 共识]`
|
||||||
|
6. **菱形是主力拓扑** — 派发(parallel 扇出收集广度)→ 归约(普通代码压缩)→ 合成(最后的高档位 agent 写答案);parallel 是屏障等最慢者,默认应选无屏障的 pipeline。 `[分类: 共识]`
|
||||||
|
7. **验证器三模式** — 对抗式验证(N 个怀疑者反驳)、多视角验证(各盯一个方面)、评委制(并行打分择优融合);Bun 运行时移植团队靠对抗式代码评审焊进循环做成。 `[分类: 共识]`
|
||||||
|
8. **收敛循环的去重对象** — "跑到干为止"的循环必须对"见过的一切"去重而非只对"已确认的结果",否则被否掉的发现每轮重冒,循环永不收敛。 `[分类: 共识]`
|
||||||
|
9. **模型分层与失败隔离** — 重复性节点降档到便宜模型、判断力节点留高档位;一个抛错函数解析为 null 不拖垮批次,.filter(Boolean) 与容忍缺失输入是设计原则;并行写入用 git worktree 隔离。 `[分类: 共识]`
|
||||||
|
10. **Dynamic workflows 让 Claude 自己画图** — 对无法提前规划的任务,Claude 自写编排脚本、自我路由,脚本可存入 .claude/workflows/ 版本化复用。 `[分类: 未探索]`
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 批判性分析
|
||||||
|
|
||||||
|
### 假设前提
|
||||||
|
- 默认读者使用 Claude Code 的 workflow/agent()/parallel() API,跨平台迁移需转译概念(等价物存在于其他编排框架,但代码不可直接复用)。
|
||||||
|
- 预设"编排层零 token"成立——即编排脚本由 Claude 一次性写出后可靠执行,未讨论脚本本身出错时的调试成本。
|
||||||
|
- 以"loop 已跑稳"为前提门槛,隐含读者已过单 Agent 工程化阶段。
|
||||||
|
|
||||||
|
### 论据与逻辑
|
||||||
|
- 逻辑链条清晰:从"要不要建图"的否决性自检,到构件、契约、拓扑、验证、收敛,层层递进,且每步给出判断标准(如屏障 vs 流水线的选择判据)。
|
||||||
|
- Bun 运行时移植是真实案例锚点;但"全网570w人看过"等表述是传播数据而非效果证据,"几乎每个人第一次都会踩的坑"属经验断言。
|
||||||
|
- "边是免费的"在编排代码确定性成立的前提下为真,但忽略了写这些代码本身的工程时间成本。
|
||||||
|
|
||||||
|
### 边界与局限
|
||||||
|
- 未给出图规模上限(几十上百个 subagent 的经验阈值)与成本量级数据。
|
||||||
|
- 对 Shared State 的并发写冲突仅以 git worktree 一笔带过,状态机设计细节缺失。
|
||||||
|
- 未讨论图的测试与回归方法(何时重跑整图、如何做局部回归)。
|
||||||
|
- 摘要者推断:14 步中约半数是 Claude workflow 产品功能介绍而非通用图工程方法,读者需自行区分。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 可引用金句
|
||||||
|
|
||||||
|
> "Graph 不是 loop 的升级版,是 loop 的组织方式。"
|
||||||
|
|
||||||
|
> "没有失败边的图,只是一张流程图,不是一个能跑的系统。"
|
||||||
|
|
||||||
|
> "很多人花模型 token 去做的事,其实就是一条边,而边是免费的。"
|
||||||
|
|
||||||
|
> "两年来,多 agent 协作的杠杆一直在单个 loop 上:更好的 verifier,更稳的退出条件,更干净的状态文件。而现在,把这些 loop 怎么连起来,成了新的护城河。"
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 总体评价
|
||||||
|
|
||||||
|
**亮点**:把图工程从概念转译为一组可执行的工程判断,每个判断都给出判据;"没传数据就没有边""对见过的一切去重"等坑点提炼精准;代码示例可直接套用;开篇的否决性自检(四问+附加题)体现了少见的克制。
|
||||||
|
|
||||||
|
**不足**:强绑定 Claude Code workflow API;无成本与规模量化数据;Shared State 与图级测试着墨不足;标题与"570w人看过"等表述营销味较重。
|
||||||
|
|
||||||
|
**适用场景**:多 Agent 编排系统设计与重构评审;判断团队是否该从单 Agent 升级到图拓扑的决策检查;Claude Code workflow/subagent 的实战入门。
|
||||||
|
|
||||||
|
**关联建议**:与《企业内Agent工具落地实践》对照——本文解决单任务内部的编排图,该文解决企业层的运行时与治理,两层可组合成完整 Agent 工程视图;"验证器三模式"可移植到本院 skill 评测体系建设;收敛循环的"见过的一切去重"对爬虫/情报收集类 Agent 有直接参考价值。
|
||||||
@@ -0,0 +1,22 @@
|
|||||||
|
# 政策分析报告|当前AI对国内外就业产生的冲击及应对建议
|
||||||
|
|
||||||
|
> **来源**:微信公众平台(GIG)
|
||||||
|
> **作者**:GIG
|
||||||
|
> **发布日期**:2026-08-20(原文未标注明确日期,按下载日占位;报告正文注明"本报告写于2026年5月")
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/qgQSauWUn1OIA1TwEirv0w
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
|
||||||
|
|
||||||
|
广州粤港澳大湾区研究院(GIG)立足湾区,服务国家,面向未来。研究院由著名学者郑永年教授担任理事长。
|
||||||
|
|
||||||
|
本报告写于2026年5月
|
||||||
|
|
||||||
|
当前,人工智能的爆炸式快速增长对全球劳动力市场的影响,已不再只是停留在理论讨论或趋势预测中,而正实实在在地改变就业结构。最新关于"AI裁员陷阱"的模型研究显示,当企业通过AI替代劳动者时,虽然单个企业能够享受人力成本下降的收益,但失业和收入下降造成的需求损失却由整个社会承担。AI首先冲击的是初级白领岗位以及大量"入门型"职业。这些岗位原本是年轻人进入专业领域、积累经验、向上流动的重要通道,如今,这些通道被AI不断压缩,甚至被直接替代,可能导致人才培养链条出现断层,也会加剧未来的人力资本风险。更值得警惕的是,过度依赖AI可能让人类逐渐丧失独立思考、判断和学习的能力,形成所谓的"人工智残"现象。如果这种趋势继续发展,社会可能会越来越依赖少数掌握资本、算力和平台资源的群体,普通人则被动接受技术系统的安排,最终滑向一种被管理、被驯化的"牧民社会"。我们需要在发展与安全之间进行统筹安排,短期采取相应措施整治存量"内卷"并建立就业缓冲机制,依托大科创体系重塑产教融合,长期则需通过颠覆性的教育改革与高水平的开源开放战略,以"新质生产力"创造海量增量经济空间,实现技术红利与高质量就业的动态平衡。
|
||||||
|
|
||||||
|
★GIG智库产品面向政府、高校、企业等机构用户,如需了解本报告完整版或本系列报告获取途径,请在公众号后台留言:机构名称-姓名-职务-工作邮箱。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
广州粤港澳大湾区研究院是"民间性质、官方支持、非营利性"的研究机构。研究院秉承独立、客观、有效的核心价值理念,汇聚海内外具有"国际视野,中国情怀"的学者和实践者,扎根真实世界,积极回应转型中国的重大政治、经济与社会问题,致力于知识创新和专业的政策研究,为政府、企业和社会组织提供政策咨询和解决方案。
|
||||||
@@ -0,0 +1,68 @@
|
|||||||
|
# 📊 文章摘要:政策分析报告|当前AI对国内外就业产生的冲击及应对建议
|
||||||
|
|
||||||
|
> **原文**:[2026-08-20_政策分析报告_当前AI对国内外就业产生的冲击及应对建议](./2026-08-20_政策分析报告_当前AI对国内外就业产生的冲击及应对建议.md)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/qgQSauWUn1OIA1TwEirv0w
|
||||||
|
> **来源**:微信公众平台
|
||||||
|
> **作者**:GIG(广州粤港澳大湾区研究院,理事长郑永年)
|
||||||
|
> **发布日期**:2026-08-20(报告正文注明写于 2026 年 5 月)
|
||||||
|
> **摘要日期**:2026-08-20
|
||||||
|
> **价值评级**:⭐⭐ 中
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 核心命题
|
||||||
|
|
||||||
|
> **AI裁员陷阱** — 单个企业以 AI 替代劳动者时享受人力成本下降的收益,而失业与收入下降造成的需求损失由整个社会承担,就业冲击具有负外部性。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 文章概要
|
||||||
|
|
||||||
|
本文是广州粤港澳大湾区研究院(GIG,郑永年任理事长)2026 年 5 月政策报告的公众号摘要版(完整版需机构身份留言获取),仅一段约 700 字的核心观点浓缩。报告提出三层判断:AI 已实际改变就业结构,首当其冲的是初级白领与"入门型"职业,年轻人向上流动通道被压缩,人才培养链条面临断层风险;过度依赖 AI 可能导致"人工智残",社会或滑向少数人掌控资本/算力/平台、大众被管理驯化的"牧民社会";对策上短期整治"内卷"并建立就业缓冲机制、中期依托大科创体系重塑产教融合、长期以颠覆性教育改革与高水平开源开放战略创造增量经济空间。作为智库政策视角的样本有价值,但摘要版无数据、无论证细节,结论的警示性表述强于实证支撑。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 关键要点
|
||||||
|
|
||||||
|
1. **AI 裁员陷阱的负外部性结构** — 引"最新模型研究":企业得私利、社会担需求损失,构成 AI 替代就业的市场失灵论证基础(原文未给出研究出处)。 `[分类: 争议]`
|
||||||
|
2. **冲击对象是初级白领与入门型职业** — 这些岗位原是年轻人进入专业领域、积累经验的通道,通道被压缩将导致人才培养链条断层与人力资本风险。 `[分类: 共识]`
|
||||||
|
3. **"人工智残"警示** — 过度依赖 AI 可能使人类逐渐丧失独立思考、判断和学习的能力。 `[分类: 争议]`
|
||||||
|
4. **"牧民社会"终极担忧** — 社会将依赖少数掌握资本、算力和平台资源的群体,普通人被动接受技术系统安排、被管理被驯化。 `[分类: 争议]`
|
||||||
|
5. **三段式政策处方** — 短期:整治存量"内卷"+就业缓冲机制;中期:大科创体系重塑产教融合;长期:颠覆性教育改革+高水平开源开放战略,以"新质生产力"创造增量空间,实现技术红利与高质量就业动态平衡。 `[分类: 未探索]`
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 批判性分析
|
||||||
|
|
||||||
|
### 假设前提
|
||||||
|
- 默认 AI 的替代效应是就业冲击的主导机制,未讨论增强/互补效应与 AI 创造的新岗位(历史上技术革命的双向效应)。
|
||||||
|
- "入门岗位消失→人才断层"是线性外推,未考虑培训方式转型(如 AI 辅助在岗学习)对通道的替代性重建。
|
||||||
|
|
||||||
|
### 论据与逻辑
|
||||||
|
- 摘要版为纯观点浓缩:核心论据"AI裁员陷阱"的模型研究未注明作者、机构与结论条件;全文无一处量化数据。
|
||||||
|
- "人工智残""牧民社会"等概念有传播力但属规范性修辞,从"依赖 AI"到"被驯化社会"的推演链条缺少中间论证。
|
||||||
|
- 政策建议(教育改革、开源开放)与问题诊断(就业结构冲击)之间的因果机制未展开——这可能是完整版的内容,摘要版无法验证。
|
||||||
|
|
||||||
|
### 边界与局限
|
||||||
|
- 这是报告的营销摘要而非报告本身,完整版获取设有机构门槛,可核查性低。
|
||||||
|
- 立场为政府咨询导向(发展与安全统筹),天然倾向警示与干预叙事。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 可引用金句
|
||||||
|
|
||||||
|
> "当企业通过AI替代劳动者时,虽然单个企业能够享受人力成本下降的收益,但失业和收入下降造成的需求损失却由整个社会承担。"
|
||||||
|
|
||||||
|
> "当今人类正处于AGI的前夜。但'前夜'不等于'黎明'。"
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 总体评价
|
||||||
|
|
||||||
|
**亮点**:负外部性框架为理解 AI 就业冲击提供了清晰的经济学前置;"入门岗位=人才通道"视角切中要害;政策分层(短中长期)结构完整。
|
||||||
|
|
||||||
|
**不足**:摘要版零数据、零引用;概念警示性强于论证;完整版不可得使全部结论不可验证。
|
||||||
|
|
||||||
|
**适用场景**:了解官方智库对 AI 就业议题的定调口径与政策话语(内卷整治/产教融合/新质生产力);引用"AI 裁员陷阱"外部性论述时的原始出处线索。
|
||||||
|
|
||||||
|
**关联建议**:与《FDE 在中国火了》(IDC中国)互补阅读——一者宏观警示 AI 对就业结构的冲击,一者微观展示 AI 服务交付新岗位(FDE)的兴起,合观可见就业结构"消失与新增并存"的全貌。
|
||||||
@@ -0,0 +1,162 @@
|
|||||||
|
# 文章背后 | 漂:聚焦城市新移民
|
||||||
|
|
||||||
|
> **来源**:微信公众平台(Geores)
|
||||||
|
> **作者**:Geores
|
||||||
|
> **发布日期**:2026-08-20(原文未标注明确日期,按下载日占位)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/gPvUj751Gz-G70_DWMl3UQ
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
在中国地理学会副秘书长、中国地理学会编辑出版工作委员会副主任、中国科学院地理资源所学术期刊中心常务副主任、《地理学报》专职副主编**何书金研究员**的指导下,中国地理资源期刊微信公众平台**近期创意推出"文章背后"专栏**,从作者、读者、审稿人、评论人、编辑等多元视角,着力挖掘各个期刊刊文背后不为人知的感人故事,诚邀您的投稿。
|
||||||
|
|
||||||
|
联系方式:朱晓华
|
||||||
|
|
||||||
|
E-mail:geores@igsnrr.ac.cn
|
||||||
|
|
||||||
|
电话:010-64889584
|
||||||
|
|
||||||
|
|
||||||
|
|
||||||
|
**本期嘉宾**
|
||||||
|
|
||||||
|
**李志刚**,武汉大学城市设计学院院长,教授,博导,中国地理学会城市地理专业委员会副主任,中国城市规划学会城乡治理与政策研究学术委员会副秘书长,中国城市规划学会理事、学术工作委员会委员,湖北省城乡规划学会副理事长,美国Urban China Research Network副主任委员。曾先后担任中国地理学会青工委副主任委员、中山大学城市化研究院副院长以及广东省城市化与地理环境空间模拟重点实验室副主任等职务。
|
||||||
|
|
||||||
|
近年在国内外城市地理、城市研究、城市规划领域发表文章140多篇,其中SSCI收录40多篇。参与国内外10多部书籍编写,出版中文专著3部。主持国家自然科学基金项目5项,参与国际和省部级科研项目10多项。主持国家自然科学基金"优秀青年基金",入选教育部"新世纪"人才、广东省高等学校"千百十人才培养工程"、湖北省"楚天学者"特聘教授,曾先后获得中国地理学会"第十一届青年地理科技奖"、中国城市规划学会"首届中国城市规划青年科技奖"、中国地理学会"中国城市地理优秀论文奖"一等奖、"第二届吴传钧人文与经济地理优秀论文奖"一等奖,南京大学规划校友会"卓越青年奖",并连续入选Elsevier"中国高被引学者" (2014-2017年连续四年)。曾为英国伦敦大学学院(UCL)巴特莱规划学院访问教授,兼任曼彻斯特大学Manchester Urban Institute国际委员、教育部人文社会科学重点研究基地华东师范大学中国现代城市研究中心学术委员会委员、上海同济城市规划设计研究院城市与社会研究中心学术委员会委员、武汉市第十四届人大常委会咨询专家等。
|
||||||
|
|
||||||
|
主要研究方向为中国城市社会地理,目前的主要研究兴趣为移民聚居区、农民工回流及建成环境对城乡居民健康和感知方面的影响。担任国际期刊《Urban Studies》中国编辑(2012-2015)和国际编委(2016至今),担任《Urban Affairs Review》、《Environment and Planning A》、《International Journal of Urban and Regional Research》、《The China Quarterly》、《Transactions of the Institute of British Geographers》、《Journal of Urban Affairs》、《地理学报》、《地理研究》、《城市规划》等国内外高水平期刊的审稿专家。
|
||||||
|
|
||||||
|
**本期"文章背后",听李志刚教授讲述他从事城市新移民研究的故事,与大家一起分享。**
|
||||||
|
|
||||||
|
**朱晓华**
|
||||||
|
|
||||||
|
中国地理资源期刊微信平台总编室
|
||||||
|
|
||||||
|
应朱晓华老师的热情邀请,需要完成这篇"文章背后"以"漂"命名的命题作文。这样的题目,说明朱老师对我和我干的活非常了解,加上他顺带赠送给了我他在商务印书馆的新著——《生命由自己把握》,形成一种无形的动(压)力,使我只能加班加点,完成以下的叙述(此处有呵呵,其实我本人也非常乐意写作一点文字,以与同仁分享)。
|
||||||
|
|
||||||
|
我的履历非常简单:出生在湖北天门市岳口镇,一个地图上都不太能看清的地方,如果没听说过一点也不奇怪,一个普通家庭,父母都是普通工人;上大学离开家乡,读完博士回国工作,一直在同一个大学——中山大学工作了十年,最近回到了湖北武汉,在武汉大学工作了三年多。时间过的真快。每次填写干部履历表,职业栏的填写都很容易,没有太多好写。如果回首往事,也就似乎没什么好写。仔细想想,觉得自己属于比较典型的小镇青年,运气较好地出生在70年代末的中国,等到1998年我从大学毕业,已经开始目睹这个国家的巨变和腾飞。2001年留学回国工作,当时的广州正在房价剧增的前夜,上海、北京、深圳的房价大涨也只是刚刚起步,所以我很幸运地早早"买楼",所以,也没有感觉太大的生活压力。当然,也是向同事们借一些、银行贷一些,好在负担不重。也许,运气一直伴随着我吧。
|
||||||
|
|
||||||
|
**我的大学**
|
||||||
|
|
||||||
|
置身于城市地理研究领域,我把自己定位在中国城市研究。但在1998年以前,作为大学里一名普通的建筑系城市规划专业的学生,我其实完全不知道将来该去做什么,也并不清楚未来的道路何去何从。城市地理、城市研究这些,更是十分遥远。小镇同学在武大读书的不少,多是物理、通信、经济之类专业,如我这样读工程、设计专业的很少。亲戚中有几位在家乡做建筑设计,影响我选择了相近专业,以便将来"能有一碗饭吃"。同学们多数延续了高中的节奏,理科、数学、考试。而我对绘画、设计、艺术表达这些东西,内心更多的是不解与抗拒,老师所说的灵感和天赋,只是让我更加困惑。类似很多来自小地方的迷茫的年轻人一样,我花了很多时间去阅读名人传记、参加数学竞赛,苦闷地寻找着未来的方向。在这期间,对我影响很大的,是经常聚会的一对双胞胎同乡,保送武大物理系的两兄弟早就立志出国,进入大学后更是夜以继日地学英语、听英语。同班同学中也有类似情况,TOEFL、GRE的考试十分热门(也许今天依然如此)。这些现象,使得我也心生出国的念头,偶尔在学校图书馆翻看英文杂志,想象着遥远世界的模样。由于家庭条件所限,我在高中二年级才第一次到过本省的大城市武汉,省外更是完全没有去过。可能由于这样的原因,我对外面的世界有着强烈的向往。这种向往,当然也应该蕴含了孤独的小镇青年追求认同的渴望,出国在当时无疑是比较"酷"的。不过,真的出国是在我从南京大学城市资源学系的人文地理专业硕士研究生毕业之后的事了。
|
||||||
|
|
||||||
|
**南大研究生阶段**
|
||||||
|
|
||||||
|
1998年的就业形势不妙,规划专业不好找工作。由于当时的武大并没有规划专业的硕士点,我决定考研,目标是南京大学。当时的想法,完全不是专业上的考虑,首先是要去一个更好的大学。当年南大开国内SCI之风,影响很大,绝对是青年学子们向往的地方。艰苦的准备考研,幸运的考上了,而且更幸运的成为学界泰斗崔功豪先生的学生。当时的南大,对硕士生毕业已经有了严格的发表文章的要求。作为一名传统设计训练模式培养出来的规划专业学生,我也生平第一次面对"科研文章"这样一个新鲜事物。记得当时在南大图书馆查阅英文期刊数据库,界面不大友好,也不知具体该如何查找,试了几下就放弃了。南大三年,深感这所百年名校的优势在于优良的学风、勤奋和严谨。教学楼在周末和假期也很难找到自习的地方,"人满为患",到处是埋头苦读的人。除了大师级的老师如崔老师、顾朝林教授、林炳耀教授、周怡教授等,很多学长如张京祥、甄峰等,都给我留下了深刻印象,对我有各方面的影响和帮助,持续至今。南大的出国氛围更加浓厚,研究生宿舍弥漫着Offer的气息:出国读博几乎是当时每个人的理想。我也置身其中,并且幸运的拿到了英国的ORS奖学金,得以在毕业后去英国南安普敦大学地理系读博士。不过,当时并不知道出国以后到底要读一个什么样的博士,PhD该做什么更是几乎毫无概念。去南安以前,只和未来导师吴缚龙教授(当时还是讲师)在南京汽车站匆匆见过一面。现在想来,当年的吴老师其实比我现在还要年轻好几岁。小镇青年要出国了!记得出发前,家里大摆宴席,来了很多亲戚朋友,还在镇上电视台点播了流行歌曲和港产电影,字幕依次排出热烈祝贺某某某赴英国就读博士云云(呵呵,好喜庆)。
|
||||||
|
|
||||||
|
**博士阶段的研究**
|
||||||
|
|
||||||
|
从北京飞伦敦是我第一次坐飞机。现在还可以清楚记得那个寒冷的冬夜,吴老师开车在南安汽车站接我到宿舍的情景。他还带了访问学者们留下的锅碗瓢盆给我。留学四年,我的研究生涯才真正开始了。我的学术生涯乃至整个人生的幸运值,也由此开始爆表。作为南大和港大着力培养的、在国际上最具潜力的中国城市研究的青年学者,吴老师给予了我学术上全方位的悉心指引和关怀,他的认真仔细、严谨踏实和勤奋努力感染了我,也激发了我对研究工作的兴趣和热忱。与同门何深静、刘玉亭伉俪,同宿舍的魏严正(前年已经故去)、邓军博士,在一次次茶余饭后的交流中,也潜移默化地提升了我的认知能力和学术水平。吴老师手上有一些国内的人口普查数据,我一直在帮他处理。我们发现,这些数据,可以用来实证芝加哥学派早期所开创的城市生态学研究,国际上的工作很多,中国的除了广州和南京,其他地方的研究基本还没有展开。加上和当时在南安短期访问的北大冯健博士、中大魏立华博士交流,我逐渐明确了研究主题:中国城市居住空间分异问题——市场化下的中国,愈发凸显的城市居住空间分异现象正在出现。当然,因子生态分析还不够支撑一篇博士论文,吴老师为我进一步确定了上海社区调查和小尺度的研究内容。没想到的是,这样的工作,会从当时(2003年)持续至今,最近我依然还在做着武汉的社区调查工作。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
**与导师吴缚龙教授在一起**
|
||||||
|
|
||||||
|
上海的社区调查是在上海市社科院卢汉龙老师的帮助下展开的,还记得当时在他家旁听他指导研究生毕业论文的场景,他们谈的现代性问题,我要到多年以后才会再次思考。在场几位学友,匆匆一别再也未曾见过。当时的主要感悟,是调研计划与复杂现实之间的张力。今天回头来看,其实是一种调研中的常态。三个典型社区新福康里、番瓜弄和新泾,从名字即可看出社会经济地位或贫富差距,都是上海较为有名的典型社区。顺带查了一下,现在新福康里的房价已经涨到每平米15万元,番瓜弄的均价也在每平米5万元,这在十五年前是完全感觉不到的,时至今日,犹如梦境。博士期间所积累的大量文献、见识和人脉,为我后来的工作奠定了很好的基础,尤其是以论文核心内容为基础所写的几篇文章,分别发表在《地理学报》、《TIBG》等国内外顶级期刊上。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
**空间分异与城市空间结构研究**
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
2005年9月底毕业回国,跨入罗湖口岸的一刻,深圳的天际线扑面而来,立刻感受到国内城市与英国城市尺度的差别,珠三角是当之无愧的巨型城市区域。中山大学是我的下一站,入职前几天我在广州看望了正在表兄开办的皮具厂打工的父亲,"三来一补"、城中村、农民工的话题,从纸面转成现实,从此有了实际接触。而这些课题正是中大人文地理研究的特色与强项,城中村和农民工社会空间研究从此与我结下不解之缘。直到今天,身处武汉大学的人才公寓,隔壁也是一片繁荣的城中村(风光村)和外来人口聚居区。
|
||||||
|
|
||||||
|
**中大十年**
|
||||||
|
|
||||||
|
中大地院的十年,是我的学术工作起步和渐入佳境之时。基于源自德国的优秀地理学血脉和临近港澳的地理优势,中大在城市地理、城市研究、城市国际化研究等方面具有得天独厚的优势,诸多先生们如许学强教授、闫小培教授、保继刚教授、薛德升教授、朱宏教授、李立勋教授、李郇教授等,给予了当时聚集的我们一帮年轻人以巨大的支持和鼓励,创造了十分和谐融洽、也颇为奋进的学术氛围(不知他们是如何做到的?!)。许多场景,每每想起仍会非常怀念!这一群"年轻人"包括曹小曙、林耿、刘云刚、周素红、陶伟、袁媛、何深静、沈静等等,今天多数已成长为中国人文地理学领域的中流砥柱。身处其中,不成材也难。记得曾有半年时间,与薛德升教授和刘云刚教授每天相约在中大旁边的下渡村同一家小饭馆吃午饭,几乎无话不谈,交流可谓多矣。还记得司徒尚纪教授退休后仍每天上班,笔耕不辍,每每路过我的办公室,会递来厚厚的新著,令人汗颜不已。珠三角和广州是城市地理研究的绝佳场域,为我实践在博士期间所接触的诸多文献和理论提供了机会,感觉自己的学术天地一下广阔了起来。
|
||||||
|
|
||||||
|
**A**
|
||||||
|
|
||||||
|
**项目带学科**
|
||||||
|
|
||||||
|
融入项目带学科的中大模式,我很快开始接触地方实践。最早负责的项目来自时任深圳市副市长的闫小培教授,结合当时社会主义新农村建设的背景,深圳一方面推动全域城市化,一方面开始建设"社会主义新社区",两个工作均指向了当时所谓"关外"的大批城中村。在闫老师指导下,位于龙岗的爱联社区的转型与规划研究成为我的第一个课题。我曾大量阅读的芝加哥学派、居住分异、移民社区等方面文献,一下有了用武之地。作为一种中国特色的移民聚居区,城中村的复杂远超我的想象,中国现实与已有理论的距离是明显的。在与华南理工大学魏立华教授和团队的合作中,也教给我很多地方知识,整个过程下来,感觉又做了一篇博士论文一般,当然也出产了几篇好文章。微观社会空间尤其是移民聚居区的丰富性、复杂性,其中所折射的地方与全球、以及国家、市场和社会之间的互动与张力,也开始吸引我的注意。移民聚居区是一种怎样的社会空间过程?背井离乡的他(她)们对于城乡中国究竟意味着什么?身边出现了很多来自老家的亲戚朋友,他们都在珠三角地区打工。一次一次去到广州、深圳、东莞的城中村、工厂、作坊,在一次次访谈问卷调查过程中,我开始意识到,从小镇青年到大学老师,我自己的"漂"的状态,我所面临的融入单位、融入广州、乃至融入国际化的状况,以及从一个普通的(甚至社会底层的)工人家庭向所谓"中产"或知识分子阶层的转化,其中所蕴含的奋斗、激情、困惑与张力,在这些社区和移民身上可以清楚地感受到。其实我自己就身处在这股"移民大潮"之中。这个国家和她的人民何尝不也是一样,也正朝向复兴和繁荣的未来"移民"?**研究移民聚居区就是研究我们身处的这个特殊时代,就是认识和理解我们自己。**
|
||||||
|
|
||||||
|
**B**
|
||||||
|
|
||||||
|
**非洲人区**
|
||||||
|
|
||||||
|
广州小北路非洲人区的研究始于2006年指导本科论文期间,国际化的广州正在出现各种新变化,非洲人区的出现在当时已经不时见诸报端,我所在的中大团队在学界最早开展了相关研究。作为一种"南南流动"的全新移民现象,广州非洲人区的研究很快也开始受到国际学术界的广泛关注,与国际学者的合作和互动成为这一时期我的学术工作的重要特点,很多本是研究非洲的学者如卡迪夫大学的Alison Brown教授、伦敦南岸大学的Michal Lyons教授(已故)、当时在香港大学的Adams Bodomo教授等、还有诸多知名华人学者如美国的马润潮教授(当时刚退休)、耶鲁大学的萧凤霞教授、UCLA的周敏教授等,纷纷参与其中。与他(她)们的合作和交流使我受益匪浅,一种综合的,结合人类学、社会学等的小尺度的城市地理研究思路也逐渐成型。基于这些合作,我逐步增加了自己的文章数量,在《地理学报》、《地理研究》和诸多SSCI期刊发表了系列文章。在与这些学界前辈的交流中,我还深刻感受到他(她)们对于所从事的研究事业的热爱。特别是Michal Lyons教授——她是犹太移民,从以色列去到英国工作和生活,当时已是癌症晚期,却仍坚持亲自实地调研,每次从伦敦飞来广州便立即开始田野工作,每天会在旅馆整理访谈资料直到凌晨。
|
||||||
|
|
||||||
|
在近十年的时间里,我也接触、接待或指导了各国各地关注这一问题的青年学者、学生近百人,交到很多朋友,其中如挪威奥斯陆大学的Heidi Haugen博士、德国科隆大学的Tabea Bork博士等,都已成长为这一领域的青年专家。他们有的来自地理学、规划学、建筑学、社会学、人类学、管理学等学科背景,也有MBA、学外交的、传媒的、语言学的、电信的、医学的,还有很多媒体人(如《纽约客》记者Evan Osnos、BBC、央视的记者等)、艺术家、摄影师(如李东)、作家(如旅行作家Lieve Joris)、电影人、清华本科生暑期调研的,等等。与他们的交流,让我愈发感受到了当前学科发展的交叉融合趋向,解读全球时代的地理现象需要不同专业观点的碰撞与综合。
|
||||||
|
|
||||||
|
更为感慨的,是在田野调查中所接触的非洲"移民"。虽然不像某些媒体所描绘的那么低端,但广州的多数非洲人并非如上海北京等地的跨国公司里的"高端"白领,多数是从事中非贸易的商人。例如我的朋友、当时加纳商会的首领阿塔,他常常问我:"你的研究对我们有什么用处?"这也成了我时常思考的问题。见过无数行色匆匆、颠沛流离之间仍然在奋斗不息的非洲商人,让我总有似曾相识之感。我想起早年所看到的自己的父母,他们在小镇集体经济倒闭之后,变成了小商小贩,经营日用品和小商品,经常在半夜去坐班车,到武汉汉正街进货后第二天傍晚返回,感觉他们总是嘶声竭力、行色匆匆、坚强维持;节假日是最忙的时候,家里总是没有大人。
|
||||||
|
|
||||||
|
**小北路非洲人(摄影:李东)**
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
作为非洲人聚居区的小北路"自下而上"发展而成,非常类似纽约内城的老唐人街,是一种"非正规的"、但极为重要的连接中非的"经济之桥"和"社会文化之桥"。全球与地方的复杂互动、国家政策、地方文化对这类族裔聚居区的影响无疑具有时代性和全球性。而中非关系更具有很强的国家战略性,"一带一路"大格局里包含了一个个"小北路"一般的微观社会空间。北大柴彦威教授曾告诉我,日本当代地理学的任务是为人类探索成熟型的、老龄化社会的持续发展道路。我想,小北路研究话题虽小,但也肩负着为中国城市融入全球化、为在社区尺度服务"一带一路"国家战略探路的重大任务。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
**广州非洲人聚居区研究成果**
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
**C**
|
||||||
|
|
||||||
|
**湖北村**
|
||||||
|
|
||||||
|
同步开展的,还有针对广州湖北村等城中村话题的研究。湖北村的研究,是我念兹在兹的一个。2008年从学校教师宿舍搬出,住进中大教工们所在的商品房小区坚真花园。没想到的是,楼下不远即是海珠区最大的一片城中村——东风村,其中活跃的外来人口居然多是来自我的故乡湖北天门的制衣工人或老板,很多来自老家的亲戚朋友,在其中讨生活。他们有成的有败的,满是酸甜苦辣。每每路过村里人山人海的"招工桥"去海珠湖跑步,耳边便是熟悉的乡音,看到的都是来自故乡的农民工。我会产生一丝幻觉,觉得自己是其中的一员,"漂"在这个大都市里,有着一样的苦斗。我决定,一定要为这里写点什么,要为他们做点什么。
|
||||||
|
|
||||||
|
湖北村的调查和研究系统地展开,我所指导的研究生们也完成了相关论文。这些工作,为发表在《地理研究》和《Urban Studies》上的系列成果奠定了基础。正是因为这样的情感基础和亲身接触,我对城中村问题有着自己的判断,希望能以实证支撑和强调其中所蕴含的经济、社会与文化活力,在一定程度上去除诸多城中村所面临的"污名化"问题。这样的问题,在小北路非洲人聚居区也同样存在,甚至更加严重。地理学的力量在于揭示空间差异,而我所关注的空间分异问题往往指向某些移民聚居空间所面临的歧视与误解,以及由此所产生的简单粗暴的改造、规划或拆除。对于广州保障房社区的一系列研究,也有同样的感受。因此,思想和观念上的"除魅"是这类研究的一种重要应用。
|
||||||
|
|
||||||
|
运气非常好,当时吴老师申请获得了英国ESRC所资助的一个大项目,我是项目的Co-PI, 针对北上广等地的系统的城中村调研开展起来,与华东师大宁越敏教授、北大冯健博士等的深度合作也开展起来,我对城中村的研究再上一个台阶,成果发表在了《城市规划》、《Urban Geography》等期刊上并获得了一些奖项。2013年中央提出"新型城镇化"战略,强调"人的城市化",农民工的城市融合问题是其中的一个重要方面。我一直关心的"新移民聚居区"问题,也就更加有了用武之地。结合国际上正在兴起的情感地理学研究,我将新的研究方向定位在了农民工群体的社区依恋、归属感和居住满意度等社区感知方面,以此拓展社会空间研究的分析框架。人是有七情六欲的,人与社区的情感关系是一种越来越重要的人地关系。为此,我和团队师生进一步研究了深圳富士康等各类外来人口聚居区,揭示了"归属感"和"乡愁"对于农民工群体的重要意义,甚至关系其身心健康水平。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
**湖北村与城中村研究成果**
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
**回到武大**
|
||||||
|
|
||||||
|
2015年,我回到武汉大学工作,担任城市设计学院院长。作为青年学科带头人,我开始思考如何拓展研究领域,带好科研团队、培养学生。相比珠三角的全球化、市场化和移民化特征,湖北乃至中部地区的学术"生态位"在于人口外流与输出,正好可与对东部地区的研究形成互补。进入"新时代",伴随产业发展的转型升级,回流农民工开始在湖北出现,我也开始关注他们,将目光投向家乡所在的"天门—潜江—仙桃"(所谓"天潜沔"地区)区域的回流农民工,尤其关注"回流地"的选择和"创业精神"的影响因素,从而与我在广州所做的城中村研究形成整体和回路。同时,依托武大的人文化、综合化学科优势和在数字化技术方面的领先地位,我将自己和团队的研究方向进一步落地,开始关注更为基本的科学问题:建成环境对居民健康与感知方面的影响,将其视为"人地关系"角度的城市研究新的核心任务。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
**建成环境对城乡居民健康与感知的影响研究成果**
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
在与国外学者如哈佛的Neil Brenner教授等的交流中,我发现对于发展中国家的关注度正在上升,出现了所谓后殖民批判、比较城市化、地方化(provincialization)等新动向,强调所谓"普通城市"和地方经验。原因在于,传统城市理论过于聚焦北美西欧、多将纽约等明星城市经验视为普世化的,忽略了其他城市和地区的理论潜力。这对我很有启发,因为湖北乃至武汉,更不用说中部诸多小城市,不也正是这种"地图之外"的"普通城市"吗?由此,我们一方面系统引介了这些新的理论观点,一方面开始了针对新的实证工作并尝试"理论化"工作,相关成果也将先后发表出来。
|
||||||
|
|
||||||
|
**结语**
|
||||||
|
|
||||||
|
作为青年学者,我的所谓"往事"的叙述其实是一件很"尴尬"的事,其实,人生的故事应是才刚刚开始,本文只是展现了我的成长与科研"背后"的一些事情,以便与同仁们做一个深度的分享。一路走来,从家乡到武汉,之后到南京,到英国南安普敦,到广州,再回到武汉,自己似乎完成了一段不长不短的"奥德赛"之旅。感触最深的,是这个时代所赋予的各种机会和所遇以及各种各样帮助我的人。整整一百年前,德国社会学家马克斯韦伯在其著名演讲《学术作为一种志业》中曾提出,学术生涯的成功,其实往往取决于运气。对此我深以为然,也为自己的好运而感慨。如果没有这些机缘,没有这些帮助、启发和指引,我是绝不可能取得目前这些有限但十分宝贵的科研成果的。
|
||||||
|
|
||||||
|
虽然一直漂泊在各地的"异乡",与家乡的关系也难说紧密,但我作为小镇青年的"身份认同"始终存在,也一直发挥着重要作用,影响我的研究和选择。因此,我也自信地以为,自己这些研究是一种独特的"参与观察",有自己的深度和温度。正因为这种血脉关系,服务国家和社会,应该是研究工作的天职。比如著名地理和规划学者、英国UCL大学的Peter Hall爵士,就一直致力于通过学术研究来服务英国的城市发展和建设。我觉得,这种服务可以是多种多样的,可以是参与大项目、大工程,也可以是通过一点一滴的实证以改进观念和认知。就学科而言,发展和创新是常态的,科学革命的步伐总是向前的,已有的知识体系总是会进入"过去时"。随着中国发展的深度全球化、物联网和人工智能时代的到来,城市地理研究的范式、方法和理论也会面临新的"科学革命"。作为一种讲究交叉性、综合性和系统性的学科,地理学也许会进入新的"移民"阶段,面临新的"漂"的状态。如何应对?这些年所接触的移民们已经告诉我答案:面对复杂,保持欢喜;学习、调整、适应,然后继续前进。是的,Keep Calm and Carry On。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|

|
||||||
@@ -0,0 +1,72 @@
|
|||||||
|
# 📊 文章摘要:文章背后 | 漂:聚焦城市新移民
|
||||||
|
|
||||||
|
> **原文**:[2026-08-20_文章背后_漂_聚焦城市新移民](./2026-08-20_文章背后_漂_聚焦城市新移民.md)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/gPvUj751Gz-G70_DWMl3UQ
|
||||||
|
> **来源**:微信公众平台
|
||||||
|
> **作者**:Geores(中国地理资源期刊微信平台)
|
||||||
|
> **发布日期**:2026-08-20
|
||||||
|
> **摘要日期**:2026-08-20
|
||||||
|
> **价值评级**:⭐⭐ 中
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 核心命题
|
||||||
|
|
||||||
|
> **漂泊治学** — 以自身"小镇青年—移民学者"的漂泊经历作为"参与观察",研究中国城市新移民聚居区
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 文章概要
|
||||||
|
|
||||||
|
这是中国地理资源期刊"文章背后"专栏对武汉大学城市设计学院院长李志刚教授的学术自述约稿。文章以"漂"为线索,串起他从湖北小镇到武大、南大、英国南安普敦(师从吴缚龙)、中山大学再回武大的学术旅程,以及三大研究方向的形成:中国城市居住空间分异、广州小北路非洲人聚居区与"湖北村"等城中村(移民聚居区)、回流农民工与建成环境对健康感知的影响。其认知贡献在于方法论自觉——研究者自身的移民身份即是理解研究对象的资源,"研究移民聚居区就是研究我们身处的这个特殊时代";同时为城市地理学三十年的议题变迁(分异—城中村—情感地理—健康地理)留下第一手个人史。局限是回忆性叙述,无系统方法论论证,成功叙事中时代机遇与个人努力的权重未加辨析。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 关键要点
|
||||||
|
|
||||||
|
1. **研究者的身份即方法** — 作者自认"小镇青年"身份认同是其移民研究的"独特参与观察",有"深度和温度" `[分类: 范式突破]`
|
||||||
|
2. **移民聚居区研究的时代意义** — "研究移民聚居区就是研究我们身处的这个特殊时代,就是认识和理解我们自己" `[分类: 共识]`
|
||||||
|
3. **广州小北路非洲人区的"南南流动"价值** — 中大团队最早开展研究;小北路类比纽约老唐人街,是"非正规的"但重要的中非"经济之桥"与"社会文化之桥" `[分类: 共识]`
|
||||||
|
4. **为城中村"除魅"** — 以实证强调城中村的经济、社会与文化活力,去除"污名化",反对简单粗暴的改造、规划或拆除 `[分类: 争议]`
|
||||||
|
5. **情感地理拓展** — 将研究方向转向农民工的社区依恋、归属感、居住满意度,揭示"归属感"和"乡愁"关系其身心健康 `[分类: 共识]`
|
||||||
|
6. **学术"生态位"互补** — 回湖北后研究中西部人口外流与回流农民工("天潜沔"地区),与东部移民研究形成"整体和回路" `[分类: 未探索]`
|
||||||
|
7. **"普通城市"理论化** — 受比较城市化、地方化(provincialization)启发,认为中部"地图之外"的城市具有理论潜力,反对以纽约等明星城市经验为普世 `[分类: 共识]`
|
||||||
|
8. **学科前瞻** — 物联网和人工智能时代城市地理研究将面临新"科学革命",地理学或进入新的"移民"阶段 `[分类: 未探索]`
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 批判性分析
|
||||||
|
|
||||||
|
### 假设前提
|
||||||
|
- 预设"参与观察"的主观共情是学术资产而非偏差来源;身份贴近研究对象带来的立场风险(如为城中村辩护的倾向)未被反思
|
||||||
|
- 叙事框架预设"运气+贵人"决定论(引韦伯《学术作为一种志业》),个人努力与结构性机遇的作用未作区分
|
||||||
|
|
||||||
|
### 论据与逻辑
|
||||||
|
- 第一手经历细节丰富(上海三社区调查、小北路田野、湖北村乡缘),人物、期刊、年份具体可查,史料价值高
|
||||||
|
- 但全文为回忆性自证,无文献引用与数据支撑,个别判断(如城中村活力论)在其自身论文中虽有实证,本文仅作断言
|
||||||
|
- "小北路服务一带一路国家战略"的表述带有明显的时代话语色彩,学术与政策话语交织
|
||||||
|
|
||||||
|
### 边界与局限
|
||||||
|
- 对研究方法本身(因子生态分析、社区调查设计)只有极简提及,不能当作方法论文读
|
||||||
|
- 对移民研究的困境(如非洲商人问"你的研究对我们有什么用处")点到即止,未展开回应
|
||||||
|
- 与 AI/技术主题无直接关联,对本库属于跨领域人文参考
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 可引用金句
|
||||||
|
|
||||||
|
> "研究移民聚居区就是研究我们身处的这个特殊时代,就是认识和理解我们自己。"
|
||||||
|
|
||||||
|
> "面对复杂,保持欢喜;学习、调整、适应,然后继续前进。是的,Keep Calm and Carry On。"
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 总体评价
|
||||||
|
|
||||||
|
**亮点**:一位主流城市地理学者30年学术生涯的真诚自述;"身份即方法"的参与观察自觉;小北路、湖北村等案例的中国城市研究史料价值。
|
||||||
|
|
||||||
|
**不足**:回忆体无方法论细节;成功叙事对时代红利的归因较重;政策话语与学术判断时有混同。
|
||||||
|
|
||||||
|
**适用场景**:了解中国城市地理学议题演进(空间分异→城中村→情感/健康地理);研究生学术生涯规划与选题启发;"研究者位置性(positionality)"讨论案例。
|
||||||
|
|
||||||
|
**关联建议**:文中"物联网和人工智能时代的城市研究新科学革命"可与本库 AI 相关内容互参;"参与观察"方法论对做用户研究、社会计算的 AI 团队有借鉴意义。
|
||||||
@@ -0,0 +1,48 @@
|
|||||||
|
# FDE 在中国火了,Agent 实施服务的真正考验在哪儿?
|
||||||
|
|
||||||
|
> **来源**:微信公众平台(IDC中国)
|
||||||
|
> **作者**:IDC中国(张舒,IDC中国研究经理)
|
||||||
|
> **发布日期**:2026-08-20(原文未标注明确日期,按下载日占位)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/iOkC1JMQEUu2dZeQheTZYA
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
|
||||||
|
|
||||||
|
当概念热度转化为产业动作,真正值得追问的不再是"什么是FDE",而是"什么样的FDE能力能够在市场中持续被识别、被认可、被买单"。
|
||||||
|
|
||||||
|
FDE(Forward Deployed Engineer,前沿部署工程师)正在中国经历从概念到实践的加速转化。近期,北京、武汉等地在加快智能体发展的专项政策中,相继将FDE明确为加速应用落地的创新模式;多家头部IT服务商、企业软件厂商、云厂商和大模型公司已相继设立FDE相关团队——政策推动与市场响应正在同步提速。
|
||||||
|
|
||||||
|
但热度并不等同于共识。IDC 观察到,中国 FDE 实践正在发生明显的分化:一部分服务商开始系统性地构建 FDE 能力体系——包括人才选拔标准、交付方法论、前线与后方的反馈闭环;另一部分则尚未与传统驻场交付形成实质性区隔。同一个"FDE"标签之下,能力模型、交付逻辑和商业实质可能截然不同。
|
||||||
|
|
||||||
|
这种分化并非中国市场独有的现象。IDC 在全球调研中注意到,部分 FDE 标签被用于包装并未实质改变交付逻辑的传统角色,这个词本身正在失去采购信号价值。中国市场对 FDE 的反应速度和参与热度可能是全球最快的之一,但这也意味着概念红利的窗口可能收窄得更快——当越来越多服务商都说"我们有FDE",标签本身的区分度正在衰减。真正能拉开差距的,不再是"有没有"这个岗位,而是能否说清楚自己的交付逻辑与传统的实施服务有什么实质性不同。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
## 热度之外,服务商正在面临的三重考验
|
||||||
|
|
||||||
|
FDE 的热度之下,一些更深层的结构性问题正在浮现。它们不只在单一市场出现,而是在全球范围内被反复验证——而中国市场的特殊性,又让这些问题呈现出不同的面貌。
|
||||||
|
|
||||||
|
第一重考验:技术能解决的问题,和组织接不住的结果。IDC 调研显示,全球企业实现可量化业务成果的AI项目平均占比提升至52%,值得注意的一个发现是:客户端的执行纪律、变革意愿和治理准备,往往比服务商的技术水平对落地效果的影响更为直接。这在 Agent 交付场景中尤其突出——Agent 不是部署完就结束的系统,它会在运行中持续更新,需要客户侧有人能理解、能治理、能迭代。如果服务商只管"把 Agent 部署进去"而不管"客户能不能接得住",交付效果必然受影响。在中国市场,大量企业正处于从"试试 Agent 能做什么"向"让Agent 跑在业务里"过渡的阶段,组织就绪度的缺口可能比全球平均水平更为显著。这对服务商是一个现实的选择:是否愿意且有能力帮助客户补上这一环?
|
||||||
|
|
||||||
|
第二重考验:FDE 天然要求结果导向,但商业模型准备好为此定价了吗? FDE 的工作方式是从业务结果出发定义技术方案,而非从需求规格出发推演交付计划——这使它天然倾向于对业务结果负责。然而,IDC 全球调研显示,接触过结果导向定价的客户比例在扩大,但常态化应用仍然有限——客户对定价确定性的偏好,往往走在组织能力前面。中国市场的局面更为复杂——一方面,"按效果付费"已有服务商在 Agent 交付中落地实践;另一方面,大量客户仍不愿为"理解业务"的过程买单。FDE 模式要求服务商从按人头计价的逻辑中走出来,但定价能力、客户接受度和内部核算体系之间的结构性矛盾,尚未被充分讨论。
|
||||||
|
|
||||||
|
第三重考验:Agent 实施服务是 FDE 当前在中国被推向台前的场景,而不是它的来源——这块拼图要嵌入一个新版图,适配和重构是绕不开的。FDE 的火热,本质上回应的是一个市场困境:当 Agent 从"试试看"进入"真正跑在业务里",传统实施服务的交付逻辑不够用了。需求在现场共同发现,效果在持续运行中验证,知识需要从前线反哺平台——FDE 站在这个变化的交叉点上。但它不是全部。一个服务商能否做好 Agent 交付,还要看行业深耕能力、方法论成熟度、持续运营体系等多个维度是否完整。IDC 全球研究也提示:FDE 活动范围之外的工作——治理、变革、流程再设计——恰恰是组织缺乏准备的环节。单点能力难以回答系统性问题,市场需要的是一个能够系统评估和比较 Agent 实施服务能力的参照框架。
|
||||||
|
|
||||||
|
FDE 在中国的故事刚刚开始。真正重要的,不是谁能最快喊出这个概念,而是谁能把它变成客户可感知、可验证的交付能力。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
**本文作者**:
|
||||||
|
|
||||||
|
张舒
|
||||||
|
|
||||||
|
IDC中国研究经理
|
||||||
|
|
||||||
|
## 进一步交流
|
||||||
|
|
||||||
|
FDE 是 Agent 实施服务能力的一个观察切口,但远不是全部。架构设计、行业知识、治理机制、变革管理、持续运营——每一个维度都在影响最终交付质量。这正是 IDC 正在开展的《IDC MarketScape:中国 Agent 实施服务厂商评估,2026》研究所试图回应的需求。该研究将从多个维度对中国市场主要服务商的 Agent 实施服务能力进行系统性评估,旨在为行业用户和服务商提供一个完整的能力参照。更多信息,欢迎关注 IDC,也欢迎具备 Agent 实施服务能力的厂商与我们联系交流。
|
||||||
|
|
||||||
|
## 免责声明
|
||||||
|
|
||||||
|
本文中的内容和数据均来源于IDC所发布的报告,所有内容及数据均为我公司所有。未经IDC书面许可,任何机构和个人不得以任何形式翻版、复制、刊登、发表或引用。
|
||||||
@@ -0,0 +1,72 @@
|
|||||||
|
# 📊 文章摘要:FDE 在中国火了,Agent 实施服务的真正考验在哪儿?
|
||||||
|
|
||||||
|
> **原文**:[2026-08-20_FDE_在中国火了_Agent_实施服务的真正考验在哪儿](./2026-08-20_FDE_在中国火了_Agent_实施服务的真正考验在哪儿.md)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/iOkC1JMQEUu2dZeQheTZYA
|
||||||
|
> **来源**:微信公众平台
|
||||||
|
> **作者**:IDC中国(张舒,IDC中国研究经理)
|
||||||
|
> **发布日期**:2026-08-20
|
||||||
|
> **摘要日期**:2026-08-20
|
||||||
|
> **价值评级**:⭐⭐⭐ 高
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 核心命题
|
||||||
|
|
||||||
|
> **FDE分化** — FDE 标签正在通胀,中国 Agent 实施服务的真正分水岭不在"有没有 FDE 岗位",而在交付逻辑是否与传统驻场实施形成实质差异,能否被客户识别、验证并为之定价。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 文章概要
|
||||||
|
|
||||||
|
IDC 中国研究经理张舒撰文剖析 FDE(Forward Deployed Engineer,前沿部署工程师)在中国的概念落地与实质分化:北京、武汉专项政策已将 FDE 列为加速智能体落地的创新模式,头部 IT 服务商、云厂商、大模型公司纷纷设立 FDE 团队,但同一标签下能力模型与商业实质可能截然不同,部分只是传统驻场交付的包装。文章提出服务商面临的三重结构性考验——客户组织"接不住"技术交付的结果、结果导向定价与按人头计价体系的结构性矛盾、FDE 只是 Agent 实施服务版图的一块拼图——并预告 IDC MarketScape 中国 Agent 实施服务厂商评估(2026)。对 Agent 交付从业者,这是目前少见的清醒去泡沫分析。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 关键要点
|
||||||
|
|
||||||
|
1. **FDE 标签正在失去采购信号价值** — IDC 全球调研发现部分 FDE 标签被用于包装未实质改变交付逻辑的传统角色;中国市场热度全球最快,概念红利窗口也可能收窄最快。 `[分类: 争议]`
|
||||||
|
2. **中国 FDE 实践已现真分化** — 一部分服务商系统性构建 FDE 能力体系(人才选拔标准、交付方法论、前线与后方反馈闭环),另一部分与传统驻场交付无实质区隔。 `[分类: 共识]`
|
||||||
|
3. **第一重考验:组织就绪度比技术更决定落地效果** — IDC 调研:可量化业务成果的 AI 项目平均占比升至 52%;客户端执行纪律、变革意愿、治理准备对落地的影响往往比服务商技术水平更直接。 `[分类: 争议]`
|
||||||
|
4. **Agent 是持续运营系统而非交付即结束的项目** — Agent 在运行中持续更新,需要客户侧有人能理解、能治理、能迭代;服务商必须回答"是否愿意且有能力帮客户补上这一环"。 `[分类: 共识]`
|
||||||
|
5. **第二重考验:结果导向定价的结构性矛盾** — FDE 从业务结果出发定义方案、天然倾向对结果负责,但客户对定价确定性的偏好走在组织能力前面;大量客户仍不愿为"理解业务"的过程买单。 `[分类: 共识]`
|
||||||
|
6. **第三重考验:FDE 是拼图不是全景** — 行业深耕、方法论成熟度、持续运营体系缺一不可;IDC 全球研究提示治理、变革、流程再设计恰是组织最缺准备的环节。 `[分类: 共识]`
|
||||||
|
7. **系统评估框架呼之欲出** — 《IDC MarketScape:中国 Agent 实施服务厂商评估,2026》将多维度评估主要服务商能力,为买卖双方提供参照。 `[分类: 未探索]`
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 批判性分析
|
||||||
|
|
||||||
|
### 假设前提
|
||||||
|
- 预设 FDE(源自 Palantir 的组织形态)是 Agent 落地的有效载体,未讨论 FDE 高人力投入模式在中国软件服务价格体系下的经济可行性。
|
||||||
|
- "组织就绪度决定论"建立在 IDC 调研数据之上,但调研样本、口径与"52%"的统计边界未披露。
|
||||||
|
|
||||||
|
### 论据与逻辑
|
||||||
|
- 三重考验是分析框架而非实证结论:每重考验有全球调研的间接佐证(占比数据、定价观察),但中国市场证据以定性观察为主(政策列举、"已有服务商落地实践"无具体案例)。
|
||||||
|
- 文章自身是 IDC MarketScape 评估的预热动员文(文末明确邀请厂商联系交流),"市场需要参照框架"的论断与 IDC 售卖评估报告的商业动机存在利益关联,读时需打折扣。
|
||||||
|
|
||||||
|
### 边界与局限
|
||||||
|
- 未给出 FDE 能力体系的可操作定义(何为"实质性不同"缺乏判据),结论停留在"要能说清楚"层面。
|
||||||
|
- 三重考验均从服务商视角出发,客户侧视角(如何自评组织就绪度)未展开。
|
||||||
|
- FDE 与传统实施服务在人天成本、项目周期上的量化对比缺失。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 可引用金句
|
||||||
|
|
||||||
|
> "真正重要的,不是谁能最快喊出这个概念,而是谁能把它变成客户可感知、可验证的交付能力。"
|
||||||
|
|
||||||
|
> "客户端的执行纪律、变革意愿和治理准备,往往比服务商的技术水平对落地效果的影响更为直接。"
|
||||||
|
|
||||||
|
> "Agent 不是部署完就结束的系统,它会在运行中持续更新,需要客户侧有人能理解、能治理、能迭代。"
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 总体评价
|
||||||
|
|
||||||
|
**亮点**:对 FDE 概念泡沫的清醒判断在一片追捧中稀缺;三重考验框架(组织就绪度/定价模型/能力版图)结构清晰且互相咬合;明确指出标签通胀的全球普遍性而非仅中国现象。
|
||||||
|
|
||||||
|
**不足**:中国市场的实证案例与数据薄弱;FDE 能力体系无可操作判据;文章兼作 IDC 评估报告的预热营销。
|
||||||
|
|
||||||
|
**适用场景**:软件服务商制定 Agent 实施业务战略(是否设 FDE、如何定价、如何构建交付方法论)的直接参考;企业客户评估 Agent 实施服务商的提问清单;AI 服务转型研讨素材。
|
||||||
|
|
||||||
|
**关联建议**:与本院 Agent 交付能力建设直接相关——三重考验可作为我司 Agent 实施服务能力自评框架(组织就绪度评估服务、结果导向定价试点、方法论与持续运营体系);另与《Jonex × WorkBuddy》对照可见 Agent 交付的"产品派"(工具链)与"服务派"(FDE)两条路径。
|
||||||
@@ -0,0 +1,268 @@
|
|||||||
|
# 从 OpenCode 升级到 V2,我们看到上下文工程与驾驭工程的三个趋势
|
||||||
|
|
||||||
|
> **来源**:微信公众平台(Kerry)
|
||||||
|
> **作者**:Kerry
|
||||||
|
> **发布日期**:2026-08-20(原文未标注明确日期,按下载日占位)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/2u4ntl_2HZ7-iV-aHBrV8A
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
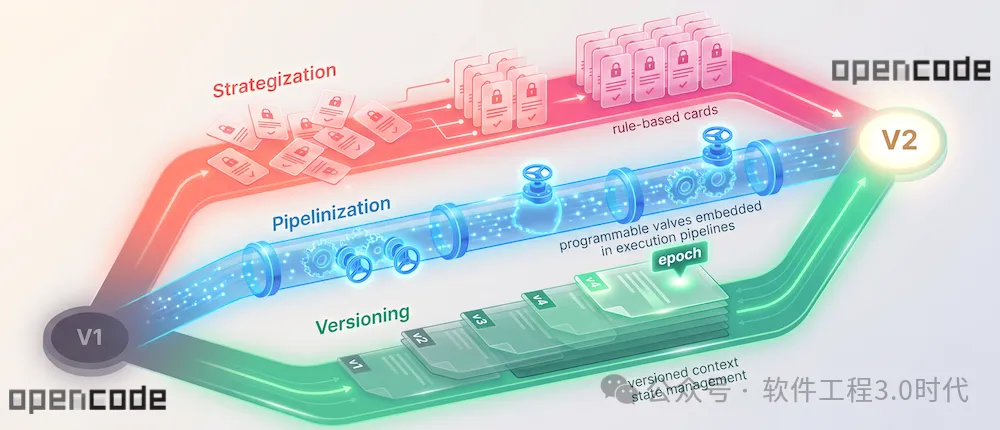
|
||||||
|
|
||||||
|
(参考:https://opencode.ai/v2/docs)
|
||||||
|
|
||||||
|
2026年7月,OpenCode 悄然上线了V2 beta。
|
||||||
|
|
||||||
|
如果你只是把它当作"又一个工具的版本更新"来浏览,你会看到:运行时从 Bun 换到了 Node,Desktop 从 Tauri 换到了 Electron,Plugin API 全部重写,配置字段大量重命名。这些是表面变化。
|
||||||
|
|
||||||
|
但如果你带着一个问题去读它的文档——**"这个工具的设计者认为,驾驭一个 AI Agent 最难的事情是什么?"**——你会看到一些更深层的东西。
|
||||||
|
|
||||||
|
V2 的每一个重大设计决策,都在回答同一个问题:**当 Agent 的能力越来越强,人类如何既充分利用它,又不失去对它的控制?**
|
||||||
|
|
||||||
|
答案藏在四个变化里:Permission 变成有序规则数组、Plugin 获得 transform + runtime 双层能力、Compaction 变成带版本号的 checkpoint 机制、Instructions 引入 durable deltas 和 epoch 概念。
|
||||||
|
|
||||||
|
这四个变化,恰好对应了上下文工程和驾驭工程的三个发展趋势。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 趋势一:从配置到策略——Permission的有序规则数组
|
||||||
|
|
||||||
|
### V1 的样子
|
||||||
|
|
||||||
|
V1 的 permission 是一个按工具分组的对象:
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
这个设计的问题在于:**当多条规则可能同时匹配时,谁优先?** V1 没有给出明确答案。规则之间的优先级是隐式的、依赖实现的、不可预测的。
|
||||||
|
|
||||||
|
### V2 的样子
|
||||||
|
|
||||||
|
V2 把 permission 变成了一个**有序数组**,每条规则有三个字段:`action`、`resource`、`effect`:
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
官方文档给出了明确的语义:**"The last matching rule wins."**(最后匹配的规则生效。)
|
||||||
|
|
||||||
|
这看起来只是一个数据结构的变化,但它代表了一个根本性的思维转变:
|
||||||
|
|
||||||
|
| | V1 | V2 |
|
||||||
|
| --- | --- | --- |
|
||||||
|
| 思维模型 | "给工具设置开关" | "编写策略规则" |
|
||||||
|
| 优先级 | 隐式、依赖实现 | 显式、last-match-wins |
|
||||||
|
| 可组合性 | 对象合并,冲突不可预测 | 数组追加,顺序决定一切 |
|
||||||
|
| Agent 级规则 | 替换全局规则 | **追加** 在全局规则之后 |
|
||||||
|
|
||||||
|
最后一点尤其重要。V2 明确说:
|
||||||
|
|
||||||
|
> "Global permissions are applied to every agent before its agent-specific rules, so a later agent rule can refine a global rule." [ref:agents]
|
||||||
|
|
||||||
|
这意味着你可以写一套全局策略(比如"所有 shell 命令默认 ask"),然后给特定 agent 追加更细的规则(比如"reviewer agent 的 git diff 直接 allow"),而不用担心 agent 规则会覆盖全局规则。
|
||||||
|
|
||||||
|
**这就是"策略即代码"(Policy as Code)的思路**——和 Kubernetes 的 RBAC、AWS IAM 的 policy evaluation 逻辑如出一辙。
|
||||||
|
|
||||||
|
### 这个趋势意味着什么?
|
||||||
|
|
||||||
|
驾驭工程正在从"给 Agent 配几个开关"走向"为 Agent 编写可审计、可组合、可预测的策略体系"。
|
||||||
|
|
||||||
|
当我们团队有 5 个不同的 agent(build、plan、reviewer、explorer、deployer),每个 agent 有不同的权限边界时,我们需要的不是 5 份独立的配置,而是**一套分层的策略系统**:全局策略 + agent 级追加规则 + 显式的优先级语义。
|
||||||
|
|
||||||
|
V2 的 permission 数组就是这个思路的雏形。
|
||||||
|
|
||||||
|
### 一个容易被忽略的细节
|
||||||
|
|
||||||
|
V2 文档中有一句非常诚实的话:
|
||||||
|
|
||||||
|
> "Shell runs with the host user's filesystem, process, and network authority. Its resource is raw text, not a parsed command. [...] Prefer a narrow shell allowlist over patterns intended to identify every dangerous command."
|
||||||
|
|
||||||
|
翻译过来就是:**shell 命令是原始文本,不是结构化命令,我们不可能通过模式匹配识别所有危险命令。与其写黑名单,不如写白名单。**
|
||||||
|
|
||||||
|
这句话暴露了驾驭工程的一个根本困境:**你无法穷举所有危险操作**。所以正确的策略不是"列出所有不能做的事",而是"只列出允许做的事"。
|
||||||
|
|
||||||
|
这正是我们常强调的原则:**红线用 deny 硬执行,白名单用 allow 放行,其余全部 ask。** V2 的设计把这个原则变成了配置层面的默认行为。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 趋势二:从回调函数到组合式中间件——Plugin的双层能力
|
||||||
|
|
||||||
|
### V1的Plugin能做什么?
|
||||||
|
|
||||||
|
V1的plugin本质上是一组回调函数:
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
它能做的事情有限:在工具执行前后拦截、注入环境变量、订阅事件。**它无法修改 Agent 的定义、无法修改模型请求、无法添加工具。**
|
||||||
|
|
||||||
|
### V2 的 Plugin 能做什么
|
||||||
|
|
||||||
|
V2 把 plugin 能力分成了两层:**Transform hooks**(修改配置)和 **Runtime hooks**(拦截运行时操作)。
|
||||||
|
|
||||||
|
**Transform hooks** 让我们修改 OpenCode 的配置本身:
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
**Runtime hooks**让我们在运行时拦截操作。其中最强大的一个是`ctx.session.hook("context")`:
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
```
|
||||||
|
这个hook让我们可以在模型请求发出之前,修改system prompt、消息列表、工具集。
|
||||||
|
```
|
||||||
|
|
||||||
|
### 为什么这很重要?
|
||||||
|
|
||||||
|
在 V1 中,如果我们想让某个agent不能使用某个工具,只有两个选择:
|
||||||
|
|
||||||
|
1. 在 permission 里 deny 那个工具(但 agent 仍然"知道"这个工具存在,只是被拒绝)
|
||||||
|
2. 在 AGENTS.md 里写"不要使用这个工具"(但 agent 可能忽略)
|
||||||
|
|
||||||
|
在 V2 中,我们可以**直接从模型请求中删除这个工具**。模型根本不知道这个工具存在。这不是"拒绝",这是"不存在"。
|
||||||
|
|
||||||
|
**这是驾驭工程的一个质的飞跃:从"告诉 Agent 不要做什么"到"让 Agent 根本不知道可以做什么"。**
|
||||||
|
|
||||||
|
### 更深层的设计:Hook failure fails the operation
|
||||||
|
|
||||||
|
V2 文档中有一句关键的话:
|
||||||
|
|
||||||
|
> "A hook failure fails the operation it intercepts." [ref:plugins]
|
||||||
|
|
||||||
|
这意味着:如果plugin hook 抛出异常,**被拦截的操作会直接失败**。不是"记录一条日志然后继续",而是"操作被阻断"。
|
||||||
|
|
||||||
|
这给了我们一个非常重要的能力:**用 plugin 实现硬性门禁**。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
在 V1 中,`tool.execute.before` 抛出异常也能阻断操作,但 V2 把这个行为**明确写进了文档**,并且扩展到了 HTTP 请求/响应层面。这意味着你可以在**模型请求发出之前**就拦截不合规的请求,而不仅仅是在工具执行时拦截。
|
||||||
|
|
||||||
|
### 这个趋势意味着什么?
|
||||||
|
|
||||||
|
驾驭工程正在从"在Agent外面包一层防护"走向"把防护逻辑嵌入 Agent 的执行管线"。
|
||||||
|
|
||||||
|
- V1 的plugin像是在 Agent 外面装了一个监控摄像头——它能看到 Agent 做了什么,但很难阻止 Agent 做什么。
|
||||||
|
- V2 的plugin像是在 Agent 的执行管线里插入了一组**可编程的阀门**——你可以在任何一个环节关闭阀门,让后续的操作根本不会发生。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 趋势三:从"遗忘"到"有版本的状态管理"
|
||||||
|
|
||||||
|
### V1 的Compaction
|
||||||
|
|
||||||
|
V1 的compaction是一个相对简单的机制:当上下文快满时,把旧消息压缩成一段摘要,保留最近几轮对话。
|
||||||
|
|
||||||
|
问题是:**压缩之后,之前注入的指令(比如 AGENTS.md 里的红线)还在不在?** V1 没有给出明确答案。实践中,很多团队发现compaction之后Agent 开始"忘记"关键约束。
|
||||||
|
|
||||||
|
### V2 的Compaction:Checkpoint 机制
|
||||||
|
|
||||||
|
V2 把compaction重新设计为**checkpoint机制**:
|
||||||
|
|
||||||
|
> "Compaction replaces the active model context from an older part of a session with a generated checkpoint. The checkpoint contains a structured summary and a serialized tail of recent context." [ref:compaction]
|
||||||
|
|
||||||
|
Checkpoint 包含两部分:
|
||||||
|
|
||||||
|
1. **结构化摘要:目标、重要细节、已完成和进行中的工作、阻塞项、下一步、相关文件**
|
||||||
|
2. **序列化的最近上下文尾部:保留最近 keep.tokens(默认 15000)个token的原始对话**
|
||||||
|
|
||||||
|
更关键的是,V2引入了**上下文溢出自动恢复**:
|
||||||
|
|
||||||
|
> "If an overflow occurs before the provider produces assistant output, V2 can compact and retry that step once." [ref:compaction]
|
||||||
|
|
||||||
|
也就是说,如果模型返回"context overflow"错误,V2会**自动compact并重试一次**。这在 V1 中是不存在的。
|
||||||
|
|
||||||
|
### Instruction Epoch:上下文工程的"版本号"
|
||||||
|
|
||||||
|
这是 V2 最精妙的设计之一。
|
||||||
|
|
||||||
|
V2 把instructions(AGENTS.md 等)的变更存储为**durable deltas**(持久化增量):
|
||||||
|
|
||||||
|
> "It stores source values as durable deltas, then renders initial instructions and chronological updates when assembling each model request." [ref:instructions]
|
||||||
|
|
||||||
|
每次compaction完成后,**instruction epoch推进**:
|
||||||
|
|
||||||
|
> "Completed compaction advances the instruction epoch, making the currently admitted values initial without rereading sources or authoring an instruction event." [ref:compaction]
|
||||||
|
|
||||||
|
翻译成人话:
|
||||||
|
|
||||||
|
- Compaction之前,instructions 是"初始值 + 一系列增量变更"
|
||||||
|
- Compaction之后,当前已准入的值变成新的"初始值",之前的增量历史被折叠
|
||||||
|
- 下次请求装配时,从新的初始值开始渲染
|
||||||
|
|
||||||
|
**这本质上是给上下文引入了"版本号"的概念。**
|
||||||
|
|
||||||
|
### 为什么这很重要?
|
||||||
|
|
||||||
|
在 V1 中,上下文管理是一个"黑箱":我们不知道compaction之后哪些信息还在、哪些丢了,我们只能祈祷关键约束没被压缩掉。
|
||||||
|
|
||||||
|
在 V2 中,上下文管理变成了一个**有版本、有增量、有明确语义的状态系统**:
|
||||||
|
|
||||||
|
| 概念 | 类比 | 作用 |
|
||||||
|
| --- | --- | --- |
|
||||||
|
| Durable deltas | Git commit | 记录每次 instruction 变更 |
|
||||||
|
| Instruction epoch | Git tag / release | 标记 compaction 边界 |
|
||||||
|
| Checkpoint | Git snapshot | 保存当前状态的完整快照 |
|
||||||
|
| 请求装配 | Git checkout | 从特定版本重建完整上下文 |
|
||||||
|
|
||||||
|
### Nested AGENTS.md:按需加载的上下文
|
||||||
|
|
||||||
|
V2 还引入了一个 V1 没有的机制:**嵌套 AGENTS.md 的按需发现**。
|
||||||
|
|
||||||
|
> "An AGENTS.md below the Location is not part of the initial upward scan. When the read tool successfully reads a file or lists a directory, OpenCode discovers AGENTS.md files from that target upward to, but not including, the Location." [ref:instructions]
|
||||||
|
|
||||||
|
也就是说:位于当前工作目录**之下**的 AGENTS.md,不会在启动时加载。只有当 Agent 用 `read` 工具读到那个目录时,才会被发现并注入。
|
||||||
|
|
||||||
|
**这是上下文工程的一个重大进步:上下文不再是一次性全量加载的,而是按需、动态、增量装配的。**
|
||||||
|
|
||||||
|
它解决了上下文工程的一个核心矛盾:
|
||||||
|
|
||||||
|
- 想让 Agent 知道所有规则(完整性)
|
||||||
|
- 但不希望所有规则同时占用上下文窗口(效率)
|
||||||
|
|
||||||
|
嵌套发现机制的回答是:**只在 Agent 真正需要的时候,才注入相关的规则。**
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 一个意外但重要的变化:Undo 与 Snapshots
|
||||||
|
|
||||||
|
V2 还引入了一个看起来和上下文工程无关、但实际上非常重要的功能:**基于 Git 的 per-step 快照和 Undo/Redo**。
|
||||||
|
|
||||||
|
> "For each model step, OpenCode attempts to capture the worktree immediately before the model call and after a cleanly completed step." [ref:snapshots]
|
||||||
|
|
||||||
|
这意味着 Agent 的每一步操作都被快照了。我们可以用 `/undo` 回滚到任意一步之前的状态,包括文件内容和对话历史。
|
||||||
|
|
||||||
|
**这给 Agent 的动作引入了"事务语义"**:每一步操作要么完整执行、要么可以完整回滚。
|
||||||
|
|
||||||
|
在驾驭工程的语境下,这是一个重要的安全网:即使 Agent 做了错误的事情,我们也可以一键回滚,而不需要手动修复。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 总结:三个趋势,一个方向
|
||||||
|
|
||||||
|
把这三个趋势放在一起看,我们会发现它们指向同一个方向:
|
||||||
|
|
||||||
|
| 趋势 | V1 的做法 | V2 的做法 | 本质变化 |
|
||||||
|
| --- | --- | --- | --- |
|
||||||
|
| **策略化** | 给工具设开关 | 编写有序策略规则 | 从"配置"到"策略即代码" |
|
||||||
|
| **管线化** | 在 Agent 外面包防护 | 把防护嵌入执行管线 | 从"监控"到"可编程阀门" |
|
||||||
|
| **版本化** | 上下文是黑箱 | 上下文有版本、有增量、有 epoch | 从"祈祷不丢"到"确定性状态管理" |
|
||||||
|
|
||||||
|
这三个趋势合在一起,指向一个结论:
|
||||||
|
|
||||||
|
> **驾驭 AI Agent 正在从"提示工程"走向"系统工程"。**
|
||||||
|
|
||||||
|
在提示工程时代,我们通过写好的 prompt 来引导 Agent,控制手段是"说清楚"。
|
||||||
|
|
||||||
|
在系统工程时代,我们通过策略规则、执行管线、状态版本来驾驭 Agent。控制手段是"让它不能不知道、不能做、做了也能回滚"。
|
||||||
|
|
||||||
|
OpenCode V2 不是第一个走这条路的工具,但它是目前**把这三件事做得最完整、最公开的开源实现**。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## OpenCode V2 目前还是 beta。官方明确说"we may wipe your data, things may break, and APIs may change"。
|
||||||
|
|
||||||
|
但它的**设计方向**是清晰的。即使 V2 的 API 还会变化,它背后的三个趋势——策略化、管线化、版本化——不会变。
|
||||||
|
|
||||||
|
因为这三个趋势不是 OpenCode 发明的,而是整个行业在驾驭 AI Agent 的过程中,一步一步摸索出来的。
|
||||||
|
|
||||||
|
OpenCode V2 只是把它们写成了代码。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
---
|
||||||
@@ -0,0 +1,77 @@
|
|||||||
|
# 📊 文章摘要:从 OpenCode 升级到 V2,我们看到上下文工程与驾驭工程的三个趋势
|
||||||
|
|
||||||
|
> **原文**:[2026-08-20_从_OpenCode_升级到_V2_我们看到上下文工程与驾驭工程的三个趋势](./2026-08-20_从_OpenCode_升级到_V2_我们看到上下文工程与驾驭工程的三个趋势.md)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/2u4ntl_2HZ7-iV-aHBrV8A
|
||||||
|
> **来源**:微信公众平台
|
||||||
|
> **作者**:Kerry
|
||||||
|
> **发布日期**:2026-08-20
|
||||||
|
> **摘要日期**:2026-08-20
|
||||||
|
> **价值评级**:⭐⭐⭐ 高
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 核心命题
|
||||||
|
|
||||||
|
> **系统驾驭** — 驾驭 AI Agent 正从"提示工程"走向以策略化、管线化、版本化为特征的"系统工程"
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 文章概要
|
||||||
|
|
||||||
|
作者以"驾驭一个 AI Agent 最难的事情是什么"为透镜解读 OpenCode V2 beta 的官方文档,将四个重大设计变化(Permission 有序规则数组、Plugin 双层 hook、Compaction checkpoint 机制、Instructions durable deltas + epoch)归纳为上下文工程与驾驭工程的三个趋势:策略化(Policy as Code)、管线化(防护嵌入执行管线)、版本化(上下文确定性状态管理),并额外分析了 per-step Git 快照带来的"事务语义"。文章论据以 V2 官方文档原文引用为主(均标注 [ref:xxx]),框架提炼清晰且可迁移到任何自研 Agent 框架的设计评审。局限是部分代码示例仅为截图(文中未能呈现),且三个趋势的归纳是作者个人解读而非 OpenCode 官方立场。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 关键要点
|
||||||
|
|
||||||
|
1. **Permission 从对象变为有序规则数组** — "The last matching rule wins" 显式优先级,agent 级规则追加而非替换全局规则,等同 Kubernetes RBAC / AWS IAM 的策略即代码思路 `[分类: 共识]`
|
||||||
|
2. **白名单优于黑名单的根本困境** — 官方文档承认 shell 命令是原始文本、无法模式匹配识别所有危险命令;正确策略是"红线 deny、白名单 allow、其余 ask" `[分类: 共识]`
|
||||||
|
3. **Plugin 双层能力:Transform hooks + Runtime hooks** — 可在模型请求发出前修改 system prompt、消息列表、工具集,"直接从模型请求中删除工具",从"告诉 Agent 不要做"升级为"让 Agent 根本不知道" `[分类: 范式突破]`
|
||||||
|
4. **Hook failure fails the operation** — hook 抛异常则被拦截操作直接失败(而非记日志继续),可用来实现模型请求层面的硬性门禁 `[分类: 共识]`
|
||||||
|
5. **Compaction 变为 checkpoint 机制** — 结构化摘要(目标/阻塞项/下一步等)+ 最近 keep.tokens(默认 15000)token 原始对话尾部;上下文溢出时自动 compact 并重试一次 `[分类: 共识]`
|
||||||
|
6. **Instruction Epoch = 上下文版本号** — instructions 以 durable deltas 存储,compaction 后 epoch 推进、增量历史折叠为新的初始值,类比 Git commit/tag/snapshot/checkout `[分类: 范式突破]`
|
||||||
|
7. **嵌套 AGENTS.md 按需发现** — 工作目录之下的 AGENTS.md 不在启动时加载,read 工具触及时才注入,化解"完整性 vs 效率"矛盾 `[分类: 共识]`
|
||||||
|
8. **Per-step Git 快照引入事务语义** — 每个模型步骤前后捕获 worktree,/undo 可回滚文件与对话历史,构成驾驭工程的安全网 `[分类: 未探索]`
|
||||||
|
9. **三趋势合一的判断** — 控制手段从"说清楚"(prompt)变为"让它不能不知道、不能做、做了也能回滚"(策略+管线+版本) `[分类: 争议]`
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 批判性分析
|
||||||
|
|
||||||
|
### 假设前提
|
||||||
|
- 预设 OpenCode V2 的设计文档诚实完备,且其设计动机可以代表"行业趋势"(作者也承认趋势非 OpenCode 独创,但未给出其他工具的平行例证)
|
||||||
|
- 预设"更强的结构性控制"必然优于"提示式引导",未讨论策略体系过重对个人开发者的负担
|
||||||
|
|
||||||
|
### 论据与逻辑
|
||||||
|
- 核心论据全部来自 V2 官方文档的直接引用且标注出处([ref:agents]/[ref:plugins]/[ref:compaction]/[ref:instructions]/[ref:snapshots]),可验证性强
|
||||||
|
- V1 的问题描述(优先级隐式、上下文黑箱)与 V2 文档相互印证,对比逻辑成立
|
||||||
|
- "三个趋势"是作者强加的解释框架:V2 团队未必以此命名设计意图;趋势概括有事后合理化风险;Git 类比(epoch=tag)是修辞性近似而非严格同构
|
||||||
|
- "V1 中很多团队发现 compaction 后忘记关键约束"为经验性断言,无出处
|
||||||
|
|
||||||
|
### 边界与局限
|
||||||
|
- 文中代码示例全部以截图形式存在,文字版缺失,读者无法直接复用配置片段
|
||||||
|
- V2 处于 beta,官方明言 API 可能变化,文章结论的时效性受限(作者已自我声明)
|
||||||
|
- 未讨论性能代价:per-step 快照、durable deltas、每请求装配的开销未评估
|
||||||
|
- 未与 Claude Code、Cursor 等同类工具的等价机制对比,"做得最完整、最公开"的断言依据不足
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 可引用金句
|
||||||
|
|
||||||
|
> "驾驭 AI Agent 正在从'提示工程'走向'系统工程'。"
|
||||||
|
|
||||||
|
> "控制手段是'让它不能不知道、不能做、做了也能回滚'。"
|
||||||
|
|
||||||
|
> "这不是'拒绝',这是'不存在'。"
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 总体评价
|
||||||
|
|
||||||
|
**亮点**:以官方文档为据的深度解读,证据链完整可验证;"策略化/管线化/版本化"三趋势框架高度可迁移;对 Permission、epoch、嵌套 AGENTS.md 等机制的语义阐释精准。
|
||||||
|
|
||||||
|
**不足**:代码示例仅截图无文字;三趋势框架属作者个人归纳未经官方确认;缺少性能开销与竞品横向对比。
|
||||||
|
|
||||||
|
**适用场景**:自研 Agent 框架/内部 coding agent 的权限系统与上下文管理设计评审;制定团队 Agent 安全基线(deny/allow/ask);理解 compaction 语义演进的参考读物。
|
||||||
|
|
||||||
|
**关联建议**:与《我复刻了 Claude 刚发布的生成式 UI 交互!》互补阅读(输出端渲染 vs 驾驭端工程);其 Permission 思想可对照本库 Claude Code hooks/permissions 实践;"上下文版本化"可关联本会话的上下文压缩(compaction)机制讨论。
|
||||||
@@ -0,0 +1,156 @@
|
|||||||
|
# 未来战场已然来临:大规模廉价无人系统、多域蜂群、人工智能
|
||||||
|
|
||||||
|
> **来源**:微信公众平台(专知防务)
|
||||||
|
> **作者**:专知防务
|
||||||
|
> **发布日期**:2026-08-20(原文未标注明确日期,按下载日占位;文内注释可见信息至 2026-07-26)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/g57nYwvtj-kllPxX5s9l5g
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
|
||||||
|
|
||||||
|
未来战场将由大规模部署的廉价系统、多域蜂群、能够分析信息并支持或作出决策的人工智能,以及技术能力与法律和伦理监管能力之间日益扩大的鸿沟所定义。通过结合数量规模、行动节奏、冗余性、自主性和网络化,蜂群能够产生不依赖于任何单个平台、而取决于系统集体行为的效应。在人类已无法跟上机器观察、计算和打击速度的时代,需要更强有力的人类控制——不是作为法律装饰,而是作为作战与伦理的双重约束。
|
||||||
|
|
||||||
|
|
||||||
|
|
||||||
|
## 引言
|
||||||
|
|
||||||
|
未来战场并非渐次浮现,而是以惊人的速度在当下骤然降临。短短数年间,无人系统已从情报支援工具演变为塑造现代战争的能力。除战术侦察系统和巡飞弹外,最初作为摄影平台起步的商用无人机,已变成廉价、易得、致命且难以拦截的武器。乌克兰战争、中东战事以及大国间的战略竞争均表明,这不仅仅是技术上的渐进式改进,而是作战概念、力量结构、战争经济学以及武装冲突法层面的深刻变革。
|
||||||
|
|
||||||
|
四大趋势正驱动这场革命。其一,小型、廉价、可消耗无人机构成的威胁正迅速增长。其二,小型无人系统正扩散至陆地与海洋领域。其三,从直接操控单个系统转向在空、陆、海域运用蜂群,包括借助人工智能控制的综合蜂群。其四,人工智能正被集成至探测、目标识别、目标遴选、优先级排序和攻击环节,其程度日益将人类挤出决策流程。这引发了一个尤为严峻的困境:随着系统在判定合法目标以及何时可合法使用武力方面获得更大自主性,国际人道法的核心原则——区分、比例性、预防措施及人类责任——正日益承受压力[1]。
|
||||||
|
|
||||||
|
本文认为,主要威胁不在于自主平台本身,而在于其所代表的系统,该系统涵盖大规模生产、去中心化通信、学习型软件、廉价传感器、持续连通性,以及以大量无人系统替代士兵的作战意愿[2]。军事蜂群不仅仅是平台的集合,它是一个分布式、网络化、可扩展的系统,具备故障韧性。它可以由数十、数百甚至数千个平台运作,在平台间分配任务,替换损失平台,并在部分蜂群被摧毁后继续执行任务。在此环境中,优势转向能够缩短“传感器到射手”链条、运用协同蜂群并快速适应对抗措施的行动者。
|
||||||
|
|
||||||
|
## 无人系统构成的威胁正在升级
|
||||||
|
|
||||||
|
无人机已成为当代战争的决定性特征,因其改变了战场的成本—收益等式。一架仅耗资数百或数千美元的平台即可定位一支部队、调整炮火、打击装甲车辆、扰乱后勤或制造持续的心理压力。在乌克兰,FPV无人机、巡飞弹、无人地面车辆和无人水面艇已展现出与其成本极不相称的作战影响力。乌克兰已成为“未来战争的实验室”,廉价可消耗系统正在重塑作战方式,迫使大型军队迅速适应[3]。
|
||||||
|
|
||||||
|
这种升级在多个维度上显而易见。首先,无人机现已广泛可得,不仅被国家使用,也被非国家组织、民兵和小型战术单位所运用。其次,它们已被集成至打击周期的每个阶段:探测、识别、目标遴选、攻击和战斗损伤评估。第三,它们在充斥对抗措施的环境中运作,包括电子战、拦截系统、GPS干扰、轻武器火力及探测系统。因此,无人机正迅速向光学导航、替代通信、自主飞行、光纤制导以及沿不可预测航迹攻击等方向演进。最后,它们正在重塑认知作战空间:每一次移动都暴露于传感器之下,前沿区域已变得透明、受威胁且持续脆弱。
|
||||||
|
|
||||||
|
乌克兰冲突诠释了新型的“消耗战经济模式”。双方均不依赖少量昂贵平台,而是大量使用可消耗系统。乌克兰正在发展一种以人工智能赋能的自主战争概念,尽管技术雄心与广泛成熟的作战能力之间仍存在差距。这一教训至关重要:这场革命并非一蹴而就,而是通过数千次小型作战实验推进,其产生的学习速度超越任何传统采办流程[4]。
|
||||||
|
|
||||||
|
以色列同样认识到了日益增长的威胁。10月7日的袭击表明,小型简易无人机能够扰乱防御系统、损毁监视资产并为地面入侵提供便利。此后,以色列加速了探测、电子干扰和拦截工具的研发,同时将人工智能集成至轻武器和反无人机防御系统中。以色列正专注于相关技术,旨在通过集成传感器、软件以及改进的射击与瞄准能力,将单兵武器和战术系统转化为打击小型空中目标的有效手段[5]。
|
||||||
|
|
||||||
|
无人机防御不能仅依赖昂贵的拦截层。当攻击者运用大量小型廉价平台时,防御者无法始终以昂贵的导弹应对。需要的是一种多层架构,将早期探测、自动分类、电子战、干扰、接管能力、廉价动能火力、定向能、物理防护、欺骗以及基础设施的分散与加固结合起来。挑战不仅在于拦截单个平台,更在于打破攻击者的成本—收益等式[6]。
|
||||||
|
|
||||||
|
无人地面系统正迅速超越有限的支援角色,成为作战编队的内在组成部分。地面机器人最初主要用于破坏任务、爆炸物处理、危险区域侦察和物资运输。如今,它们日益被用于前沿后勤、伤员后送、开辟通路以允许部队推进、武装侦察和攻击任务。传感器、通信、自主导航和人工智能的集成使这些系统能够在有人部队前方运作,降低士兵风险,探测敌方力量,控制地形,并快速闭合火力循环。下一阶段将是部署同步的地面系统编队,即机器人蜂群。在同步蜂群中,一个平台执行侦察,另一个携带弹药或有效载荷,第三个充当通信中继,第四个支援后送或后勤。另一种模式是完全分布式的蜂群,像狼群一样攻击一支军事力量。因此,地面机器人技术正从一种点解决方案演变为一种可能改变地面机动本质的能力。
|
||||||
|
|
||||||
|
无人水面及水下系统同样正从孤立应用走向涵盖侦察、威胁和攻击的系统化概念。正如乌克兰和伊朗所展示的,小型廉价无人水面艇能够威胁军舰、港口和沿海基础设施,而无需使人员暴露于风险之中。与此同时,无人水下系统正通过将水雷布设、情报搜集以及对电缆、管道和关键基础设施的攻击延伸至海底,拓展威胁维度。未来将其集成至海上和水下蜂群,将使对手更难识别威胁来源、防御广阔海域并维持海上行动自由。
|
||||||
|
|
||||||
|
## 从空中蜂群到多域蜂群
|
||||||
|
|
||||||
|
从管理单个无人系统到运用蜂群的转变是一个转折点。蜂群不仅仅是“大量无人机”或“许多无人系统”,而是一个由众多平台共享信息、分配任务、互换角色并适应变化环境的系统。它也可以分布式方式运作,所有平台追求一个共同目标:定位并摧毁。蜂群的特征在于去中心化控制——没有单一领导者,但平台间保持持续通信,具备跨大量系统的可扩展性,以及基于算法和人工智能的相对自主性。一个有效的蜂群能够迷惑防御系统、饱和雷达覆盖、同时实施欺骗和攻击、在大范围区域内探测目标,并在损失部分力量后继续运作。其作战意义不仅在于平台数量,更在于其协调性和集体行为。
|
||||||
|
|
||||||
|
四种主要蜂群类型正在涌现:由无人机(UAV)和无人机组成的空中蜂群;由机器人和无人地面车辆组成的地面蜂群;由无人水面和水下艇船组成的海上及水下蜂群;以及综合蜂群——或称“蜂群之蜂群”——其中空中、陆地和海上平台在单一网络化指挥结构下运作。最后一种构成最严峻的挑战,因其模糊了作战域之间的边界,并要求防御者同时应对从不同维度、以不同节奏和不同特征到来的威胁。
|
||||||
|
|
||||||
|
空中蜂群能够饱和防空系统、探测目标,并同时运用“猎手”和“观察手”。在陆地上,无人系统可执行侦察、前沿后勤、伤员后送、布设爆炸装置或在火力下开辟通路。在海上,无人水面艇已证明其扰乱传统舰队、打击基础设施以及对港口、桥梁、海上平台和航运构成持续威胁的能力。乌克兰战场正在塑造空中、海上和陆地领域的自主战争未来[7]。
|
||||||
|
|
||||||
|
海上领域尤为重要,因其颠覆了关于海上优势的传统假设。一个没有常规海军的国家或组织,可以运用小型廉价自杀式无人水面艇来威胁大型军舰、港口和能源基础设施。在俄乌战争中,无人水面艇已变得足够有效,迫使俄罗斯舰队撤出黑海部分地区[8]。这让人得以一窥未来:海上和水下蜂群将与空中和地面蜂群一同作为单一综合系统的组成部分运作。
|
||||||
|
|
||||||
|
运作蜂群的核心挑战在于指挥与控制。随着平台数量增加,人类对每一个平台的直接控制变得不可能。因此,蜂群至少在路径选择、保持编队、目标分配、障碍规避和适应平台损失等功能上需要部分自主性。乌克兰的一些项目已使无人机和地面系统能够参与协同作战。这些项目减少了所需操作手的数量,同时将部分规划、任务分配和执行过程转移至算法[9]。即便人类作为监督者仍“在环内”,此人也会日益脱离实际的决策过程。
|
||||||
|
|
||||||
|
从以色列的视角来看,保持质量优势需要在传感器、人工智能、安全通信、反无人机技术和进攻性蜂群能力上取得优势。与此同时,以色列面对的对手能够迅速采用商业技术,从乌克兰、伊朗和真主党的经验中学习,并大量部署简单系统。因此,以色列必须将人工智能和自主系统——包括无人机、无人地面车辆和无人机蜂群——视为未来力量发展的必备组成部分,同时保留人类在决策过程中的角色[10]。
|
||||||
|
|
||||||
|
在此背景下,以色列国防军(IDF)总参谋长埃亚勒·扎米尔(Eyal Zamir)关于下一个多年期力量发展计划的论述尤为切题。他表示,该计划将加强机器人能力并将其集成至作战编队中,实现远程操作,改善地形控制和敌方探测,并加速“传感器到射手”链条。这反映出一种认识:地面机器人技术已不再仅仅是辅助性或实验性能力,而是作战编队的内在组成部分——它将地形控制、目标探测、机动、杀伤力和缩短“传感器到射手”链条集于一体[11]。
|
||||||
|
|
||||||
|
多域蜂群正在改变防御概念。仅保卫一国领空或边界已不再足够。基地、港口、发电站、供水设施、通信网络、交通路线和机动部队都必须受到保护,以抵御可能同时从空中、海上和陆地到来的威胁。因此,防御必须变得网络化、局部化、机动化和自适应化。它必须集成情报、网络能力、电子战、火力、物理防护和欺骗,并以与进攻性威胁演进相匹配的速度运作。
|
||||||
|
|
||||||
|
案例研究表明,没有任何单一蜂群模式占据主导。中国正在发展一种智能、多维度的蜂群概念[12];俄罗斯依赖数量规模、消耗和适应[13];乌克兰展示了快速创新[14];美国正在追求一种结合数量、软件、自主性和人类控制的“智能规模”概念[15]。在这些模式之中,共同教训是:蜂群将战争的重心从单个平台转移至系统行为。随着陆地、空中和海上领域的日益融合,防御者必须做的不仅仅是拦截单个平台,还必须理解运作模式、扰乱网络、打击生产和发射基础设施,并能够比敌人更快地作出决策。
|
||||||
|
|
||||||
|
## 人工智能、自主目标定位及将人类排除出决策过程的伦理维度
|
||||||
|
|
||||||
|
最危险的发展并非无人系统的大规模使用,而是蜂群与人工智能赋能的决策的结合。人工智能能够分析海量信息、识别模式、探测异常、遴选和排定目标优先级,甚至在没有具体人类指令的情况下操作无人平台。在此过程中,它在缩短军事决策周期的同时,将部分人类判断转移至机器。
|
||||||
|
|
||||||
|
法律辩论聚焦于致命性自主武器系统(LAWS)[16],即能够在不经人类干预的情况下选定并攻击目标的系统。据联合国裁军事务厅(UNODA)称,目前对此类系统尚无国际公认的定义。然而,各国正日益研发和部署具有自主功能的系统,包括巡飞弹、防御系统、无人地面车辆和无人海上平台[17]。缺乏公认定义并未减轻问题,相反,它使各国得以在一个技术进展快于法律进展的灰色地带运作。
|
||||||
|
|
||||||
|
国际人道法依据区分、比例性、预防措施和责任原则来评估新技术。然而,自主系统难以作出依赖具体情境的评估,特别是在战斗人员与平民混杂、信息不完整且快速变化、且行动的法律意义取决于微妙背景因素的环境中。2025年,红十字国际委员会呼吁在涉及武力使用的决策上保持有意义的人类控制,认为有效监管的窗口正在迅速关闭[18]。
|
||||||
|
|
||||||
|
联合国以格外强烈的措辞描述了这一危险。它呼吁禁止能够在没有人类控制或监督的情况下造成人员死亡的系统,称其在政治上不可接受且在伦理上成问题[19]。这一呼吁既是作战层面的,也是道德层面的。一台无法实时理解人类背景、意图、投降、受伤、平民身份或变化中的环境的机器,有可能将致命武力的使用变成一种自动化过程,同时破坏指挥责任。
|
||||||
|
|
||||||
|
在实践中,大多数军队并未采纳人类完全“出环”的模式,而是经历中间阶段:人类在环内、人类在环上,最终人类出环。在第一阶段,每次打击都需要人类批准。在第二阶段,人类监督并可干预,但系统执行大部分流程。在第三阶段,系统自行选定目标并使用武力。危险在于,从第二阶段向第三阶段的过渡可能不是通过明确的政策决定,而是通过软件改进、作战压力和缩短响应时间需求的累积效应而发生。
|
||||||
|
|
||||||
|
在以色列,围绕使用人工智能系统支持目标遴选和管理火力周期已出现一场辩论。必须区分将人工智能用作分析支援工具与授予其使用致命武力的自主权限。然而,即便是支援工具也可能产生“自动化偏见”,即人类操作手倾向于采纳系统的建议,因为其看起来更准确、更快速、更客观。集成此类自主系统可能造成责任缺口并加速杀伤链[20]。
|
||||||
|
|
||||||
|
法律和伦理问题并非始于武力的使用,而是始于算法识别模式、将某人或某平台指定为目标、在平台间分配任务并提出攻击优先级之时。人类操作手用来质疑机器建议的时间、背景和能力越少,人类控制就越流于形式。因此,核心问题不仅仅是系统中是否“有人类存在”,而是该人类能否理解系统的决策、阻止它并对其负责。
|
||||||
|
|
||||||
|
最大的危险在于“例外的常态化”。最初,引入人工智能是为了帮助人类操作手应对信息过载。随后,审查时间被缩短。再后来,系统允许对预定义类别的目标使用武力。最终,在蜂群、饱和攻击和以秒计的响应时间压力下,指挥官可能更偏好比人类决策更快的系统。当到达这一点时,国际法将面临既成事实:机器将决定谁受到伤害,而人类只能在事后解释为何未能干预。
|
||||||
|
|
||||||
|
仅仅聚焦于“杀手机器人”会错失核心挑战。自主性不是一种二元状态,而是一个能力连续体,可以以不同水平和局部应用的方式被纳入武器系统。因此,主要危险不局限于武器发射的那一刻,而在于搜索、识别、分类和排定目标优先级能力的逐步积累,直至人类操作手形式上仍在场,但不再充当相关的决策者[21]。
|
||||||
|
|
||||||
|
## 建议:为未来战场做好准备
|
||||||
|
|
||||||
|
为未来战场做准备需要概念上的转变,而不仅仅是获取新能力。多层防御必须集成探测、分类、电子战、廉价拦截、定向能武器、物理防护和欺骗。目标不仅仅是付出任何代价拦截每一架无人机,而是识别蜂群行为、扰乱同步、破坏网络并挫败敌人的攻击。
|
||||||
|
|
||||||
|
以色列应建立独立的蜂群能力。一支无法运作蜂群的军队将难以理解如何防御蜂群。这种能力应跨越空、陆、海领域,并立足于国内生产、持续的作战实验以及将一线部队集成至开发过程中。乌克兰的教训是:学习的速度几乎与平台本身的质量同等重要。
|
||||||
|
|
||||||
|
与扎米尔总参谋长的愿景一致,应将对地面部队的重新重视转化为人机综合作战编队的实际模式。因此,每个营级和旅级作战编队都应有机地运用无人机、地面机器人、传感器、通信系统和火力支援资产,确保机器人技术不局限于专业部队。这些机器人—人类编队将改善地形控制、加速敌方探测、实现危险区域的远程操作并缩短杀伤链,同时在敏感目标定位决策上保留人类监督。
|
||||||
|
|
||||||
|
以色列面临的威胁环境与较大国家不同。其战略纵深有限,周边多条战线,且对能源安全和贸易至关重要的海上领域。与此同时,它面对的国家和非国家对手均能产生严重的多域威胁。以色列不能等待昂贵、完全成熟的下一代自主系统出现,而必须通过基于实验、作战部署、经验教训、持续改进、迭代生产和快速集成至一线部队的快速作战学习来发展蜂群。
|
||||||
|
|
||||||
|
在进攻方面,以色列国防军应发展超越无人机范畴的多域蜂群能力。在空中,应发展用于侦察、欺骗、电子干扰和攻击的蜂群,使其能够在GPS拒止环境中对抗防空网络、定位发射器并追剿敌方细胞。在陆地上,应发展能够在有人部队前方运作、开辟通路、探测爆炸装置、搜索建筑物和隧道、运输物资并在减少士兵风险的同时实现精确攻击的机器人机动编队。在海上,应发展由无人水面和水下艇船组成的蜂群,用于侦察、保护海上平台和港口、威胁探测、欺骗、封锁海上航线以及对用于发射无人系统的敌方舰船或基础设施实施攻击。
|
||||||
|
|
||||||
|
在防御方面,以色列应从点拦截转向针对蜂群系统的防御。目标不应仅仅是探测单个平台,而是识别运作模式,包括发射位置、通信中继、接近路线、平台间功能分配以及饱和现有防御系统的企图。为支持这一方法,以色列应为机动部队、军事基地、港口、海上平台、发电站和其他关键设施开发局部防御包。这些防御包应集成短程探测、自动分类、干扰和电子扰乱、精确轻武器、廉价拦截器、欺骗措施、物理防护以及为应对饱和攻击而设计的操作程序。成功不应仅以拦截平台的数量来衡量,而应以扰乱蜂群的能力来衡量。当然,这种能力旨在补充——而非取代——针对导弹和火箭等既有威胁的防御。
|
||||||
|
|
||||||
|
以色列还应发展打击蜂群威胁价值链中每个环节的能力,包括生产中心、储存设施、发射场、通信中继、指挥控制系统、母舰和导航基础设施。这将通过把焦点从单个平台转移至支撑蜂群运作的更广泛系统,来补充局部防御措施。
|
||||||
|
|
||||||
|
蜂群时代还需要组织变革。除现有的发展局外,以色列国防军应设立一个作战机构,负责将地面、空中和海军部队与指挥、控制、通信、计算机与情报(C4I)局及国防研究与发展局(Mafat-DDR&D)集成起来。该机构应定义作战、通信、敌我识别、安全、网络安全、人类决策与控制文档记录的共同架构。不应允许个别军种孤立地发展独立的蜂群能力。只有当蜂群能力成为单一综合指挥控制系统的一部分时,以色列的比较优势才会显现。
|
||||||
|
|
||||||
|
以色列还应就运用人工智能和蜂群制定明确的法律和作战边界。应在决策支持系统与决策系统之间保持区分,并制定明确规则,规定蜂群可自主执行哪些行动、哪些行动需要人类授权,以及在何种情况下必须自动终止任务。任何影响目标遴选或打击的系统都应经过法律审查、可靠性测试、数据源的全面文档记录、可解释性评估、人类接管机制的纳入以及明确界定的指挥责任分配。不应允许任何无人系统在缺乏有效人类控制的情况下对人类使用致命武力。
|
||||||
|
|
||||||
|
以色列应发展一种“负责任的人类在环”学说。仅仅声明人类是系统的一部分是不够的。学说应界定“环内”人类拥有何种信息、何时应给予授权、如何能够终止攻击,以及在失败情况下承担何种责任。有效的人类控制不仅仅是按下按钮的形式行为,而是真正理解、评估和干预决策的能力。与此同时,民主国家应制定评估自主系统的共同标准,分享作战教训,并限制那些危及平民或破坏人类责任的系统。
|
||||||
|
|
||||||
|
最后,以色列应加强在力量建设方面的国际合作。在早前一篇论述以色列需要更大程度军备独立的文章中,我们提议建立一个致力于发展关键军事能力的国际联盟[22]。跨空、陆、海和水下领域的自主系统发展,似乎是此类合作的合适候选方向。
|
||||||
|
|
||||||
|
## 结论
|
||||||
|
|
||||||
|
未来战场已然在此。它由大规模部署的廉价系统、多域蜂群、以机器速度分析信息并作出决策的人工智能,以及技术所提供的可能性与法律和伦理监管能力之间日益扩大的鸿沟所定义。蜂群构成了一种系统性变革。它们结合了数量规模、行动节奏、冗余性、自主性和网络化,使其能够产生不依赖于任何单个平台、而取决于系统集体行为的效应。这场革命并未消除人类的角色,但除非重新定义这一角色,否则将使人类日益多余。
|
||||||
|
|
||||||
|
无人机改变了战争的经济学。蜂群正在改变其节奏。人工智能最终可能改变战争中责任本身的性质。未来的优势未必属于拥有最昂贵平台的一方,而属于能够构建学习型、网络化、廉价、冗余且快速适应系统的那一方——同时剥夺对手集体运作的能力。
|
||||||
|
|
||||||
|
因此,挑战是双重的:在取得技术优势的同时,维护军事决策的道义基础。正因机器能够比人类更快地观察、计算和打击,才需要更强有力的人类控制——不是作为法律装饰,而是作为作战与道义的双重保障。未来正以惊人的速度到来。问题在于我们是否为此做好准备,以及我们能否成功将责任留在人类手中。
|
||||||
|
|
||||||
|
[1] 区分原则要求武装冲突各方在战斗员与军事目标、平民与民用物体之间作出区分。不具备此种区分能力的武器或系统均受禁止。比例原则要求,相对于预期获得的具体和直接军事利益,预期对平民和民用物体造成的附带损害不得过分。预防措施原则要求武装冲突各方采取一切可行的预防措施,以避免或尽量减少对平民的损害,包括通过手段与方法的选择、警告以及取消攻击等方式。责任与问责虽不同于上述三项原则,并非规范敌对行动行为的经典原则,但依然是一项根本且具有约束力的原则。包括指挥官和操作手在内的国家与个人,仍须对遵守法律承担责任。
|
||||||
|
|
||||||
|
[2] Uzi Rubin, “Will Unmanned Aircraft Decide the War in Ukraine?,” Jerusalem Institute for Strategy and Security (JISS), May 27, 2026.
|
||||||
|
|
||||||
|
[3] Samuel Bendett and David Kirichenko, “Battlefield Drones and the Accelerating Autonomous Arms Race in Ukraine,” Modern War Institute, January 10, 2025.
|
||||||
|
|
||||||
|
[4] Kateryna Bondar, “Ukraine’s Future Vision and Current Capabilities for Waging AI-Enabled Autonomous Warfare,” Center for Strategic and International Studies, March 6, 2025.
|
||||||
|
|
||||||
|
[5] Pesach Benson and Omer Novoselsky, “Israeli AI Turns Standard Rifles into Drone Killers,” TPS-IL, February 9, 2026.
|
||||||
|
|
||||||
|
[6] Sven Clement, “Mastering the Future of Uncrewed Warfare,” NATO Parliamentary Assembly, October 12, 2025.
|
||||||
|
|
||||||
|
[7] Peter Dickinson, “Ukraine Is Shaping the Future of Drone Warfare at Sea as Well as on Land,” Atlantic Council, June 12, 2025.
|
||||||
|
|
||||||
|
[8] Tsiporah Fried, “The Impact of Drones on the Battlefield: Lessons of the Russia-Ukraine War from a French Perspective,” Hudson Institute, November 13, 2025.
|
||||||
|
|
||||||
|
[9] Patrick Tucker, “This Ukrainian Startup Has Re-Invented Drone Swarming,” Defense One, September 15, 2025.
|
||||||
|
|
||||||
|
[10] Anna Ahronheim, “Israel’s Strategic Edge in the Age of AI & Autonomous Warfare,” The Jerusalem Post, July 20, 2025.
|
||||||
|
|
||||||
|
[11] Yoni Kempinski, “Chief of Staff: We Will Build a Decisive Ground Force,” Arutz Sheva, July 23, 2026.
|
||||||
|
|
||||||
|
[12] Timothy Ditter, “PRC Concepts for UAV Swarms in Future Warfare,” CNA, November 7, 2025. https://www.cna.org/analyses/2025/10/prc-concepts-for-uav-swarms-in-future-warfare
|
||||||
|
|
||||||
|
[13] Missile Defense Advocacy Alliance, “MDAA Alert: Russia’s Advancing Geran Family of Attack Drone Capabilities,” June 29, 2026. https://www.missiledefenseadvocacy.org/alerts/mdaa-alert-russias-advancing-geran-family-of-attack-drone-capabilities
|
||||||
|
|
||||||
|
[14] Vlad Cherevko, “Ukrainian Forces Using Drone Swarms That Autonomously Locate and Strike Targets—WSJ,” Ukrainska Pravda, September 3, 2025. https://www.pravda.com.ua/eng/news/2025/09/03/7529154
|
||||||
|
|
||||||
|
[15] Thomas Novelly, “Anduril, General Atomics Get Air Force Contracts to Build First Drone Wingmen,” Defense One, June 17, 2026. https://www.defenseone.com/defense-systems/2026/06/anduril-general-atomics-get-air-force-contracts-build-first-drone-wingmen/414266
|
||||||
|
|
||||||
|
[16] The term LAWS stands for lethal autonomous weapons systems. These are AI-enabled military systems capable of identifying, selecting, and engaging targets without human intervention in the operational decision-making loop.
|
||||||
|
|
||||||
|
[17] United Nations Office for Disarmament Affairs, “Lethal Autonomous Weapon Systems,” accessed July 26, 2026.
|
||||||
|
|
||||||
|
[18] Mirjana Spoljaric, “Preserving Human Control over the Use of Force,” International Committee of the Red Cross, May 12, 2025.
|
||||||
|
|
||||||
|
[19] UN News, “‘Politically Unacceptable, Morally Repugnant’: UN Chief Calls for Global Ban on ‘Killer Robots,’” May 14, 2025.
|
||||||
|
|
||||||
|
[20] Ramón Reichert, “Autonomous Occupation: Israel’s AI-Driven Drone Warfare and the Digital Architecture of Authoritarian Power,” Dialogues on Digital Society 1, no. 3 (2025).
|
||||||
|
|
||||||
|
[21] Gabi Siboni and Yoni Eshpar, “Dilemmas in the Use of Autonomous Weapons,” Strategic Assessment 16, no. 4 (January 2014).
|
||||||
|
|
||||||
|
[22] Gabi Siboni and Erez Winner, “Israel’s Path to Armaments Independence,” Jerusalem Institute for Strategy and Security (JISS), July 24, 2026.
|
||||||
|
|
||||||
|
本文来源:专知智能防务
|
||||||
@@ -0,0 +1,80 @@
|
|||||||
|
# 📊 文章摘要:未来战场已然来临:大规模廉价无人系统、多域蜂群、人工智能
|
||||||
|
|
||||||
|
> **原文**:[2026-08-20_未来战场已然来临_大规模廉价无人系统_多域蜂群_人工智能](./2026-08-20_未来战场已然来临_大规模廉价无人系统_多域蜂群_人工智能.md)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/g57nYwvtj-kllPxX5s9l5g
|
||||||
|
> **来源**:微信公众平台
|
||||||
|
> **作者**:专知防务
|
||||||
|
> **发布日期**:2026-08-20
|
||||||
|
> **摘要日期**:2026-08-20
|
||||||
|
> **价值评级**:⭐⭐⭐ 高
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 核心命题
|
||||||
|
|
||||||
|
> **蜂群系统战** — 未来战场优势取决于廉价、网络化、可学习系统的集体行为而非单一平台性能;机器速度越快,越需要强化而非弱化人类控制。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 文章概要
|
||||||
|
|
||||||
|
本文是编译类战略研究长文(文内注释指向以色列战略与安全研究所 JISS 等来源,共 22 条脚注,信息截至 2026-07),系统论述无人系统战争的四大趋势及其后果:廉价无人机改变战争成本—收益等式、无人系统向陆海扩散、从单平台操控转向多域蜂群、AI 进入"探测—识别—遴选—攻击"链路并将人类挤出决策流程。核心论点是:主要威胁不在自主平台本身,而在其背后的系统(大规模生产+去中心化通信+学习型软件+廉价传感器+持续连通性+以无人系统替代士兵的意愿);蜂群的战斗力来自集体行为与冗余,战争重心从平台转向系统。后半部分聚焦 LAWS 的法律与伦理困境,提出"环内→环上→环外"三阶段滑移与"例外的常态化"两个概念工具,主张"负责任的人类在环"学说,并给出以色列十条建军建议。局限:以色列视角鲜明,建议部分含智库政策推销成分;对蜂群在电子战环境下的技术脆弱性着墨很少。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 关键要点
|
||||||
|
|
||||||
|
1. **威胁是系统而非平台** — 主要威胁不在于自主平台本身,而在于其代表的系统:大规模生产、去中心化通信、学习型软件、廉价传感器、持续连通性,以及以无人系统替代士兵的作战意愿 `[分类: 范式突破]`
|
||||||
|
2. **成本等式的攻防反转** — 数百美元的平台撬动不成比例的战果;防御方无法用昂贵导弹逐架拦截,目标是"打破攻击者的成本—收益等式"而非拦截每个平台 `[分类: 共识]`
|
||||||
|
3. **蜂群四类型与综合蜂群** — 空中/地面/海上水下蜂群之上出现"蜂群之蜂群"(单一网络化指挥结构下跨域运作),模糊作战域边界、最防御难 `[分类: 共识]`
|
||||||
|
4. **蜂群 C2 必然部分自主** — 平台数量增加后人无法逐个控制;乌克兰项目已在减少操作手数量,把规划与任务分配转移给算法 `[分类: 共识]`
|
||||||
|
5. **人类角色三阶段滑移** — 人在环内→人在环上→人出环;危险在于第二→第三阶段的过渡不是由明确政策决定,而是通过软件改进、作战压力和缩短响应时间的累积效应悄然发生 `[分类: 范式突破]`
|
||||||
|
6. **"例外的常态化"** — AI 先帮人应对信息过载→审查时间缩短→预定义类别目标可开火→指挥官偏好更快的机器;最终国际法面对既成事实 `[分类: 范式突破]`
|
||||||
|
7. **人类控制的实质标准** — 核心问题不是系统里"是否有人类存在",而是该人类能否理解系统的决策、阻止它并对其负责 `[分类: 共识]`
|
||||||
|
8. **各国模式分化** — 中国(智能、多维度蜂群)、俄罗斯(数量规模与消耗)、乌克兰(快速创新)、美国(数量+软件+自主性+人类控制的"智能规模");共同教训:学习速度几乎与平台质量同等重要 `[分类: 共识]`
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 批判性分析
|
||||||
|
|
||||||
|
### 假设前提
|
||||||
|
- 以色列安全视角贯穿全文:战略纵深有限、多战线、海上生命线依赖,结论(快速部署、局部防御包、国际联盟)由该处境推导,向其他国家安全环境外推需谨慎。
|
||||||
|
- 假定技术扩散不可逆、"有效监管的窗口正在迅速关闭",这是论证立场而非经检验的事实。
|
||||||
|
- "自主性是能力连续体而非二元状态"这一前提支撑了全文渐进式分析,同时也弱化了"禁令派"(联合国、红十字)方案的可行性论证。
|
||||||
|
|
||||||
|
### 论据与逻辑
|
||||||
|
- 证据密度高:22 条脚注覆盖 JISS、CSIS、Modern War Institute、北约议会、联合国裁军事务厅、红十字国际委员会等,来源多元可溯源;乌克兰、以色列、俄乌黑海等案例具体。
|
||||||
|
- 逻辑主线(趋势→系统属性→防御概念→伦理→建议)完整;但从"趋势描述"跳到"以色列应设立蜂群作战机构、发展打击价值链各环节能力"的建军建议存在立场跳步,机构设置与国际联盟主张含智库政策游说成分。
|
||||||
|
- 反证讨论不足:蜂群在强电子战/通信干扰环境下的脆弱性、集群算法的成熟度、误识别的法律后果等可能削弱结论的证据几乎未展开。
|
||||||
|
|
||||||
|
### 边界与局限
|
||||||
|
- 边界意识较强:明确区分"决策支持系统"与"决策系统";承认 LAWS 尚无国际公认定义、各国在灰色地带运作;承认乌克兰"技术雄心与广泛成熟的作战能力之间仍存在差距";防御建议注明是补充而非取代传统防空。
|
||||||
|
- 结构性局限:编译文本(原文为英文战略评论),译文体痕迹明显;"建议"章节约占全文四成,使文章后半从分析滑向政策方案推销。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 可引用金句
|
||||||
|
|
||||||
|
> "无人机改变了战争的经济学。蜂群正在改变其节奏。人工智能最终可能改变战争中责任本身的性质。"
|
||||||
|
|
||||||
|
> "正因机器能够比人类更快地观察、计算和打击,才需要更强有力的人类控制——不是作为法律装饰,而是作为作战与道义的双重保障。"
|
||||||
|
|
||||||
|
> "核心问题不仅仅是系统中是否'有人类存在',而是该人类能否理解系统的决策、阻止它并对其负责。"
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 总体评价
|
||||||
|
|
||||||
|
**亮点**:
|
||||||
|
- "系统对平台"的威胁重构框架、"环内→环上→环外"三阶段滑移、"例外的常态化"三个概念工具均有强迁移价值,可直接用于民用 AI 自主系统的治理讨论(自动化偏见、人类监督设计)。
|
||||||
|
- 22 条注释体系完整可溯源,在公众号文章中罕见。
|
||||||
|
|
||||||
|
**不足**:
|
||||||
|
- 以色列立场贯穿建议部分,游说成分稀释分析客观性;技术反证(抗干扰、可靠性、误伤)缺失;编译翻译腔明显。
|
||||||
|
|
||||||
|
**适用场景**:
|
||||||
|
- 军事 AI 与国际人道法研究、无人系统产业与政策分析、AI 自主性治理与人类监督机制设计的跨领域参考。
|
||||||
|
|
||||||
|
**关联建议**:
|
||||||
|
- 与同日归档的阿颖《对 GLM-5.3 的真实评价》形成"能力上游—应用下游"对照:后者讲模型长程 Agent 能力如何练出来,本文讲长程自主系统投入使用后人类控制如何设计。
|
||||||
|
- "自动化偏见""例外的常态化"概念可与 Agent 工程中的人机审批环节设计交叉引用。
|
||||||
@@ -0,0 +1,64 @@
|
|||||||
|
# Kimi K3之后:开源还是闭源,这是个问题
|
||||||
|
|
||||||
|
> **来源**:微信公众平台(侯宏)
|
||||||
|
> **作者**:侯宏
|
||||||
|
> **发布日期**:2026-08-20(原文未标注明确日期,按下载日占位)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/hybZIAHrShl4xunoTf3hiQ
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
|
||||||
|
|
||||||
|
中美AI竞争常被概括为"开源对闭源"的竞争:中国头部模型厂商更倾向开放权重,美国最强的frontier models则主要由OpenAI、Anthropic等闭源实验室控制。这大体符合事实,但任何决策都不是理所当然和一成不变的,在技术与商业图景尚未稳定的AI产业尤其如此。
|
||||||
|
|
||||||
|
7月Kimi K3发布后引发美国政商界争论,尤其是《开放权重与美国的AI领先地位》公开信为我们透视"开源vs闭源"的复杂考量提供了窗口。透过它,可以看到更复杂、动态也更深刻的产业图景。
|
||||||
|
|
||||||
|
## 一、K3引发的政策争论
|
||||||
|
|
||||||
|
7月初发布的Kimi K3创造了中美AI竞争的第二个Deepseek时刻。它的出现强化了一个趋势:中国模型不再只是以低成本追赶美国闭源模型,而开始借助开放策略争夺全球开发者、企业用户与技术生态。这一变化很快进入美国政策讨论。
|
||||||
|
|
||||||
|
此前Anthropic已多次强调,中国模型厂商可能通过对美国闭源模型进行大规模distillation来缩短能力差距,并主张将模型访问控制与先进芯片出口限制共同纳入美国AI竞争政策。K3发布后,美国政府官员进一步将中国模型追赶、知识产权、distillation和国家安全联系起来,潜在逻辑是:中国开放模型追赶美国 → 美国技术和安全利益受损 → 美国应限制open weights。
|
||||||
|
|
||||||
|
7月24日,NVIDIA、Meta、Microsoft、Google、IBM等273家AI企业或研究机构联合签署公开信《Open Weights and American AI Leadership》。这封公开信没有提及具体模型或国家。它采用的是更一般化的论证方式:重新界定AI领先地位的来源,并澄清看似自然、实则并不必然成立的因果关系。
|
||||||
|
|
||||||
|
## 二、公开信的抗辩逻辑
|
||||||
|
|
||||||
|
公开信明确提出,"美国的AI领导地位不取决于某个前沿模型能力,而取决于美国能否建立一个能够渗透到各行各业的强大而开放的AI生态...美国赢得AI时代并非因为拥有最强模型,而因为AI能进入工厂、医院、农场、课堂和大量企业的工作流"
|
||||||
|
|
||||||
|
开放权重模型是这一愿景不可或缺的基础设施!公开信强调开源模型相对于闭源模型的两个具体优势。
|
||||||
|
|
||||||
|
一方面,开源模型刺激全方位的供给侧竞争,避免少数企业垄断产业利益(此处Nvidia应脸红)。比如,闭源模型的配套服务通常由闭源模型厂商独家提供,但开源模型的配套服务可以由广泛的、无需授权的第三方厂家提供。再比如,如果只有大型银行才能用得起的高价闭源模型,小型银行就可能被进一步边缘化;反之,小型银行可以与大型银行在同一AI模型的起跑线上进行服务创新的竞争。
|
||||||
|
|
||||||
|
另一方面,开源模型使得用户掌控自身数据与知识。这无疑促进了AI采纳,因为用户无需担忧被锁定在单一供应商上。公开信隐晦地回应了闭源模型厂商吸纳用户知识以训练自身模型的担忧,写道:当组织利用AI创新时,开放权重允许它们通过自发改进模型、专有能力和知识沉淀以拥有(own)该创新的价值。这一段原文使用了"American sovereignty"一词。它的意思不是美国的国家主权,而更接近美国企业的技术或智能自主权:美国企业、公共机构乃至整个美国经济对关键AI能力保持自主控制,而不被少数模型供应商锁定或失去自身积累的知识与能力。
|
||||||
|
|
||||||
|
在阐明开源优势的前提下,公开信进一步把开源和三个莫须有的罪名解绑。
|
||||||
|
|
||||||
|
首先,将开放权重与与价值流失解绑。从单一模型厂商看,开放权重确实会削弱API租金和技术排他性;但从整个产业体系看,模型成本下降可能扩大芯片、云计算、企业软件和下游应用市场。换言之,模型层的收益下降不等于整个美国AI产业的价值捕获能力下降,价值可能向互补资产重新分配。
|
||||||
|
|
||||||
|
其次,将开放权重与不安全解绑。Anthropic主打安全牌。公开信首先承认AI模型的滥用确实会导致安全问题, 但它紧接着指出,闭源模型同样可能被攻破、滥用或发生外部无法观察的失效。并且,闭源模型把安全风险的管控寄托在"单点"上,失败的风险可能更高。与之相比,开放能扩大模型审查、漏洞发现、组队防御。
|
||||||
|
|
||||||
|
最后,将蒸馏与盗用/misappropriation解绑。公开信直接要求政策制定者不要混淆合法的模型开发技术与misappropriation,并指出蒸馏是模型改进、评估和验证中广泛使用的方法。同时,它也明确承认,"unlawful efforts to extract value from closed models raise legitimate concerns",但这些问题应通过targeted legal and commercial frameworks处理,而不应转化为对重要模型开发技术的普遍限制。
|
||||||
|
|
||||||
|
值得指出的是,公开信并未主张最先进模型都应开放。相反,它明确提出不同任务应匹配不同层次的模型。其政策主张不是以开放模型取代闭源frontier models,而是建议美国维持plural frontier:支持开放生态并不等于放弃frontier优势。
|
||||||
|
|
||||||
|
## 三、公开信背后的产业共识
|
||||||
|
|
||||||
|
谁都知道开源模型是中国在引领,怎么和美国的领导地位扯上关系了呢?通过解读大家明白,它着眼的不是模型能力的竞争,而是经济体系吸纳模型能力、转化为产业竞争力的竞争。从这个标尺看,不管黑猫白猫,能够提升产业竞争力的就是好猫。这个立场非常符合美国政策制定者的一贯立场,应该起到了一定的效果。
|
||||||
|
|
||||||
|
但是,国家利益与特定厂商的利益并不必然一致。对于A和O两家闭源厂商,开源模型是强劲的替代者,直接影响其上市估值,进而影响到背后的诸多投资人。
|
||||||
|
|
||||||
|
有趣的是,微软、Nvidia、Amazon、Google等作为这两家企业的主要投资人都签署了这份公开信。好理解:它们都是产业投资人,相对于开源为它们的业务(主要是云业务)带来的持续正向刺激,一次性的财务收益不具备战略性。
|
||||||
|
|
||||||
|
更有趣的是,至少有9家投资公司签署了该公开信。其中不少是专注于开源生态、AI基础设施领域和早期start-up的投资公司(如A16z,YC),但也不乏这两家企业的股东。尤其是ARK, 目前重仓OpenAI 和Anthropic,仍然签署了公开信。一个合理的解释是,这些追求portfolio而非特定case投资回报的专业投资公司相信,未来的价值更多分布在开源生态及其土壤上长出来的应用生态中。
|
||||||
|
|
||||||
|
这封几乎所有美国AI玩家共同签署的公开信,代表了一个与政策视角并无矛盾的产业共识。然而,开源模型的商业模式是什么?土壤上会开出美丽的花朵、结出丰硕的果实,但土壤自身的商业模式并不清晰。公开信所强调的开源的各种优势,都可以概括为一个术语:外部性,即其所创造但外溢而无法捕获的价值。
|
||||||
|
|
||||||
|
## 四、中国的问题:开源模型的商业模式
|
||||||
|
|
||||||
|
商业模式问题对美国工商业界并不急迫,因为开源玩家主要是中国企业。这些玩家已上市或即将上市,在投资人的高期待下面临高增长、高亏损的困境。我并不看好这些企业的商业前景(单就其作为模型提供商的定位而言),因为开源商业的难处在于,开源的对象不仅包括用户和开发者,也包括竞争对手。
|
||||||
|
|
||||||
|
大模型这个行业有其内在的缺陷。早期,它的问题在于上游英伟达的垄断,而今TPU、AMD、博通等的努力已经把英伟达的份额大幅降低。现在,它的问题在于同业竞争过于激烈。闭源模型对于蒸馏技术的存在恨之入骨,正因为后者使得竞争对手可以从输出中反推其内部结构,进而快速提升性能。闭源尚且如此,开源就更不用说了。有人会说,现在大模型行业不就这几个玩家了吗,垄断收益在望。殊不知,开源和垄断在定义上就不可兼容。从全球来看,没有新玩家介入基模行业,很可能不是不能,而是不愿——既然有开源的,做freeridder何乐而不为呢?
|
||||||
|
|
||||||
|
资本耐心有限,开源商业模式必须自救。一个信号是,接近IPO的Kimi最近修改了K3的开源条款,要求云平台部署其"开源"版本时必须另签协议——这已背离开源的经典定义了。我相信这一步未来会走得更远、迈得更大,跟随的开源厂商会更多。从商业角度无可厚非,但本文前半段所描绘的种种好处,可能逐步缩水了——这不是政府愿意看到的。对当局而言,当务之急可能不在于限制中国开源模型流入它国,而是设法确保国内的开源氛围维持而不至于在水面下暗暗转向其对立面。
|
||||||
|
|
||||||
|
要找到产业利益和国家利益的契合点,有一个思路供参考。那就是,采取市场手段而非行政手段限制开源模型的外流。这个市场手段就是Kimi已经在尝试的渠道加价,但该策略只应针对海外云平台,而对国内云平台豁免。这种歧视性定价用面向特定国家的开源税来补贴国内市场,符合国际政治与企业发展的双重需要。
|
||||||
@@ -0,0 +1,80 @@
|
|||||||
|
# 📊 文章摘要:Kimi K3之后:开源还是闭源,这是个问题
|
||||||
|
|
||||||
|
> **原文**:[2026-08-20_Kimi_K3之后_开源还是闭源_这是个问题](./2026-08-20_Kimi_K3之后_开源还是闭源_这是个问题.md)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/hybZIAHrShl4xunoTf3hiQ
|
||||||
|
> **来源**:微信公众平台
|
||||||
|
> **作者**:侯宏
|
||||||
|
> **发布日期**:2026-08-20
|
||||||
|
> **摘要日期**:2026-08-20
|
||||||
|
> **价值评级**:⭐⭐⭐ 高
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 核心命题
|
||||||
|
|
||||||
|
> **生态主导权** — AI 领先地位的竞争不是"最强模型"之争,而是经济体系吸纳模型能力、转化为产业竞争力的生态之争;开源的商业软肋(外部性无法捕获)才是中国模型厂商的真正考题。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 文章概要
|
||||||
|
|
||||||
|
本文以 Kimi K3 发布后美国政商界的反应为切口,深度解读 273 家机构联署的《Open Weights and American AI Leadership》公开信,提出一个重新框定竞争的视角:美国的 AI 领导地位不取决于某个前沿模型,而取决于开放生态对各行各业的渗透。文章三层递进:先拆解公开信的抗辩逻辑(开源与价值流失、不安全、盗用三个"罪名"解绑),再分析签署方结构揭示产业共识与投资人利益分化(连重仓 OpenAI/Anthropic 的 ARK 都签了),最后把问题转回中国——开源优势本质是"外部性",土壤本身没有商业模式,Kimi 修改 K3 开源条款正是自救信号。作者立场鲜明(不看好开源模型厂商作为模型提供商的商业前景)并给出政策建议。局限:对公开信的解读是一家之言,"开源税"建议的可行性未论证。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 关键要点
|
||||||
|
|
||||||
|
1. **重新界定 AI 领先地位来源** — "美国赢得AI时代并非因为拥有最强模型,而因为AI能进入工厂、医院、农场、课堂和大量企业的工作流"——竞争标尺从模型能力切换为经济体系吸纳能力 `[分类: 范式突破]`
|
||||||
|
2. **公开信三大解绑** — 开源与价值流失解绑(模型层收益下降≠产业价值捕获下降,价值向互补资产再分配);开源与不安全解绑(闭源单点风控失败风险更高);蒸馏与盗用解绑(蒸馏是广泛使用的合法开发技术)`[分类: 共识]`
|
||||||
|
3. **plural frontier 主张** — 公开信并不主张最先进模型都开放,而是维持多元前沿:支持开放生态≠放弃 frontier 优势 `[分类: 共识]`
|
||||||
|
4. **投资人立场分化揭示价值判断** — 产业投资人(微软/Nvidia/Amazon/Google)为云业务的持续正刺激签信;连重仓 OpenAI/Anthropic 的 ARK 也签——专业投资公司相信未来价值分布在开源生态及其上的应用生态 `[分类: 范式突破]`
|
||||||
|
5. **开源优势 = 外部性** — 公开信强调的开源好处都可概括为"所创造但外溢而无法捕获的价值";土壤能开花结果,但土壤自身商业模式不清晰 `[分类: 范式突破]`
|
||||||
|
6. **开源与垄断定义上不兼容** — 全球无新玩家进入基模行业不是"不能"而是"不愿"——有开源的,做 freerider 何乐而不为 `[分类: 争议]`
|
||||||
|
7. **Kimi 修改 K3 开源条款是转折信号** — 云平台部署"开源"版本须另签协议,已背离开源经典定义;作者预判这一步会走得更远、跟随者更多 `[分类: 未探索方向]`
|
||||||
|
8. **歧视性定价"开源税"建议** — 市场手段而非行政手段限制外流:渠道加价只针对海外云平台、国内豁免,用面向特定国家的开源税补贴国内市场 `[分类: 争议]`
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 批判性分析
|
||||||
|
|
||||||
|
### 假设前提
|
||||||
|
|
||||||
|
(1) 公开信真实反映签署方共识而非策略性表态——273 家联署机构利益各异,联署行为与实际立场可能脱节;(2) "产业竞争力吸纳能力"这把新标尺优于模型能力标尺——这服务于开放阵营的论证需要;(3) 中国开源厂商必然走向条款收紧——Kimi 单例被外推为趋势。
|
||||||
|
|
||||||
|
### 论据与逻辑
|
||||||
|
|
||||||
|
论证强度高:用签署方结构(谁签了、谁重仓谁)做利益分析,是文本之外的有效证据;对公开信原文(如 American sovereignty 一词)做了贴近原文的辨析。薄弱处:对中国厂商商业前景的否定("我并不看好")是判断而非论证;"开源税"建议未讨论 WTO 合规性与报复风险;将 Kimi 条款修改直接解读为"商业模式自救",也存在安全性/合规性解释的可能。
|
||||||
|
|
||||||
|
### 边界与局限
|
||||||
|
|
||||||
|
适用于理解中美 AI 政策博弈与开源商业模式的结构性问题;不适用于具体厂商投资决策(作者明确限定"单就其作为模型提供商的定位而言",未评估其整体业务)。文中 A/O 等代称与坊间传闻(如 Grok Bot 团队背景)需读者自行核实。预测性判断(条款收紧会扩大)有待时间检验。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 可引用金句
|
||||||
|
|
||||||
|
> "美国赢得AI时代并非因为拥有最强模型,而因为AI能进入工厂、医院、农场、课堂和大量企业的工作流"
|
||||||
|
|
||||||
|
> "公开信所强调的开源的各种优势,都可以概括为一个术语:外部性,即其所创造但外溢而无法捕获的价值。"
|
||||||
|
|
||||||
|
> "开源和垄断在定义上就不可兼容。从全球来看,没有新玩家介入基模行业,很可能不是不能,而是不愿——既然有开源的,做freeridder何乐而不为呢?"
|
||||||
|
|
||||||
|
> "当务之急可能不在于限制中国开源模型流入它国,而是设法确保国内的开源氛围维持而不至于在水面下暗暗转向其对立面。"
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 总体评价
|
||||||
|
|
||||||
|
**亮点**:
|
||||||
|
- 罕见地把公开信当作文本来精读,逐条拆解论证结构而非停留在立场站队
|
||||||
|
- 用签署方持仓结构做利益分析,证据运用娴熟
|
||||||
|
- 把美国政策辩论转译为中国厂商商业模式问题,视角转换有洞察
|
||||||
|
|
||||||
|
**不足**:
|
||||||
|
- 对中国厂商的负面预判论证不足,带有较强个人立场
|
||||||
|
- "开源税"建议的可操作性、合规性未展开
|
||||||
|
- 未讨论开源模型安全评估等技术与治理维度
|
||||||
|
|
||||||
|
**适用场景**:AI 产业政策研究、开源战略制定、大模型厂商商业模式分析、中美科技竞争跟踪
|
||||||
|
|
||||||
|
**关联建议**:可对照公开信原文(Open Weights and American AI Leadership)与 Anthropic 关于 distillation 的政策文件阅读;跟踪 Kimi/DeepSeek/Qwen 后续开源条款变化验证作者预判
|
||||||
@@ -0,0 +1,74 @@
|
|||||||
|
# 2026制造业生死局:工业大模型落地,AI智能体进厂,正在重构工厂的生存法则
|
||||||
|
|
||||||
|
> **来源**:微信公众平台(墨执子)
|
||||||
|
> **作者**:墨执子
|
||||||
|
> **发布日期**:2026-08-20(原文未标注明确日期,按下载日占位)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/WX5ysyywBrx5Nnb7JyKKeg
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
|
||||||
|
|
||||||
|
**墨算未来**
|
||||||
|
|
||||||
|
墨科技演进,算未来气象
|
||||||
|
|
||||||
|
|
||||||
|
|
||||||
|
2026年,在中国的制造业江湖里,流传着一个让所有厂长都睡不着觉的消息:那位传说中的“新师傅”,终于要大范围进厂了。
|
||||||
|
|
||||||
|
这位“新师傅”不吃饭、不睡觉、不闹情绪,更不会在关键时刻撂挑子。它的出现,不是为了简单地抢谁的饭碗,而是要彻底改写工厂的生存法则。
|
||||||
|
|
||||||
|
过去几十年,咱们的工厂经历过两次脱胎换骨的改造。现在回头看,那两次不过是热身,真正的深水区变革,才刚刚开始。这不是简单的给旧机器换个新零件,而是一场生存法则的彻底重置。
|
||||||
|
|
||||||
|
很多年前,制造业迎来了第一次蜕变。那时候,大家喊的口号是“自动化”。核心思路很朴素:把人的体力劳动,交给机器。
|
||||||
|
|
||||||
|
流水线转起来了,机械臂挥起来了。拧螺丝、焊接、搬运,这些累活、重复活,机器全包了。它解决了一个核心问题:“干”的问题。以前需要十个壮小伙才能搬动的钢材,现在一个机械臂轻松拿捏,又快又稳,还不用倒班。但那时候的机器,脑子是一根筋。你让它往东它绝不往西,你给它编好的程序是1,它绝不会给你干出个2来。它是个能干但不会想的好把式,遇到程序里没有的新情况,立马就傻眼。
|
||||||
|
|
||||||
|
后来,大家觉得光能干还不行,还得能“看”。于是,第二次蜕变来了,叫“数字化”。人们在机器上、产线上,密密麻麻地安上了无数的小眼睛,也就是传感器。温度、压力、转速、振动频率,这些过去凭老师傅手感才能感知到的模糊信息,瞬间变成了电脑屏幕上精确的数字。生产线哪台设备在偷懒,哪个环节在发烧,一目了然。它解决的是“看”的问题。厂长们终于不用天天泡在嘈杂的车间里,坐在有空调的办公室就能看清一切。可新问题又来了,看到了,然后呢?数据是死的,像医院的体检报告,只告诉你哪里指标异常,却不会告诉你病因,更不会帮你开药方。分析和决断,还得靠经验丰富的老专家。
|
||||||
|
|
||||||
|
现在,第三次蜕变的浪潮已经拍到了工厂围墙边,这就是“智能化”。它要解决最核心的那个问题:“想”的问题。它的主角,就是这位不吃不睡的“新师傅”,一种基于工业大模型和智能体技术的新型智慧。这位新师傅不仅能干,能看,最关键的是,它能自己琢磨事。它能24小时不间断地盯着每一台设备的呼吸和心跳,从浩如烟海的数据里瞬间揪出异常的苗头,然后自己分析,自己判断,自己给出调整指令。以前是人来当家作主,现在是这位新师傅来替你运筹帷幄。这不是多了一个帮手,而是换了一种思考模式,是从“人治”到“智治”的跨越。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
为什么工厂对新师傅如此渴望?
|
||||||
|
|
||||||
|
全世界的工厂老板,无论大江南北,愁的几件事高度一致。而这些发愁的事,恰好撞在了这位新师傅的枪口上。
|
||||||
|
|
||||||
|
工厂里的第一愁,是事情多到管不过来。一条现代化的产线,成百上千台设备,涉及上千个参数,上万个变量。这些变量之间还相互拉扯、互相影响,其复杂程度远超常人想象。靠几个经验丰富的车间主任和老师傅,就算把头发熬白了,也根本盯不住、调不好。而新师傅最拿手的就是处理这种极端复杂的局面。在它看来,再多参数也不过是一堆数字游戏,它能轻松地从中理出头绪,找到那条通往最高效、最稳定的黄金路线。
|
||||||
|
|
||||||
|
第二愁,是绝活全在老师傅脑子里。很多工厂都有几位镇厂之宝级别的老师傅。机器闹脾气,别人听半天没动静,他过去听一耳朵,就知道哪个齿轮该上油了。工艺出了瑕疵,别人调整半天不管用,他随手拨弄几个参数,产品质量立马就稳了。但这些手艺,往往只可意会不可言传,都装在他们的大脑中。老师傅一退休,这些宝贵的经验和诀窍也就跟着离开了。新徒弟上来,又得重新交学费、踩大坑。而新师傅最厉害的本事,就是能把老师傅的绝活给“学”过来,并且永久地沉淀下来。它不是靠喝大酒拜师学艺,而是将老师傅每一次成功的判断和操作,都转化为算法模型里的一组数据、一条规律。人走了,经验不仅留下来了,还能被整个工厂共享。它还能像炼蛊一样,结合成千上万个案例,不断学习和优化,最终变成一个永不退休、技艺还日益精进的超级老师傅。
|
||||||
|
|
||||||
|
第三愁,是市场大环境变得太快。今天客户要A款,明天就流行B款了。原材料的价格也是上蹿下跳,跟坐过山车似的。生产计划就得跟着变,工艺参数也得跟着调。靠人来调度,从拍板到传达,再到执行,反应速度像是一头反应迟钝的恐龙。脚上被蚊子叮了一口,半天才能传到大脑。而新师傅的反应速度是毫秒级的。它能实时感知到外部环境的变化,然后瞬间计算出几套最优应对方案,让产线像一头灵活的猎豹,随时调整姿态,快速响应市场的风吹草动。
|
||||||
|
|
||||||
|
最后一愁,就是成本这座大山。利润薄得像纸片,人工在涨,原料在涨,竞争却越来越刺刀见红。怎么省钱,是每个工厂永恒的头等大事。新师傅恰好是降本增效的顶尖高手。一个智能体,能干好几个高级工程师的脑力活;一次悄无声息的工艺参数优化,一年下来可能就省下几百万的原材料。它不知疲倦地寻找每一个可以节能的缝隙,堵住每一个浪费的耗点,这种无孔不入的省钱能力,足以让最精明的财务总监都自愧不如。
|
||||||
|
|
||||||
|
那么,这位神通广大的新师傅是怎么炼成的?它的诞生,靠一个超级大脑和一双灵巧的手脚。
|
||||||
|
|
||||||
|
它的超级大脑,叫“工业大模型”。这东西可以理解成一种专门为工厂量身定制的超级专家大脑,而不是那种上知天文下知地理,但样样稀松的通用聊天对象。这个大脑是深耕在工业领域的,它学习工业原理,精通工艺流程,对设备构造了如指掌。2026年,这种专业大脑已经从飘在空中的概念,实实在在地落到了生产线上。国家和地方层面都推出了强有力的行动计划,要推动这种超级大脑在制造业里深度应用,目标是培育出一批有全球影响力的顶尖企业。很多行业巨头,都已经推出了自己的工业大模型,把这个超级大脑植入到了工厂的生产环节。
|
||||||
|
|
||||||
|
光有大脑还不够,还得有能干活的手脚,这就是“工业智能体”。如果大脑负责思考,智能体就是那个把想法变成现实的执行者。它不仅能听懂人的指令,还能自己把一个大目标拆解成一个个小步骤。比如,你告诉它,目标是把A产品的良率从95%提升到98%。它会自己去分析历史数据,去查阅工艺知识,去调用各种检测工具,然后规划出一套完整的试验方案,自己控制设备去执行,根据结果再实时调整。遇到难题,它会自己想办法绕过去,或者寻找新的解决方案。以前的各种应用,就像你去问路,别人告诉你左转右转,你记下来自己走。现在的智能体,是直接接过你手中的地图和方向盘,把你安全快速地送到目的地。2026年,这种工业智能体迎来了爆发,各大公司都在争相发布自己的产品。有搞生产调度的,有搞设备运维的,有搞质量优化的,它们的效率提升,不是用百分比点,而是动辄百分之几十的跃升。一个工程师以前要花一周时间辛辛苦苦做的工程配置,智能体两三天就能干完,而且不出错。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
新师傅如何一步步接管车间?
|
||||||
|
|
||||||
|
新师傅进厂,不是锣鼓喧天、鞭炮齐鸣,然后一夜之间全厂大变样。它的渗透方式,像春雨润物一样,悄无声息,一个角落一个角落地攻克。通常是从最痛苦、最能见效果的环节先下手。
|
||||||
|
|
||||||
|
最成熟的第一站,往往是质量检测。以前靠人眼盯着流水线上飞速滑过的产品,一天下来两眼昏花,难免漏掉瑕疵品。新师傅的一双电子眼不知疲倦,精度堪比孙悟空的火眼金睛,任何微米级别的划痕、缺口、色差都逃不过它的法眼。这个场景现在已经在大量工厂普及开来。
|
||||||
|
|
||||||
|
然后是设备运维,也就是给机器看病。以前是设备突然趴窝了,才火急火燎地去抢修,损失巨大。新师傅摇身一变成为预言大师,它通过长期监听设备的振动和温度,就能精准预测出哪个零件在什么时间可能会出毛病,提前发出预警。维修人员就可以利用换班间隙,轻松地把隐患扼杀在摇篮里,避免了整条产线突如其来的大瘫痪。
|
||||||
|
|
||||||
|
第三站,也是最值钱也最难啃的骨头,就是工艺优化。这就像是给产品配方和烹饪手法找最佳搭配。发酵时间长短、温度高低、压力大小,这些参数之间微妙的组合,直接决定了产品的最终品质和成本。新师傅可以像一个不知疲倦的顶级大厨,在虚拟世界里进行成千上万次试错和推演,最终找到一套最优的参数组合,在保证最高品质的同时,还把能耗和物料消耗降到最低。这带来的效益,是实打实的真金白银。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
接下来,它还会逐步接管更复杂的生产调度,像个超级交通指挥官,让所有的物料、设备、订单都最高效地流动起来,不留瓶颈。以及安全管理,用无数双永不疲倦的眼睛盯住厂区的每个角落,把火灾、泄漏等风险扼杀在萌芽中。
|
||||||
|
|
||||||
|
为了让新师傅的超级大脑不瞎琢磨,还有一个关键环节:得给大脑喂“真经”。这真经就是“工业知识图谱”。简单说,就是把整个工厂从建厂以来所有的图纸、工艺手册、设备参数、故障记录,甚至老师傅口传心授的经验,都梳理成一套互联互通的、结构化的知识网络。有了这套真经,当它思考问题时,就有据可依,有法可循。你问它怎么调某个注塑参数,它给出的答案就不再是天马行空的乱猜,而是基于这个工厂真实沉淀下来的最佳实践。那些原本只藏在老师傅脑中的隐性绝活,就此显性化,成为了企业谁也带不走的数字资产。
|
||||||
|
|
||||||
|
这是一个全新的竞技场。以前,工厂之间比拼的是谁的规模更大,谁的成本更低,谁的人手更多。以后,决定生死的,将是数据、是算法、是工厂的智慧化程度。谁能先把这位不吃不睡的新师傅请进门,并且用好它,谁就能在新一轮的残酷淘汰赛中拿到主动权。这条路注定不会平坦,但方向已经明确。对于每一个身处其中的人来说,这不再是一道可有可无的选择题,而是一道关乎未来生存的必答题。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|

|
||||||
@@ -0,0 +1,77 @@
|
|||||||
|
# 📊 文章摘要:2026制造业生死局:工业大模型落地,AI智能体进厂,正在重构工厂的生存法则
|
||||||
|
|
||||||
|
> **原文**:[2026-08-20_2026制造业生死局_工业大模型落地_AI智能体进厂_正在重构工厂的生存法则](./2026-08-20_2026制造业生死局_工业大模型落地_AI智能体进厂_正在重构工厂的生存法则.md)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/WX5ysyywBrx5Nnb7JyKKeg
|
||||||
|
> **来源**:微信公众平台
|
||||||
|
> **作者**:墨执子
|
||||||
|
> **发布日期**:2026-08-20
|
||||||
|
> **摘要日期**:2026-08-20
|
||||||
|
> **价值评级**:⭐⭐ 中
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 核心命题
|
||||||
|
|
||||||
|
> **人治到智治** — 制造业第三次蜕变(智能化)解决的是"想"的问题,决策主体从人转向"工业大模型+工业智能体"系统。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 文章概要
|
||||||
|
|
||||||
|
本文以通俗科普笔法宣告 2026 年"工业大模型+工业智能体"将大范围进厂,用"自动化解决干、数字化解决看、智能化解决想"的三段式框架,把当前变革定位为从"人治"到"智治"的生存法则重置。文章先梳理工厂四大痛点(变量管不过来、老师傅经验随退休流失、市场变化快、成本压力),再解释"新师傅"的构成(工业大模型为大脑、工业智能体为手脚),并给出按痛苦程度递进的落地路径:质量检测→设备预测性运维→工艺优化(最值钱最难)→生产调度与安全管理,最后强调工业知识图谱是把隐性经验变成企业数字资产的关键。局限非常明显:全文没有一个具名案例、没有任何有出处的数据、不讨论任何风险与失败模式,属于理念布道文而非实证分析。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 关键要点
|
||||||
|
|
||||||
|
1. **三次蜕变框架** — 自动化解决"干"(体力交机器)、数字化解决"看"(传感器把模糊信息变精确数字)、智能化解决"想"(自己分析判断给指令)`[分类: 共识]`
|
||||||
|
2. **数字化遗留问题被点破** — 数据像体检报告,只报异常不给病因不开药方,分析和决断仍依赖老专家 `[分类: 共识]`
|
||||||
|
3. **四愁对四解** — 变量复杂→模型理头绪;隐性经验→沉淀为算法规律;市场快变→毫秒级响应;成本→无孔不入的优化 `[分类: 共识]`
|
||||||
|
4. **新师傅的双件套结构** — 工业大模型(领域大脑:工业原理、工艺流程、设备构造)+ 工业智能体(自主拆解目标、规划、执行、闭环调整的执行者)`[分类: 共识]`
|
||||||
|
5. **落地顺序按"痛感+见效"推进** — 质检最成熟已普及→设备预测性维护→工艺优化(虚拟世界海量试错找最优参数)→生产调度、安全管理 `[分类: 共识]`
|
||||||
|
6. **工业知识图谱是"真经"** — 图纸、工艺手册、故障记录、老师傅口传经验结构化为知识网络,让模型回答有据可依,隐性绝活显性化为"谁也带不走的数字资产" `[分类: 共识]`
|
||||||
|
7. **竞争焦点迁移** — 从比规模、成本、人手转向比数据、算法、智慧化程度,"不再是选择题而是必答题" `[分类: 争议]`
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 批判性分析
|
||||||
|
|
||||||
|
### 假设前提
|
||||||
|
- 默认技术已经 ready:"2026 年已从概念实实在在落到生产线上",无需论证可行性。
|
||||||
|
- 默认老师傅的隐性经验(文中自认"只可意会不可言传")可以被完整数据化并被模型学会——这正是知识工程中最难的瓶颈,被一笔带过。
|
||||||
|
- 默认效率数字可信:"动辄百分之几十的跃升""一年省下几百万"均无出处。
|
||||||
|
|
||||||
|
### 论据与逻辑
|
||||||
|
- 全文零具名案例(未提及任何企业、任何工业大模型产品名)、零可核查数据;类比论证(新师傅、火眼金睛、炼蛊、大厨)替代了论证。
|
||||||
|
- "四愁"归纳与多数制造业 AI 讨论同构,无新信息增量;"必答题"式紧迫感渲染缺乏分行业、分规模的条件区分。
|
||||||
|
|
||||||
|
### 边界与局限
|
||||||
|
- 完全没有边界意识:不讨论哪些场景不适合上大模型、数据基础薄弱的中小工厂怎么办、幻觉与安全风险、集成成本与组织阻力。
|
||||||
|
- 标题用"生死局"制造焦虑,但文中无任何失败案例或成本收益的反面讨论。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 可引用金句
|
||||||
|
|
||||||
|
> "数据是死的,像医院的体检报告,只告诉你哪里指标异常,却不会告诉你病因,更不会帮你开药方。"
|
||||||
|
|
||||||
|
> "这不是多了一个帮手,而是换了一种思考模式,是从'人治'到'智治'的跨越。"
|
||||||
|
|
||||||
|
> "那些原本只藏在老师傅脑中的隐性绝活,就此显性化,成为了企业谁也带不走的数字资产。"
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 总体评价
|
||||||
|
|
||||||
|
**亮点**:
|
||||||
|
- "干—看—想"三段式框架清晰易懂,是向非技术受众解释制造业 AI 演进的合格话术框架。
|
||||||
|
- 四愁→四解、落地顺序(质检→运维→工艺→调度)的结构化梳理有普及价值。
|
||||||
|
|
||||||
|
**不足**:
|
||||||
|
- 无一案例具名、无一数字有出处,宣传性远大于信息性;对风险、成本、失败模式零讨论。
|
||||||
|
|
||||||
|
**适用场景**:
|
||||||
|
- 向制造业客户或管理层做 AI 进厂的理念铺垫、售前教育;不适合作为技术选型或投资判断的依据。
|
||||||
|
|
||||||
|
**关联建议**:
|
||||||
|
- 与同日归档的《干货丨一文get 2026"人工智能+制造"融合创新研讨会 核心观点》(自动化博览)主题互证;建议搭配有实证数据的工业 AI 落地研报平衡阅读。
|
||||||
@@ -0,0 +1,72 @@
|
|||||||
|
# 人工智能时代数智化生存的哲学省思
|
||||||
|
|
||||||
|
> **来源**:微信公众平台(张灿)
|
||||||
|
> **作者**:张灿(中国矿业大学马克思主义学院教授)
|
||||||
|
> **发布日期**:2026-08-20(原文未标注明确日期,按下载日占位)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/G0MfY7D4wkXVwZHsok3YRQ
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
|
||||||
|
|
||||||
|
当前,我们正站在人类文明史的关键转折点。人工智能的爆发式演进与深度数智化浪潮,早已超越单纯的技术革新,正从根本上重塑人类的存在根基。从认知世界、理解自我,到建构社会关系、定义生命价值,人类的生存状态正前所未有地被嵌入由数据、算法与智能机器交织而成的精密体系之中。这种被智能技术深度中介乃至结构性重构的生存范式,即为数智化生存。它以空前的效率、联结度与可能性为人类带来巨大福祉,却也悄然开启了"潘多拉魔盒",催生出一系列深刻、复杂且亟待回应的哲学问题。
|
||||||
|
|
||||||
|
**生存空间的数智化与超连接**
|
||||||
|
|
||||||
|
空间既非空洞的物质容器,亦非抽象的理性范畴,而是承载社会属性、价值导向与政治意涵的实践场域。步入人工智能时代,数智空间持续迭代,呈现出自动化、超连接、平台性、界面性四大核心特征。
|
||||||
|
|
||||||
|
自动化是数智空间的基础特质。数智技术驱动社会治理、生产与生活方式实现全流程数智化转型,塑造出自动化生存形态。世间万物被编码、标记、扫描与精准定位,由此,自动化技术体系已内化为现代社会与日常生活的底层逻辑与基础环境。
|
||||||
|
|
||||||
|
超连接是数智空间的核心特征。无论是人机交互还是人际交流,人们之间不再局限于普通连接,而是走向超连接:始终保持在线状态,能够在移动场景下于虚实世界之间无缝漫游。简言之,这是一种嵌入日常生活、泛在且趋于隐形的数智化生存方式,深刻重塑着人们的身份认同与社会交往模式。
|
||||||
|
|
||||||
|
平台性成为数智空间的主导组织形态。具体而言,数字平台并非单纯的技术系统,而是融合软硬件、运行规则与社会关系的技术—社会复合体。其将人的日常行为标准化、数据化,为各类数智运算与社会决策提供基础素材,进而实现对社会关系、信息流动与资源分配的深度重构。
|
||||||
|
|
||||||
|
界面性赋予数智空间具身实践属性。界面构成人与智能系统、物理现实与虚拟场域交互的中介边界,成为通往数智世界的核心载体,构成结构化、可预期的操作体系。界面的本质不在于视觉图形和抽象中立的信息通道,而在于其持续召唤身体参与的具身交互实践。人与界面的具身互动是数智化生存的实现方式,使个体体验既保有鲜活可感的真实感,又带领主体抵达全新的存在境界。
|
||||||
|
|
||||||
|
**生存时间的数智化与加速**
|
||||||
|
|
||||||
|
时间具有绵延流变、难以把握的特质,兼具客观秩序与主观体验双重属性。数智技术深刻重塑了人类的生存时间性,令个体陷入时间压缩与碎片化困境,使人与自我、他者、世界之间的关系走向异化,难以建立深度共鸣。
|
||||||
|
|
||||||
|
第一,数智技术助推社会加速,逐渐消融工作与生活、劳动与休闲的时间边界,造成个体普遍的时间匮乏感。个体对时间的自主掌控权正持续弱化,时间节奏日益被外部系统支配与规训。AI对实时处理、即时反馈的极致追求,使实时性成为主导性时间范式,不断挤压反思、延迟与等待的存在空间,进而催生当下的暴政——人被牢牢困在瞬时信息流中,失去慢下来、沉下去的可能。
|
||||||
|
|
||||||
|
第二,数智技术催生以直播、永久在线为表征的全新时间形态,持续重塑人类存在的时间逻辑。换言之,它进一步凸显并延展了曼纽尔·卡斯特(Manuel Castells)提出的"无时间之时间"范式。依托同步共在与即时通信机制,文本、图像与视频不断流动、切换,最终消解了统合过去、现在与未来的时间所固有的历史深度。
|
||||||
|
|
||||||
|
第三,数智技术正深度重塑我们认知过往、筹划未来的思维方式。从本质上来看,数智技术把过往与未来化作可调配、可利用的现实资源,突破时间维度的局限,搭建并塑造全新的时空形态。一方面,数智技术催生了"当下未来"的现实状态,依托过往积淀与现实发展趋势,孕育尚未成型、亟待实践创造的未来;另一方面,数智技术造就了"未来当下"的生活模式,将未来的多元可能性融入当下,以预判的发展结果审视当下行为,进而反向调整、重塑未来的发展走向。
|
||||||
|
|
||||||
|
**数智记忆的媒介化与无意识性**
|
||||||
|
|
||||||
|
数智技术与社交媒体一方面为个体留存、梳理与回溯记忆构筑起媒介载体,另一方面重塑了记忆的生成机制及价值内涵。简单来说,数智技术从根本上改变了个人与群体的记忆逻辑,包括如何记忆、记忆什么以及记忆背后的初衷与意义。
|
||||||
|
|
||||||
|
第一,记忆实践展现为记忆的技术量化。在指标量化的统摄之下,记忆实践沦为一场依托数据展开的竞争,记忆自带的私密性与情感厚度由此遭受系统性侵蚀。一方面,数智记忆根据平台展示的点赞、转发和评论等对记忆内容进行排序和可见性分配,将具有情感性、历史厚度和社会关联的记忆体验压缩为一种单一可比的数据关系;另一方面,数智记忆的量化机制又披上了客观性的外衣,将记忆体验中不可通约的意义进行简化和有倾向性的排除。
|
||||||
|
|
||||||
|
第二,"记忆什么"表现为一种感官刺激。信息过载加剧了注意力资源的争夺,而平台算法以用户停留时长、互动频率等指标筛选内容,因此,能够快速抓取注意力的记忆碎片被优先推送与扩散;反之,需要深度沉浸、理性思辨的复杂叙事则日趋边缘化。由此,数智时代的记忆图谱呈现出显著的碎片化与快消化特征。记忆的价值评判标准发生根本性转向,评判核心不再是历史真实性与情感深度,而是感官刺激强度、传播热度与流量转化效率。
|
||||||
|
|
||||||
|
第三,"为何记忆"表现为一种技术无意识性。技术无意识表明,技术能够对人类意识与思维方式进行隐性塑造,使人们逐渐将技术构建的生存环境视作唯一合理的存在形态。在数智化生存语境下,软件、算法、大语言模型等智能体主导着日常生活的价值体系和行为模式,形成一套隐性的控制体系。
|
||||||
|
|
||||||
|
**生存主体的数智化与流变**
|
||||||
|
|
||||||
|
在人工智能时代,个体的网络浏览、虚拟社交、位置信息、人脸识别、人机交互等数据汇聚形成虚拟画像,以此建构出全新的数智主体。数智主体并非单纯经由数智媒介中介化形成的主体,而是依托数据、算法模型与计算生成的主体。
|
||||||
|
|
||||||
|
首先,数智主体建构了新型数字身份。简而言之,我们不仅持续生成数据,更被数据建构,并经由数据被算法解读、赋予标签化意义。在此过程中,数据不仅能够解释主体,而且能够规范主体,决定谁能够被看见以及在多大程度上被看见。
|
||||||
|
|
||||||
|
其次,数智技术推动了个体存在方式的深层转型。一方面,数智主体关乎主体化过程,即数智主体开展自我激励与自主优化;另一方面,数智主体关乎社会认同建构,它通过公开展演自我,获取社交反馈,进而完成自我建构的强化。换言之,数智主体不仅是主体性生产的产物,更是一项兼具自我关怀与自我治理的技术实践。
|
||||||
|
|
||||||
|
再次,数智空间看似赋予主体挣脱肉身桎梏的自由,令个体能够在虚拟维度建构自我,但与此同时,自拍、社交、形象展演等日常实践也不断推动数智自我走向商品化与美学化,使之成为兼具生产性与消费性的双重客体。在平台经济逻辑下,数智自我有着沦为资本挖掘数据价值的文化制品的风险,个体也会在无意识中陷入自我物化与价值剥削的共谋结构。
|
||||||
|
|
||||||
|
最后,数智主体是可变、未完成、始终处在生成过程中的动态行动者。它既非纯粹的人工人格,也不只是浅层的数智表征与影像,而是依托人类与智能体的交互,在数智空间内不断演化生成。数智主体外在于经验自我,却又反向塑造与规训着自我。其内嵌权力机制、主体化逻辑与自动化治理框架,已然成为人工智能时代理解主体性、技术与权力关系的核心命题。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
本文系国家社科基金后期资助项目"人工智能时代数字化生存的伦理风险研究"(25FZXB045)阶段性成果
|
||||||
|
|
||||||
|
作者系中国矿业大学马克思主义学院教授
|
||||||
|
|
||||||
|
来源:中国社会科学报
|
||||||
|
|
||||||
|
责任编辑:常达
|
||||||
|
|
||||||
|
新媒体编辑:张雨楠
|
||||||
|
|
||||||
|
如需交流可联系我们
|
||||||
|
|
||||||
|
邮箱账号:skwgzh2023@163.com
|
||||||
@@ -0,0 +1,70 @@
|
|||||||
|
# 📊 文章摘要:人工智能时代数智化生存的哲学省思
|
||||||
|
|
||||||
|
> **原文**:[2026-08-20_人工智能时代数智化生存的哲学省思.md](./2026-08-20_人工智能时代数智化生存的哲学省思.md)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/G0MfY7D4wkXVwZHsok3YRQ
|
||||||
|
> **来源**:微信公众平台
|
||||||
|
> **作者**:张灿(中国矿业大学马克思主义学院教授,原载中国社会科学报)
|
||||||
|
> **发布日期**:2026-08-20
|
||||||
|
> **摘要日期**:2026-08-20
|
||||||
|
> **价值评级**:⭐ 低
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 核心命题
|
||||||
|
|
||||||
|
> **数智化生存** — 人的生存正被数据、算法与智能机器深度中介乃至结构性重构,需从空间、时间、记忆、主体四个维度对这一新生存范式做哲学审思。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 文章概要
|
||||||
|
|
||||||
|
本文是国家社科基金后期资助项目阶段性成果的哲学科普文章,从四个维度系统描述 AI 时代的"数智化生存":数智空间的自动化、超连接、平台性、界面性四特征;数智技术造成的时间加速、时间匮乏与"当下的暴政";数智记忆的技术量化、感官刺激筛选与技术无意识性;以及"数智主体"被数据建构、自我商品化的命运。其价值在于为非哲学读者提供了一套成体系的批判性概念框架(尤其"当下未来/未来当下""技术无意识"等提法可用于 AI 伦理与社会影响讨论);局限是纯思辨综述,无经验研究支撑,只诊断不开方。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 关键要点
|
||||||
|
|
||||||
|
1. **数智化生存的定义** — "被智能技术深度中介乃至结构性重构的生存范式",被界定为超越单纯技术革新的存在方式变革。 `[分类: 共识]`(国内学界主流话语)
|
||||||
|
2. **数智空间四特征** — 自动化(底层逻辑与环境)、超连接(泛在且趋于隐形)、平台性(技术—社会复合体,重构资源分配)、界面性(具身交互实践而非中立信息通道)。 `[分类: 共识]`
|
||||||
|
3. **当下的暴政** — AI 对实时处理、即时反馈的极致追求使实时性成为主导时间范式,挤压反思、延迟与等待,人被"牢牢困在瞬时信息流中"。 `[分类: 共识]`
|
||||||
|
4. **"当下未来"与"未来当下"** — 数智技术把过往与未来化作可调配的现实资源:孕育尚未成型的未来(当下未来),并以预判结果反向审视当下行为(未来当下)。 `[分类: 争议]`(作者的综合提法,无实证)
|
||||||
|
5. **数智记忆三问** — 如何记忆(技术量化侵蚀私密性与情感厚度)、记忆什么(感官刺激与流量优先,复杂叙事边缘化)、为何记忆(技术无意识形成隐性控制体系)。 `[分类: 共识]`
|
||||||
|
6. **数智主体的建构与物化** — "我们不仅持续生成数据,更被数据建构";数智自我在平台经济逻辑下有沦为资本数据制品的风险,个体陷入自我物化与价值剥削的共谋结构。 `[分类: 共识]`(批判理论传统)
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 批判性分析
|
||||||
|
|
||||||
|
### 假设前提
|
||||||
|
- 预设技术对人的塑造是单向的结构性力量,人的能动空间被压缩为"共谋",缺乏对抵抗、退出与差异化实践的讨论。
|
||||||
|
- 预设平台逻辑高度同质化,未考虑不同社会语境下数智化生存的分化。
|
||||||
|
|
||||||
|
### 论据与逻辑
|
||||||
|
- 全文为思辨演绎,以"第一、第二、第三"断言式列举推进,无经验数据或案例支撑;理论渊源(卡斯特"无时间之时间"、技术无意识等)仅点到即止。
|
||||||
|
|
||||||
|
### 边界与局限
|
||||||
|
- 只诊断不开方,全文未给出任何应对路径;无技术细节,对 AI 从业者的直接可操作性低。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 可引用金句
|
||||||
|
|
||||||
|
> "我们不仅持续生成数据,更被数据建构,并经由数据被算法解读、赋予标签化意义。"
|
||||||
|
|
||||||
|
> "数据不仅能够解释主体,而且能够规范主体,决定谁能够被看见以及在多大程度上被看见。"
|
||||||
|
|
||||||
|
> "记忆的价值评判标准发生根本性转向,评判核心不再是历史真实性与情感深度,而是感官刺激强度、传播热度与流量转化效率。"
|
||||||
|
|
||||||
|
> "人被牢牢困在瞬时信息流中,失去慢下来、沉下去的可能。"
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 总体评价
|
||||||
|
|
||||||
|
**亮点**:四维度(空间/时间/记忆/主体)框架完整,"当下的暴政""技术无意识""数智主体"等概念可作为 AI 社会影响讨论的现成语汇,行文规范、来源清晰(中国社会科学报、社科基金成果)。
|
||||||
|
|
||||||
|
**不足**:纯综述思辨,无一手研究;断言多论证少;无对策建议;与工程实践距离远。
|
||||||
|
|
||||||
|
**适用场景**:AI 伦理与数智社会议题写作的概念工具箱;技术人文类分享的引文来源。
|
||||||
|
|
||||||
|
**关联建议**:与知识库中技术向文章形成"批判视角"互补,无需深入跟踪该作者后续。
|
||||||
@@ -0,0 +1,166 @@
|
|||||||
|
# 技术速递|评估 GitHub Copilot 智能体运行框架在不同模型和任务中的性能与效率
|
||||||
|
|
||||||
|
> **来源**:微信公众平台(微软Reactor)
|
||||||
|
> **作者**:Shibani Basava & Carlos Castro
|
||||||
|
> **发布日期**:2026-08-20(原文未标注明确日期,按下载日占位)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/TmXrgtT1A70VZfPESKinNQ
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
_作者:Shibani Basava & Carlos Castro_
|
||||||
|
|
||||||
|
_排版:Alan Wang_
|
||||||
|
|
||||||
|
深入了解 GitHub Copilot 智能体运行框架如何在多项基准测试中取得出色表现,并实现行业领先的 Token 使用效率,同时保持灵活性,让开发者能够在 20 多种模型之间自由选择。
|
||||||
|
|
||||||
|
|
||||||
|
|
||||||
|
虽然模型提供了底层智能,但真正决定这些智能能否高效发挥作用的,是智能体运行框架。GitHub Copilot 智能体运行框架是 GitHub Copilot SDK 的统一共享组件,为 GitHub Copilot CLI、GitHub Copilot App、Copilot Code Review,以及 GitHub 和微软生态中的众多 AI 开发体验提供支撑。对这一运行框架的任何改进,都将惠及所有基于它构建的产品和功能。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
_GitHub Copilot 智能体运行框架为 GitHub Copilot 的各项 AI 开发体验提供支撑。_
|
||||||
|
|
||||||
|
工具调用、上下文管理以及工作流编排均由这一运行框架统一协调。一个优秀的智能体运行框架应具备响应迅速、Token 使用高效且行为可预测等特性,而这正是 GitHub Copilot 智能体运行框架的设计目标。
|
||||||
|
|
||||||
|
本文将通过一系列数据,展示 GitHub Copilot 智能体运行框架在各类智能体软件工程任务中的性能表现与运行效率。
|
||||||
|
|
||||||
|
**持续进行的优化**
|
||||||
|
|
||||||
|
为了充分发挥每一个 Token 的价值,我们持续优化上下文管理和模型路由。此外,我们还分享了在任务委派方面的实验与优化成果,以及这些改进如何帮助开发者进一步提升开发效率。
|
||||||
|
|
||||||
|
**GitHub Copilot SDK**
|
||||||
|
|
||||||
|
https://github.com/github/copilot-sdk?utm_source=blog-benchmarking-1&utm_medium=blog&utm_campaign=github-copilot-app-ga-2026/?wt.mc_id=3reg_webpage_reactor
|
||||||
|
|
||||||
|
**GitHub Copilot CLI**
|
||||||
|
|
||||||
|
https://github.com/features/copilot/cli?utm_source=blog-benchmarking-1&utm_medium=blog&utm_campaign=github-copilot-app-ga-2026/?wt.mc_id=3reg_webpage_reactor
|
||||||
|
|
||||||
|
**GitHub Copilot App**
|
||||||
|
|
||||||
|
https://github.com/features/ai/github-app?utm_source=blog-benchmarking-1&utm_medium=blog&utm_campaign=github-copilot-app-ga-2026/?wt.mc_id=3reg_webpage_reactor
|
||||||
|
|
||||||
|
**Copilot Code Review**
|
||||||
|
|
||||||
|
https://docs.github.com/copilot/concepts/agents/code-review?utm_source=blog-benchmarking-1&utm_medium=blog&utm_campaign=github-copilot-app-ga-2026/?wt.mc_id=3reg_webpage_reactor
|
||||||
|
|
||||||
|
**持续优化上下文管理和模型路由**
|
||||||
|
|
||||||
|
https://github.blog/ai-and-ml/github-copilot/getting-more-from-each-token-how-copilot-improves-context-handling-and-model-routing/?wt.mc_id=3reg_webpage_reactor
|
||||||
|
|
||||||
|
**在任务委派方面的实验与优化**
|
||||||
|
|
||||||
|
https://github.blog/ai-and-ml/how-we-made-github-copilot-cli-more-selective-about-delegation/?wt.mc_id=3reg_webpage_reactor
|
||||||
|
|
||||||
|
**我们如何借助基准测试持续迭代**
|
||||||
|
|
||||||
|
我们持续结合公开基准测试和内部自研基准测试,对 GitHub Copilot 智能体运行框架的能力与效率进行评估。公开基准测试采用行业通用标准,而部分内部基准测试则基于 GitHub 和微软的大型代码库构建。此外,我们还结合真实世界指标和在线实验,不仅评估运行框架在受控环境下的表现,也验证其在实际智能体问题求解和任务完成中的效果。
|
||||||
|
|
||||||
|
为了公平比较 GitHub Copilot 智能体运行框架与模型厂商原生运行框架的性能,我们尽可能控制所有变量,包括:
|
||||||
|
|
||||||
|
- 使用**相同的模型**
|
||||||
|
- 使用**相同的基准测试任务**
|
||||||
|
- 统一上下文窗口
|
||||||
|
- 保持一致的推理强度
|
||||||
|
- 使用相同的工具选择
|
||||||
|
- 使用相同的 MCP Server 配置
|
||||||
|
|
||||||
|
下面展示的是我们持续跟踪的部分基准测试在四款主流模型上的最新结果,包括 Claude Sonnet 4.6、Claude Opus 4.7、GPT-5.4 和 GPT-5.5。
|
||||||
|
|
||||||
|
| | | |
|
||||||
|
| --- | --- |
|
||||||
|
| **基准测试** | **测试领域** | **测试目的** |
|
||||||
|
| SWE-bench Verified | 来自开源 Python 仓库的 500 个经过人工验证的 Bug 修复任务 | 业界公认的 Coding Agent 标准基准测试 |
|
||||||
|
| SWE-bench Pro | 更复杂的多步骤软件工程任务,需要更深入的推理和更大范围的代码修改 | 更真实地反映复杂的软件工程场景 |
|
||||||
|
| SkillsBench | 智能体利用技能完成任务的能力 | 评估智能体的可扩展性,以及技能调用和触发能力 |
|
||||||
|
| TerminalBench | 基于终端的开发任务 | 衡量智能体在命令行开发工作流中的表现 |
|
||||||
|
| Win-Hill | GitHub 内部基于 Windows 容器运行的测试基准 | 验证运行框架的性能能否跨操作系统和不同运行环境保持一致 |
|
||||||
|
|
||||||
|
在整个评测过程中,我们将 **GitHub Copilot CLI** 与模型厂商针对相应模型提供的原生智能体运行框架进行了对比:Claude Sonnet 4.6 和 Claude Opus 4.7 对比 **Claude Code**,GPT-5.4 和 GPT-5.5 对比 **Codex CLI**。
|
||||||
|
|
||||||
|
**Token 效率**
|
||||||
|
|
||||||
|
在保持模型和任务不变的情况下,通过多个基准测试结果可以看到,GitHub Copilot 智能体运行框架在任务完成率方面与其他模型厂商提供的运行框架基本持平,同时在大多数配置下表现出更低的 Token 消耗。
|
||||||
|
|
||||||
|
_Token 效率:GitHub Copilot CLI vs. 其他模型厂商运行框架_
|
||||||
|
|
||||||
|
**任务解决能力**
|
||||||
|
|
||||||
|
Token 效率只有在任务真正完成时才有意义。
|
||||||
|
|
||||||
|
在固定模型和基准任务的条件下,GitHub Copilot 智能体运行框架在这些基准测试中的任务解决率与模型厂商提供的运行框架基本持平。这意味着,开发者既可以充分发挥底层模型的能力,也能够获得多模型支持、Token 效率优化,以及更强的记忆和上下文管理能力。
|
||||||
|
|
||||||
|
_任务解决能力:GitHub Copilot CLI vs. 模型厂商运行框架_
|
||||||
|
|
||||||
|
这些结果体现了两者之间的有效平衡。由于模型本身具有随机性,测试结果在不同运行之间存在自然波动,因此不同运行框架之间的性能差异均处于合理变化范围内,可以认为二者表现基本相当。
|
||||||
|
|
||||||
|
**TerminalBench:Token 效率、任务完成率与运行波动**
|
||||||
|
|
||||||
|
为了持续提升 GitHub Copilot 智能体运行框架在任务完成能力和 Token 效率方面的表现,我们会定期基于多个基准测试进行深入分析。下面展示的是 TerminalBench 2.0 的方差分析示例。该分析不仅体现了 GitHub Copilot 在任务完成率和 Token 效率方面的优势,也展示了此类智能体基准测试中固有的运行间波动。
|
||||||
|
|
||||||
|
_任务解决率 vs. 单任务成本:越靠左上越好——解决更多任务,同时消耗更少成本。_
|
||||||
|
|
||||||
|
图中的每一个点代表 TerminalBench 2.0 中一种智能体与模型组合配置。纵轴表示任务解决率,横轴表示每个任务的美元成本,每个点周围的椭圆表示 ±1σ(一个标准差)的运行波动范围,展示该配置在多次运行之间的稳定程度。
|
||||||
|
|
||||||
|
三个关键发现:
|
||||||
|
|
||||||
|
1. **GitHub Copilot 智能体运行框架在任务完成和成本控制方面达到或超过其他智能体**。在评估的多种配置中,GitHub Copilot 智能体运行框架在任务完成率和单任务成本方面,与其他智能体相比表现相当甚至更优。图中的紫色点(代表 Copilot)与同模型下的竞争方案,在几乎所有模型配置中都处于相互重叠的椭圆范围内,说明两者差异处于运行波动范围之内。Copilot 在任务完成率上从未低于竞争方案,同时在成本方面也没有更高的消耗。
|
||||||
|
2. **运行间的波动性**。我们针对每一种智能体-模型组合至少运行了五次测试。图中的椭圆表示这些运行结果的 1σ 波动范围:更紧凑的椭圆表示结果更加稳定、更容易复现;更宽的椭圆表示不同运行之间的任务完成率和成本存在更大的波动。
|
||||||
|
3. **GitHub Copilot 多模型选择带来的优势**。图表展示了不同模型之间真实存在的权衡关系:GPT 系列模型(图中偏左区域)提供了最佳性价比:以最低成本实现较高任务解决率;Claude Opus(图中右上区域)能够达到最高任务解决率,但成本更高。GitHub Copilot 同时支持多种模型选择,因此开发者可以根据不同任务需求,在效率优先和最高质量之间自由选择。对于简单任务,可以选择更高性价比的模型;对于复杂任务,则可以选择更强大的模型以获得最佳结果。
|
||||||
|
|
||||||
|
**一个运行框架,多种模型**
|
||||||
|
|
||||||
|
GitHub Copilot 智能体运行框架支持 20 多种前沿模型,覆盖 GPT、Claude、Gemini 和 MAI 模型系列,同时支持通过自带密钥使用开源模型和本地模型。开发者可以根据不同任务的能力需求和成本特征,选择最适合的模型;也可以使用 Auto 模型选择功能,由系统自动完成模型匹配,在理解任务意图和评估模型状态的基础上,优化 Token 使用效率。
|
||||||
|
|
||||||
|
多模型架构还赋予了 GitHub Copilot 运行框架层面的独特能力,这些能力是单一模型厂商的运行框架无法提供的。例如,Rubber Duck 通过跨模型家族的协作评审机制,让一个模型对另一个模型的输出进行审查和改进,从而获得超越单一模型独立运行时的效果。
|
||||||
|
|
||||||
|
**Auto 模型选择**
|
||||||
|
|
||||||
|
https://docs.github.com/en/copilot/concepts/models/auto-model-selection/?wt.mc_id=3reg_webpage_reactor
|
||||||
|
|
||||||
|
**Rubber Duck**
|
||||||
|
|
||||||
|
https://github.blog/ai-and-ml/github-copilot/github-copilot-cli-combines-model-families-for-a-second-opinion/?wt.mc_id=3reg_webpage_reactor
|
||||||
|
|
||||||
|
**结论**
|
||||||
|
|
||||||
|
基准测试只是衡量能力的众多指标之一。我们持续通过基准测试、真实使用数据指标以及线上实验,不断提升 GitHub Copilot 的质量表现,同时致力于更高效地利用每一个 Token。
|
||||||
|
|
||||||
|
GitHub Copilot 凭借多模型架构,在多个配置场景下能够以更少的 Token 消耗,实现与领先模型厂商运行框架相当的任务解决能力,同时避免开发者被单一模型绑定。对于开发者而言,这意味着可以用更低的 Token 成本完成相近的任务,同时仍然可以根据具体任务需求,选择最适合的模型。
|
||||||
|
|
||||||
|
**亲自体验**
|
||||||
|
|
||||||
|
你可以使用自己选择的模型体验 GitHub Copilot,比较不同方案在日常开发任务中的表现,并观察不同模型和智能体策略在你的实际工作环境中的效果。
|
||||||
|
|
||||||
|
进一步了解:
|
||||||
|
|
||||||
|
- GitHub Copilot CLI
|
||||||
|
|
||||||
|
https://github.com/features/copilot/cli?utm_source=blog-benchmarking-1&utm_medium=blog&utm_campaign=github-copilot-app-ga-2026/?wt.mc_id=3reg_webpage_reactor
|
||||||
|
|
||||||
|
- GitHub Copilot App
|
||||||
|
|
||||||
|
https://github.com/features/ai/github-app?utm_source=blog-benchmarking-1&utm_medium=blog&utm_campaign=github-copilot-app-ga-2026/?wt.mc_id=3reg_webpage_reactor
|
||||||
|
|
||||||
|
- GitHub Copilot SDK
|
||||||
|
|
||||||
|
https://github.com/github/copilot-sdk?utm_source=blog-benchmarking-1&utm_medium=blog&utm_campaign=github-copilot-app-ga-2026/?wt.mc_id=3reg_webpage_reactor
|
||||||
|
|
||||||
|
这些体验背后均由同一个智能体运行框架提供支持。我们将持续提升其质量、效率和灵活性。
|
||||||
|
|
||||||
|
**方法论**
|
||||||
|
|
||||||
|
为了让对比结果尽可能公平、可控且可复现,我们在不同模型、任务和运行环境中,采用等效配置运行每个智能体。
|
||||||
|
|
||||||
|
- 所有测试运行:
|
||||||
|
- 超时时间统一设置为 2 小时;
|
||||||
|
- 所有智能体均采用非交互式单轮模式运行;
|
||||||
|
- 禁用 Web 工具;
|
||||||
|
- 开放所有可用工具。
|
||||||
|
|
||||||
|
**TerminalBench2 分析**:为智能体启用默认设置,推理强度设置为 medium(例如,Claude Code 启用了工具搜索功能,而 Copilot CLI 使用 GitHub MCP Server)。Codex 和 Claude Code 使用 Anthropic 和 OpenAI 的官方直连接口。为了确保结果完整且可靠,任何缺失数据或与基础设施相关的失败都会重新运行,直到所有 89 个 TerminalBench2 任务均产出结果。由模型生成的错误会被保留,不会从分析中排除。每个模型均经过五次独立运行评估,同时 Copilot 进行了两批独立评估,以便与 Claude Code 和 Codex 进行对比。
|
||||||
|
|
||||||
|
**所有基准测试**:所有智能体-模型组合均标准化为相同的上下文窗口大小、相同的 Prompt Token 限制、相同的推理强度(medium)和测试设置——不启用工具搜索,不使用 MCP Server。保留运行框架默认内置工具。为了确保公平比较,所有智能体在基准测试中的基础设施相关异常和网络访问影响均被排除。为了降低运行间差异对较小规模基准测试(<100 个实例)的影响,测试进行了五次独立运行,并报告其中得分最高的一次结果。所有指标均以 pass@1 形式呈现。这些标准化处理意味着测试结果会与公开基准测试提交结果有所不同,因为公开基准测试通常会采用更高的推理强度以及其他经过调优的设置。
|
||||||
@@ -0,0 +1,74 @@
|
|||||||
|
# 📊 文章摘要:技术速递|评估 GitHub Copilot 智能体运行框架在不同模型和任务中的性能与效率
|
||||||
|
|
||||||
|
> **原文**:[2026-08-20_技术速递_评估_GitHub_Copilot_智能体运行框架在不同模型和任务中的性能与效率](./2026-08-20_技术速递_评估_GitHub_Copilot_智能体运行框架在不同模型和任务中的性能与效率.md)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/TmXrgtT1A70VZfPESKinNQ
|
||||||
|
> **来源**:微信公众平台
|
||||||
|
> **作者**:微软Reactor(编译自 GitHub 官方博客,原作者 Shibani Basava & Carlos Castro)
|
||||||
|
> **发布日期**:2026-08-20
|
||||||
|
> **摘要日期**:2026-08-20
|
||||||
|
> **价值评级**:⭐⭐⭐ 高
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 核心命题
|
||||||
|
|
||||||
|
> **运行层效率** — 在模型能力趋同的条件下,智能体运行框架(而非模型本身)成为 Token 效率、成本控制与多模型自由度的决定层,且该层优化可做到不牺牲任务完成率。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 文章概要
|
||||||
|
|
||||||
|
本文是 GitHub 官方对 Copilot 智能体运行框架(支撑 Copilot CLI/App/Code Review 等产品的统一共享组件)的系统自评:在控制模型、任务、上下文窗口、推理强度、工具与 MCP 配置完全一致的条件下,将 Copilot CLI 与模型厂商原生框架(Claude Code、Codex CLI)在 SWE-bench Verified/Pro、SkillsBench、TerminalBench、内部 Win-Hill 等基准上对比。结论是任务解决率基本持平(差异在运行波动范围内),而 Token 消耗在多数配置下更低。其真正价值不在自评结论,而在方法论披露:多次运行、±1σ 方差椭圆、pass@1、标准化配置与公开提交结果的差异说明,为行业提供了 Agent 评测的可复现范式。局限是利益相关方自评、底层数据不公开、关键图表在公众号版本中不可见。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 关键要点
|
||||||
|
|
||||||
|
1. **运行框架是独立于模型的关键层** — 工具调用、上下文管理、工作流编排由运行框架统一协调,其改进惠及所有上层产品;"模型提供底层智能,运行框架决定智能能否高效发挥"。 `[分类: 共识]`
|
||||||
|
2. **同任务解决率下更低 Token 消耗** — 控制变量后,Copilot 运行框架任务解决率与 Claude Code/Codex CLI"基本相当",多数配置下 Token 消耗更低(此为作者结论,底层数据未公开)。 `[分类: 争议]`
|
||||||
|
3. **运行间波动是 Agent 基准的固有属性** — 每种智能体-模型组合至少运行 5 次,用 ±1σ 椭圆展示波动;两框架差异落在重叠椭圆内即应视为"基本相当",单次跑分不可作为结论依据。 `[分类: 共识]`
|
||||||
|
4. **模型间存在真实权衡而非单向优劣** — GPT 系列性价比最高(低成本高解决率),Claude Opus 解决率最高但成本更高;多模型可选(20+ 模型、Auto 模型选择)让开发者按任务在效率与质量间切换。 `[分类: 共识]`
|
||||||
|
5. **跨模型家族协作是运行层独有能力** — Rubber Duck 机制让一个模型审查另一模型输出,获得超越单模型独立运行的效果,这是单一厂商运行框架做不到的。 `[分类: 未探索]`
|
||||||
|
6. **标准化配置导致与公开榜单结果必然分叉** — 统一 medium 推理强度、禁用工具搜索/MCP、排除基础设施异常后,结果会低于公开提交(后者用更高推理强度与调优设置);小规模基准(<100 实例)报告五次运行的最高分。 `[分类: 共识]`
|
||||||
|
7. **评测方法论细节可迁移** — 超时统一 2 小时、非交互单轮、禁 Web 工具、模型生成错误保留不剔除、基础设施失败重跑补全、pass@1 呈现。 `[分类: 共识]`
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 批判性分析
|
||||||
|
|
||||||
|
### 假设前提
|
||||||
|
- 假设"任务解决率持平 + Token 更少"是开发者选型运行框架的充分理由,未讨论框架功能差异(如 Claude Code 的工具搜索、Hooks 生态)对真实开发体验的影响。
|
||||||
|
- 假设基准测试环境(单轮非交互、禁 Web)能代表真实使用,而真实 Copilot 使用多为交互式长会话。
|
||||||
|
- 自评者即利益方:GitHub 既是被测运行框架的开发者,又掌控评测配置(如"Copilot 使用 GitHub MCP Server"这类不对称默认设置)。
|
||||||
|
|
||||||
|
### 论据与逻辑
|
||||||
|
- 方法论透明度显著高于一般厂商benchmark 文章(方差分析、五次运行、pass@1、与公开提交差异的主动说明),这是其可信度的主要来源。
|
||||||
|
- 但所有关键图表(Token 效率图、任务解决能力图、TerminalBench 散点图)在公众号版本中均为失效 blob 链接,读者实际只能看到定性结论,"更低 Token 消耗"缺乏可验证的数字。
|
||||||
|
- "基本持平/差异在波动范围内"的表述严谨(诚实承认无显著优势),但标题与结论段又强调"行业领先的 Token 效率",存在表述张力。
|
||||||
|
|
||||||
|
### 边界与局限
|
||||||
|
- 未覆盖延迟/响应速度维度(其自己列出的优秀运行框架三特性之一),仅谈了任务完成率与成本。
|
||||||
|
- 内部基准(Win-Hill、基于 GitHub/微软代码库的自研基准)无法外部复现。
|
||||||
|
- 结论时效性强绑定四款模型(Claude Sonnet 4.6/Opus 4.7、GPT-5.4/5.5),模型迭代可能快速改变对比格局。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 可引用金句
|
||||||
|
|
||||||
|
> "虽然模型提供了底层智能,但真正决定这些智能能否高效发挥作用的,是智能体运行框架。"
|
||||||
|
|
||||||
|
> "Token 效率只有在任务真正完成时才有意义。"
|
||||||
|
|
||||||
|
> "Copilot 在任务完成率上从未低于竞争方案,同时在成本方面也没有更高的消耗。"
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 总体评价
|
||||||
|
|
||||||
|
**亮点**:方法论披露完整且诚实(方差、多次运行、与公开提交的差异说明);"框架层与模型层解耦"的定位论证清晰;主动承认差异在波动范围内而非夸大领先。
|
||||||
|
|
||||||
|
**不足**:利益相关方自评且数据不可验证;关键图表缺失;未测量延迟与真实交互场景;内部基准不可复现。
|
||||||
|
|
||||||
|
**适用场景**:设计 Agent/Coding Agent 评测方案时的方法论参考(方差意识、标准化配置、pass@1);企业选型 CLI 工具时理解"框架层 Token 效率"这一采购维度;撰写技术评测报告的写作范本。
|
||||||
|
|
||||||
|
**关联建议**:与《2026CSDI:AGI前夜》(编排式 vs 模型原生 Agent 之争)对照阅读——本文证明编排层(运行框架)在 Token 效率上有优化空间,恰好是该争论的实证素材;方法论部分可直接用于本院 Agent 评测体系建设。
|
||||||
@@ -0,0 +1,150 @@
|
|||||||
|
# 链路贯通|Jonex × WorkBuddy 打通 MCP 链路:本体知识 + 企业 Agent 赋能工程智能决策
|
||||||
|
|
||||||
|
> **来源**:微信公众平台(悦智人工智能)
|
||||||
|
> **作者**:悦智人工智能
|
||||||
|
> **发布日期**:2026-08-20(原文未标注明确日期,按下载日占位)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/u7QfwbV2fx1XkxHhGhKHIA
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
**Jonex(取自于Joint Ontology Nexus),是一套基于本体论、支持多模态的面向企业Agent的知识引擎。它通过联合(Joint)架构融合文本、图像、音视频等多模态数据,以本体论(Ontology)统一建模业务对象、关系、规则与行动,并通过知识中枢(Nexus)支撑Agent可推理、可追溯、可扩展地调用企业知识。**
|
||||||
|
|
||||||
|
**Jonex由来自前微软、腾讯云、阿里等企业的首席顾问、架构师、技术专家,以及毕业于清华大学、新加坡国立大学等高校的硕博人才组成的产品研发团队打造。团队长期专注于企业AI规模化落地、Agent应用与行业知识工程,致力于帮助企业将文档、视频、音频、图片和专家经验中的行业Know-how,转化为可持续复用和放大的生产力资产。**
|
||||||
|
|
||||||
|
前四篇,我们从企业"暗数据"、多模态解析引擎和本体论出发,讨论了Jonex如何把分散资料编译为Agent可以调用的知识。今天,我们以某型硬件设备运维的真实工程场景为例,进一步深入讨论:
|
||||||
|
|
||||||
|
当产品持续迭代、部件不断更换、现场证据逐年累积,工程师怎样在不遗漏影响关系、不越过证据边界的前提下,更快完成判断?
|
||||||
|
|
||||||
|
目前,**Jonex已通过MCP接入WorkBuddy企业版**。企业的文档、图像、音视频等多模态数据先在Jonex中完成解析与知识编译,WorkBuddy再直接调用这些结果,将Agent的自然交互与Jonex的专业知识能力结合起来,使知识准备前移、调用更加高效。
|
||||||
|
|
||||||
|
## 一项变更,会沿着哪些关系向外扩散?
|
||||||
|
|
||||||
|
## Jonex本体论给出解法
|
||||||
|
|
||||||
|
在某型硬件设备进行技术变更时,时常会遇到这一类棘手的问题:
|
||||||
|
|
||||||
|
_哪些产品型号需要同步调整?现有图纸和BOM是否仍然有效?生产工艺、检验规范和维护手册要改到哪里?培训视频里有没有已经过时的操作?已经交付的设备中,又有多少台属于受影响范围?_
|
||||||
|
|
||||||
|
一项工程变更进入企业以后,很少只影响发起变更的那份文件。它会顺着部件、型号、图纸、流程和客户设备一路传播。即使每个部门都能讲清自己负责的部分,也很难由某一个人在短时间内拼出完整的范围。而Jonex接入Workbuddy,就完美解决了这一问题。
|
||||||
|
|
||||||
|
我们以一组演示数据为例:XX2系列设备准备调整冷却方案。 现在,工程师只需在WorkBuddy中输入:
|
||||||
|
|
||||||
|
_将XX2系列的冷却方式由ONAF调整为ODAF,需要同步核查哪些部件、技术参数、操作规范、维护项目和在用设备?请列出依据,以及暂时无法确认的事项。_
|
||||||
|
|
||||||
|
就可以得到一张沿着工程关系展开的影响清单。得益于Jonex的本体建模,系统能够从"冷却方式变更"这一节点出发,沿着产品型号、部件、控制规则、图纸、工艺、维护要求和在用设备等关系逐层展开,并同时带回对应依据。
|
||||||
|
|
||||||
|
## 一项工程变更,究竟会影响到哪里?
|
||||||
|
|
||||||
|
传统搜索能找到"ODAF""油泵"或"冷却控制"等材料,但通常只返回若干文件,既难说明每份材料为何受到影响,也难确认是否遗漏传播路径。
|
||||||
|
|
||||||
|
_例如,XX2原采用ONAF,由六组散热器和十二台风扇组成,风扇按温度自动启停;改为ODAF后,还需增加油泵与油路控制,运行顺序、PLC逻辑、保护元件、告警设置和备用设备轮换方式都要重新核对。相应的图纸、作业指导书、检验表、维护手册、培训视频以及已交付设备台账也会进入检查范围。_
|
||||||
|
|
||||||
|
【图一|工程变更影响网络】
|
||||||
|
|
||||||
|
Jonex将产品型号、冷却方式、部件、控制规则、工艺、检验项目和设备实例组织为业务节点,并把图纸、手册、表格和视频作为证据挂接其上。借助本体关系,系统可从"冷却方式变更"出发,沿风扇、油泵、控制规则、图纸、工艺和维护要求向外检查,同时带回依据。
|
||||||
|
|
||||||
|
## 接入Agent,使 Jonex具有更多外接能力
|
||||||
|
|
||||||
|
上一节关注的是一项变更会影响哪些对象;这里要解决的是另一类任务:
|
||||||
|
|
||||||
|
候选替代件已经明确后,如何按约束逐项核验,并把缺失证据和后续工作一并整理出来?
|
||||||
|
|
||||||
|
仍以冷却系统为例:
|
||||||
|
|
||||||
|
_XX2使用的风扇电机功率为1.1 kW,单台风量为16000 m³/h。供应商停止生产原型号后,采购部门找到了 XX3 使用的1.5 kW风扇,单台风量达到22000 m³/h。_
|
||||||
|
|
||||||
|
工程师需要核查的内容很多:
|
||||||
|
|
||||||
|
_它的安装尺寸、连接方式和叶片结构是否一致?额定电流会不会超过原控制回路的设计范围?接触器、断路器和热继电器是否需要重新选型?原来的温控启停逻辑还能不能使用?单台风量提高以后,散热器表面的气流分布会不会改变?_
|
||||||
|
|
||||||
|
_更重要的是,XX3原本属于另一套ODAF冷却系统。它拥有更多散热器和风扇,同时还配置油泵与PLC控制。将其中一个部件单独取出,不代表它能够脱离原系统条件,直接进入XX2。_
|
||||||
|
|
||||||
|
这个问题正适合交给Jonex与WorkBuddy配合处理。工程师在WorkBuddy中给出设备型号、原部件、候选部件、核验维度和输出要求:
|
||||||
|
|
||||||
|
_XX2冷却系统原用的1.1 kW风扇已经停产,能否直接使用XX3的1.5 kW风扇替代?请比较风量、供电、控制方式、系统结构和维护要求,并单独列出目前缺少的判断依据。_
|
||||||
|
|
||||||
|
WorkBuddy保留当前任务的上下文与约束,并通过MCP调用Jonex。Jonex调取两种风扇所属系统中的参数、控制要求和维护记录,WorkBuddy再按电气参数、机械接口、控制保护、系统性能和认证要求等维度组织结果。
|
||||||
|
|
||||||
|
现有材料能够确认功率、风量、风扇数量、冷却方式和控制方式等差异,也会显示XX3的运行逻辑依赖油泵与PLC。各项结果分别标记为"满足""存在差异"或"待补证据",并回到相应手册、参数表或章节
|
||||||
|
|
||||||
|
【图二|替代件核验卡片】
|
||||||
|
|
||||||
|
这正是两者结合后的优势:
|
||||||
|
|
||||||
|
Jonex为WorkBuddy提供经过**本体关系约束、带有来源和知识边界的专业内容**;
|
||||||
|
|
||||||
|
WorkBuddy则让Jonex的知识进入**连续对话、条件筛选、文档生成和协作执行**。工程师无需学习知识图谱的操作方式,也不必把检索结果重新抄进另一套工作表。
|
||||||
|
|
||||||
|
## 异构数据之处理:
|
||||||
|
|
||||||
|
## 多模态解析引擎如何组织故障证据
|
||||||
|
|
||||||
|
前两个问题至少有一个清楚的起点:
|
||||||
|
|
||||||
|
某项方案准备变更,或者某个部件等待替换。
|
||||||
|
|
||||||
|
故障分析往往没有这么明确,假设一批设备出现间歇性异常。异常持续时间很短,无法稳定复现,也没有任何一份材料能够单独指向原因。工程团队已经按照流程收集了完整资料:
|
||||||
|
|
||||||
|
运行日志记录了异常发生的时间和状态码;传感器曲线保留了温度、电流或压力变化;现场照片呈现部件外观;视频记录了设备运行时的声音、振动和动作;设备台账保存零部件批次与软件版本;维修工单则记录每台设备曾经更换过什么、调整过什么,以及异常是否再次出现。
|
||||||
|
|
||||||
|
资料完整,并不意味着答案已经存在。
|
||||||
|
|
||||||
|
出现异常的设备是否集中在某个零部件批次?某种曲线变化是否总与视频中的同一现场表现同时出现?已经更换某部件的设备,异常发生频率有没有变化?异常是否只出现在特定软件版本和负载条件的组合下?历史案例与当前情况究竟相似到什么程度?
|
||||||
|
|
||||||
|
这项工作最消耗时间的部分,往往不是某一个专业判断,而是反复筛选样本、对齐时间、核对版本和整理证据。
|
||||||
|
|
||||||
|
而接入Jonex后,工程师只需在WorkBuddy中输入:
|
||||||
|
|
||||||
|
_这批设备的间歇性异常与哪些历史案例最接近?请综合运行日志、传感器曲线、现场照片、异常视频、零部件批次和维修记录,按证据强弱列出可能原因,并说明每项判断的来源和仍需验证的部分。_
|
||||||
|
|
||||||
|
便可以得到一张按证据强弱组织的故障假设清单:哪些线索相互印证,哪些结论仍有冲突,哪些信息尚待补充,以及每项判断对应的日志行、曲线区间、图片区域或视频时间点。
|
||||||
|
|
||||||
|
这里,Jonex的价值不只在于分别读取日志、曲线、照片和视频,更在于让它们在同一异常事件中互相补充。日志记录状态码,曲线呈现变化过程,照片保留部件外观,视频则记录声音、振动和动作;单一材料通常只能说明问题的一部分,完成跨模态对齐后,系统才有可能还原更完整的异常现场。
|
||||||
|
|
||||||
|
【图三|多模态故障证据网络】
|
||||||
|
|
||||||
|
在这一场景中,**多模态解析引擎**负责把不同形式的材料**变成可比较、可定位的证据**;**本体关系负责把证据挂到设备、版本和事件上;**WorkBuddy则承接工程师后续的样本筛选和验证计划生成。
|
||||||
|
|
||||||
|
## Jonex + Workbuddy 工作链路
|
||||||
|
|
||||||
|
Jonex 位于企业资料与员工工作之间,将文档、图纸、日志、图片和视频编译为围绕产品、部件、版本、事件、规则与证据组织的专业知识。WorkBuddy作为统一入口,承接提问、筛选、整理、生成和任务执行,使这些知识直接进入具体业务场景。
|
||||||
|
|
||||||
|
企业原有的文档平台、知识库、培训系统和业务系统仍可继续承担内容管理与流程运行;Jonex补充专业语义与关系连接,WorkBuddy再将结果转化为影响分析、替代件核验、验证计划或任务清单。由此,企业资料中的业务联系能够被Agent稳定调用并持续复用。
|
||||||
|
|
||||||
|
【图四|Jonex + WorkBuddy工作链路】
|
||||||
|
|
||||||
|
在AI时代,当一项变化可以迅速找到受影响的对象,一个替代方案可以看清尚未满足的条件,一次复杂异常可以从海量资料中形成可验证的原因假设,企业知识才真正进入工程决策。
|
||||||
|
|
||||||
|
Jonex + WorkBuddy,让专业人员看得更全,也让每一次判断更接近证据。
|
||||||
|
|
||||||
|
**知识如流,汇聚成溪。**
|
||||||
|
|
||||||
|
上一篇回顾:《场景落地|当学生卡在一道题上:Jonex 如何把一门课编译成可导航的知识系统》
|
||||||
|
|
||||||
|
下期预告:当知识结果进入流程,企业 Agent 如何从辅助判断走向协同执行?
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
**国家高新技术企业**
|
||||||
|
|
||||||
|
**软件成熟度CMMI5认证**
|
||||||
|
|
||||||
|
**ISO42001 人工智能管理体系认证**
|
||||||
|
|
||||||
|
**ISO系列认证**
|
||||||
|
|
||||||
|
**ITSS认证**
|
||||||
|
|
||||||
|
**腾讯云第一大技术服务商**
|
||||||
|
|
||||||
|
**腾讯云优选级代理合作伙伴**
|
||||||
|
|
||||||
|
**腾讯云国际一级经销商**
|
||||||
|
|
||||||
|
**GCP Partner授权合作伙伴**
|
||||||
|
|
||||||
|
**AWS SPP授权解决方案提供商**
|
||||||
|
|
||||||
|
**专业提供**
|
||||||
|
|
||||||
|
人工智能、云计算、大数据、云经纪代理等技术产品与服务。
|
||||||
@@ -0,0 +1,70 @@
|
|||||||
|
# 📊 文章摘要:链路贯通|Jonex × WorkBuddy 打通 MCP 链路:本体知识 + 企业 Agent 赋能工程智能决策
|
||||||
|
|
||||||
|
> **原文**:[2026-08-20_链路贯通_Jonex_×_WorkBuddy_打通_MCP_链路_本体知识_+_企业_Agent_赋能工程智能决策](./2026-08-20_链路贯通_Jonex_×_WorkBuddy_打通_MCP_链路_本体知识_+_企业_Agent_赋能工程智能决策.md)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/u7QfwbV2fx1XkxHhGhKHIA
|
||||||
|
> **来源**:微信公众平台
|
||||||
|
> **作者**:悦智人工智能
|
||||||
|
> **发布日期**:2026-08-20
|
||||||
|
> **摘要日期**:2026-08-20
|
||||||
|
> **价值评级**:⭐⭐ 中
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 核心命题
|
||||||
|
|
||||||
|
> **知识编译** — 把企业多模态"暗数据"编译为以本体论组织的、可推理可追溯的知识层,再经 MCP 供企业 Agent 调用,让工程决策不遗漏影响关系、不越过证据边界。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 文章概要
|
||||||
|
|
||||||
|
这是悦智人工智能(自称腾讯云第一大技术服务商)系列产品文章第五篇,介绍其知识引擎 Jonex(Joint Ontology Nexus)通过 MCP 接入 WorkBuddy 企业版的联合方案。文章用三个硬件设备运维场景展示能力:工程变更影响分析(从"冷却方式变更"节点沿本体关系逐层展开受影响部件/图纸/工艺/设备并带回依据)、替代件核验(跨系统调参、按维度比对并三态标记"满足/存在差异/待补证据")、多模态故障证据组织(日志/曲线/照片/视频跨模态对齐,按证据强弱生成假设清单)。场景叙事具体是本文最大优点,但全部基于"一组演示数据",属厂商产品宣传文,无真实客户案例与量化效果,且通篇未与主流 RAG 方案做对比论证。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 关键要点
|
||||||
|
|
||||||
|
1. **Jonex = 本体论 + 多模态 + 知识中枢** — 以 Ontology 统一建模业务对象/关系/规则/行动,Joint 架构融合文本/图像/音视频,支撑 Agent 可推理、可追溯、可扩展地调用企业知识。 `[分类: 共识]`
|
||||||
|
2. **工程变更沿关系网络传播,传统搜索无法回答"影响范围"** — 变更会顺着部件、型号、图纸、流程、客户设备一路扩散;搜索只返回文件,难说明为何受影响、难确认是否遗漏传播路径。 `[分类: 共识]`
|
||||||
|
3. **影响清单带回依据链** — 从变更节点沿产品型号/部件/控制规则/图纸/工艺/维护要求/在用设备逐层展开,同时列出依据及"暂时无法确认的事项"。 `[分类: 未探索]`
|
||||||
|
4. **替代件核验的三态标记** — 结果分为"满足/存在差异/待补证据"并回链手册/参数表/章节;且能识别"部件脱离原系统条件不可直接移植"这类系统级约束(XX3 风扇依赖油泵与 PLC)。 `[分类: 未探索]`
|
||||||
|
5. **多模态跨对齐还原故障现场** — 日志记状态码、曲线呈变化、照片留外观、视频录声振,单一材料只说明局部,跨模态对齐后按证据强弱输出假设清单(含冲突与待补信息)。 `[分类: 共识]`
|
||||||
|
6. **分工架构:知识引擎管编译,Agent 管交互** — Jonex 提供受本体关系约束、带来源和知识边界的内容;WorkBuddy 承接连续对话、条件筛选、文档生成与协作执行;知识准备前移、MCP 调用。 `[分类: 共识]`
|
||||||
|
7. **存量系统不推翻** — 原有文档平台/知识库/培训系统继续承担内容管理与流程运行,Jonex 补语义与关系,WorkBuddy 转化为业务产出。 `[分类: 共识]`
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 批判性分析
|
||||||
|
|
||||||
|
### 假设前提
|
||||||
|
- 隐含假设:本体建模的知识质量收益大于其构造成本。但本体工程(本体设计、实体抽取、关系维护、随业务演进的更新)以高投入著称,文章完全未讨论成本与冷启动周期。
|
||||||
|
- 未论证为何本体论优于当前企业知识检索主流的 RAG/向量方案——这是选型读者最关心的问题,文章以"传统搜索只返回若干文件"的稻草人对比带过。
|
||||||
|
|
||||||
|
### 论据与逻辑
|
||||||
|
- 三个场景全部基于"一组演示数据"(原文自述),无真实客户、无量化指标(构建周期/准确率/人力节省),产品能力未经第三方或生产环境验证。
|
||||||
|
- "而Jonex接入Workbuddy,就完美解决了这一问题"属典型营销断言,与前文"很难由某一个人在短时间内拼出完整的范围"的问题复杂性不匹配。
|
||||||
|
- 团队背景(前微软/腾讯云/阿里、清华/新加坡国立硕博)是信任背书而非能力证据;文末资质列表(CMMI5、腾讯云第一大服务商)与产品论证无关。
|
||||||
|
|
||||||
|
### 边界与局限
|
||||||
|
- 场景限于结构化程度较高的硬件设备运维(BOM/图纸/参数表天然适配本体建模),对非结构化业务知识(经验、判断、跨部门隐性知识)的适用性未讨论。
|
||||||
|
- 演示话术中的自然语言查询都高度结构化(明确型号/维度/输出要求),真实工程师的模糊提问效果未知。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 可引用金句
|
||||||
|
|
||||||
|
> "当一项变化可以迅速找到受影响的对象,一个替代方案可以看清尚未满足的条件,一次复杂异常可以从海量资料中形成可验证的原因假设,企业知识才真正进入工程决策。"
|
||||||
|
|
||||||
|
> "单一材料通常只能说明问题的一部分,完成跨模态对齐后,系统才有可能还原更完整的异常现场。"
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 总体评价
|
||||||
|
|
||||||
|
**亮点**:三个工程场景的问题定义精准(影响传播、跨系统替代核验、多模态故障归因),"三态标记+证据回链+待补事项"的证据边界设计值得借鉴;产品叙事面向真实工程痛点而非技术炫技。
|
||||||
|
|
||||||
|
**不足**:纯演示数据、零客户案例、零量化效果;回避与 RAG 主流方案的正面对比;本体建模的成本与维护难题只字未提;营销断言("完美解决")削弱可信度。
|
||||||
|
|
||||||
|
**适用场景**:设计企业知识工程/Agent 知识层方案时的场景与交互范式参考(尤其是证据可追溯性设计);评估本体论路线时的厂商观点样本;智能运维(AIOps)产品规划素材。
|
||||||
|
|
||||||
|
**关联建议**:与《FDE 在中国火了》(IDC中国)对照,展示 Agent 落地的"工具链派"路线;本院在做企业知识库/Agent 知识层选型时,其"三态标记""证据回链"交互设计可直接借用,但选型决策需补充 RAG 对比与本体构建成本评估。
|
||||||
@@ -0,0 +1,70 @@
|
|||||||
|
# 国人真牛!把 ClaudeCode 秒变 Openclaw,可飞书、Discord 远程控制!
|
||||||
|
|
||||||
|
> **来源**:微信公众平台(数字元哥)
|
||||||
|
> **作者**:数字元哥
|
||||||
|
> **发布日期**:2026-08-20(原文未标注明确日期,按下载日占位)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/93dtdbUbyrjSruqnKEdq1w
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
你是否在用Claude Code?
|
||||||
|
|
||||||
|
Claude Code 是当前最当前最受欢迎的AI 编程工具之一,以终端为入口、以项目级上下文为核心、以安全可控为底线,很适合追求效率与工程化的独立开发者与团队。(由于Anthropic常封国人账号,也许很多国人是使用Claude Code替代工具:OpenCode~~)
|
||||||
|
|
||||||
|
如果在用Claude Code,给大家推荐一个开源项目。一款由国人开发的项目,可以让你的 Claude Code 秒变 Openclaw,换个方式吃龙虾肉。
|
||||||
|
|
||||||
|
|
||||||
|
|
||||||
|
这是一款很实用的Agent 客户端,支持Telegram、Discord、飞书,可任意组合启用连接,实现远程控制。
|
||||||
|
|
||||||
|
这项目就是由藏师傅开发的CodePilot。
|
||||||
|
|
||||||
|
|
||||||
|
|
||||||
|
刚开始这个项目的定位只是 Claude Code 的桌面端,现已支持:
|
||||||
|
|
||||||
|
> 飞书等 IM 远程连接;
|
||||||
|
>
|
||||||
|
> 可视化配置所有 Code plan 套餐;
|
||||||
|
>
|
||||||
|
> 藏师傅写的设计 Agent 和素材库;
|
||||||
|
>
|
||||||
|
> 多个 Agent 并发分屏;
|
||||||
|
>
|
||||||
|
> Token 使用检测看板;
|
||||||
|
>
|
||||||
|
> 还能一键帮你安装 Claude Code ;
|
||||||
|
>
|
||||||
|
> MacOS 和 Windows 全平台支持。
|
||||||
|
>
|
||||||
|
> 藏师傅
|
||||||
|
|
||||||
|
通过这个客户端,你可以非常优雅而且全面把 Claude Code 连接各种 IM 工具,比如飞书之类。非常适合小白入门和使用,而使用上比 OpenClaw 安全多了。
|
||||||
|
|
||||||
|
CodePilot:可以说是一个Claude Code 桌面端 + Cowork + OpenClaw的组合体。
|
||||||
|
|
||||||
|
项目开源地址:
|
||||||
|
|
||||||
|
```
|
||||||
|
https://github.com/op7418/CodePilot/
|
||||||
|
```
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
这款Agent 客户端发布不久,但一直在迭代,听说这几天会加上记忆和心跳机制,功能越来越强,值得大家试用哦。
|
||||||
|
|
||||||
|
更多详细的功能和接入指南就不在这里细说了,
|
||||||
|
|
||||||
|
有需要可直接去看中文文档:
|
||||||
|
|
||||||
|
```
|
||||||
|
https://github.com/op7418/CodePilot/blob/main/README_CN.md
|
||||||
|
```
|
||||||
|
|
||||||
|
如果觉得内容不错,随手点个赞、在看、转发
|
||||||
|
|
||||||
|
如果想第一时间收到推送,也可以给我个星标⭐,谢谢。
|
||||||
@@ -0,0 +1,65 @@
|
|||||||
|
# 📊 文章摘要:国人真牛!把 ClaudeCode 秒变 Openclaw,可飞书、Discord 远程控制!
|
||||||
|
|
||||||
|
> **原文**:[2026-08-20_国人真牛_把_ClaudeCode_秒变_Openclaw_可飞书_Discord_远程控制](./2026-08-20_国人真牛_把_ClaudeCode_秒变_Openclaw_可飞书_Discord_远程控制.md)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/93dtdbUbyrjSruqnKEdq1w
|
||||||
|
> **来源**:微信公众平台
|
||||||
|
> **作者**:数字元哥
|
||||||
|
> **发布日期**:2026-08-20
|
||||||
|
> **摘要日期**:2026-08-20
|
||||||
|
> **价值评级**:⭐ 低
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 核心命题
|
||||||
|
|
||||||
|
> **IM 接入** — 开源客户端 CodePilot 让 Claude Code 可经飞书/Discord/Telegram 远程控制
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 文章概要
|
||||||
|
|
||||||
|
这是一篇工具推荐文:介绍国人开发者"藏师傅"(歸藏)的开源项目 CodePilot,它最初是 Claude Code 桌面端,现已支持飞书/Telegram/Discord 远程连接、多 Agent 并发分屏、Token 用量看板等功能,作者将其定位为"Claude Code 桌面端 + Cowork + OpenClaw 的组合体"。文章对产品价值的实际价值在于给出了开源地址和中文文档入口;但对功能只有罗列、无实测体验、无技术细节,"比 OpenClaw 安全多了"的说法未给出任何论证,属于低信息密度的转述型安利文。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 关键要点
|
||||||
|
|
||||||
|
1. **CodePilot 支持多 IM 远程控 Claude Code** — Telegram、Discord、飞书可任意组合启用连接 `[分类: 共识]`
|
||||||
|
2. **功能清单** — 可视化配置 Code plan 套餐、设计 Agent 与素材库、多 Agent 并发分屏、Token 检测看板、一键安装 Claude Code、macOS/Windows 全平台 `[分类: 共识]`
|
||||||
|
3. **产品定位** — 作者转述:"Claude Code 桌面端 + Cowork + OpenClaw 的组合体" `[分类: 共识]`
|
||||||
|
4. **"比 OpenClaw 安全"** — 原文断言无论证,安全机制只字未提 `[分类: 争议]`
|
||||||
|
5. **路线图(传闻级)** — "听说这几天会加上记忆和心跳机制",非官方确认 `[分类: 未探索]`
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 批判性分析
|
||||||
|
|
||||||
|
### 假设前提
|
||||||
|
- 预设读者已在用 Claude Code 且有远程/移动端控制需求
|
||||||
|
- 预设"接入 IM = 更好用",未讨论远程暴露终端 Agent的安全代价
|
||||||
|
|
||||||
|
### 论据与逻辑
|
||||||
|
- 全文无实测、无截图佐证的功能细节、无与 OpenClaw 的对比数据,结论均为主观断言
|
||||||
|
- 信息源基本转自项目 README,独立增量信息有限
|
||||||
|
|
||||||
|
### 边界与局限
|
||||||
|
- 未说明 CodePilot 的权限模型、飞书接入配置成本、数据流向
|
||||||
|
- 与同一项目作者首发的《我复刻了 Claude 刚发布的生成式 UI 交互!》相比,本文无一手信息
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 可引用金句
|
||||||
|
|
||||||
|
> "CodePilot:可以说是一个Claude Code 桌面端 + Cowork + OpenClaw的组合体。"
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 总体评价
|
||||||
|
|
||||||
|
**亮点**:提供了 CodePilot 开源地址与中文文档入口;功能清单可当作产品速览。
|
||||||
|
|
||||||
|
**不足**:无实测、无论证、有夸大倾向("比 OpenClaw 安全多了"无依据);信息密度低。
|
||||||
|
|
||||||
|
**适用场景**:仅作为发现 CodePilot 这一工具的线索;技术决策前必读项目官方文档。
|
||||||
|
|
||||||
|
**关联建议**:务必与《我复刻了 Claude 刚发布的生成式 UI 交互!》(同一项目作者一手文章)对照阅读,获取真实的技术与产品信息。
|
||||||
@@ -0,0 +1,556 @@
|
|||||||
|
# 万字长文:做了些爆款 Skills 以后,我对 Skills 的看法
|
||||||
|
|
||||||
|
> **来源**:微信公众平台(歸藏的AI工具箱)
|
||||||
|
> **作者**:歸藏的AI工具箱
|
||||||
|
> **发布日期**:2026-08-20(原文未标注明确日期,按下载日占位)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/sZXl5kHA9LErEwnegpvgXg
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
我最近几次聊 Skills,有一个越来越明确的判断:
|
||||||
|
|
||||||
|
大家现在都在说 Agent,但大多数人其实还没有真正理解 Agent。
|
||||||
|
|
||||||
|
大众理解里的 Agent,往往还是一个聊天框。
|
||||||
|
|
||||||
|
你输入一句话,它回答一段文字;你再输入一句,它继续回答。
|
||||||
|
|
||||||
|
这个视角下,AI 好像天然会带来一种平权:以前不会写代码的人可以写代码,不会做 PPT 的人可以做 PPT,不会剪视频的人可以剪视频。
|
||||||
|
|
||||||
|
只要模型足够强,大家的能力差距就会被抹平。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
但我越来越觉得,这个判断是错的。Agent 不是简单抹平能力差距,而是在放大能力差距。
|
||||||
|
|
||||||
|
头部用户已经默认理解 Agent 的组成:
|
||||||
|
|
||||||
|
文档、规则、memory、loop、MCP、CLI、工具调用、权限、安全沙箱、上下文工程、定时任务、心跳、文件系统、代码执行和 Skill。
|
||||||
|
|
||||||
|
但普通用户只知道"Agent 能写代码""Agent 可以调用 Skill",并不知道 Agent 的上限从哪里来,也不知道自己应该如何组织目标、资料和流程,才能让 Agent 真正工作。
|
||||||
|
|
||||||
|
**Agent**:这里指的不只是聊天机器人,而是能理解目标、规划步骤、调用工具并持续执行任务的 AI 系统。
|
||||||
|
|
||||||
|
**Memory**:Agent 用来保存长期偏好、项目状态和历史决策的外部记忆,不等同于模型训练记忆。
|
||||||
|
|
||||||
|
**Loop**:Agent 反复"思考、调工具、观察结果、再决定下一步"的执行循环。
|
||||||
|
|
||||||
|
这里就出现了一个很大的认知割裂:头部用户已经在搭系统,普通用户还在问聊天框。
|
||||||
|
|
||||||
|
目标清晰、上下文好、品味和判断强的人,会被 Agent 放大;目标混乱、没有文档、没有判断的人,也会被 Agent 放大混乱。
|
||||||
|
|
||||||
|
所以用户会出现 K 型分化。去年还可以靠产品设计、交互设计和用户教育降低一些门槛,今年我觉得已经很难靠简单 UX 弥合这个差距。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
Skill 则可以弥合 Agent 使用能力差距。
|
||||||
|
|
||||||
|
## Skill 是能力商品,不只是提示词
|
||||||
|
|
||||||
|
我现在对 Skill 的一句话定义是:
|
||||||
|
|
||||||
|
Skill 是把专家经验、工作流、品味和工具调用封装成可分发、可复用、可迭代的 Agent 能力单元。
|
||||||
|
|
||||||
|
**Skill**:把提示词、流程、工具调用、模板、脚本、边界和经验打包起来的可复用能力单元。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
它不是单纯的提示词,也不是传统意义上的 App。
|
||||||
|
|
||||||
|
它更像 Agent 时代的"能力商品"。用户不需要理解底层的 MCP、CLI、workflow、memory、loop、模型选择、代码执行和上下文工程,只需要知道:
|
||||||
|
|
||||||
|
它解决什么问题,产出什么结果,怎么使用,别人用得怎么样。
|
||||||
|
|
||||||
|
提示词本身很难成为产品。它容易被复制,难以分发,没有版本管理,也缺少安装和调用语义。
|
||||||
|
|
||||||
|
Skill 把提示词、规则、示例、工具调用、文件结构、脚本、依赖和使用说明打包起来,让它变成一个可以安装、调用、迭代和传播的能力包。
|
||||||
|
|
||||||
|
所以 Skill 和 Prompt 本质上并非完全不同,但 Skill 的调用效率更高,分发和理解成本更低,也能承载更多工程化内容。
|
||||||
|
|
||||||
|
更重要的是,很多任务并不是一句提示词能解决的。
|
||||||
|
|
||||||
|
它们是一组稳定流程:读取材料,分析需求,选择模板,调用工具,生成产物,验证结果,修复问题,导出文件。
|
||||||
|
|
||||||
|
Skill 把这套流程从一次性对话中抽出来,变成可以反复调用的工作流。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
比如 PPT Skill 的流程不是"生成 PPT"这么简单。
|
||||||
|
|
||||||
|
它要读取文章或大纲,询问主题、页数和配图,选择主题、颜色和版式,生成 HTML PPT,自动后验检查常见问题,再修正缺属性、未居中、溢出、图片裁切、节奏重复等问题,必要时还要调用图像模型生成配图,最后输出可演示、可分享的文件。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
这背后真正有价值的,是 Skill 把人的演示经验被外化了。
|
||||||
|
|
||||||
|
## Skill 的核心,是把人的经验外化
|
||||||
|
|
||||||
|
我做的设计类 Skill 很能说明这一点。
|
||||||
|
|
||||||
|
真正有价值的部分是把人的审美、版式判断、设计系统经验、模板选择、图片裁切规则、明暗遮罩规则、字体和颜色规则固化进去。
|
||||||
|
|
||||||
|
这要求创作者同时懂三件事:传统专业知识,AI 的上下限,以及产品化思维。
|
||||||
|
|
||||||
|
传统专业知识决定你知道什么结果算好。比如设计、剪辑、写作、健身、法律、商业化投放,每个行业都有大量隐性判断。AI 的上下限决定你知道模型什么能做、什么做不稳、什么必须工程化兜底。
|
||||||
|
|
||||||
|
产品化思维决定你知道用户场景、使用门槛、反馈路径和稳定性要求。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
这也是我做几个 Skill 时最深的体会。
|
||||||
|
|
||||||
|
PPT Skill 最开始不是为了"做一个 Skill",是因为我真的要做一场分享。
|
||||||
|
|
||||||
|
第一版基本成型后,我通过五六轮对话调整间距、字号、字体、颜色、配图、重复内容、WebGL 背景等问题。
|
||||||
|
|
||||||
|
讲完之后发现大家最关心的不是分享本身,而是 PPT 怎么做,于是才把这套模板和流程沉淀成 Skill。
|
||||||
|
|
||||||
|
社交媒体卡片 Skill 也不是凭空抽象出来的。它来自非常具体的内容分发需求:
|
||||||
|
|
||||||
|
3:4 竖版图文卡片,适配小红书、公众号、Twitter 等不同场景。它要处理 11 类内容,两套视觉系统,28 个版式骨架,真实图片 + Coding 排版,还要规避 AI 图限流、文字不锐利、平台风格不匹配等问题。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
Logo Generator Skill 也是同一逻辑。它没有直接让图像模型一把梭生成 Logo,因为图片模型的文字、结构和可编辑性不稳定。
|
||||||
|
|
||||||
|
它选择先生成 SVG Logo 变体,再生成展示图和 WebGL 背景,把 Logo 本体、展示场景和交互背景拆成不同层,分别用最适合的技术处理。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
AI Desk Card 则说明 Skill 的边界可以扩展到物理环境。
|
||||||
|
|
||||||
|
它让 Agent 接管屏幕边缘的物理信息位:固件烧录、Wi-Fi 配置、信息推送、定时任务、memory、todo、日历、GitHub 展示、墨水屏刷新,都可以被封装成一套 Skill。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
这些案例共同说明:Skill 的核心是"人把什么经验变成了可调用的能力"。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
## 用户不关心概念,用户关心结果
|
||||||
|
|
||||||
|
对普通用户来说,Skill、MCP、CLI、Plugin 叫什么并不重要。
|
||||||
|
|
||||||
|
他们关心的是:这个功能能解决什么问题,适合什么场景,我点一下能不能用,需要输入什么材料,结果长什么样,别人用得怎么样。
|
||||||
|
|
||||||
|
**MCP**:Model Context Protocol,可以理解为让 AI 以统一方式连接外部工具、数据源和服务的协议。
|
||||||
|
|
||||||
|
**CLI**:Command Line Interface,命令行工具;对 Agent 来说,它常常是比图形界面更稳定、更容易自动化的操作入口。
|
||||||
|
|
||||||
|
因此,面向用户的产品层不应该堆术语。Codex 把很多东西统一叫插件,我觉得就是一个正确方向:弱化概念,强调功能。
|
||||||
|
|
||||||
|
底层可以是 Skill、MCP、CLI 或原生 Plugin;用户只需要知道它能干什么。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
但对产品和创作者来说,这些底层形态的区别又很重要。
|
||||||
|
|
||||||
|
Skill 适合承载相对垂直、可描述、可复用的工作,比如 PPT、社交媒体卡片、文章配图、写作润色、视频包装、简历优化、数据可视化、某个行业 SOP。
|
||||||
|
|
||||||
|
MCP 更适合 Agent 架构中的原子服务和上下文连接,比如地图、浏览器、网盘、设计稿、数据库、企业 API。
|
||||||
|
|
||||||
|
CLI 则是目前很现实的通用 Plugin 形态:命令行、代码、Skill 都可以封装进去,也不绑定单一 Agent 平台。
|
||||||
|
|
||||||
|
飞书 CLI 就是一个很好的例子。用户不用理解 200 多条命令,也不用知道背后是哪个 API。
|
||||||
|
|
||||||
|
他只需要说"帮我把今天的智能纪要拉到笔记里",Agent 背后可以搜索云文档、读取妙记、下载逐句转写、写入本地 Markdown、建立反向链接。
|
||||||
|
|
||||||
|
用户看到的是结果,Agent 用的是工具,Skill 封装的是流程。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
这也是为什么 Skill、CLI 和 MCP 的关系不能只从技术概念上理解。
|
||||||
|
|
||||||
|
它们最终都要落到一个问题:怎么让普通用户用上头部用户已经验证过的能力。
|
||||||
|
|
||||||
|
## 好 Skill 的架构:中心短,辐射厚
|
||||||
|
|
||||||
|
很多人会把 Skill 理解成一个 SKILL.md 文件,这只说对了一半。
|
||||||
|
|
||||||
|
**SKILL.md**:很多 Skill 的入口说明文件,用来告诉 Agent 什么时候加载这个能力、按什么流程执行、哪些坑不能踩。
|
||||||
|
|
||||||
|
好的 Skill 往往是一个目录。SKILL.md 只是入口,旁边还可以有 scripts/、references/、assets/、模板、schema、配置文件、子 Skill 和特殊案例。
|
||||||
|
|
||||||
|
复杂 Skill 不怕有复杂内容,怕的是把复杂内容一次性塞给模型。文件系统本身就是一种上下文工程。
|
||||||
|
|
||||||
|
**上下文窗口**:AI 一次能"看见"和处理的信息范围,文档、代码、聊天记录和工具说明都会占用它。
|
||||||
|
|
||||||
|
好 Skill 的信息架构应该是"中心短,辐射厚"。
|
||||||
|
|
||||||
|
SKILL.md 只放高信号流程和判断;references/ 放重文档和领域材料,按条件读取;scripts/ 放确定性逻辑,让 Agent 调用而不是重写;assets/ 放模板、schema、示例、字体、主题和版式骨架;配置文件或稳定数据目录放首次配置、偏好和历史记录。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
这里有个很关键的点:Skill 的 description 不是宣传语,也不是功能摘要,是路由触发器。
|
||||||
|
|
||||||
|
好的 description 应该描述用户什么时候需要它,最好来自真实用户表达;坏的 description 只是解释"这个 Skill 做什么"。
|
||||||
|
|
||||||
|
比如一个 PPT Skill,不应该写"这个 Skill 可以生成漂亮 PPT"。
|
||||||
|
|
||||||
|
它应该写"当用户需要把文章、大纲或演讲内容转成可演示 HTML PPT 时加载"。前者是广告,后者是 Agent 的判断条件。
|
||||||
|
|
||||||
|
这能解释为什么"把所有能力塞进一个大 Agent"不是好方向。
|
||||||
|
|
||||||
|
大而全的 harness 会把工具定义、协议细节和长文档塞满上下文,带来更高延迟、更高 token 成本和更多误用。
|
||||||
|
|
||||||
|
反过来,薄 harness 只提供最小运行环境,Skill 作为按需加载的能力包,才能让系统长期复利。
|
||||||
|
|
||||||
|
**Harness**:运行 Agent 的外层程序,负责模型循环、文件读写、上下文管理和安全边界。
|
||||||
|
|
||||||
|
更稳的架构是 Thin Harness, Fat Skills:harness 保持薄,负责跑模型循环、读写文件、管理上下文、执行权限和安全边界;
|
||||||
|
|
||||||
|
Skill 变厚,承载流程、判断、领域知识、模板、脚本、资产、gotchas 和 eval;
|
||||||
|
|
||||||
|
确定性工具下沉给 CLI、scripts 或 API;模型留在理解、判断、综合、取舍和表达这些更适合它的部分。
|
||||||
|
|
||||||
|
**Thin Harness, Fat Skills**:让 Agent 底层运行环境保持轻,把具体流程、领域知识、模板、脚本和失败经验放进按需加载的 Skill 里。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
## Skill 质量要像代码质量一样维护
|
||||||
|
|
||||||
|
好 Skill 不是一次写完。它需要维护,而且要像代码质量一样维护。
|
||||||
|
|
||||||
|
一个比较可靠的生命周期是:
|
||||||
|
|
||||||
|
1. 先用无 Skill 的 Agent 跑真实任务,找到它会错在哪里;
|
||||||
|
|
||||||
|
2. 基于真实 query 写 eval,包括正例、反例和 forbidden load;
|
||||||
|
|
||||||
|
3. 先调 description,确保该加载时加载,不该加载时不加载;
|
||||||
|
|
||||||
|
4. 写主体时删除显而易见的内容,只保留会改变模型行为的判断;
|
||||||
|
|
||||||
|
5. 把失败案例追加到 gotchas,而不是不断加长主流程;改 description 或路由边界时补 eval;
|
||||||
|
|
||||||
|
6. 再做跨模型测试,看不同编排模型对 Skill 触发和执行的差异。
|
||||||
|
|
||||||
|
**Eval**:用一组真实或模拟任务测试 Skill 是否按预期触发、执行和交付结果。
|
||||||
|
|
||||||
|
**Gotchas**:从真实失败里总结出来的"别这么做"清单,往往比正向说明更能提升 Skill 稳定性。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
每个 Skill 都是一种税。
|
||||||
|
|
||||||
|
它进入索引后,每个会话、每个用户都在为它的 name 和 description 付上下文成本;
|
||||||
|
|
||||||
|
它被加载后,后续对话都在为主体内容付成本。
|
||||||
|
|
||||||
|
所以每一句都要问:没有这句,Agent 会不会做错?如果不会,就删。
|
||||||
|
|
||||||
|
gotchas 是最高价值内容,因为它们来自真实失败。
|
||||||
|
|
||||||
|
正向原则往往模型已经知道,负面边界才是专家经验。
|
||||||
|
|
||||||
|
设计 Skill 中"不要纯白纯黑""连续三页相同节奏是 P0 错误""文字不能压脸""AI 图只在无合适真实图时使用",都属于 gotchas 或强约束。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
这也解释了为什么完全自动生成 Skill 只能做初稿。
|
||||||
|
|
||||||
|
模型可以帮你起草结构,但它无法凭空拥有你的失败样本、审美判断、行业边界和用户反馈。
|
||||||
|
|
||||||
|
真正有价值的是人把经验注入进去,再通过 eval 和 gotchas 让它持续变厚。
|
||||||
|
|
||||||
|
## 设计 Skill 的本质:把品味变成约束
|
||||||
|
|
||||||
|
设计类 Skill 不是简单的"AI 会画图"。
|
||||||
|
|
||||||
|
它需要解决模型不稳定、图像限流、文字不锐利、排版不可控、风格一致性难判断等问题。
|
||||||
|
|
||||||
|
设计 Skill 的核心是把专业品味变成模型可执行的限制。
|
||||||
|
|
||||||
|
模型默认会收敛到一些平庸模式:
|
||||||
|
|
||||||
|
Tailwind 大色块、紫色渐变、emoji 堆砌、Inter 字体、发光、过度圆角、无意义动效、信息密度失控。这不是模型没有审美素材,而是没有稳定的取舍原则。
|
||||||
|
|
||||||
|
所以设计 Skill 里最有价值的是主观但明确的约束:
|
||||||
|
|
||||||
|
• 不使用纯白和纯黑,降低刺眼和廉价感;
|
||||||
|
|
||||||
|
• 不让用户任意输入 hex,只提供经过验证的主题色板;
|
||||||
|
|
||||||
|
• 不用紫色多彩渐变、发光和大面积 blur 作为主视觉捷径;
|
||||||
|
|
||||||
|
• 动画只在必要时使用,且只动 transform 和 opacity;
|
||||||
|
|
||||||
|
• 图文卡片优先真实摄影和截图美化,AI 生图只是兜底;
|
||||||
|
|
||||||
|
• 版式骨架先被人工验证,AI 负责填充、组合和微调;
|
||||||
|
|
||||||
|
• 文字必须根据图像主体、明度和可读区域自适应落点、字色、遮罩和断行。
|
||||||
|
|
||||||
|
这些规则看起来限制自由,实际是在保护输出下限。设计类 Skill 的质量来自"替用户排除绝大多数会变丑的选项"。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
好看不是玄学,而是可拆解、可编码、可检查的行业常识。
|
||||||
|
|
||||||
|
Skill 的价值,就是把这些常识压进 SKILL.md、模板、checklist、主题变量和后验检查里。
|
||||||
|
|
||||||
|
PPT Skill 和社交媒体卡片 Skill 的一个共同方法,是把 AI 的任务从"自由设计"降级成"在高质量骨架里填充"。
|
||||||
|
|
||||||
|
PPT Skill 里,10 种页面布局、5 套主题色、字体三级分工、7:5 / 6:6 / 8:4 网格、hero 与 non-hero 的节奏交替,构成了一个稳定的演示系统。AI 不需要从零发明版式,只需要根据内容选择合适页面类型并填进去。
|
||||||
|
|
||||||
|
社交媒体卡片 Skill 进一步把场景校准到手机信息流:
|
||||||
|
|
||||||
|
3:4 是主战场,1 秒决定停不停下。它不是把 PPT 截图成竖图,而是重新定义了图文品类、版式比例、断行规则和素材优先级。
|
||||||
|
|
||||||
|
11 个内容品类、两套视觉系统、28 个版式骨架、截图美化、地图组件、真实图库和克制 AI 生图,共同构成了"内容平台视觉 Skill"。
|
||||||
|
|
||||||
|
Logo Generator Skill 也是同一逻辑:
|
||||||
|
|
||||||
|
不直接让图像模型一把梭生成 Logo,因为图片模型的文字、结构和可编辑性不稳定;
|
||||||
|
|
||||||
|
它是先生成 SVG 变体,再做展示图和 WebGL 背景。这里把 Logo 本体、展示场景、交互背景拆成不同层,分别用最适合的技术处理。
|
||||||
|
|
||||||
|
人工沉淀审美系统,模型理解内容和语义,代码负责稳定排版和导出,图像模型只处理适合它的视觉部分。
|
||||||
|
|
||||||
|
这比单纯"让 AI 画一张图"更慢一点,但可控、可改、可复用,也更适合内容创作者长期使用。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
## Skill 生态不能做成仓库列表
|
||||||
|
|
||||||
|
如果一个 Skill 能被图文、案例、评价、使用数据、作者、应用场景反向链接起来,它就不只是一个工具,而是一个社区节点。
|
||||||
|
|
||||||
|
**反向链接**:从使用案例、文章、图文或项目页面反过来链接到某个 Skill,让人能看到它被谁用、怎么用、效果如何。
|
||||||
|
|
||||||
|
当前很多 Skill 展示的问题是:
|
||||||
|
|
||||||
|
列表很长,像 GitHub 仓库名;图标都一样;没有结果展示;没有评价指标;
|
||||||
|
|
||||||
|
多模态 Skill 也只用文本展示;用户不知道哪个适合自己。
|
||||||
|
|
||||||
|
推荐 10 个或 20 个精选 Skill,并讲清楚怎么用,远好过给用户几千个列表。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
每个 Skill 都应该像一个软件功能页。页面应该说明:
|
||||||
|
|
||||||
|
它解决什么问题,适合什么场景,需要输入什么,输出长什么样,典型提示词是什么,生成结果截图或视频,谁用过、怎么评价,有哪些常见失败情况,如何安装和修改。
|
||||||
|
|
||||||
|
这本质上需要强运营。
|
||||||
|
|
||||||
|
不是把名字列出来,而是一个一个挑、一个一个写介绍、展示结果,最好还有视频讲解。
|
||||||
|
|
||||||
|
GitHub 是代码型 Skill 的天然托管地,因为 Skill 往往包含代码,需要版本管理;
|
||||||
|
|
||||||
|
GitHub 有生态位、版权声明和分发基础;AI 也熟悉 Git 和 GitHub 操作;开源还能覆盖所有 Agent 平台,不绑定单一产品。
|
||||||
|
|
||||||
|
但小红书适合做视觉内容和使用案例分发。
|
||||||
|
|
||||||
|
小红书的优势是内容感知、视觉展示、用户审美和评论体系。
|
||||||
|
|
||||||
|
PPT Skill 和社交媒体卡片 Skill 都已经在小红书之外的人群中传播,比如咖啡馆主理人、数码测评、活动策划、餐厅、三线城市分享场景。这说明 Skill 能跨出 AI 圈。
|
||||||
|
|
||||||
|
应用商店式 Skill 分发也有潜力:更精准推荐、更低使用门槛、可能给创作者分成。
|
||||||
|
|
||||||
|
但对创作者来说,如果只在一个平台上架,就等于押注这个平台能做好产品、生态、分发和市场占领。
|
||||||
|
|
||||||
|
更稳的策略可能是:GitHub 做基础分发和跨平台覆盖,平台 Skillhub / 应用商店做体验优化、运营推荐和商业转化。
|
||||||
|
|
||||||
|
未来的 Skill 平台,本质上会同时是 App Store、GitHub、社区种草页、评价系统和 Agent 工具层。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
## 普通用户真正卡在哪里
|
||||||
|
|
||||||
|
AI 圈外的人并非不能用 Skill。
|
||||||
|
|
||||||
|
实际观察中,咖啡馆主理人、数码测评、活动策划、健身教练等都能用出好结果。
|
||||||
|
|
||||||
|
真正卡点是交互心智。
|
||||||
|
|
||||||
|
很多人仍然用传统软件思维,以为一次生成就该完成:
|
||||||
|
|
||||||
|
不习惯通过 chat 连续调整;不知道可以要求 AI 改颜色、改字、修溢出、换图;不知道如何提供上下文和素材;也不知道如何从自己的工作流中抽 Skill。
|
||||||
|
|
||||||
|
因此,Skill 产品不仅要提供安装,还要提供使用教育。
|
||||||
|
|
||||||
|
行业 Skill 会是一个很重要的方向。很多行业有非常好的经验和客户洞察:
|
||||||
|
|
||||||
|
健身、法律、餐饮、活动策划、教育、商业化投放等。但行业专家不一定知道如何做 Skill,也担心分享后被盗。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
这里的关键不是把 Skill 作为服务添加项。
|
||||||
|
|
||||||
|
健身教练可以用 Agent 维护会员饮食、训练、有氧、提醒和反馈,提高客户粘性和服务效率。
|
||||||
|
|
||||||
|
法律从业者可以把琐碎文本处理、条文审查、格式检查做成辅助 Skill,但核心判断仍由人完成。
|
||||||
|
|
||||||
|
餐饮和活动行业可以用图文 Skill 把真实图片和故事包装成可传播内容。
|
||||||
|
|
||||||
|
AI 不能替代线下履约,但可以提高获客、沟通、维护和复用效率。
|
||||||
|
|
||||||
|
这类行业用户只需要基础启蒙:带他做一次需求分析,落地成一个 Skill,他就知道边界在哪里。
|
||||||
|
|
||||||
|
每个行业都有先锋用户:有创造力、有好奇心、想用 AI 获得竞争优势。先服务这些人。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
## 内容 Skill:文章、产品和案例互相喂养
|
||||||
|
|
||||||
|
从我已有文章看,我正在形成一条很清晰的内容 Skill 路线:
|
||||||
|
|
||||||
|
不是为某个抽象 AI 概念写文章,是先做出一个能用的 Skill,再把制作过程、设计判断和使用场景写成传播内容。
|
||||||
|
|
||||||
|
这类内容有几个特点。
|
||||||
|
|
||||||
|
PPT Skill 最初来自一次 AI 和组织分享,观众问得最多的是 PPT 怎么做,于是从一次交付沉淀成开源 Skill。这是副产品变主产品。
|
||||||
|
|
||||||
|
文章本身像说明书,但不是 README。
|
||||||
|
|
||||||
|
它要讲清楚为什么这样设计、适合谁、边界在哪、真实效果如何,降低用户理解门槛。
|
||||||
|
|
||||||
|
产品演示本身就是内容资产。PPT 截图、图文卡片、Logo 展示图、Desk Card 场景图,都可以成为传播素材。
|
||||||
|
|
||||||
|
Skill 反过来也提升写作效率。社交卡片 Skill 可以把文章段落直接转成更适合小红书、公众号或 Twitter 的视觉卡片。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
每篇文章都在扩展 Skill 的语义边界。
|
||||||
|
|
||||||
|
PPT 是演示,Social Card 是内容分发,Logo 是项目品牌资产,Desk Card 是硬件和环境 UI,夜巡录则指向游戏 demo 工作流。
|
||||||
|
|
||||||
|
这说明 Skill 不只是"工具产品",也是内容创作者的表达基础设施。
|
||||||
|
|
||||||
|
过去文章和产品是分开的:先做产品,再写推广。现在 Skill、文章、案例、开源仓库、社交反馈会互相喂养。
|
||||||
|
|
||||||
|
这就是个人产品在 Agent 时代的复利飞轮。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
## Skill 的边界会继续扩大
|
||||||
|
|
||||||
|
过去"插件"通常意味着软件里的一个按钮。现在 Skill 的边界可以明显更大。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
浏览器 Skill 会是消费者入口。Tabbit Browser 一类产品说明,Skills 可以进入浏览器场景,变成普通用户在网页、资料、脚本和自动化之间的入口。
|
||||||
|
|
||||||
|
浏览器是大众最熟悉的工作环境,如果 Skill 能以"现成脚本 / 使用案例 / 一键执行"的方式出现,会比裸露 CLI 或 GitHub 仓库更容易被理解。
|
||||||
|
|
||||||
|
硬件 Skill 则说明 AI 可以接管环境 UI。
|
||||||
|
|
||||||
|
AI Desk Card 的价值在于它把 Agent 的能力延伸到了物理环境:
|
||||||
|
|
||||||
|
安装固件、配置 Wi-Fi、写 cron、读取 Memory、选择 widget、刷新墨水屏,全流程由 AI 引导。用户不再面对 App 设置页,AI 本身就是设置页。
|
||||||
|
|
||||||
|
游戏 Skill 代表更长链路的创作流程。
|
||||||
|
|
||||||
|
夜巡录开发手记里提到的"独立游戏 demo Skill",从玩法母题、原型、素材采集、绿幕抠图、contact sheet、视频生成、音乐、Electron 打包、GitHub Actions 到 Release。
|
||||||
|
|
||||||
|
封装是一套跨程序员、美术、动画、作曲和运维的生产流水线。它的价值是把"做个原型"和"独立交付完整作品"之间的墙变薄。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
Skill 的未来不只会局限在聊天框里,它会扩展到浏览器、桌面、本地文件、硬件、内容平台、游戏引擎和真实工作环境。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
## Skill 与 Gene:手写经验和自动进化的边界
|
||||||
|
|
||||||
|
还有一个值得保留但需要谨慎使用的对比:Agent Skill 与 GEP Gene。
|
||||||
|
|
||||||
|
Skill 更像人类预先沉淀的能力包:有明确创建者、明确边界、明确流程和版本。
|
||||||
|
|
||||||
|
Gene / Capsule 这类概念强调运行中从成功经验里自动长出能力:带成功率、变异历史、适用上下文和自动修复机制。
|
||||||
|
|
||||||
|
**Gene / Capsule**:这里指从 Agent 反复执行中的成功路径里沉淀出的可复用经验单元,强调自动演化而不是人工手写。
|
||||||
|
|
||||||
|
这两者不是简单替代关系,是不同的层级。
|
||||||
|
|
||||||
|
Skill 适合承载人的专家经验、审美、行业 SOP、工具不变式和明确交付标准;
|
||||||
|
|
||||||
|
Gene 适合从重复执行中捕捉成功路径,把临时试错变成可复用经验;Capsule 类似把多个 Gene 组合成更长工作流。
|
||||||
|
|
||||||
|
从当前产品现实看,Skill 仍是更可落地的单位,因为它能被写、被审、被发布、被解释、被传播。
|
||||||
|
|
||||||
|
但长期看,自动沉淀 Skill / Gene 化经验会成为方向:Agent 先用通用工具试错,成功后把路径写回 Skill 或生成新的子能力。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
这也回应了"自动沉淀 Skill"的讨论。系统可以自动发现重复流程,但是否值得沉淀、如何命名、边界在哪里、哪些失败要写进 gotchas,仍然需要人的判断。
|
||||||
|
|
||||||
|
真正理想的形态不是完全自动,也不是完全手写,而是人定义品味和边界,Agent 负责收集证据、提出改动、补充 eval 和维护长尾经验。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
## 盗用不是靠藏,防御方式是持续分发
|
||||||
|
|
||||||
|
Skill 很难靠闭源防盗。即便不开源,只要看到产出结果,试用几次,也可能被复刻。
|
||||||
|
|
||||||
|
所以防御方式不是"藏起来",而是开源覆盖更多平台,用影响力威慑过分盗用者,做自媒体让用户知道源头是谁,用持续迭代建立领先,用社区案例和评价体系形成品牌资产。
|
||||||
|
|
||||||
|
在产品壁垒降低的时代,个人产品如果没有渠道、资源和营销,就必须自己做宣发。以前自媒体是可选项,现在是基础设施。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
## 平台真正该做什么
|
||||||
|
|
||||||
|
如果要做 Skill 平台,不能只押 Skill。用户下载独立端的理由,首先是 Agent 基础体验足够好:
|
||||||
|
|
||||||
|
漂亮好用的客户端,多模型支持,尤其国产模型;文件、项目、memory、CLI、MCP、Skill 管理;
|
||||||
|
|
||||||
|
权限和安全沙箱;长程任务和状态延续;多设备流转,手机控制桌面,桌面反向控制手机;官方高质量插件开箱即用。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
Workbody 的启发是,它没有做特别独特的东西,只是把该有的基础体验做齐了。很多国内产品连这一点还没做好。
|
||||||
|
|
||||||
|
一些高频、必须、常见的能力应该内置并打磨好,不要让用户自己折腾安装。
|
||||||
|
|
||||||
|
官方插件强,会形成壁垒。多设备、云端和本地互控,也会形成壁垒。
|
||||||
|
|
||||||
|
Skill 与本地环境强相关时,移动端需要遥控 PC。
|
||||||
|
|
||||||
|
Skill 可跨端通用,但依赖本地文件、脚本、浏览器、CLI 的 Skill 在移动端很难直接跑。
|
||||||
|
|
||||||
|
移动端适合轻量级从 0 到 1 创作;桌面端适合重任务和本地环境调用。
|
||||||
|
|
||||||
|
自动沉淀 Skill 是长期方向,但好 Skill 仍需要人。Dumate 等产品提出"自动沉淀 Skill":从用户重复工作中自动总结流程。
|
||||||
|
|
||||||
|
这个方向成立,但好 Skill 仍需要业务 SOP、品味、测试和迭代。自动生成可以做初版,真正能稳定交付的 Skill 需要打磨。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
## 一个完整 Skill 生命周期
|
||||||
|
|
||||||
|
如果把前面的判断收束成一条路径,一个完整 Skill 生命周期大概是这样的。
|
||||||
|
|
||||||
|
1 先发现真实需求,从自己或行业用户的重复工作开始。
|
||||||
|
|
||||||
|
2 再做一次高质量产物,不要先抽象,先用 Agent 解决真实任务。
|
||||||
|
|
||||||
|
3 然后抽象流程,识别可复用步骤、输入、输出、约束和工具。
|
||||||
|
|
||||||
|
4 接着工程化模板,把审美、版式、调用、验证和修复机制固化。
|
||||||
|
|
||||||
|
5 再做跨模型测试,好模型看上限,差模型保下限。
|
||||||
|
|
||||||
|
6 之后才是封装发布,GitHub 托管,配 README、示例和安装方式。
|
||||||
|
|
||||||
|
7 再做内容分发,用小红书、Twitter、公众号、视频展示结果。
|
||||||
|
|
||||||
|
8 然后收集反馈,从 issue、评论区、用户案例和平台数据里找真实问题。反馈还要筛选,只吸收能提升泛化和稳定性的部分。
|
||||||
|
|
||||||
|
这条路看起来长,但它的本质很简单:
|
||||||
|
|
||||||
|
每一次真实任务,都不只是在完成任务,而是在积累下一次能调用的能力资产。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
Agent 时代最稀缺的是可复用的能力组织方式。
|
||||||
|
|
||||||
|
Skill 之所以重要,是因为它第一次让人的经验、工作流和品味,有机会变成一种可以分发、调用、评价和持续迭代的商品。
|
||||||
|
|
||||||
|
这可能才是 Agent 生态里真正的大机会。
|
||||||
|
|
||||||
|
好,今天的内容就到这里。如果你觉得有帮助,欢迎帮我点个赞,或者转发给你需要的朋友。
|
||||||
|
|
||||||
|

|
||||||
@@ -0,0 +1,84 @@
|
|||||||
|
# 📊 文章摘要:万字长文:做了些爆款 Skills 以后,我对 Skills 的看法
|
||||||
|
|
||||||
|
> **原文**:[2026-08-20_万字长文_做了些爆款_Skills_以后_我对_Skills_的看法](./2026-08-20_万字长文_做了些爆款_Skills_以后_我对_Skills_的看法.md)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/sZXl5kHA9LErEwnegpvgXg
|
||||||
|
> **来源**:微信公众平台
|
||||||
|
> **作者**:歸藏的AI工具箱
|
||||||
|
> **发布日期**:2026-08-20
|
||||||
|
> **摘要日期**:2026-08-20
|
||||||
|
> **价值评级**:⭐⭐⭐ 高
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 核心命题
|
||||||
|
|
||||||
|
> **经验商品化** — Skill 首次把人的专家经验、工作流和品味封装成可分发、可调用、可迭代的"能力商品",成为弥合 Agent 使用能力 K 型分化的关键机制。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 文章概要
|
||||||
|
|
||||||
|
本文是爆款 Skill 创作者的一手方法论总结。作者基于 PPT Skill、社交媒体卡片、Logo Generator、AI Desk Card 等实战案例,提出核心判断:Agent 不是抹平而是放大能力差距,用户正出现 K 型分化,而 Skill 是弥合这一差距的机制——它把专家经验外化为可复用的能力单元。文章系统阐述了 Skill 的定义、信息架构(中心短辐射厚、Thin Harness Fat Skills)、质量维护方法(eval + gotchas)、设计类 Skill 的本质(把品味变成约束)、生态分发策略(GitHub + 小红书 + 持续分发防盗)以及 Skill 与 Gene(自动进化经验)的层级关系。局限在于:案例全部来自作者个人实践,缺乏第三方验证与失败率数据,部分判断(如 K 型分化)是趋势推断而非实证结论。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 关键要点
|
||||||
|
|
||||||
|
1. **Agent 放大而非抹平能力差距** — 目标清晰、判断力强的人被 Agent 放大,目标混乱者也被放大混乱,用户呈 K 型分化;UX 设计已难以弥合这一差距 `[分类: 范式突破]`
|
||||||
|
2. **Skill 是能力商品,不是提示词** — 把专家经验、工作流、品味和工具调用封装成可分发、可复用、可迭代的能力单元;用户无需理解 MCP/CLI/memory 等底层概念 `[分类: 范式突破]`
|
||||||
|
3. **Thin Harness, Fat Skills 架构** — harness 保持薄(模型循环、权限、安全边界),Skill 变厚(流程、领域知识、模板、gotchas、eval);大而全 Agent 塞满上下文是反方向 `[分类: 争议]`
|
||||||
|
4. **description 是路由触发器,不是宣传语** — 好的 description 描述"用户什么时候需要它"(判断条件),坏的只解释"这个 Skill 做什么"(广告)`[分类: 共识]`
|
||||||
|
5. **"中心短,辐射厚"的信息架构** — SKILL.md 只放高信号流程;references/ 按条件读取重文档;scripts/ 放确定性逻辑;文件系统本身就是上下文工程 `[分类: 共识]`
|
||||||
|
6. **每个 Skill 都是一种税** — 进入索引后每个会话都为其 name/description 付上下文成本;每句都要问"没有这句 Agent 会不会做错,不会就删" `[分类: 共识]`
|
||||||
|
7. **gotchas 是最高价值内容** — 失败案例清单来自真实失败,负面边界才是专家经验;正向原则模型往往已知 `[分类: 共识]`
|
||||||
|
8. **设计 Skill 本质是把品味变成约束** — 主观但明确的规则(不用纯白纯黑、禁紫色渐变捷径、动画只动 transform/opacity)在保护输出下限;把 AI 任务从"自由设计"降级为"在高质量骨架里填充" `[分类: 范式突破]`
|
||||||
|
9. **防盗靠持续分发而非闭源** — 开源覆盖更多平台、做自媒体标明源头、持续迭代建立领先;壁垒降低时代自媒体是基础设施 `[分类: 争议]`
|
||||||
|
10. **Skill 与 Gene 是层级而非替代** — Skill 承载人的手写经验(可写、可审、可发布),Gene 从重复执行中自动沉淀成功路径;理想形态是人定义品味和边界,Agent 收集证据、补 eval `[分类: 未探索方向]`
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 批判性分析
|
||||||
|
|
||||||
|
### 假设前提
|
||||||
|
|
||||||
|
作者立论隐含三个前提:(1) Agent 能力差距主要来自使用者的组织能力而非模型能力——若模型快速进化到"全自动编排",K 型分化可能收窄;(2) 专家经验可以被显式编码进 SKILL.md 与规则——但大量隐性知识(审美、时机判断)未必能完整外化;(3) Skill 生态会形成分发-评价体系——这依赖平台方行为,尚无定论。
|
||||||
|
|
||||||
|
### 论据与逻辑
|
||||||
|
|
||||||
|
论据全部来自作者本人爆款 Skill 的一手经验,含具体设计细节(28 个版式骨架、11 类内容、gotchas 示例),内部效度高;但存在明显的幸存者偏差——只讲了成功的 Skill,未提供失败 Skill 的比例与原因。对"Grok Bot 式零配置"路线、平台战略的判断属趋势推断。文章逻辑链条完整:从现象(认知割裂)到定义(能力商品)到方法(架构/维护/分发)逐层递进。
|
||||||
|
|
||||||
|
### 边界与局限
|
||||||
|
|
||||||
|
适用于内容创作、设计、办公自动化等"可描述、可复用"的垂直工作流场景;对强物理约束、高安全合规、需实时数据的场景(作者自己也指出 AI 不能替代线下履约)不适用。作者为中国个人开发者视角,对平台政策、企业级采购的判断需打折。数据时效性:写作时点的 Skill 生态早期特征明显,结论可能随平台格局变化而失效。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 可引用金句
|
||||||
|
|
||||||
|
> "Agent 不是简单抹平能力差距,而是在放大能力差距。"
|
||||||
|
|
||||||
|
> "Skill 是把专家经验、工作流、品味和工具调用封装成可分发、可复用、可迭代的 Agent 能力单元。"
|
||||||
|
|
||||||
|
> "每个 Skill 都是一种税。"
|
||||||
|
|
||||||
|
> "gotchas 是最高价值内容,因为它们来自真实失败。正向原则往往模型已经知道,负面边界才是专家经验。"
|
||||||
|
|
||||||
|
> "好看不是玄学,而是可拆解、可编码、可检查的行业常识。"
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 总体评价
|
||||||
|
|
||||||
|
**亮点**:
|
||||||
|
- 一手爆款经验,方法论颗粒度细到可直接操作(description 写法、eval 顺序、gotchas 优先级)
|
||||||
|
- 提出"能力商品""Thin Harness, Fat Skills""中心短辐射厚"等可迁移框架
|
||||||
|
- 覆盖完整生命周期:需求发现→工程化→发布→分发→防盗→反馈
|
||||||
|
|
||||||
|
**不足**:
|
||||||
|
- 样本单一(全部为作者本人作品),存在幸存者偏差
|
||||||
|
- K 型分化、平台演化等判断缺乏数据支撑
|
||||||
|
- 对企业级场景(权限、审计、合规)着墨极少
|
||||||
|
|
||||||
|
**适用场景**:Agent/Skill 开发者、AI 产品经理、内容创作者工具设计、个人产品化路线规划
|
||||||
|
|
||||||
|
**关联建议**:可对照 OpenAI Anthropic 官方 Skill 工程文档验证方法论;与《Grok Bot 诞生》(本批归档)对读,理解零配置与厚 Skill 两条路线的张力;关注作者提到的 Gene/Capsule 自动沉淀方向的后续进展
|
||||||
@@ -0,0 +1,199 @@
|
|||||||
|
# 开源一个 PPT Skill|压进了我 10 年的设计经验
|
||||||
|
|
||||||
|
> **来源**:微信公众平台(歸藏的AI工具箱)
|
||||||
|
> **作者**:歸藏的 AI 工具箱
|
||||||
|
> **发布日期**:2026-08-20(原文未标注明确日期,按下载日占位)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/GXjjlxpIJ604HVCCZJkUBA
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
上周被李继刚老师邀请去做了场私享会,关于 AI 和组织的访谈。
|
||||||
|
|
||||||
|
散场之后,发现大家问得最多的一句话是:"那个 PPT 是什么做的,能不能开源一下?"
|
||||||
|
|
||||||
|
没想到副产品成了主产品。
|
||||||
|
|
||||||
|
索性就把它开源了,叫 guizang-ppt-skill(github.com/op7418/guizang-ppt-skill)。
|
||||||
|
|
||||||
|
今天这篇文章聊聊这个 Skill 长什么样,以及作为一个做了十年设计的人,我为什么会觉得它好看。
|
||||||
|
|
||||||
|
## 它长什么样
|
||||||
|
|
||||||
|
打开 Skill 生成的 PPT,第一眼的感觉大概是:这不太像 AI 做的。
|
||||||
|
|
||||||
|
|
||||||
|
|
||||||
|
几个直观特征:
|
||||||
|
|
||||||
|
- 封面:墨色底 + 衬线大标题,背后一层若隐若现的 WebGL 流体在缓缓流动
|
||||||
|
- 正文:底色切回纸白,墨字压在上面,像一本摊开的印刷杂志
|
||||||
|
- 翻页:横向左右滑动,键盘、滚轮、触屏手势都行,不是 PowerPoint 的下一页
|
||||||
|
- 元数据:每页四个角落有小号等宽字,写着 "Act II · 15 / 25" 这类报刊页码
|
||||||
|
|
||||||
|
我给这套视觉基调起了个名字,叫"电子杂志 × 电子墨水"。
|
||||||
|
|
||||||
|
灵感来源是《Monocle》《卫报》《NYT》这类印刷杂志的版式传统,叠加 Kindle 电子纸的阅读美学,再用当代 Web 的交互语法串起来。
|
||||||
|
|
||||||
|
## 它能做什么
|
||||||
|
|
||||||
|
Skill 目前提供 10 种页面布局、5 套主题色预设,和一套完整的翻页交互。
|
||||||
|
|
||||||
|
10 种布局覆盖了一场 15-30 页分享会用到的几乎所有页面类型:
|
||||||
|
|
||||||
|
|
||||||
|
|
||||||
|
开场封面、章节幕封、数据大字报、左文右图、图片网格、Pipeline 流程、悬念问题、大引用、Before/After 对比、图文混排。
|
||||||
|
|
||||||
|
每种都是一段可以直接粘贴的 HTML 骨架,改掉文字和图片就能用。
|
||||||
|
|
||||||
|
|
||||||
|
|
||||||
|
5 套主题分别对应不同场景:
|
||||||
|
|
||||||
|
**墨水经典** — 商业发布、通用默认
|
||||||
|
|
||||||
|
**靛蓝瓷** — 科技、研究、AI 发布会
|
||||||
|
|
||||||
|
**森林墨** — 自然、可持续、人文
|
||||||
|
|
||||||
|
**牛皮纸** — 怀旧、文学、独立杂志
|
||||||
|
|
||||||
|
**沙丘** — 艺术、设计、创意
|
||||||
|
|
||||||
|
每套主题只是 6 个 CSS 变量的不同取值,切换主题只要替换 :root 里那 6 行代码。
|
||||||
|
|
||||||
|
用户不允许自定义 hex,后面会说原因。
|
||||||
|
|
||||||
|
翻页交互支持键盘左右箭头、鼠标滚轮、触屏滑动、底部圆点跳转、ESC 键打开缩略图索引。
|
||||||
|
|
||||||
|
尽量接近在浏览器里翻一本真实杂志的体验。
|
||||||
|
|
||||||
|
产物是一个单文件 HTML,双击浏览器就能看,发给别人也只是一个文件,不用担心字体和动画在别人电脑上乱掉。
|
||||||
|
|
||||||
|
|
||||||
|
|
||||||
|
## 怎么用
|
||||||
|
|
||||||
|
其实这份 Skill 真正的价值不在模板本身,而在它定义了一套人 × AI 协作做 PPT 的接口。
|
||||||
|
|
||||||
|
下面三件事,是我自己用了一周后,觉得最值得告诉别人的。
|
||||||
|
|
||||||
|
### 先跟 AI 说清这 6 件事
|
||||||
|
|
||||||
|
Skill 装好之后,你只需要说一句"帮我做一份杂志风 PPT",Claude 会反过来主动问你 6 个问题:
|
||||||
|
|
||||||
|
1. 受众是谁、什么场景?(行业内部 / 商业发布 / 私享会)
|
||||||
|
2. 分享时长多久?(15 分钟 ≈ 10 页,30 分钟 ≈ 20 页)
|
||||||
|
3. 有没有原始素材?(文档、数据、旧 PPT、文章链接)
|
||||||
|
4. 有没有图片、放在哪?
|
||||||
|
5. 想要哪套主题色?(5 套预设里选)
|
||||||
|
6. 有没有硬约束?(必须包含 XX 数据 / 不能出现 YY)
|
||||||
|
|
||||||
|
你不用一次说完,它会一条条问。答完之后,它会先给你一份大纲和主题节奏表,对齐之后再开始写代码——这一步拦截了我 80% 的返工。
|
||||||
|
|
||||||
|
以前用 AI 做 PPT 最痛的是什么?是它直接开始写,等你看到第 10 页才发现整体方向就是错的。这套澄清流程把"对齐"前置到了开头。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
### 图片这样塞
|
||||||
|
|
||||||
|
图片放在和 index.html 同级的 images/ 文件夹,文件名有规则:
|
||||||
|
|
||||||
|
```
|
||||||
|
ppt/
|
||||||
|
├── index.html
|
||||||
|
└── images/
|
||||||
|
├── 01-cover.jpg
|
||||||
|
├── 03-figma.png
|
||||||
|
└── 05-dashboard.png
|
||||||
|
```
|
||||||
|
|
||||||
|
- 页号补零 + 英文语义——01 不是 1,cover 不是 fengmian。方便按顺序排,AI 引用也清晰
|
||||||
|
- 照片用 JPG,截图用 PNG——截图带文字,PNG 保真不糊
|
||||||
|
- 单张 ≥ 1600px 宽——大屏投影才不糊
|
||||||
|
|
||||||
|
你只需要告诉 Claude"第 3 页是 Figma 界面截图",它会自动写成 images/03-figma.png,你把同名文件丢进文件夹就行。
|
||||||
|
|
||||||
|
### 无损换图的秘诀:同名覆盖
|
||||||
|
|
||||||
|
文案改完想换张图,结果要全局搜替换路径,一不小心就把 HTML 改坏了。
|
||||||
|
|
||||||
|
正确做法只有一句话:新图用同名覆盖旧图,HTML 一个字不改。
|
||||||
|
|
||||||
|
## 为什么长成这样
|
||||||
|
|
||||||
|
聊完怎么用,聊聊它为什么是这个样子。
|
||||||
|
|
||||||
|
好看不是玄学,是一套可以拆解的决策。我做的事情,本质上是把杂志行业一百年沉淀下来的排版语言,搬到了 HTML 里。
|
||||||
|
|
||||||
|
### 字体的三级分工
|
||||||
|
|
||||||
|
|
||||||
|
|
||||||
|
- 衬线 → "观点"。大标题用衬线,读者一眼就觉得"这是一句该被重视的话"。
|
||||||
|
- 非衬线 → "信息"。正文密度高、阅读不累。
|
||||||
|
- 等宽 → "元数据"。页眉页脚的章节号、日期、页码,像杂志页脚,也像终端里的代码。
|
||||||
|
|
||||||
|
读者不用费劲想,眼睛自己就知道这句话是正文还是附注。
|
||||||
|
|
||||||
|
### 色彩的纪律
|
||||||
|
|
||||||
|
|
||||||
|
|
||||||
|
纸白、墨色,加一个重点色,就够了。
|
||||||
|
|
||||||
|
纯白刺眼、纯黑暴力,印刷行业从来不这么干,Kindle 也是。
|
||||||
|
|
||||||
|
Skill 的 5 套主题,底色没有一个是 #FFFFFF,字色没有一个是 #000000。
|
||||||
|
|
||||||
|
每套只暴露 6 个 CSS 变量,SKILL.md 里写明:不允许用户自定义 hex,只能五选一。
|
||||||
|
|
||||||
|
约束越严,风格越稳。 保护美学,比给用户自由更重要。
|
||||||
|
|
||||||
|
### 网格与节奏
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
7:5、6:6、8:4 几套固定网格保证单页秩序。
|
||||||
|
|
||||||
|
hero 页和 non-hero 页必须交替,保证整本的节奏。
|
||||||
|
|
||||||
|
一页密、一页疏,就是翻杂志时那种呼吸感。
|
||||||
|
|
||||||
|
Skill 里写了条硬规则:连续三页以上相同主题会被判为 P0 错误。
|
||||||
|
|
||||||
|
没有节奏的 PPT 就是一沓 slide 堆成的 PDF。
|
||||||
|
|
||||||
|
## 写在最后
|
||||||
|
|
||||||
|
上面这些规则,没有一条是我发明的。
|
||||||
|
|
||||||
|
我做了十年设计,UI、交互、AI 特效都干过,这些其实都是行业常识。
|
||||||
|
|
||||||
|
我只是把它们一条条写进了 SKILL.md 和 checklist.md,让 AI 能替我逐条执行而已。
|
||||||
|
|
||||||
|
换句话说,这个 Skill 就是我这十年审美的一个压缩包。
|
||||||
|
|
||||||
|
以前做一份像样的 PPT,我得花两天手动调网格、选字号、抠色值。
|
||||||
|
|
||||||
|
现在把素材丢给 AI,它按照这些规则直接拼出来,我只需要检查一下。
|
||||||
|
|
||||||
|
也正因为这样,我才敢把它开源。
|
||||||
|
|
||||||
|
规则本来就不是我的独家,《Monocle》的设计师比我早用了几十年,我只是把它 copy 到了 2026 年的 HTML 里。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
Skill 已经放在 GitHub 上:github.com/op7418/guizang-ppt-skill
|
||||||
|
|
||||||
|
README 里有一段"给 AI 的安装 prompt",复制粘贴给你的 Claude Code或其他 AI Agent,它会自动完成安装。
|
||||||
|
|
||||||
|
装好之后对它说一句"帮我做一份杂志风 PPT"就会触发。
|
||||||
|
|
||||||
|
也可以在 Bloome 这个 Agent 里面用,目前是免费的:
|
||||||
|
|
||||||
|
https://bloome.im/agent/join/iKXCLtkD?ref=wNL9Ew2G
|
||||||
|
|
||||||
|
如果觉得内容对你有帮助的话,可以帮我点个赞,或者分享给你需要的朋友。
|
||||||
|
|
||||||
|
也可以在评论区分享一下你拿这个 Skill 做的 PPT。
|
||||||
@@ -0,0 +1,77 @@
|
|||||||
|
# 📊 文章摘要:开源一个 PPT Skill|压进了我 10 年的设计经验
|
||||||
|
|
||||||
|
> **原文**:[2026-08-20_开源一个_PPT_Skill_压进了我_10_年的设计经验](./2026-08-20_开源一个_PPT_Skill_压进了我_10_年的设计经验.md)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/GXjjlxpIJ604HVCCZJkUBA
|
||||||
|
> **来源**:微信公众平台
|
||||||
|
> **作者**:歸藏的 AI 工具箱
|
||||||
|
> **发布日期**:2026-08-20
|
||||||
|
> **摘要日期**:2026-08-20
|
||||||
|
> **价值评级**:⭐⭐ 中
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 核心命题
|
||||||
|
|
||||||
|
> **经验压缩包** — 把专家十年沉淀的设计规则逐条写进 SKILL.md 让 AI 逐条执行,Skill 的本质是专家经验的"压缩包",而非模板集合。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 文章概要
|
||||||
|
|
||||||
|
作者(十年经验的设计师)在一次私享会后应听众要求开源了 guizang-ppt-skill——一个生成"电子杂志 × 电子墨水"风格单文件 HTML 演示文稿的 Claude Skill,包含 10 种页面布局、5 套主题色预设与完整翻页交互。文章依次介绍 Skill 的形态、使用方式(6 问澄清流程、图片命名规则、同名覆盖换图)以及背后的设计决策依据(字体三级分工、色彩纪律、网格与节奏)。其真正价值不在 PPT 工具本身,而在示范了"专家经验 → 可执行规则 → AI 代劳"的 skill 构建方法论;局限是产品介绍性质偏重,关键主张(如拦截 80% 返工)无验证数据,且未讨论 Skill 的适用边界。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 关键要点
|
||||||
|
|
||||||
|
1. **副产品成主产品** — 私享会访谈的 PPT 反而成为被追问最多的产物,遂开源为 guizang-ppt-skill(github.com/op7418/guizang-ppt-skill)。 `[分类: 共识]`
|
||||||
|
2. **产物是单文件 HTML** — 10 种布局、5 套主题(各仅 6 个 CSS 变量取值)、完整翻页交互,双击浏览器即看,分发无字体与动画兼容问题。 `[分类: 共识]`
|
||||||
|
3. **6 问澄清流程把对齐前置** — Skill 触发后 Claude 主动追问受众/时长/素材/图片/主题/硬约束,先出大纲与节奏表对齐再写代码,作者称拦截了 80% 返工。 `[分类: 争议]`
|
||||||
|
4. **图片接口约定** — images/ 目录 + 页号补零英文语义命名(01-cover.jpg)、照片 JPG/截图 PNG、单张 ≥1600px;换图用同名覆盖、HTML 一字不改。 `[分类: 共识]`
|
||||||
|
5. **字体三级分工** — 衬线承载"观点"、非衬线承载"信息"、等宽承载"元数据",读者无需思考即可分辨句子层级。 `[分类: 共识]`
|
||||||
|
6. **色彩纪律:约束优于自由** — 5 套主题底色无 #FFFFFF、字色无 #000000;禁止用户自定义 hex 只能五选一,"约束越严,风格越稳"。 `[分类: 争议]`
|
||||||
|
7. **节奏硬规则** — hero 页与 non-hero 页必须交替,连续三页以上相同主题判为 P0 错误,"没有节奏的 PPT 就是一沓 slide 堆成的 PDF"。 `[分类: 共识]`
|
||||||
|
8. **Skill=十年审美的压缩包** — 规则没有一条是作者发明的,全是行业常识;作者做的是把《Monocle》等杂志百年排版语言写进 SKILL.md 与 checklist.md 让 AI 执行。 `[分类: 范式突破]`
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 批判性分析
|
||||||
|
|
||||||
|
### 假设前提
|
||||||
|
- 预设"杂志风"是普遍可接受的演示美学,未考虑政企汇报等偏好模板化/官方风格的场景。
|
||||||
|
- "拦截 80% 返工"基于作者一周的个人使用,样本为一人的主观感受。
|
||||||
|
- 隐含读者已有 Claude Code 或兼容 Agent 环境,非技术用户路径(Bloome)仅一句带过。
|
||||||
|
|
||||||
|
### 论据与逻辑
|
||||||
|
- 论证方式是"展示+归因":先展示效果特征,再逐条解释设计依据,逻辑清晰但属于自我印证。
|
||||||
|
- 诚实度较高:明确承认规则全部来自行业常识而非原创,这反而增强了可信度。
|
||||||
|
- 设计原则(字体分工、色彩纪律、网格节奏)有印刷行业百年实践背书,论据来源可靠。
|
||||||
|
|
||||||
|
### 边界与局限
|
||||||
|
- 未讨论 Skill 的失败案例或生成质量的不稳定情形。
|
||||||
|
- 单文件 HTML 形态的固有局限(打印导出、企业模板合规、离线字体体积)未提及。
|
||||||
|
- "不允许自定义 hex"是强约束设计,对有品牌色需求的用户反而增加了门槛,作者未讨论该权衡的适用范围。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 可引用金句
|
||||||
|
|
||||||
|
> "换句话说,这个 Skill 就是我这十年审美的一个压缩包。"
|
||||||
|
|
||||||
|
> "好看不是玄学,是一套可以拆解的决策。"
|
||||||
|
|
||||||
|
> "约束越严,风格越稳。 保护美学,比给用户自由更重要。"
|
||||||
|
|
||||||
|
> "没有节奏的 PPT 就是一沓 slide 堆成的 PDF。"
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 总体评价
|
||||||
|
|
||||||
|
**亮点**:以真实开源作品示范了"专家经验规则化"的 skill 构建路径;设计决策逐条给出依据,可迁移性强;对自身非原创性的坦诚提升了说服力;6 问澄清与同名覆盖等细节可直接复用。
|
||||||
|
|
||||||
|
**不足**:无效果验证数据;对适用边界(企业合规、打印、品牌色)零讨论;产品宣传成分与 Bloome 推广链接稀释了方法论浓度。
|
||||||
|
|
||||||
|
**适用场景**:skill 设计方法论参考(如何把领域专家经验转写为可执行规则);快速生成高质感 HTML 演示文稿;本院 skill 评测与澄清流程设计的对照样本。
|
||||||
|
|
||||||
|
**关联建议**:与《企业内Agent工具落地实践》中 skill 三层渐进加载、评测分层互证——本文是"个人经验型 skill"的实例,该文提供企业级治理框架;其"P0 错误硬规则"做法可借鉴到本院 skill 的 checklist 机制;可与本院 arno-gen-pptx(PptxGenJS 路线)对比两种 PPT 生成技术路线的取舍。
|
||||||
@@ -0,0 +1,388 @@
|
|||||||
|
# 我复刻了 Claude 刚发布的生成式 UI 交互!
|
||||||
|
|
||||||
|
> **来源**:微信公众平台(歸藏的 AI 工具箱)
|
||||||
|
> **作者**:歸藏的 AI 工具箱
|
||||||
|
> **发布日期**:2026-08-20(原文未标注明确日期,按下载日占位)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/3IQIs6zP5jfdTwmT5LUJ6g
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
|
||||||
|
|
||||||
|
前天 Anthropic 在 Claude 里面上线了基于生成式 UI 的新交互。
|
||||||
|
|
||||||
|
可以帮你在聊天信息流里面用地吗可视化的方式介绍一些概念和信息,远比原来的纯文本要好理解。
|
||||||
|
|
||||||
|
|
||||||
|
|
||||||
|
我之前就一直在看类似的方案,刚好 Claude 发了,我就感觉我也得加紧做了。
|
||||||
|
|
||||||
|
同时刚好也可以逆向参考一下他的方案。
|
||||||
|
|
||||||
|
疯狂 PUA 了两天 Codex 和 Claude 还真让我搞出来了!
|
||||||
|
|
||||||
|
|
||||||
|
|
||||||
|
这个功能能让 AI 直接在聊天里画交互式图表,流式输出,边生成边渲染。
|
||||||
|
|
||||||
|
以前让 AI 写网页,得等整个页面代码全部生成完才能渲染,等半天。
|
||||||
|
|
||||||
|
现在不一样了。
|
||||||
|
|
||||||
|
你能看着图表一笔一笔在画布上画出来,SVG 节点一个接一个冒出来。
|
||||||
|
|
||||||
|
生成过程本身就很震撼,而且生成完直接就能交互。
|
||||||
|
|
||||||
|
直接在我的 Agent 产品 Code Pilot 里面体验:https://github.com/op7418/CodePilot
|
||||||
|
|
||||||
|
这篇内容我就会介绍一下它的用法,以及具体的实现过程和一些注意事项。
|
||||||
|
|
||||||
|
## 有哪些好玩的用法
|
||||||
|
|
||||||
|
数据分析:数字终于能看懂了
|
||||||
|
|
||||||
|
比如让它画一个"美国和伊朗冲突每天成本估算"的图表。
|
||||||
|
|
||||||
|
以前 AI 给你一大段文字,数字关系根本看不清。
|
||||||
|
|
||||||
|
现在直接出图表,每部分金额多少一目了然,文字和图表混在一起输出,该解释的解释,该画的画。
|
||||||
|
|
||||||
|
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
小工具:写个可交互的计算器啥的
|
||||||
|
|
||||||
|
让它做一个复利计算器。
|
||||||
|
|
||||||
|
拖滑块改初始金额、改投资年限,下面的图表和数字实时变化。
|
||||||
|
|
||||||
|
这不是静态图片,是真的能交互的小工具。
|
||||||
|
|
||||||
|
贷款计算、单位换算这类东西都能做。
|
||||||
|
|
||||||
|
|
||||||
|
|
||||||
|
架构图:程序员最爱
|
||||||
|
|
||||||
|
你可以让他帮你画某个项目的架构,或者某一个实现方案的可视化。
|
||||||
|
|
||||||
|
比如这里我让它画 API 到 JWT 身份验证的完整流程。
|
||||||
|
|
||||||
|
特性对比、流程图、层级结构全是图形化的,比看文字描述理解架构快太多了。
|
||||||
|
|
||||||
|
|
||||||
|
|
||||||
|
分析线上数据
|
||||||
|
|
||||||
|
还有个玩法直接丢一个 GitHub 仓库链接给它,它自己抓数据然后可视化分析。
|
||||||
|
|
||||||
|
比如这里我就把我自己的项目地址 Codepilot 发给他让他分析。
|
||||||
|
|
||||||
|
星数、fork 数、技术栈、架构设计、核心模块,全部画成图表。
|
||||||
|
|
||||||
|
一眼就能看清楚项目全貌,比读一大段文字强多了。
|
||||||
|
|
||||||
|
|
||||||
|
|
||||||
|
可以进行交互和深度解释
|
||||||
|
|
||||||
|
这个最强的是他跟模型结合的相当紧密,不是一顿输出就完事了。
|
||||||
|
|
||||||
|
你可以跟他生成的示意图进行交互,让他进行更详细的解释。
|
||||||
|
|
||||||
|
比如这里我让他解释季风和洋流的关系。
|
||||||
|
|
||||||
|
|
||||||
|
|
||||||
|
如果我们想更详细的了解就可以点击那个洋流机制的按钮。
|
||||||
|
|
||||||
|
就会自动向当前的模型发送指令,继续帮你生成洋流机制的示意图。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
当然我们可以进行更加复杂的交互,比如常见的物理数学公式的可视化。
|
||||||
|
|
||||||
|
这种对于学生来说非常好用,每个参数都可以通过滑块和输入控制,动画立刻会发生变化。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
国产模型支持
|
||||||
|
|
||||||
|
Codepilot 实现之后不只是 Claude 能用。
|
||||||
|
|
||||||
|
Kimi K2.5、Minimax M2.5、Anthropic 原生模型都跑得起来。
|
||||||
|
|
||||||
|
K2.5 画的图形我觉得甚至比 Sonnet 4.6 还好看,架构分析也很详细。
|
||||||
|
|
||||||
|
如果用这个功能我推荐首选 K2.5 试试。
|
||||||
|
|
||||||
|
好,到这里,模型的玩法基本上展示完了。
|
||||||
|
|
||||||
|
如果你不关心是如何实现的,可以直接去装个 Codepilot,愉快地玩耍了。
|
||||||
|
|
||||||
|
## 如何实现的
|
||||||
|
|
||||||
|
|
||||||
|
|
||||||
|
### Claude 怎么做的
|
||||||
|
|
||||||
|
Claude.ai 官方用的是 tool_use 机制。
|
||||||
|
|
||||||
|
模型调用一个专用 tool 输出结构化的 widget 内容,
|
||||||
|
|
||||||
|
前端解析 tool 调用的 input 参数来渲染。
|
||||||
|
|
||||||
|
这个方案在 Claude.ai 自己的架构下没问题。
|
||||||
|
|
||||||
|
但搬到 CodePilot 就不行了,原因有三个:
|
||||||
|
|
||||||
|
第一,SDK 限制。
|
||||||
|
CodePilot 用 Claude Agent SDK 的 preset: 'claude_code' 模式,
|
||||||
|
没法注册自定义 tool。
|
||||||
|
SDK 暴露的是 text delta 流,tool 层面扩展不了。
|
||||||
|
|
||||||
|
第二,流式体验。
|
||||||
|
tool_use 的结果要等 input_json_delta 拼完才能渲染,
|
||||||
|
不支持 HTML 增量渲染。
|
||||||
|
代码围栏方式下,HTML 随文本流式到达,边生成边预览。
|
||||||
|
|
||||||
|
第三,渲染隔离。
|
||||||
|
|
||||||
|
Claude.ai 用 Shadow DOM 做隔离。
|
||||||
|
|
||||||
|
我们选了 sandbox iframe。
|
||||||
|
|
||||||
|
iframe 隔离更彻底——完全独立的 JS 执行环境,
|
||||||
|
|
||||||
|
CSP 精确控制资源加载,
|
||||||
|
|
||||||
|
不存在样式泄漏和脚本逃逸。
|
||||||
|
|
||||||
|
### 我们怎么做的
|
||||||
|
|
||||||
|
触发:代码围栏
|
||||||
|
|
||||||
|
模型输出一段特殊的 Markdown 代码围栏来触发渲染:
|
||||||
|
|
||||||
|
```
|
||||||
|
show-widget
|
||||||
|
{"title":"training_flow","widget_code":"<svg width=\"100%\" viewBox=\"0\" 0\" 680\" 400\">..."}
|
||||||
|
```
|
||||||
|
|
||||||
|
这个格式复用了 CodePilot 已有的代码围栏模式
|
||||||
|
(image-gen-request、batch-plan 等),
|
||||||
|
前端 parser 链天然支持。
|
||||||
|
|
||||||
|
|
||||||
|
|
||||||
|
渲染:sandbox iframe
|
||||||
|
|
||||||
|
每个 widget 渲染在一个 sandbox="allow-scripts" 的 iframe 里。
|
||||||
|
iframe 的 srcdoc 是一个精心构建的 receiver 页面。
|
||||||
|
CSP 策略只放行 4 个 CDN 域名的外部脚本,
|
||||||
|
connect-src 'none' 禁止所有网络请求。
|
||||||
|
|
||||||
|
通过 postMessage 接收内容更新。
|
||||||
|
流式预览阶段发 widget:update,不执行脚本。
|
||||||
|
最终渲染发 widget:finalize,执行脚本。
|
||||||
|
|
||||||
|
ResizeObserver 监听内容高度变化,
|
||||||
|
通过 postMessage 报告给父页面。
|
||||||
|
|
||||||
|
所有 `<a>` 点击被拦截,
|
||||||
|
转发给父页面在新窗口打开。
|
||||||
|
|
||||||
|
主题同步靠监听父页面的 class 变化,
|
||||||
|
实时切换深色/浅色模式。
|
||||||
|
|
||||||
|
|
||||||
|
|
||||||
|
CSS 变量桥接
|
||||||
|
|
||||||
|
这是让 widget 跟应用视觉融合的关键。
|
||||||
|
|
||||||
|
CodePilot 用 OKLCH 色彩空间的 CSS 变量。
|
||||||
|
Anthropic 的 widget 设计指南用 --color-background-primary 这类标准变量名。
|
||||||
|
|
||||||
|
桥接层在 iframe 初始化时,
|
||||||
|
把 CodePilot 的变量值注入 iframe 的 :root。
|
||||||
|
模型按指南写的 CSS 就能直接用当前主题的颜色。
|
||||||
|
|
||||||
|
深色模式切换时,
|
||||||
|
父页面检测到 class 变化,
|
||||||
|
重新算变量值推给 iframe。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
流式渲染
|
||||||
|
|
||||||
|
这是整个实现里最复杂的部分。
|
||||||
|
|
||||||
|
模型逐 token 生成。
|
||||||
|
任意时刻收到的 widget 代码都可能是不完整的 JSON、
|
||||||
|
不完整的 HTML、不完整的 `<script>` 标签。
|
||||||
|
|
||||||
|
处理流程是这样的:
|
||||||
|
|
||||||
|
正则匹配 ```show-widget,
|
||||||
|
区分"未闭合"和"已闭合"状态。
|
||||||
|
|
||||||
|
手动定位 "widget_code":" 后面的内容,
|
||||||
|
逐字符反转义。
|
||||||
|
不能用 JSON.parse,因为 JSON 还没写完。
|
||||||
|
|
||||||
|
检测到未闭合的 `<script>` 标签时,
|
||||||
|
在 `<script` 之前截断,
|
||||||
|
避免 JavaScript 代码显示成可见文本。
|
||||||
|
|
||||||
|
120ms debounce 防止 iframe 更新太频繁。
|
||||||
|
|
||||||
|
流式内容剥离所有脚本和事件处理器,
|
||||||
|
预览阶段不需要交互。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
### 体验打磨:那些不该被注意到的细节
|
||||||
|
|
||||||
|
其实从代码或者是实现方案来看并不复杂,复杂的是体验的打磨。
|
||||||
|
|
||||||
|
这里边有太多可以影响体验的地方,需要让用户注意不到那些细节和生成的过程。
|
||||||
|
|
||||||
|
这就需要在每个阶段去用不同的方式处理:
|
||||||
|
|
||||||
|
1. 1.那些看起来不像流式的细节
|
||||||
|
2. 2.不该出现的内容
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
文字消失
|
||||||
|
|
||||||
|
模型先输出一段介绍文字("我来为你可视化解释..."),
|
||||||
|
然后开始输出 widget 围栏。
|
||||||
|
围栏一出现,前面的文字突然没了,
|
||||||
|
等 widget 渲染完才回来。
|
||||||
|
|
||||||
|
原因是 parseAllShowWidgets() 对纯文本返回空数组。
|
||||||
|
围栏刚出现但还没闭合时,
|
||||||
|
围栏前的文字被传进这个函数,结果被丢了。
|
||||||
|
|
||||||
|
修复:检测到围栏前的文本不含已完成的 widget 围栏时,
|
||||||
|
直接渲染为 `<MessageResponse>`,绕过解析函数。
|
||||||
|
|
||||||
|
高度跳变
|
||||||
|
|
||||||
|
widget 渲染完的瞬间,整个聊天区域抖一下。
|
||||||
|
|
||||||
|
iframe 初始高度 0px。
|
||||||
|
内容第一次报告实际高度时可能是 400px+,
|
||||||
|
CSS transition 让这个变化在 300ms 内完成,
|
||||||
|
就成了明显的动画跳变。
|
||||||
|
|
||||||
|
修复:首次高度报告时临时禁用 CSS transition,
|
||||||
|
让高度瞬间到位。
|
||||||
|
后续高度微调才用平滑过渡。
|
||||||
|
|
||||||
|
Finalize 闪烁
|
||||||
|
|
||||||
|
widget 从流式预览切到最终渲染时,内容闪一下。
|
||||||
|
|
||||||
|
receiver iframe 在 finalize 时执行 root.innerHTML = html 整体替换 DOM。
|
||||||
|
即使新旧内容完全一样(纯 SVG widget),
|
||||||
|
浏览器也会触发一帧重绘。
|
||||||
|
|
||||||
|
修复:finalize 时先把新 HTML 解析到临时容器,
|
||||||
|
分离出 script 元素。
|
||||||
|
比较去掉 script 后的 visual HTML 跟当前 DOM——
|
||||||
|
一样就跳过 innerHTML 替换,直接追加 script 执行。
|
||||||
|
纯 SVG widget 实现了零重绘 finalize。
|
||||||
|
|
||||||
|
滚动回跳
|
||||||
|
|
||||||
|
聊天正在自动滚到底部,
|
||||||
|
突然跳回几百像素前的位置,再跳回来。
|
||||||
|
|
||||||
|
streaming 结束时,
|
||||||
|
StreamingMessage 组件卸载,MessageItem 组件挂载。
|
||||||
|
这是两个完全不同的 React 组件,
|
||||||
|
内部的 WidgetRenderer 被销毁再重建。
|
||||||
|
新实例的 iframe 高度从 0 开始,
|
||||||
|
内容区高度骤降,
|
||||||
|
use-stick-to-bottom 检测到高度变化就触发了滚动调整。
|
||||||
|
|
||||||
|
修复:模块级高度缓存。
|
||||||
|
每当 widget 报告高度时,
|
||||||
|
以 widgetCode 前 200 字符为 key 写入缓存。
|
||||||
|
新的 WidgetRenderer 实例在 useState 初始化时从缓存读高度,
|
||||||
|
iframe 以正确高度开始渲染,
|
||||||
|
不存在 0→实际的过渡。
|
||||||
|
|
||||||
|
Script 代码泄露
|
||||||
|
|
||||||
|
带 Chart.js 的 widget 加载时,
|
||||||
|
底部显示一大段 JavaScript 代码。
|
||||||
|
|
||||||
|
模型输出的 `<script>` 标签在流式传输中逐字符到达。
|
||||||
|
`<script>` 开标签到了但 `</script>` 还没到时,
|
||||||
|
sanitizeForStreaming 剥离了开标签,
|
||||||
|
但标签内的 JavaScript 代码变成了裸文本节点,
|
||||||
|
被浏览器渲染成可见内容。
|
||||||
|
|
||||||
|
修复:在 StreamingMessage 的 partial code 提取后,
|
||||||
|
检测最后一个 `<script` 有没有匹配的 `</script>`。
|
||||||
|
没有就在 `<script` 位置截断。
|
||||||
|
widget 指南规定 script 放最后,截断不影响视觉内容。
|
||||||
|
截断期间展示 shimmer 遮罩,
|
||||||
|
状态栏显示"正在为可视化添加交互动画"。
|
||||||
|
|
||||||
|
iframe Ready 竞态
|
||||||
|
|
||||||
|
极少数情况下 widget 完全不渲染,停在 0px 高度。
|
||||||
|
|
||||||
|
WidgetRenderer 通过 useEffect 注册 message 事件监听。
|
||||||
|
但 iframe 的 receiver script 加载完就立刻发 widget:ready。
|
||||||
|
如果 iframe 加载速度快于 React effect 执行,
|
||||||
|
widget:ready 在监听器注册之前就发出去了,
|
||||||
|
iframeReady 永远不会变成 true。
|
||||||
|
|
||||||
|
修复:在 iframe 元素上加 onLoad 回调兜底。
|
||||||
|
onLoad 触发时 receiver script 必然已执行完,
|
||||||
|
是可靠的就绪信号。
|
||||||
|
|
||||||
|
React 组件树稳定性
|
||||||
|
|
||||||
|
widget 在围栏闭合瞬间闪一次。
|
||||||
|
|
||||||
|
两个问题叠在一起:
|
||||||
|
流式 partial widget 没有 React key,
|
||||||
|
闭合后获得 key="w-0",key 变了导致 remount。
|
||||||
|
shimmer overlay 用外包 `<div>` 实现,
|
||||||
|
改变了组件树结构,type 变了又导致 remount。
|
||||||
|
|
||||||
|
修复:给 partial widget 算稳定的 key
|
||||||
|
(w-N,N 是在最终 segments 数组中的预期位置),
|
||||||
|
跟闭合后的 key 一致。
|
||||||
|
shimmer overlay 移进 WidgetRenderer 内部,
|
||||||
|
通过 showOverlay prop 控制。
|
||||||
|
组件树始终是 `<WidgetRenderer key="w-N">`,不变。
|
||||||
|
|
||||||
|
## 写在最后
|
||||||
|
|
||||||
|
整个生成式 UI 系统,
|
||||||
|
难的不是"让一段 HTML 在 iframe 里跑起来"。那很简单。
|
||||||
|
|
||||||
|
真正的复杂度在于:
|
||||||
|
让这个 iframe 在流式传输、组件生命周期切换、主题变化这些状态转换中,
|
||||||
|
保持视觉上的稳定。
|
||||||
|
|
||||||
|
每一个"闪一下""跳一下""消失一下",
|
||||||
|
都要去理解 React 的 reconciliation、
|
||||||
|
浏览器的渲染管线、
|
||||||
|
postMessage 的时序。
|
||||||
|
|
||||||
|
最终效果是:
|
||||||
|
用户看到模型的回复里自然地穿插着图表和示意图。
|
||||||
|
|
||||||
|
就像它们本来就该在那里。
|
||||||
|
|
||||||
|
这是今天的内容。如果觉得对你有帮助的话,可以帮我点个赞,或者是发给有需要的朋友。
|
||||||
@@ -0,0 +1,74 @@
|
|||||||
|
# 📊 文章摘要:我复刻了 Claude 刚发布的生成式 UI 交互!
|
||||||
|
|
||||||
|
> **原文**:[2026-08-20_我复刻了_Claude_刚发布的生成式_UI_交互](./2026-08-20_我复刻了_Claude_刚发布的生成式_UI_交互.md)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/3IQIs6zP5jfdTwmT5LUJ6g
|
||||||
|
> **来源**:微信公众平台
|
||||||
|
> **作者**:歸藏的 AI 工具箱
|
||||||
|
> **发布日期**:2026-08-20
|
||||||
|
> **摘要日期**:2026-08-20
|
||||||
|
> **价值评级**:⭐⭐⭐ 高
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 核心命题
|
||||||
|
|
||||||
|
> **流式生成 UI** — 在聊天流内边生成边渲染可交互 widget,真正的工程难点不是"跑起来",而是状态转换中的视觉稳定
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 文章概要
|
||||||
|
|
||||||
|
Anthropic 在 Claude 上线生成式 UI 交互后,作者在两天内于自研 Agent 产品 CodePilot 中复刻了该能力:AI 直接在聊天里流式输出交互式图表(数据分析、可交互计算器、架构图、仓库分析、公式可视化),生成完即可交互,并支持 Kimi K2.5、Minimax M2.5 等非 Anthropic 模型。文章价值在于完整披露了实现方案——代码围栏触发 + sandbox iframe 渲染 + CSS 变量桥接 + 流式增量渲染,以及七个真实踩坑(文字消失、高度跳变、finalize 闪烁、滚动回跳、script 泄露、iframe 竞态、React remount)的成因与修复。局限是部分论断(如 K2.5 画图优于 Sonnet 4.6)为主观体验,未附基准数据。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 关键要点
|
||||||
|
|
||||||
|
1. **官方方案不可直接照搬** — Claude.ai 用 tool_use + Shadow DOM,但 Claude Agent SDK 的 claude_code preset 无法注册自定义 tool,且 tool_use 必须等 input_json_delta 拼完才能渲染,不支持增量 `[分类: 共识]`
|
||||||
|
2. **代码围栏触发渲染** — 模型输出 `show-widget` 特殊代码围栏而非 tool 调用,复用已有 parser 链,HTML 随文本流式到达、边生成边预览 `[分类: 争议]`
|
||||||
|
3. **sandbox iframe 隔离** — 相比 Shadow DOM,iframe 提供完全独立 JS 环境、CSP 精确控制(connect-src 'none')、无样式泄漏和脚本逃逸 `[分类: 共识]`
|
||||||
|
4. **两阶段渲染协议** — 流式预览发 widget:update(不执行脚本),最终渲染发 widget:finalize(执行脚本),预览阶段剥离所有脚本和事件处理器 `[分类: 共识]`
|
||||||
|
5. **CSS 变量桥接实现主题融合** — iframe 初始化时把宿主 OKLCH 色彩变量注入 :root,模型按标准变量名写 CSS 即自动适配深浅色主题 `[分类: 共识]`
|
||||||
|
6. **流式渲染需手写解析而非 JSON.parse** — 逐字符反转义未完成的 JSON,检测未闭合 `<script>` 标签提前截断防代码泄露,120ms debounce 控制 iframe 更新频率 `[分类: 共识]`
|
||||||
|
7. **真正的复杂度在体验打磨** — 七个"闪一下/跳一下/消失一下"问题分别源于 React reconciliation、浏览器渲染管线、postMessage 时序,需高度缓存、稳定 key、onLoad 兜底等手段逐一消解 `[分类: 范式突破]`
|
||||||
|
8. **国产模型可用** — Kimi K2.5、Minimax M2.5 均能驱动该功能,作者主观认为 K2.5 图形质量超过 Sonnet 4.6 `[分类: 未探索]`
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 批判性分析
|
||||||
|
|
||||||
|
### 假设前提
|
||||||
|
- 假定读者具备 React/iframe/CSP 前置知识,修复细节点到为止,未给完整代码
|
||||||
|
- 假定"边生成边渲染"是生成式 UI 的必要体验,未论证用户是否真的需要看到生成过程
|
||||||
|
- 假定模型能稳定输出符合规范的 show-widget 围栏格式,未讨论格式出错时的降级策略
|
||||||
|
|
||||||
|
### 论据与逻辑
|
||||||
|
- 论据以第一手实现经验为主,每个问题都给出"现象→根因→修复"闭环,可信度高
|
||||||
|
- 三个不采用官方方案的理由(SDK 限制、流式体验、渲染隔离)具体且可验证
|
||||||
|
- "K2.5 比 Sonnet 4.6 好看"属于个人观感,无对照样本;"疯狂 PUA 了两天"是营销话术而非工程描述
|
||||||
|
|
||||||
|
### 边界与局限
|
||||||
|
- 未涉及安全风险的深层讨论:模型生成的 HTML/JS 在 sandbox 内执行,CSP 白名单 4 个 CDN 域名,但供应链风险未评估
|
||||||
|
- widget 与模型的"深度交互"(如点击按钮继续生成)机制仅展示效果,未披露实现细节
|
||||||
|
- 未提供性能数据(流式渲染的 token 吞吐影响、iframe 数量上限)
|
||||||
|
- CodePilot 为作者自己的产品,文章兼具产品推广属性,评价立场需注意
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 可引用金句
|
||||||
|
|
||||||
|
> "真正的复杂度在于:让这个 iframe 在流式传输、组件生命周期切换、主题变化这些状态转换中,保持视觉上的稳定。"
|
||||||
|
|
||||||
|
> "每一个'闪一下''跳一下''消失一下',都要去理解 React 的 reconciliation、浏览器的渲染管线、postMessage 的时序。"
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 总体评价
|
||||||
|
|
||||||
|
**亮点**:罕见地把生成式 UI 的完整工程实现(含七个踩坑修复)公之于众;sandbox iframe + 代码围栏 + 流式两阶段渲染的方案可直接迁移到任何聊天式 AI 产品;对官方方案的逆向分析有理有据。
|
||||||
|
|
||||||
|
**不足**:模型能力对比为主观判断;安全与性能维度缺失;部分交互机制只展示未讲解;自带产品推广色彩。
|
||||||
|
|
||||||
|
**适用场景**:为聊天类 AI 产品添加生成式 UI / 可视化输出能力;设计流式渲染管线;排查 React 组件切换导致的视觉抖动类问题。
|
||||||
|
|
||||||
|
**关联建议**:与《从 OpenCode 升级到 V2,我们看到上下文工程与驾驭工程的三个趋势》互为参照——前者关注 Agent 输出端的渲染工程,后者关注 Agent 驾驭端的系统工程;sandbox iframe 隔离思路也可与 Agent 安全沙箱设计话题关联。
|
||||||
@@ -0,0 +1,210 @@
|
|||||||
|
# Storage Agent Family: Agent 时代,重构云存储的"人机交互"
|
||||||
|
|
||||||
|
> **来源**:微信公众平台(火山引擎存储)
|
||||||
|
> **作者**:火山引擎存储
|
||||||
|
> **发布日期**:2026-08-20(原文未标注明确日期,按下载日占位)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/tEDiv1KjsQvKO4Ffm41aOg
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
**系列定位:**本文是**《从 Data Lake 到 State Lake:面向 Agent 时代的存储基础设施重构》**的续篇。上一篇讲了 Agent 时代重新组织的三条存储主线:Sandbox Store、Artifact Store、Agent 观测 & 评测。这一篇聚焦最"面向用户"的一条支线——存储产品自身的 Agent 化,我们称之为 **Storage Agent Family**。
|
||||||
|
|
||||||
|
**从一个真实场景开始**
|
||||||
|
|
||||||
|
一位做 AI 数据运维的同学,一天要打开火山引擎控制台好几次。
|
||||||
|
|
||||||
|
建个训练数据桶要跳几个页面:建桶、配 KMS 加密、开版本控制、改 ACL、配访问日志,一步漏了,审计就找上门。
|
||||||
|
|
||||||
|
下午图片打不开,他打开对象存储控制台,权限、限流、CORS 配置挨个查,页面来回切。晚上老板追问上月账单涨 30% 的原因,他又得跑费用中心拉数据、自己算,再琢磨要不要把冷数据转归档。
|
||||||
|
|
||||||
|
功能都有,每一项能力在控制台里也都找得到,但"明明会用,就是费劲"的感觉始终挥之不去。
|
||||||
|
|
||||||
|
往大了说,今天用 TOS,明天查 TLS 的日志,后天团队上 vePFS 或 EFS。**每款存储都得重新学一遍怎么用:**菜单不同、概念不同,连"哪个操作要二次确认"的规则都不一样。
|
||||||
|
|
||||||
|
存储能力从来不是问题,真正的痛点是:用好存储,始终缺一个统一、懂人话的入口。
|
||||||
|
|
||||||
|
**Storage Agent Family 是什么**
|
||||||
|
|
||||||
|
Storage Agent Family 不是一个新产品,也不是一个"统一大 Agent ",而是**火山引擎存储线上 N 款存储产品各自的 Agent,共同遵守的一份约定**——TOS 有 TOS Agent,TLS 有 TLS Agent,后面还会有 vePFS、EFS、EBS、MQ 的 Agent。每款 Agent 都由对应的产品团队独立打造,但它们对外呈现的样子是"一家人"。
|
||||||
|
|
||||||
|
它想给客户解决的问题很简单:
|
||||||
|
|
||||||
|
**引入一个存储管理的专家伙伴,协助客户更高效地管理和使用存储产品。**建生产桶、批量改配置、排查访问异常、算账单、找素材、做创作、查日志、追延迟,过去要跨十几个页面,甚至写脚本才能完成的活儿,现在一句话说清楚意图,Agent 自主规划,逐步执行,每一步都可看、可停、可纠偏。
|
||||||
|
|
||||||
|
接下来,先看家族里已经上线的两位成员——TOS Agent 和 TLS Agent,分别代表家族里最典型的两种形态:一个偏运维向,一个偏分析向。
|
||||||
|
|
||||||
|
**TOS Agent:让日常运维"说人话"**
|
||||||
|
|
||||||
|
TOS Agent 是家族的第一个成员,不是控制台边上的一个问答框,而是客户在 TOS 上的**主工作入口**,把日常存储工作中的高频、繁琐、吃专业经验的活儿,交给一个能听懂意图、自主规划、随时可纠偏的工作台来做。
|
||||||
|
|
||||||
|
**四类场景:工作台在真实业务里做什么**
|
||||||
|
|
||||||
|
**日常运维:一句话,编排一整套操作**
|
||||||
|
|
||||||
|
过去建一个生产级桶要在多个 Tab 之间反复跳,批量改一批桶的配置只能逐个点或自己写脚本,现在把意图说清楚就行:
|
||||||
|
|
||||||
|
"帮我建一个用于 AI 训练数据的桶,开 KMS 加密、开版本控制、关闭 ACL 公共访问、接入访问日志。"
|
||||||
|
|
||||||
|
"给我账号下所有华东 1 区域、对象数大于 1000 的桶,统一开启访问日志。"
|
||||||
|
|
||||||
|
TOS Agent 把这类指令拆成一条有序执行链,逐步落地,过程透明。遇到批量变更或不可逆动作,它会先做一次影响预演(Dry-Run),清晰呈现波及范围,再等你确认——把"多步操作编排"从体力活变成一句话。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
**异常排查:从一条报错,追到根因和修复**
|
||||||
|
|
||||||
|
线上访问出问题,问题根因,可能是权限、签名、CORS、限流、慢请求等,排查过程需要很多专业经验。TOS Agent 会把这些细活接过来,如把一个打不开的图片链接甩给它,它自己解析 URL 和报错、拉访问日志和监控指标做聚合分析、对照错误码释义找根因,最后给一份"现象 → 根因 → 修复建议"的结论——从"告诉你为什么不行",到"帮你把问题解决"。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
**数据洞察:把账单、热点、冷热分层,一次问清**
|
||||||
|
|
||||||
|
TOS 计费项多,每个桶的费用和访问结构都不一样,"上个月账单为什么突然涨了 30%?" "哪些对象近 90 天没被访问,转归档能省多少?"这类问题以前要跨几个系统才能算清。
|
||||||
|
|
||||||
|
现在,TOS Agent 会自动拉账单和计量数据、识别异常波动并归因、分析访问热点和冷热分布,最后给你一份结构化的洞察报告和能落地的优化建议。生命周期策略、归档、加速器、QoS 都在里面—— "数据"从一个单纯被查询的对象,变成了一个能解释与建议的洞察对象。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
**多媒体创作:找素材、做创作、回存,一气呵成**
|
||||||
|
|
||||||
|
这是 TOS Agent 最具想象力的场景,它联动内容感知和处理能力,让你在一个对话里跑完"找素材 → 做创作 → 存产物"的完整闭环。基于多模态语义,从海量素材中直接召回符合描述的图片或视频片段;调用生成能力,完成改图、加水印;产物再自动回存到指定桶,天然沿用你的权限和治理策略,后续业务流转也直接用——对媒资、电商、营销团队来说,素材生产链路从"多个工具来回倒腾文件",简化成"在一个对话中说清楚需求"。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
**四项关键机制:让"对话式工作台"真正可用**
|
||||||
|
|
||||||
|
能编排的 Agent 有很多,但让客户敢把线上生产活儿交出去,靠的不是"模型有多聪明",而是长时协作、记忆连续、权限边界、动作安全这四项能力全部可靠。TOS Agent 在这四项能力上均做了针对性设计,这也是 Storage Agent Family 中所有成员必须恪守的底线。
|
||||||
|
|
||||||
|
**活跃会话数量无上限**
|
||||||
|
|
||||||
|
传统智能助手常受限于固定的会话资源,开多了就排队,被回收。TOS Agent 依托 TOS 原生分布式架构承载会话,不对活跃会话数量设上限,你可以为"排查异常""月度成本盘点""整理素材"分别开一条独立会话,并行跑互不干扰,跑到一半关掉,下次打开还能继续。
|
||||||
|
|
||||||
|
这一点对大规模创作团队尤其关键,成百上千名创作者同一时刻打开工作台,每个人都有一条独立、不掉线的会话,不会因为"别人在用"而被降级或被踢下线。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
**User 级长期记忆**
|
||||||
|
|
||||||
|
工作台会为每一个 User 维护独立的长期记忆空间,把跨会话的偏好和上下文沉淀下来:常用地域、命名规范、加密和权限基线、关注的成本口径……这些都会被记住,并在后续任务里自动复用。记忆的写入、召回、归档由服务端统一治理,用自然语言就能管理,你不用关心底层实现。
|
||||||
|
|
||||||
|
你不用每次从头交代背景,它越用越懂你。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
**User 凭证贯穿全部动作执行**
|
||||||
|
|
||||||
|
这是工作台安全模型的核心,**发起任务的 User 凭证,会贯穿此次任务里 Agent 触发的每一个动作。**不管是查询、配置变更,还是数据读写,Agent 调用的每一个工具都携带你的凭证,在你的权限边界内执行。它能做的,永远是"你本来就能做的事"的子集,不会因为"交给了 Agent "就越权碰到你无权访问的资源。
|
||||||
|
|
||||||
|
能力被放大,权限边界却分毫不变。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
**动作安全护栏:Commit + Dry-Run + 分级管控**
|
||||||
|
|
||||||
|
**写操作,先 Commit,再执行。**当模型识别到此次发起的是一个写请求(创建、变更、删除、覆盖、批量),它不会"想到就做",而是主动把动作弹到前台,清楚地告诉你"我准备做什么、影响哪些资源、可能产生什么后果",等你确认之后才真正落地。
|
||||||
|
|
||||||
|
Commit 之上,工作台还叠加几层护栏:删除这类不可逆动作触发前,主动提示影响范围并进行二次确认;写入优先用"不存在才写"语义避免误覆盖;配置变更、存储类型转换等动作先做预演(Dry-Run);不同 API 动作按读、写、删除分级管控,高危动作要更强的确认。
|
||||||
|
|
||||||
|
工作台拥有自动执行的能力,但把"按下确认键"的权力始终交还给你。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
再往上一层,当你要把这套工作台**打包转售给自己的众多终端客户**时,TOS Agent 借助 TOS 原生的让多租户隔离开箱即用,每个客户一个专属空间,工作空间、会话、记忆、配额彼此隔离,一套工作台就能服务成百上千家客户。
|
||||||
|
|
||||||
|
**TLS Agent:可观测分析专家**
|
||||||
|
|
||||||
|
TLS Agent 是家族的第二个成员,由日志服务团队独立研发,与 TOS Agent 为两条平行的研发线,但体验一致,是出自同一家族的产品。
|
||||||
|
|
||||||
|
日志服务是云上承接日志、Trace、指标和各类机器数据的接入入口和存储分析底座,能力完整。但业务问题的观测诊断分析,也还需专家经验的积累。新用户要先弄明白每类功能解决什么问题,从哪儿开始;老用户在复杂场景下,需编写好检索分析语句,查询经验文档,拆解问题分析的步骤。
|
||||||
|
|
||||||
|
TLS Agent 旨在降低使用门槛,并进一步把可观测信息转成可行动的洞察,让用户从"找到一条日志",走向"理解一个系统现象"。
|
||||||
|
|
||||||
|
当然仅靠 Text2SQL 是无法实现的,日志服务团队做的是让 Agent**进入日志服务的工作流。**
|
||||||
|
|
||||||
|
整体拆为三层能力:一个可探索的知识底座、一个可执行的工作环境、一套能把注意力拉回来的分析引导机制。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
**可探索的知识底座:LLMWiki**
|
||||||
|
|
||||||
|
日志分析既要懂产品知识,也要懂用户业务知识:服务拓扑、接口含义、错误码、告警规则、历史故障、团队 SOP,这些往往只存在于用户自有文档和经验中。
|
||||||
|
|
||||||
|
如果只是把所有文档切片做向量检索,召回容易变得不稳定:多了变噪声,少了漏关键。TLS Agent 用 **LLMWiki** 把知识库做成一个可探索的空间,不是一次性把片段塞进上下文,而是按任务阶段逐步探索,先限定知识空间和目录,再看文件名、标题和片段命中,最后只在确认有价值时才扩读原文。
|
||||||
|
|
||||||
|
图谱结构补充"相似搜索不一定命中"的部分,它告诉模型"这篇文档为什么可能相关,什么时候值得继续读"。RAG 从"搜到一段相似文本",升级为"找到一组更小、更准、可解释的分析上下文"。
|
||||||
|
|
||||||
|
长期记忆是闭环的一部分,单次分析完成后,经确认的业务背景、常见问题、资源偏好和排障路径会自动沉淀,下次遇到同类问题,Agent 可准确分析,无需从零理解。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
**可执行的工作环境:Sandbox**
|
||||||
|
|
||||||
|
可观测分析中,很多任务无法仅在模型上下文内完成,Agent 需要真实、稳定、可控的执行环境,支撑 Agent 运行查询、执行验证脚本、对结果程序化处理。
|
||||||
|
|
||||||
|
TLS Agent 以 **TLS CLI** 作为统一的能力入口:TLS API 覆盖的资源和动作多,若每个 API 都包装为模型可见的工具,会导致工具列表迅速膨胀;CLI 让 Agent 可像工程师一样,通过命令分组、子命令和 help 渐进式了解产品能力。
|
||||||
|
|
||||||
|
选了 CLI,就要有终端。**Sandbox**为 Agent 提供稳定的工作台:
|
||||||
|
|
||||||
|
沙箱支持运行命令、保存中间文件、读取输出,失败继续调整重试;每个 Skill 除提示词和工具调用外,自带验证脚本,可检查返回字段是否完整、时间范围是否正确、统计口径是否符合预期、查询结果是否足以支撑当前结论。Agent 不会生成"看似合理的答案",而是能在沙箱里做检查、发现问题、重试。
|
||||||
|
|
||||||
|
海量日志检索的过滤、聚合、TopN、趋势等重计算,**优先下推至 TLS 检索分析引擎**,Agent 不用拿模型去替代检索系统做大规模计算。若结果体量依然过大塞不进上下文,Agent 会在 Sandbox 内通过 rg、Python 完成筛选、统计、抽样、校验,再把更小、更关键的事实交给模型组织表达,**不把"样例观察"当成"总体结论"。**
|
||||||
|
|
||||||
|
**上下文引导:让注意力回到关键约束**
|
||||||
|
|
||||||
|
完整的日志分析需经历多轮交互:确认问题、理解资源、读取知识、生成查询、执行工具、修正路径。上下文越长,模型越容易被中间信息带偏,忘掉最初的分析目标、时间范围、过滤条件。
|
||||||
|
|
||||||
|
TLS Agent 设计了注意力引导模块,可以根据规则注入重要提示信息,不替代 Agent 做决策,只在关键节点把容易丢失的约束重新放回模型视野:
|
||||||
|
|
||||||
|
- 从"收集信息"进入"生成查询"时,把原始用户需求带回来,提醒 Agent 核对目标、时间范围和过滤条件;
|
||||||
|
- 执行较重的查询前,引导 Agent 先收敛范围,关注时间窗口、索引命中、返回行数和查询效率;
|
||||||
|
- 涉及趋势、聚合、异常判断时,提醒 Agent 把结论建立在检索分析能力之上,而不是几条样本上。
|
||||||
|
|
||||||
|
这类引导看起来很轻,但对长任务的稳定性很重要。
|
||||||
|
|
||||||
|
**内部实践:真实排障案例**
|
||||||
|
|
||||||
|
说了这么多机制,不如看两个例子。
|
||||||
|
|
||||||
|
"这个采集规则凌晨被改过,日志消失了,帮我确认是不是人为操作,具体原因是什么?"
|
||||||
|
|
||||||
|
"近 12 小时数据加工任务有入库延迟,帮我分析下延迟发生在哪个阶段。"
|
||||||
|
|
||||||
|
**案例一 | 操作溯源:**用户反馈某个采集规则在凌晨被改后日志消失,想确认是否人为操作及具体原因。
|
||||||
|
|
||||||
|
TLS Agent 结合用户提供的项目、Topic 和采集配置上下文,定位到对应的操作记录,输出修改时间、接口、操作者、来源和命中资源,排障过程从"猜是谁改了配置",转为"基于操作证据分析影响和解决方案"。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
**案例二 | 延迟归因:**用户反馈近 12 小时有入库延迟。
|
||||||
|
|
||||||
|
Agent 结合任务 ID、源 Topic 和时间范围检索内部日志,定位到延迟集中发生在源端消费恢复阶段:消费者心跳过期后触发 worker 批量重建,任务恢复后继续处理,未发现持续写入阻塞或执行错误。分析把"入库慢"拆解为可验证的阶段和证据,便于判断是短时抖动,还是要继续追链路瓶颈。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
每一次这样的分析,经确认的业务背景、常见问题、资源偏好和排障路径都会沉淀进长期记忆,下次遇到相似问题不必从零讲起,Agent 对同一团队、同一系统的理解会越来越稳定。
|
||||||
|
|
||||||
|
**Storage Agent Family 一致性**
|
||||||
|
|
||||||
|
看完两个成员,我们把 Storage Agent Family 对客户的价值收拢成三条,每一个加入家族的存储 Agent 都会遵守。
|
||||||
|
|
||||||
|
**一致的操作节奏,不用重新学。**不论是 TOS Agent 还是 TLS Agent,对话入口、数据范围选择、结果呈现、"先选范围、再对话、危险动作先确认"的节奏都完全一样。不用换一款产品重学一遍,这是"学会一个,用好每一款"最直接的兑现。
|
||||||
|
|
||||||
|
**一致的安全底线,可放心交付任务。**三级风险分级(只读直接执行 / 写入二次确认 / 破坏性拒绝自动执行)、User 凭证贯穿全部动作、写操作先 Commit 再执行、数据范围围栏、执行前权限校验——这些不是可选项,而是家族的常开底线。TOS Agent 有,TLS Agent 有,后面每一个成员也必须有。
|
||||||
|
|
||||||
|
**越用越懂你的系统。**每次任务中经用户确认的业务背景、排障路径、资源偏好,都会沉淀到该 User 的长期记忆中,下次任务自动召回。这对每款存储 Agent 都成立——用得越久,Agent 对你团队和系统的理解越准。
|
||||||
|
|
||||||
|
另外,家族对外统一接口,支持像装插件一样接入更多的存储 Agent;你在一个产品里问到另一个产品的问题,会主动引导你跳转,不断档。
|
||||||
|
|
||||||
|
**写在最后**
|
||||||
|
|
||||||
|
"用好存储"这件事,过去需要摸透控制台、用溜 SDK、背全最佳实践。
|
||||||
|
|
||||||
|
现在有一个听懂话的伙伴,能把多步操作自动编排、异常根因定位、成本与洞察一次问清、长任务与长记忆稳定运行,而且这套体验在每一款存储产品中都一致。
|
||||||
|
|
||||||
|
Storage Agent Family 已经上线 TOS Agent 和 TLS Agent,vePFS、EFS、EBS、MQ 的 Agent 已经在路上。它们从第一天就遵循同一份家族约定,未来会沿着两个方向走下去:一是让家族成员更多,覆盖场景更广;二是把 Agent 和工作区更深地打通,让人和 Agent 在同一个工作区里并肩工作,不必再在文档、控制台和聊天窗口之间来回切换。
|
||||||
|
|
||||||
|
**火山引擎 Storage Agent Family: 让每一款存储产品,都长出一个懂它、也懂你的专家。学会一个,用好每一款。**
|
||||||
@@ -0,0 +1,80 @@
|
|||||||
|
# 📊 文章摘要:Storage Agent Family: Agent 时代,重构云存储的"人机交互"
|
||||||
|
|
||||||
|
> **原文**:[2026-08-20_Storage_Agent_Family_Agent_时代_重构云存储的_人机交互](./2026-08-20_Storage_Agent_Family_Agent_时代_重构云存储的_人机交互.md)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/tEDiv1KjsQvKO4Ffm41aOg
|
||||||
|
> **来源**:微信公众平台
|
||||||
|
> **作者**:火山引擎存储
|
||||||
|
> **发布日期**:2026-08-20
|
||||||
|
> **摘要日期**:2026-08-20
|
||||||
|
> **价值评级**:⭐⭐⭐ 高
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 核心命题
|
||||||
|
|
||||||
|
> **存储Agent化** — 云存储的竞争焦点从"控制台功能完备"转向"给每款存储产品配一个懂产品、也懂用户的专家 Agent",并以家族约定(统一节奏、统一安全底线、统一记忆)保证"学会一个,用好每一款"。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 文章概要
|
||||||
|
|
||||||
|
本文是火山引擎存储团队的系列文章续篇,宣布其"Storage Agent Family"落地:不为全部存储产品建一个统一大 Agent,而是每款产品(TOS、TLS,后续 vePFS/EFS/EBS/MQ)由各自团队独立研发 Agent,共同遵守一份体验与安全约定。文章详述 TOS Agent(运维向:一句话编排建桶/批量配置、报错根因排查、账单与冷热分层洞察、多模态素材创作闭环)与 TLS Agent(分析向:LLMWiki 可探索知识底座、CLI+Sandbox 执行环境、注意力引导机制),并给出两项对 Agent 工程普遍适用资产:User 凭证贯穿全部动作的权限模型,以及 Commit + Dry-Run + 读写删除三级管控的动作安全护栏。局限在于这是厂商产品发布文,全部能力描述为自述,无第三方评测与量化效果数据。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 关键要点
|
||||||
|
|
||||||
|
1. **去中心化的产品 Agent 联邦** — 不做"统一大 Agent",而是 N 款产品各自的 Agent 共同遵守家族约定(统一接口、插件式接入、跨产品引导跳转),用组织约定而非单一大模型解决"每款存储重学一遍"问题。 `[分类: 争议]`(与行业"统一入口助手"主流路线相反的设计选择)
|
||||||
|
2. **四项可用性底线** — 长时协作(会话无上限)、记忆连续(User 级长期记忆)、权限边界(凭证贯穿)、动作安全(Commit+Dry-Run+分级管控),被定义为家族所有成员"必须恪守的底线"。 `[分类: 共识]`
|
||||||
|
3. **User 凭证贯穿全部动作** — Agent 触发的每个动作都携带发起任务的 User 凭证,在其权限边界内执行,"它能做的,永远是'你本来就能做的事'的子集"。这是 Agent 权限设计的高可迁移模式。 `[分类: 共识]`
|
||||||
|
4. **动作安全护栏三层结构** — 写操作先 Commit(弹前台确认影响面)再执行;不可逆动作二次确认+影响预演(Dry-Run);读写删除三级风险分级(只读直接执行/写入二次确认/破坏性拒绝自动执行)。 `[分类: 共识]`
|
||||||
|
5. **LLMWiki:从向量检索到可探索知识空间** — 拒绝"一次性把片段塞进上下文",按任务阶段逐步探索(限定知识空间→文件名/标题命中→确认有价值才扩读原文),图谱结构解释"为什么相关、何时值得读",将 RAG 升级为"更小、更准、可解释的分析上下文"。 `[分类: 范式突破]`
|
||||||
|
6. **CLI 优先于 API 工具化** — 不把每个 API 包装成模型可见工具(工具列表膨胀),而以 CLI 作为统一入口,让 Agent 像工程师一样通过命令分组、子命令和 help 渐进式了解产品能力。 `[分类: 范式突破]`
|
||||||
|
7. **计算下推 + Sandbox 校验** — 过滤/聚合/TopN 等重计算优先下推至检索分析引擎;结果过大时在 Sandbox 内用 rg、Python 筛选统计抽样,"不把'样例观察'当成'总体结论'";每个 Skill 自带验证脚本检查字段完整性、时间范围、统计口径。 `[分类: 共识]`
|
||||||
|
8. **注意力引导模块** — 长任务中在关键节点(收集信息→生成查询时带回原始需求、重查询前收敛范围、趋势判断时锚定检索引擎而非样本)把易丢约束重新放回模型视野,不替代 Agent 决策。 `[分类: 未探索]`(文中称"看起来很轻,但对长任务的稳定性很重要",未给出量化验证)
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 批判性分析
|
||||||
|
|
||||||
|
### 假设前提
|
||||||
|
- 预设"对话式工作台"优于控制台 GUI:对高频运维、跨页面编排场景成立,但对精细配置对比、审计留痕、大规模重复性自动化(IaC/Terraform 体系)未必更优,文章未讨论与既有基础设施即代码体系的关系。
|
||||||
|
- 预设用户敢于把生产环境操作交给 Agent——这正是文章用大量篇幅解释安全机制的原因,但信任建立过程本身未被论证。
|
||||||
|
- 预设大模型能稳定理解云存储领域的专业意图(计费口径、权限模型、错误码体系)。
|
||||||
|
|
||||||
|
### 论据与逻辑
|
||||||
|
- 全文为厂商自述的产品发布文,无任何量化效果数据(任务完成率、编排准确率、误操作率、根因定位准确率),无第三方评测。
|
||||||
|
- 两个 TLS 排障案例(采集规则操作溯源、入库延迟归因)是能力演示,非可复现的评测。
|
||||||
|
- 逻辑主线(痛点场景→产品定义→机制设计→案例)清晰自洽,但"痛点已解决"只有断言,无前后对比度量。
|
||||||
|
|
||||||
|
### 边界与局限
|
||||||
|
- 未讨论幻觉导致的错误配置如何兜底(Dry-Run 预演本身由模型生成,预演错了怎么办)。
|
||||||
|
- 未提 Agent 使用的成本、延迟与配额,"会话数量无上限"的资源代价不明。
|
||||||
|
- 家族一致性在成员增多(6+ 款产品)后的治理成本与体验漂移风险未展开。
|
||||||
|
- 多租户转售、多模态创作等场景仅一段带过,成熟度未知。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 可引用金句
|
||||||
|
|
||||||
|
> "发起任务的 User 凭证,会贯穿此次任务里 Agent 触发的每一个动作。"
|
||||||
|
|
||||||
|
> "工作台拥有自动执行的能力,但把'按下确认键'的权力始终交还给你。"
|
||||||
|
|
||||||
|
> "RAG 从'搜到一段相似文本',升级为'找到一组更小、更准、可解释的分析上下文'。"
|
||||||
|
|
||||||
|
> "Agent 不会生成'看似合理的答案',而是能在沙箱里做检查、发现问题、重试。"
|
||||||
|
|
||||||
|
> "让每一款存储产品,都长出一个懂它、也懂你的专家。学会一个,用好每一款。"
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 总体评价
|
||||||
|
|
||||||
|
**亮点**:把"Agent 时代云存储交互重构"讲成了可执行的产品工程而非概念——四项可用性底线、权限与动作安全模型、LLMWiki/CLI/Sandbox/注意力引导这组 Agent 工程组件,均可直接迁移到任意企业级 Agent 产品设计;"去中心化产品 Agent + 家族约定"的组织策略本身即是重要参考。
|
||||||
|
|
||||||
|
**不足**:零量化数据、零第三方验证,全部结论为厂商自述;对失败模式(预演错误、误确认、记忆污染)完全没有讨论。
|
||||||
|
|
||||||
|
**适用场景**:企业级 Agent 产品的安全与权限架构设计参考;RAG/工具调用/长任务稳定性的工程模式选型;云厂商产品 Agent 化竞品分析。
|
||||||
|
|
||||||
|
**关联建议**:与 Agent 工程类归档(工具调用、权限模型、长任务记忆)互链;后续可关注其宣称的 Dry-Run 影响预演与三级风险分级是否有公开 API/文档落地,以验证可迁移性。
|
||||||
@@ -0,0 +1,209 @@
|
|||||||
|
# 从 Data Lake 到 State Lake:面向 Agent 时代的存储基础设施重构
|
||||||
|
|
||||||
|
> **来源**:微信公众平台(火山引擎存储)
|
||||||
|
> **作者**:火山引擎存储
|
||||||
|
> **发布日期**:2026-08-20(原文未标注明确日期,按下载日占位)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/qakhw_mXrCO7Fcb3tikv4A
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
**核心观点:**Agent 正在把 AI 从"回答问题"推向"完成任务",存储也随之从"提供容量、承载文件"的资源层,升级为贯穿 Agent 运行、协作与持续优化的关键底座。火山引擎存储团队以 **Storage Agent Infra** 为载体,围绕 Sandbox Store、Artifact Store、Agent 观测 & 评测三大能力方向,重新组织存储能力,支撑 Agent 时代的真实业务。
|
||||||
|
|
||||||
|
过去几年,AI 应用的形态正在快速变化。从早期的模型调用,到对话式助手,再到具备工具调用、任务执行、环境交互和长期记忆能力的 Agent,AI 系统正在从"回答问题"走向"完成任务"。这种变化不仅改变了上层应用的交互方式,也对底层基础设施提出了新的要求。
|
||||||
|
|
||||||
|
结合 AI Agent 场景的快速成熟和发展,AI 驱动的数据 Workload 也在快速发生着演变。可划分为三个阶段:
|
||||||
|
|
||||||
|
- **Training(训练)阶段,数据 Workload 特点是海量、大规模、高吞吐**
|
||||||
|
- 海量 Dataset 数据集在对象存储中汇集,一个成熟模型在预训练阶段依赖的数据集规模可达到百 PiB~EiB 级别;Dataset 中的数据类型依据模型特点所决定,例如各类高精度生图生视频模型会更依赖高质量的多模态数据素材;
|
||||||
|
- 训练启动前会将 Dataset 从存储向上加载至 GPU,训练启动后会周期性高频产生 CKPT 写入至存储,加载和写入都会跨越到 TB/s 级别的带宽;存储需要保障上述过程的性能和时效,否则会导致训练 GPU 空转。
|
||||||
|
|
||||||
|
- **Inference(推理)阶段,数据 Workload 特点是低时延、高并发、KV 化、高吞吐**
|
||||||
|
- 推理服务面向用户实时交互,极致低时延是刚性指标,毫秒甚至微秒级的推理 IO 延迟都会直接影响端侧性能表现;
|
||||||
|
- KVCache 成为关键负载,每轮 token 的生成都会关联依赖 KVCache。KVCache 的命中率和时延会直接影响推理响应的 TTFT 和 TBT;围绕超大规模的推理服务,KVCache 的吞吐也会线性提升,重依赖 KVCache 在分布式扩展性、分层架构方面的落地能力。
|
||||||
|
|
||||||
|
- **Agent(智能体)阶段,数据 Workload 特点是场景多元化、批量高负载、可观测/自进化**
|
||||||
|
- 相较于训练、推理的标准化算力负载场景,Agent 应用阶段完全面向真实生产业务,场景碎片化、多元化特征突出,核心围绕智能体真实落地、业务闭环执行展开,所有负载能力均服务于 Agent 生产环境稳定运行与迭代进化;
|
||||||
|
- 具备高频动态的环境沙箱与工作区读写需求,需要频繁创建、切换、销毁独立沙箱工作环境,产生大量临时性、场景化的环境数据、任务缓存、操作快照数据,对存储的灵活隔离、快速启停、轻量化读写能力要求极高;
|
||||||
|
- 任务运行会持续生成文件、多模态 Output 数据,这类产物不再局限于单沙箱独立使用,存在极强的跨沙箱复用、共享、流转、公网访问需求,需要统一存储底座实现产物持久化留存;
|
||||||
|
- 依赖全链路 Trace 观测与日志存储,Agent 多轮对话、工具调用、逻辑决策、任务执行的全流程需要完整溯源记录,并支撑 Agent 的进化。
|
||||||
|
|
||||||
|
基于上述 AI Workload 的变化,也驱动了存储范式的演进:
|
||||||
|
|
||||||
|
- **Content Storage** 面向 Dataset、文档、图片、视频、日志等数据,核心命题是海量、持久化、冷归档与分发,目标是"把内容保存好",对应过去十年围绕对象存储、并行文件系统和冷热分层建立起来的成熟范式;
|
||||||
|
- **State Storage** 则面向 Checkpoint / Optimizer State、KVCache / Embedding、Environment / Memory / Trace 等执行状态,核心命题是短生命周期张量与上下文的高速流转、秒级恢复和低成本分叉,目标是"把系统状态维持住"。
|
||||||
|
|
||||||
|
上述两种范式的变化,并非简单的数据规模差异,而是在数据形态(文件 vs 数百 MB~数十 GB 的短生命周期状态块)、IO 模式(带宽敏感的顺序批扫 vs 延迟敏感的随机流转)、SLO 要求(秒级可用 vs 毫秒/微秒级不可失)与成本结构(可冷热分层 vs 无"冷"态可退)四个维度上的数据范式进化。
|
||||||
|
|
||||||
|
存储的角色因此**从"数据底座"升级为"状态底座"**,**从 Data Lake 走向 State Lake**。
|
||||||
|
|
||||||
|
火山存储围绕 AI Workload 的驱动变化,已布局了从 Training 到 Inference 到 Agent,从 Data Lake 走向 State Lake 完整的产品能力规划和落地。
|
||||||
|
|
||||||
|
本文重点围绕火山存储在 Agent 应用领域,从 Data Lake 走向 State Lake 的落地之路。
|
||||||
|
|
||||||
|
## 一、Agent 应用生态整体架构
|
||||||
|
|
||||||
|
从工程视角看,Agent 应用可以抽象为多个层次:底层是算力、控制面和环境接入面,中间是运行时引擎、工具路由、记忆管理和控制循环,上层则是具体的 Agent 应用、工作流和产品封装。
|
||||||
|
|
||||||
|
在这个体系中,存储能力贯穿多个关键环节。
|
||||||
|
|
||||||
|
围绕火山引擎客户各类 Agent 应用的运行特点,火山引擎存储团队将 Storage Agent Infra 的重点方向归纳为三类:
|
||||||
|
|
||||||
|
1. **Sandbox Store**:面向 Agent 沙箱运行环境,提供本地环境 rootfs 挂载、快照、启动恢复、状态保存等能力;
|
||||||
|
2. **Artifact Store**:面向 Agent 执行过程中的镜像、程序包、脚本、模型、输入输出文件和任务产物,提供持久化、共享、分发和访问能力;
|
||||||
|
3. **Agent 观测 & 评测**:面向 Agent 执行过程中的日志、Trace、Session、评测数据和实验结果,支撑观测、评测和持续优化闭环。
|
||||||
|
|
||||||
|
这三个方向分别对应 Agent 生命周期中的不同阶段。Sandbox Store 关注的是 Agent "在哪里运行"以及"如何快速、稳定地恢复运行环境";Artifact Store 关注的是 Agent "读写什么数据"以及"任务产物如何保存、共享和分发";Agent 观测 & 评测则关注 Agent "运行得怎么样"以及"如何基于数据持续改进"。它们共同构成了 Storage Agent Infra 的基本框架。
|
||||||
|
|
||||||
|
## 二、Storage Agent Infra 的三大能力方向和存储智能化
|
||||||
|
|
||||||
|
### 2.1 Sandbox Store:让 Agent 沙箱更快启动、更好恢复
|
||||||
|
|
||||||
|
Agent 的一个重要特点,是需要在受控环境中执行任务。在代码生成、数据处理、模型评估、多模态任务等场景中,Agent 往往需要一个相对完整的运行环境:它要能够安装依赖、执行脚本、读取输入、生成输出,并在必要时进行回滚、恢复或并行探索。这使得沙箱不只是一个"计算环境",其背后的状态保存、数据共享与会话通信,共同构成了 Agent Infra 中非常关键的一层。
|
||||||
|
|
||||||
|
同时沙箱在多种业务状态下的数据 Workload 变化,也推动 Sandbox Store 增加对各种 Data State 的支持,Sandbox Store 也逐步扮演为沙箱视角下的 State Lake。
|
||||||
|
|
||||||
|
在业务需求上,Sandbox Store 面临几类典型诉求:
|
||||||
|
|
||||||
|
- **启动要快**:沙箱启动时延通常需要控制在较低水平,以保证 Agent 交互和任务执行体验;
|
||||||
|
- **状态要能保存**:在 pause / resume、checkpoint、模型评估、任务重试等场景中,需要通过快照等机制保存沙箱状态;
|
||||||
|
- **容量要可控**:不同类型 Agent 对单沙箱容量的需求不同,但整体需要兼顾成本、密度和弹性;
|
||||||
|
- **隔离要清晰**:多租户场景下,需要在存储边界、权限、容量和性能上提供隔离能力;
|
||||||
|
- **恢复要灵活**:在跨机器、跨机房或批量调度场景中,恢复能力直接影响资源利用率和任务连续性;
|
||||||
|
- **通信中枢**:不同沙箱中的 Agent 协作、复杂任务长会话、高并发请求、海量租户隔离场景,通信机制更为关键。
|
||||||
|
|
||||||
|
围绕这些需求,Storage Agent Infra 在 Sandbox Store 方向上重点规划了基于 EBS、EFS 和 MQ 的能力组合。
|
||||||
|
|
||||||
|
**通用沙箱 rootfs 场景**
|
||||||
|
|
||||||
|
- 云盘 EBS 更适合作为基础方案,通过快照、延迟加载(Lazyload)、批量创盘和挂载优化等能力,支持沙箱快速启动、批量创建、pause / resume 以及数据保护;
|
||||||
|
- EBS 支持大规模高频快照、超长快照链、极速克隆,让 Agent 能随时存下当前状态、回退到任意一步。例如,在模型评估场景中,Agent 可以在每一步推理或实验后保存快照。如果某一步结果不理想,就可以基于前序快照重新拉起沙箱,调整模型参数或实验配置,从而支持更高效的并行探索和对比评估。
|
||||||
|
|
||||||
|
**多 Agent 并行实验、共享工作区和弹性容量等场景**
|
||||||
|
|
||||||
|
- EFS 可有效补齐 EBS 在共享与协同场景下的能力边界。 它提供高性能、弹性扩展的共享存储空间,具备完整 POSIX 语义,以及目录级访问隔离、目录级配额、目录级数据流动和共享挂载等能力,能够更好承载多沙箱、多 Agent 并行实验过程中对共享数据集、工作目录和中间结果的统一访问与管理需求。
|
||||||
|
|
||||||
|
**通信中枢需求**
|
||||||
|
|
||||||
|
- 会话级隔离与强顺序:**MQ LiteTopic** 为每一个 Agent 会话分配独立的消息主题,确保会话隔离,同时保持上下文严格顺序,为模型提供高质量交互源;
|
||||||
|
- 海量并发与高效调度:百万级 LiteTopic 动态创建与自动释放机制,支持海量会话并发的弹性;基于优先级消息,实现异步调度、支撑 Multi-Agent 协作、长会话任务的高效准确的调度。
|
||||||
|
|
||||||
|
这套组合的本质,不是选择某一种存储介质,而是按 Agent 沙箱的运行状态特征做分层协同:
|
||||||
|
|
||||||
|
- **EBS** 承载沙箱本地状态,聚焦快速启动、快照恢复与强隔离;
|
||||||
|
- **EFS** 补齐共享、弹性与 POSIX 文件能力,支撑多沙箱协作;
|
||||||
|
- **MQ LiteTopic**则打通会话通信,以会话级隔离和弹性调度支撑长会话、高并发的交互链路。
|
||||||
|
|
||||||
|
三者分别覆盖沙箱的"状态、共享、通信"三个面,共同构成 Sandbox Store 的数据底座。
|
||||||
|
|
||||||
|
### 2.2 Artifact Store:承载 Agent 的输入、输出与任务产物
|
||||||
|
|
||||||
|
如果说 Sandbox Store 解决的是 Agent 的运行环境问题,那么 Artifact Store 解决的就是 Agent 执行过程中的数据流转问题。
|
||||||
|
|
||||||
|
Agent 在执行任务时,会持续消费和生成各类文件。它可能读取用户上传的文档、图片和数据集,也可能生成代码包、报告、模型结果、多媒体文件或中间产物。这些内容既需要在 Agent 内部被访问,也需要在用户、团队和其他系统之间共享。
|
||||||
|
|
||||||
|
从业务需求看,Artifact Store 具有几个明显特点:
|
||||||
|
|
||||||
|
- 文件大小通常集中在 KB 到 MB 级,部分任务类场景会产生更大的文件;
|
||||||
|
- 吞吐需求整体不一定持续很高,但会出现任务型 burst;
|
||||||
|
- 多数场景不需要 pause / resume,但需要多租户挂载、公网上传和分发;
|
||||||
|
- 在 Coding、轻量数据库、小文件密集修改等场景中,会出现 POSIX 语义诉求;
|
||||||
|
- 产物需要支持用户访问、团队协作、智能检索和长期保存。
|
||||||
|
|
||||||
|
围绕这些特征,Storage Agent Infra 在 Artifact Store 方向上形成了两类路径:
|
||||||
|
|
||||||
|
**第一类,面向强 POSIX 语义和高性能读写诉求的场景:**
|
||||||
|
|
||||||
|
- **强文件语义**: EFS 天然适合承载对文件系统 POSIX 语义、并发访问性能和本地目录体验要求较高的 Agent 业务。存储在 EFS 中的文件可通过标准目录树统一管理,使用体验与本地文件系统保持一致;同时,EFS 提供接近完整的 POSIX 语义兼容能力,支持 rename、文件锁、软硬链接、Close-to-Open 一致性等关键语义,能够更好适配依赖标准文件系统能力的 Agent 工具链;
|
||||||
|
- **高性能**:EFS 能够应对 Agent 业务高并发、强波动的访问特征。针对性能下限保障,EFS 支持配置预置带宽,确保业务在关键阶段获得稳定的数据访问能力;针对突发性并发访问,EFS 面向 Agent 场景提供突发带宽能力,在千万级 Agent 并发访问时最高可获得 2TB/s 访问带宽。对于 git clone、tar 解压等典型小文件密集读写场景,EFS 可提供亚毫秒级时延和最高 3000 万 IOPS,帮助提升 Agent 启动、依赖拉取、任务执行和产物生成效率;
|
||||||
|
- **数据流动与降本**:在数据生命周期管理上,EFS 的数据流动能力可以同时满足 Agent 产物的降本与分发需求。Agent 产物在生成阶段和高频访问阶段需要高性能文件访问,但长期不访问后会带来不必要的存储成本。通过数据流动,冷数据可自动淘汰至 TOS,释放 EFS 存储成本,同时淘汰后的文件仍可通过 EFS 路径直接访问。对于需要立即通过 URL 访问的产物,也可以通过数据流动的沉降能力即时写入 TOS 后,通过 TOS API 完成分发和公网访问。
|
||||||
|
|
||||||
|
**第二类,面向无强 POSIX 需灵活的数据分发生态的场景:**
|
||||||
|
|
||||||
|
对象存储天然适合承载任务产物、模型文件、脚本包和多模态文件的存储、分发和公网访问。
|
||||||
|
|
||||||
|
火山引擎 TOS 面向 Agent 产物"数量爆发、形态多样、访问不均"的特征,提供海量、弹性、低成本的存储能力:
|
||||||
|
|
||||||
|
- **海量**:采用扁平的对象命名空间与近乎无上限的横向扩展架构,单桶即可承载从千万到亿级乃至更高规模的对象,轻松容纳 Agent 在长期运行中持续生成的多模态文件与中间产物,开发者无需为容量规划和分库分桶操心;
|
||||||
|
- **弹性**:存储容量与吞吐按实际用量自动伸缩,天然契合 Agent 产物生成"平时平稳、任务型突发(burst)"的访问特征。高峰时可弹性支撑大规模并发读写与分发,低谷时不产生额外资源占用,避免了为峰值预留容量带来的浪费;
|
||||||
|
- **低成本**:以按量付费和规模效应显著摊薄单位存储成本;配合多档存储类型(标准 / 低频 / 归档 / 冷归档),可将不同访问热度的产物匹配到相应价位的存储层,在保证可用性的同时把长期留存成本降到最低;
|
||||||
|
- **易运维**:TOS 在可运维性上,同样为海量产物的长期治理提供了完善能力。通过生命周期可按前缀、标签、创建时间等条件自动执行存储类型转换和删除,让冷、热产物在无人干预的情况下持续、自动地流转和清理;结合版本管理、事件通知、访问权限与审计等能力,Agent 产物的写入、访问与回收得以形成闭环治理。
|
||||||
|
|
||||||
|
**在上述两类场景基础上,另一个变化也在快速发生。**
|
||||||
|
|
||||||
|
Agent 时代,技术平权,开发方式在变化,借助大模型、Serverless 架构,可快速搭建 AI Agent。但从 demo 迈向"生产级应用",用户数演进到万级、百万级甚至亿级,存储管理复杂度指数级提升,多租隔离、权限、Quota 管理等变成难题。
|
||||||
|
|
||||||
|
火山存储 Artifact Store 整体会以 Agent Bucket 为统一基建,继而为亿级 Agent 用户时代的到来,做好充足的准备。
|
||||||
|
|
||||||
|
Agent Bucket 是火山引擎 TOS 推出的亿级 Agent 原生存储桶,也是火山引擎在国内存储领域又一引领业内趋势的前瞻性布局。
|
||||||
|
|
||||||
|
Agent Bucket 通过在传统 Bucket → Object 两层模型中引入 AI 原生资源层级 ObjectSet,让 Agent 时代的"开发者"无需自建复杂中间层,即可为亿级终端用户提供安全、隔离、Quota、管理的专属存储空间,助力 Agent 从"demo"走向"生产级应用"。
|
||||||
|
|
||||||
|
**进一步,TOS 针对多模态产物、Agent 上下文场景,我们推出了 SenseFlow、ContextBucket 功能。**
|
||||||
|
|
||||||
|
- **SenseFlow** **多模态理解与处理引擎**,让产物从"存下来",进一步走向"被理解"。数据不出桶,即可感知与处理:预置模板与算子编排,支持多模态处理、内容理解、智能检索与生成链路,并与 TOS 权限和事件通知天然打通。这使得任务产物不再只是静态文件,而是可感知、可检索、可加工、可消费的数据资产。
|
||||||
|
- **ContextBucket** 面向 Agent 的记忆与工作区诉求,把 Agent 的长期记忆与工作区收敛到同一个底座上,做到"记得住、找得到、带得走"。它让上下文与中间状态得以跨任务、跨会话持续沉淀,Agent 在长周期任务和多轮协作中可以随时回到既有记忆和工作区,而不必每次从零构建。
|
||||||
|
|
||||||
|
Agent 时代,数字世界交互方式也在被重构 —— 人与 Agent 之间的协作与共享,呼唤全新的基础设施。火山引擎推出 **ADrive — Agentic 智能网盘**,专为 Agent 与人协同而生。
|
||||||
|
|
||||||
|
ADrive 是为 Agent 平台提供**可挂载、可访问、可管理、可共享**的持久化存储层,解决四个核心问题:
|
||||||
|
|
||||||
|
- **Agent 产物持久化与共享**:代码、报告、图片、数据文件等 Agent 产出不再散落在临时工作目录中。ADrive 自动持久化每一份产物,让它们可追溯、可检索、可共享,构建持续积累的个人知识库。
|
||||||
|
- **Agent 存储管理与多租户隔离**:支持将 ADrive Space 映射 / 挂载为 Agent 工作目录或存储扩展,支撑海量租户(千万级至亿级)的隔离。每个 Agent 实例拥有独立的存储空间,安全可控。
|
||||||
|
- **Agent & 人无缝协同**:打通跨 Agent 产品挂载同一空间、本地盘符挂载同步、客户端与 CLI / Skill 多端访问。Agent 读取与生成,人查看、编辑、分享与审计 —— 统一的工作空间闭环,让人与 Agent 真正协作。
|
||||||
|
- **Agent 数据智能检索与再创作**:用户或 Agent 以自然语言检索文件,系统快速返回匹配结果与内容概览。AI 助手基于 Agent 产出文件进行摘要、改写与二次创作;基于知识库内容智能问答,答案精准溯源至原始文件。
|
||||||
|
|
||||||
|
**这意味着,Artifact Store 并不只是一个"文件存储服务",而是在 Agent 与人、Agent 与 Agent、Agent 与平台之间,提供统一的数据承载、理解与记忆入口——产物既存得下、又理解得了、还记得住。**
|
||||||
|
|
||||||
|
### 2.3 Agent 观测 & 评测:让 Agent 形成持续优化闭环
|
||||||
|
|
||||||
|
Agent 系统与传统应用的一个重要差异在于:它的运行结果并不总是可以通过固定规则判断。一次 Agent 任务是否完成得好,可能取决于中间推理路径、工具调用结果、上下文使用方式、模型输出质量以及最终用户反馈。要持续提升 Agent 的能力,就必须对执行过程进行记录、观测、分析和评测。因此,Storage Agent Infra 将观测到评测的闭环作为重要方向之一。
|
||||||
|
|
||||||
|
TLS AgentLoop 承担了 Agent 观测、数据飞轮平台能力,并打通评测进化。它可以围绕 Agent 执行过程,提供观测数据接入、 Trace 调用链 / Session分析 / 监控大盘等观测数据、数据处理与 Trace 回流,并与 Cozeloop 合作,打通评测集 / 评估器管理 / 评估实验。TLS AgentLoop,将 Agent 的运行过程,从"黑盒结果"转化为"可观测、可分析、可评测"的数据资产。
|
||||||
|
|
||||||
|
对于研发团队而言,这可以帮助判断不同版本 Agent 的效果变化;对于平台团队而言,这可以帮助发现系统瓶颈、工具调用异常和任务失败原因;对于业务团队而言,这可以帮助持续优化 Agent 的任务完成质量。
|
||||||
|
|
||||||
|
更进一步,围绕 Ops Agent 的规划也体现了类似思路:通过日志、指标和观测数据,支持异常巡检、智能分析、问题诊断、修复建议和 Runbook 联动,推动企业运维工作流向 Agent 化演进。
|
||||||
|
|
||||||
|
### 2.4 从存储系统到 Agentic Teammate
|
||||||
|
|
||||||
|
Storage Agent Infra 的另一个重要方向,是让存储团队自己也成为这套基础设施的使用者。
|
||||||
|
|
||||||
|
在规划中,火山引擎存储团队提出了 **Storage Agent Family** 的思路:围绕 TOS、EBS、TLS、EFS、MQ 等存储和中间件产品,逐步建设面向用户和工程师的智能助手能力。
|
||||||
|
|
||||||
|
这些 Agent 可以提供预置专家能力,例如存储运维、方案选型、洞察分析、知识库问答、日志与报表总结等;默认内置安全围栏,在高危操作中引入 Human in the loop 或直接拦截,保证 Agent 运行始终处于业务安全范围内;同时,还可以支持用户自定义技能和自定义知识库,适配不同产品与用户场景。
|
||||||
|
|
||||||
|
Storage Agent 还支持记忆进化能力,Agent 回复后用户确认对/错,可选择将其沉淀为记忆/知识方便后续自动复用。这代表了一个更长期的方向:存储系统不只是被 Agent 使用,也可以通过 Agent 化能力提升自身的可用性,让你的 Agent 越用越"聪明"。
|
||||||
|
|
||||||
|
换句话说,Storage Agent Infra 既是 Agent 应用的底层存储基础设施,也是存储产品走向智能化、助手化和协作化的重要支点。
|
||||||
|
|
||||||
|
## 三、三个真实场景:能力如何落地
|
||||||
|
|
||||||
|
Storage Agent Infra 的前三大能力方向落到业务一线,会变成更具体的工程问题:推理链路需要反复快照、Input / Output 需要资产化管理、人与 Agent 的协作空间需要产品化。下面通过三个典型场景,看这些能力如何组合起来支撑真实的 Agent 业务。
|
||||||
|
|
||||||
|
**场景一|研发测试类 Agent**
|
||||||
|
|
||||||
|
在单次开发调试链路中连续记录快照,支持基于任一历史状态回滚、切换分支/依赖并重跑。这依赖基于 EBS 高频快照所实现的版本回溯能力,以及沙箱的 pause / resume 机制作为底层支撑。
|
||||||
|
|
||||||
|
**场景二|多模态创作类 Agent**
|
||||||
|
|
||||||
|
Input 素材先预处理再入库,Output 素材生成后沉淀、回传,并支持公网访问,对应 **Agent Bucket on TOS**、Input / Output 资产库与分发能力。
|
||||||
|
|
||||||
|
**场景三| 智能办公类 Agent**
|
||||||
|
|
||||||
|
用户素材留在 User 空间,Agent 协作内容进入 Claw 空间,团队共享访问并用 AI Search 检索,背后依赖 ADrive 智能网盘的双空间、协作与检索能力。
|
||||||
|
|
||||||
|
三个场景把 Sandbox 对启动、快照、恢复的即时要求,与 Artifact 对多租、共享、分发、检索的持续要求同时压实。
|
||||||
|
|
||||||
|
## 四、面向 Agent 时代,重新理解存储基础设施
|
||||||
|
|
||||||
|
Agent 带来的真正变化,不只是新增一类负载,而是重塑存储的服务对象与价值边界。当 AI 从"回答问题"走向"完成任务",存储要承接的已不再是静止的文件,而是持续流动的任务、状态、上下文与产物。
|
||||||
|
|
||||||
|
存储的价值坐标,也因此从"提供了多少容量",转向"托住了多少状态、参与了多少闭环"——**它从被动的数据底座,成长为主动的状态底座。**
|
||||||
|
|
||||||
|
这也意味着,衡量一套存储基础设施是否面向 Agent,标准不再是单点的容量、带宽或时延,而是它能否在 Agent 的完整生命周期中始终在场:环境要能秒级拉起与恢复,产物要能被理解、被检索、被记忆,运行过程要能被观测、被评测、被反哺。
|
||||||
|
|
||||||
|
Storage Agent Infra 的意义正在于此,火山存储以 **Sandbox Store、Artifact Store、Agent 观测 & 评测**三条主线为骨架,把 EBS、EFS、TOS、ADrive、TLS、MQ 等能力按 Agent 的运行状态特征重新编排,让离散的存储介质凝聚为一个"理解任务、承接状态、参与闭环"的有机整体。
|
||||||
|
|
||||||
|
更进一步,当存储团队让自身也成为这套基础设施的使用者,存储便完成了一次角色跃迁:**从被 Agent 调用的资源,变为与人和 Agent 并肩协作的 Teammate**。存储不再只是任务链路末端的落点,而是能感知、会分析、可进化的一环,在使用中持续变得更聪明、更可靠。
|
||||||
|
|
||||||
|
这正是"从 Data Lake 走向 State Lake"的深层含义:存储的终局,不是更大的湖,而是更懂业务的底座。**面向 Agent 时代,火山引擎存储团队将沿着这一方向持续演进,让存储真正成为 Agent 运行、协作与自我进化中不可或缺、且越用越智能的基础设施。**
|
||||||
@@ -0,0 +1,79 @@
|
|||||||
|
# 📊 文章摘要:从 Data Lake 到 State Lake:面向 Agent 时代的存储基础设施重构
|
||||||
|
|
||||||
|
> **原文**:[2026-08-20_从_Data_Lake_到_State_Lake_面向_Agent_时代的存储基础设施重构](./2026-08-20_从_Data_Lake_到_State_Lake_面向_Agent_时代的存储基础设施重构.md)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/qakhw_mXrCO7Fcb3tikv4A
|
||||||
|
> **来源**:微信公众平台
|
||||||
|
> **作者**:火山引擎存储
|
||||||
|
> **发布日期**:2026-08-20
|
||||||
|
> **摘要日期**:2026-08-20
|
||||||
|
> **价值评级**:⭐⭐⭐ 高
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 核心命题
|
||||||
|
|
||||||
|
> **状态底座** — 存储正从承载静止内容的 Data Lake 升级为承接 Agent 运行状态(沙箱、产物、记忆、Trace)的 State Lake,价值标尺从"提供多少容量"变为"托住多少状态、参与多少闭环"。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 文章概要
|
||||||
|
|
||||||
|
火山引擎存储团队的体系性技术宣言:AI 应用的演进(Training→Inference→Agent)驱动数据负载范式变化,Content Storage(把内容保存好)与 State Storage(把系统状态维持住)在数据形态、IO 模式、SLO、成本结构四维上分野,存储角色从"数据底座"升级为"状态底座"。围绕 Storage Agent Infra 提出三大能力方向——Sandbox Store(EBS 状态 + EFS 共享 + MQ LiteTopic 通信的分层协同)、Artifact Store(EFS/TOS 双路径 + Agent Bucket 亿级原生存储 + SenseFlow/ContextBucket + ADrive 人机协同网盘)、Agent 观测评测(TLS AgentLoop 数据飞轮),并展望存储从被调用资源变为 Agentic Teammate。作为厂商一手架构文章,框架价值高,但本质是产品布局陈述,缺乏与业界方案的对比和公开性能数据。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 关键要点
|
||||||
|
|
||||||
|
1. **AI Workload 三阶段演进** — Training(海量高吞吐)、Inference(低时延高并发 KV 化)、Agent(场景多元、批量高负载、可观测/自进化),负载特征逐阶段分化 `[分类: 共识]`
|
||||||
|
2. **Content vs State 两种存储范式四维分野** — 数据形态(文件 vs 数百 MB~数十 GB 短生命周期状态块)、IO 模式(带宽敏感顺序批扫 vs 延迟敏感随机流转)、SLO(秒级可用 vs 毫秒/微秒级不可失)、成本结构(可冷热分层 vs 无"冷"态可退)`[分类: 范式突破]`
|
||||||
|
3. **Sandbox Store 三件套分层协同** — EBS 承载沙箱本地状态(高频快照、极速克隆、任意步回退),EFS 补齐 POSIX 共享与弹性容量,MQ LiteTopic 打通会话通信(百万级主题、会话隔离、强顺序)`[分类: 共识]`
|
||||||
|
4. **快照即 Agent 的"存档点"** — 模型评估场景中每步推理后存快照、结果不理想即回退重跑,把"游戏存档"机制引入 Agent 并行探索 `[分类: 范式突破]`
|
||||||
|
5. **Agent Bucket 引入 ObjectSet 层级** — 在 Bucket→Object 两层模型中增加 AI 原生资源层级,让开发者无需自建中间层即可为亿级终端用户提供隔离、Quota 管理的专属空间 `[分类: 未探索方向]`
|
||||||
|
6. **存储从"存下来"到"被理解"** — SenseFlow 让数据不出桶即可多模态处理与检索;ContextBucket 把 Agent 长期记忆与工作区收敛到同一底座(记得住、找得到、带得走)`[分类: 未探索方向]`
|
||||||
|
7. **ADrive 重构人机协作空间** — 产物持久化、多租隔离、人查看/编辑/审计与 Agent 读取/生成的统一工作空间闭环 `[分类: 未探索方向]`
|
||||||
|
8. **观测评测评闭环是 Agent 进化的前提** — TLS AgentLoop 把运行过程从"黑盒结果"转化为可观测、可分析、可评测的数据资产,与评测集管理打通 `[分类: 共识]`
|
||||||
|
9. **存储的终极角色:Agentic Teammate** — 从被 Agent 调用的资源,变为与人和 Agent 并肩协作、越用越聪明的一环 `[分类: 范式突破]`
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 批判性分析
|
||||||
|
|
||||||
|
### 假设前提
|
||||||
|
|
||||||
|
(1) Agent 负载将成为存储的主要增量场景——成立与否取决于 Agent 生产化落地速度;(2) 云厂商统一底座优于用户自组装开源组件——文章回避了自建路线(如自管 Redis/对象存储/文件系统组合)的成本对比;(3) "State Lake"是范式跃迁而非营销命名——四维分野论证有一定支撑,但 KV Cache 存储等早已有之,新意在于统一框架化。
|
||||||
|
|
||||||
|
### 论据与逻辑
|
||||||
|
|
||||||
|
作为架构文章,逻辑自洽:负载特征→范式分野→三大方向→场景落地,链条完整。但论据全部为产品能力陈述("2TB/s 突发带宽""3000 万 IOPS"均为厂商口径),无第三方评测、无真实客户数据、无失败案例。三个"真实场景"实为能力到场景的映射示例,非案例复盘。与业界(如 AWS/Azure 的 Agent 存储方案、Mooncake 类 KVCache 系统)无对比定位。
|
||||||
|
|
||||||
|
### 边界与局限
|
||||||
|
|
||||||
|
适用于理解 Agent 时代存储需求的结构性变化与云厂商布局方向;具体产品选型不可直接采信(需实测)。文章代表火山引擎单一视角,"引领业内趋势"等自我评价需过滤。Agent Bucket/SenseFlow/ContextBucket 等为规划或早期产品,成熟度未知。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 可引用金句
|
||||||
|
|
||||||
|
> "存储的价值坐标,也因此从'提供了多少容量',转向'托住了多少状态、参与了多少闭环'——它从被动的数据底座,成长为主动的状态底座。"
|
||||||
|
|
||||||
|
> "存储的终局,不是更大的湖,而是更懂业务的底座。"
|
||||||
|
|
||||||
|
> "它让上下文与中间状态得以跨任务、跨会话持续沉淀,Agent 在长周期任务和多轮协作中可以随时回到既有记忆和工作区,而不必每次从零构建。"
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 总体评价
|
||||||
|
|
||||||
|
**亮点**:
|
||||||
|
- "State Lake"四维分野框架清晰,是理解 Agent 存储需求的优秀心智模型
|
||||||
|
- Sandbox Store 的"状态/共享/通信"三面分解与快照-回退机制描述具体可感
|
||||||
|
- 把观测-评测-进化闭环纳入存储基础设施范畴,视角完整
|
||||||
|
|
||||||
|
**不足**:
|
||||||
|
- 厂商白皮书性质,全部性能数字无第三方验证
|
||||||
|
- 无与竞品/自建方案的对比,"引领趋势"式自我评价过多
|
||||||
|
- Agent Bucket 等关键新概念的技术细节(ObjectSet 如何实现隔离)语焉不详
|
||||||
|
|
||||||
|
**适用场景**:Agent 平台架构设计参考、云存储产品选型调研起点、AI Infra 趋势研究
|
||||||
|
|
||||||
|
**关联建议**:与 PD 分离/KV Cache 主题文章(2026-08-06 归档批次)对读,理解推理侧 KVCache 存储与 Agent 侧状态存储的谱系;跟踪 Agent Bucket、ContextBucket 的实际落地与定价
|
||||||
@@ -0,0 +1,88 @@
|
|||||||
|
# 火山引擎 RDS MySQL 向量索引:把高性能向量检索带到 MySQL 上
|
||||||
|
|
||||||
|
> **来源**:微信公众平台(火山引擎数据库)
|
||||||
|
> **作者**:火山引擎数据库
|
||||||
|
> **发布日期**:2026-08-20(原文未标注明确日期,按下载日占位)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/f5aEV7az3RYQeivyQUJsYQ
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 一、火山引擎 RDS MySQL 的高性能向量索引能力
|
||||||
|
|
||||||
|
随着近两年 AI 的快速发展,像 AI 模型、AI 助手等 AI 产品越来越多,这些 AI 产品几乎都用到了 RAG(检索增强生成)架构。向量数据库也逐渐重要,变成了业务不可缺少的数据库,但对于绝大多数的 MySQL 数据库用户来说,业务数据全部存储在 MySQL 中,如果需要向量检索就需要额外再部署一个向量数据库,不仅会导致数据查询链路变长,增加查询耗时,多部署一个数据库,数据同步的成本和对该数据库的运维成本也会增加。
|
||||||
|
|
||||||
|
为了解决 MySQL 用户的这个问题,火山引擎 RDS MySQL 正式推出了高性能向量索引,用户不用再单独部署向量数据库,可以让您在一张 MySQL 表里同时执行常规业务查询和向量检索,仅依赖 MySQL 数据库即可完整实现 RAG 业务能力。
|
||||||
|
|
||||||
|
## 二、主流数据库向量能力差异对比
|
||||||
|
|
||||||
|
Oracle 在 MySQL 9.0 中新增了 VECTOR 向量字段类型和一些转换函数,但是没有支持向量索引。如果用户想要做高性能近似最近邻(ANN)向量检索,要么需要扫描全表的数据,要么就是去额外购买付费的 HeatWave 组件。而火山引擎提供了轻量化、更有优势的检索方案:
|
||||||
|
|
||||||
|
- 在 MySQL 8.0 和 MySQL 8.4 版本上都支持高性能向量索引,不需要升级到 MySQL 9.x 版本,也不需要购买额外的付费 HeatWave 组件。
|
||||||
|
- 完全兼容 MySQL 9.x 的标准 VECTOR 向量字段定义和向量转换语法,不用改造业务代码,维护成本低。
|
||||||
|
|
||||||
|
下表列举了各数据库的原生向量能力的功能差异:
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
## 三、RDS MySQL 与 MariaDB、pgvector 的向量索引性能对比
|
||||||
|
|
||||||
|
市面上主流数据库的向量索引存在索引构建耗时长、向量检索耗时长和向量索引占用大量磁盘存储空间这几个痛点。火山引擎 RDS MySQL 针对上述痛点,进行了深度的内核优化,同时从索引构建速度、索引的大小、索引查询性能三个方面,横向对比了与 MariaDB 13.1(同属 MySQL 生态)和 pgvector 0.8.2(PostgreSQL 生态中最受欢迎的向量索引扩展)的差异。
|
||||||
|
|
||||||
|
### 1、索引的构建速度:提升 4~6 倍
|
||||||
|
|
||||||
|
MariaDB 的向量索引都是采用串行索引构建的,这就导致了构建大量向量索引的耗时极长。而火山引擎依靠自研的高性能并行构建引擎,打破了向量索引构建的瓶颈,即使是百万级向量数据,也可以快速构建向量索引。
|
||||||
|
|
||||||
|
本次测试使用参数 m=16、ef_construction=128 的 HNSW 索引配置,选取两组不同维度的向量数据集,统计了从向量数据载入至索引构建的整体耗时。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
根据柱状图的对比数据,可以得出以下结论:
|
||||||
|
|
||||||
|
- **1536 维、5 万条向量数据**:MariaDB 构建索引耗时 126 秒,pgvector 构建索引耗时 27.76 秒,火山引擎 RDS MySQL 构建索引耗时 22 秒。火山引擎 RDS MySQL 构建索引的速度相比 MariaDB 提升约 6 倍。
|
||||||
|
|
||||||
|
- **768 维、100 万条向量数据**:MariaDB 构建索引耗时 2524.5 秒,pgvector 构建索引耗时 378.5 秒,火山引擎 RDS MySQL 构建索引耗时 645.6 秒。火山引擎 RDS MySQL 构建索引的速度相比 MariaDB 提升约 4 倍。
|
||||||
|
|
||||||
|
向量数据集越大,并行构建向量索引的效率提升越明显,在百万级向量索引构建场景下,索引的构建时间从 42 分钟缩短到至 11 分钟以内。
|
||||||
|
|
||||||
|
### 2、索引的大小:减少 2~4 倍
|
||||||
|
|
||||||
|
原生 pgvector 仅支持 Float32 向量存储,构建的索引占用的磁盘空间较大。而火山引擎 RDS MySQL 提供 SQ16、SQ8 两种标量量化,用更紧凑的方式存储向量索引。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
结合上述柱状图对比数据,可以得出以下结论:
|
||||||
|
|
||||||
|
- **1536 维、5 万条向量数据**:MariaDB 构建的索引大小为 218.1 MB,pgvector 构建的索引大小为 391 MB,火山引擎 RDS MySQL 构建的索引大小为 220.4 MB。
|
||||||
|
- **768 维、100 万条向量数据**:MariaDB 构建的索引大小为 2.135 GB,pgvector 构建的索引大小为 3.906 GB,火山引擎 RDS MySQL 构建的索引大小为 2.219 GB。
|
||||||
|
|
||||||
|
相比 pgvector,开启 SQ16 量化后索引大小可缩减至 1/2,SQ8 量化后进一步缩减至 1/4,可以有效减少向量索引占用的磁盘空间,降低存储成本。
|
||||||
|
|
||||||
|
### 3、索引的查询性能:高召回下查询吞吐领先 2~3 倍
|
||||||
|
|
||||||
|
本次性能测试使用行业公认基准工具 VectorDBBench 执行,基于高召回率的实用业务区间,统计各数据库向量检索吞吐(QPS)指标。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
结合上述柱状图对比数据,可以得出以下结论:
|
||||||
|
|
||||||
|
- **1536 维 5 万条向量数据、97% 召回率**:MariaDB 向量检索吞吐(QPS)为 5326,pgvector 向量检索吞吐(QPS)为 3600,火山引擎 RDS MySQL 向量检索吞吐(QPS)为 8334。相比之下,火山引擎 RDS MySQL 的向量吞吐(QPS)约为 MariaDB 的 1.6 倍、pgvector 的 2.3 倍。
|
||||||
|
- **768 维 100 万条向量数据、95% 召回率**:MariaDB 向量检索吞吐(QPS)为 3703,pgvector 向量检索吞吐(QPS)为 2100,火山引擎 RDS MySQL 向量检索吞吐(QPS)为 4838。相比之下,火山引擎 RDS MySQL 的向量吞吐(QPS)约为 MariaDB 的 1.3 倍、pgvector 的 2.3 倍。
|
||||||
|
|
||||||
|
## 四、对接开源框架,RDS MySQL 就是 RAG 向量库
|
||||||
|
|
||||||
|
除了具备高性能向量索引的能力外,是否能低成本、快速便捷地接入 AI 应用也很重要。火山引擎 RDS MySQL 官方适配 LangChain、LlamaIndex 两大主流 RAG 开发框架,将底层的向量操作 SQL 封装成标准的 vector_store 接口,仅调用框架标准 API 即可完成向量表和向量索引的创建、向量的增删改查、相似度检索等操作。开发者不用再手写 SQL,即可将 RDS MySQL 作为 RAG 框架原生向量存储后端。
|
||||||
|
|
||||||
|
综上所述,您的 MySQL 实例可以直接作为向量数据库去使用,无需再额外部署 Milvus、Pinecone 或 Weaviate 等向量引擎数据库了;并且业务数据和向量数据存储在同一张表中,也保证了业务数据与向量数据的一致性。
|
||||||
|
|
||||||
|
```
|
||||||
|
from langchain_community.vectorstores import MySQLVectorStore
|
||||||
|
vectorstore = MySQLVectorStore( connection_string="mysql+pymysql://user:pass@rds-endpoint:3306/mydb", embedding_function=embeddings, table_name="documents")
|
||||||
|
# 直接当向量数据库用
|
||||||
|
results = vectorstore.similarity_search("如何配置数据库备份?", k=5)
|
||||||
|
```
|
||||||
|
|
||||||
|
## 总结
|
||||||
|
|
||||||
|
火山引擎 RDS MySQL 为标准的 MySQL 补齐了向量数据存储与高性能向量索引能力,填补了 MySQL 生态在 AI 场景的短板。它支持 MySQL 8.0 和 MySQL 8.4 两个版本,完全兼容 MySQL 9.x 的标准 VECTOR 向量字段定义和向量转换语法,不用改造业务代码,同时也具备高性能索引构建与检索能力,并适配 LangChain、LlamaIndex 开发框架。
|
||||||
|
|
||||||
|
如果您正在为 AI 应用选择向量数据库,又想减少额外部署向量数据库的成本,可以选择火山引擎的 RDS MySQL(点击阅读原文获取),即可一站式落地企业 RAG 业务。
|
||||||
@@ -0,0 +1,74 @@
|
|||||||
|
# 📊 文章摘要:火山引擎 RDS MySQL 向量索引:把高性能向量检索带到 MySQL 上
|
||||||
|
|
||||||
|
> **原文**:[2026-08-20_火山引擎_RDS_MySQL_向量索引_把高性能向量检索带到_MySQL_上](./2026-08-20_火山引擎_RDS_MySQL_向量索引_把高性能向量检索带到_MySQL_上.md)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/f5aEV7az3RYQeivyQUJsYQ
|
||||||
|
> **来源**:微信公众平台
|
||||||
|
> **作者**:火山引擎数据库
|
||||||
|
> **发布日期**:2026-08-20
|
||||||
|
> **摘要日期**:2026-08-20
|
||||||
|
> **价值评级**:⭐⭐ 中
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 核心命题
|
||||||
|
|
||||||
|
> **向量进 MySQL** — 业务数据与向量数据同表共存,仅靠 MySQL 一套系统即可完整落地 RAG,免除额外部署向量数据库的链路、同步与运维成本。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 文章概要
|
||||||
|
|
||||||
|
火山引擎数据库团队的产品发布文:RDS MySQL 推出高性能向量索引,在 MySQL 8.0/8.4 上支持 HNSW 向量索引且完全兼容 MySQL 9.x 的 VECTOR 语法,用户可在一张表内同时执行常规业务查询与向量检索。文章给出与 MariaDB 13.1、pgvector 0.8.2 的三方基准对比(VectorDBBench):索引构建速度提升 4~6 倍(并行构建引擎)、SQ16/SQ8 标量量化使索引体积缩减至 1/2~1/4、高召回率下检索 QPS 领先 2~3 倍,并官方适配 LangChain/LlamaIndex 的 vector_store 接口。价值在于选型参考数据;局限是厂商自测基准、对比对象不含专用向量数据库(Milvus 等)。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 关键要点
|
||||||
|
|
||||||
|
1. **一张表内业务查询+向量检索** — 免去"MySQL + 独立向量库"双系统的查询链路变长、数据同步与运维成本 `[分类: 共识]`
|
||||||
|
2. **兼容 MySQL 9.x VECTOR 语法且支持 8.0/8.4** — 不改造业务代码、不强制升级版本、无需购买 HeatWave 付费组件 `[分类: 厂商主张]`
|
||||||
|
3. **并行构建引擎:索引构建提速 4~6 倍** — 百万级向量索引构建从 42 分钟缩短到 11 分钟内(对比 MariaDB 串行构建)`[分类: 厂商数据]`
|
||||||
|
4. **SQ16/SQ8 标量量化:索引体积缩至 1/2~1/4** — 相比 pgvector 仅支持 Float32 存储,存储成本显著下降 `[分类: 厂商数据]`
|
||||||
|
5. **高召回下 QPS 领先 2~3 倍** — 97%/95% 召回率实用区间,QPS 约为 pgvector 的 2.3 倍(VectorDBBench 基准)`[分类: 厂商数据]`
|
||||||
|
6. **官方适配 LangChain/LlamaIndex** — vector_store 标准接口封装 SQL,开发者无需手写 SQL 即可接入 RAG 框架 `[分类: 共识]`
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 批判性分析
|
||||||
|
|
||||||
|
### 假设前提
|
||||||
|
|
||||||
|
(1) 用户的核心痛点是"多部署一套向量数据库"——对已重度使用 MySQL 的团队成立,对云原生团队未必;(2) 厂商自测基准环境公平——未公开测试硬件、数据集与配置细节;(3) RAG 规模停留在百万级向量——更大规模(亿级)场景未验证。
|
||||||
|
|
||||||
|
### 论据与逻辑
|
||||||
|
|
||||||
|
对比数据具体(维度×数据量×耗时×QPS),有行业基准工具背书,内部逻辑完整。但明显回避了与专用向量数据库(Milvus、Pinecone、Weaviate——文中仅作为"可不再部署"的对象提及)的性能对比;pgvector 0.8.2 的量化能力(halfvec 等)也未讨论。768 维百万级场景中构建耗时(645.6s)实际慢于 pgvector(378.5s),标题的"4~6 倍提升"仅相对 MariaDB,存在选择性表述。
|
||||||
|
|
||||||
|
### 边界与局限
|
||||||
|
|
||||||
|
适用于 MySQL 存量业务团队为 RAG 场景做数据库选型参考;不适用于需要亿级向量、多模态索引、分布式检索的重度向量场景。性能数字为厂商口径,采购前应自行复测。blob 图片链接(功能对比表、性能柱状图)在归档中不可见,关键表格数据依赖原文页面。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 可引用金句
|
||||||
|
|
||||||
|
> "用户不用再单独部署向量数据库,可以让您在一张 MySQL 表里同时执行常规业务查询和向量检索,仅依赖 MySQL 数据库即可完整实现 RAG 业务能力。"
|
||||||
|
|
||||||
|
> "在百万级向量索引构建场景下,索引的构建时间从 42 分钟缩短到至 11 分钟以内。"
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 总体评价
|
||||||
|
|
||||||
|
**亮点**:
|
||||||
|
- 三方对比数据具体到维度、数据量、召回率与 QPS,参考价值实
|
||||||
|
- 兼容 9.x 语法 + 支持 8.0/8.4 的组合拳切中存量用户痛点
|
||||||
|
- LangChain/LlamaIndex 适配降低接入门槛
|
||||||
|
|
||||||
|
**不足**:
|
||||||
|
- 厂商自测,无第三方复现;未对比专用向量数据库
|
||||||
|
- "提升 4~6 倍"仅相对最弱的 MariaDB 基线,对 pgvector 的构建速度并无优势(选择性表述)
|
||||||
|
- 关键性能图以 blob 图片承载,文本不可提取
|
||||||
|
|
||||||
|
**适用场景**:MySQL 存量团队的 RAG 架构选型、向量数据库 vs 关系库一体化的技术评估
|
||||||
|
|
||||||
|
**关联建议**:与 G3 组《从 Data Lake 到 State Lake》《Storage Agent Family》(本批归档)对读,理解火山引擎"数据基础设施全面 Agent 化/RAG 化"的布局;专用向量库场景可对照 Milvus 基准报告
|
||||||
@@ -0,0 +1,188 @@
|
|||||||
|
# 过去一周,模型在下饺子,价格在下刀子,人才在跑路,AI厂商卷入生死时速!
|
||||||
|
|
||||||
|
> **来源**:微信公众平台(祖哥)
|
||||||
|
> **作者**:祖哥(e-works 祖哥综合报道)
|
||||||
|
> **发布日期**:2026-08-20(原文未标注明确日期,文中覆盖 8 月 8 日至 14 日动态,按下载日占位)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/tRwcm21YyiiMU-HxgysinQ
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
|
||||||
|
|
||||||
|
快看看过去这一周都发生了什么?从8月8日到14日,全球AI圈像集体被按了快进键:阿里、智谱、MiniMax、谷歌、OpenAI、DeepSeek、xAI、Meta、LTX——你能叫得出名字的厂商,几乎个个都在这周放了大招。最夸张的是8月14日,一天之内五家厂商轮番上阵,你方唱罢我登场。这一周,没有一家敢歇脚,谁也不愿意当那个掉队的人。这周AI下料真的太猛,AI厂商已进入生死时速!
|
||||||
|
|
||||||
|
内容提要/OVERVIEW
|
||||||
|
|
||||||
|
**- 文章信息 -**
|
||||||
|
|
||||||
|
本文由e-works祖哥综合报道。
|
||||||
|
|
||||||
|
先上张全貌图表,看看这一周的发布节奏有多密,我把8月8日之前的两个重要的前序事件(MiniMax-H3以及Jeff Dean)也加入了列表:
|
||||||
|
|
||||||
|
|
||||||
|
|
||||||
|
下文我们用倒序的手法,更加详细的给大家唠唠一些细节:
|
||||||
|
|
||||||
|
**01**
|
||||||
|
|
||||||
|
**8月14日**
|
||||||
|
|
||||||
|
**一天五连发,火药味拉满**
|
||||||
|
|
||||||
|
如果把这周拍成一部电影,8月14日就是全片高潮——一天之内,五家厂商先后登台,放个响炮就走,绝不多耽误一秒。
|
||||||
|
|
||||||
|
🔷 先是阿里千问,当晚正式开源Qwen3.8-27B。270亿参数,原生多模态稠密模型,是开发者社区呼声最高的"黄金尺寸";原生支持262K超长上下文,再用YaRN技术轻轻一推,直接拉到100万Token。最狠的是,它明明比自家大哥Qwen3.7-Plus小一大圈,编程和办公场景的表现却反超了大哥,还被不少开发者拿来和Claude 4.6正面硬刚,社区直呼"小钢炮"。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
🔷 紧接着,智谱甩出GLM-5.3,一句话概括它的定位:"为写代码而生,为网络防御而备。"这次智谱没换基座,还是在743B参数的大模型上做后训练,但打法换了:把长程任务环境扩了数十倍、环境类型更丰富、后训练时间拉到超长。效果立竿见影——官方称编程能力较上一代提升50%,在Terminal Bench 3.0、Agents' Last Exam这些公开榜单上拿下"开源第一",网络安全更是被官方视为"开源模型的新标准"。不过它留了个小心思:完整权重要等两周后才放出来,吊足了开源社区的胃口。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
🔷 同一天,MiniMax发布了Music 3.0——一个开放权重、生产级、全能的音乐生成模型。给它一个创意和可选歌词,它一次性给你生成最长5分钟、32kHz立体声的完整歌曲,词曲配唱一条龙,堪称"AI界的音乐制作人"。继 AI 视频自由(MiniMax H3)后,AI 音乐也自由了。Music 3.0目前在开源社区极度受欢迎。
|
||||||
|
|
||||||
|
Minimax Music 3 chill R&B 样例演示
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
🔷 谷歌这天也没闲着,火速上线Gemini 3.7 Flash。这个版本有多赶?距离上一代3.6 Flash发布才过去三周,短短两三个月内,Flash系列已经迭代了三次。这次依然没有Pro压阵,只有Flash单刀赴会,主打编程和智能体场景,官方称它是"迄今最智能的主力工作模型",还把价格直接砍半——2026年底前,输入每百万Token只要0.75美元。业内解读很直白:谷歌这是要靠密集发版对冲DeepMind人事地震的冲击,用产品说话,比什么都实在。业界普遍风评,对于3.7 Flash印象不错,"谷大爷"终于从前面的阴影中稍微走了出来!
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
🔷 压轴的OpenAI则祭出"速度杀招"——为旗舰模型GPT-5.6 Sol推出Ultrafast超高速模式(预览版),推理速度是标准版的14倍,最高每秒输出750个Token,由Cerebras硬件提供支持。GPT-5.6 Sol本来就是OpenAI在"法律文书、金融模型、工程报告"这些场景上表现最好的模型,现在配上14倍速,在衡量经济价值知识工作的GDP-Val基准上实现了5.6倍的端到端提速,质量一点没掉。官方表示先在API对选定客户开放,等算力跟上再放量——典型的高端产品"饥饿营销"。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
Ultrafast和Standard代码生成
|
||||||
|
|
||||||
|
与实时 3D/仿真模拟对比
|
||||||
|
|
||||||
|
**02**
|
||||||
|
|
||||||
|
**8月13日:DeepSeek深夜悄悄交卷**
|
||||||
|
|
||||||
|
**还捎带涨了个价**
|
||||||
|
|
||||||
|
如果说8月14日是明火执仗,那8月13日的DeepSeek就是深夜偷家——没有发布会、没有海报,8月12日晚上悄悄把官网API文档里的模型版本号更新成V4-Pro-0813,凌晨在群里轻描淡写发了句公告。大哥,你依然还是太低调了。但是社区的狂热粉丝不允许它低调。
|
||||||
|
|
||||||
|
正式版主打的就一件事:补齐Agent(智能体)能力。官方给的几组数据非常夸张:软件工程基准DeepSWE从12.8直接飙到62.7,涨了近5倍;网络安全Cybergym从52.7涨到83.3;Terminal Bench 2.1更是从72.1冲到87.9——而海外顶级模型Claude Fable 5是88.0,就差0.1分,多项基准直指Fable 5。实测下来,1M Token上下文、最大384K输出,明显是奔着多文件、长任务的老手编程场景去的。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
不过,大家更关心的可能是钱的事。DeepSeek这次不只是发模型,还宣布了一波涨价:8月17日零时起实行"峰谷分时定价",高峰时段V4-Pro每百万Token输出从6元涨到27元,涨幅350%;V4-Flash高峰输出也从2元涨到9元;闲时价格则打对折。翻译一下:以后想用便宜的DeepSeek,得学会"错峰用电"。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
涨价消息一出,评论区立刻玩起了"滑动变阻器"的梗——网友把物理课上的滑动变阻器谐音成"滑动变祖器",调侃梁文锋的"调参强度"就像拨动变阻器,刻度从"小难梁"一路滑到"梁祖"。这个梗火到什么程度?有人干脆把它做成了DeepSeek Harness的皮肤。没错,DeepSeek这次还顺带开源了自家Agent框架Harness v0.1(内部代号"黑鲸"团队出品),用MIT协议面向全球开发者开放——模型涨价、框架开源,一紧一松,路子玩得明明白白。
|
||||||
|
|
||||||
|
来源X社区网友@chen du
|
||||||
|
|
||||||
|
说到梁文锋,就不得不提"买芯片"这档子事。此前一场闭门会议的实录流出:梁文锋直言英伟达CUDA的护城河正在瓦解,华为超节点可以"完全平替",在买不到英伟达卡的情况下,DeepSeek干脆"壮士断腕",把宝押在了华为昇腾950等国产芯片上。模型涨价要养算力,算力底座又赌在国产芯片上——DeepSeek这盘棋,下得比谁都大。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
不过实话实说,这次V4-Pro正式版带来的轰动,确实不如7月31日的V4-Flash 0731那一波。原因也简单:Flash版本刚炸过场,Pro版是"虚晃一枪后正式交卷",大家阈值被抬高了。
|
||||||
|
|
||||||
|
**03**
|
||||||
|
|
||||||
|
**8月12日**
|
||||||
|
|
||||||
|
**马斯克的"AI战役"宣言**
|
||||||
|
|
||||||
|
8月12日这天,主角只有一个:埃隆·马斯克。他的AI部门一口气放了三件套。
|
||||||
|
|
||||||
|
🔷 第一件,Grok 4.6正式发布。官方原话:"它交付了前沿智能,且在同一价格下比Grok 4.5有显著提升。"翻译过来就是:加量不加价——输入每百万Token仍是2美元、输出6美元,价格直接挂在竞品的一半。这代模型背后有个秘密武器:SpaceX此前以600亿美元全股票收购了AI编程工具Cursor,Grok 4.6深度吸收了Cursor的海量真实编程工作流数据(还是匿名化的),这让它在写代码这件事上突飞猛进,在综合9项基准的Artificial Analysis智能指数上追平GPT-5.6 Sol(同为61分),部分单项甚至反超,稳坐第一梯队。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
用Grok 4.6进行代理构建CAD的工作
|
||||||
|
|
||||||
|
用Grok 4.6通过Three.js
|
||||||
|
|
||||||
|
做的一个喷气发动机爆炸图视角
|
||||||
|
|
||||||
|
各大厂商开始把"工业设计、工业应用"当成新的吹嘘资本,因为能搞定发动机、能画CAD,才代表模型真正理解了物理世界。
|
||||||
|
|
||||||
|
🔷 第二件,Grok Bot率先上线(8月11日放出,比Grok 4.6还早一天)。官方介绍很带感:"Bot就是帮你干实事的AI队友。它们登录你的工具,像你一样使用它们,然后把干完的活交给你。"早期用户评价:体验不像给客服下指令,更像把活儿交给一个能力出众的同事。摆明了要对标Anthropic和OpenAI的智能体产品。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
🔷 第三件,马斯克在SpaceX全员大会上的"战前动员"(一段约30分钟的视频被公开)。他的核心台词只有一句:AI这一仗,必须赢。马老师还放了大预言:AI业务收入最快今年9月就能超过SpaceX其他所有业务,5年后AI将占公司估值的99%,明年底建成10GW算力。翻译一下就是:以后SpaceX不是造火箭的公司,是披着火箭壳子的AI公司。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
还没完,马斯克顺手又发了条推,预告Grok 4.7"马上就要来"——4.6的余温还没散,4.7的预告就来了,这速度,卷得让人头皮发麻。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
有人说——马斯克很神奇的地方在于,短期经常失败,但长期来看几乎都是成功的,比如最近的 xAI,本来以为不行了,结果 Grok4.6 几个版本发出来,再配合 SpaceX 数据中心土建狂魔,一下子又变成头部玩家了。
|
||||||
|
|
||||||
|
**04**
|
||||||
|
|
||||||
|
**8月11日**
|
||||||
|
|
||||||
|
**开源界扔下两颗炸弹**
|
||||||
|
|
||||||
|
这周最"分裂"的厂商,非Meta莫属。
|
||||||
|
|
||||||
|
五天前才刚以闭源姿态发布旗舰Muse Spark 1.2,一个字没提开源;五天后(美国时间8月10日,北京时间8月11日),Meta超级智能实验室却冷不丁甩出Muse Glimmer——继Llama 4之后首次开源的重磅炸弹:300亿参数,史上最宽松的Apache 2.0协议(这是Meta第一次用Apache 2.0发模型),在Artificial Analysis智能指数上拿到35分,还专门为"全天候常驻运行的本地智能体"做了深度优化——4bit量化之后,一张24GB或32GB显存的消费级显卡就能本地跑,普通Mac和PC都能玩。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
有意思的是,扎克伯格同一天发了6500字长文谈开源生态,Meta还放话说Muse Spark 1.2的权重"很快也会开源"。五天前闭源、五天后开源,一收一放之间,把小扎"打不过就加入"的心态暴露得明明白白。有媒体点评:Meta回开源赛道,是带着"悔过书"回来的。
|
||||||
|
|
||||||
|
同一天,开源视频领域也炸了:由Lightricks分拆出来的LTX公司发布了LTX-2.5。这可不是普通的文生视频模型,官方管它叫"开放世界模型"——视频、音频、世界模拟一把抓。效率更是离谱:在英伟达旗舰双卡GB200上,单张图生成10秒720p视频只要6.8秒,比视频播放本身还快,生成成本只有同类模型的八分之一。而且它原生集成进了ComfyUI,面向中小企业直接免费——开源视频模型的"价格屠夫",出现了。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
**05**
|
||||||
|
|
||||||
|
**在此之前**
|
||||||
|
|
||||||
|
**MiniMax-H3的狂欢余波**
|
||||||
|
|
||||||
|
严格来说,MiniMax-H3是7月31日发布、8月3日开源的,赶在这周之前,但它的热度一直烧到了这周。这款通用全模态生成模型当时引起业界狂欢:统一理解文本、图像、视频、音频,最高2K分辨率、一次生成15秒、自带原生立体声音效,24fps的流畅画面,直接对标字节的Seedance 2.5。价格更是"白菜":768p每秒只要0.23元,2K也只要0.4元。社区实测,一张12GB显存的RTX 3060就能跑,开源24小时内就完成了对华为昇腾、AMD、Intel的适配——开源视频模型的性价比天花板,被它捅了个大窟窿。这也是为什么网友说,这周的LTX-2.5,是"狂欢的延续"。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
**06**
|
||||||
|
|
||||||
|
**人比模型更抢手**
|
||||||
|
|
||||||
|
**AI人才大逃亡**
|
||||||
|
|
||||||
|
模型在下饺子,人在跑路。这周的AI人才动向,比发布会还精彩。
|
||||||
|
|
||||||
|
🔷 8月14日,Meta超级智能实验室核心研究员余家辉宣布离职创业。他是被小扎用天价薪酬挖来的——此前《连线》杂志报道,Meta为顶级AI人才开出的薪酬包最高四年3亿美元,第一年就可能超过1亿美元(约合7亿元人民币)。可就是这样"亿元年薪"也留不住人:他加入Meta才一年出头,带队做出Muse Spark,离职前刚更新到1.2版本,转头就宣布要"探索对人类未来至关重要的事"。在他之前,华人科学家田渊栋、图灵奖得主杨立昆已经先后出走创业,据媒体统计,Meta出走的AI骨干已近千人。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
🔷 8月12日凌晨,原阿里千问技术负责人林俊旸在X平台发文官宣:在上海创办AI公司Pragmatik Labs(语用科技,简称p7k),方向是"横跨数字世界和物理世界的下一代Agent",高榕创投和红杉中国联合领投,腾讯和上海未来产业基金也下场支持,市场传闻估值已达20亿美元。阿里出身的顶级人才,一转身就成了新贵公司的创始人。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
🔷 再把时间往前拨:8月5日,谷歌AI迎来史上最大人事地震——在谷歌工作27年的首席科学家Jeff Dean正式离职,与三位技术元老一起创办Discovery Loop;DeepMind CEO哈萨比斯卸任,转任DeepMind董事长兼Alphabet首席科学家,据说他原本也想打包走人,是被谷歌连夜拦下、"架"上董事长位置的。
|
||||||
|
|
||||||
|
再往前,7月底,人称"AI圈最会追风的男人"的贾扬清离开英伟达,创办Intent Lab,押注自主AI软件工程。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
一句话总结这周的人才局面:巨头们一边在台上发布新模型,一边在台下目送自己的技术大牛离职创业。模型可以靠后训练,人才可没法靠后训练——这,才是巨头们最头疼的护城河问题。
|
||||||
|
|
||||||
|
**结语**
|
||||||
|
|
||||||
|
回过头看这疯狂的一周:8月14日一天五连发,DeepSeek深夜悄悄交卷顺便涨了价,马斯克放话"AI这一仗必须赢"还顺手预告了4.7,Meta时隔大半年重回开源、LTX把视频生成成本打到八分之一……模型在下饺子,价格在下刀子,人才在跑路。
|
||||||
|
|
||||||
|
2026下半年的AI竞争,已经不是什么"军备竞赛",而是实实在在的"生死时速"——没有人敢掉队,没有人敢歇口气。下一周会有什么?没人知道。但可以肯定的是,这群厂商,一刻都不会停。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|

|
||||||
@@ -0,0 +1,73 @@
|
|||||||
|
# 📊 文章摘要:过去一周,模型在下饺子,价格在下刀子,人才在跑路,AI厂商卷入生死时速!
|
||||||
|
|
||||||
|
> **原文**:[2026-08-20_过去一周_模型在下饺子_价格在下刀子_人才在跑路_AI厂商卷入生死时速.md](./2026-08-20_过去一周_模型在下饺子_价格在下刀子_人才在跑路_AI厂商卷入生死时速.md)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/tRwcm21YyiiMU-HxgysinQ
|
||||||
|
> **来源**:微信公众平台
|
||||||
|
> **作者**:祖哥(e-works 综合报道)
|
||||||
|
> **发布日期**:2026-08-20
|
||||||
|
> **摘要日期**:2026-08-20
|
||||||
|
> **价值评级**:⭐⭐ 中
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 核心命题
|
||||||
|
|
||||||
|
> **生死时速** — 以 2026 年 8 月 8 日至 14 日一周为窗口,记录全球 AI 厂商密集发布、价格策略转向与顶级人才外流三条并行主线,呈现行业竞争从"军备竞赛"升级为"无人敢掉队"的消耗战。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 文章概要
|
||||||
|
|
||||||
|
本文是 e-works 的 AI 行业周报,倒序盘点一周动态:8 月 14 日阿里 Qwen3.8-27B、智谱 GLM-5.3、MiniMax Music 3.0、谷歌 Gemini 3.7 Flash、OpenAI GPT-5.6 Sol Ultrafast 五连发;8 月 13 日 DeepSeek V4-Pro-0813 深夜上线并宣布峰谷分时涨价(高峰输出涨 350%);8 月 12 日马斯克 xAI 三件套(Grok 4.6、Grok Bot、战前动员);8 月 11 日 Meta 重回开源(Muse Glimmer,首个 Apache 2.0)与 LTX-2.5 开源视频;并汇总余家辉、林俊旸、Jeff Dean、哈萨比斯、贾扬清等人才大流动。其价值是高密度的时间线索引与可引用事实清单(发布节奏、定价、参数);局限是汇编转述,官方宣传、社区传闻与玩梗混排,无独立核查,情绪化修辞较多。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 关键要点
|
||||||
|
|
||||||
|
1. **8 月 14 日一天五连发** — Qwen3.8-27B 开源(262K 原生上下文,YaRN 拉至 1M Token);GLM-5.3(743B 后训练,官方称编程提升 50%,完整权重两周后放出);Music 3.0(开放权重,最长 5 分钟 32kHz 立体声);Gemini 3.7 Flash(三周迭代一次,价格砍半至 0.75 美元/百万输入 Token);GPT-5.6 Sol Ultrafast(Cerebras 支撑,推理 14 倍速、750 Token/秒)。 `[分类: 共识]`
|
||||||
|
2. **DeepSeek V4-Pro 补齐 Agent 能力** — DeepSWE 12.8→62.7(近 5 倍)、Cybergym 52.7→83.3、Terminal Bench 2.1 72.1→87.9(对比 Claude Fable 5 的 88.0 仅差 0.1),1M 上下文/384K 输出,指向多文件长任务编程。 `[分类: 共识]`(数据为官方口径)
|
||||||
|
3. **DeepSeek 峰谷分时定价** — 8 月 17 日起 V4-Pro 高峰输出 6→27 元/百万 Token(+350%),V4-Flash 2→9 元,闲时减半。"错峰用电"式定价是头部低价厂商定价范式松动的信号。 `[分类: 争议]`
|
||||||
|
4. **模型涨价与框架开源并行** — 同步开源 Agent 框架 Harness v0.1(MIT 协议,"黑鲸"团队出品),"一紧一松"的生态策略。 `[分类: 共识]`
|
||||||
|
5. **DeepSeek 押注国产芯片** — 引梁文锋闭门会议流出实录:CUDA 护城河正在瓦解、华为超节点可"完全平替"、算力底座押华为昇腾 950 等国产芯片。 `[分类: 争议]`(单一信源流出实录,未获证实)
|
||||||
|
6. **Meta 五天内闭源转开源** — 8 月 6 日闭源发布 Muse Spark 1.2 后,8 月 11 日以史上首个 Apache 2.0 协议开源 Muse Glimmer(30B,4bit 量化后 24/32GB 消费级显卡可跑本地常驻 Agent),扎克伯格同日发 6500 字开源长文。 `[分类: 共识]`
|
||||||
|
7. **开源视频成本击穿** — LTX-2.5("开放世界模型",视频+音频+世界模拟):GB200 双卡生成 10 秒 720p 视频仅 6.8 秒(快于播放本身),成本为同类 1/8,原生集成 ComfyUI 并对中小企业免费;承接 7 月底 MiniMax-H3 的性价比狂欢(768p 每秒 0.23 元)。 `[分类: 共识]`
|
||||||
|
8. **Grok 4.6 与 Cursor 数据** — 依托 SpaceX 600 亿美元收购 Cursor 获得匿名化真实编程工作流数据,Artificial Analysis 智能指数 61 分追平 GPT-5.6 Sol;马斯克预言 AI 业务 5 年后占 SpaceX 估值 99%、明年底建成 10GW 算力。 `[分类: 争议]`(预言部分)
|
||||||
|
9. **顶级人才大逃亡** — Meta 余家辉(亿元级薪酬仍离职创业,累计出走骨干近千人)、阿里林俊旸创 Pragmatik Labs(传估值 20 亿美元)、谷歌 Jeff Dean 离职创 Discovery Loop、哈萨比斯被"架"上董事长、贾扬清创 Intent Lab。作者论断:人才是无法靠后训练补齐的护城河。 `[分类: 争议]`(作者观点)
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 批判性分析
|
||||||
|
|
||||||
|
### 假设前提
|
||||||
|
- 默认各厂商自报的榜单成绩、能力提升幅度与定价策略均如实且可信,未做交叉核验。
|
||||||
|
- 以发布节奏密度直接推断竞争烈度("生死时速"),预设发版速度等于竞争力。
|
||||||
|
|
||||||
|
### 论据与逻辑
|
||||||
|
- 官方数据、媒体报道(如《连线》薪酬报道)、社区传闻("市场传闻估值已达 20 亿美元")、流出实录(梁文锋闭门会)与网络玩梗(滑动变阻器)混排,信源可信度分层缺失。
|
||||||
|
- 修辞驱动("下饺子""下刀子""跑路"),结论性判断("生死时速""没有一家敢歇脚")缺乏商业数据支撑(收入、份额、利用率)。
|
||||||
|
|
||||||
|
### 边界与局限
|
||||||
|
- 观察窗口仅一周,趋势判断的外推风险高;所有基准成绩均为厂商口径。
|
||||||
|
- 对发布物的能力边界(榜单之外的失效场景)无任何检验或保留。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 可引用金句
|
||||||
|
|
||||||
|
> "模型可以靠后训练,人才可没法靠后训练——这,才是巨头们最头疼的护城河问题。"
|
||||||
|
|
||||||
|
> "2026下半年的AI竞争,已经不是什么'军备竞赛',而是实实在在的'生死时速'——没有人敢掉队,没有人敢歇口气。"
|
||||||
|
|
||||||
|
> "以后想用便宜的DeepSeek,得学会'错峰用电'。"
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 总体评价
|
||||||
|
|
||||||
|
**亮点**:一周时间线 + 全部关键发布参数/定价的高密度汇编,配有发布节奏总览图,是 2026 年 8 月中旬 AI 产业动态的优质索引与事实清单来源。
|
||||||
|
|
||||||
|
**不足**:无独立核查、无信源分级、传闻与事实混排;情绪化标题与修辞先行,批判距离不足。
|
||||||
|
|
||||||
|
**适用场景**:行业动态时间线归档、竞品发布与定价追踪的线索入口(引用具体数字前建议回溯各厂商官方公告核实)。
|
||||||
|
|
||||||
|
**关联建议**:与已归档的模型发布类文章互链;DeepSeek 涨价与国产芯片押注两条线索值得单独开档跟踪验证。
|
||||||
@@ -0,0 +1,78 @@
|
|||||||
|
# 干货丨一文get 2026“人工智能+制造”融合创新研讨会 核心观点
|
||||||
|
|
||||||
|
> **来源**:微信公众平台(自动化博览)
|
||||||
|
> **作者**:自动化博览
|
||||||
|
> **发布日期**:2026-08-20(原文未标注明确日期,按下载日占位;会议举办日为 2026-06-26)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/DnC2BPZBkO5PywsmWlsNSA
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
|
||||||
|
|
||||||
|
|
||||||
|
|
||||||
|
|
||||||
|
|
||||||
|
6月26日,2026“人工智能+制造”融合创新研讨会在京举行。大会以“AI赋能智能制造,构建协同发展新生态”为主题,聚焦工业大脑、智能安全标准化、自主化运营及无人场域建设等热点议题,产学研专家共献智造升级新思路。本文全程回顾,一文尽览嘉宾报告内容与核心观点。
|
||||||
|
|
||||||
|
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
**扫描下方二维码或点击文末阅读原文**
|
||||||
|
|
||||||
|
**即可在线观看现场精彩视频**
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
**· end ·**
|
||||||
|
|
||||||
|
来源 | 2026“人工智能+制造”融合创新研讨会
|
||||||
|
|
||||||
|
责任编辑 | 乔珺
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
**推荐阅读**
|
||||||
|
|
||||||
|
## **重磅 | 《自动化博览》2026年第一期暨《2026具身智能专刊》上线****重磅 |《自动化博览》2026年第二期暨《工业控制系统信息安全专刊(第十二辑)》上线******
|
||||||
|
|
||||||
|
## **重磅 | 《自动化博览》2026年7月刊上线!聚焦传感器与智能仪表、智慧城市~**
|
||||||
|
|
||||||
|
**重磅 |**提智向新 聚势前行——“2025中国自动化产业年会”在京隆重举行
|
||||||
|
|
||||||
|
## **趋势 | 2030中国智能制造及自动化行业展望,附下载**
|
||||||
|
|
||||||
|
## **控制周讯 | 2026年第14期,聚焦“智能交通、工业互联网”**
|
||||||
|
|
||||||
|
## **界·智 |**界·智 2026-7——智能制造电子期刊
|
||||||
|
|
||||||
|
## **院士谈 | 乔红院士:2025具身智能机器人发展趋势**
|
||||||
|
|
||||||
|
## **控制专题 | 工业信息安全 筑牢新型工业化“安全底座”**
|
||||||
|
|
||||||
|
“十五五”专题报告 | 具身智能深度:应用场景、产业链、市场规模,附下载
|
||||||
|
|
||||||
|
**封面故事 | 和利时:以全面自主+工业智能激活流程工业高质量发展新动能**
|
||||||
|
|
||||||
|
## ****白皮书 |**基于具身智能的智慧工厂创新应用白皮书(2025),附下载**
|
||||||
|
|
||||||
|
## ****具身智能 |**于海斌院士等:面向柔性制造的具身智能综述**
|
||||||
|
|
||||||
|
## **工业软件 | 和利时:全国产化SCADA系统在油气长输管道场景的应用**
|
||||||
|
|
||||||
|
**封面故事 | 双轨驱动智造未来:ABB以本地化擘画中国机器人新纪元**
|
||||||
|
|
||||||
|
**洞察 |** 前瞻产业研究院:中国智能制造装备产业发展机遇蓝皮书
|
||||||
|
|
||||||
|
**白皮书 | 2025新质生产力数字人才白皮书,附PDF下载**
|
||||||
|
|
||||||
|
## **荐读 |** 人工智能在光伏安全检测中的应用研究
|
||||||
|
|
||||||
|
## **干货 | 先进制造业核心赛道产业链全景图,附完整图谱!**
|
||||||
|
|
||||||
|
## **机器人 | 山信软件:钢筋焊标机器人3D视觉引导算法**
|
||||||
|
|
||||||
|
**工信部 | 场景化、图谱化推进重点行业数字化转型的参考指引(2025版),附下载**
|
||||||
@@ -0,0 +1,64 @@
|
|||||||
|
# 📊 文章摘要:干货丨一文get 2026"人工智能+制造"融合创新研讨会 核心观点
|
||||||
|
|
||||||
|
> **原文**:[2026-08-20_干货丨一文get_2026_人工智能_制造_融合创新研讨会_核心观点](./2026-08-20_干货丨一文get_2026_人工智能_制造_融合创新研讨会_核心观点.md)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/DnC2BPZBkO5PywsmWlsNSA
|
||||||
|
> **来源**:微信公众平台
|
||||||
|
> **作者**:自动化博览
|
||||||
|
> **发布日期**:2026-08-20(会议举办日为 2026-06-26)
|
||||||
|
> **摘要日期**:2026-08-20
|
||||||
|
> **价值评级**:⭐ 低
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 核心命题
|
||||||
|
|
||||||
|
> **智造新生态** — 会议通稿式回顾,仅提供 2026 年"AI+制造"的议题风向快照,核心观点以图片/视频承载、文本不可得。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 文章概要
|
||||||
|
|
||||||
|
本文是《自动化博览》对 2026 年 6 月 26 日在京举行的"人工智能+制造"融合创新研讨会的回顾推文。会议主题为"AI赋能智能制造,构建协同发展新生态",议题聚焦工业大脑、智能安全标准化、自主化运营及无人场域建设。需要特别说明:标题所承诺的"嘉宾报告内容与核心观点"在网页中以长图图片和直播视频链接形式呈现,正文的可机读文本仅有会议导语、视频导流信息与账号过往文章推荐列表,实质内容无法从文本中提取。其价值仅在于作为 2026 年 AI+制造政策与产业关注点的议程快照。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 关键要点
|
||||||
|
|
||||||
|
1. **会议主题定调** — "AI赋能智能制造,构建协同发展新生态",强调协同生态而非单点技术 `[分类: 共识]`
|
||||||
|
2. **四大热点议题** — 工业大脑、智能安全标准化、自主化运营、无人场域建设 `[分类: 共识]`
|
||||||
|
3. **核心观点载体为图片/视频** — 嘉宾报告内容以长图与直播回放承载,文本不可提取,本归档无法还原实质观点 `[分类: 事实说明]`
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 批判性分析
|
||||||
|
|
||||||
|
### 假设前提
|
||||||
|
- 无可评估的论证内容(正文实质内容缺失)。
|
||||||
|
|
||||||
|
### 论据与逻辑
|
||||||
|
- 唯一可读的导语段落为标准会议通稿模板,无独立论据。
|
||||||
|
|
||||||
|
### 边界与局限
|
||||||
|
- 归档局限性明确:原文核心内容在图片中,需观看直播回放(httphuodongs.kongzhi.net/2026/AIIM/zhibo.html)或人工读图方可获取实质观点。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 可引用金句
|
||||||
|
|
||||||
|
> "大会以'AI赋能智能制造,构建协同发展新生态'为主题,聚焦工业大脑、智能安全标准化、自主化运营及无人场域建设等热点议题,产学研专家共献智造升级新思路。"
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 总体评价
|
||||||
|
|
||||||
|
**亮点**:
|
||||||
|
- 议题清单(工业大脑/智能安全标准化/自主化运营/无人场域)本身反映了 2026 年 AI+制造领域的产业关注点,有议程参考价值。
|
||||||
|
|
||||||
|
**不足**:
|
||||||
|
- 标题承诺的"核心观点"不可机读(图片承载);正文为通稿模板+导流信息+往期文章列表,信息密度极低。
|
||||||
|
|
||||||
|
**适用场景**:
|
||||||
|
- 仅作 2026 年 AI+制造议题风向参考;如需实质内容须观看会议视频或人工解读长图。
|
||||||
|
|
||||||
|
**关联建议**:
|
||||||
|
- 与同日归档的墨执子《2026制造业生死局》同主题对照,后者提供叙事框架、本篇提供议题清单;二者均需搭配实证材料使用。
|
||||||
@@ -0,0 +1,98 @@
|
|||||||
|
# 郑永年:真正的技术自主,是拥有定义技术路径的能力
|
||||||
|
|
||||||
|
> **来源**:微信公众平台(郑永年)
|
||||||
|
> **作者**:郑永年
|
||||||
|
> **发布日期**:2026-08-20(原文未标注明确日期,按下载日占位)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/sNcoweoLC_eHMUoVynpDiw
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
|
||||||
|
|
||||||
|
导语:7月,华为昇腾950超节点(Atlas 950 SuperPoD)在世界人工智能大会(WAIC)上公开亮相。作为目前业界规模最大的超节点,昇腾950超节点通过高速互联,将大量AI处理器组织成一个高度协同的计算系统,使成百上千张算力卡能够"像一台计算机一样工作"。从DeepSeek以稀疏架构降低训练和推理成本,到Kimi K3在超大参数规模下进一步提升计算效率,再到昇腾950以高速互联和系统集成提升整体算力,中国AI产业正形成一条系统协同的技术发展路径。**这种变化固然是外部技术约束下的现实选择,但也折射出中美科技竞争中技术路线的分化。**
|
||||||
|
|
||||||
|
近日,浙江大学传媒与国际文化学院常务副院长方兴东所著《昇腾崛起》由湛庐文化、浙江科学技术出版社出版。郑永年教授在为该书所作序言中,将昇腾置于国家能力、技术体系与全球结构重组的交汇处加以考察。在他看来,外部技术压力正在推动中国重新思考科技发展的组织方式。围绕昇腾展开的这场探索,也由此超出了一个企业、一款芯片或一种产品路线的范围,进一步触及中国科技如何在新的国际环境中形成持续性的系统能力。
|
||||||
|
|
||||||
|
## 本文作者
|
||||||
|
|
||||||
|
**郑永年 教授**
|
||||||
|
|
||||||
|
**华南理工大学公共政策研究院(IPP)学术委员会主席,香港中文大学(深圳)公共政策学院院长、前海国际事务研究院院长,广州粤港澳大湾区研究院理事长**
|
||||||
|
|
||||||
|
*下文为郑永年教授为《昇腾崛起》所作推荐序。
|
||||||
|
|
||||||
|
在今天讨论中国科技发展的语境中,人们往往容易陷入两种相反甚至极端的叙事陷阱:一种是技术乐观主义,认为只要投入足够的资源与人才,中国就必然会在某些关键领域实现全面突破;另一种则是技术悲观主义,将外部约束视为不可跨越的结构性障碍,从而低估制度韧性与组织能力的作用。
|
||||||
|
|
||||||
|
方兴东教授的大作《昇腾崛起》的意义恰恰在于跳出了这两种简单化叙事,而试图从国家能力、技术体系与全球结构重组的交叉点,重新理解中国科技在外部压力下的演化路径。
|
||||||
|
|
||||||
|
**《昇腾崛起》,浙江科技出版社,方兴东著**
|
||||||
|
|
||||||
|
## 算力即权力,算法即秩序
|
||||||
|
|
||||||
|
如果说过去30多年全球化的技术分工是建立在效率最大化与市场扩张逻辑之上的"开放体系",那么近年来,随着世界范围内地缘政治的崛起而围绕芯片、算力、操作系统与AI基础设施所展开的国家间的竞争,则标志着全球技术体系正在从"经济逻辑主导"转向"安全逻辑主导"。
|
||||||
|
|
||||||
|
在这一转变过程中,技术不再只是生产要素的优化工具,而逐渐演变为国家间结构性权力的一部分,甚至是主体部分。算力即权力,算法即秩序,平台即治理,类似的变化正在重塑国家之间的竞争规则。
|
||||||
|
|
||||||
|
> 上海人工智能大会上展出的华为 Atlas 950 SuperPoD 超节点模型。图源:Bloomberg
|
||||||
|
|
||||||
|
从这个意义上看,《昇腾崛起》所讨论的,并不仅仅是一家企业或一个技术路线的问题,而是中国如何在外部技术封锁与内部产业升级之间,构建一种新的"技术生存结构"。迄今看来,这种结构至少包含三个层面:
|
||||||
|
|
||||||
|
第一是基础硬件体系的自主可控能力;
|
||||||
|
|
||||||
|
第二是围绕开发者生态与应用场景的系统组织能力;
|
||||||
|
|
||||||
|
第三是将技术能力转化为产业标准与规则制定能力的制度能力。
|
||||||
|
|
||||||
|
缺乏其中任何一环,我们一直在强调的"自主创新"都可能停留在局部突破阶段,而无法形成体系优势。
|
||||||
|
|
||||||
|
值得注意的是,在全球技术体系高度集中化的今天,尤其是在图形处理器(GPU)、AI训练框架与云计算基础设施越来越被极少数企业高度垄断的背景下,后发国家所面临的挑战已经不再是单点技术突破,而是整个技术栈的结构性依附问题。这种依附不仅体现在硬件层面,还体现在软件生态、开发者习惯以及标准接口之中。因此,真正的技术自主,从来不是"有没有芯片"这么简单的问题,而是"是否拥有定义技术路径的能力"。
|
||||||
|
|
||||||
|
> 有分析指出AI竞争正在进入基础设施竞争阶段。芯片只是算力产业链的一环,决定AI规模化的还有数据中心、电力、电网、冷却系统、土地、光纤以及技术工人组成的完整基础设施体系。图为谷歌位于基利库拉的数据中心。
|
||||||
|
|
||||||
|
《昇腾崛起》一书所呈现的另一层重要意义,在于它反映了一种典型的中国式产业组织逻辑:**在国家战略引导与市场机制之间,通过平台化方式实现资源快速聚合与迭代优化。**这种模式既不同于完全市场化的硅谷路径,也不同于传统计划经济的集中配置,而是一种"嵌入式国家能力"的体现。在这一过程中,企业既是市场主体,也是国家技术体系的节点,这种双重身份构成了中国科技发展的独特张力和动能。
|
||||||
|
|
||||||
|
与此同时,我们也必须看到和清醒地意识到,这种高强度组织动员能力,在带来突破效率的同时,也对创新体系的长期多样性提出了挑战。一个高度目标导向的技术体系,往往擅长解决"已知问题",但在面对"未知问题"时,其探索能力是否足够开放、多元与容错,仍然是一个需要持续观察的问题。
|
||||||
|
|
||||||
|
从经验角度来看,任何目标导向和政府主导的研究,无论是基础科研还是应用技术,都往往是"追赶型"的。这是一种"别人有了,我也要"的追赶模式。而对"未知问题"的发现、定义和答案寻找大都发生在人们所说的一个"技术思想市场"之中,"多元、开放、容错"便是"技术思想市场"的主要特征。
|
||||||
|
|
||||||
|
因此,我们可以明确地说,中国科技体系未来的关键,不仅在于"能否突破",更在于"如何持续产生突破"。
|
||||||
|
|
||||||
|
## 技术竞争残酷性的另一面,就是制度创新的可能性
|
||||||
|
|
||||||
|
今天,从全球视角来看,技术体系的分化正在加速形成不同的"数字主权空间"。美国强调以企业创新为核心的技术扩散模式,欧洲强调以规则治理为核心的技术约束模式,而中国则更强调以系统能力与产业链完整性为基础的整体推进模式。
|
||||||
|
|
||||||
|
尽管这三种路径的形成并非因为简单的国家之间的竞争,而是在不同历史条件与制度结构下的不同演化结果,但是对各自的技术进步正在产生深刻和深层的影响。三种路径各自具有自身的比较优势和比较劣势,未来的发展取决于在多大程度上突破各自的"路径依赖",充分吸取其他路径的优势。可以预见,**未来的竞争能力并非仅仅是把各自的优势最大化,而是能否保持一种"多元、开放和包容"的技术生态。**
|
||||||
|
|
||||||
|
> 7月19日,参观者在华为展台观看展品昇腾950超节点。图源:新华社
|
||||||
|
|
||||||
|
在这种背景下,《昇腾崛起》所讨论的,实际上已经触及了更深层的问题:中国是否正在形成一种新的技术现代化路径?这种路径是否具有可持续性?这种路径能否在未来更复杂的国际环境中保持韧性?所有这些问题都无法通过单一技术指标来回答,而必须放在国家能力、产业体系与国际结构互动的框架中加以理解。
|
||||||
|
|
||||||
|
因此,**本书的价值,不在于提供某种技术乐观的结论,而在于提供一种理解中国科技崛起的分析框架:它既承认外部约束的现实性,也强调内部组织能力的关键性;既看到技术竞争的残酷性,也看到制度创新的可能性。**在这个意义上,它不仅是关于技术的讨论,更是关于国家如何在不确定的世界中重建确定性的讨论。
|
||||||
|
|
||||||
|
如果说未来10年全球竞争的核心变量之一是"算力结构",那么真正决定胜负的,可能并不是单一技术节点的领先,而是一个国家能否在长期博弈中持续组织技术、资本与制度三者之间的协同能力。《昇腾崛起》所揭示的,正是这种"系统性能力竞争"的现实起点。
|
||||||
|
|
||||||
|
## 新书信息
|
||||||
|
|
||||||
|
**书名:《昇腾崛起》**
|
||||||
|
|
||||||
|
**作者**:方兴东
|
||||||
|
|
||||||
|
**出版时间:**2026年7月
|
||||||
|
|
||||||
|
**出版社**:湛庐文化/浙江科学技术出版社
|
||||||
|
|
||||||
|
**ISBN**: 978-7-5739-2368-4
|
||||||
|
|
||||||
|
【内容简介】
|
||||||
|
|
||||||
|
读懂昇腾崛起,就读懂了中国**AI为什么能活下来,三条主线,带你走入中国科技"成人礼"的深度纪实。技术信仰线:工程理性胜过制裁叙事——华为用系统架构创新证明:工艺可以被封锁,架构无法被封锁;国家主权线:"算力主权就是AI时代的制海权"——昇腾不是华为一家的芯片,而是中国AI产业的底座;英雄故事线:从2017年温哥华密会到2025年除夕点亮3000张卡——一群工程师的8年孤勇。**
|
||||||
|
|
||||||
|
**关于华为昇腾全生态的全景叙事,还原中国AI算力底座发展本质。系统拆解中国AI芯片自主技术路线,还原真是工程与决策逻辑。赋能AI全产业链发展,提供ji限环境下的商业与技术范本。昇腾崛起,就是华为崛起,就是中国高科技崛起;昇腾全球化,就是华为再全球化,就是中国高科技真正全球化。昇腾具有中国乃至全球高科技发展史上符号性意义和标志性影响。**
|
||||||
|
|
||||||
|
【作者简介】
|
||||||
|
|
||||||
|
方兴东
|
||||||
|
|
||||||
|
浙江大学传媒与国际文化学院常务副院长,求是特聘教授、博士生导师。现任浙江大学临空智能媒体研究院院长、浙江大学网络空间国际治理研究基地主任,兼任民进中央出版和传媒委员会委员、民进浙江大学委员会副主委、浙江省第十三届政协委员。入选国家万人计划领军人才(2025年)、北京市宣传思想文化系统"四个一批"人才(2015年)、浙江省万人计划文科领军人才(2021年)。
|
||||||
|
|
||||||
|
三十载深耕,方兴东教授以跨学科跨文化视野聚焦数字时代人机互动。他跨越实践、理论与政策,融通创新与传播逻辑,剖析技术如何重塑社会与全球秩序,关切个体境遇与中国走向,系统探索"技术向善"的本土化路径。其对国际互联网史及关键人物的研究,赋予其学术体系新的视野——从先驱思想到制度变迁,从平台博弈到多元文明的技术演进,均在考察之列。核心方向涵盖互联网历史、智能传播、平台治理、国际传播与创新和科技政策。
|
||||||
@@ -0,0 +1,77 @@
|
|||||||
|
# 📊 文章摘要:郑永年:真正的技术自主,是拥有定义技术路径的能力
|
||||||
|
|
||||||
|
> **原文**:[2026-08-20_郑永年_真正的技术自主_是拥有定义技术路径的能力](./2026-08-20_郑永年_真正的技术自主_是拥有定义技术路径的能力.md)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/sNcoweoLC_eHMUoVynpDiw
|
||||||
|
> **来源**:微信公众平台
|
||||||
|
> **作者**:郑永年(发布公众号为 IPP评论,华南理工大学公共政策研究院官方平台)
|
||||||
|
> **发布日期**:2026-08-20
|
||||||
|
> **摘要日期**:2026-08-20
|
||||||
|
> **价值评级**:⭐⭐ 中
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 核心命题
|
||||||
|
|
||||||
|
> **路径定义权** — 技术自主的本质不是"有没有芯片",而是"是否拥有定义技术路径的能力";中国科技体系的关键不仅在"能否突破",更在"如何持续产生突破"。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 文章概要
|
||||||
|
|
||||||
|
本文是郑永年为方兴东新著《昇腾崛起》所作推荐序(经 IPP评论公众号发布),借华为昇腾950超节点亮相 WAIC 的契机,把昇腾置于国家能力、技术体系与全球结构重组的交汇处考察。文章主张跳出技术乐观主义与技术悲观主义两种叙事,提出"技术生存结构"三层框架(硬件自主、生态组织、标准规则制度能力),并引入"技术思想市场"概念警示高度目标导向体系擅长已知问题、未知问题探索能力存疑。其价值在于提供一个理解中国科技崛起的分析框架而非结论;局限是书序体裁决定了论证以判断性论述为主,缺乏数据支撑,且对昇腾技术细节本身着墨很少。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 关键要点
|
||||||
|
|
||||||
|
1. **技术自主=定义技术路径的能力** — 后发国家的挑战已不是单点突破而是整个技术栈的结构性依附(硬件、软件生态、开发者习惯、标准接口)。 `[分类: 范式突破]`
|
||||||
|
2. **全球技术体系从经济逻辑转向安全逻辑** — 算力即权力、算法即秩序、平台即治理,技术成为国家间结构性权力的主体部分。 `[分类: 共识]`
|
||||||
|
3. **技术生存结构三层论** — 基础硬件自主可控、开发者生态与应用场景组织、技术能力转化为标准与规则制定的制度能力,缺一环则自主创新停留局部突破。 `[分类: 共识]`
|
||||||
|
4. **嵌入式国家能力** — 在国家战略引导与市场机制之间以平台化方式聚合资源迭代,既非硅谷路径也非计划经济;企业兼具市场主体与国家技术体系节点双重身份。 `[分类: 争议]`
|
||||||
|
5. **技术思想市场** — 政府主导研究多为追赶型("别人有了,我也要"),未知问题的发现与定义发生在需要"多元、开放、容错"的技术思想市场中;高强度动员对创新长期多样性构成挑战。 `[分类: 争议]`
|
||||||
|
6. **三种数字主权路径** — 美国(企业创新扩散)、欧洲(规则治理约束)、中国(系统能力与产业链完整),各有路径依赖,未来竞争力取决于能否保持多元开放包容的技术生态。 `[分类: 共识]`
|
||||||
|
7. **系统性能力竞争** — 未来10年核心变量是"算力结构",胜负不在单一技术节点领先,而在技术、资本、制度三者长期协同的组织能力。 `[分类: 共识]`
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 批判性分析
|
||||||
|
|
||||||
|
### 假设前提
|
||||||
|
- 预设"安全逻辑主导"是技术体系的长期而非阶段性特征。
|
||||||
|
- "三种路径"的划分(美/欧/中)是理想类型化处理,忽略各国内部的多样性与路径间的相互渗透。
|
||||||
|
- 书序体裁隐含为《昇腾崛起》定位背书的立场,存在天然的推介倾向。
|
||||||
|
|
||||||
|
### 论据与逻辑
|
||||||
|
- 论据以昇腾950、WAIC、DeepSeek、Kimi K3 等事件为锚点,但均止于提及,未展开技术或产业数据论证。
|
||||||
|
- 核心论证方式是概念框架推演(技术生存结构、嵌入式国家能力、技术思想市场),逻辑自洽但属规范分析而非实证研究。
|
||||||
|
- 亮点是自我设限意识:明确指出高强度动员模式的短板并"持续观察",避免了单向度赞颂。
|
||||||
|
|
||||||
|
### 边界与局限
|
||||||
|
- 对昇腾的实际技术水准、生态成熟度、产能约束等关键事实未做评估,"昇腾崛起"的判断主要转由所序之书承担。
|
||||||
|
- "技术思想市场"如何在中国体制内落地,作者未给出机制性设想。
|
||||||
|
- 文末新书信息与内容简介部分带有明显出版营销色彩("昇腾崛起就是华为崛起,就是中国高科技崛起"等表述与正文审慎立场强度不一致),阅读时应与序言正文区分。
|
||||||
|
- 摘要者推断:本文适合作为战略分析框架的输入,而非事实依据。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 可引用金句
|
||||||
|
|
||||||
|
> "真正的技术自主,从来不是'有没有芯片'这么简单的问题,而是'是否拥有定义技术路径的能力'。"
|
||||||
|
|
||||||
|
> "中国科技体系未来的关键,不仅在于'能否突破',更在于'如何持续产生突破'。"
|
||||||
|
|
||||||
|
> "算力即权力,算法即秩序,平台即治理。"
|
||||||
|
|
||||||
|
> "未来的竞争能力并非仅仅是把各自的优势最大化,而是能否保持一种'多元、开放和包容'的技术生态。"
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 总体评价
|
||||||
|
|
||||||
|
**亮点**:以"路径定义权"重新界定技术自主,比"自主可控"话语更具分析力;主动跳出乐观/悲观二元叙事,对动员型体制的未知问题探索能力提出清醒警示;三层结构与三种路径框架可直接复用于科技战略分析。
|
||||||
|
|
||||||
|
**不足**:判断多、论证少,全篇无量化支撑;作为书序对昇腾本身几乎无技术评估;文末营销性内容简介与正文理性立场存在风格落差。
|
||||||
|
|
||||||
|
**适用场景**:科技政策与产业战略研讨的框架输入;理解智库视角下中美科技竞争的叙事结构;为算力自主、开源生态等议题提供"制度能力"维度的思考角度。
|
||||||
|
|
||||||
|
**关联建议**:与本院《Storage Agent Family》等算力基础设施文章互补(工程视角 vs 制度视角);"技术思想市场"概念可与开源生态、AI 人才流动等议题交叉讨论;建议延伸阅读其所序《昇腾崛起》原书以获取实证细节。
|
||||||
@@ -0,0 +1,228 @@
|
|||||||
|
# 对 GLM-5.3 的真实评价。
|
||||||
|
|
||||||
|
> **来源**:微信公众平台(阿颖)
|
||||||
|
> **作者**:阿颖
|
||||||
|
> **发布日期**:2026-08-20(原文未标注明确日期,按下载日占位)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/SpXEbbzv9jZ2xrZd7lcM7w
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
时隔两个月,GLM-5.3 来了。
|
||||||
|
|
||||||
|
从今天大家的反馈来看,效果确实非常不错。**我感觉智谱这一年,应该是找到了一条非常清楚的路径来继续优化模型能力。**
|
||||||
|
|
||||||
|
而且这次出乎所有人的意料。按照智谱 Release Blog 的说法,GLM-5.3 相比 GLM-5.2,基座模型没有变,模型参数也没有继续增加,但能力仍然有不小的提升。
|
||||||
|
|
||||||
|
这些提升,全部来自后训练。
|
||||||
|
|
||||||
|
|
||||||
|
|
||||||
|
**智谱这家公司真的非常神。**从学术起家,创始人也是国内大模型圈里最学术的,感觉所有对大模型技术路线感兴趣的同学,都值得认真看他们的 Model Card。
|
||||||
|
|
||||||
|
**#01**
|
||||||
|
|
||||||
|
**预训练和后训练**
|
||||||
|
|
||||||
|
这两年,其实所有大模型公司主要都在两个地方下功夫。一个是继续做 Pre-training Scaling,另一个就是越来越重要的 Post-training Scaling。
|
||||||
|
|
||||||
|
两边大家其实都在做,只是不同公司、不同阶段的侧重点不一样。
|
||||||
|
|
||||||
|
先说 Pre-training Scaling。
|
||||||
|
|
||||||
|
这条路我们其实非常熟悉,一个最直观的表现,就是模型还在越做越大。**比如 Kimi K3,直接把总参数做到了 2.8T。**字节的模型据说也要奔着 10 万亿去。
|
||||||
|
|
||||||
|
模型参数大概已经成了每次大模型发布时,大家最喜欢问的问题之一。
|
||||||
|
|
||||||
|
但其实参数量从来都不是一个可以单独看的数字。至少还要一起看几件事:你有多少训练数据、多少算力,以及这个模型最后要在什么样的条件下运行。
|
||||||
|
|
||||||
|
2020 年,OpenAI 的 Jared Kaplan 等人发表了一篇后来影响非常大的论文《Scaling Laws for Neural Language Models》。
|
||||||
|
|
||||||
|
很多人今天讨论大模型的 Scaling Law,都会追溯到这篇论文。
|
||||||
|
|
||||||
|
它当时给行业一个很强的信号:随着算力增加,模型规模还可以继续往上做,而且参数量可以比训练数据增长得更快。
|
||||||
|
|
||||||
|
整个行业很快就沿着这个方向往前走。
|
||||||
|
|
||||||
|
于是有了 GPT-3 的 175B、Gopher 的 280B,以及后来的 MT-NLG 530B。那几年大家最直观的感受就是,模型越大,能力通常也越强。
|
||||||
|
|
||||||
|
到了 2022 年,DeepMind 又重新研究了一遍这个问题。
|
||||||
|
|
||||||
|
**他们训练了四百多个不同规模的模型,最后发现,之前大家其实有点过于追求参数量了。**
|
||||||
|
|
||||||
|
在同样的算力预算下,与其把参数一味做大,不如把更多算力拿出来,让模型看更多数据。
|
||||||
|
|
||||||
|
他们最后给出了一个很有名的经验值:大约每一个参数,配 20 个 Token 的训练数据。并且应当以相同的速率增长,也就是说这个配比不随规模漂移。
|
||||||
|
|
||||||
|
随后 DeepMind 训练出了 Chinchilla。它只有 70B 参数,远小于 280B 的 Gopher,但用了 1.4T Token 来训练。
|
||||||
|
|
||||||
|
**结果在差不多的训练算力下,Chinchilla 不仅超过了 Gopher,也超过了当时很多参数规模大得多的模型。**
|
||||||
|
|
||||||
|
这件事当时给行业一个很大的启发:
|
||||||
|
|
||||||
|
模型参数、数据和算力之间需要找到更合适的配比。**一个参数少一些、但训练得更充分的模型,完全可能超过一个大得多的模型。**
|
||||||
|
|
||||||
|
所以今天我们看到大家继续做 Pre-training Scaling,也不能简单理解成继续堆参数。真正要 Scale 的,其实一直都是参数、数据和算力这一整套东西。
|
||||||
|
|
||||||
|
与此同时,Post-training Scaling 也已经变得无比重要。
|
||||||
|
|
||||||
|
我再稍微解释一下。
|
||||||
|
|
||||||
|
**预训练其实就是先给模型打一个足够好的底子,后训练则是通过 RL、环境和真实任务,把这个底子不断变成更强的能力。**
|
||||||
|
|
||||||
|
像 GPT-3 时代,预训练几乎承担了模型能力提升的大部分工作。后训练更多是在做最后一层调整,比如让模型学会聊天、遵循指令。
|
||||||
|
|
||||||
|
所以当时大家基本会认为,一个模型到底有多强,在 Base Model 训练完成的时候,大概已经决定了。这也是最早“大力出奇迹”的由来。
|
||||||
|
|
||||||
|
后来到了 O1 这一代,大家发现 RL 不只是负责把模型调整得更好用,它本身也能够继续提升模型能力。
|
||||||
|
|
||||||
|
数学推理、Coding,包括 Agent 连续完成复杂任务的能力,都可以通过大规模 RL 继续往上训练。
|
||||||
|
|
||||||
|
智谱的 GLM-5.3 这次,没有增加参数,也没有换基座,只靠后训练,仍然把模型能力往上推了一截。
|
||||||
|
|
||||||
|
所以我推测,他们在后训练这部分,应该确实找到了一些切实有效的方法。
|
||||||
|
|
||||||
|
**#02**
|
||||||
|
|
||||||
|
**Post-training Scaling**
|
||||||
|
|
||||||
|
Post-training Scaling 到底怎么做?**很简单,Scale Environment,Scale Experience。**
|
||||||
|
|
||||||
|
我们可以把 Post-training 的发展分成几个阶段。
|
||||||
|
|
||||||
|
最早就是我们熟悉的单轮 Q&A。模型回答一道数学题,然后告诉它对还是错,然后 RL 更新权重。
|
||||||
|
|
||||||
|
**后来大家发现,单纯做 Q&A 太简单了,很多更复杂的能力根本练不出来,于是就开始把模型放进模拟环境里训练。**
|
||||||
|
|
||||||
|
比如 Coding。以前可能只是给模型一道编程题,现在会真的给它一个代码库,允许它调用 Terminal、修改代码、运行测试。
|
||||||
|
|
||||||
|
模型可能先看代码,发现问题之后修改,跑一遍测试失败了,再回来重新分析,然后继续修改。
|
||||||
|
|
||||||
|
整个过程可能连续几十步甚至几百步,最后再根据任务到底有没有完成,给它一个 Reward。
|
||||||
|
|
||||||
|
这时候,模型就开始学习怎么使用工具,以及怎么在很长的任务里保持目标等等。
|
||||||
|
|
||||||
|
**过去这一年,模型在长程任务上的快速提升,很大程度上都和这些后训练方法有关。**
|
||||||
|
|
||||||
|
同时,大家也意识到,如果想让模型获得更高阶的能力,就需要同时提高环境的复杂度。
|
||||||
|
|
||||||
|
**如果大家去看智谱今天的公众号,会发现他们专门提到了这事。**
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
所以 Post-training Scaling 和 Pre-training Scaling,Scale 的东西开始不太一样。
|
||||||
|
|
||||||
|
预训练的 Scale,主要增加模型规模、训练数据和计算量。**后训练往上 Scale,则是让模型面对越来越复杂的任务、更真实的环境,以及越来越长的任务过程。**
|
||||||
|
|
||||||
|
**有点像读万卷书和行万里路的区别。**
|
||||||
|
|
||||||
|
话说我还是强烈推荐大家读一下智谱官方的 Blog。前面讲的这些线索,他们都已经点到了。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
**像我圈红框的地方,IndexShare、SAO、Slime 都有对应的论文或者 GitHub 地址可以研究。**我放下链接,感兴趣的同学可以看看,我都想组个读智谱论文的活动了.......
|
||||||
|
|
||||||
|
https://arxiv.org/abs/2603.12201
|
||||||
|
|
||||||
|
https://arxiv.org/abs/2607.07508
|
||||||
|
|
||||||
|
https://github.com/THUDM/slime/blob/main/README_zh.md
|
||||||
|
|
||||||
|
**而且你看红框最后一句,他们说,可能还远未开发出这个基座的智能上界。**这话太给人想象空间了。
|
||||||
|
|
||||||
|
毕竟 GLM-5 系列在开发者内心的封神程度,已经超过大家对这个尺寸模型的预期上限了。
|
||||||
|
|
||||||
|
这次官方 Blog 的第二点,专门把网络安全能力拎了出来,他们专门用了很大的篇幅解释网络安全。
|
||||||
|
|
||||||
|
我的理解是,GLM 前面一直在重点 Scale Coding 和 Agent 的长程任务。
|
||||||
|
|
||||||
|
**但随着训练环境越来越复杂,模型原来在 Coding 里练出来的能力,也开始迁移到更专业的领域,网络安全就是其中一个。**后面可能还会解锁能多的领域。
|
||||||
|
|
||||||
|
从逻辑上,我觉得这也能理解。毕竟安全工作本身就和 Coding 高度相关。再加上智谱专门的安全环境训练,这个能力就被迅速放大了。
|
||||||
|
|
||||||
|
再看看今年以来的变化。**进入 2026,据传几个 Frontier Labs 包括 OpenAI 和 Anthropic 几乎都在模型中用到了 Loop Transformer。**
|
||||||
|
|
||||||
|
Loop Transformer 的核心,是让 Scaling Law 的衡量目标从单纯扩大总参数量,转向推理链路长度(一次 forward 中实际经过了多少有效计算)。
|
||||||
|
|
||||||
|
本质上,这是预训练中的后训练带来的收益。
|
||||||
|
|
||||||
|
**#03**
|
||||||
|
|
||||||
|
**我跑的几个 Case**
|
||||||
|
|
||||||
|
最后给大家看看我用 GLM-5.3 做的一些 Case。
|
||||||
|
|
||||||
|
这个是我一位 00 后同事做的。小哥花了一个多小时,就跑出了完全可用的象棋应用。还挺酷炫的。有同学需要的话,我可以私发。
|
||||||
|
|
||||||
|
我用 GLM-5.3 给团队做了一个排版小工具。
|
||||||
|
|
||||||
|
这个想法其实周一就有了,因为我同事每次排公众号都特别慢,我觉得 10 分钟能搞定的事,他经常要花半个小时,主要时间都耗在段落调整、加粗这些细节上。
|
||||||
|
|
||||||
|
**所以今天我干脆说,直接做个工具吧。**以后这些段落、加粗之类的排版工作都交给 AI,5 分钟基本就能搞定。
|
||||||
|
|
||||||
|
大家看,左侧直接从飞书文档把文章复制进去,右侧加粗和段落都会调整好。我直接点复制到公众号的按钮,再粘贴到公众号的文章页就行了。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
图片也可以直接过去。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
前面两个 Case 都偏工具,我们再看一个复杂的,直接看我们线上跑的生产系统。
|
||||||
|
|
||||||
|
这两天我发现,下个月准备上线的购票订单功能总有一些 Bug。
|
||||||
|
|
||||||
|
**平时测试看着没问题,但一到并发高一点的时候,就会偶尔出现重复订单、漏单,或者订单状态对不上的情况。**
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
之前的代码我其实是用 Codex 写的。这个问题,Codex 也没有解决,我这边已经没有什么思路了。
|
||||||
|
|
||||||
|
大家看 GLM 5.3 的排查逻辑。先是把整个链路的代码都过了一遍,跑了下测试,发现没问题。**我看的时候就心想,小样,这个级别的小问题,肯定不会卡我这么久啊。**
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
接着继续,他通过端到端的模拟,跑了一次链路。发现了问题。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
这是最后的结论:
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
以及还顺带发现了一些连带的 Bug。其实这部分已经是安全层面的问题了。**强烈建议大家可以让 GLM 5.3 扫一下自己现有产品的安全类 Bug。**绝对会有惊喜。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
这是最终的修复结果。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
**#04**
|
||||||
|
|
||||||
|
**写在最后**
|
||||||
|
|
||||||
|
我发现很多创业公司发模型的时候,都喜欢在 Blog 最前面放一句话。
|
||||||
|
|
||||||
|
这种话通常不会太长,但它多少代表了模型团队最近一段时间的真实心境。
|
||||||
|
|
||||||
|
**智谱这次写的是:**
|
||||||
|
|
||||||
|
**单弦不成音,独木不成林。**
|
||||||
|
|
||||||
|
**官方没有解释,我自己的理解是,这句话至少有两层意思。**
|
||||||
|
|
||||||
|
第一层,是现在国内外模型之间这种你追我赶的状态。
|
||||||
|
|
||||||
|
尤其国内这半年特别明显。DeepSeek、Kimi、Qwen、GLM、豆包,大家的节奏都非常之快。
|
||||||
|
|
||||||
|
我特别喜欢这种状态。**虽然大家在竞争,但这种竞争最后会逼着所有人一起往前走。**一个模型做出了新东西,其他团队很快就会跟进。
|
||||||
|
|
||||||
|
如果整个市场最后只剩下一家公司,这件事反而没什么意思了。就像我们觉得,如果整个模型行业只有 OpenAI 和 Anthropic 的话,那对于应用层公司可能也是灾难。
|
||||||
|
|
||||||
|
第二层,大概是说合作和生态。尤其这次智谱重点强调的网络安全,背后就不是一个模型团队自己能完成的。
|
||||||
|
|
||||||
|
**整篇 Blog 里提到了清华、南开,也有绿盟、赛博昆仑、DARKNAVY、腾讯玄武这些安全团队。**安全已经是一个垂直领域了,它需要专门的 Know How。
|
||||||
|
|
||||||
|
还有更深入的芯片、人才、开源社区,其实也是一样。
|
||||||
|
|
||||||
|
**单弦不成音,独木不成林。**说的真好。希望国模越来越好。
|
||||||
@@ -0,0 +1,81 @@
|
|||||||
|
# 📊 文章摘要:对 GLM-5.3 的真实评价。
|
||||||
|
|
||||||
|
> **原文**:[2026-08-20_对_GLM-5.3_的真实评价](./2026-08-20_对_GLM-5.3_的真实评价.md)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/SpXEbbzv9jZ2xrZd7lcM7w
|
||||||
|
> **来源**:微信公众平台
|
||||||
|
> **作者**:阿颖
|
||||||
|
> **发布日期**:2026-08-20
|
||||||
|
> **摘要日期**:2026-08-20
|
||||||
|
> **价值评级**:⭐⭐⭐ 高
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 核心命题
|
||||||
|
|
||||||
|
> **后训练扩展** — 不加参数、不换基座,靠规模化环境与经验(Scale Environment, Scale Experience)的后训练即可显著提升模型能力。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 文章概要
|
||||||
|
|
||||||
|
GLM-5.3 发布当日的评测文。作者抓住官方 Release Blog 最反直觉的信息:GLM-5.3 相比 GLM-5.2 基座没变、参数没增,全部提升来自后训练。为解释这一点,文章回溯 Scaling Law 史——从 Kaplan 2020(参数可比数据涨更快)到 DeepMind 2022 训练四百多个模型得出的 Chinchilla 配比(约每参数 20 Token、同速率增长)——说明"堆参数"从来不是孤立变量;再拆解 Post-training Scaling 的方法论:从单轮 Q&A 进化到把模型放进真实环境(代码库、终端、测试)做几十至几百步的长程任务,按任务完成与否给 Reward。作者据智谱 Blog 推断其在后训练上找到了切实方法,并观察到 Coding 能力经安全环境训练迁移到网络安全领域。文末给出三个一手案例(一小时象棋应用、排版小工具、修复 Codex 未解决的生产系统并发下单 Bug)与"单弦不成音,独木不成林"的双层解读(竞争推动全行业 + 垂直领域需要生态合作)。局限:判断建立在官方口径与个人少量案例上,无基准测试数据,Loop Transformer 等关键说法仅"据传"。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 关键要点
|
||||||
|
|
||||||
|
1. **GLM-5.3 的发布口径** — 基座模型没有变、参数没有增加,能力提升全部来自后训练(作者转述官方 Blog)`[分类: 共识]`
|
||||||
|
2. **参数量不能单独看** — Chinchilla 证明约每参数配 20 个 Token、两者同速率增长;参数少但训练充分的模型可超过大得多的模型 `[分类: 共识]`
|
||||||
|
3. **后训练 Scaling 的方法论一句话** — "Scale Environment, Scale Experience":新的 Scale 对象是更复杂的任务、更真实的环境、更长的任务过程 `[分类: 范式突破]`
|
||||||
|
4. **预训练/后训练分工** — 预训练打底子,后训练通过 RL、环境和真实任务把底子变成能力;"有点像读万卷书和行万里路的区别" `[分类: 共识]`
|
||||||
|
5. **长程任务提升的环境解释** — 模型放进模拟环境(代码库+终端+测试)训练,连续几十上百步后按任务完成度给 Reward;过去一年长程任务的快速提升很大程度上源于此 `[分类: 共识]`
|
||||||
|
6. **能力迁移假说** — Coding/Agent 长程能力随训练环境复杂化迁移到网络安全等更专业领域(作者明示"我的理解是""我推测")`[分类: 争议]`
|
||||||
|
7. **Loop Transformer 传闻** — 据传 OpenAI、Anthropic 等已采用,把 Scaling 衡量目标从总参数量转向推理链路长度(一次 forward 中的有效计算)`[分类: 未探索]`
|
||||||
|
8. **生产级排查案例** — 购票订单并发 Bug(Codex 未解决):GLM-5.3 先过全链路代码+测试无果,再通过端到端模拟复现定位根因,并顺带发现安全类连带 Bug(单例证据,作者强烈建议用它扫描现有产品安全 Bug)`[分类: 共识]`
|
||||||
|
9. **"单弦不成音,独木不成林"双层解读** — 竞争逼所有人一起往前走;安全等垂直领域需要专门 Know-How 与外部团队合作(Blog 提及清华、南开、绿盟、赛博昆仑、DARKNAVY、腾讯玄武)`[分类: 争议]`
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 批判性分析
|
||||||
|
|
||||||
|
### 假设前提
|
||||||
|
- 把官方 Blog 的说法(基座未变、参数未增、提升全部来自后训练)直接采信为事实,无独立验证渠道。
|
||||||
|
- "效果确实非常不错"基于发布日社区反馈氛围与作者个人体验,存在新发布 honeymoon 效应。
|
||||||
|
- 从 Blog 倒推"智谱找到了切实有效的后训练方法"是作者的推测(其本人已标注"我推测")。
|
||||||
|
|
||||||
|
### 论据与逻辑
|
||||||
|
- 主线(Scaling Law 史→后训练方法论→一手案例)清晰,附 2 篇 arXiv 论文与 1 个 GitHub 链接(IndexShare、SAO、Slime)可供核查,在评测文中证据意识较好。
|
||||||
|
- 但案例 n=3 且均为作者团队主观体验,无基准测试、无失败案例、无对照组(对 Codex 的对比仅一处且为单例);"据传 OpenAI 和 Anthropic 几乎都用 Loop Transformer"无任何出处,属传闻级论据。
|
||||||
|
- 标题为"真实评价"但通篇无负面发现,正面倾向明显。
|
||||||
|
|
||||||
|
### 边界与局限
|
||||||
|
- 边界意识尚可:作者多处显式区分官方信息与个人理解("我的理解是""我推测""据传"),未把推断包装成事实。
|
||||||
|
- 未讨论后训练 Scaling 的代价(环境构建成本、RL 算力开销)与天花板;也未涉及 GLM-5.3 的短板或适用边界,评价维度单一。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 可引用金句
|
||||||
|
|
||||||
|
> "Post-training Scaling 到底怎么做?很简单,Scale Environment,Scale Experience。"
|
||||||
|
|
||||||
|
> "预训练其实就是先给模型打一个足够好的底子,后训练则是通过 RL、环境和真实任务,把这个底子不断变成更强的能力。"
|
||||||
|
|
||||||
|
> "一个参数少一些、但训练得更充分的模型,完全可能超过一个大得多的模型。"
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 总体评价
|
||||||
|
|
||||||
|
**亮点**:
|
||||||
|
- 把一次模型发布放进 Scaling Law 技术史中解释,框架清楚;"环境规模化"视角对 Agent 训练环境设计直接可用。
|
||||||
|
- 附论文/代码链接可深究(IndexShare、SAO、Slime),一手生产案例有细节。
|
||||||
|
|
||||||
|
**不足**:
|
||||||
|
- 无基准数据、无反面对照,与"真实评价"的标题不符;Loop Transformer 传闻无出处;情绪上偏乐观。
|
||||||
|
|
||||||
|
**适用场景**:
|
||||||
|
- 大模型技术路线跟踪、Agent 训练环境与任务设计参考、国产模型选型的定性输入。
|
||||||
|
|
||||||
|
**关联建议**:
|
||||||
|
- 与同日归档的专知防务《未来战场已然来临》对照阅读:一端是长程自主能力的来源(训练环境),一端是自主系统投放后的治理(人类控制设计)。
|
||||||
|
- IndexShare/SAO/Slime 论文与 slime 仓库可作为后续深读与实验对象。
|
||||||
@@ -0,0 +1,379 @@
|
|||||||
|
# 企业内Agent工具落地实践:统一Harness、Skill与虚拟文件系统
|
||||||
|
|
||||||
|
> **来源**:微信公众平台(随机比特)
|
||||||
|
> **作者**:随机比特
|
||||||
|
> **发布日期**:2026-08-20(原文未标注明确日期,按下载日占位)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/D4RId9oiULoFj567vawPig
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
这是一篇关于企业 Agent 落地的笔记:结合行业案例和自己的实践。我知道在 AI 时代写长文是逆潮流的——注意力越来越短。写完后我反复权衡过要不要让 AI 删减,最终没舍得删任何一段。希望对你有启发。
|
||||||
|
|
||||||
|
企业 Agent 从演示走向生产,最难的问题通常不再是模型能不能调用工具,而是三个更基础的问题:一次任务可以访问什么,分散在各团队的业务经验如何进入 Agent,以及跨越几十甚至几百步的工作状态应该保存在哪里。
|
||||||
|
|
||||||
|
如果这三个问题没有统一答案,接入再多模型和 MCP 工具,也只会得到一个能力强但不可治理的聊天机器人。本文讨论一种更接近生产系统的架构:以统一 harness 承载执行和安全,以 skill 分发领域能力,以虚拟文件系统管理长任务的上下文、证据和最终产物。
|
||||||
|
|
||||||
|
## 01
|
||||||
|
|
||||||
|
企业 Agent 的分水岭不是模型,而是运行时
|
||||||
|
|
||||||
|
一个 Agent 原型通常只有四个部件:模型、system prompt、若干工具,以及一个不断把工具结果交还给模型的循环。它足以演示"查数据后生成报告",却没有回答生产系统必须回答的问题:进程中断后能不能恢复;长任务怎样避免撑爆上下文;两个有权限的数据域能否在同一会话中混用;模型生成的代码在哪里运行;领域提示词由谁维护;一次失败究竟是模型、工具、skill 还是数据造成的。
|
||||||
|
|
||||||
|
这些问题共同指向 **Agent harness**。本文所说的 harness,不是某个模型 SDK 的薄封装,而是包围模型的完整运行时:它编排模型与工具调用,管理会话状态和检查点,控制工具暴露与人工审批,装载 skills,提供文件和代码执行环境,并输出可用于调试和评测的 trace。
|
||||||
|
|
||||||
|
这一区分很重要。模型决定一次推理的上限,harness 决定这份能力能否稳定、可控地进入企业流程。更换模型可能提高回答质量,却不会自动产生权限隔离、失败恢复、资产治理和交付证据。
|
||||||
|
|
||||||
|
### 两种常见但不可持续的落地方式
|
||||||
|
|
||||||
|
第一种是"一个场景一个 Agent"。销售准备、财务分析、故障巡检各自复制一份 prompt,再连接各自的工具。它的初期交付速度很快,但重复的基础逻辑会逐渐分叉:每个 Agent 有不同的重试、权限、审计和输出约定,领域团队也很难判断应该修改 prompt、工具还是模型。
|
||||||
|
|
||||||
|
第二种是"直接把 coding agent 发给所有人"。Coding agent 的文件、终端和代码执行能力很强,但它默认面对的是工程工作区。知识工作者需要的却是业务对象、受控数据和可分享的报告,而不是任意 shell。把强执行能力原样暴露出去,会把安全风险和支持成本一起转嫁给用户。
|
||||||
|
|
||||||
|
Stripe 在建设 Knowledge AI Platform(Kai)之前也经历过类似阶段:其 NoCode Agent Builder 曾产生超过 4,000 个工作流 Agent,随后出现相似提示词重复、质量不一以及难以统一维护的问题。Kai 最终选择共享运行平台、由领域团队贡献 skills 的方向,而不是继续扩张微型 Agent 数量。Stripe 的官方复盘(https://stripe.dev/blog/meet-stripes-knowledge-ai-platform)说明,这不是单纯的检索优化,而是产品和运行时边界的重构。
|
||||||
|
|
||||||
|
## 02
|
||||||
|
|
||||||
|
总体架构:稳定内核与可变领域能力分离
|
||||||
|
|
||||||
|
一个可扩展的企业 Agent 平台可以拆成四层:
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
最上层是用户已经工作的入口。Web 聊天只是其中一种,Agent 还可能嵌入企业 IM、数据平台、工单系统或浏览器扩展。入口应调用同一套 surface-agnostic API,而不是各自复制 Agent 逻辑。
|
||||||
|
|
||||||
|
控制面管理的是变化较快、需要领域所有权的资产:skill、Agent 配置、默认工具集、评测集、版本和质量信号。企业 harness 则承接统一身份、会话范围、权限、审计和基础设施适配。最底层的通用 runtime 负责模型调用、middleware、流式事件、checkpoint 和恢复。
|
||||||
|
|
||||||
|
这种分层的原则是:**通用 Agent 问题只解决一次,企业特有问题留在企业层,领域知识交给最了解它的人维护。** Stripe 在 Kai 中使用 Deep Agents/LangGraph 处理通用运行时,再叠加 Stripe 自身的安全和内部服务;Deep Agents 官方也将自己定位为带文件系统、summarization、subagent、持久化和 HITL 的 opinionated harness,而不是业务应用本身。Deep Agents 项目说明(https://github.com/langchain-ai/deepagents)
|
||||||
|
|
||||||
|
### Harness 应该拥有的最小职责
|
||||||
|
|
||||||
|
一个生产级 harness 至少需要提供以下能力:
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
这些职责属于稳定内核。业务团队不应该为了增加一个"发布周报"skill,就重新实现 checkpoint 或 sandbox;平台团队也不应该为了修改财务分析口径,成为领域 prompt 的审批瓶颈。
|
||||||
|
|
||||||
|
## 03
|
||||||
|
|
||||||
|
Skill:把领域经验变成可治理的软件资产
|
||||||
|
|
||||||
|
工具解决"能做什么",skill 解决"在什么场景下,应该按什么流程、使用哪些工具、以什么标准完成"。一个查询流水线日志的 API 是工具;"先定位失败阶段,再下载相关日志,区分代码失败与基础设施失败,最后用固定证据格式回填工单"才是 skill。
|
||||||
|
|
||||||
|
这个差异使 skill 成为企业能力分发的合适边界。它既不像 system prompt 那样全局而不可拆分,也不像工具描述那样只能说明输入输出。一个完整 skill 可以包含:
|
||||||
|
|
||||||
|
- 用于发现和路由的元数据;
|
||||||
|
- 模型执行的步骤、判断标准与失败分支;
|
||||||
|
- 对工具、数据和运行环境的依赖声明;
|
||||||
|
- 可复用的脚本、参考资料和产物模板;
|
||||||
|
- 正例、近邻负例和结果评测;
|
||||||
|
- owner、版本、风险等级和变更记录。
|
||||||
|
|
||||||
|
**3.1 Progressive disclosure 只解决一半问题**
|
||||||
|
|
||||||
|
Deep Agents 采用三层渐进加载:启动时只把每个 skill 的 `name` 与 `description` 放进上下文;模型判断相关后再读取完整 `SKILL.md`;scripts、references 和 assets 最后按需加载。官方 Skills 文档(https://docs.langchain.com/oss/python/deepagents/skills)将其称为 progressive disclosure。
|
||||||
|
|
||||||
|
```
|
||||||
|
Level 1: name + description 所有候选技能,负责发现
|
||||||
|
Level 2: SKILL.md 命中后读取,负责执行策略
|
||||||
|
Level 3: scripts/references/... 用到时读取,负责确定性能力与详细知识
|
||||||
|
```
|
||||||
|
|
||||||
|
它避免了把所有领域说明一次性塞入 system prompt,但没有消除目录选择问题。几十个描述相近的 skill 同时出现时,模型仍可能误选或犹豫。LangChain 对 Kai 的案例披露,当系统 prompt 叠加到约 150 个技能时,frontier model 的选择质量已出现下降;Kai 因而开始从纯 LLM 选择转向"检索或分类器预筛,再由 LLM 最终判断"。Kai 技术案例(https://www.langchain.com/blog/how-stripe-built-their-knowledge-ai-platform-on-deep-agents)
|
||||||
|
|
||||||
|
因此,大规模 skill 目录需要两个阶段:
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
第一阶段追求召回率,把几百项缩小为十几项;第二阶段利用 LLM 对当前会话的理解做精确选择。真正执行时,harness 才注册被选 skill 允许的工具。这样做同时降低上下文成本和攻击面:无关工具不只是"不建议调用",而是根本不出现在当前模型请求里。
|
||||||
|
|
||||||
|
**3.2 联邦所有权,而不是中心团队代写所有 Skill**
|
||||||
|
|
||||||
|
企业知识通常分散在财务、法务、销售、研发和运维团队。平台团队可以定义 skill 规范和运行时,却不可能长期维护每个领域的判断标准。合理模式是联邦治理:
|
||||||
|
|
||||||
|
- 平台团队维护 schema、lint、发布、权限编译、评测和观测能力;
|
||||||
|
- 领域团队拥有 skill 内容、参考资料和业务验收标准;
|
||||||
|
- 安全团队维护强制政策和风险模板;
|
||||||
|
- 用户或项目可以在受控范围内叠加本地 skill;
|
||||||
|
- 同名覆盖遵守明确的 base → team → project → user 优先级。
|
||||||
|
|
||||||
|
Kai 采用了类似分层:基础技能固定存在,职能默认技能按用户画像装载,个人再增加自己的技能。这里真正可复制的不是 Stripe 的组织结构,而是"平台不垄断知识,领域团队也不能绕开平台约束"。
|
||||||
|
|
||||||
|
**3.3 Skill Control Plane 的最小数据模型**
|
||||||
|
|
||||||
|
只把 `SKILL.md` 放进 Git 还不够。平台需要从它生成机器可读 registry,并把风险和质量变成一等字段:
|
||||||
|
|
||||||
|
```
|
||||||
|
name: release-rollback-weekly-report
|
||||||
|
version: 1.4.0
|
||||||
|
owner: devops-governance
|
||||||
|
domain: engineering.change-management
|
||||||
|
invocation: model
|
||||||
|
risk: write
|
||||||
|
allowed_tools:
|
||||||
|
- query_pipeline
|
||||||
|
- read_change_order
|
||||||
|
- publish_iwiki_with_approval
|
||||||
|
data_scopes:
|
||||||
|
- project:${session.project_id}
|
||||||
|
surfaces:
|
||||||
|
- web
|
||||||
|
- codex
|
||||||
|
eval_suite: evals/routing-and-output.json
|
||||||
|
status: promoted
|
||||||
|
```
|
||||||
|
|
||||||
|
这些字段不能只用于展示。registry 应进一步编译出运行时工具白名单、HITL 规则、可用入口和评测任务。CI 则检查命名、目录一致性、重复描述、失效引用、无 owner 的 promoted skill,以及"具有写风险但没有审批策略"等结构性问题。
|
||||||
|
|
||||||
|
**3.4 首先评测"有没有选对",再评测"做得好不好"**
|
||||||
|
|
||||||
|
Skill 评测至少分为两层。第一层是 catalog routing:该触发时是否触发、相邻 skill 是否混淆、组合任务是否能选出多个 skill、没有匹配项时是否拒绝硬套。第二层才是执行结果:工具是否正确、证据是否充分、产物是否符合结构、是否发生越权或不必要写入。
|
||||||
|
|
||||||
|
只优化单个 skill 的正例是不够的。最有价值的测试往往是近邻负例,例如"查询构建日志"和"下载构建制品"、"创建工蜂 Issue"和"修复已有 MR"。目录规模越大,越应该报告 top-1 accuracy、top-k recall、误触发率、漏触发率、token 成本和具体混淆对,而不是只看最终回答是否看起来合理。
|
||||||
|
|
||||||
|
## 04
|
||||||
|
|
||||||
|
虚拟文件系统:长任务的上下文平面与交付平面
|
||||||
|
|
||||||
|
为什么 Agent 需要文件系统?因为知识工作并不是一连串可以丢弃的聊天消息。一次完整任务通常同时包含原始证据、下载的文档、查询结果、中间脚本、清洗后的数据、图表、报告草稿和最终版本。把这些对象全部编码进 message history,会造成三个问题:上下文越来越昂贵;模型难以定位最新版本;用户无法在对话之外接管产物。
|
||||||
|
|
||||||
|
虚拟文件系统(Virtual Filesystem,VFS)提供了一套模型已经非常熟悉的操作语义:ls、read、write、edit、grep。它不要求底层真的使用 POSIX 磁盘;路径可以路由到内存状态、对象存储、数据库、远端 workspace 或只读知识库。关键是给 Agent 一个稳定、可寻址、能跨轮次存在的工作空间。
|
||||||
|
|
||||||
|
**4.1 会话文件系统的建议布局**
|
||||||
|
|
||||||
|
```
|
||||||
|
/sessions/<session-id>/
|
||||||
|
scope.json # 本会话绑定的项目、租户、环境和权限快照
|
||||||
|
evidence/ # 工具拉取的原始只读证据
|
||||||
|
working/ # 中间数据、脚本、计划与草稿
|
||||||
|
artifacts/ # 用户可消费的报告、图表、文档
|
||||||
|
checkpoints/ # 可恢复的执行状态或其索引
|
||||||
|
manifest.json # 产物来源、hash、owner、审批与交付状态
|
||||||
|
/skills/ # 版本化 skill,可配置只读或受控写入
|
||||||
|
/memories/ # 跨会话的稳定偏好和项目约定
|
||||||
|
/shared/ # 显式发布后才能进入的团队共享资产
|
||||||
|
```
|
||||||
|
|
||||||
|
目录的价值不只是整洁,而是建立信息生命周期。`evidence/` 默认不可被 Agent 覆盖,避免模型"修正"原始证据;`working/` 可以频繁变化;`artifacts/` 是对用户承诺的输出;只有经过显式发布,内容才从 session 私有空间进入 `/shared/`。这样,临时推理状态不会无意中变成组织事实。
|
||||||
|
|
||||||
|
**4.2 VFS 与 Sandbox 必须是两个边界**
|
||||||
|
|
||||||
|
文件持久化和代码执行不应该绑在同一个宿主环境里。推荐的模型是:Agent runtime 运行在受控服务中,通过 VFS 管理状态;当任务需要 Python 分析、图表生成或 PDF/PPT 处理时,再把 sandbox 作为工具调用。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
Kai 使用的正是类似思路:以 S3 支撑多租户虚拟文件系统,执行前把相关文件 materialize 到 sandbox,结束后同步变化;Agent 本身在 sandbox 外运行。这样既保持跨轮次文件世界的一致性,又把模型生成代码的风险限制在独立执行环境中。LangChain 对 Kai 的实现说明(https://www.langchain.com/blog/how-stripe-built-their-knowledge-ai-platform-on-deep-agents)
|
||||||
|
|
||||||
|
> Sandbox 保护的是宿主环境,不代表 sandbox 内的数据天然安全。输入文件、网络、凭证、运行时长、CPU/内存、输出大小以及 sync-out 路径都必须单独约束。
|
||||||
|
|
||||||
|
**4.3 文件系统如何缓解上下文膨胀**
|
||||||
|
|
||||||
|
VFS 不是把上下文窗口无限扩大的魔法,而是把"当前推理必须看到的内容"和"任务需要保留但不必每轮发送的内容"分开。工具返回大型日志时,harness 可以把完整结果写入 `evidence/build-123.log`,只向模型返回路径、摘要、行数和 hash。后续如果需要定位错误,再用 `grep` 和分段读取取回相关部分。
|
||||||
|
|
||||||
|
长会话还需要 summarization 与 checkpoint 配合。Summarization 压缩的是已经发生的对话,文件系统保留的是可再次验证的事实和产物,checkpoint 保存的是执行状态。三者不能互相替代:只有摘要会丢失细节,只有文件会丢失决策过程,只有 checkpoint 则会让每次模型调用继续背负全部上下文。
|
||||||
|
|
||||||
|
**4.4 Artifact 必须带有来源和交付状态**
|
||||||
|
|
||||||
|
Agent 生成一个 `report.md` 不等于完成交付。企业任务经常需要区分:来源是否为实时系统、数据窗口是什么、本地验证是否通过、是否已推送、是否已部署、是否经过业务验收。建议让 `manifest.json` 成为 artifact contract:
|
||||||
|
|
||||||
|
```json
|
||||||
|
{
|
||||||
|
"artifact": "artifacts/rollback-weekly-report.md",
|
||||||
|
"generated_at": "2026-08-06T10:30:00+08:00",
|
||||||
|
"session_scope": {
|
||||||
|
"project": "appset",
|
||||||
|
"environment": "production-readonly"
|
||||||
|
},
|
||||||
|
"sources": [
|
||||||
|
{"path": "evidence/change-orders.json", "sha256": "..."}
|
||||||
|
],
|
||||||
|
"validation": {
|
||||||
|
"local": "passed",
|
||||||
|
"remote_pipeline": "not_run",
|
||||||
|
"deployed": false,
|
||||||
|
"accepted": false
|
||||||
|
},
|
||||||
|
"approvals": []
|
||||||
|
}
|
||||||
|
```
|
||||||
|
|
||||||
|
这让 UI、后续 Agent 和审计系统能够读取结构化事实,而不是从自然语言中的"已经完成"猜测真实状态。
|
||||||
|
|
||||||
|
## 05
|
||||||
|
|
||||||
|
安全:从用户权限收缩到会话能力
|
||||||
|
|
||||||
|
传统企业应用通常以用户身份做授权:用户能否读取某个项目、修改某条配置。Agent 增加了一个新的委托层——用户授权 Agent 完成某项任务。用户拥有的全部权限,不应该自动成为这次任务的全部权限。
|
||||||
|
|
||||||
|
更合理的有效能力模型是:
|
||||||
|
|
||||||
|
```
|
||||||
|
effective capability
|
||||||
|
= user authorization
|
||||||
|
∩ agent configuration
|
||||||
|
∩ selected skill policy
|
||||||
|
∩ session/task scope
|
||||||
|
∩ tool-side enforcement
|
||||||
|
```
|
||||||
|
|
||||||
|
例如,用户分别有权访问客户 A 和客户 B,不代表一次针对客户 A 的分析可以读取 B。会话创建时应绑定 `customer_id=A`,工具服务端检查请求目标是否仍在 scope 内。模型不能通过换一种参数写法扩大范围,sandbox 中的脚本也不能绕过相同约束。
|
||||||
|
|
||||||
|
### Prompt 不是安全边界
|
||||||
|
|
||||||
|
"不要访问其他客户""写操作前请询问用户"可以帮助模型做出正确选择,但不能作为最终控制。Deep Agents 的 README 也明确采用 "trust the LLM" 模型:Agent 可以做工具允许的任何事,必须在工具或 sandbox 层设置边界。Deep Agents 安全说明(https://github.com/langchain-ai/deepagents#security)
|
||||||
|
|
||||||
|
实际落地时至少需要四道门:
|
||||||
|
|
||||||
|
1. **工具可见性**:只向模型注册当前 skill 需要的工具;
|
||||||
|
2. **参数策略**:在 tool gateway 校验租户、项目、环境、对象和操作类型;
|
||||||
|
3. **执行隔离**:shell、脚本和文档解析进入限制网络与资源的 per-session sandbox;
|
||||||
|
4. **人工审批**:发布、删除、生产变更和跨范围读取在执行前 interrupt。
|
||||||
|
|
||||||
|
框架自带的 filesystem permission 也要理解其边界。Deep Agents 官方文档指出,其声明式 permissions 约束的是内建文件工具,并不会自动覆盖自定义工具和 MCP;具有任意命令执行能力的 sandbox 同样需要独立策略。Permissions 文档(https://docs.langchain.com/oss/python/deepagents/permissions) 因此,`allowed-tools`、MCP server 权限、sandbox policy 和业务 API 授权必须组合使用。
|
||||||
|
|
||||||
|
## 06
|
||||||
|
|
||||||
|
一次请求如何穿过整个平台
|
||||||
|
|
||||||
|
把上述部件放在一起,一次"分析某项目最近一周的回滚并发布周报"的请求,不应该直接变成一轮带全部工具的模型调用,而应经历一条可观测、可阻断的执行链:
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
这里有几个刻意的设计:scope 在 session gateway 固化,而不是让模型自己推断;候选 skill 和工具集逐步收窄;工具结果首先成为证据文件,而不是无结构地堆进上下文;写操作在真正调用前审批;最终响应引用 manifest 中的状态,而不是由模型自由描述。
|
||||||
|
|
||||||
|
### 状态要分成三类
|
||||||
|
|
||||||
|
实现时可以把状态明确分为:
|
||||||
|
|
||||||
|
```python
|
||||||
|
class SessionContext(TypedDict):
|
||||||
|
# 创建会话后不可由模型修改
|
||||||
|
user_id: str
|
||||||
|
tenant_id: str
|
||||||
|
project_id: str
|
||||||
|
environment: str
|
||||||
|
capability_id: str
|
||||||
|
|
||||||
|
class AgentState(TypedDict):
|
||||||
|
# 可 checkpoint 的执行状态
|
||||||
|
messages: list
|
||||||
|
plan: list
|
||||||
|
selected_skills: list[str]
|
||||||
|
pending_approvals: list[str]
|
||||||
|
|
||||||
|
class ArtifactState(TypedDict):
|
||||||
|
# 通过 VFS 保存的大对象与交付事实
|
||||||
|
evidence_paths: list[str]
|
||||||
|
artifact_paths: list[str]
|
||||||
|
manifest_path: str
|
||||||
|
```
|
||||||
|
|
||||||
|
不可变的 session context 不应混在模型可以编辑的文件或消息里;AgentState 适合 checkpoint 和恢复;ArtifactState 只保存路径和索引,大文件由 VFS backend 管理。这样的拆分可以避免一次 summarization 意外改变权限,也避免 checkpoint 数据库反复序列化大型文档。
|
||||||
|
|
||||||
|
## 07
|
||||||
|
|
||||||
|
从现有工具体系演进,而不是重写一切
|
||||||
|
|
||||||
|
企业通常已经拥有 MCP、内部 API、脚本、知识库和若干 Agent。引入统一 harness 不意味着把这些能力全部重写。更现实的路径是先统一控制协议,再逐步替换执行内核。
|
||||||
|
|
||||||
|
### 阶段一:建立资产与风险基线
|
||||||
|
|
||||||
|
先枚举现有 Agent、skills 和 tools,回答五个问题:谁拥有、在哪些入口使用、读取什么数据、能执行哪些写操作、如何判断成功。将 prompt 中可复用的领域流程拆为 skill,将确定性逻辑沉淀为脚本或工具,将全局安全提醒转为 runtime policy。
|
||||||
|
|
||||||
|
这一阶段的交付物不是新聊天页面,而是 registry、lint 和 eval baseline。没有这些基线,后续无法证明新架构比旧架构更安全或更准确。
|
||||||
|
|
||||||
|
### 阶段二:接入统一 Harness
|
||||||
|
|
||||||
|
选择一个高频、读多写少、能够产生明确 artifact 的流程做试点,例如运行报告、账户研究或故障巡检。让现有入口通过统一 session API 调用 harness;把原有工具放到 tool gateway 后面;为任务创建 scope;将工具结果和报告迁入 VFS。
|
||||||
|
|
||||||
|
不要在第一版同时建设复杂 RAG、多 Agent 协作和自我改进。先验证最基本的闭环:任务能恢复、skill 能选对、证据能追溯、写操作能阻断、产物能被用户接管。
|
||||||
|
|
||||||
|
### 阶段三:做两阶段 Skill 路由
|
||||||
|
|
||||||
|
当 catalog 仍只有几十项时,可以先测量纯 LLM 路由,不必预设向量检索一定更好。随着技能数量和描述重叠上升,再引入领域标签、关键词、embedding 或轻量分类器预筛。比较时至少保留:
|
||||||
|
|
||||||
|
- top-1 与 top-k 选择质量;
|
||||||
|
- 每次请求注入的 skill/tool token;
|
||||||
|
- 首次有效工具调用延迟;
|
||||||
|
- 无关工具曝光数量;
|
||||||
|
- 误触发高风险 skill 的比例。
|
||||||
|
|
||||||
|
只有当预筛层在这些指标上产生净收益,才值得承担索引更新、召回调试和权限过滤的额外复杂度。
|
||||||
|
|
||||||
|
### 阶段四:建立 Trace-to-Skill 改进闭环
|
||||||
|
|
||||||
|
生产 trace 最有价值的用途不是展示调用链,而是发现 harness 和 skill 的缺口:用户反复纠正同一判断、某工具经常先失败再走 fallback、同一类任务反复手工补充上下文、某个 skill 被相邻 skill 抢占。这些模式应自动转化为候选回归用例和修改建议。
|
||||||
|
|
||||||
|
但生产 Agent 不应直接修改生产 skill。合理流程是:trace 发现问题 → 生成候选 patch 和 eval → owner review → 在隔离环境跑回归 → 合并发布。这样既利用 Agent 做自我分析,又保留领域责任和变更审计。
|
||||||
|
|
||||||
|
## 08
|
||||||
|
|
||||||
|
如何衡量是否真的落地
|
||||||
|
|
||||||
|
Agent 平台不能只用"调用次数"和"用户说好用"衡量。建议同时观察四组指标:
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
分母必须明确。例如"完成率 80%"需要说明是 80/100 个进入执行的任务,还是排除了澄清、取消和权限拒绝后的 80/85。业务效果也要区分相关性和因果性:高能力用户可能更愿意使用 Agent,复杂任务也可能天然需要更多调用。上线前保留对照基线,比事后只展示增长百分比更可靠。
|
||||||
|
|
||||||
|
## 09
|
||||||
|
|
||||||
|
几个容易踩的坑
|
||||||
|
|
||||||
|
### 把统一 Harness 做成新的单体 Agent
|
||||||
|
|
||||||
|
统一的是执行、安全和治理,不是把所有领域说明重新塞回一个超级 prompt。Skill 仍应按领域拥有并按需装载,工具也应动态暴露。
|
||||||
|
|
||||||
|
### 把 `allowed-tools` 当成完整授权
|
||||||
|
|
||||||
|
它最多描述模型在某个 skill 中应该看到什么。真正的授权必须由 tool gateway 和目标服务校验;MCP、自定义脚本和 sandbox 不能成为旁路。
|
||||||
|
|
||||||
|
### 把 VFS 当成无限期知识库
|
||||||
|
|
||||||
|
Session working files、组织知识和长期 memory 有不同生命周期、所有权和合规要求。没有发布流程和 TTL 的 VFS,最终只会变成另一座数据沼泽。
|
||||||
|
|
||||||
|
### 过早引入多 Agent
|
||||||
|
|
||||||
|
Subagent 适合隔离大量中间上下文或提供专门能力,但会增加状态、成本、权限继承和调试难度。如果一个确定性脚本或单 Agent 计划就能完成,不应仅因为框架支持就拆成多 Agent。
|
||||||
|
|
||||||
|
### 只验证"成功路径"
|
||||||
|
|
||||||
|
企业 Agent 的关键测试包括权限拒绝、工具超时、发布中断、sandbox 资源耗尽、skill 冲突和证据过期。一个只能在所有依赖正常时完成任务的 Agent,仍然只是演示。
|
||||||
|
|
||||||
|
## 10
|
||||||
|
|
||||||
|
结语:把 Agent 当成平台能力,而不是聊天功能
|
||||||
|
|
||||||
|
企业 Agent 的竞争力不会长期来自"接入了哪个最新模型"。模型会持续更替,真正沉淀下来的资产是:可复用且有 owner 的 skills、经过验证的工具与权限边界、能够恢复的执行状态、可追溯的证据和 artifacts,以及从生产 trace 回到评测与改进的工程闭环。
|
||||||
|
|
||||||
|
统一 harness、skill 和虚拟文件系统分别解决三个不同层次的问题:harness 让执行可靠且可控,skill 让分散的领域经验可以独立演进,VFS 让长任务拥有稳定的上下文和交付载体。三者组合后,Agent 才不再只是会调用工具的聊天机器人,而成为可以嵌入企业工作流、承担长期任务并接受治理的数字协作者。
|
||||||
|
|
||||||
|
这也是 Stripe Kai 案例最值得借鉴的部分:不是复制某个框架名称,也不是追逐"一周构建"的宣传数字,而是把通用 Agent 基础设施、企业安全边界和领域所有权放在正确的层次上。框架可以替换,模型可以升级;只要这些边界清楚,企业能力就不会随着某次技术选型一起重写。
|
||||||
|
|
||||||
|
**参考资料**
|
||||||
|
|
||||||
|
- Stripe:Meet Stripe's Knowledge AI Platform
|
||||||
|
|
||||||
|
https://stripe.dev/blog/meet-stripes-knowledge-ai-platform
|
||||||
|
- LangChain:How Stripe Built Kai, its Company-Wide AI Agent, on Deep Agents
|
||||||
|
|
||||||
|
https://www.langchain.com/blog/how-stripe-built-their-knowledge-ai-platform-on-deep-agents
|
||||||
|
- Deep Agents GitHub
|
||||||
|
|
||||||
|
https://github.com/langchain-ai/deepagents
|
||||||
|
- Deep Agents:Overview
|
||||||
|
|
||||||
|
https://docs.langchain.com/oss/python/deepagents/overview
|
||||||
|
- Deep Agents:Skills
|
||||||
|
|
||||||
|
https://docs.langchain.com/oss/python/deepagents/skills
|
||||||
|
- Deep Agents:Backends
|
||||||
|
|
||||||
|
https://docs.langchain.com/oss/python/deepagents/backends
|
||||||
|
- Deep Agents:Permissions
|
||||||
|
|
||||||
|
https://docs.langchain.com/oss/python/deepagents/permissions
|
||||||
|
- Deep Agents:Subagents
|
||||||
|
|
||||||
|
https://docs.langchain.com/oss/python/deepagents/subagents
|
||||||
|
|
||||||
|
原创作者|随机比特
|
||||||
@@ -0,0 +1,78 @@
|
|||||||
|
# 📊 文章摘要:企业内Agent工具落地实践:统一Harness、Skill与虚拟文件系统
|
||||||
|
|
||||||
|
> **原文**:[2026-08-20_企业内Agent工具落地实践_统一Harness_Skill与虚拟文件系统](./2026-08-20_企业内Agent工具落地实践_统一Harness_Skill与虚拟文件系统.md)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/D4RId9oiULoFj567vawPig
|
||||||
|
> **来源**:微信公众平台
|
||||||
|
> **作者**:随机比特
|
||||||
|
> **发布日期**:2026-08-20
|
||||||
|
> **摘要日期**:2026-08-20
|
||||||
|
> **价值评级**:⭐⭐⭐ 高
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 核心命题
|
||||||
|
|
||||||
|
> **运行时分水岭** — 企业 Agent 的分水岭不是模型而是 harness 运行时,稳定内核(harness)与可变领域能力(skill)分离、以虚拟文件系统承载长任务状态,才是从演示走向生产的架构答案。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 文章概要
|
||||||
|
|
||||||
|
本文针对企业 Agent 从演示走向生产时的三个基础问题——任务可访问什么、领域经验如何进入 Agent、长任务状态保存在哪里——提出一套生产架构:以统一 harness 承载执行与安全,以 skill 分发领域能力,以虚拟文件系统(VFS)管理上下文、证据与产物。文章的价值在于把分散的工程议题(权限、评测、checkpoint、审计)整合成一个可落地的分层框架,并以 Stripe Knowledge AI Platform(Kai)从 4,000 个微型 Agent 失败转向共享运行时的真实案例作支撑。局限是多数内容属于架构主张与作者实践笔记,缺乏量化的前后对比数据,且强依赖 LangChain Deep Agents 生态的术语体系。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 关键要点
|
||||||
|
|
||||||
|
1. **分水岭在运行时而非模型** — 模型决定单次推理上限,harness(编排、状态、检查点、审批、trace 的完整运行时)决定能力能否稳定可控进入企业流程。 `[分类: 范式突破]`
|
||||||
|
2. **两种不可持续的落地方式** — "一个场景一个 Agent"导致基础逻辑分叉;"把 coding agent 发给所有人"把安全风险转嫁给用户;Stripe 的 NoCode Agent Builder 曾产生超 4,000 个工作流 Agent 后难以为继。 `[分类: 共识]`
|
||||||
|
3. **Skill 是领域经验的可治理软件资产** — 区别于 system prompt(全局不可拆分)与工具描述(仅输入输出),skill 携带元数据、步骤、依赖、评测与 owner,通过联邦所有权让领域团队维护内容、平台团队维护规范。 `[分类: 共识]`
|
||||||
|
4. **Progressive disclosure 只解决一半问题** — 约 150 个技能叠加进系统 prompt 时 frontier model 选择质量下降,需转向"检索/分类器预筛召回 + LLM 精选"的两阶段路由,且只注册被选 skill 的工具以缩小攻击面。 `[分类: 共识]`
|
||||||
|
5. **VFS 是长任务的上下文平面与交付平面** — evidence/working/artifacts/checkpoints 目录划分建立信息生命周期;工具大结果写入文件只回传路径与摘要,缓解上下文膨胀;与 summarization、checkpoint 三者不可互相替代。 `[分类: 共识]`
|
||||||
|
6. **Artifact 必须带来源与交付状态** — manifest.json 作为 artifact contract 记录数据窗口、来源 hash、验证与审批状态,让 UI 与审计系统读取结构化事实而非猜测自然语言。 `[分类: 未探索]`
|
||||||
|
7. **Prompt 不是安全边界** — 有效能力 = 用户授权 ∩ Agent 配置 ∩ skill 策略 ∩ 会话范围 ∩ 工具侧强制;需工具可见性、参数策略、执行隔离、人工审批四道门组合。 `[分类: 共识]`
|
||||||
|
8. **演进路径与反模式** — 先建 registry/eval 基线再试点,避免把统一 harness 做成新单体、把 allowed-tools 当完整授权、把 VFS 当无限期知识库、过早引入多 Agent。 `[分类: 共识]`
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 批判性分析
|
||||||
|
|
||||||
|
### 假设前提
|
||||||
|
- 默认企业已有多入口、多团队、多数据域的复杂度,个人或小团队场景下该架构的治理成本可能超过收益。
|
||||||
|
- 假设领域团队有意愿和能力持续维护 skill(联邦所有权成立的前提),文中未讨论领域团队动力不足时的退化路径。
|
||||||
|
- 框架参照系是 LangChain Deep Agents + Stripe Kai,隐含"该生态方向正确"的判断。
|
||||||
|
|
||||||
|
### 论据与逻辑
|
||||||
|
- Stripe Kai(4,000 Agent 失败、150 技能路由退化)是有出处的真实案例,论据质量高;但其余多为架构主张,属于"合理推演"而非验证结论。
|
||||||
|
- 逻辑结构严密:三个基础问题 → 三个构件(harness/skill/VFS)→ 穿插安全与评测 → 演进路径,前后自洽。
|
||||||
|
- "完成率 80% 的分母"等指标讨论体现了少见的严谨,但全文没有给出该架构落地后的量化收益数据。
|
||||||
|
|
||||||
|
### 边界与局限
|
||||||
|
- 未讨论成本:VFS、registry、tool gateway、sandbox 的自建工程量对中型企业是否可行。
|
||||||
|
- 未涉及模型差异(不同模型对 skill 路由、工具调用可靠性的影响)。
|
||||||
|
- Trace-to-Skill 自动生成回归用例的闭环描述偏理想化,实际噪声处理未展开。
|
||||||
|
- 摘要者推断:该文更适合作架构蓝图与检查清单,而非可直接执行的实施方案。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 可引用金句
|
||||||
|
|
||||||
|
> "模型决定一次推理的上限,harness 决定这份能力能否稳定、可控地进入企业流程。"
|
||||||
|
|
||||||
|
> "通用 Agent 问题只解决一次,企业特有问题留在企业层,领域知识交给最了解它的人维护。"
|
||||||
|
|
||||||
|
> "无关工具不只是'不建议调用',而是根本不出现在当前模型请求里。"
|
||||||
|
|
||||||
|
> "一个只能在所有依赖正常时完成任务的 Agent,仍然只是演示。"
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 总体评价
|
||||||
|
|
||||||
|
**亮点**:把企业 Agent 的治理问题系统化为 harness/skill/VFS 三层框架;Stripe Kai 案例提供真实失败与转向证据;评测分层(先路由后执行)、近邻负例、指标分母等细节体现工程严谨性;反模式清单可直接用作评审检查表。
|
||||||
|
|
||||||
|
**不足**:无落地量化数据;强绑定 Deep Agents 生态术语,跨框架迁移需转译;对中小团队的适用性未讨论;VFS 与 sandbox 细节停留在布局建议层面。
|
||||||
|
|
||||||
|
**适用场景**:企业级 Agent 平台架构设计与评审;Agent 从 PoC 转生产的技术选型论证;skill 治理规范与评测体系搭建的参考蓝图。
|
||||||
|
|
||||||
|
**关联建议**:与本院 arno-anl-article-sum 等 skill 治理实践互证(联邦所有权、渐进加载);与《重磅!Graph Engineering 实操手册公开》对照阅读——后者聚焦单 Agent 内部的编排图,本文聚焦企业层的运行时与治理,二者构成 Agent 工程的两个层次;Stripe Kai 与 Deep Agents 官方文档可作为延伸验证材料。
|
||||||
@@ -0,0 +1,32 @@
|
|||||||
|
# Go是最好的"AI编程"语言?
|
||||||
|
|
||||||
|
> **来源**:微信公众平台(🍍)
|
||||||
|
> **作者**:🍍
|
||||||
|
> **发布日期**:2026-08-20(原文未标注明确日期,按下载日占位)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/f0-KvuYE_q2XOFRWMKd6CQ
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
当 AI 帮你写代码时,你选什么编程语言?Google 的答案是 Go —— 不是因为它好写,而是因为它好读、好审、好维护。
|
||||||
|
|
||||||
|
Google 官方博客发表了一篇立场鲜明的文章,论证 Go 是 AI 辅助软件工程的理想语言。逻辑很直接:当 AI 成为你团队里那个**"有点莽撞但产出极高的队友"**时,软件工程的瓶颈从"写代码"变成了"审代码"。Go 从设计之初就押注了可读性优先于可写性,这让它在 AI 时代意外地占尽优势。
|
||||||
|
|
||||||
|
|
||||||
|
|
||||||
|
几个关键论点:
|
||||||
|
|
||||||
|
Go 的静态类型系统是 AI 生成代码的自动安全网。在 Python 这样的动态语言中,AI 幻觉出的不存在的方法调用或类型错误,往往要到运行时才暴露 —— 而且要特定生产负载才能触发。在 Go 中,编译器直接拒绝,AI 可以在自纠正循环中快速迭代。
|
||||||
|
|
||||||
|
Go 的"标准库优先"文化天然减少了 AI 引入恶意依赖的风险。LLM 训练数据中常常包含过时、无人维护甚至恶意的第三方包,而 Go 庞大的标准库让 AI 倾向于使用官方维护的包,大幅缩小了供应链攻击面。
|
||||||
|
|
||||||
|
Go 的兼容性承诺 —— "不会有 Go 2.0" —— 意味着 15 年前写的代码现在仍然能编译运行。在 AI Agent 可以一夜之间生成几百个 PR 的时代,这个承诺是一种结构性的稳定性保障。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
Google 不是第一个做这种判断的。Steve Yegge 曾说过,AI 编程语言的评判标准是"agent ergonomics(智能体工学)" —— 不是人打字快不快,而是 agent 生成的代码容不容易验证。Go 的 gofmt 统一格式、快速编译、现代器(modernizers)自动重构,都是为这个目标服务的。
|
||||||
|
|
||||||
|
Python 统治了 AI 模型的训练和推理,但 AI 帮你写生产代码时,规则的赢家可能不是它。
|
||||||
|
|
||||||
|
参考来源:
|
||||||
|
|
||||||
|
- Google Developers Blog: Why Go is an Ideal Language for AI-Assisted Software Engineering - https://developers.googleblog.com/why-go-is-an-ideal-language-for-ai-assisted-software-engineering/
|
||||||
@@ -0,0 +1,73 @@
|
|||||||
|
# 📊 文章摘要:Go是最好的"AI编程"语言?
|
||||||
|
|
||||||
|
> **原文**:[2026-08-20_Go是最好的_AI编程_语言.md](./2026-08-20_Go是最好的_AI编程_语言.md)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/f0-KvuYE_q2XOFRWMKd6CQ
|
||||||
|
> **来源**:微信公众平台
|
||||||
|
> **作者**:🍍
|
||||||
|
> **发布日期**:2026-08-20
|
||||||
|
> **摘要日期**:2026-08-20
|
||||||
|
> **价值评级**:⭐⭐ 中
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 核心命题
|
||||||
|
|
||||||
|
> **智能体工学** — 当 AI 大量生成代码后,语言优劣的评判标准从"好不好写"转向"agent 生成的代码容不容易验证"(agent ergonomics),Go 因可读性优先、静态类型、标准库优先与兼容承诺而占优。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 文章概要
|
||||||
|
|
||||||
|
本文是对 Google 官方博客文章《Why Go is an Ideal Language for AI-Assisted Software Engineering》的中文短评转述:核心逻辑是 AI 使软件工程瓶颈从"写代码"变成"审代码",而 Go 的三项设计恰好服务于此——静态类型系统构成 AI 生成代码的编译期安全网(对比 Python 动态语言的运行时才暴露);"标准库优先"文化减少 AI 引入过时/恶意第三方依赖的供应链攻击面;"不会有 Go 2.0"的兼容承诺在 Agent 一夜生成数百 PR 的时代提供结构性稳定。其价值是把 Steve Yegge 的"agent ergonomics"判断与 Google 的官方立场压缩成可用的技术选型论据;局限是转述体,无独立验证,且未呈现任何反方证据(Google 与 Go 的利益关联、静态类型语言间的横向对比均缺席)。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 关键要点
|
||||||
|
|
||||||
|
1. **瓶颈转移:写代码→审代码** — 当 AI 成为"有点莽撞但产出极高的队友",工程瓶颈移到审查与验证侧,语言选型应以可验证性为第一标准。 `[分类: 范式突破]`(Yegge 提出 agent ergonomics,Google 官方背书后成为选型新框架)
|
||||||
|
2. **静态类型=编译期安全网** — AI 幻觉出的不存在方法/类型错误在 Go 编译期被直接拒绝,使 AI 可在自纠正循环中快速迭代;Python 中同类错误要到运行时、甚至特定生产负载才暴露。 `[分类: 共识]`
|
||||||
|
3. **标准库优先=缩小供应链攻击面** — LLM 训练数据中含过时、无人维护甚至恶意的第三方包,Go 庞大标准库使 AI 倾向用官方维护的包。 `[分类: 共识]`
|
||||||
|
4. **"不会有 Go 2.0"的兼容承诺** — 15 年前的代码仍可编译运行;在 Agent 一夜生成几百个 PR 的时代,这是结构性稳定性保障。 `[分类: 共识]`
|
||||||
|
5. **工具链服务可验证性** — gofmt 统一格式、快速编译、modernizers 自动重构,均服务于"agent 生成代码易于验证"这一目标。 `[分类: 共识]`
|
||||||
|
6. **训练推理与生产代码的语言分裂** — Python 统治 AI 模型训练与推理,但 AI 辅助写生产代码时"赢家可能不是它"。 `[分类: 争议]`(作者推测,无数据)
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 批判性分析
|
||||||
|
|
||||||
|
### 假设前提
|
||||||
|
- 预设 AI 生成代码占比将持续升高到足以改变语言选型逻辑。
|
||||||
|
- 预设编译期类型检查能捕获的错误是 AI 代码的主要风险类别——而逻辑错误、需求理解偏差、并发缺陷等静态类型管不了的风险被忽略。
|
||||||
|
- 预设 AI 的自纠正循环依赖编译反馈这一单一信号。
|
||||||
|
|
||||||
|
### 论据与逻辑
|
||||||
|
- Google 既是 Go 的母公司又是该论断的发布者,利益相关性未被提示。
|
||||||
|
- 三个论点(类型系统、标准库、兼容承诺)并非 Go 独有:Rust、TypeScript 同样静态类型且生态活跃,文章未做任何横向对比即得出"最好"暗示。
|
||||||
|
- 忽略反方证据:Go 在 LLM 训练语料中占比显著低于 Python/JS,生成质量与语料丰度的关系未讨论;Go 泛型与错误处理的冗长对生成 token 成本的影响也未提。
|
||||||
|
|
||||||
|
### 边界与局限
|
||||||
|
- 短评转述体(约 600 字),无实验数据、无引用量化基准;标题问号是姿态,正文结论单向。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 可引用金句
|
||||||
|
|
||||||
|
> "不是因为它好写,而是因为它好读、好审、好维护。"
|
||||||
|
|
||||||
|
> "当 AI 成为你团队里那个'有点莽撞但产出极高的队友'时,软件工程的瓶颈从'写代码'变成了'审代码'。"
|
||||||
|
|
||||||
|
> "不是人打字快不快,而是 agent 生成的代码容不容易验证。"
|
||||||
|
|
||||||
|
> "Python 统治了 AI 模型的训练和推理,但 AI 帮你写生产代码时,规则的赢家可能不是它。"
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 总体评价
|
||||||
|
|
||||||
|
**亮点**:将"agent ergonomics"这一 AI 时代语言选型新标准提炼清晰,三个论点(编译期安全网、供应链攻击面、兼容承诺)均可直接用于团队技术选型讨论,且附原始来源链接可回溯。
|
||||||
|
|
||||||
|
**不足**:纯转述无验证;利益关联未声明;无静态类型语言横向对比;忽略语料规模对生成质量的影响。
|
||||||
|
|
||||||
|
**适用场景**:AI 辅助编程时代的服务端语言选型讨论素材;Agent 工程中"生成代码可验证性"论点的引用入口。
|
||||||
|
|
||||||
|
**关联建议**:引用前建议回读 Google 原文博客;可与知识库中 Agent 工程、代码生成类文章互链,作为"语言与工具链"视角的补充。
|
||||||
@@ -14,6 +14,171 @@
|
|||||||
- 360 x 276
|
- 360 x 276
|
||||||
- 540 x 414
|
- 540 x 414
|
||||||
|
|
||||||
|
## 2026-08-20
|
||||||
|
|
||||||
|
- [Skill 工程方法论](https://mp.weixin.qq.com/s/sZXl5kHA9LErEwnegpvgXg)
|
||||||
|
- 
|
||||||
|
- 
|
||||||
|
- **Agent 放大而非抹平能力差距——Skill 把专家经验封装成可分发、可复用、可迭代的能力商品,是弥合用户 K 型分化的关键机制。**
|
||||||
|
- 认知层: [万字长文:做了些爆款 Skills 以后,我对 Skills 的看法](https://mp.weixin.qq.com/s/sZXl5kHA9LErEwnegpvgXg)
|
||||||
|
- 摘要:[查看](./微信公众平台/歸藏的AI工具箱/2026-08-20_万字长文_做了些爆款_Skills_以后_我对_Skills_的看法_摘要.md)
|
||||||
|
- 歸藏的AI工具箱 / 微信公众平台
|
||||||
|
- **Skill 是能力商品,不是提示词**——封装专家经验、工作流、品味与工具调用;用户无需理解 MCP/CLI/memory 等底层概念
|
||||||
|
- **Thin Harness, Fat Skills**——harness 保持薄,Skill 变厚承载流程与领域知识;description 是路由触发器而非宣传语
|
||||||
|
- **每个 Skill 都是一种税**——gotchas(失败清单)是最高价值内容,负面边界才是专家经验
|
||||||
|
- **设计 Skill 本质是把品味变成约束**——把 AI 任务从"自由设计"降级为"在高质量骨架里填充"
|
||||||
|
- 实践层: [开源一个 PPT Skill|压进了我 10 年的设计经验](https://mp.weixin.qq.com/s/GXjjlxpIJ604HVCCZJkUBA)
|
||||||
|
- 摘要:[查看](./微信公众平台/歸藏的AI工具箱/2026-08-20_开源一个_PPT_Skill_压进了我_10_年的设计经验_摘要.md)
|
||||||
|
- 歸藏的AI工具箱 / 微信公众平台
|
||||||
|
- **经验压缩包**——"这个 Skill 就是我这十年审美的一个压缩包",专家经验规则化为可复用 Skill 的方法示范
|
||||||
|
|
||||||
|
- [Agent 运行时工程化](https://mp.weixin.qq.com/s/D4RId9oiULoFj567vawPig)
|
||||||
|
- 
|
||||||
|
- 
|
||||||
|
- **驾驭 AI Agent 正在从"提示工程"走向"系统工程"——模型决定一次推理的上限,harness 决定这份能力能否稳定、可控地进入企业流程。**
|
||||||
|
- 认知层: [企业内Agent工具落地实践:统一Harness、Skill与虚拟文件系统](https://mp.weixin.qq.com/s/D4RId9oiULoFj567vawPig)
|
||||||
|
- 摘要:[查看](./微信公众平台/随机比特/2026-08-20_企业内Agent工具落地实践_统一Harness_Skill与虚拟文件系统_摘要.md)
|
||||||
|
- 随机比特 / 微信公众平台
|
||||||
|
- **运行时分水岭**——统一 Harness、Skill 治理与虚拟文件系统的企业级 Agent 生产架构系统化蓝图
|
||||||
|
- 认知层: [从 OpenCode 升级到 V2,我们看到上下文工程与驾驭工程的三个趋势](https://mp.weixin.qq.com/s/2u4ntl_2HZ7-iV-aHBrV8A)
|
||||||
|
- 摘要:[查看](./微信公众平台/Kerry/2026-08-20_从_OpenCode_升级到_V2_我们看到上下文工程与驾驭工程的三个趋势_摘要.md)
|
||||||
|
- Kerry / 微信公众平台
|
||||||
|
- **系统驾驭**——以文档为据提炼 Agent 驾驭三趋势,从提示工程走向系统工程
|
||||||
|
- 实践层: [技术速递|评估 GitHub Copilot 智能体运行框架在不同模型和任务中的性能与效率](https://mp.weixin.qq.com/s/TmXrgtT1A70VZfPESKinNQ)
|
||||||
|
- 摘要:[查看](./微信公众平台/微软Reactor/2026-08-20_技术速递_评估_GitHub_Copilot_智能体运行框架在不同模型和任务中的性能与效率_摘要.md)
|
||||||
|
- 微软Reactor / 微信公众平台
|
||||||
|
- **运行层效率**——"真正决定这些智能能否高效发挥作用的,是智能体运行框架";基准自评方法论可迁移
|
||||||
|
- 实践层: [重磅!Graph Engineering 实操手册公开](https://mp.weixin.qq.com/s/GZrKCHJaG5g7Ua-ZiEP-fQ)
|
||||||
|
- 摘要:[查看](./微信公众平台/Datawhale/2026-08-20_重磅_Graph_Engineering_实操手册公开_摘要.md)
|
||||||
|
- Datawhale(原作者 Codez) / 微信公众平台
|
||||||
|
- **图即组织**——"Graph 不是 loop 的升级版,是 loop 的组织方式";多 Agent 图编排 14 步实操手册
|
||||||
|
|
||||||
|
- [Agent 数据基础设施](https://mp.weixin.qq.com/s/qakhw_mXrCO7Fcb3tikv4A)
|
||||||
|
- 
|
||||||
|
- 
|
||||||
|
- **存储从承载数据的 Data Lake 升级为承接 Agent 运行状态的 State Lake,数据库则把向量检索收进 MySQL——数据栈正在为 Agent 全面重构。**
|
||||||
|
- 认知层: [从 Data Lake 到 State Lake:面向 Agent 时代的存储基础设施重构](https://mp.weixin.qq.com/s/qakhw_mXrCO7Fcb3tikv4A)
|
||||||
|
- 摘要:[查看](./微信公众平台/火山引擎存储/2026-08-20_从_Data_Lake_到_State_Lake_面向_Agent_时代的存储基础设施重构_摘要.md)
|
||||||
|
- 火山引擎存储 / 微信公众平台
|
||||||
|
- **Content 与 State 四维分野**——数据形态、IO 模式、SLO、成本结构;Sandbox Store / Artifact Store / 观测评测三大方向
|
||||||
|
- **快照即 Agent 存档点**——EBS 高频快照 + 任意步回退把"游戏存档"机制引入并行探索
|
||||||
|
- **存储终局**——"不是更大的湖,而是更懂业务的底座",从被调用资源变为 Agentic Teammate
|
||||||
|
- 实践层: [Storage Agent Family: Agent 时代,重构云存储的"人机交互"](https://mp.weixin.qq.com/s/tEDiv1KjsQvKO4Ffm41aOg)
|
||||||
|
- 摘要:[查看](./微信公众平台/火山引擎存储/2026-08-20_Storage_Agent_Family_Agent_时代_重构云存储的_人机交互_摘要.md)
|
||||||
|
- 火山引擎存储 / 微信公众平台
|
||||||
|
- **存储Agent化**——"发起任务的 User 凭证,会贯穿此次任务里 Agent 触发的每一个动作";云存储产品 Agent 化完整工程设计
|
||||||
|
- 实践层: [火山引擎 RDS MySQL 向量索引:把高性能向量检索带到 MySQL 上](https://mp.weixin.qq.com/s/f5aEV7az3RYQeivyQUJsYQ)
|
||||||
|
- 摘要:[查看](./微信公众平台/火山引擎数据库/2026-08-20_火山引擎_RDS_MySQL_向量索引_把高性能向量检索带到_MySQL_上_摘要.md)
|
||||||
|
- 火山引擎数据库 / 微信公众平台
|
||||||
|
- **向量进 MySQL**——一张表内同时执行常规业务查询与向量检索,仅靠 MySQL 落地 RAG;构建提速 4~6 倍、SQ8 量化索引缩至 1/4、高召回 QPS 领先 2~3 倍(厂商自测口径)
|
||||||
|
|
||||||
|
- [Agent 交互与工具集成](https://mp.weixin.qq.com/s/3IQIs6zP5jfdTwmT5LUJ6g)
|
||||||
|
- 
|
||||||
|
- 
|
||||||
|
- **Agent 的交互形态正在突破聊天框——界面组件在流式传输中实时组装,Claude Code 可经飞书、Discord 远程驾驭。**
|
||||||
|
- 实践层: [我复刻了 Claude 刚发布的生成式 UI 交互!](https://mp.weixin.qq.com/s/3IQIs6zP5jfdTwmT5LUJ6g)
|
||||||
|
- 摘要:[查看](./微信公众平台/歸藏的AI工具箱/2026-08-20_我复刻了_Claude_刚发布的生成式_UI_交互_摘要.md)
|
||||||
|
- 歸藏的AI工具箱 / 微信公众平台
|
||||||
|
- **流式生成UI**——"真正的复杂度在于:让这个 iframe 在流式传输、组件生命周期切换、主题变化这些状态转换中,保持视觉上的稳定"
|
||||||
|
- 案例层: [国人真牛!把 ClaudeCode 秒变 Openclaw,可飞书、Discord 远程控制!](https://mp.weixin.qq.com/s/93dtdbUbyrjSruqnKEdq1w)
|
||||||
|
- 摘要:[查看](./微信公众平台/数字元哥/2026-08-20_国人真牛_把_ClaudeCode_秒变_Openclaw_可飞书_Discord_远程控制_摘要.md)
|
||||||
|
- 数字元哥 / 微信公众平台
|
||||||
|
- **IM接入**——CodePilot:Claude Code 桌面端 + Cowork + OpenClaw 的组合体(无实测的工具转述)
|
||||||
|
|
||||||
|
- [Agent 产品与服务生态](https://mp.weixin.qq.com/s/Suq0Z4bseQHEzL42s18Nbw)
|
||||||
|
- 
|
||||||
|
- 
|
||||||
|
- **Agent 大规模落地拼的不是概念而是交付——零配置舰队降低使用门槛,实施服务的交付能力决定价值兑现。**
|
||||||
|
- 战略层: [硅谷CEO: Grok Bot诞生,震撼程度堪比Claude Code时刻!](https://mp.weixin.qq.com/s/Suq0Z4bseQHEzL42s18Nbw)
|
||||||
|
- 摘要:[查看](./微信公众平台/ASI启示录/2026-08-20_硅谷CEO_Grok_Bot诞生_震撼程度堪比Claude_Code时刻_摘要.md)
|
||||||
|
- ASI启示录 / 微信公众平台
|
||||||
|
- **零配置舰队**——零配置 + 强制云端 VM + 多智能体原生协同;与 Hermes/OpenClaw 共存而非替代
|
||||||
|
- **模型决定上限**——"工具再好,如果模型不够聪明,一切都是零";Token 成本是"一人公司"的真实门槛
|
||||||
|
- 战略层: [FDE 在中国火了,Agent 实施服务的真正考验在哪儿?](https://mp.weixin.qq.com/s/iOkC1JMQEUu2dZeQheTZYA)
|
||||||
|
- 摘要:[查看](./微信公众平台/IDC中国/2026-08-20_FDE_在中国火了_Agent_实施服务的真正考验在哪儿_摘要.md)
|
||||||
|
- IDC中国 / 微信公众平台
|
||||||
|
- **FDE分化**——"真正重要的,不是谁能最快喊出这个概念,而是谁能把它变成客户可感知、可验证的交付能力"
|
||||||
|
- 案例层: [链路贯通|Jonex × WorkBuddy 打通 MCP 链路:本体知识 + 企业 Agent 赋能工程智能决策](https://mp.weixin.qq.com/s/u7QfwbV2fx1XkxHhGhKHIA)
|
||||||
|
- 摘要:[查看](./微信公众平台/悦智人工智能/2026-08-20_链路贯通_Jonex_×_WorkBuddy_打通_MCP_链路_本体知识_+_企业_Agent_赋能工程智能决策_摘要.md)
|
||||||
|
- 悦智人工智能 / 微信公众平台
|
||||||
|
- **知识编译**——本体知识 + 企业 Agent 赋能工程智能决策,三个运维场景叙事(厂商宣传文)
|
||||||
|
|
||||||
|
- [大模型前沿:后训练扩展](https://mp.weixin.qq.com/s/SpXEbbzv9jZ2xrZd7lcM7w)
|
||||||
|
- 
|
||||||
|
- 
|
||||||
|
- **不加参数、不换基座——后训练靠 Scale Environment, Scale Experience 仍能把模型能力再推一截。**
|
||||||
|
- 认知层: [对 GLM-5.3 的真实评价。](https://mp.weixin.qq.com/s/SpXEbbzv9jZ2xrZd7lcM7w)
|
||||||
|
- 摘要:[查看](./微信公众平台/阿颖/2026-08-20_对_GLM-5.3_的真实评价_摘要.md)
|
||||||
|
- 阿颖 / 微信公众平台
|
||||||
|
- **后训练扩展**——"Scale Environment, Scale Experience";Coding 能力向网络安全等垂直领域迁移
|
||||||
|
- **Scaling 目标转向**——Loop Transformer 让 Scaling 衡量目标从参数量转向推理链路长度
|
||||||
|
- 实践层: [Go是最好的"AI编程"语言?](https://mp.weixin.qq.com/s/f0-KvuYE_q2XOFRWMKd6CQ)
|
||||||
|
- 摘要:[查看](./微信公众平台/🍍/2026-08-20_Go是最好的_AI编程_语言_摘要.md)
|
||||||
|
- 🍍 / 微信公众平台
|
||||||
|
- **智能体工学**——"不是人打字快不快,而是 agent 生成的代码容不容易验证";agent ergonomics 视角的语言选型
|
||||||
|
|
||||||
|
- [产业与开源生态](https://mp.weixin.qq.com/s/hybZIAHrShl4xunoTf3hiQ)
|
||||||
|
- 
|
||||||
|
- 
|
||||||
|
- **AI 领先地位的竞争不是最强模型之争,而是生态吸纳能力之争——开源的优势是外部性,商业软肋也是外部性。**
|
||||||
|
- 战略层: [Kimi K3之后:开源还是闭源,这是个问题](https://mp.weixin.qq.com/s/hybZIAHrShl4xunoTf3hiQ)
|
||||||
|
- 摘要:[查看](./微信公众平台/侯宏/2026-08-20_Kimi_K3之后_开源还是闭源_这是个问题_摘要.md)
|
||||||
|
- 侯宏 / 微信公众平台
|
||||||
|
- **生态主导权**——"美国赢得AI时代并非因为拥有最强模型,而因为AI能进入工厂、医院、农场、课堂和大量企业的工作流"
|
||||||
|
- **开源与垄断定义上不兼容**——无新玩家入场是"不愿"非"不能";Kimi 修改 K3 开源条款是商业模式自救信号
|
||||||
|
- **开源税设想**——渠道加价只针对海外云平台、国内豁免的歧视性定价
|
||||||
|
- 战略层: [郑永年:真正的技术自主,是拥有定义技术路径的能力](https://mp.weixin.qq.com/s/sNcoweoLC_eHMUoVynpDiw)
|
||||||
|
- 摘要:[查看](./微信公众平台/郑永年/2026-08-20_郑永年_真正的技术自主_是拥有定义技术路径的能力_摘要.md)
|
||||||
|
- 郑永年(IPP评论) / 微信公众平台
|
||||||
|
- **路径定义权**——"真正的技术自主,从来不是'有没有芯片'这么简单的问题,而是'是否拥有定义技术路径的能力'"
|
||||||
|
- 案例层: [过去一周,模型在下饺子,价格在下刀子,人才在跑路,AI厂商卷入生死时速!](https://mp.weixin.qq.com/s/tRwcm21YyiiMU-HxgysinQ)
|
||||||
|
- 摘要:[查看](./微信公众平台/祖哥/2026-08-20_过去一周_模型在下饺子_价格在下刀子_人才在跑路_AI厂商卷入生死时速_摘要.md)
|
||||||
|
- 祖哥(e-works) / 微信公众平台
|
||||||
|
- **生死时速**——"模型可以靠后训练,人才可没法靠后训练——这,才是巨头们最头疼的护城河问题"
|
||||||
|
- 案例层: [2026CSDI:AGI前夜,属于懂Agent、更懂模型的长期深耕企业](https://mp.weixin.qq.com/s/oNIIz2OmoV7Mk1zo87cBjA)
|
||||||
|
- 摘要:[查看](./微信公众平台/CSDIsummit/2026-08-20_2026CSDI_AGI前夜_属于懂Agent_更懂模型的长期深耕企业_摘要.md)
|
||||||
|
- CSDIsummit / 微信公众平台
|
||||||
|
- **预训练天花板**——"大模型是引擎,工程化链路是把引擎变成整车的工程。发动机决定上限,工程决定能不能跑、跑多远、跑多稳"
|
||||||
|
|
||||||
|
- [制造业 AI 落地](https://mp.weixin.qq.com/s/WX5ysyywBrx5Nnb7JyKKeg)
|
||||||
|
- 
|
||||||
|
- 
|
||||||
|
- **制造业第三次蜕变的本质是决策主体从人转向"工业大模型+工业智能体"——数据只报告异常,智能系统才开药方。**
|
||||||
|
- 认知层: [2026制造业生死局:工业大模型落地,AI智能体进厂,正在重构工厂的生存法则](https://mp.weixin.qq.com/s/WX5ysyywBrx5Nnb7JyKKeg)
|
||||||
|
- 摘要:[查看](./微信公众平台/墨执子/2026-08-20_2026制造业生死局_工业大模型落地_AI智能体进厂_正在重构工厂的生存法则_摘要.md)
|
||||||
|
- 墨执子 / 微信公众平台
|
||||||
|
- **人治到智治**——"数据是死的,像医院的体检报告,只告诉你哪里指标异常,却不会告诉你病因,更不会帮你开药方"
|
||||||
|
- 案例层: [干货丨一文get 2026"人工智能+制造"融合创新研讨会 核心观点](https://mp.weixin.qq.com/s/DnC2BPZBkO5PywsmWlsNSA)
|
||||||
|
- 摘要:[查看](./微信公众平台/自动化博览/2026-08-20_干货丨一文get_2026_人工智能_制造_融合创新研讨会_核心观点_摘要.md)
|
||||||
|
- 自动化博览 / 微信公众平台
|
||||||
|
- **议题风向**——工业大脑、智能安全标准化、自主化运营及无人场域(会议通稿,核心观点以图片/视频承载)
|
||||||
|
|
||||||
|
- [军事AI与社会影响](https://mp.weixin.qq.com/s/g57nYwvtj-kllPxX5s9l5g)
|
||||||
|
- 
|
||||||
|
- 
|
||||||
|
- **无人机改变战争的经济学,蜂群改变其节奏,AI 可能改变责任本身的性质——机器速度越快,越需要强化而非弱化人类控制。**
|
||||||
|
- 战略层: [未来战场已然来临:大规模廉价无人系统、多域蜂群、人工智能](https://mp.weixin.qq.com/s/g57nYwvtj-kllPxX5s9l5g)
|
||||||
|
- 摘要:[查看](./微信公众平台/专知防务/2026-08-20_未来战场已然来临_大规模廉价无人系统_多域蜂群_人工智能_摘要.md)
|
||||||
|
- 专知防务 / 微信公众平台
|
||||||
|
- **蜂群系统战**——未来战场优势取决于廉价、网络化、可学习系统的集体行为而非单一平台性能
|
||||||
|
- 战略层: [政策分析报告|当前AI对国内外就业产生的冲击及应对建议](https://mp.weixin.qq.com/s/qgQSauWUn1OIA1TwEirv0w)
|
||||||
|
- 摘要:[查看](./微信公众平台/GIG/2026-08-20_政策分析报告_当前AI对国内外就业产生的冲击及应对建议_摘要.md)
|
||||||
|
- GIG(广州粤港澳大湾区研究院) / 微信公众平台
|
||||||
|
- **AI裁员陷阱**——"单个企业能够享受人力成本下降的收益,但失业和收入下降造成的需求损失却由整个社会承担"
|
||||||
|
- 根基层: [人工智能时代数智化生存的哲学省思](https://mp.weixin.qq.com/s/G0MfY7D4wkXVwZHsok3YRQ)
|
||||||
|
- 摘要:[查看](./微信公众平台/张灿/2026-08-20_人工智能时代数智化生存的哲学省思_摘要.md)
|
||||||
|
- 张灿(中国矿业大学) / 微信公众平台
|
||||||
|
- **数智化生存**——"我们不仅持续生成数据,更被数据建构,并经由数据被算法解读、赋予标签化意义"
|
||||||
|
|
||||||
|
- 独立文章: [文章背后 | 漂:聚焦城市新移民](https://mp.weixin.qq.com/s/gPvUj751Gz-G70_DWMl3UQ)
|
||||||
|
- 摘要:[查看](./微信公众平台/Geores/2026-08-20_文章背后_漂_聚焦城市新移民_摘要.md)
|
||||||
|
- Geores / 微信公众平台
|
||||||
|
- **漂泊治学**——"研究移民聚居区就是研究我们身处的这个特殊时代,就是认识和理解我们自己";城市地理学者 30 年学术自述
|
||||||
|
|
||||||
|
- 视频笔记: [Codex傻瓜式操作blender,复刻高质科普视频(小红书)](https://www.xiaohongshu.com/discovery/item/6a697076000000001102ee5b?app_platform=ios&app_version=9.43&share_from_user_hidden=true&xsec_source=app_share&type=video&xsec_token=CBTtFivWeAwsWqK1OaCi5Tsm-hZm0dHQqupCPBVglV0lw=&author_share=1&xhsshare=WeixinSession&shareRedId=Nz03Qjw1NDo-OUpFPEE2PTY8Ojw8Oz9C&apptime=1787136637&share_id=b041a4889b6d47ffbc19a1cf17832da6&code=54O2AyMatW1#pushState)
|
||||||
|
- 孙沐晏 / 小红书(7:02 视频,视频内容无法文本化归档)
|
||||||
|
- 推荐博主 Branch Education、Redknot-乔红;Skill 地址:GitHub 上的 make-blender-education-video-skill
|
||||||
|
|
||||||
## 2026-08-06
|
## 2026-08-06
|
||||||
|
|
||||||
- [PD分离技术原理](https://zhuanlan.zhihu.com/p/27836625742)
|
- [PD分离技术原理](https://zhuanlan.zhihu.com/p/27836625742)
|
||||||
|
|||||||

|
After Width: | Height: | Size: 22 KiB |

|
After Width: | Height: | Size: 1.6 MiB |

|
After Width: | Height: | Size: 28 KiB |

|
After Width: | Height: | Size: 2.8 MiB |

|
After Width: | Height: | Size: 20 KiB |

|
After Width: | Height: | Size: 1.3 MiB |

|
After Width: | Height: | Size: 20 KiB |

|
After Width: | Height: | Size: 1.9 MiB |

|
After Width: | Height: | Size: 17 KiB |

|
After Width: | Height: | Size: 824 KiB |

|
After Width: | Height: | Size: 26 KiB |

|
After Width: | Height: | Size: 3.0 MiB |

|
After Width: | Height: | Size: 20 KiB |

|
After Width: | Height: | Size: 1.4 MiB |

|
After Width: | Height: | Size: 28 KiB |

|
After Width: | Height: | Size: 2.9 MiB |

|
After Width: | Height: | Size: 19 KiB |

|
After Width: | Height: | Size: 2.0 MiB |