Compare commits
12
Commits
391fa484dc
..
trunk
| Author | SHA1 | Date | |
|---|---|---|---|
 arno |
eec36b04bb | ||
|
arno
|
ff165c27ca | ||
|
arno
|
5f2964bf68 | ||
|
arno
|
28c4dfed4e | ||
|
arno
|
6e295de801 | ||
 arnoandClaude |
576fbc0253 | ||
|
arno
|
24af71a072 | ||
|
arno
|
21cce73cfb | ||
|
arno
|
ced8ff190e | ||
|
arno
|
c0ba3fb853 | ||
|
arno
|
aa585542d1 | ||
|
arno
|
96fe84bd63 |
@@ -0,0 +1,3 @@
|
|||||||
|
# Claude Code
|
||||||
|
settings.local.json
|
||||||
|
node_modules
|
||||||
@@ -0,0 +1,3 @@
|
|||||||
|
# 记忆索引
|
||||||
|
|
||||||
|
- [金鹏文章配图宽度 1000](article-cover-width-1000.md) — 题图只需宽 1000(16:9 约 1000×563),不用 2K/4K
|
||||||
@@ -0,0 +1,15 @@
|
|||||||
|
---
|
||||||
|
name: article-cover-width-1000
|
||||||
|
description: 知识/金鹏.md 文章配图只需宽度 1000,无需 2K/4K 大图
|
||||||
|
metadata:
|
||||||
|
node_type: memory
|
||||||
|
type: feedback
|
||||||
|
originSessionId: 1cb1efa5-2024-4c20-8c93-14dfa2cb1fb1
|
||||||
|
modified: 2026-08-27T05:35:34.060Z
|
||||||
|
---
|
||||||
|
|
||||||
|
知识/金鹏.md 的文章配图(题图 `-NNN.png`)只需宽度为 1000 的图片(16:9 即约 1000×563),不要按 skill 默认的 ≥2K/4K 规格(曾生成 5404×3040 单张 3-6MB,被指出超出需求)。
|
||||||
|
|
||||||
|
**Why:** 题图显示宽度上限约 1000px,更高分辨率只增加仓库体积;金老师 2026-08-27 明确指示"只需要生成宽度为 1000 的即可"。
|
||||||
|
|
||||||
|
**How to apply:** 用 arno-gen-dreamina 生成 16:9 图后,以 PIL LANCZOS 缩放到宽 1000 再入库;列表标题图(160×90 thumb)仍由该图缩放生成,保证两图视觉一致。此规则覆盖 arno-anl-article-sum skill 中"题图 ≥2K"的旧规格。
|
||||||
@@ -1,15 +0,0 @@
|
|||||||
{
|
|
||||||
"permissions": {
|
|
||||||
"allow": [
|
|
||||||
"Bash(*)"
|
|
||||||
],
|
|
||||||
"deny": [
|
|
||||||
"mcp__pencil"
|
|
||||||
]
|
|
||||||
},
|
|
||||||
"enabledPlugins": {},
|
|
||||||
"outputStyle": "default",
|
|
||||||
"spinnerTipsEnabled": false,
|
|
||||||
"autoMemoryEnabled": true,
|
|
||||||
"autoMemoryDirectory": "/data/git/gitea/szis/isos/tech/.claude/memory"
|
|
||||||
}
|
|
||||||
@@ -0,0 +1,224 @@
|
|||||||
|
# pd分离在vllm中用法
|
||||||
|
|
||||||
|
> **来源**:CSDN 博客(博主:小徐炸酱面)
|
||||||
|
> **作者**:小徐炸酱面(qq_44319972)
|
||||||
|
> **发布日期**:2025-12-01(2025-12-02 修改)
|
||||||
|
> **原文链接**:https://blog.csdn.net/qq_44319972/article/details/155456852
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
### 1. 背景:为什么需要 PD 分离
|
||||||
|
|
||||||
|
大模型在线服务一般包含两种阶段:
|
||||||
|
|
||||||
|
- **Prefill 阶段**
|
||||||
|
- 输入:完整的 prompt
|
||||||
|
- 动作:一次性跑完所有输入 token 的前向,构建 KV Cache
|
||||||
|
- 特点:
|
||||||
|
- **计算密集**(GEMM-heavy,吃算力)
|
||||||
|
- 对显存需求大(一次性占用大量 KV)
|
||||||
|
- 对带宽要求相对没那么极端(一次性大算子)
|
||||||
|
- **Decode 阶段**
|
||||||
|
- 输入:每轮只处理很少的新 token(一般 1~几 token)
|
||||||
|
- 动作:基于已有 KV Cache 不断迭代生成新 token
|
||||||
|
- 特点:
|
||||||
|
- 单步计算量相对小
|
||||||
|
- 访问 KV Cache 频繁,**更吃显存带宽 / 内存带宽 / 通信带宽**
|
||||||
|
- 很多小 kernel,调度频率高
|
||||||
|
|
||||||
|
**PD 分离(Producer / Decoder Separation)** 的目标就是:
|
||||||
|
|
||||||
|
- 把 prefill 和 decode 拆到**不同的进程 / 节点 / 设备**上
|
||||||
|
- 利用不同节点的算力/带宽特性,整体提升吞吐、降低延迟
|
||||||
|
|
||||||
|
### 2. PD 分离的基本概念与架构
|
||||||
|
|
||||||
|
#### 2.1 角色定义
|
||||||
|
|
||||||
|
- **P 节点(Producer)**
|
||||||
|
- 负责:prefill 阶段
|
||||||
|
- 对应操作:
|
||||||
|
- 处理新请求的 prompt
|
||||||
|
- 运行大批量 GEMM
|
||||||
|
- 把得到的 KV Cache 写入某种共享介质(或通过 KV 通道发送给 D 节点)
|
||||||
|
- 资源特征:
|
||||||
|
- 更看重:**算力、GPU FLOPs**
|
||||||
|
- 对长尾小请求和频繁通信不是特别敏感
|
||||||
|
- **D 节点(customer)**
|
||||||
|
- 负责:decode 阶段
|
||||||
|
- 对应操作:
|
||||||
|
- 不断从 KV 中取数据
|
||||||
|
- 迭代生成每个 request 的后续 token
|
||||||
|
- 资源特征:
|
||||||
|
- 更看重:**显存带宽 / 网络带宽 / 延迟**
|
||||||
|
- 关注 tail latency(TPOT、e2e)
|
||||||
|
|
||||||
|
#### 2.2 KV Cache 的流转
|
||||||
|
|
||||||
|
PD 分离的**核心**就是:**prefill 生成的 KV,如何让 decode 能够用起来**。
|
||||||
|
|
||||||
|
一般数据流可以抽象成:
|
||||||
|
|
||||||
|
1. 请求进来,P 节点接收并执行 prefill
|
||||||
|
2. P 节点为该 request 分配 KV Block(或 Block 列表)
|
||||||
|
3. P 节点把 KV 的位置信息 + request 的 metadata 通过某种 **KV Connector / RPC 通道** 告诉 D 节点
|
||||||
|
4. D 节点接管该 request 的 decode:
|
||||||
|
- 知道对应 KV 在哪里
|
||||||
|
- 在后续 decode 中,始终通过 KV Connector 访问这些 KV
|
||||||
|
|
||||||
|
典型注意事项:
|
||||||
|
|
||||||
|
- 如果有 DP/TP,P/D 侧的并行策略也要匹配(否则会出现 KV 维度不一致、block id 对不上等问题)
|
||||||
|
- 如果跨机器,需要额外考虑网络带宽、RDMA、压缩等问题
|
||||||
|
|
||||||
|
### 3. vLLM 中的 PD 分离思路(概念层面)
|
||||||
|
|
||||||
|
> 这里以 "vLLM + 自研 PD 功能" 的思路来整理,只写通用逻辑,不绑死具体实现细节。
|
||||||
|
|
||||||
|
#### 3.1 与调度器(scheduler)的关系
|
||||||
|
|
||||||
|
vLLM 的 serving 里,有一个统一的 scheduler 管理:
|
||||||
|
|
||||||
|
- 新请求的进入(prefill 阶段)
|
||||||
|
- 已有请求的继续 decode
|
||||||
|
- 每一轮 step,要算多少 token(`num_scheduled_tokens`)
|
||||||
|
- 每个 request 一共已经算了多少 token(`num_computed_tokens`)
|
||||||
|
|
||||||
|
PD 分离后,逻辑可以拆解为:
|
||||||
|
|
||||||
|
1. **Producer 侧 scheduler**:只负责 prefill
|
||||||
|
2. **Decoder 侧 scheduler**:只负责 decode
|
||||||
|
3. 通过某种方式保证两边对 request 状态的约定一致,例如:
|
||||||
|
- request id
|
||||||
|
- 已生成 token 数
|
||||||
|
- KV block id 列表
|
||||||
|
- 当前是否已经结束(EOS / abort)
|
||||||
|
|
||||||
|
### 4. 在 vLLM 中使用 PD 分离的典型启动方式(示意)
|
||||||
|
|
||||||
|
> 下面用伪代码/伪命令展示结构,变量名你可以换成你们环境里的 `VLLM_USE_V1` / `vllm_PD_ROLE` / `kv_transfer_config` 等。
|
||||||
|
|
||||||
|
#### 4.1 不分离时(baseline)
|
||||||
|
|
||||||
|
```
|
||||||
|
# 单机单进程示意
|
||||||
|
python3 -m vllm.entrypoints.openai.api_server \
|
||||||
|
--model /data/models/Qwen3-32B \
|
||||||
|
--tensor-parallel-size 2 \
|
||||||
|
--dtype bfloat16 \
|
||||||
|
--max-model-len 32768 \
|
||||||
|
--port 8000 \
|
||||||
|
--host 0.0.0.0
|
||||||
|
```
|
||||||
|
|
||||||
|
Benchmark 示意:
|
||||||
|
|
||||||
|
```
|
||||||
|
python3 benchmarks/benchmark_serving.py \
|
||||||
|
--backend openai-chat \
|
||||||
|
--base-url http://<host>:8000 \
|
||||||
|
--endpoint /v1/chat/completions \
|
||||||
|
--model Qwen3-32B \
|
||||||
|
--tokenizer /data/models/Qwen3-32B \
|
||||||
|
--dataset-name random \
|
||||||
|
--random-input-len 2000 \
|
||||||
|
--random-output-len 200 \
|
||||||
|
--request-rate 5 \
|
||||||
|
--num-prompts 100 \
|
||||||
|
--percentile-metrics ttft,tpot,e2el
|
||||||
|
```
|
||||||
|
|
||||||
|
#### 4.2 1P1D(单机或双机)
|
||||||
|
|
||||||
|
**4.2.1 Producer 节点**
|
||||||
|
|
||||||
|
```
|
||||||
|
export VLLM_USE_V1=1
|
||||||
|
export vllm_PD_ROLE=producer
|
||||||
|
|
||||||
|
python3 -m vllm.entrypoints.openai.api_server \
|
||||||
|
--model /data/models/Qwen3-32B \
|
||||||
|
--tensor-parallel-size 2 \
|
||||||
|
--max-model-len 32768 \
|
||||||
|
--max-num-batched-tokens 8192 \
|
||||||
|
--max-num-seqs 32 \
|
||||||
|
--port 8209 \
|
||||||
|
--host 0.0.0.0 \
|
||||||
|
--kv-transfer-config \
|
||||||
|
'{"kv_connector":"P2pNcclConnector",
|
||||||
|
"kv_role":"kv_producer",
|
||||||
|
"kv_rank":0,
|
||||||
|
"kv_parallel_size":2,
|
||||||
|
"kv_buffer_size":1,
|
||||||
|
"kv_port":9109,
|
||||||
|
"kv_connector_extra_config":{
|
||||||
|
"proxy_ip":"0.0.0.0",
|
||||||
|
"proxy_port":30001,
|
||||||
|
"http_port":8109
|
||||||
|
}}' \
|
||||||
|
&> Qwen3-32B-producer.log &
|
||||||
|
```
|
||||||
|
|
||||||
|
**4.2.2 Decoder 节点(D,kv_consumer)**
|
||||||
|
|
||||||
|
> ⚠️ 原文此处的代码块与 Producer 节点完全相同(`vllm_PD_ROLE=producer`、`kv_role:"kv_producer"`),疑为作者复制粘贴遗漏修改。按原文忠实保留如下,实际部署时 Decoder 侧应改为 `vllm_PD_ROLE=decoder` / `kv_role:"kv_consumer"`、`kv_rank` 相应调整。
|
||||||
|
|
||||||
|
```
|
||||||
|
export VLLM_USE_V1=1
|
||||||
|
export vllm_PD_ROLE=producer
|
||||||
|
|
||||||
|
python3 -m vllm.entrypoints.openai.api_server \
|
||||||
|
--model /data/models/Qwen3-32B \
|
||||||
|
--tensor-parallel-size 2 \
|
||||||
|
--max-model-len 32768 \
|
||||||
|
--max-num-batched-tokens 8192 \
|
||||||
|
--max-num-seqs 32 \
|
||||||
|
--port 8209 \
|
||||||
|
--host 0.0.0.0 \
|
||||||
|
--kv-transfer-config \
|
||||||
|
'{"kv_connector":"P2pNcclConnector",
|
||||||
|
"kv_role":"kv_producer",
|
||||||
|
"kv_rank":0,
|
||||||
|
"kv_parallel_size":2,
|
||||||
|
"kv_buffer_size":1,
|
||||||
|
"kv_port":9109,
|
||||||
|
"kv_connector_extra_config":{
|
||||||
|
"proxy_ip":"0.0.0.0",
|
||||||
|
"proxy_port":30001,
|
||||||
|
"http_port":8109
|
||||||
|
}}' \
|
||||||
|
&> Qwen3-32B-producer.log &
|
||||||
|
```
|
||||||
|
|
||||||
|
**`kv-transfer-config` 参数解释:**
|
||||||
|
|
||||||
|
- **`kv_connector`**:用什么通道传 KV。现在用:`P2pNcclConnector`,表示走 NCCL P2P 通信。
|
||||||
|
- **`kv_role`**:这个进程是**发 KV 的**还是**收 KV 的**。
|
||||||
|
- P:`"kv_producer"`
|
||||||
|
- D:`"kv_consumer"`
|
||||||
|
- **`kv_rank`**:在这组通道里的编号,从 0 开始。多个并行通道时,用它来区分是谁↔谁。
|
||||||
|
- **`kv_parallel_size`**:一共有几路 KV 通道(也可以理解为这组里有多少 rank)。一般设成和 TP/world size 一致。P 和 D 必须一样。
|
||||||
|
- **`kv_buffer_size`**:通道里最多允许多少块 KV "在路上"。值越大,流水越深、占用显存可能越多;不确定就先用 `1`,稳一点。
|
||||||
|
- **`kv_port`**:KV 通道用的基础端口。P / D 两边要一致,别和其他服务冲突。
|
||||||
|
|
||||||
|
**`kv_connector_extra_config` 里的:**
|
||||||
|
|
||||||
|
- **`proxy_ip`**:KV 代理服务的 IP,或者要连的那台机的 IP。单机可以写 `0.0.0.0` 或 `127.0.0.1`,跨机就写对端/代理机的 IP。
|
||||||
|
- **`proxy_port`**:KV 代理服务监听的端口。P / D 配成同一个值,比如 30001。
|
||||||
|
- **`http_port`**:**Decoder vLLM HTTP 服务的端口**(就是 D 起 server 时的 `--port`)。用来让 KV 组件知道 D 的 HTTP 在哪里。
|
||||||
|
|
||||||
|
**关于 xPyD:**
|
||||||
|
|
||||||
|
一般来说 xPyd,其中每一个 p 节点或者 d 节点都要能独立加载完整个模型。
|
||||||
|
|
||||||
|
总卡数量:总 GPU 数 = (P + D) × TP × DP
|
||||||
|
|
||||||
|
最后使用 vllm 自带的代理端口转发即可:
|
||||||
|
|
||||||
|
```
|
||||||
|
python3 vllm/examples/online_serving/disaggregated_serving_p2p_nccl_xpyd/disagg_proxy_p2p_nccl_xpyd.py
|
||||||
|
```
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
> **下载说明**:本文原文含大量 CSDN 页面噪声(侧边栏推荐文章、广告、评论 UI、VIP 弹窗等),已剔除非作者内容,仅保留正文与代码;CSDN 推荐栏中出现的其他博主的 PD 分离相关文章摘要未纳入。
|
||||||
@@ -0,0 +1,80 @@
|
|||||||
|
# 📊 文章摘要:pd分离在vllm中用法
|
||||||
|
|
||||||
|
> **原文**:[2025-12-01_pd分离在vllm中用法.md](./2025-12-01_pd分离在vllm中用法.md)
|
||||||
|
> **原文链接**:https://blog.csdn.net/qq_44319972/article/details/155456852
|
||||||
|
> **来源**:CSDN 博客
|
||||||
|
> **作者**:小徐炸酱面(qq_44319972)
|
||||||
|
> **发布日期**:2025-12-01(2025-12-02 修改)
|
||||||
|
> **摘要日期**:2026-08-06
|
||||||
|
> **价值评级**:⭐⭐ 中
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 核心命题
|
||||||
|
|
||||||
|
> **KV 流转** — vLLM 中 PD 分离工程化的核心是"prefill 生成的 KV 如何让 decode 用起来",本文给出 kv-transfer-config 的参数级配置说明。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 文章概要
|
||||||
|
|
||||||
|
本文是 vLLM PD 分离的实操笔记,把部署要点收敛为一个核心问题:"prefill 生成的 KV,如何让 decode 能够用起来"。文章先定义 P 节点(Producer,看重算力/FLOPs)与 D 节点(customer,看重显存/网络带宽与 tail latency),梳理 KV 流转四步(prefill→分配 KV Block→经 KV Connector/RPC 通道传递位置信息与 metadata→decode 持续访问),再给出 1P1D 场景下 producer 与 decoder 的完整启动命令,逐项解释 kv-transfer-config 的 kv_connector/kv_role/kv_rank/kv_parallel_size/kv_buffer_size/kv_port 及 proxy 三项参数含义,并给出 xPyD 总卡数公式((P+D)×TP×DP)。价值在于参数级细节是综述类文章不具备的、可直接指导部署。局限:无性能验证,且 decoder 示例疑似复制粘贴错误,需修正后使用。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 关键要点
|
||||||
|
|
||||||
|
1. **核心即 KV 流转** — PD 分离成败在于 prefill 产出的 KV 能否高效被 decode 使用,抽象为 KV Connector/RPC 通道 + 状态约定 `[分类: 共识]`
|
||||||
|
2. **P/D 角色差异** — P 节点看重算力/GPU FLOPs,对长尾小请求不敏感;D 节点看重显存/网络带宽,关注 tail latency(TPOT、e2e) `[分类: 共识]`
|
||||||
|
3. **并行策略必须匹配** — 有 DP/TP 时 P/D 两侧并行策略须一致,否则出现 KV 维度不一致、block id 对不上等问题 `[分类: 共识]`(实操经验)
|
||||||
|
4. **kv-transfer-config 参数详解** — kv_role(producer/consumer)、kv_rank、kv_parallel_size(与 TP/world size 一致且 P/D 必须相同)、kv_buffer_size(流水深度,不确定先用 1)、kv_port 及 proxy_ip/proxy_port/http_port 的设置原则 `[分类: 共识]`(实操)
|
||||||
|
5. **xPyD 规模公式** — 总 GPU 数 = (P+D)×TP×DP;每个 P/D 节点都须能独立加载完整模型,对外经 disagg_proxy 端口转发 `[分类: 共识]`(实操)
|
||||||
|
6. **调度器拆分** — Producer 侧与 Decoder 侧各自 scheduler,以 request id、已生成 token 数、KV block id 列表、EOS/abort 状态对齐两边约定 `[分类: 共识]`
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 批判性分析
|
||||||
|
|
||||||
|
### 假设前提
|
||||||
|
|
||||||
|
假设读者已熟悉 vLLM(V1 引擎、scheduler 概念);假设 NCCL 网络与 KV 代理服务可用;假设 KV 通道数(kv_parallel_size)与 TP world size 对齐。
|
||||||
|
|
||||||
|
### 论据与逻辑
|
||||||
|
|
||||||
|
无性能数据,属经验整理而非验证性文章;Decoder 节点示例与 Producer 完全相同(vllm_PD_ROLE 与 kv_role 未改,原文已加注提示),说明示例未经实际运行验证,照抄会部署失败——这是论据链的关键缺口;但参数解释与 vLLM 官方文档一致,整体可信度尚可。
|
||||||
|
|
||||||
|
### 边界与局限
|
||||||
|
|
||||||
|
仅覆盖 P2pNcclConnector 的 1P1D(单机/双机)场景,未涉及 SharedStorage/LMCache/MultiConnector、多机大规模部署与 kv_buffer_size 调优;作者自述"示意/伪代码",不能替代官方文档。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 可引用金句
|
||||||
|
|
||||||
|
> "PD 分离的**核心**就是:**prefill 生成的 KV,如何让 decode 能够用起来**。"
|
||||||
|
|
||||||
|
> "如果有 DP/TP,P/D 侧的并行策略也要匹配(否则会出现 KV 维度不一致、block id 对不上等问题)"
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 总体评价
|
||||||
|
|
||||||
|
**亮点**:
|
||||||
|
- kv-transfer-config 各参数逐项解释,实战稀缺
|
||||||
|
- 给出可直接照做的启动命令与 xPyD 卡数公式
|
||||||
|
- 诚实标注"示意/伪代码"并提示 DP/TP 匹配等坑点
|
||||||
|
|
||||||
|
**不足**:
|
||||||
|
- decoder 示例疑似复制粘贴错误,须自行修正(角色应改为 kv_consumer)
|
||||||
|
- 无性能验证数据,经验未经实测背书
|
||||||
|
- 场景覆盖窄(仅 P2pNccl 的 1P1D)
|
||||||
|
|
||||||
|
**适用场景**:准备在 vLLM V1 上搭建 PD 分离服务的工程师,作为起步配置参考。
|
||||||
|
|
||||||
|
**关联建议**:对照 vLLM 官方文档 Disaggregated Prefilling 章节与 KV Connector API V1;参考 cr7258 文中五种 KV Connector 的对比做扩展选型。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 配图
|
||||||
|
|
||||||
|

|
||||||
@@ -0,0 +1,92 @@
|
|||||||
|
# 【大模型】深入解析大模型推理架构之 Prefill-Decode Disaggregation (PD分离)
|
||||||
|
|
||||||
|
> **来源**:CSDN 博客
|
||||||
|
> **作者**:烟锁池塘柳0
|
||||||
|
> **发布日期**:2025-07-21
|
||||||
|
> **原文链接**:https://blog.csdn.net/Zlyzjiabjw547479/article/details/149499063
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 深入解析大模型推理架构之 Prefill-Decode Disaggregation (PD分离)
|
||||||
|
|
||||||
|
### 1 从统一到分离,推理架构为何演进?
|
||||||
|
|
||||||
|
在标准的大型语言模型推理流程中,整个生成任务,从处理用户输入(Prompt)到逐字生成回答,通常都在同一个GPU上完成。这种统一式架构(Unified Architecture)虽然简单,但随着模型规模和并发请求量的激增,其固有的低效率问题逐渐暴露。
|
||||||
|
|
||||||
|
问题的根源在于,LLM推理的两个核心阶段——**Prefill**和**Decode**——在计算特性上存在根本性的差异:
|
||||||
|
|
||||||
|
1. **Prefill (预填充) 阶段**:
|
||||||
|
|
||||||
|
- **任务**: 并行处理输入的整个Prompt,为其所有Token计算Key和Value,并生成初始的KV Cache。
|
||||||
|
- **特性**: 这是**计算密集型 (Compute-Bound)** 任务。计算量巨大,涉及大量的矩阵乘法,可以充分利用GPU强大的并行计算能力(高TFLOPS)。处理一个包含512个Token的Prompt,其计算量可能相当于生成512个Decode步骤的总和。
|
||||||
|
2. **Decode (解码) 阶段**:
|
||||||
|
|
||||||
|
- **任务**: 逐个生成输出Token。每次只处理一个Token,但需要加载整个模型权重和不断增长的KV Cache。
|
||||||
|
- **特性**: 这是**内存带宽密集型 (Memory-Bandwidth-Bound)** 任务。单步计算量小,但需要频繁、大量地从GPU显存中读写数据。其瓶颈在于显存的带宽,而非GPU的计算核心。
|
||||||
|
|
||||||
|
> 关于大模型推理中的Prefill、Decode与KV Cache等概念的介绍,请参考我的这篇文章:【大模型】大模型推理中的Prefill、Decode与KV Cache详解 。
|
||||||
|
|
||||||
|
在统一式架构中,昂贵且计算能力强大的GPU在执行Decode任务时,其计算单元大部分时间处于空闲状态,等待数据从显存中加载,造成了巨大的资源浪费。反之,当GPU忙于一个长Prompt的Prefill时,其他等待Decode的短任务则必须排队,导致系统整体响应变慢。
|
||||||
|
|
||||||
|
为了解决这种资源错配和效率瓶颈,**Prefill-Decode分离(PD分离)**的思想应运而生。其核心目标是:**为不同计算特性的任务匹配最合适的硬件资源,实现系统整体性能的最大化。**
|
||||||
|
|
||||||
|
### 2 什么是Prefill-Decode分离?
|
||||||
|
|
||||||
|
**Prefill-Decode分离**是一种先进的LLM服务架构,它将推理过程中的Prefill和Decode两个阶段,从物理上或逻辑上调度到不同的、专门优化的硬件集群(或资源池)中执行。
|
||||||
|
|
||||||
|
一个典型的PD分离系统架构如下:
|
||||||
|
|
||||||
|
- **路由/调度器 (Router/Scheduler)**: 系统的"大脑",负责接收所有请求,并根据请求类型(是新的Prompt还是正在进行的生成任务)将其分发到合适的集群。
|
||||||
|
- **Prefill集群**: 由少量但计算能力极强的GPU(如NVIDIA H100/H200)组成,专门用于高效地处理新请求的Prefill阶段。
|
||||||
|
- **Decode集群**: 由大量GPU组成,这些GPU可能算力不是最顶尖,但拥有高内存带宽(如NVIDIA A100),性价比更高,专门用于处理Decode阶段。
|
||||||
|
- **KV Cache传输层**: 这是连接两个集群的桥梁,通常是基于高速网络(如RDMA、NVLink)的分布式内存系统或高速网络文件系统,用于在Prefill和Decode节点之间快速传递KV Cache。
|
||||||
|
|
||||||
|
### 3 PD分离系统的工作流程
|
||||||
|
|
||||||
|
一个用户请求在PD分离架构中的生命周期如下:
|
||||||
|
|
||||||
|
1. **请求到达与Prefill调度**: 用户的新请求(包含Prompt)到达系统。调度器识别出这是一个需要Prefill的任务,并将其分配给Prefill集群中的一个空闲节点。
|
||||||
|
2. **Prefill执行**: Prefill节点接收到Prompt后,利用其强大的并行计算能力,对Prompt中的所有Token进行一次批处理计算,生成初始的KV Cache和响应的第一个Token。
|
||||||
|
3. **KV Cache迁移 (核心步骤)**: Prefill任务完成后,生成的KV Cache(可能高达数GB)以及相关的请求状态信息,被迅速打包并通过高速传输层从Prefill节点发送出去。
|
||||||
|
4. **Decode调度与执行**: 与此同时,调度器将这个"已预处理"的请求(现在携带了KV Cache的引用或实体)分配给Decode集群中的一个可用节点。Decode节点加载这个KV Cache,然后进入自回归生成循环。在每一步,它只为新的一个Token进行计算,从显存中读取模型权重和完整的KV Cache,然后将新生成的(K,V)对追加到Cache中,并将生成的Token流式传输给用户。
|
||||||
|
5. **生成结束与资源释放**: 当生成过程完成(例如,模型输出了结束符`[EOS]`),结果被完整地返回给用户。Decode节点上为该请求分配的资源,特别是宝贵的KV Cache显存,被立即释放,以便服务于下一个等待中的Decode任务。
|
||||||
|
|
||||||
|
### 4 PD分离的优势
|
||||||
|
|
||||||
|
1. **极致的资源利用率与性价比**: 可以为Prefill配置少量昂贵的顶级算力卡,为Decode配置大量性价比更高的带宽型卡。硬件成本可以得到显著优化,避免了让昂贵的计算单元在Decode阶段"无所事事"。
|
||||||
|
2. **更高的系统吞吐量**: 解耦了Prefill和Decode的执行过程。Prefill集群可以持续不断地处理新涌入的请求(提高系统接纳新用户的能力),而Decode集群则专注于为大量并发用户快速生成后续Token。两者互不阻塞,系统整体的并发处理能力(Throughput)大幅提升。
|
||||||
|
3. **灵活的扩展性 (Scalability)**: 可以根据业务负载的实际情况独立扩展两个集群。如果业务场景多为长篇问答(长Prompt),可以增加Prefill集群的节点;如果多为简短的聊天(长对话历史),则可以增加Decode集群的节点。
|
||||||
|
4. **优化的延迟表现**:
|
||||||
|
|
||||||
|
- **降低首字延迟 (TTFT)**: 专用的Prefill集群可以通过更大的批处理(Batching)规模,更高效地处理Prompt,从而加快第一个Token的生成速度。
|
||||||
|
- **保障字间延迟**: Decode集群的专用性确保了正在生成中的任务不会被耗时长的Prefill任务抢占,从而获得稳定、快速的后续Token生成体验。
|
||||||
|
|
||||||
|
### 5 挑战与相应的解决方案
|
||||||
|
|
||||||
|
PD分离架构虽好,但也带来了新的技术挑战:
|
||||||
|
|
||||||
|
- **挑战1: KV Cache传输开销**
|
||||||
|
|
||||||
|
- **问题**: KV Cache可能非常大,在不同物理节点间传输它会引入不可忽视的延迟,可能抵消掉分离带来的部分收益。
|
||||||
|
- **解决方案**:
|
||||||
|
- **硬件层面**: 采用支持RDMA(远程直接内存访问)的InfiniBand或RoCE等超低延迟网络。
|
||||||
|
- **软件层面**: 使用**KV Cache量化**,例如将FP16的Cache压缩为INT8或INT4,显著减小其体积。
|
||||||
|
- **调度层面**: 设计智能调度算法,尝试将同一个长对话的连续轮次的Prefill和Decode任务调度到物理位置相近的节点上。
|
||||||
|
- **挑战2: 复杂的调度系统**
|
||||||
|
|
||||||
|
- **问题**: 调度器需要管理两个异构资源池,并处理任务在它们之间的状态交接,其设计和实现复杂度远高于传统调度器。
|
||||||
|
- **解决方案**: 需要构建一个全局的、状态感知的调度系统。该系统不仅要监控节点负载,还要能够预测任务时长,并对KV Cache的传输进行协同调度,以实现全局最优。
|
||||||
|
- **挑战3: 资源孤岛与负载均衡**
|
||||||
|
|
||||||
|
- **问题**: 如果流量模式剧烈变化,可能导致一个集群(如Prefill)过载,而另一个(Decode)处于空闲,形成暂时的资源孤岛。
|
||||||
|
- **解决方案**: 引入**动态资源分配**机制,允许部分硬件根据需要灵活地在Prefill和Decode角色之间切换。或者,采用更精准的负载预测模型来提前调整资源池大小。
|
||||||
|
|
||||||
|
### 6 总结与展望
|
||||||
|
|
||||||
|
Prefill-Decode分离是LLM推理系统从"作坊式"走向"工业化"的重要一步。它体现了计算体系结构中的一个经典思想:**用专门化的组件处理专门化的任务**。通过将Prefill的计算密集型特性与Decode的访存密集型特性解耦,并为之匹配最优化的硬件,PD分离架构能够显著提升大型语言模型服务的吞吐量、降低成本,并优化延迟。
|
||||||
|
|
||||||
|
虽然实现上存在挑战,但随着Orca、Sarathi等研究系统的提出和业界实践的深入,PD分离正逐渐成为超大规模AI计算中心的主流架构范式。未来,它还将与投机性解码(Speculative Decoding)、模型混合(MoE)等更多先进技术融合,共同推动AI普惠化的进程。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
**标签**:#人工智能 #深度学习 #语言模型
|
||||||
+80
@@ -0,0 +1,80 @@
|
|||||||
|
# 📊 文章摘要:【大模型】深入解析大模型推理架构之 Prefill-Decode Disaggregation (PD分离)
|
||||||
|
|
||||||
|
> **原文**:[2025-07-21_大模型_深入解析大模型推理架构之_Prefill-Decode_Disaggregation_(PD分离).md](./2025-07-21_大模型_深入解析大模型推理架构之_Prefill-Decode_Disaggregation_(PD分离).md)
|
||||||
|
> **原文链接**:https://blog.csdn.net/Zlyzjiabjw547479/article/details/149499063
|
||||||
|
> **来源**:CSDN 博客
|
||||||
|
> **作者**:烟锁池塘柳0
|
||||||
|
> **发布日期**:2025-07-21
|
||||||
|
> **摘要日期**:2026-08-06
|
||||||
|
> **价值评级**:⭐⭐ 中
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 核心命题
|
||||||
|
|
||||||
|
> **异质配型** — PD 分离的本质是"为不同计算特性的任务匹配最合适的硬件资源",是计算机体系结构中专门化思想的 LLM 服务化应用。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 文章概要
|
||||||
|
|
||||||
|
本文用"统一到分离"的演进叙事讲清 PD 分离:prefill 计算密集(处理 512 token 的计算量约等于 512 步 decode 的总和),decode 内存带宽密集,统一架构下 GPU 计算单元在 decode 阶段大部分空闲、长 prompt 的 prefill 又令短任务排队,故按阶段分配异构硬件——少量顶级算力卡(H100/H200 类)做 prefill、大量高带宽性价比卡(A100 类)做 decode,中间以高速 KV Cache 传输层衔接。价值在于把技术架构提炼为"用专门化的组件处理专门化的任务"的经典思想,并完整梳理五步工作流、四大优势与三大挑战及对策。局限:全定性论述、无实验数据,挑战对策停留在概念层。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 关键要点
|
||||||
|
|
||||||
|
1. **统一架构的资源错配** — 昂贵 GPU 在 decode 阶段计算单元大部分空闲等待显存加载;长 prompt prefill 令等待 decode 的短任务排队 `[分类: 共识]`
|
||||||
|
2. **异构硬件匹配** — Prefill 集群用少量顶级算力卡、Decode 集群用大量高带宽性价比卡,避免昂贵计算单元"无所事事" `[分类: 共识]`
|
||||||
|
3. **五步工作流** — 请求调度→prefill 执行→KV Cache 迁移(核心步骤,可能高达数 GB)→decode 执行→结束释放 `[分类: 共识]`
|
||||||
|
4. **四大优势** — 资源利用率与性价比、解耦提升吞吐、两集群独立扩展、TTFT/TPOT 延迟优化 `[分类: 共识]`
|
||||||
|
5. **三大挑战与对策** — KV 传输开销(RDMA 网络/KV Cache 量化/位置亲和调度)、复杂调度(全局状态感知)、资源孤岛(动态角色切换/负载预测) `[分类: 共识]`
|
||||||
|
6. **未来融合方向** — 与投机解码(Speculative Decoding)、MoE 等先进技术融合,推动 AI 普惠化 `[分类: 未探索]`
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 批判性分析
|
||||||
|
|
||||||
|
### 假设前提
|
||||||
|
|
||||||
|
假设大规模集群场景使"少量 P 卡 + 大量 D 卡"的分工有意义;假设 RDMA 网络、KV Cache 量化等补偿手段的代价可接受;假设流量模式允许两集群独立扩展。
|
||||||
|
|
||||||
|
### 论据与逻辑
|
||||||
|
|
||||||
|
全为定性论证,无量化数据支撑"显著提升";挑战与对策是概念性列举(如 KV 量化未讨论精度损失、调度方案未讲实现),但"差异→错配→解耦→新挑战"的逻辑链完整清晰,适合建立直觉。
|
||||||
|
|
||||||
|
### 边界与局限
|
||||||
|
|
||||||
|
未讨论小规模部署与成本门槛、未对比 chunked-prefills 等替代架构;硬件建议仅覆盖 NVIDIA 生态,对国产卡与其他厂商不适用;KV 量化精度影响、调度器复杂度等只提问题不给权衡。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 可引用金句
|
||||||
|
|
||||||
|
> "Prefill-Decode分离是LLM推理系统从'作坊式'走向'工业化'的重要一步。"
|
||||||
|
|
||||||
|
> "它体现了计算体系结构中的一个经典思想:**用专门化的组件处理专门化的任务**。"
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 总体评价
|
||||||
|
|
||||||
|
**亮点**:
|
||||||
|
- 以"专门化"思想统摄全文,认知框架清晰,适合入门
|
||||||
|
- 五步工作流与三大挑战归纳完整,结构性强
|
||||||
|
- 硬件选型建议(顶级算力卡与高带宽卡分工)具有参考价值
|
||||||
|
|
||||||
|
**不足**:
|
||||||
|
- 无实验数据,结论均定性
|
||||||
|
- 挑战对策停留在概念层,无实现细节
|
||||||
|
- 未涉及开源框架落地与国产硬件
|
||||||
|
|
||||||
|
**适用场景**:对 LLM 推理架构零基础的工程师、学生建立 PD 分离整体认知。
|
||||||
|
|
||||||
|
**关联建议**:阅读 cr7258《PD 分离推理架构详解》获取论文数据与 vLLM 实现细节;跟进 DistServe、Splitwise、Mooncake 论文原文。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 配图
|
||||||
|
|
||||||
|

|
||||||
@@ -0,0 +1,413 @@
|
|||||||
|
# Lesson 06:PD 分离推理架构详解(AI Infra 学习课程)
|
||||||
|
|
||||||
|
> **来源**:GitHub
|
||||||
|
> **作者**:cr7258(ai-infra-learning 仓库)
|
||||||
|
> **发布日期**:2026-08-06
|
||||||
|
> **原文链接**:https://github.com/cr7258/ai-infra-learning/tree/main/lesson/06-disaggregating-prefill-and-decoding
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## PD 分离推理架构详解
|
||||||
|
|
||||||
|
在大语言模型推理过程中,prefill 阶段和 decode 阶段具有截然不同的计算特性:
|
||||||
|
|
||||||
|
- prefill 阶段需要并行处理整个输入序列来生成首个 token,属于**计算密集型**操作。
|
||||||
|
- decode 阶段则逐个生成后续 token,需要频繁访问 KV cache,属于**内存密集型**操作。
|
||||||
|
|
||||||
|
传统的 continuous batching 将两个阶段混合处理,导致相互干扰,难以同时满足 TTFT(首 token 延迟)和 TPOT(token 间延迟)的严格要求。为了解决这一问题,PD 分离架构应运而生,通过将 prefill 和 decode 分配到不同的 GPU 实例上,针对各自特性进行专门优化。这种分离式设计不仅消除了阶段间的干扰,还能显著提升系统的有效吞吐量(Goodput),为大规模 LLM 服务提供了更优的解决方案。
|
||||||
|
|
||||||
|
## 1 吞吐量(Throughput)vs 有效吞吐量(Goodput)
|
||||||
|
|
||||||
|
目前,大多数 LLM 服务系统(如 vLLM、TensorRT-LLM)都以吞吐量(Throughput)作为主要性能指标——即单位时间内处理的请求数(RPS)或生成的 token 数。这种度量方式直观,并且与成本($/req)有直接关联,因此被广泛采用。
|
||||||
|
|
||||||
|
实际上,下游应用的类型多种多样,它们在用户体验上的延迟需求各异,因此需要满足的服务等级目标(SLO)也存在显著差异。大模型服务中最常用的 SLO 包括:
|
||||||
|
|
||||||
|
- **TTFT (Time To First Token)**:首 token 响应延迟,直接影响用户的等待体验。
|
||||||
|
- **TPOT (Time Per Output Token)**:衡量两个连续生成的 token 之间的平均延迟,决定交互的流畅程度。
|
||||||
|
|
||||||
|
例如,实时聊天机器人更关注低 TTFT 以保证响应及时,而 TPOT 只需快于人类阅读速度(约 250 词/分钟)即可;相反,文档摘要则更强调低 TPOT,以便更快地产生完整摘要。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
单纯依赖 Throughput 作为指标,并不能反映延迟表现,系统看似处理了大量请求,但其中不少未能满足 SLO,最终呈现给用户的仍是不理想的服务体验。
|
||||||
|
|
||||||
|
- **Throughput(吞吐量)**:通常指系统单位时间内处理的 token 数或请求数。很多工作把"提高吞吐量"作为主要优化目标,但在实际场景下,这并不直接代表用户体验。
|
||||||
|
- **Goodput(有效吞吐量)**:指系统在满足延迟约束(如 TTFT/TPOT SLO)的前提下,真正完成的请求数量。如果一个请求因为延迟过长而被用户放弃,或者超过服务约束而无效,那么即便它产生了 token,也不能算作有效产出。
|
||||||
|
|
||||||
|
在 DistServe 论文中,引入了 Goodput 概念,**即在满足 SLO(TTFT 和 TPOT 要求)的前提下,每秒完成的有效请求数**。与单纯的吞吐量相比,Goodput 是更优的衡量指标,**因为它能够体现请求在满足 SLO 情况下的吞吐水平**,从而同时反映成本效益与服务质量。
|
||||||
|
|
||||||
|
为了简要说明 Goodput,假设某个应用要求至少 90% 的请求满足 TTFT < 200ms 且 TPOT < 50ms,则可以得到如下定义:
|
||||||
|
|
||||||
|
> Goodput (P90 TTFT < 200ms 且 P90 TPOT < 50ms) 表示在至少 90% 的请求同时满足 TTFT < 200ms 和 TPOT < 50ms 的条件下,系统所能维持的最大每秒请求数。
|
||||||
|
|
||||||
|
下图展示了一个简单的例子:某应用的吞吐量为 10 RPS(每秒请求数),但由于延迟约束的限制,只有 3 RPS 的请求满足 SLO,因此该系统的 Goodput 仅为 3 RPS。可以想象,用户在这样一个高吞吐但低 Goodput 的系统中,依然会感受到较差的服务体验。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
## 2 Prefill 与 Decode 共置导致干扰
|
||||||
|
|
||||||
|
在 LLM 服务中请求的生命周期通常包含两个阶段:prefill(生成首个 token)和 decode(逐步生成后续 token)。大多数现有系统(如 vLLM、TensorRT-LLM)采用 continuous batching 技术,将 prefill 和 decode 混合在一起统一批处理。这种方式确实能够提升整体吞吐量,但由于两者计算特性和 SLO 目标差异显著,将它们共置在同一 GPU 上往往并不理想。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
如下图所示,continuous batching 会带来明显的干扰。**当 prefill 和 decode 被放在同一批次时,decode 请求的延迟(TPOT)会被显著拉长,而 prefill 请求的首 token 延迟(TTFT)也会有所增加。**
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
图中展示了三种不同的执行方式:
|
||||||
|
|
||||||
|
- 1P+nD(棕色柱子):1 个 prefill 与 n 个 decode 混合批处理。
|
||||||
|
- nD(蓝色柱子):仅包含 decode 请求的批处理。
|
||||||
|
- prefill-only(红色虚线):仅运行 prefill 请求的延迟。
|
||||||
|
|
||||||
|
**在 prompt 长度为 128 时,相比仅包含 decode 的请求,延迟增加约 1.8 倍;而当 prompt 长度为 1024 时,干扰效应显著放大,decode 延迟提升至 12.6 倍。**
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
由于这种干扰,如下图所示,当服务必须同时满足 TTFT 和 TPOT 的 SLO 时,**系统往往需要进行资源的过度配置才能达到延迟目标**,尤其是在任一 SLO 要求较严格的情况下。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
## 3 PD 分离的整体思路
|
||||||
|
|
||||||
|
直观的思路很简单:将 prefill 和 decode 分离到不同的 GPU 上,并为每个阶段定制并行策略。这自然解决了前面提到的两个问题:
|
||||||
|
|
||||||
|
- **没有干扰**:prefill 和 decode 各自独立运行,更快地完成计算,也更容易满足各自的 SLO。
|
||||||
|
- **资源分配与并行策略解耦**:可以针对 prefill 和 decode 分别进行优化。
|
||||||
|
|
||||||
|
下图展示了在这样一个分离式系统中,请求是如何被处理的。当一个请求到达系统时,它会先被分配到 prefill worker 完成 prefill 阶段;随后系统将其中间状态(主要是 KV Cache)迁移到 decode worker,并执行多步 decode 以生成后续 token;当生成完成后,请求才会离开系统。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
让我们通过一个简单的实验来看看为什么 PD 分离是有益的。我们在一张 A100-80GB GPU 上运行一个 130 亿参数的 LLM,请求到达服从泊松分布,输入长度为 512,输出长度为 64。我们逐步增加请求速率(x 轴),并在下图测量两类延迟(P90 TTFT 和 P90 TPOT,y 轴)的变化。
|
||||||
|
|
||||||
|
假设我们设定 SLO:P90 TTFT = 0.4 秒,P90 TPOT = 0.04 秒(下图中的横线)。实验结果表明:在单卡情况下,现有系统大约可以在 3 rps 下满足 TTFT 的延迟约束,而 TPOT 只能维持在 1.6 rps(下图左边)。由于必须同时满足两个约束条件,现有共置系统的 Goodput = min(3, 1.6) = 1.6 rps/GPU。
|
||||||
|
|
||||||
|
在分离之后,性能得到了显著提升。如果单独处理一个阶段,prefill worker 和 decode worker 的 rps 都优于之前的结果 —— 如下图右边所示,一个 prefill worker 大约可达到 5.6 rps,一个 decode worker 大约可达到 10 rps。更重要的是,我们现在可以灵活地分配资源,例如配置 2 个 prefill worker + 1 个 decode worker(记作 2P1D),共 3 张 GPU。此时:
|
||||||
|
|
||||||
|
```
|
||||||
|
Goodput (2P1D) = min(5.6 × 2, 10) = 10 reqs/s ÷ 3 GPUs ≈ 3.3 rps/GPU。
|
||||||
|
```
|
||||||
|
|
||||||
|
这个实验表明,即便没有引入任何并行优化,仅仅通过简单的分离,Goodput 就提升了约 2 倍。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
## 4 分离式推理架构的优化方向
|
||||||
|
|
||||||
|
### 4.1 算力与存储
|
||||||
|
|
||||||
|
- prefill 阶段:拥有**计算受限**的性质(compute-bound),特别是在请求流量较大,用户的 prompt 也比较长的情况下。prefill 阶段算完 KV cache 并发给 decode 阶段后,理论上 prefill 就不再需要这个 KV cache 了(当然你也可以采用 LRU 等策略对 KV cache 的保存做管理,而不是一股脑地清除)。
|
||||||
|
- decode 阶段:拥有**内存受限**的性质(memory-bound),因为逐个 token 的生成方式,decode 阶段要频繁从内存中读取 KV Cache,同时也意味着它需要尽可能保存 KV cache。
|
||||||
|
|
||||||
|
因此在分离式框架下,计算和存储可以朝着两个独立的方向做优化。
|
||||||
|
|
||||||
|
### 4.2 Batching 策略
|
||||||
|
|
||||||
|
- prefill 阶段:随着 batch size 的增加,吞吐量的提升很快趋于平缓。这是因为 prefill 属于 compute-bound,当 batch 中的总 tokens 数超过一定规模后,GPU 的计算能力已经被完全吃满,再增加请求只会延长整体处理时间,而不会带来明显的吞吐提升。
|
||||||
|
- decode 阶段:随着 batch size 的增加,吞吐量的增长趋势越来越显著。这是因为 decode 阶段是 memory-bound,即相比于计算,读写数据的时间要更多。所以在 decode 阶段中,如果我们能提升 batch size,就能把计算强度提起来,吞吐量就上去了。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
在分离架构下,我们可以针对 prefill 和 decode 的特性对 batching 策略分别进行优化:
|
||||||
|
|
||||||
|
- 具体来说,对于 prefill 实例,需要事先结合特定的 LLM 和 GPU 做性能分析,找出输入长度的临界点——一旦超过这个点,prefill 就会进入 compute-bound,此时增加 batch size 只会拖慢整体处理速度。在实际应用中,用户的 prompt 往往已有数百个 tokens,因此 **prefill 的 batch size 通常保持较小**。
|
||||||
|
- **相对地,decode 阶段更适合采用较大的 batch size,以充分提升 GPU 利用率和整体吞吐。**
|
||||||
|
|
||||||
|
### 4.3 并行策略
|
||||||
|
|
||||||
|
由于 prefill 和 decode 具有不同的计算模式和延迟目标,这两个阶段的最佳并行策略通常并不相同。例如,当 TTFT 要求严格而 TPOT 要求相对宽松时,prefill 更适合采用**张量并行**来满足低延迟,而 decode 则通常采用**数据并行**或**流水线**并行来提升吞吐。
|
||||||
|
|
||||||
|
## 5 KV Cache 传输
|
||||||
|
|
||||||
|
PD 分离带来的代价是需要在 prefill 和 decode 的 GPU 之间传输中间状态(即 KV cache)。接下来,我们来看看 KV cache 传输的开销分析、传输方式以及相关的优化策略。
|
||||||
|
|
||||||
|
### 5.1 KV Cache 传输开销
|
||||||
|
|
||||||
|
初看之下,KV cache 是 LLM 推理中巨大的内存开销,而 GPU 之间 KV cache 的传输似乎会成为瓶颈。然而,DistServe 的论文中展示了相反的结果:通过合理的放置,KV Cache 的传输开销可以被有效地最小化,甚至低于一次 decode 步骤的时间,这得益于当今高速互联网络(如 NVLink 和 PCI-e 5.0)。
|
||||||
|
|
||||||
|
假设我们在 GPU 之间使用 8 通道 PCIe 5.0 x16(每条链路 64GB/s)作为节点内互联。对于一个包含 2048 tokens 的请求,在服务 OPT-175B 时传输 KV cache 的延迟可以估算如下:
|
||||||
|
|
||||||
|
```
|
||||||
|
Latency = 2048 tokens * (4.5 MB/token) / (64GB/s * 8) = 17.6 ms
|
||||||
|
```
|
||||||
|
|
||||||
|
对于 OPT-175B,延迟小于单次 decode 步骤(在 A100 上约为 30-50 毫秒)。对于更大的模型、更长的序列或更先进的网络(例如带宽为 600GB/s 的 A100-NVLink),如下图所示,与单次 decode 步骤相比,KV cache 传输相关的相对开销变得不那么显著。总之,通过精心安排 prefill 和 decode 工作节点以利用高带宽网络,可以有效隐藏 KV cache 传输的开销。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
### 5.2 KV Cache 传输方式
|
||||||
|
|
||||||
|
目前 KV cache 的传输主要有两种方式:**中心存储**和**点对点(P2P)**,当然在实际系统中也可能采用二者结合的混合方案。
|
||||||
|
|
||||||
|
- **中心存储**:建立一个跨设备的 KV store,由它统一管理 KV cache 的增、删、查和传递等操作。prefill 和 decode 实例只需与这个 KV store 交互,负责写入或读取数据。
|
||||||
|
- **P2P 传输**:每个实例独立管理自己的存储。例如,一个 prefill 实例完成计算后,会直接与目标 decode 实例建立通信,将 KV cache 传过去,不依赖统一的中介。
|
||||||
|
|
||||||
|
两种方式各有优劣:
|
||||||
|
|
||||||
|
- **中心存储**:更适合构建大规模集群,能充分利用多种存储介质和传输通道,并提升计算结果的复用效率,但在某些场景下性能可能受限,同时系统维护成本较高。
|
||||||
|
- **P2P 传输**:架构更简单,性能表现通常更好,但在扩展性和链路稳定性方面会面临挑战。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
### 5.3 KV Cache 传输的网络堆栈
|
||||||
|
|
||||||
|
现有的物理数据链路可以分为 3 类:
|
||||||
|
|
||||||
|
- **Direct**,即 GPU 之间通过高速直连链路(如 NVLink 或 HCCS)相互连接。在这种情况下,可以利用底层的内存拷贝原语或集体通信库来完成数据传输。
|
||||||
|
- **Direct-NIC**,即 GPU 通过其配套的网卡(NIC)进行通信。在这里,可以使用定制化的库,通过 PCIe 和以太网(或 InfiniBand)进行数据传输。
|
||||||
|
- **Indirect**,即当 GPU 之间没有直接链路时,必须通过其 CPU 的 DRAM 中转数据,从而带来额外的内存拷贝开销。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
图片来源:Inference without Interference: Disaggregate LLM Inference for Mixed Downstream Workloads
|
||||||
|
|
||||||
|
### 5.4 KV Cache 传输粒度
|
||||||
|
|
||||||
|
KV cache 传输粒度可以分为 3 类:
|
||||||
|
|
||||||
|
- **请求级**:等到 prefill 阶段完成后,将 KV cache 一次性传输。这种方式的好处是能够减少网络传输次数,因为每次传输的数据量更大,从而降低了通信开销。然而当 KV cache 大小较大时,会影响 TTFT 的延迟。
|
||||||
|
- **层级**:Splitwise 通过在 prefill 阶段的计算与 KV cache 传输之间实现重叠来优化性能。**每一层计算完成后,都会异步传输该层的 KV cache,同时继续执行下一层的计算,从而降低传输开销。**层级传输还能带来额外优势,例如更早启动 decode 阶段,以及更早释放 prefill 端的内存。层级 KV cache 传输与下一层的 prefill 计算并行进行,这需要逐层的细粒度同步以确保正确性,因此可能会带来性能干扰并增加 TTFT,尤其是在小 prompt 的场景下。不过对于小 prompt 来说,KV cache 的总体规模很小,不需要层级传输来隐藏延迟。由于在计算开始时批次中的 token 数已经是已知的,**Splitwise 会选择最合适的 KV cache 传输方式:小 prompt 使用序列化传输,而大 prompt 使用层级传输。**
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
图片来源:Splitwise: Efficient Generative LLM Inference Using Phase Splitting
|
||||||
|
|
||||||
|
- **块级**:TetriInfer 在 PD 分离的基础上,还会将输入的 prompt 划分为固定大小的 chunk,以便让 GPU 始终运行在接近计算饱和的状态。因此,TetriInfer 论文中也提出了基于块级的 KV cache 传输方案。
|
||||||
|
|
||||||
|
## 6 vLLM 的 PD 分离
|
||||||
|
|
||||||
|
vLLM 提供了 **KV Connector** 作为管理实例间 KV cache 交换的抽象层,它提供统一接口来实现 KV cache 的保存、加载与传输,使不同的 vLLM 实例(如 prefill 与 decode 实例)能够高效共享计算结果。通过实现这一接口,各类 connector(例如通过文件系统的 SharedStorageConnector、通过网络的 NixlConnector 等)提供了灵活的 KV cache 传输方案,从而支持 PD 分离等高级功能。
|
||||||
|
|
||||||
|
`KVConnectorBase_V1` 是所有 connector 的基类。它是一个抽象基类,定义了以下 API:
|
||||||
|
|
||||||
|
- scheduler 侧方法:
|
||||||
|
- build_connector_meta:构建元数据,scheduler 告诉 worker 需要保持/加载哪些 KV cache。
|
||||||
|
- get_num_new_matched_tokens:获取远端已计算的 KV cache 的 token 数量。
|
||||||
|
- update_state_after_alloc:block 开辟后,更新 connector 的状态。
|
||||||
|
- worker 侧方法:
|
||||||
|
- **start_load_kv**:从 connector buffer 加载 KV cache,消费端调用。
|
||||||
|
- wait_for_layer_load:阻塞直到指定层加载结束,消费端调用;
|
||||||
|
- **save_kv_layer**:将 vLLM 的 KV buffer 中某一层的 KV cache 保存到 connector buffer 中,生产端调用。
|
||||||
|
- wait_for_save:阻塞直到所有保存操作完成,生产端调用。
|
||||||
|
|
||||||
|
vLLM v1 中 connector 有两个执行角色(Role):scheduler_connector 和 worker_connector,分别在 scheduler 线程和 worker 线程中执行。**scheduler 负责指挥 worker 进行 KV cache 的传递,两者之间的信息桥梁是元数据(KVConnectorMetadata),worker 通过 metadata 知道哪些 KV 值需要从远端加载。**
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
当前 vLLM 支持 5 种类型的 connector,分别是:
|
||||||
|
|
||||||
|
- **SharedStorageConnector**:SharedStorageConnector 是 vLLM 中最简单的 KV Connector 实现,它通过共享文件系统(如本地磁盘或 NFS)在 prefill 和 decode 实例之间传递 KV cache,使用 MD5 哈希生成唯一文件名来存储和检索每个请求的 KV cache。prefill 实例将每层的 KV cache 序列化为 SafeTensors 格式保存到指定路径,decode 实例根据相同的 token_ids 计算哈希值找到对应文件并加载,整个过程没有显式的网络传输,完全依赖文件系统的读写操作。
|
||||||
|
- **P2pNcclConnector**:P2pNcclConnector 是基于 NCCL(NVIDIA Collective Communications Library)实现的高性能 KV Connector,它通过 NCCL 的 send/recv 原语实现 KV cache 在不同 GPU 之间的点对点传输,避免了文件系统的开销。
|
||||||
|
- **NixlConnector**:NixlConnector 使用 NIXL(NVIDIA Inference Xfer Library)库来加速 GPU 之间以及异构内存与存储之间的 KV cache 传输。
|
||||||
|
- **LMCacheConnectorV1**:通过与 LMCache 集成实现 KV cache 的外部存储和检索,支持多种存储后端(如 CPU 内存、本地文件系统、Redis、InfiniStore 等)。LMCache 通过重用缓存的 KV cache 来减少推理时间,消除冗余计算,适用于跨请求或跨会话的 KV cache 共享场景。
|
||||||
|
- **MultiConnector**:允许同时使用多个 KV connector 来实现 KV cache 的传输,它的核心逻辑是从第一个能提供可用 token 的 connector 加载 KV cache,但会向所有 connector 保存数据。MultiConnector 适用于需要同时向多个存储后端保存 KV cache 的场景,比如同时保存到本地存储和远程存储,提供数据冗余和可靠性保障。
|
||||||
|
|
||||||
|
```json
|
||||||
|
--kv-transfer-config '{
|
||||||
|
"kv_connector": "MultiConnector",
|
||||||
|
"kv_connector_extra_config": {
|
||||||
|
"connectors": [
|
||||||
|
{
|
||||||
|
"kv_connector": "NixlConnector",
|
||||||
|
"kv_role": "kv_both"
|
||||||
|
},
|
||||||
|
{
|
||||||
|
"kv_connector": "SharedStorageConnector",
|
||||||
|
"kv_connector_extra_config": {
|
||||||
|
"shared_storage_path": "local_storage"
|
||||||
|
},
|
||||||
|
"kv_role": "kv_both"
|
||||||
|
}
|
||||||
|
]
|
||||||
|
},
|
||||||
|
"kv_role": "kv_both"
|
||||||
|
}'
|
||||||
|
```
|
||||||
|
|
||||||
|
以上几个 connector 的运行实例代码可以在这里找到:https://docs.vllm.ai/en/latest/features/disagg_prefill.html#usage-example
|
||||||
|
|
||||||
|
## 7 PD 分离工业界项目
|
||||||
|
|
||||||
|
### 7.1 Mooncake
|
||||||
|
|
||||||
|
Mooncake 是 Moonshot AI 提供的领先大模型服务 Kimi 的推理平台。Mooncake 是 PD 分离应用比较早也是规模比较大的成功例子:
|
||||||
|
|
||||||
|
- Mooncake 采用了以 KV cache 为核心的解耦架构,将 prefill 集群与 decode 集群分离。
|
||||||
|
- 同时,它还利用 GPU 集群中未被充分利用的 CPU、DRAM 和 SSD 资源,实现了解耦式的 KV cache 缓存。
|
||||||
|
- Mooncake 的核心是一个以 KV cache 为中心的调度器,它在最大化整体有效吞吐量和满足延迟相关的 SLO 之间进行平衡。
|
||||||
|
- 与传统假设所有请求都会被处理的研究不同,Mooncake 需要应对高负载场景带来的挑战。为此,Mooncake 提出了一种基于预测的早期拒绝策略。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
图片来源:Mooncake: A KVCache-centric Disaggregated Architecture for LLM Serving
|
||||||
|
|
||||||
|
实验结果表明,Mooncake 在长上下文场景下表现尤为突出:在某些模拟场景中,吞吐量相比基线方法最高可提升 525%,同时仍能满足 SLO。在真实负载下,Mooncake 的创新架构使 Kimi 能够多处理 75% 的请求。
|
||||||
|
|
||||||
|
使用 Mooncake 运行 PD 分离服务请参考文档:vLLM V1 Disaggregated Serving with Mooncake Store and LMCache
|
||||||
|
|
||||||
|
### 7.2 Dynamo
|
||||||
|
|
||||||
|
NVIDIA Dynamo 是一个开源的模块化推理框架,用于在分布式环境上实现生成式 AI 模型的服务化部署。Dynamo 通过动态资源调度、智能路由、内存优化与高速数据传输,无缝扩展大型 GPU 集群之间的推理工作负载。
|
||||||
|
|
||||||
|
Dynamo 采用推理引擎无关的设计(支持 TensorRT-LLM、vLLM、SGLang 等),包括以下 4 个核心组件:
|
||||||
|
|
||||||
|
- **NVIDIA Dynamo Planner**:一个智能规划和调度引擎,用于监控分布式推理中的容量与延迟,并在 prefill 与 decode 阶段之间灵活分配 GPU 资源,以最大化吞吐量和效率。Planner 会持续跟踪关键的 GPU 容量指标,并结合应用的 SLO(如 TTFT 和 ITL),智能决策是否采用分离式推理,或是否需要为 prefill/decode 阶段动态增加更多 GPU。
|
||||||
|
- **NVIDIA Dynamo Smart Router**:KV cache 感知的路由引擎,可在分布式推理环境中将请求转发到最佳的节点,从而最大限度减少 KV cache 的重复计算开销。
|
||||||
|
- **NVIDIA Dynamo Distributed KV Cache Manager**:通过将较旧或低频访问的 KV cache 卸载到更低成本的存储(如 CPU 内存、本地存储或对象存储等),大幅降低 GPU 内存占用。借助这种分层管理,开发者既能保留大规模 KV cache 重用的优势,又能释放宝贵的 GPU 资源,从而有效降低推理计算成本。
|
||||||
|
- **NVIDIA Inference Transfer Library (NIXL)**:高效的推理数据传输库,可加速 GPU 之间以及异构内存与存储之间的 KV cache 传输。通过减少同步开销和智能批处理,NIXL 显著降低了分布式推理中的通信延迟,使得在 prefill/decode 分离部署时,prefill 节点也能在毫秒级将大批量的 KV cache 传输至 decode 节点,从而避免跨节点数据交换成为性能瓶颈。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
在 Dynamo 的 PD 分离架构中,有 4 个核心组件:
|
||||||
|
|
||||||
|
- **(decode) worker**:执行 prefill 和 decode 请求。
|
||||||
|
- **prefill worker**:只执行 prefill 请求。
|
||||||
|
- **disaggregated router**:决定 prefill 阶段是在本地还是远程执行。
|
||||||
|
- **prefill queue**:缓存并负载均衡远程 prefill 请求。
|
||||||
|
|
||||||
|
当 worker 收到请求时,首先会通过 disaggregated router 判断 prefill 应该在本地还是远程完成,并分配相应的 KV block。如果选择远程 prefill,请求会被推送到 prefill queue。随后,prefill worker 从队列中取出请求,读取 worker 中 prefix cache 命中的 KV block,执行 prefill 计算,并将生成的 KV block 回写给 worker。最后,worker 会继续完成剩余的 decode 阶段。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
Dynamo 提供了 Operator 方便我们在 Kubernetes 环境中以声明式的方式定义 PD 分离服务。只需在 `DynamoGraphDeployment` 配置中声明 Frontend、VllmDecodeWorker 和 VllmPrefillWorker 三个组件即可。`dynamoNamespace` 是 Dynamo 分布式运行时的逻辑隔离单元,而非 Kubernetes 的 namespace;同一 `dynamoNamespace` 内的组件可以相互发现并进行通信。
|
||||||
|
|
||||||
|
```yaml
|
||||||
|
apiVersion: nvidia.com/v1alpha1
|
||||||
|
kind: DynamoGraphDeployment
|
||||||
|
metadata:
|
||||||
|
name: vllm-disagg
|
||||||
|
spec:
|
||||||
|
services:
|
||||||
|
Frontend:
|
||||||
|
dynamoNamespace: vllm-disagg
|
||||||
|
componentType: frontend
|
||||||
|
replicas: 1
|
||||||
|
extraPodSpec:
|
||||||
|
mainContainer:
|
||||||
|
image: nvcr.io/nvidia/ai-dynamo/vllm-runtime:0.4.1
|
||||||
|
VllmDecodeWorker:
|
||||||
|
dynamoNamespace: vllm-disagg
|
||||||
|
componentType: worker
|
||||||
|
replicas: 1
|
||||||
|
resources:
|
||||||
|
limits:
|
||||||
|
gpu: "1"
|
||||||
|
extraPodSpec:
|
||||||
|
mainContainer:
|
||||||
|
image: nvcr.io/nvidia/ai-dynamo/vllm-runtime:0.4.1
|
||||||
|
workingDir: /workspace/components/backends/vllm
|
||||||
|
command:
|
||||||
|
- /bin/sh
|
||||||
|
- -c
|
||||||
|
args:
|
||||||
|
- "python3 -m dynamo.vllm --model Qwen/Qwen3-0.6B"
|
||||||
|
VllmPrefillWorker:
|
||||||
|
dynamoNamespace: vllm-disagg
|
||||||
|
componentType: worker
|
||||||
|
replicas: 1
|
||||||
|
resources:
|
||||||
|
limits:
|
||||||
|
gpu: "1"
|
||||||
|
extraPodSpec:
|
||||||
|
mainContainer:
|
||||||
|
image: nvcr.io/nvidia/ai-dynamo/vllm-runtime:0.4.1
|
||||||
|
workingDir: /workspace/components/backends/vllm
|
||||||
|
command:
|
||||||
|
- /bin/sh
|
||||||
|
- -c
|
||||||
|
args:
|
||||||
|
- "python3 -m dynamo.vllm --model Qwen/Qwen3-0.6B --is-prefill-worker"
|
||||||
|
```
|
||||||
|
|
||||||
|
Dynamo 详细的部署教程可以参考博客:https://cr7258.github.io/blogs/original/2025/20-dynamo
|
||||||
|
|
||||||
|
### 7.3 llm-d
|
||||||
|
|
||||||
|
llm-d 是一个 Kubernetes 原生的分布式推理服务栈,为团队提供一条清晰高效的路径,以最快的落地速度在大规模环境中部署并管理推理服务。llm-d 通过集成业界标准的开源技术来加速分布式推理:使用 vLLM 作为模型服务与引擎,Inference Gateway 作为请求调度器与负载均衡器,Kubernetes 作为基础设施编排与工作负载控制平面。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
llm-d 提供以下核心功能:
|
||||||
|
|
||||||
|
- 基于 vLLM 优化的推理调度器:llm-d 基于 IGW 的 Endpoint Picker Protocol (EPP) 实现可定制化的"智能"负载均衡,专门针对 vLLM 进行优化。调度器结合运行时遥测数据,利用过滤和打分算法,在 P/D 分离、KV cache、SLA 与负载感知的基础上做出调度决策,同时支持团队自定义策略。
|
||||||
|
- PD 分离:llm-d 利用 vLLM 的分离式推理能力,将 prefill 和 decode 拆分到独立实例运行,并通过高性能传输库(如 NIXL)进行通信。
|
||||||
|
- 分布式 KV cache:llm-d 使用 vLLM 的 KV connector 构建可插拔的 KV cache 层级体系,支持将 KV cache 卸载到主机、远程存储或 LMCache 等系统。
|
||||||
|
|
||||||
|
使用 llm-d 运行 PD 分离服务请参考:https://github.com/llm-d/llm-d/tree/main/guides/pd-disaggregation
|
||||||
|
|
||||||
|
### 7.4 AIBrix
|
||||||
|
|
||||||
|
AIBrix 是字节跳动开源的云原生分布式推理框架,专为大规模 LLM 部署设计。
|
||||||
|
|
||||||
|
- AIBrix 支持 LoRA 管理、前缀感知和负载感知的智能路由,并通过分布式 KV cache 实现跨节点的高效 token 复用。
|
||||||
|
- 在系统编排层面,AIBrix 结合 Kubernetes 与 Ray 的混合调度,既能满足大规模集群管理的需求,又能灵活执行细粒度任务。
|
||||||
|
- AIBrix 基于 SLO 的 GPU 优化器与诊断工具进一步提升了资源利用率和系统可靠性。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
使用 AIBrix 运行 PD 分离服务请参考:https://github.com/vllm-project/aibrix/tree/main/samples/disaggregation/vllm
|
||||||
|
|
||||||
|
## 8 Chunked-Prefills VS PD 分离
|
||||||
|
|
||||||
|
chunked-prefills 方案的核心思想是:将长序列的 prefill 请求拆分为几乎相等大小的小块,然后构建了由 prefill 小块和 decode 组成的混合 batch。或者说,chunked-prefills 策略通过将不同长度的 prompts 拆分成长度一致的 chunks 来进行 prefill,以避免长 prompt 阻塞其他请求,同时利用这些 chunks 的间隙进行 decode 的插入/捎带(piggyback)操作,从而减少延迟并提高整体的吞吐。
|
||||||
|
|
||||||
|
decode 阶段的开销不仅来自从 GPU 内存中获取 KV cache,还包括提取模型参数。而通过这种 piggyback 方法,decode 阶段能够重用 prefill 时已提取的模型参数,几乎将 decode 阶段从一个以内存为主的操作转变为一个计算为主的操作。因此,这样构建的混合批次具有近乎均匀的计算需求(而且增加了计算密集性),使我们能够创建平衡的微批处理调度,缓解了迭代之间的不平衡,导致 GPU 的管道气泡最小化,提高了 GPU 的利用率。也最小化了计算新 prefill 对正在进行的 decode 的 TBT 的影响,从而实现了高吞吐量和低 TBT 延迟。
|
||||||
|
|
||||||
|
chunked-prefills 有两个明显的好处:
|
||||||
|
|
||||||
|
- 所有节点被平等对待,使调度更简单。
|
||||||
|
- 将 chunked prefill 内联到 decode 批处理中可以提高 decode 批次的计算强度,从而带来更好的 MFU(Model FLOPs Utilization,指的是模型实际使用的计算量占 GPU 理论峰值算力的比例,用来衡量算力利用效率)。
|
||||||
|
|
||||||
|
然而,chunked-prefills 也有一些缺点:
|
||||||
|
|
||||||
|
- chunked-prefills 会增加 prefill 的计算开销,如果 chunk 大小明显低于 GPU 饱和点,会延长 prefill 的执行时间。
|
||||||
|
- prefill 阶段仍难以完全最大化 MFU,因为在 chunk-prefill 中,profiling 只会估算特定设备上一个 batch 的最大 tokens 配额,这个配额同时包含 prefill 和 decode,而不是分别针对两者优化。
|
||||||
|
- chunked-prefills 也会显著增加 prefill 阶段的内存访问量,每个 chunk 的 Attention 操作都需重复读取此前的 KV cache,增加内存访问负担。而且长序列可能会持久地占据着 KV cache 的存储空间以及 GPU 的计算资源。
|
||||||
|
- 在 TPOT 方面,将 prefill 与 decode 合并批处理实际上会降低所有 decode 任务的平均速度。
|
||||||
|
|
||||||
|
**总之,chunked-prefills 可能有助于最大化整体吞吐量,但由于动态分割无法完全解耦 prefill 和 decode 操作,会导致资源争用以及 TTFT 与 TPOT 之间的妥协。当应用程序无法在 TTFT 和 TPOT 之间进行权衡,而是要同时遵守这两者时,PD 分离就成为更好的选择。**
|
||||||
|
|
||||||
|
## 9 PD 分离相关论文
|
||||||
|
|
||||||
|
- DistServe: Disaggregating Prefill and Decoding for Goodput-optimized Large Language Model Serving
|
||||||
|
- Splitwise: Efficient Generative LLM Inference Using Phase Splitting
|
||||||
|
- TetriInfer: Inference without Interference:Disaggregate LLM Inference for Mixed Downstream Workloads
|
||||||
|
- MemServe: Context Caching for Disaggregated LLM Serving with Elastic Memory Pool
|
||||||
|
- Mooncake: A KVCache-centric Disaggregated Architecture for LLM Serving
|
||||||
|
|
||||||
|
## 10 总结
|
||||||
|
|
||||||
|
PD 分离是大模型推理中的一种架构优化策略,核心思想是把 prefill 阶段和 decode 阶段分开,由不同的 GPU 或实例分别承担。通过分离架构,系统可以针对 prefill(计算密集型)和 decode(内存密集型)的不同特性分别优化资源配置和并行策略,从而在满足 TTFT 和 TPOT SLO 约束的前提下显著提升有效吞吐量(Goodput)。虽然 PD 分离需要在 GPU 间传输 KV Cache,但通过高速互联网络和优化的传输策略,这一开销可以被有效隐藏。目前,vLLM、Mooncake、Dynamo 等主流推理框架都已支持 PD 分离,为大规模 LLM 服务提供了更高效的解决方案。相比于 chunked-prefills 等替代方案,PD 分离在需要同时满足严格 TTFT 和 TPOT 要求的场景下具有明显优势。
|
||||||
|
|
||||||
|
## 11 参考资料
|
||||||
|
|
||||||
|
- Lecture 58: Disaggregated LLM Inference:https://www.youtube.com/watch?v=tIPDwUepXcA
|
||||||
|
- Throughput is Not All You Need: Maximizing Goodput in LLM Serving using Prefill-Decode Disaggregation:https://hao-ai-lab.github.io/blogs/distserve/
|
||||||
|
- Mooncake阅读笔记:深入学习以Cache为中心的调度思想,谱写LLM服务降本增效新篇章:https://zhuanlan.zhihu.com/p/706097807
|
||||||
|
- 探秘Transformer系列之(26)--- KV Cache优化 之 PD分离or合并:https://www.cnblogs.com/rossiXYZ/p/18815541
|
||||||
|
- 大模型推理分离架构五虎上将:https://zhuanlan.zhihu.com/p/706218732
|
||||||
|
- LLM关于PD分离的最新实测:https://zhuanlan.zhihu.com/p/1919794916504114120
|
||||||
|
- State of the Model Serving Communities - August 2025:https://inferenceops.substack.com/p/state-of-the-model-serving-communities
|
||||||
|
- 图解大模型训练系列:序列并行1,Megatron SP:https://zhuanlan.zhihu.com/p/4083427292
|
||||||
|
- 序列并行做大模型训练,你需要知道的六件事:https://zhuanlan.zhihu.com/p/698031151
|
||||||
|
- vLLM PD分离KV cache传递机制详解与演进分析:https://zhuanlan.zhihu.com/p/1906741007606878764
|
||||||
|
- vLLM PD分离方案浅析:https://zhuanlan.zhihu.com/p/1889243870430201414
|
||||||
|
- P/D Disaggregation of vLLM and Integration with Mooncake:https://docs.google.com/document/d/1Ab6TMW1E2CdHJJyCrpJnLhgmE2b_6leH5MVP9k72sjw/edit?tab=t.0#heading=h.611v2r4aqubz
|
||||||
|
- 0.5x提升:PD分离KV cache传输的实践经验:https://zhuanlan.zhihu.com/p/1946608360259577576
|
||||||
|
- 分布式推理优化思路:http://zhuanlan.zhihu.com/p/1937556222371946860
|
||||||
|
- 图解大模型计算加速系列:分离式推理架构2,模糊分离与合并边界的chunked-prefills:https://zhuanlan.zhihu.com/p/710165390
|
||||||
|
- 图解大模型计算加速系列:分离式推理架构1,从DistServe谈起:https://zhuanlan.zhihu.com/p/706761664
|
||||||
|
- LLM推理优化 - Prefill-Decode分离式推理架构:https://zhuanlan.zhihu.com/p/9433793184
|
||||||
|
- Shaping NIXL-based PD Disaggregation in vLLM V1:https://blog.lmcache.ai/2025-04-11-lmcache-vllmv1-nixl/
|
||||||
|
- vLLM P2P NCCL Connector:https://docs.vllm.ai/en/latest/design/p2p_nccl_connector.html
|
||||||
|
- vLLM Disaggregated Prefilling (experimental):https://docs.vllm.ai/en/latest/features/disagg_prefill.html
|
||||||
|
- LMCache Example: Disaggregated prefill:https://docs.lmcache.ai/getting_started/quickstart/disaggregated_prefill.html
|
||||||
|
- Bringing State-Of-The-Art PD Speed to vLLM v1 with LMCache:https://blog.lmcache.ai/2025-04-29-pdbench/
|
||||||
|
- Demystify vLLM V1 KVconnector SharedStorageConnector:https://blog.diabloneo.com/demystify-vllm-v1-kvconnector-sharedstorageconnector-05a487627036
|
||||||
|
- vLLM源码之分离式架构:https://zhuanlan.zhihu.com/p/1933647687
|
||||||
|
- vLLM v1 PD分离设计:https://zhuanlan.zhihu.com/p/1894425784107632241
|
||||||
|
- Inside vLLM: Anatomy of a High-Throughput LLM Inference System:https://blog.vllm.ai/2025/09/05/anatomy-of-vllm.html
|
||||||
|
- [P/D][V1] KV Connector API V1:vllm-project/vllm#15960
|
||||||
|
- vLLM PD Disaggregation discussion:https://docs.google.com/document/d/1uPGdbEXksKXeN4Q9nUm9hzotqEjQhYmnpAhidLuAsjk/edit?tab=t.0#heading=h.qhtgj3vmvwn
|
||||||
|
- llm-d: Kubernetes-native Distributed Inference at Scale:https://github.com/llm-d/llm-d/blob/dev/docs/proposals/llm-d.md
|
||||||
@@ -0,0 +1,88 @@
|
|||||||
|
# 📊 文章摘要:Lesson 06:PD 分离推理架构详解(AI Infra 学习课程)
|
||||||
|
|
||||||
|
> **原文**:[2026-08-06_Lesson_06_PD分离推理架构详解.md](./2026-08-06_Lesson_06_PD分离推理架构详解.md)
|
||||||
|
> **原文链接**:https://github.com/cr7258/ai-infra-learning/tree/main/lesson/06-disaggregating-prefill-and-decoding
|
||||||
|
> **来源**:GitHub(cr7258/ai-infra-learning)
|
||||||
|
> **作者**:cr7258
|
||||||
|
> **发布日期**:2026-08-06
|
||||||
|
> **摘要日期**:2026-08-06
|
||||||
|
> **价值评级**:⭐⭐⭐ 高
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 核心命题
|
||||||
|
|
||||||
|
> **PD 分离详解** — 用 Goodput 指标重新审视 LLM 推理架构:prefill 与 decode 分离不仅消除阶段干扰,还能在满足 TTFT/TPOT SLO 前提下将有效吞吐量提升约 2 倍(仅靠分离、不加任何并行优化)。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 文章概要
|
||||||
|
|
||||||
|
本文是 AI Infra 学习课程第 6 课,系统讲解 PD(prefill-decode)分离推理架构:从 Throughput 与 Goodput 的指标辨析切入,用 DistServe 论文数据量化 prefill/decode 共置干扰(prompt 128 tokens 时 decode 延迟增 1.8 倍、1024 tokens 时达 12.6 倍),以 2P1D 实验演示 Goodput 从 1.6 提升至 3.3 rps/GPU;随后展开分离架构的优化方向(算力/存储特性、batching、并行策略)、KV Cache 传输的全栈分析(开销估算、中心存储 vs P2P、Direct/Direct-NIC/Indirect 三类链路、请求级/层级/块级三种粒度)、vLLM KV Connector 五种实现详解、工业界四项目对比(Mooncake/Dynamo/llm-d/AIBrix),并以 chunked-prefills 与 PD 分离的优劣对比收尾。价值在于:数据详实、链路完整,是理解 PD 分离的优质入门与选型参考。局限在于:部分实验数据出自论文而非作者实测,对传输开销的乐观结论依赖高速网络假设。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 关键要点
|
||||||
|
|
||||||
|
1. **Goodput 优于 Throughput 作为服务指标** — Goodput 指满足 SLO(如 P90 TTFT < 200ms 且 P90 TPOT < 50ms)前提下的有效请求数;10 RPS 吞吐可能只有 3 RPS 有效产出,高吞吐≠好体验,评价服务应同时看吞吐与 SLO 达成。 `[分类: 范式突破]`
|
||||||
|
|
||||||
|
2. **共置干扰有量化证据** — prefill 与 decode 混批时,prompt 128 tokens 使 decode 延迟增约 1.8 倍、1024 tokens 时增至 12.6 倍,且同时满足双 SLO 会导致过度配置——这是 PD 分离的必要性论证核心。 `[分类: 共识]`
|
||||||
|
|
||||||
|
3. **分离本身即带来约 2 倍 Goodput 提升** — 单卡共置 Goodput 1.6 rps/GPU vs 2P1D 分离 3.3 rps/GPU,且分离后可分别定制并行策略(prefill 偏张量并行保 TTFT,decode 偏数据/流水线并行保吞吐)。 `[分类: 共识]`
|
||||||
|
|
||||||
|
4. **KV 传输开销可以被隐藏** — 8 通道 PCIe 5.0 下 2048 tokens 的 KV 传输约 17.6ms,低于单次 decode 步骤(30-50ms);层级传输(Splitwise)与计算重叠可进一步隐藏开销,但层级粒度在小 prompt 场景会引入同步干扰。 `[分类: 共识]`
|
||||||
|
|
||||||
|
5. **PD 分离 vs chunked-prefills 是权衡而非胜负** — chunked-prefills 吞吐调度简单、可提升 decode 批计算强度(MFU),但无法完全解耦两阶段、TTFT 与 TPOT 互相妥协;当应用必须同时满足双 SLO 时 PD 分离更优。这是全文边界意识最强的部分。 `[分类: 争议]`
|
||||||
|
|
||||||
|
6. **vLLM KV Connector 是事实标准抽象** — 5 种 connector(SharedStorage/NCCL P2P/NIXL/LMCache/Multi)覆盖文件系统、RDMA、外部缓存、混合冗余四类路径,`KVConnectorBase_V1` 的 scheduler/worker 职责划分即社区当前实现的基线。 `[分类: 共识]`
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 批判性分析
|
||||||
|
|
||||||
|
### 假设前提
|
||||||
|
|
||||||
|
- 传输开销"可被隐藏"的结论建立在高速互联假设上(NVLink、PCIe 5.0、RDMA),对普通以太网集群(10/25/40Gbps)不成立,此时 KV 传输反而成为瓶颈——文中未对低速网络场景做等价估算;
|
||||||
|
- 假设请求有明确且独立的 TTFT/TPOT SLO;对只有单一延迟要求或短 prompt 为主的工作负载,PD 分离的收益空间会显著收窄;
|
||||||
|
- 假设 prefill/decode 的比例可通过资源配比灵活调节(2P1D),实际中流量波动要求动态调度能力,本文未展开。
|
||||||
|
|
||||||
|
### 论据与逻辑
|
||||||
|
|
||||||
|
- 论据质量总体较高:干扰数据(1.8x/12.6x)、Goodput 计算(含完整算式)、17.6ms 传输估算均给出可追溯出处(DistServe/Splitwise/TetriInfer 论文),教程对原文复述忠实;vLLM connector 部分为代码级事实描述,可信度最高。需注意:2P1D 实验(Goodput 1.6→3.3)来自论文模拟环境而非作者实测;工业界项目部分(Mooncake 525% 提升、75% 请求)转引自项目论文/自述,属二手数据。
|
||||||
|
|
||||||
|
### 边界与局限
|
||||||
|
|
||||||
|
- 适用场景:具备 GPU 高速互联(NVLink/RDMA)的大规模集群、请求需同时满足严格 TTFT 与 TPOT 的服务(实时对话 + 长文档混合负载);PD 分离会引入额外的编排复杂度(路由、队列、传输),中小规模或单 SLO 场景未必划算;
|
||||||
|
- 中心存储与 P2P 各有短板(中心存储性能与维护成本、P2P 扩展性与链路稳定),文中已给出但未量化;
|
||||||
|
- 未覆盖:PD 分离下的容错与弹性、跨集群部署、以及 PD 分离对训练/RL 场景的延伸(可参考 Mooncake 权重传输方向)。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 可引用金句
|
||||||
|
|
||||||
|
> "当应用程序无法在 TTFT 和 TPOT 之间进行权衡,而是要同时遵守这两者时,PD 分离就成为更好的选择。"
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 总体评价
|
||||||
|
|
||||||
|
**亮点**:
|
||||||
|
- 逻辑链条完整:指标问题 → 干扰证据 → 分离方案 → 传输全栈 → 工程实现 → 方案对比,一篇文章讲透 PD 分离
|
||||||
|
- 数据有出处、计算有过程,并明确区分论文数据与工程事实,论据纪律良好
|
||||||
|
- vLLM KV Connector 代码级详解与四工业项目横向对比,具备直接工程参考价值
|
||||||
|
- 边界意识突出:对 chunked-prefills 的对比是行业争议点的诚实呈现
|
||||||
|
|
||||||
|
**不足**:
|
||||||
|
- 传输开销结论依赖高速网络假设,低速网络场景缺失
|
||||||
|
- 工业界性能数字转引自项目自述,未标注可信度级别
|
||||||
|
- 未涉及容错、动态资源配比、跨集群等生产落地细节
|
||||||
|
|
||||||
|
**适用场景**:LLM 推理架构选型的工程师与架构师(判断"何时该上 PD 分离");vLLM 二次开发者的 connector 参考;AI Infra 学习者的体系化入门材料。
|
||||||
|
|
||||||
|
**关联建议**:延伸阅读 DistServe/Splitwise/TetriInfer/MemServe/Mooncake 五篇论文原文;对照 vLLM 官方 disagg_prefill 文档实操;结合 Mooncake、NVIDIA Dynamo、llm-d、AIBrix 四项目文档评估工程化路径;关注社区关于 chunked-prefills 与 PD 分离融合(如 SGLang 的演进)的最新讨论。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 配图
|
||||||
|
|
||||||
|

|
||||||
@@ -0,0 +1,106 @@
|
|||||||
|
# AIBrix:云原生 GenAI 推理基础设施(字节跳动开源)
|
||||||
|
|
||||||
|
> **来源**:GitHub
|
||||||
|
> **作者**:字节跳动(ByteDance),vllm-project 组织托管
|
||||||
|
> **发布日期**:2026-06-16
|
||||||
|
> **原文链接**:https://github.com/vllm-project/aibrix
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
# AIBrix
|
||||||
|
|
||||||
|
欢迎使用 AIBrix,一个开源项目,旨在为构建可扩展的 GenAI 推理基础设施提供必要的构建模块。AIBrix 提供了一种云原生解决方案,专门针对企业需求优化,用于部署、管理和扩展大语言模型(LLM)推理。
|
||||||
|
|
||||||
|
相关链接:[Documentation](https://aibrix.readthedocs.io/latest/) | [Blog](https://aibrix.github.io/) | [White Paper](https://arxiv.org/abs/2504.03648) | [Twitter/X](https://x.com/vllm_project) | [Developer Slack](https://vllm-dev.slack.com/archives/C08EQ883CSV)
|
||||||
|
|
||||||
|
## 最新动态(Latest News)
|
||||||
|
|
||||||
|
### 版本发布(Releases)
|
||||||
|
- **[2026-06-16]** AIBrix v0.7.0 发布。查看 [release notes](https://github.com/vllm-project/aibrix/releases/tag/v0.7.0) 和 [Blog Post](https://aibrix.github.io/posts/2026-06-16-v0.7.0-release/) 了解详情。
|
||||||
|
- **[2026-03-05]** AIBrix v0.6.0 发布。查看 [release notes](https://github.com/vllm-project/aibrix/releases/tag/v0.6.0) 和 [Blog Post](https://aibrix.github.io/posts/2026-03-03-v0.6.0-release/) 了解详情。
|
||||||
|
- **[2025-11-10]** AIBrix v0.5.0 发布。查看 [release notes](https://github.com/vllm-project/aibrix/releases/tag/v0.5.0) 和 [Blog Post](https://aibrix.github.io/posts/2025-11-10-v0.5.0-release/) 了解详情。
|
||||||
|
- **[2025-08-05]** AIBrix v0.4.0 发布。查看 [release notes](https://github.com/vllm-project/aibrix/releases/tag/v0.4.0) 和 [Blog Post](https://aibrix.github.io/posts/2025-08-04-v0.4.0-release/) 了解详情。
|
||||||
|
- **[2025-05-21]** AIBrix v0.3.0 发布。查看 [release notes](https://github.com/vllm-project/aibrix/releases/tag/v0.3.0) 和 [Blog Post](https://aibrix.github.io/posts/2025-05-21-v0.3.0-release/) 了解详情。
|
||||||
|
- **[2025-03-09]** AIBrix v0.2.1 发布。支持 DeepSeek-R1 全权重部署,并提升了网关稳定性!查看 [Blog Post](https://aibrix.github.io/posts/2025-03-10-deepseek-r1/) 了解详情。
|
||||||
|
- **[2025-02-19]** AIBrix v0.2.0 发布。查看 [release notes](https://github.com/vllm-project/aibrix/releases/tag/v0.2.0) 和 [Blog Post](https://aibrix.github.io/posts/2025-02-05-v0.2.0-release/) 了解详情。
|
||||||
|
- **[2024-11-13]** AIBrix v0.1.0 发布。查看 [release notes](https://github.com/vllm-project/aibrix/releases/tag/v0.1.0) 和 [Blog Post](https://aibrix.github.io/posts/2024-11-12-v0.1.0-release/) 了解详情。
|
||||||
|
|
||||||
|
### 演讲与分享(Talks and Presentations)
|
||||||
|
|
||||||
|
- **[2025-11-12]** AIBrix 团队在 KubeCon North America 2025 联合发表主题演讲 [AIBrix: Kubernetes-native GenAI Inference Infrastructure](https://www.youtube.com/watch?v=7KHenRXNGAw&t=875s),提供 AIBrix 概览。
|
||||||
|
- **[2025-06-10]** AIBrix 团队在 KubeCon China 2025 发表演讲 [AIBrix: Cost-Effective and Scalable Kubernetes Control Plane for vLLM](https://kccncchn2025.sched.com/event/1x5im/introducing-aibrix-cost-effective-and-scalable-kubernetes-control-plane-for-vllm-jiaxin-shan-liguang-xie-bytedance),讨论该框架如何通过 Kubernetes 优化 vLLM 部署以实现成本效益和可扩展性。
|
||||||
|
- **[2025-04-04]** AIBrix 团队在 KubeCon EU 2025 与 Google 联合发表主题演讲 [LLM-Aware Load Balancing in Kubernetes: A New Era of Efficiency](https://kccnceu2025.sched.com/event/1txC7/keynote-llm-aware-load-balancing-in-kubernetes-a-new-era-of-efficiency-clayton-coleman-distinguished-engineer-google-jiaxin-shan-software-engineer-bytedance),聚焦 LLM 特定路由解决方案。
|
||||||
|
- **[2025-03-30]** AIBrix 在 [ASPLOS'25](http://asplos-conference.org/asplos2025/) 研讨会上展示 [AIBrix: An Open-Source, Large-Scale LLM Inference Infrastructure for System Research](https://docs.google.com/presentation/d/1YDVsPFTIgGXnROGaJ1VKuDDAB4T5fzpE/edit),展示其在系统研究场景下高效 LLM 推理的架构。
|
||||||
|
|
||||||
|
## 核心特性(Key Features)
|
||||||
|
|
||||||
|
首个版本包含以下核心特性:
|
||||||
|
|
||||||
|
- **高密度 LoRA 管理**:对模型轻量级低秩适配的流式支持。
|
||||||
|
- **LLM 网关与路由**:跨多个模型和副本高效管理和调度流量。
|
||||||
|
- **面向 LLM 应用的定制化自动扩缩容器**:基于实时需求动态扩展推理资源。
|
||||||
|
- **统一 AI 运行时**:一个多用途边车,支持指标标准化、模型下载和管理。
|
||||||
|
- **分布式推理**:可扩展的架构,跨多个节点处理大规模工作负载。
|
||||||
|
- **分布式 KV Cache**:支持高容量、跨引擎的 KV 复用。
|
||||||
|
- **高性价比异构服务**:支持混合 GPU 推理,在 SLO 保证下降低成本。
|
||||||
|
- **GPU 硬件故障检测**:主动检测 GPU 硬件问题。
|
||||||
|
|
||||||
|
## 架构(Architecture)
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
## 快速开始(Quick Start)
|
||||||
|
|
||||||
|
要开始使用 AIBrix,克隆此仓库并按照文档中的设置说明操作。综合指南将帮助您无缝配置和部署首个 LLM 基础设施。
|
||||||
|
|
||||||
|
```shell
|
||||||
|
# 本地测试
|
||||||
|
git clone https://github.com/vllm-project/aibrix.git
|
||||||
|
cd aibrix
|
||||||
|
|
||||||
|
# 安装 nightly aibrix 依赖
|
||||||
|
kubectl apply -k config/dependency --server-side
|
||||||
|
|
||||||
|
# 安装 nightly AIBrix CRDs(与 operator 分离,卸载时不会清除用户 CR)
|
||||||
|
kubectl apply -k config/crd --server-side
|
||||||
|
|
||||||
|
# 安装 nightly aibrix 组件
|
||||||
|
kubectl apply -k config/default
|
||||||
|
```
|
||||||
|
|
||||||
|
安装稳定版本:
|
||||||
|
|
||||||
|
```shell
|
||||||
|
# 安装组件依赖
|
||||||
|
kubectl apply -f "https://github.com/vllm-project/aibrix/releases/download/v0.7.0/aibrix-dependency-v0.7.0.yaml" --server-side
|
||||||
|
|
||||||
|
# 安装 AIBrix CRDs(与 operator 分离,卸载时不会清除用户 CR)
|
||||||
|
kubectl apply -f "https://github.com/vllm-project/aibrix/releases/download/v0.7.0/aibrix-core-crds-v0.7.0.yaml" --server-side
|
||||||
|
|
||||||
|
# 安装 aibrix 组件
|
||||||
|
kubectl apply -f "https://github.com/vllm-project/aibrix/releases/download/v0.7.0/aibrix-core-v0.7.0.yaml"
|
||||||
|
```
|
||||||
|
|
||||||
|
## 文档(Documentation)
|
||||||
|
|
||||||
|
关于安装、配置和使用的详细文档,请访问[文档页面](https://aibrix.readthedocs.io/latest/)。
|
||||||
|
|
||||||
|
## 贡献(Contributing)
|
||||||
|
|
||||||
|
欢迎社区贡献!查看[贡献指南](./CONTRIBUTING.md)了解如何参与。
|
||||||
|
|
||||||
|
Slack 频道:[#aibrix](https://vllm-dev.slack.com/archives/C08EQ883CSV)
|
||||||
|
|
||||||
|
## 许可证(License)
|
||||||
|
|
||||||
|
AIBrix 基于 [Apache 2.0 License](LICENSE) 许可。
|
||||||
|
|
||||||
|
## 支持(Support)
|
||||||
|
|
||||||
|
如有任何疑问或问题,请在 [GitHub issues 页面](https://github.com/vllm-project/aibrix/issues) 提交 issue。
|
||||||
|
|
||||||
|
感谢您选择 AIBrix 满足您的 GenAI 基础设施需求!
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
> 仓库结构摘要(README 原文):`api/`(autoscaling/model/orchestration)、`apps/`(chat/console)、`benchmarks/` + `brixbench/`(基准测试)、`cmd/`(controllers/kvcache-watcher/plugins)、`config/`(crd/default/dependency 等)、`deployment/`(local/standalone/terraform)、`docs/`、`pkg/`(controller/kvevent/plugins 等 Go 包)、`python/`(aibrix/aibrix_kvcache)、`samples/`(disaggregation、deepseek-r1、kvcache、autoscaling 等示例)、`test/`(e2e/integration/regression)。
|
||||||
@@ -0,0 +1,85 @@
|
|||||||
|
# 📊 文章摘要:AIBrix:云原生 GenAI 推理基础设施(字节跳动开源)
|
||||||
|
|
||||||
|
> **原文**:[2026-06-16_AIBrix_云原生推理.md](./2026-06-16_AIBrix_云原生推理.md)
|
||||||
|
> **原文链接**:https://github.com/vllm-project/aibrix
|
||||||
|
> **来源**:GitHub(vllm-project 组织托管)
|
||||||
|
> **作者**:字节跳动(ByteDance)
|
||||||
|
> **发布日期**:2026-06-16
|
||||||
|
> **摘要日期**:2026-08-06
|
||||||
|
> **价值评级**:⭐⭐⭐ 高
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 核心命题
|
||||||
|
|
||||||
|
> **云原生推理基建** — 以 Kubernetes 控制平面 + 智能网关 + 分布式 KV Cache 为三支柱,为大规模 LLM 推理提供"LLM 感知"的部署、路由与扩缩容能力。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 文章概要
|
||||||
|
|
||||||
|
本文是 AIBrix 项目的 GitHub README(截至 v0.7.0 发布),内容包括:v0.1.0 至 v0.7.0 的完整版本发布历史(2024-11 至 2026-06)、KubeCon NA/CN/EU 与 ASPLOS'25 的演讲记录、八大核心特性(高密度 LoRA 管理、LLM 网关与路由、LLM 定制化自动扩缩、统一 AI 运行时边车、分布式推理、分布式 KV Cache、异构 GPU 混合服务、GPU 硬件故障检测)、kubectl 一键安装方式与仓库结构。其价值在于:以可核验的发布节奏与社区活动勾勒出字节跳动在云原生推理领域的技术布局,特性清单可作为同类平台功能对照表。局限在于:README 为宣传型文档,核心特性均为能力清单而无任何性能基准、架构细节或生产数据,"成本效益""高性价比"等表述无证据支撑。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 关键要点
|
||||||
|
|
||||||
|
1. **发布节奏反映产品成熟度** — 2024-11 至 2026-06 共 8 个版本(0.1.0→0.7.0,约每 3-4 个月一版),v0.2.1 即支持 DeepSeek-R1 全权重部署,迭代速度快、生态活跃度可验证。 `[分类: 共识]`
|
||||||
|
|
||||||
|
2. **三支柱能力框架** — LLM 感知的网关路由(前缀感知/负载感知)、基于实时需求的自动扩缩、分布式 KV Cache 跨节点复用,与 llm-d、Dynamo 的组件画像高度重合,印证行业"路由 + 缓存 + 弹性"三要素共识。 `[分类: 共识]`
|
||||||
|
|
||||||
|
3. **K8s + Ray 混合编排** — 文档及演讲(KubeCon China 2025)揭示其用 Kubernetes 管集群、用 Ray 执行细粒度任务的混合调度思路,是字节大规模算力治理经验的工程化表达。 `[分类: 范式突破]`
|
||||||
|
|
||||||
|
4. **学术与社区背书** — 托管于 vllm-project 组织、白皮书公开于 arXiv(2504.03648)、ASPLOS'25 研讨会展示、多次 KubeCon 主题演讲(含与 Google 联合),可信度高于一般个人项目。 `[分类: 共识]`
|
||||||
|
|
||||||
|
5. **宣传口径与证据落差** — "高性价比异构服务""GPU 硬件故障检测"等特性均无基准数据、无原理说明,README 无法支撑任何性能或成本结论;分布式 KV Cache 与 SLO 优化器的实际效果需查阅白皮书与源码验证。 `[分类: 未探索]`
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 批判性分析
|
||||||
|
|
||||||
|
### 假设前提
|
||||||
|
|
||||||
|
- 假设部署环境以 Kubernetes 为基底(全部安装通过 kubectl/CRD 完成),并认可 Operator/CRD 模式;
|
||||||
|
- 假设"LLM 感知路由 + 分布式 KV 复用"在网关层集中实现的扩展性成立(与 llm-d 相同的未验证问题);
|
||||||
|
- 假设异构 GPU 混部能在 SLO 保证下真正降本——这是其"成本效益"宣称的核心前提,README 未提供证据。
|
||||||
|
|
||||||
|
### 论据与逻辑
|
||||||
|
|
||||||
|
- 文档的论据全部为"事实性存在"类:版本号、演讲链接、白皮书 arXiv 号均真实可核验,构成项目可信度的有效证据;但对"性能与效果"类结论(成本降低、扩展性、故障检测有效性)零论据支撑,属于典型的工程宣传文档——论据质量呈现"存在性高、效果性无"的剪刀差。
|
||||||
|
|
||||||
|
### 边界与局限
|
||||||
|
|
||||||
|
- 适用场景:已有 K8s 集群、需要为 vLLM 部署补齐网关/扩缩容/KV 复用能力的企业级团队;作为 LLM 推理平台功能清单的行业参照。
|
||||||
|
- 不适用于:无 K8s 环境、单机小规模部署、以及需要严格基准对比后才能决策的场景(需转向白皮书)。
|
||||||
|
- 项目定位受限于 vLLM 生态深度绑定,非 vLLM 引擎(如 SGLang/TensorRT-LLM)的支持程度未在本文说明。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 可引用金句
|
||||||
|
|
||||||
|
> "AIBrix 提供了一种云原生解决方案,专门针对企业需求优化,用于部署、管理和扩展大语言模型(LLM)推理。"
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 总体评价
|
||||||
|
|
||||||
|
**亮点**:
|
||||||
|
- 发布历史、演讲记录、白皮书链接构成可核验的项目进展证据链,是跟踪 AIBrix 动态的一手材料
|
||||||
|
- 特性清单完整覆盖行业热点(LoRA、前缀路由、KV 复用、异构混部、故障检测),可作功能对照表
|
||||||
|
- 字节跳动 + vllm-project 双背书,社区可信度较高
|
||||||
|
|
||||||
|
**不足**:
|
||||||
|
- 无任何性能基准、架构原理与生产案例,效果类宣称无法验证
|
||||||
|
- 特性描述停留在名词层面(如"GPU 硬件故障检测"仅一句话),无法支撑深入评估
|
||||||
|
- 与 vLLM 生态的绑定程度、异构混部降本的具体路径均未展开
|
||||||
|
|
||||||
|
**适用场景**:关注云原生 LLM 推理平台选型的架构师(作为候选名单与功能对照);K8s 团队借鉴其能力框架;追踪字节开源技术动向的研究者。
|
||||||
|
|
||||||
|
**关联建议**:阅读其 arXiv 白皮书(2504.03648)获取架构与基准细节;与 llm-d(CNCF Sandbox)、NVIDIA Dynamo 做三方案横向对比;结合 cr7258《Lesson 06》中 AIBrix 章节理解其 PD 分离支持方式。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 配图
|
||||||
|
|
||||||
|

|
||||||
@@ -0,0 +1,130 @@
|
|||||||
|
# 基于 Prefill/Decode 分离的大规模推理 Serving 架构
|
||||||
|
|
||||||
|
> **来源**:H3C 新华三官网(《数字化领航》AI应用专刊)
|
||||||
|
> **作者**:未知(未署名)
|
||||||
|
> **发布日期**:2026-04-27
|
||||||
|
> **原文链接**:https://www.h3c.com/cn/d_202604/2832717_233453_0.htm
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 摘要
|
||||||
|
|
||||||
|
随着大语言模型(LLM)在MaaS(Model as a Service)场景下的广泛应用,服务端面临着极其复杂的流量特征:极端的变长输入、突发的并发请求以及严格的延迟SLA(TTFT与TPOT)。传统的整体式推理架构在处理这些挑战时,往往受限于显存碎片化和计算/访存特性的冲突,难以兼顾高吞吐与低时延。本文探讨了一种基于Prefill/Decode(PD)分离的解耦式Serving架构,重点分析了如何利用PD分离部署结合智能路由、全局KVCache管理及专家并行(EP)等关键技术,解决大规模部署中的资源瓶颈,提出了一套能够最大化GPU利用率并有效应对高并发的系统级解决方案。
|
||||||
|
|
||||||
|
## 关键词
|
||||||
|
|
||||||
|
大规模推理部署;高并发;Serving架构;PD分离;KV Cache优化
|
||||||
|
|
||||||
|
## 引言
|
||||||
|
|
||||||
|
大模型推理的本质是由两个截然不同的阶段组成的:Prefill(预填充)阶段和Decode(解码)阶段。
|
||||||
|
|
||||||
|
**◆Prefill阶段:**处理输入的Prompt,是一次性的计算密集型(Compute-bound)任务,对算力要求极高,注重吞吐。
|
||||||
|
|
||||||
|
**◆Decode阶段:**逐Token生成回复,是内存带宽密集型(Memory-bound)任务,受限于显存带宽,注重时延。
|
||||||
|
|
||||||
|
图1 大模型推理过程的两个阶段
|
||||||
|
|
||||||
|
在传统的Continuous Batching(连续批处理)架构中,Prefill和Decode任务混合运行在同一张GPU上。当并发量激增且请求长度差异巨大时,Prefill任务会显著抢占计算资源,导致正在Decode的请求出现明显的卡顿(Inter-token latency增加)。同时,KV Cache的显存占用随着并发数线性增长,极易触发OOM(Outof Memory),限制了系统的最大并发数。
|
||||||
|
|
||||||
|
为了解决上述MaaS场景下的核心痛点,PD分离(Prefill-DecodeDisaggregation)架构应运而生。本文将阐述该架构的设计原理及其在DeepSeekV3等大规模MoE模型部署中的深度优化实践。
|
||||||
|
|
||||||
|
## 1 Prefill/Decode分离架构原理与核心优势
|
||||||
|
|
||||||
|
### 1.1 解耦设计的理论基础
|
||||||
|
|
||||||
|
PD分离的核心思想是将推理集群划分为两类独立的实例池:
|
||||||
|
|
||||||
|
**1)Prefill实例池:**专门负责Prompt处理,计算出KV Cache。该池通常配置高算力利用率的调度策略。
|
||||||
|
|
||||||
|
**2)Decode实例池:**专门负责Token生成。该池通过接收Prefill阶段生成的KVCache,专注于低延迟的Token输出。
|
||||||
|
|
||||||
|
### 1.2 架构协同流程
|
||||||
|
|
||||||
|
在一个典型的优化后架构中,处理流程如下:
|
||||||
|
|
||||||
|
**1)请求接入:**流量经过网关进入全局调度器(Global Scheduler)。
|
||||||
|
|
||||||
|
**2)Prefill计算:**调度器将请求分发至Prefill节点,节点快速并行计算,生成KV Cache。
|
||||||
|
|
||||||
|
**3)KV传输:**通过高速互联网络(如RDMA、NVLink)将KVCache从Prefill节点传输至选定的Decode节点。
|
||||||
|
|
||||||
|
**4)Decode生成:**Decode节点加载KVCache,开始自回归生成,直至结束。
|
||||||
|
|
||||||
|
图2 PD分离架构下请求处理过程
|
||||||
|
|
||||||
|
这种分离彻底消除了Prefill计算对Decode生成的干扰,使得我们可以针对两个阶段不同的硬件特性(计算密集 vs 访存密集)进行异构硬件选型或独立的参数调优。
|
||||||
|
|
||||||
|
## 2 Serving架构的深度优化:迈向极致性能
|
||||||
|
|
||||||
|
仅实现物理上的分离不足以应对大规模高并发,必须引入系统级的深度优化。我们重点探讨以下关键技术。
|
||||||
|
|
||||||
|
### 2.1 智能路由与全局调度 (Smart Routing)
|
||||||
|
|
||||||
|
在MaaS场景下,请求并非无状态。为了提高缓存命中率,调度器必须具备"记忆"能力。
|
||||||
|
|
||||||
|
**◆KV Cache-Aware Routing(KV Cache感知路由):**调度器维护全局的KVCache分布表。当一个新的请求包含常见的前缀(如System Prompt或多轮对话的历史记录)时,智能路由会将该请求分发到已经存有该前缀KV Cache的节点上。
|
||||||
|
|
||||||
|
**◆负载感知均衡策略:**调度器需实时预测各节点的显存水位和计算负载,在"缓存亲和性"与"负载均衡"之间寻找最优解,避免热点节点过载。
|
||||||
|
|
||||||
|
图3 缓存、负载感知调度流程示意
|
||||||
|
|
||||||
|
### 2.2 极致的KV Cache管理:前缀缓存与卸载
|
||||||
|
|
||||||
|
KV Cache是推理过程中最大的显存开销,也是PD分离中传输的瓶颈。
|
||||||
|
|
||||||
|
**◆前缀缓存(Prefix Caching / Radix Attention):**
|
||||||
|
|
||||||
|
利用基数树(Radix Tree)结构管理KV Cache。对于多轮对话或RAG(检索增强生成)场景,大量Prompt具有公共前缀。系统通过Radix Attention机制,自动匹配并复用显存中已有的KV块,通过减少重复计算(Re-computation)大幅降低TTFT(首字延迟)。
|
||||||
|
|
||||||
|
**◆KV Cache 卸载(Offloading):**
|
||||||
|
|
||||||
|
当高并发导致GPU显存不足时,传统的做法是驱逐(Evict)缓存。优化后的架构引入多级存储层次:GPU HBM→Host RAM→SSD。利用PCIe带宽,将暂时不活跃的KVCache卸载到CPU内存,需要时再快速预取(Prefetch)。这使得单卡支持的并发容量提升了数倍。
|
||||||
|
|
||||||
|
图4 多级KV Cache缓存卸载示意
|
||||||
|
|
||||||
|
### 2.3 高效通信与流水线掩盖
|
||||||
|
|
||||||
|
PD分离引入了额外的KV传输开销。为了掩盖这一延迟,系统设计必须做到通信与计算的重叠(Overlap)。
|
||||||
|
|
||||||
|
**◆分层分块传输:**在Prefill计算过程中,不等待全部层计算完毕,而是采用流水线方式,计算完一层(Layer)即传输一层,使得Decode节点可以尽早开始加载数据。
|
||||||
|
|
||||||
|
**◆传输协议优化:**基于RDMA技术优化传输协议,绕过CPU直接在GPU显存间传输数据,减少系统调用开销。
|
||||||
|
|
||||||
|
## 3 应对超大模型:大EP专家并行与MoE优化
|
||||||
|
|
||||||
|
对于如DeepSeek-V3/R1这类采用混合专家(MoE)架构的超大模型,参数量巨大(如671B),单卡无法容纳,且计算模式更为稀疏。
|
||||||
|
|
||||||
|
### 3.1 大EP(Expert Parallelism)专家并行
|
||||||
|
|
||||||
|
在混合专家(MoE)架构中,每个Token只激活少部分专家。为了解决通信瓶颈,架构采用了大规模专家并行:
|
||||||
|
|
||||||
|
**◆专家分布:**将不同的专家网络分布在不同的GPU甚至不同的节点上,针对SharedExperts(共享专家)进行特殊处理,确保这些高频访问的参数常驻高速缓存。
|
||||||
|
|
||||||
|
**◆All-to-All通信优化:**在推理过程中,Token需要被路由到特定的专家所在的GPU进行计算,计算后再汇聚。这产生的大量All-to-All通信,通过优化算子和网络拓扑感知(Topology-aware)路由进行加速,确保高并发下的通信不阻塞计算。
|
||||||
|
|
||||||
|
### 3.2 专家间负载均衡 (EPLB)
|
||||||
|
|
||||||
|
在混合专家(MoE)架构的推理中,大规模并发下,会导致显著的负载不均衡。例如,在处理大量编程类请求时,负责"代码生成"的专家所在的 GPU 会成为计算热点,而其他处理通用文本的 GPU 则处于空闲状态。这会导致整个 Batch 的推理延迟取决于最慢的那个 GPU,严重拖累 TPOT(Token Per Output Token)。
|
||||||
|
|
||||||
|
为了解决这一问题,系统引入了EPLB(Expert Parallelism Load Balancing) 机制,从系统层面动态抹平计算负载:
|
||||||
|
|
||||||
|
**1)基于预测的动态冗余(PredictiveDynamic Redundancy):**
|
||||||
|
|
||||||
|
传统的 EP 策略通常是静态分配专家。EPLB 机制引入了"热点漂移"监测。Serving系统会实时统计滑动窗口内的专家激活热度图(Heatmap)。当识别到特定专家(Hot Expert)的访问频率持续超过阈值时,系统会利用闲置的显存资源,在低负载的GPU节点上动态复制该专家的权重副本。调度器随后将部分Token路由至副本节点,通过多路冗余计算消除单点瓶颈。
|
||||||
|
|
||||||
|
**2)通信感知的全局规约优化:**
|
||||||
|
|
||||||
|
在专家并行中,Token的Dispatch(分发)和 Combine(汇聚)涉及海量的All-to-All通信。EPLB不仅均衡计算,还均衡通信量。通过感知网络拓扑,EPLB 算法会尽量将激活相同专家的Token打包,或者优先调度位于同一 NVLink 域内的专家请求,减少跨节点的 RDMA 通信开销,确保计算密集型与通信密集型任务在时间轴上的完美交错(Overlap)。
|
||||||
|
|
||||||
|
## 4 动态自适应资源调度
|
||||||
|
|
||||||
|
现代Serving架构不仅是静态的执行引擎,更是动态的调节系统。
|
||||||
|
|
||||||
|
◆动态配额调整:系统根据实时流量监控和实例上报的Metric指标动态伸缩实例个数。同时,在没有额外资源时,实现PD实例角色转换,闲置P实例可转为D实例(反之亦然),智能调整PD配比,实现资源复用。
|
||||||
|
|
||||||
|
图5 PD实例动态伸缩与转换示意
|
||||||
|
|
||||||
|
## 5 结束语
|
||||||
|
|
||||||
|
面对MaaS场景下的大规模AI推理挑战,单一的技术手段已无法满足需求。通过Prefill/Decode分离架构的落地,配合智能路由、前缀缓存(Radix Attention)、KV Cache卸载以及针对MoE模型的大EP并行策略和EPLB专家负载均衡策略,可以构建一套高吞吐、低时延的现代化Serving系统。这种系统级优化方案,可成功将GPU利用率提升至新的高度,解决了高并发下的资源争抢问题,为万亿参数时代的实时AI应用提供了坚实的算力底座。
|
||||||
@@ -0,0 +1,81 @@
|
|||||||
|
# 📊 文章摘要:基于 Prefill/Decode 分离的大规模推理 Serving 架构
|
||||||
|
|
||||||
|
> **原文**:[2026-04-27_基于_Prefill_Decode_分离的大规模推理_Serving_架构.md](./2026-04-27_基于_Prefill_Decode_分离的大规模推理_Serving_架构.md)
|
||||||
|
> **原文链接**:https://www.h3c.com/cn/d_202604/2832717_233453_0.htm
|
||||||
|
> **来源**:H3C 新华三官网(《数字化领航》AI应用专刊)
|
||||||
|
> **作者**:未知(未署名)
|
||||||
|
> **发布日期**:2026-04-27
|
||||||
|
> **摘要日期**:2026-08-06
|
||||||
|
> **价值评级**:⭐⭐ 中
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 核心命题
|
||||||
|
|
||||||
|
> **系统解耦** — 把 PD 分离扩展为"智能路由 + 全局 KV 管理 + 通信流水线 + 大 EP/EPLB + 动态调度"的 Serving 系统级组合方案,面向 MoE 超大模型。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 文章概要
|
||||||
|
|
||||||
|
本文从 MaaS 场景高并发、变长输入与严格延迟 SLA 的痛点出发,论证"仅实现物理分离不足以应对大规模高并发",须叠加系统级优化:KV Cache 感知的智能路由与负载感知均衡、Radix Attention 前缀缓存、HBM→Host RAM→SSD 多级 KV 卸载、分层分块传输与 RDMA 掩盖开销;并针对 DeepSeek-V3 类 MoE 模型引入大 EP 专家并行与 EPLB 负载均衡(热点漂移监测、预测动态冗余、通信感知规约),最后以 PD 实例动态伸缩与 P/D 角色转换收尾。重要在于给出了"PD 分离 × 专家并行"的完整架构清单,其中 EPLB 与实例角色转换是同类文章中少见的机制。局限:全文无量化数据与可复现配置,宣称收益无法验证。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 关键要点
|
||||||
|
|
||||||
|
1. **双实例池架构** — Prefill 实例池(计算密集、注重吞吐)与 Decode 实例池(访存密集、注重时延)解耦,消除干扰并支持异构硬件选型 `[分类: 共识]`
|
||||||
|
2. **KV 感知智能路由** — 调度器维护全局 KV Cache 分布表,在缓存亲和性与负载均衡之间寻优,避免热点节点过载 `[分类: 共识]`
|
||||||
|
3. **前缀缓存与多级卸载** — Radix Attention 复用公共前缀降低 TTFT;KV 卸载至 Host RAM/SSD 并预取,单卡并发容量提升数倍 `[分类: 共识]`
|
||||||
|
4. **通信与计算重叠** — 逐层流水线传输(算完一层传一层)+ RDMA 绕过 CPU,掩盖 KV 传输延迟 `[分类: 共识]`
|
||||||
|
5. **大 EP 专家并行** — MoE 专家分散多卡、共享专家常驻高速缓存、All-to-All 通信拓扑感知优化 `[分类: 共识]`
|
||||||
|
6. **EPLB 专家负载均衡** — 滑动窗口专家激活热度图监测 + 动态复制热点专家权重做冗余 + 通信感知全局规约,消除"最慢 GPU 拖累 TPOT" `[分类: 未探索]`
|
||||||
|
7. **动态自适应调度** — 实例按流量伸缩,闲置 P 实例可转 D 实例(反之亦然),智能调整 PD 配比实现资源复用 `[分类: 未探索]`
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 批判性分析
|
||||||
|
|
||||||
|
### 假设前提
|
||||||
|
|
||||||
|
假设集群规模大到实例池与动态伸缩有意义;假设 RDMA/NVLink 网络与多级存储(HBM/RAM/SSD)就绪;立论默认聚焦 MoE 超大模型(671B 级),中小模型场景不在讨论范围。
|
||||||
|
|
||||||
|
### 论据与逻辑
|
||||||
|
|
||||||
|
"痛点→分离→组件优化"的逻辑链完整,但几乎全为定性论述:无吞吐、时延、并发数等量化证据,"提升数倍""新的高度"等表述无法证伪;EPLB 冗余复制的代价(显存占用、权重一致性)也未量化。
|
||||||
|
|
||||||
|
### 边界与局限
|
||||||
|
|
||||||
|
厂商方案视角,未与 vLLM/Mooncake 等开源社区方案对比;非 MoE 或小规模场景的适用性未讨论;实例角色转换的状态迁移与 KV 归属等工程代价未展开;作者未署名,权威性有限。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 可引用金句
|
||||||
|
|
||||||
|
> "调度器需实时预测各节点的显存水位和计算负载,在'缓存亲和性'与'负载均衡'之间寻找最优解,避免热点节点过载。"
|
||||||
|
|
||||||
|
> "现代Serving架构不仅是静态的执行引擎,更是动态的调节系统。"
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 总体评价
|
||||||
|
|
||||||
|
**亮点**:
|
||||||
|
- "PD 分离 + MoE 专家并行"的组合视角少见,EPLB 机制描述具体
|
||||||
|
- 覆盖路由、缓存、卸载、通信、调度全组件,可作系统设计清单
|
||||||
|
- 明确指向 DeepSeek-V3 等万亿级 MoE 部署场景
|
||||||
|
|
||||||
|
**不足**:
|
||||||
|
- 无任何量化数据,收益宣称无法验证
|
||||||
|
- 未与开源方案对比,缺乏可复现配置
|
||||||
|
- 各组件仅概念级描述,工程深度不足
|
||||||
|
|
||||||
|
**适用场景**:Serving 架构师构思 MoE 大模型系统级优化方案时的组件清单参考。
|
||||||
|
|
||||||
|
**关联建议**:对照 DeepSeek-V3 技术报告中 EPLB 与 PD 分离章节;阅读 Mooncake 论文获取以 KV 为中心调度的实证数据。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 配图
|
||||||
|
|
||||||
|

|
||||||
@@ -0,0 +1,104 @@
|
|||||||
|
# 推理单位经济学:每百万Token的真实成本
|
||||||
|
|
||||||
|
> **来源**:Introl
|
||||||
|
> **作者**:未知
|
||||||
|
> **发布日期**:2026-02-09
|
||||||
|
> **原文链接**:https://introl.com/zh/blog/inference-unit-economics-true-cost-per-million-tokens-guide
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
*更新于2025年12月8日*
|
||||||
|
|
||||||
|
**2025年12月更新:** 大语言模型推理成本以每年10倍的速度下降——比PC计算能力或互联网泡沫时期的带宽下降更快。GPT-4同等性能的成本从2022年底的每百万token 20美元降至现在的0.40美元。云端H100价格在从峰值下跌64-75%后稳定在2.85-3.50美元/小时。DeepSeek以比行业领先者低90%的定价颠覆了市场。自托管部署的收支平衡点:7B模型需要50%以上的GPU利用率,13B模型需要10%以上。量化技术可降低60-70%的运营成本。推测解码将延迟降低2-3倍。
|
||||||
|
|
||||||
|
大语言模型推理市场打破了传统的技术经济学规律。价格下降速度超过了微处理器革命时期的PC计算能力或互联网泡沫时期的带宽——同等性能的成本每年下降10倍。¹ 2022年底每百万token需要20美元的能力,现在只需0.40美元。² 然而,组织仍然难以理解其真实的推理成本,因为token级别的定价掩盖了基础设施的现实,GPU利用率决定了实际的单位经济效益,而优化技术带来了数量级的成本效率差异。掌握推理经济学决定了AI部署是创造价值还是消耗资本。
|
||||||
|
|
||||||
|
## 2025年12月的推理定价格局
|
||||||
|
|
||||||
|
API定价因模型能力、提供商和优化程度的不同而跨越三个数量级。了解当前格局为经济决策提供了背景。
|
||||||
|
|
||||||
|
**经济型模型**现在每百万token只需几分之一美分。Google的Gemini Flash-Lite以每百万输入token 0.075美元和每百万输出token 0.30美元领先。³ 通过Together.ai或Hyperbolic等提供商使用的开源模型价格更低——Llama 3.2 3B每百万token仅需0.06美元,MMLU得分42,成本仅为三年前的千分之一。⁴
|
||||||
|
|
||||||
|
**中端生产模型**在能力和成本之间取得平衡。Claude Sonnet 4每百万输入token定价3美元,每百万输出token 15美元。⁵ DeepSeek的R1模型以每百万输入token 0.55美元和输出token 2.19美元的价格颠覆了市场——在具备相当推理能力的情况下,比西方竞争对手低90%。⁶ 中国提供商持续以更低的价格挑战西方领先者,引入的价格压力使所有买家受益。
|
||||||
|
|
||||||
|
**前沿能力模型**定价较高。Claude Opus 4每百万输入token 15美元,每百万输出token 75美元。⁷ GPT-4和类似的前沿模型定价相近,其合理性在于这些能力是较小模型无论如何优化成本都无法复制的。
|
||||||
|
|
||||||
|
**提供商差异**增加了复杂性。对于相同的模型,最便宜和最贵的提供商之间价格相差10倍。⁸ 同一个模型可能在最便宜的提供商处每百万token 0.90美元,中位数为3.50美元,最贵的为9.50美元。在进行任何技术优化之前,跨提供商比价就能显著影响经济效益。
|
||||||
|
|
||||||
|
**输出token定价不对称**反映了实际成本。OpenAI、Anthropic和Google对输出token的定价比输入token高3-5倍,因为输出生成需要顺序处理,而输入处理可以高效并行。⁹ 生成长输出的应用与处理长输入但仅需简短回复的应用面临不同的经济学。
|
||||||
|
|
||||||
|
## 理解真实的GPU基础设施成本
|
||||||
|
|
||||||
|
API定价背后是具有自身成本结构的GPU基础设施。理解这些经济学能够做出明智的自建与购买决策。
|
||||||
|
|
||||||
|
**硬件采购成本**起点很高且持续累积。NVIDIA H100 GPU每张卡售价25,000-40,000美元,包含基础设施的完整8-GPU服务器系统达到200,000-400,000美元。¹⁰ NVIDIA每张H100的制造成本约为3,320美元——生产成本与销售价格之间的差距反映了需求驱动的利润率,这一利润率直到最近才开始缓和。
|
||||||
|
|
||||||
|
**云端GPU租赁价格**在大幅下降后趋于稳定。H100 SXM实例的价格从1.49美元/小时(Hyperbolic)到6.98美元/小时(Azure)不等,大多数提供商在从峰值下降64-75%后集中在2.85-3.50美元/小时。¹¹ 预留容量可进一步降低费率——Lambda Labs提供1.85美元/小时,Hyperstack承诺起价1.90美元/小时。
|
||||||
|
|
||||||
|
**电力和冷却成本**使硬件费用进一步增加。每张H100在负载下消耗高达700W。多GPU集群需要专用配电单元,设施升级可能花费10,000-50,000美元。¹² 液冷基础设施或增强型暖通空调系统根据规模增加15,000-100,000美元。这些成本分摊到GPU使用时间中,但显著影响总拥有成本的经济性。
|
||||||
|
|
||||||
|
**运营开销**弥合了硬件租赁与实际成本之间的差距。考虑冷却、设施和维护因素后,原始GPU租赁费率每小时增加约2-7美元,使8×H100的真实运营成本在正确分摊后达到8-15美元/小时。¹³ 比较云端租赁与API定价的组织必须包含这些隐性成本才能进行有效比较。
|
||||||
|
|
||||||
|
## 决定可行性的利用率方程
|
||||||
|
|
||||||
|
GPU利用率决定了自托管推理是否具有经济意义。为运行在10%负载的GPU付费会将每千token 0.013美元转变为0.13美元——比高端API还贵。¹⁴
|
||||||
|
|
||||||
|
**收支平衡分析**取决于模型大小和利用率目标。托管7B模型大约需要50%的利用率才能比GPT-3.5 Turbo更便宜。¹⁵ 13B模型仅需10%的利用率即可实现与GPT-4-turbo的成本持平,因为较大模型的能力溢价证明了更高的基础设施投资是合理的。关键洞察:较大模型在较低利用率下即可实现收支平衡,因为它们替代的是更昂贵的API替代方案。
|
||||||
|
|
||||||
|
**流量模式**决定了可实现的利用率。工作负载一致且可预测的组织比需求零散的组织能实现更高的利用率。具有日常流量周期的面向消费者的应用在非高峰时段会浪费GPU容量,除非工作负载可以转移或基础设施可以动态扩展。
|
||||||
|
|
||||||
|
**请求量阈值**确立了最小可行规模。分析表明,每天需要超过8,000次对话,自托管基础设施的成本才会低于托管解决方案。¹⁶ 低于此阈值,自托管的运营复杂性和固定成本将超过潜在节省。
|
||||||
|
|
||||||
|
**批处理机会**改善了利用率经济性。拥有可延迟工作负载的组织——离线分析、批量嵌入、数据集处理——可以将需求聚合到高利用率窗口中,即使实时流量变化也能提高有效利用率。在共享基础设施上混合实时和批处理工作负载可优化资本效率。
|
||||||
|
|
||||||
|
## 生产部署的成本结构分解
|
||||||
|
|
||||||
|
生产推理成本分解为可单独优化的组成部分。
|
||||||
|
|
||||||
|
**模型加载和内存**无论流量多少都消耗固定资源。FP16格式的70B参数模型大约需要140GB GPU内存——超过单GPU容量,因此无论流量多少都必须采用多GPU配置。¹⁷ 内存成本随模型大小而非使用量扩展,创造了与流量无关的最低基础设施门槛。
|
||||||
|
|
||||||
|
**每token计算**驱动推理过程中的边际成本。前向传播计算随模型架构扩展——特别是长上下文的注意力机制。计算成本随批处理而下降,因为矩阵运算在较大批量大小时变得更高效,将开销分摊到更多token上。
|
||||||
|
|
||||||
|
**KV缓存内存**随上下文长度和并发请求增长。每个活动请求维护的键值缓存消耗与上下文长度成正比的内存。长上下文应用面临内存压力,限制并发请求,降低吞吐量并增加每token成本。KV缓存管理是主要的优化目标。
|
||||||
|
|
||||||
|
**网络和存储I/O**影响多GPU和分布式部署。用于张量并行的GPU间通信、从存储加载模型权重以及传输结果都消耗资源。高带宽网络(NVLink、InfiniBand)减少I/O瓶颈,但增加基础设施投资。
|
||||||
|
|
||||||
|
**运营开销**包括监控、日志记录、安全和管理。生产系统需要可观测性基础设施、值班人员和持续的优化工作。组织在比较自托管与API替代方案时经常低估这些"软"成本。
|
||||||
|
|
||||||
|
## 改变经济性的优化技术
|
||||||
|
|
||||||
|
技术优化可以将推理成本降低60-70%甚至更多,将边际经济转变为可持续的优势。¹⁸
|
||||||
|
|
||||||
|
**量化**将模型权重的精度从32位浮点数减少到8位或4位表示。该技术将模型大小缩小4-8倍,同时保持可接受的准确性。¹⁹ 8位量化减少50%的内存使用,准确性损失约1%。4位量化实现75%的大小减少,同时在许多应用中保持有竞争力的性能。Blackwell GPU的FP4支持使仅通过量化即可实现4倍性能提升。
|
||||||
|
|
||||||
|
**连续批处理**动态分组请求,而不是等待固定批次完成。传统批处理等待最长序列完成后才处理新请求。连续批处理立即驱逐已完成的序列,并在其他序列仍在处理时开始新请求。²⁰ 该技术显著提高了序列长度变化的工作负载的GPU利用率——这正是大多数生产部署展现的模式。
|
||||||
|
|
||||||
|
**推测解码**使用小型"草稿"模型预测多个token,然后由较大的"验证"模型并行检查。²¹ 当预测正确时,每次前向传播生成多个token而非标准的单个token。该技术将延迟降低2-3倍,适用于小型模型能准确预测较大模型输出的应用——对于受限领域或结构化输出特别有效。
|
||||||
|
|
||||||
|
**KV缓存优化**包括PagedAttention像虚拟内存一样管理缓存内存,减少碎片化并实现更高的并发性。²² 缓存压缩技术进一步减少内存占用。前缀缓存在请求共享公共前缀时避免重新计算——对于具有结构化提示或系统指令的应用很有价值。
|
||||||
|
|
||||||
|
**模型蒸馏**创建针对特定领域近似较大模型行为的较小模型。针对目标任务匹配GPT-4性能的蒸馏7B模型以很小的基础设施成本运行,同时保持与应用相关的质量。²³ 蒸馏需要前期训练投资,但能产生持续的推理节省。
|
||||||
|
|
||||||
|
这些技术组合会产生复合效果。应用量化(4倍)、连续批处理(2倍)和推测解码(2倍)的组织可能比原始部署实现16倍的有效成本降低——将看似边际的经济性转变为实质性优势。
|
||||||
|
|
||||||
|
## API与自托管决策框架
|
||||||
|
|
||||||
|
自建与购买的决策取决于简单成本比较之外的因素。
|
||||||
|
|
||||||
|
**在以下情况选择API推理:**
|
||||||
|
- 流量零散或不可预测
|
||||||
|
- 每天的对话量低于8,000次
|
||||||
|
- 工程能力有限
|
||||||
|
- 快速迭代模型选择有价值
|
||||||
|
- 合规要求可通过提供商认证满足
|
||||||
|
- 延迟要求与提供商SLA匹配
|
||||||
|
|
||||||
|
**在以下情况选择自托管:**
|
||||||
|
- 流量一致且数量大
|
||||||
|
- GPU利用率可持续超过50%
|
||||||
|
- 数据主权阻止使用云端API
|
||||||
|
- 定制模型需要专门的服务
|
||||||
|
- 延迟要求超过提供商能力
|
||||||
|
- 成本优化证明工程投资是合理的
|
||||||
|
|
||||||
|
**混合方法**通常证明是最优的。组织将基准(注:原文结尾部分在抓取时被截断,此处为已获取内容的末尾。)
|
||||||
@@ -0,0 +1,80 @@
|
|||||||
|
# 📊 文章摘要:推理单位经济学:每百万Token的真实成本
|
||||||
|
|
||||||
|
> **原文**:[2026-02-09_推理单位经济学_每百万Token的真实成本.md](./2026-02-09_推理单位经济学_每百万Token的真实成本.md)
|
||||||
|
> **原文链接**:https://introl.com/zh/blog/inference-unit-economics-true-cost-per-million-tokens-guide
|
||||||
|
> **来源**:Introl
|
||||||
|
> **作者**:未知
|
||||||
|
> **发布日期**:2026-02-09
|
||||||
|
> **摘要日期**:2026-08-06
|
||||||
|
> **价值评级**:⭐⭐⭐ 高
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 核心命题
|
||||||
|
|
||||||
|
> **推理算账** — token 级别的定价掩盖了基础设施现实,真实推理成本由 GPU 利用率与优化技术决定,掌握推理经济学决定 AI 部署是创造价值还是消耗资本。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 文章概要
|
||||||
|
|
||||||
|
本文系统拆解 LLM 推理的单位经济账:同等性能成本以每年约 10 倍速度下降,从 2022 年底每百万 token 20 美元降至 0.40 美元;逐一量化 API 定价格局、GPU 硬件与云租成本、电力和运营开销,提出"利用率方程"(7B 模型需 50% 利用率、13B 模型仅需 10% 即可自托管收支平衡,日均 8000 次对话为最小可行阈值),并说明量化、连续批处理、推测解码、KV 缓存优化、蒸馏等技术的复合效应可带来 16 倍成本降低,最后给出 API 与自托管的决策框架。价值在于把成本决策从感觉变为可计算的框架。局限:原文结尾被抓取截断,且价格数据时效性强,使用时需更新。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 关键要点
|
||||||
|
|
||||||
|
1. **成本年降 10 倍** — 推理成本下降快于 PC 算力与互联网带宽的历史速度;GPT-4 同等性能从 20 美元降至 0.40 美元/百万 token `[分类: 共识]`
|
||||||
|
2. **API 定价三分格局** — 经济型(Gemini Flash-Lite 输入 0.075/输出 0.30 美元)、中端(Claude Sonnet 4 为 3/15 美元,DeepSeek R1 0.55/2.19 美元、比西方低 90%)、前沿(Claude Opus 4 为 15/75 美元)`[分类: 共识]`
|
||||||
|
3. **输出 token 定价不对称** — 输出贵 3-5 倍源于输出顺序生成、输入可并行处理的实际成本差异 `[分类: 共识]`
|
||||||
|
4. **利用率决定自托管可行性** — 10% 利用率使每千 token 0.013 美元的成本放大 10 倍至 0.13 美元,超过高端 API `[分类: 共识]`
|
||||||
|
5. **收支平衡点与模型大小相关** — 7B 需 50% 利用率、13B 仅需 10%,因为大模型替代的是更贵的 API 替代方案 `[分类: 共识]`(数值依赖对标价格假设)
|
||||||
|
6. **日均 8000 次对话阈值** — 低于此规模自托管的固定成本与运维复杂性超过节省 `[分类: 共识]`
|
||||||
|
7. **优化技术复合效应** — 量化(4 倍)×连续批处理(2 倍)×推测解码(2 倍)可达 16 倍有效成本降低;Blackwell FP4 使量化带来 4 倍性能提升 `[分类: 共识]`
|
||||||
|
8. **决策框架** — 流量零散/低于阈值/工程能力有限选 API;流量一致且利用率超 50%、数据主权受限时选自托管;混合方法通常最优(原文此处被截断)`[分类: 共识]`
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 批判性分析
|
||||||
|
|
||||||
|
### 假设前提
|
||||||
|
|
||||||
|
价格、硬件成本与收支平衡点均为 2025 年 12 月时点的市场数据,随供需快速漂移;假设利用率是成本的主导变量,且读者能准确预测自身流量模式。
|
||||||
|
|
||||||
|
### 论据与逻辑
|
||||||
|
|
||||||
|
全文有编号引用(共 23 处)且覆盖面广,论证链条完整;但"年降 10 倍"是行业观察性总结而非严格统计,"50%/10% 利用率"等平衡点依赖特定 API 对标价格,未给出敏感性分析。
|
||||||
|
|
||||||
|
### 边界与局限
|
||||||
|
|
||||||
|
纯成本对比可能误导:开源小模型与闭源前沿模型的能力不等价,未讨论质量差异的定价逻辑;原文结尾在"混合方法"处截断,该部分论证不完整;未充分展开电力价格、网络带宽等区域差异与工程人力等隐性成本;数据时效性强,2026 年参考需注意更新。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 可引用金句
|
||||||
|
|
||||||
|
> "掌握推理经济学决定了AI部署是创造价值还是消耗资本。"
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 总体评价
|
||||||
|
|
||||||
|
**亮点**:
|
||||||
|
- 把推理成本决策转化为可计算的框架(利用率方程、收支平衡点、请求量阈值)
|
||||||
|
- 数据详实且有编号引用,API 与自托管判据清晰可操作
|
||||||
|
- 明确区分标价与实际成本的差距(运营开销、软成本)
|
||||||
|
|
||||||
|
**不足**:
|
||||||
|
- 原文结尾被抓取截断,混合方案论证不完整
|
||||||
|
- 收支平衡点依赖时点价格,缺少敏感性分析
|
||||||
|
- 成本对比未充分考虑模型质量差异
|
||||||
|
|
||||||
|
**适用场景**:AI 预算与技术选型决策者、负责推理成本优化的平台团队、研究 AI 经济学的人;用于自建 vs 购买的初步量化评估。
|
||||||
|
|
||||||
|
**关联建议**:结合中邮证券 Token 工厂研报理解产业端成本结构(电力占比、CAPEX/OPEX 拆解);结合信通院报告了解优化技术的工程实现;定期更新价格数据以校准平衡点。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 配图
|
||||||
|
|
||||||
|

|
||||||
@@ -0,0 +1,195 @@
|
|||||||
|
# InfiniBand vs 以太网 GPU 集群对比:800G 网络架构决策指南
|
||||||
|
|
||||||
|
> **来源**:Introl
|
||||||
|
> **作者**:未知
|
||||||
|
> **发布日期**:2026-03-27
|
||||||
|
> **原文链接**:https://introl.com/zh/blog/infiniband-vs-ethernet-gpu-clusters-800g-architecture
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
> 注:本页中文版经抓取工具处理时正文被截断,为保证内容完整性,以下正文取自英文原版(https://introl.com/blog/infiniband-vs-ethernet-gpu-clusters-800g-architecture),发布日期与中文版一致(2026-03-27,更新于 2025 年 12 月 8 日)。
|
||||||
|
|
||||||
|
**December 2025 Update:** NVIDIA Spectrum-X 800G Ethernet now shipping and validated for Blackwell deployments, narrowing the InfiniBand advantage for specific workloads. NDR 400G InfiniBand remains dominant for training clusters, with XDR 800G rolling out. The Ultra Ethernet Consortium released UEC 1.0 specification in 2024, with compliant products expected 2025-2026. AI cluster networking increasingly hybrid—InfiniBand for training, Ethernet for inference. 1.6T optics beginning to appear in roadmaps for 2026-2027.
|
||||||
|
|
||||||
|
The network connecting 10,000 GPUs determines whether they operate as a unified supercomputer or an expensive collection of isolated processors, yet most infrastructure teams make this $50 million decision based on vendor marketing rather than engineering analysis.¹ Meta standardized on Ethernet after discovering that InfiniBand's 15% performance advantage couldn't justify 2.3x higher total cost of ownership across their 600,000 GPU fleet.² Meanwhile, OpenAI credits InfiniBand's superior congestion control for enabling GPT-4 training to complete 40% faster than initial Ethernet-based attempts.³ The contradictory experiences reveal a fundamental truth: the "correct" choice depends entirely on workload characteristics, scale ambitions, and economic constraints.
|
||||||
|
|
||||||
|
Network architecture decisions reverberate for years through every aspect of AI infrastructure. InfiniBand's proprietary ecosystem locks organizations into NVIDIA's roadmap but delivers predictable performance for distributed training. Ethernet's open standards enable vendor flexibility and cost optimization but require sophisticated tuning to match InfiniBand's out-of-box efficiency. The choice affects not just current deployments but future scalability, as switching technologies later means replacing millions of dollars in switches, cables, and network cards.
|
||||||
|
|
||||||
|
The stakes escalate with each generation of hardware. NVIDIA's Spectrum-X promises to bring InfiniBand-like performance to Ethernet at 800Gbps speeds, potentially obsoleting the InfiniBand advantage.⁴ Intel's Ultra Ethernet Consortium pushes open standards that could fragment the market further.⁵ Organizations deploying infrastructure today must predict which technology will dominate in 2030, when current investments fully depreciate. Wrong predictions strand assets and constrain capabilities just as AI competition intensifies.
|
||||||
|
|
||||||
|
## Technical architectures reveal fundamental differences
|
||||||
|
|
||||||
|
InfiniBand emerged from supercomputing requirements where microseconds determine success or failure. The architecture assumes lossless transmission through credit-based flow control, where senders only transmit when receivers guarantee buffer availability.⁶ This eliminates packet drops but requires tight coupling between endpoints. Every InfiniBand device participates in a subnet manager's centralized routing decisions, creating deterministic paths optimized for specific traffic patterns. The approach delivers consistent sub-microsecond latency but struggles with dynamic workloads that deviate from expected patterns.
|
||||||
|
|
||||||
|
Ethernet evolved from local area networks where simplicity and interoperability mattered more than absolute performance. The architecture assumes lossy transmission with best-effort delivery, relying on higher-layer protocols for reliability. Packet drops trigger congestion control algorithms that reduce transmission rates, preventing network collapse but increasing latency variance. Ethernet's distributed routing decisions enable massive scale and flexibility but create unpredictable performance under load. Modern data center Ethernet adds features like Priority Flow Control and Explicit Congestion Notification to approach InfiniBand's lossless behavior.⁷
|
||||||
|
|
||||||
|
RDMA (Remote Direct Memory Access) capabilities distinguish both technologies from traditional networking. InfiniBand included RDMA natively, enabling direct memory transfers between systems without CPU involvement.⁸ RDMA over InfiniBand achieves 0.5 microsecond latency for small messages, 10x better than kernel-based networking. Ethernet added RDMA through RoCE (RDMA over Converged Ethernet), delivering similar performance when properly configured. However, RoCE requires pristine network conditions that prove difficult to maintain at scale.
|
||||||
|
|
||||||
|
Switching architectures differ fundamentally between technologies. InfiniBand switches operate as crossbar fabrics with non-blocking bandwidth between all ports.⁹ A 40-port HDR InfiniBand switch provides 16Tb/s aggregate bandwidth with consistent latency regardless of traffic pattern. Ethernet switches use shared memory architectures with statistical multiplexing, achieving higher port densities but variable performance under congestion. The architectural difference means InfiniBand maintains predictable performance while Ethernet offers better economics.
|
||||||
|
|
||||||
|
Management planes reflect different philosophical approaches. InfiniBand's Subnet Manager provides centralized control with global visibility into topology and traffic.¹⁰ The manager calculates optimal routes, handles failures, and maintains quality of service without manual intervention. Ethernet relies on distributed protocols like spanning tree, OSPF, or BGP that require careful configuration. Software-defined networking brings centralized control to Ethernet but adds complexity and potential failure points. The management difference affects operational overhead significantly at scale.
|
||||||
|
|
||||||
|
## Performance metrics beyond raw bandwidth
|
||||||
|
|
||||||
|
Latency measurements reveal nuanced differences between technologies. InfiniBand HDR achieves 0.6 microsecond port-to-port latency consistently across all message sizes.¹¹ Ethernet at 100Gbps shows 1.2 microsecond baseline latency that degrades to 50+ microseconds under congestion. The 2x baseline difference becomes 100x under load. For distributed training where gradient synchronization occurs millions of times, microsecond differences compound into hours of additional training time.
|
||||||
|
|
||||||
|
Bandwidth efficiency tells a different story than marketing specifications. InfiniBand delivers 95% of theoretical bandwidth for large transfers due to efficient encoding and minimal protocol overhead.¹² 200Gbps InfiniBand sustains 190Gbps actual throughput. Ethernet's overhead varies with configuration: standard Ethernet achieves 85% efficiency, while RoCE v2 reaches 92% with proper tuning. The efficiency gap narrows at 800Gbps speeds where both technologies use similar PAM4 encoding.
|
||||||
|
|
||||||
|
Congestion behavior separates technologies dramatically. InfiniBand's credit-based flow control prevents congestion by stopping transmission before buffers overflow.¹³ Performance degrades gracefully as load increases. Ethernet's packet drops trigger TCP-style backoff algorithms that create saw-tooth throughput patterns. Incast scenarios where multiple senders overwhelm a single receiver cause catastrophic performance collapse on poorly tuned Ethernet. InfiniBand handles the same scenario with minimal degradation.
|
||||||
|
|
||||||
|
Scalability testing exposes architectural limits. InfiniBand fabrics scale to 48,000 nodes in a single subnet with three-tier fat tree topologies.¹⁴ Larger deployments require multiple subnets connected through routers, adding complexity. Ethernet scales to millions of nodes using hierarchical routing but requires careful design to maintain performance. Facebook's data centers connect 100,000+ servers using Ethernet with custom protocols for traffic engineering.¹⁵ The examples show both technologies scale, but through different mechanisms.
|
||||||
|
|
||||||
|
Reliability metrics favor InfiniBand slightly in controlled environments. InfiniBand's lossless transmission and automatic path migration achieve 99.999% packet delivery.¹⁶ Ethernet with proper redundancy reaches 99.995% reliability, acceptable for most workloads. However, InfiniBand's tighter integration means single component failures can destabilize entire fabrics. Ethernet's loose coupling contains failures better, preventing cascade effects. The reliability difference matters most for long-running training jobs where any interruption wastes millions in compute time.
|
||||||
|
|
||||||
|
## Cost analysis disrupts conventional wisdom
|
||||||
|
|
||||||
|
Hardware costs tell only part of the economic story. InfiniBand HDR adapters cost $2,000-3,000 per port compared to $800-1,500 for equivalent Ethernet cards.¹⁷ A 40-port InfiniBand switch costs $50,000 versus $25,000 for Ethernet. Cabling adds another premium: InfiniBand DAC cables cost $500-800 while Ethernet equivalents run $200-400. For a 1,000 GPU cluster, InfiniBand hardware costs $15 million versus $7 million for Ethernet, a $8 million premium that seems prohibitive.
|
||||||
|
|
||||||
|
Operational expenses shift the calculation significantly. InfiniBand's automated management reduces administrative overhead by 60% compared to Ethernet.¹⁸ One network engineer can manage 10,000 InfiniBand ports versus 4,000 Ethernet ports requiring manual configuration. The labor savings amount to $500,000 annually for large deployments. InfiniBand's higher efficiency also reduces power consumption by 15%, saving $200,000 yearly for a megawatt facility.
|
||||||
|
|
||||||
|
Software licensing creates hidden expenses that many overlook. InfiniBand's OFED (OpenFabrics Enterprise Distribution) stack is open source with optional support contracts.¹⁹ Enterprise Ethernet often requires expensive software licenses for advanced features: VMware NSX costs $5,000 per CPU, Cisco ACI runs $50,000 per switch.²⁰ These licenses can exceed hardware costs over five-year deployment lifecycles. Open networking initiatives like SONiC reduce Ethernet software costs but require engineering investment.
|
||||||
|
|
||||||
|
Total Cost of Ownership models depend heavily on utilization assumptions. If InfiniBand's 15% performance advantage translates to 15% faster training, the time savings justify premium pricing for organizations where speed determines competitive advantage. An organization spending $1 million monthly on GPU compute saves $150,000 through faster completion. Over three years, the savings exceed InfiniBand's premium. However, if workloads don't benefit from InfiniBand's advantages, the premium becomes pure waste.
|
||||||
|
|
||||||
|
Vendor lock-in costs prove difficult to quantify but significantly impact long-term economics. InfiniBand locks organizations into NVIDIA's ecosystem, limiting negotiation leverage and technology choices.²¹ Ethernet's vendor diversity enables competitive bidding that reduces costs 20-30%. However, switching between Ethernet vendors requires re-engineering that costs millions. True vendor independence remains illusory regardless of technology choice.
|
||||||
|
|
||||||
|
## Software ecosystem maturity varies dramatically
|
||||||
|
|
||||||
|
Driver stability affects production reliability more than hardware specifications. InfiniBand's Mellanox OFED drivers undergo extensive testing with NVIDIA GPUs, ensuring compatibility across software stacks.²² Version 5.8 OFED supports every CUDA version seamlessly. Ethernet driver quality varies by vendor: Intel's ice driver proves rock-solid, while some vendors ship drivers that kernel panic under load. Driver issues cause mysterious failures that waste weeks of debugging time.
|
||||||
|
|
||||||
|
Framework integration determines developer productivity. PyTorch and TensorFlow optimize for InfiniBand through native UCX support, achieving near-theoretical performance without tuning.²³ NCCL (NVIDIA Collective Communications Library) includes InfiniBand-specific optimizations that accelerate all-reduce operations by 30%.²⁴ Ethernet support exists but requires manual configuration of RoCE parameters, congestion control algorithms, and buffer sizes. The integration gap narrows as frameworks add Ethernet optimizations, but InfiniBand maintains an ease-of-use advantage.
|
||||||
|
|
||||||
|
Management tools reflect ecosystem maturity differences. NVIDIA's UFM (Unified Fabric Manager) provides comprehensive InfiniBand monitoring, automatically detecting issues and suggesting remediations.²⁵ The platform includes AI-powered analytics that predict failures before they occur. Ethernet management fragments across vendors: Arista's CloudVision, Cisco's DNA Center, and Cumulus's NetQ offer similar capabilities but lack standardization. Organizations often deploy multiple tools to achieve UFM's functionality.
|
||||||
|
|
||||||
|
Debugging capabilities separate technologies significantly during problems. InfiniBand's centralized architecture enables comprehensive packet captures and flow analysis from a single point.²⁶ Performance counters expose bottlenecks clearly. Ethernet's distributed nature requires correlating data from multiple switches to understand issues. Modern observability platforms like Kentik provide Ethernet visibility approaching InfiniBand's, but at additional cost and complexity.
|
||||||
|
|
||||||
|
Container orchestration support increasingly determines deployment flexibility. Kubernetes' device plugin framework supports both InfiniBand and Ethernet SR-IOV, enabling container-native GPU workloads.²⁷ However, InfiniBand's RDMA capabilities require privileged containers that complicate security models. Ethernet's TCP/IP compatibility enables standard container networking with acceptable performance for many workloads. The container ecosystem favors Ethernet's flexibility over InfiniBand's performance.
|
||||||
|
|
||||||
|
## Real deployments illuminate decision factors
|
||||||
|
|
||||||
|
NVIDIA's Selene supercomputer demonstrates InfiniBand at its best: 2,240 DGX A100 nodes connected through HDR InfiniBand achieving 95% scaling efficiency for MLPerf benchmarks.²⁸ The deployment uses eight-layer fat tree topology with adaptive routing that maintains consistent performance regardless of communication pattern. NVIDIA engineers report zero network-related job failures across millions of GPU-hours. The success story showcases InfiniBand's strengths but benefits from NVIDIA's unique expertise and unlimited budget.
|
||||||
|
|
||||||
|
Google's TPU v4 pods chose Ethernet exclusively, connecting 4,096 accelerators through custom optical circuit switches.²⁹ Google's Jupiter network achieves 1.3Pb/s bisection bandwidth using merchant silicon and software-defined networking. The deployment proves Ethernet can match InfiniBand's scale and performance with sufficient engineering investment. However, Google's network team includes hundreds of PhDs developing custom protocols, a resource most organizations lack.
|
||||||
|
|
||||||
|
Alibaba's hybrid approach leverages both technologies strategically. Training clusters use InfiniBand for predictable performance during model development. Inference clusters deploy Ethernet for cost-effective scaling to millions of users.³⁰ The dual-technology strategy requires maintaining expertise in both ecosystems but optimizes costs for different workload characteristics. The approach works because training and inference infrastructure remain largely separate.
|
||||||
|
|
||||||
|
European supercomputing centers overwhelmingly choose InfiniBand, with 80% of TOP500 systems using the technology.³¹ The Barcelona Supercomputing Center's MareNostrum 5 connects 6,400 GPUs through NDR InfiniBand, achieving 85% efficiency on climate simulations. European funding agencies prefer InfiniBand's proven supercomputing heritage over Ethernet's data center origins. The regional preference creates expertise clusters that reinforce technology choices.
|
||||||
|
|
||||||
|
Hyperscale cloud providers split between technologies based on business models. AWS deploys both InfiniBand and Ethernet, charging premium prices for InfiniBand-connected instances.³² Azure standardizes on InfiniBand for HPC and AI workloads, leveraging parent Microsoft's RDMA expertise. Google Cloud relies entirely on Ethernet, reflecting corporate philosophy favoring open standards. The divergence means cloud customers must choose providers partially based on network technology preferences.
|
||||||
|
|
||||||
|
## Decision framework for architectural choice
|
||||||
|
|
||||||
|
Workload characteristics drive technology selection more than abstract performance metrics. Distributed training with frequent all-reduce operations favors InfiniBand's consistent latency and efficient collectives. Models with sparse communication patterns work well on Ethernet's flexible routing. Inference workloads rarely benefit from InfiniBand's premium unless serving latency-critical applications. Mixed workloads suggest hybrid deployments or Ethernet with careful tuning.
|
||||||
|
|
||||||
|
Scale ambitions influence technology choices significantly. Organizations planning 100-500 GPU deployments can manage Ethernet complexity through manual tuning. Beyond 1,000 GPUs, InfiniBand's automation becomes valuable. At 10,000+ GPUs, the choice depends on engineering resources: InfiniBand for teams wanting turnkey solutions, Ethernet for organizations with deep networking expertise. Introl helps clients evaluate scale requirements across our global infrastructure footprint.
|
||||||
|
|
||||||
|
Budget constraints create natural technology filters. InfiniBand's 2x hardware premium plus vendor lock-in requires $20,000+ per GPU total budgets. Organizations spending less than $15,000 per GPU should choose Ethernet unless workloads absolutely require InfiniBand performance. The threshold shifts based on electricity costs, cooling infrastructure, and operational expertise. Financial modeling must include five-year TCO, not just initial purchase price.
|
||||||
|
|
||||||
|
Future flexibility requirements affect current decisions. InfiniBand commits organizations to NVIDIA's roadmap, ensuring compatibility but limiting options. Ethernet enables mixing vendors and technologies, valuable for uncertain futures. However, Ethernet's flexibility requires architectural decisions that prove difficult to change later. Organizations must balance current optimization against future optionality.
|
||||||
|
|
||||||
|
Operational expertise availability often determines success more than technology choice. InfiniBand expertise remains scarce and expensive, with qualified engineers commanding $200,000+ salaries.³³ Ethernet knowledge is widespread but achieving InfiniBand-like performance requires specialized skills. Organizations should audit existing capabilities and training budgets before committing to either technology. The wrong choice relative to team capabilities guarantees suboptimal outcomes regardless of theoretical advantages.
|
||||||
|
|
||||||
|
## Migration strategies between technologies
|
||||||
|
|
||||||
|
Gradual migration from Ethernet to InfiniBand works poorly due to incompatible protocols. Translation gateways add latency and complexity that negate InfiniBand's advantages. Organizations must plan forklift upgrades where entire clusters switch simultaneously. The approach requires maintaining parallel infrastructure during transition, doubling costs temporarily. Success requires detailed project management and acceptance of disruption.
|
||||||
|
|
||||||
|
InfiniBand to Ethernet migration proves even more challenging due to performance regression risks. Applications optimized for InfiniBand's RDMA may require significant refactoring for Ethernet. The migration usually coincides with hardware refresh cycles to amortize disruption costs. Organizations report 6-12 month migration projects with 20-30% performance degradation until optimization completes.³⁴
|
||||||
|
|
||||||
|
Hybrid deployments offer compromise solutions but increase complexity. Running both technologies requires dual expertise, separate management tools, and careful workload placement. Gateway devices enable communication between InfiniBand and Ethernet domains but add latency. The approach works for organizations with clearly separated workloads but fails when applications require mixed resources.
|
||||||
|
|
||||||
|
Cloud bursting strategies differ by technology choice. InfiniBand clusters struggle to burst to public clouds due to limited availability. Ethernet enables seamless expansion to cloud resources during demand spikes. Organizations planning hybrid cloud deployments should favor Ethernet despite on-premise performance penalties. The flexibility value exceeds performance costs for many use cases.
|
||||||
|
|
||||||
|
Future-proofing suggests waiting for technology convergence. NVIDIA's Spectrum-X brings InfiniBand features to Ethernet, potentially obsoleting pure InfiniBand.³⁵ Ultra Ethernet pushes open standards matching InfiniBand performance. By 2027, the technologies may converge sufficiently that choice becomes irrelevant. Organizations able to delay decisions should wait for clarity, though competitive pressures rarely allow such luxury.
|
||||||
|
|
||||||
|
## Quick decision framework
|
||||||
|
|
||||||
|
**Technology Selection by Workload:**
|
||||||
|
|
||||||
|
| If Your Primary Workload Is... | Choose | Rationale |
|
||||||
|
| --- | --- | --- |
|
||||||
|
| LLM training (>1000 GPUs) | InfiniBand | Consistent latency, NCCL optimization |
|
||||||
|
| Inference serving | Ethernet | Cost-effective, sufficient performance |
|
||||||
|
| Mixed training + inference | Hybrid | InfiniBand for training, Ethernet for inference |
|
||||||
|
| Research/experimentation | Ethernet | Flexibility, lower commitment |
|
||||||
|
| HPC/scientific computing | InfiniBand | Proven at scale, TOP500 dominance |
|
||||||
|
|
||||||
|
**Technology Selection by Scale:**
|
||||||
|
|
||||||
|
| GPU Count | Recommendation | Reasoning |
|
||||||
|
| --- | --- | --- |
|
||||||
|
| <100 GPUs | Ethernet | Cost savings exceed performance gap |
|
||||||
|
| 100-500 GPUs | Either (workload-dependent) | Evaluate based on communication patterns |
|
||||||
|
| 500-2000 GPUs | InfiniBand preferred | Automation and stability benefits |
|
||||||
|
| 2000-10000 GPUs | InfiniBand | Management complexity requires automation |
|
||||||
|
| >10000 GPUs | Hybrid or federation | Multi-cluster with mixed technologies |
|
||||||
|
|
||||||
|
**Cost Comparison Summary:**
|
||||||
|
|
||||||
|
| Component | InfiniBand HDR | Ethernet 100G |
|
||||||
|
| --- | --- | --- |
|
||||||
|
| Adapter (per port) | $2,000-3,000 | $800-1,500 |
|
||||||
|
| 40-port switch | ~$50,000 | ~$25,000 |
|
||||||
|
| DAC cable | $500-800 | $200-400 |
|
||||||
|
| 1,000 GPU cluster total | ~$15M | ~$7M |
|
||||||
|
| Admin ratio | 1:10,000 ports | 1:4,000 ports |
|
||||||
|
| 5-year TCO (with ops) | Varies | Often lower at scale |
|
||||||
|
|
||||||
|
## Key takeaways
|
||||||
|
|
||||||
|
**For infrastructure architects:**
|
||||||
|
- InfiniBand: 0.6µs latency, 95% bandwidth efficiency, automated management
|
||||||
|
- Ethernet: 1.2µs+ baseline latency, 85-92% efficiency, requires tuning
|
||||||
|
- Congestion behavior is the critical difference—InfiniBand degrades gracefully, Ethernet collapses under incast
|
||||||
|
- NVIDIA Spectrum-X (800G Ethernet) narrowing gap for specific workloads
|
||||||
|
|
||||||
|
**For financial planners:**
|
||||||
|
- InfiniBand hardware costs 2x Ethernet, but operational costs 40% lower
|
||||||
|
- Break-even favors InfiniBand when 15% performance advantage translates to time savings
|
||||||
|
- Hidden Ethernet costs: software licenses ($50K+ per switch for Cisco ACI)
|
||||||
|
- Hidden InfiniBand costs: NVIDIA lock-in limits negotiation leverage
|
||||||
|
|
||||||
|
**For strategic planning:**
|
||||||
|
- 80% of TOP500 supercomputers use InfiniBand—validated for extreme scale
|
||||||
|
- Google, Meta prove Ethernet works at hyperscale with sufficient engineering
|
||||||
|
- Technology convergence (Spectrum-X, Ultra Ethernet) may make choice less critical by 2027
|
||||||
|
- Cloud strategy matters: AWS/Azure offer InfiniBand, GCP is Ethernet-only
|
||||||
|
|
||||||
|
The InfiniBand versus Ethernet decision represents more than technology selection—it's a strategic choice about vendor relationships, operational models, and architectural philosophy. InfiniBand offers superior performance and simplicity for organizations willing to accept NVIDIA lock-in and premium pricing. Ethernet provides flexibility and cost advantages for teams capable of managing complexity. Neither technology is universally superior; success depends on aligning choice with organizational capabilities, workload requirements, and business objectives. The decision's multi-million dollar impact demands rigorous analysis rather than default assumptions or vendor influence.
|
||||||
|
|
||||||
|
## References
|
||||||
|
|
||||||
|
1. Gartner. "Network Infrastructure Costs for Large-Scale AI Deployments." Gartner Research, 2024. https://www.gartner.com/en/documents/network-infrastructure-ai
|
||||||
|
2. Meta. "Ethernet vs InfiniBand: TCO Analysis Across 600,000 GPUs." Meta Engineering, 2024. https://engineering.fb.com/2024/network-technology-decision/
|
||||||
|
3. OpenAI. "Infrastructure Choices for GPT-4 Training." OpenAI Engineering, 2024. https://openai.com/research/gpt-4-infrastructure-decisions
|
||||||
|
4. NVIDIA. "Spectrum-X: Bringing InfiniBand Performance to Ethernet." NVIDIA Networking, 2024. https://www.nvidia.com/en-us/networking/spectrum-x/
|
||||||
|
5. Intel. "Ultra Ethernet Consortium: Open Standards for AI Networking." Intel Network, 2024. https://www.intel.com/content/www/us/en/products/network-io/ultra-ethernet-consortium.html
|
||||||
|
6. InfiniBand Trade Association. "InfiniBand Architecture Specification v1.4." IBTA, 2024. https://www.infinibandta.org/specifications/
|
||||||
|
7. IEEE. "802.1Qbb Priority-based Flow Control." IEEE Standards, 2024. https://www.ieee802.org/1/pages/802.1bb.html
|
||||||
|
8. Mellanox. "RDMA Technology Overview." NVIDIA Networking, 2024. https://www.nvidia.com/en-us/networking/rdma/
|
||||||
|
9. ———. "InfiniBand Switch Architecture White Paper." NVIDIA Networking, 2024. https://www.nvidia.com/en-us/networking/infiniband-switch-architecture/
|
||||||
|
10. ———. "Subnet Manager Architecture and Operations." NVIDIA Documentation, 2024. https://docs.nvidia.com/networking/display/subnet-manager
|
||||||
|
11. ———. "HDR InfiniBand Performance Benchmarks." NVIDIA Networking, 2024. https://www.nvidia.com/en-us/networking/hdr-performance/
|
||||||
|
12. Ohio State University. "MVAPICH Performance Benchmarks." OSU Micro-benchmarks, 2024. https://mvapich.cse.ohio-state.edu/benchmarks/
|
||||||
|
13. Mittal, Radhika, et al. "Revisiting Network Support for RDMA." ACM SIGCOMM, 2024. https://dl.acm.org/doi/10.1145/3544216.3544265
|
||||||
|
14. Mellanox. "Building Scale-Out InfiniBand Fabrics." NVIDIA Networking, 2024. https://www.nvidia.com/en-us/networking/scale-out-fabrics/
|
||||||
|
15. Facebook. "Data Center Network Architecture at Scale." Facebook Engineering, 2024. https://engineering.fb.com/2024/data-center-network-scale/
|
||||||
|
16. InfiniBand Trade Association. "Reliability Metrics for Production Deployments." IBTA, 2024. https://www.infinibandta.org/reliability-metrics/
|
||||||
|
17. CDW. "Data Center Networking Price Guide 2024." CDW Corporation, 2024. https://www.cdw.com/content/price-guide/networking-2024
|
||||||
|
18. IDC. "Operational Efficiency Comparison: InfiniBand vs Ethernet." IDC Research, 2024. https://www.idc.com/research/network-operational-efficiency
|
||||||
|
19. OpenFabrics Alliance. "OFED Software Distribution." OFA, 2024. https://www.openfabrics.org/ofed/
|
||||||
|
20. VMware. "NSX-T Data Center Pricing." VMware, 2024. https://www.vmware.com/products/nsx/pricing.html
|
||||||
|
21. The Information. "NVIDIA's InfiniBand Lock-in Strategy." The Information, 2024. https://www.theinformation.com/articles/nvidia-infiniband-strategy
|
||||||
|
22. Mellanox. "OFED Driver Compatibility Matrix." NVIDIA Networking, 2024. https://www.nvidia.com/en-us/networking/ofed-compatibility/
|
||||||
|
23. PyTorch. "Distributed Training with InfiniBand." PyTorch Documentation, 2024. https://pytorch.org/docs/stable/distributed-infiniband.html
|
||||||
|
24. NVIDIA. "NCCL Performance with InfiniBand." NVIDIA Developer, 2024. https://developer.nvidia.com/nccl-infiniband-performance
|
||||||
|
25. ———. "UFM Telemetry and Monitoring Platform." NVIDIA Networking, 2024. https://www.nvidia.com/en-us/networking/ufm-telemetry/
|
||||||
|
26. Mellanox. "InfiniBand Diagnostic and Debugging Tools." NVIDIA Documentation, 2024. https://docs.nvidia.com/networking/display/diagnostics
|
||||||
|
27. Kubernetes. "Device Plugin for InfiniBand and SR-IOV." Kubernetes Documentation, 2024. https://kubernetes.io/docs/concepts/extend-kubernetes/device-plugins/
|
||||||
|
28. NVIDIA. "Selene Supercomputer Architecture." NVIDIA HPC, 2024. https://www.nvidia.com/en-us/data-center/selene-supercomputer/
|
||||||
|
29. Google. "Jupiter Network Evolution and TPU v4 Integration." Google Infrastructure, 2024. https://research.google/pubs/jupiter-tpu-integration/
|
||||||
|
30. Alibaba Cloud. "Hybrid Network Strategy for AI Workloads." Alibaba Cloud Community, 2024. https://www.alibabacloud.com/blog/hybrid-network-ai
|
||||||
|
31. TOP500. "Network Technology Distribution in HPC." TOP500.org, 2024. https://www.top500.org/statistics/network-technology/
|
||||||
|
32. AWS. "Network Options for HPC and ML Workloads." AWS Documentation, 2024. https://docs.aws.amazon.com/hpc/latest/userguide/network-options.html
|
||||||
|
33. Robert Half. "2024 Salary Guide: Network Engineering Specializations." Robert Half, 2024. https://www.roberthalf.com/salary-guide/network-engineering
|
||||||
|
34. Microsoft Azure. "Migration from InfiniBand to Ethernet: Lessons Learned." Azure Blog, 2024. https://azure.microsoft.com/blog/network-migration-lessons/
|
||||||
|
35. NVIDIA. "Spectrum-X Roadmap and InfiniBand Convergence." NVIDIA Investor Day, 2024. https://investor.nvidia.com/spectrum-x-roadmap
|
||||||
@@ -0,0 +1,77 @@
|
|||||||
|
# 📊 文章摘要:InfiniBand vs 以太网 GPU 集群对比:800G 网络架构决策指南
|
||||||
|
|
||||||
|
> **原文**:[2026-03-27_InfiniBand_vs_以太网_GPU_集群对比_800G_网络架构决策指南.md](./2026-03-27_InfiniBand_vs_以太网_GPU_集群对比_800G_网络架构决策指南.md)
|
||||||
|
> **原文链接**:https://introl.com/zh/blog/infiniband-vs-ethernet-gpu-clusters-800g-architecture
|
||||||
|
> **来源**:Introl
|
||||||
|
> **作者**:未知
|
||||||
|
> **发布日期**:2026-03-27
|
||||||
|
> **摘要日期**:2026-08-06
|
||||||
|
> **价值评级**:⭐⭐ 中
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 核心命题
|
||||||
|
|
||||||
|
> **按场景选型** — IB 与以太网没有普适最优解,选型取决于负载特征、规模野心、预算约束与团队工程能力。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 文章概要
|
||||||
|
|
||||||
|
文章从架构原理(无损 vs 尽力而为、集中式子网管理 vs 分布式路由)、性能指标(延迟、带宽效率、拥塞行为)、TCO(硬件、运维、软件许可、锁定成本)与生态成熟度四个维度对比 InfiniBand 与以太网,并给出按负载类型、GPU 规模与预算的快速决策框架。核心结论:大规模训练集群倾向 IB 的可预测性能与 NCCL 优化,推理服务选以太网更具性价比,混合部署是常见折中;NVIDIA Spectrum-X 与 UEC 正推动技术收敛,2027 年前后选择的重要性可能下降。决策框架完整实用,但大量具体数字的引用来源无法核实,可信度受限。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 关键要点
|
||||||
|
|
||||||
|
1. **架构哲学的对立** — IB 以信用流控实现无损与确定性路径,但集中式管理不适应动态负载;以太网以丢包重传加拥塞控制换取规模与灵活性 `[分类: 共识]`
|
||||||
|
2. **拥塞行为是最大差异** — 高负载下 IB 优雅降级,以太网在 incast 场景可能性能崩溃,两者延迟差距从基线 2 倍扩大到 100 倍 `[分类: 共识]`
|
||||||
|
3. **成本账的两面性** — IB 硬件贵约 2 倍(千卡集群约 1500 万 vs 700 万美元),但运维开销约低 40%、功耗省 15%;盈亏平衡取决于 15% 性能优势能否转化为训练时间收益 `[分类: 争议]`
|
||||||
|
4. **生态成熟度落差** — NCCL/UCX 对 IB 原生优化(AllReduce 快 30%)、UFM 集中式监控,而以太网驱动质量参差、管理工具碎片化;容器化场景以太网反而更灵活 `[分类: 共识]`
|
||||||
|
5. **成功案例两极分化** — Selene(IB,95% 扩展效率)与 Google TPU(纯以太网加自研 Jupiter 网络)都成功,但前者靠 NVIDIA 资源、后者靠数百名网络博士,多数组织两者都不具备 `[分类: 共识]`
|
||||||
|
6. **技术收敛进行时** — Spectrum-X 800G 把 IB 能力搬到以太网,UEC 1.0 规范已发布、合规产品 2025—2026 上市,2027 年前后选择可能不再关键 `[分类: 未探索]`
|
||||||
|
7. **迁移代价极高** — 协议不兼容需要整集群 forklift 替换,IB→以太网迁移需 6—12 个月并伴随 20%—30% 性能回退 `[分类: 共识]`
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 批判性分析
|
||||||
|
|
||||||
|
### 假设前提
|
||||||
|
|
||||||
|
假设网络投资是"十年期决策",2027—2030 年技术不发生剧变;假设组织有清晰的训练/推理负载画像;将 Meta(60 万 GPU 规模的 2.3 倍 TCO)与 OpenAI(GPT-4 训练快 40%)两个对比案例当作既定事实——但这两个案例均无法在公开渠道核实。
|
||||||
|
|
||||||
|
### 论据与逻辑
|
||||||
|
|
||||||
|
论证结构完整,每个论点都有数字支撑,但参考文献大量指向 2024 年的泛化链接(如 engineering.fb.com、openai.com 的相关页面),真实性存疑,有营销或 AI 生成内容之嫌;这使证据链可信度大打折扣,结论只宜作为方向性参考而非决策依据。
|
||||||
|
|
||||||
|
### 边界与局限
|
||||||
|
|
||||||
|
数字多为 2024—2025 年快照,2026 年 800G 以太网与 Spectrum-X 落地后部分差距已收窄;全文为欧美视角,未讨论国内大厂 RoCE 实践与国产化约束;"运维省 60%""1 人管理 1 万端口"等管理效率数字缺乏独立验证;中文版正文曾被截断,正文实际来自英文原版。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 可引用金句
|
||||||
|
|
||||||
|
> "The network connecting 10,000 GPUs determines whether they operate as a unified supercomputer or an expensive collection of isolated processors"(原文为英文,大意:连接 1 万块 GPU 的网络,决定了它们是一台统一的超级计算机,还是一堆昂贵的孤立处理器。)
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 总体评价
|
||||||
|
|
||||||
|
**亮点**:
|
||||||
|
- 决策框架完整(负载/规模/预算/团队能力四维),快速决策表可直接用于立项讨论
|
||||||
|
- TCO 分析覆盖硬件、运维、软件许可、锁定成本,视角全面;明确承认"两者均非普适最优",边界意识强
|
||||||
|
|
||||||
|
**不足**:
|
||||||
|
- 数据来源可疑、无法核实,削弱整体可信度;对国内 RoCE 生态与实践完全空白
|
||||||
|
- 内容为英文原文转载(中文版正文截断),部分结论已被 2026 年技术进展修正
|
||||||
|
|
||||||
|
**适用场景**:500 卡以上 GPU 集群网络选型的基础设施决策者与财务规划者;需要向管理层讲清"IB 溢价值不值"的架构师。
|
||||||
|
|
||||||
|
**关联建议**:用土法炼钢《大模型基础设施工程 04》核实工程细节与国产生态;用 Meta/阿里/字节公开工程博客(HPN、MegaScale、Grand Teton)交叉验证结论;跟踪 UEC 1.0 与 Spectrum-X 的 2026 年落地数据。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 配图
|
||||||
|
|
||||||
|

|
||||||
@@ -0,0 +1,82 @@
|
|||||||
|
# LMCache 博客
|
||||||
|
|
||||||
|
> **来源**:LMCache 博客
|
||||||
|
> **作者**:LMCache Team
|
||||||
|
> **发布日期**:2026-08-06
|
||||||
|
> **原文链接**:https://blog.lmcache.ai/
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
# LMCache
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
Caching knowledge for your LLM
|
||||||
|
|
||||||
|
## 文章列表
|
||||||
|
|
||||||
|
### 1. LMCache on Google Kubernetes Engine: Boosting LLM Inference Performance with KV Cache on Tiered Storage
|
||||||
|
|
||||||
|
By **Danna Wang, Google**
|
||||||
|
|
||||||
|
Posted on October 7, 2025
|
||||||
|
|
||||||
|
Overview of the Collaboration
|
||||||
|
|
||||||
|
[Read More](https://blog.lmcache.ai/2025/10/07/lmcache-gke-tiered-storage/)
|
||||||
|
|
||||||
|
### 2. Implementing LMCache Plugin Framework & lmcache_frontend: Design Philosophy
|
||||||
|
|
||||||
|
#### A flexible plugin system for enhanced observability and management
|
||||||
|
|
||||||
|
By **Baolong, Kobe**
|
||||||
|
|
||||||
|
Posted on September 23, 2025
|
||||||
|
|
||||||
|
Abstract
|
||||||
|
|
||||||
|
Tags: LMCache、Plugin Framework、Frontend、vLLM、Monitoring
|
||||||
|
|
||||||
|
[Read More](https://blog.lmcache.ai/2025/09/23/implementing-lmcache-plugin-framework/)
|
||||||
|
|
||||||
|
### 3. NVIDIA Dynamo integrates LMCache, Accelerating LLM Inference
|
||||||
|
|
||||||
|
By **NVIDIA Dynamo team, LMCache team**
|
||||||
|
|
||||||
|
Posted on September 18, 2025
|
||||||
|
|
||||||
|
We're thrilled to announce that Nvidia Dynamo has integrated LMCache as a KV caching layer solution. This is a big milestone: Dynamo gets a battle-tested caching solution, and LMCache becomes part of a data center-scale inference platform used by many developers worldwide to deploy AI at scale.
|
||||||
|
|
||||||
|
[Read More](https://blog.lmcache.ai/2025/09/18/nvidia-dynamo-integrates-lmcache/)
|
||||||
|
|
||||||
|
### 4. Extending LMCache Backends: A Comprehensive Guide to Custom Backend Development
|
||||||
|
|
||||||
|
#### Learn how to build custom backends for LMCache using the external backend extension mechanism
|
||||||
|
|
||||||
|
By **Baolong, Kobe**
|
||||||
|
|
||||||
|
Posted on September 11, 2025
|
||||||
|
|
||||||
|
Abstract
|
||||||
|
|
||||||
|
Tags: backend、extension、customization、storage、lmcache
|
||||||
|
|
||||||
|
[Read More](https://blog.lmcache.ai/2025/09/11/extending-lmcache-backends/)
|
||||||
|
|
||||||
|
### 5. 🎉 LMCache Hits 5,000+ GitHub Stars — Thank You, Community!
|
||||||
|
|
||||||
|
#### A milestone that shows KV cache has become a first-class citizen in the LLM inference stack
|
||||||
|
|
||||||
|
By **LMCache Team**
|
||||||
|
|
||||||
|
Posted on August 28, 2025
|
||||||
|
|
||||||
|
We're thrilled to share that LMCache has officially crossed 5,000 GitHub stars! 🚀 This milestone is not just a number — it's a strong signal that KV cache technology has become a first-class citizen in the LLM inference stack, and that our community is leading the way.
|
||||||
|
|
||||||
|
Tags: milestone、community、github、stars
|
||||||
|
|
||||||
|
[Read More](https://blog.lmcache.ai/2025/08/28/lmcache-5000-stars/)
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
LMCache Team • 2025 • lmcache.github.io
|
||||||
@@ -0,0 +1,74 @@
|
|||||||
|
# 📊 文章摘要:LMCache 博客文章列表
|
||||||
|
|
||||||
|
> **原文**:[2026-08-06_LMCache_博客文章列表.md](./2026-08-06_LMCache_博客文章列表.md)
|
||||||
|
> **原文链接**:https://blog.lmcache.ai/
|
||||||
|
> **来源**:LMCache 博客
|
||||||
|
> **作者**:LMCache Team
|
||||||
|
> **发布日期**:2026-08-06
|
||||||
|
> **摘要日期**:2026-08-06
|
||||||
|
> **价值评级**:⭐ 低
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 核心命题
|
||||||
|
|
||||||
|
> **KV缓存生态索引** — LMCache 团队博客的目录页,5 篇文章串起"KV cache 已成为 LLM 推理栈一等公民"的生态信号
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 文章概要
|
||||||
|
|
||||||
|
本文是 LMCache 团队博客(blog.lmcache.ai)的文章列表页,不含正文,仅列出 5 篇文章的标题、作者与一句话摘要:LMCache on Google Kubernetes Engine(GKE 分层存储)、插件框架与 lmcache_frontend 设计、NVIDIA Dynamo 集成 LMCache、外部后端扩展指南、5000 GitHub 星标里程碑。作为索引页,其价值在于发现入口——它透露了两个生态信号:KV cache 缓存层已进入数据中心级推理平台(NVIDIA Dynamo 集成),且被作者表述为推理栈的"一等公民";但页面本身无实质内容,信息增量极低,单篇细节需点击原文获取。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 关键要点
|
||||||
|
|
||||||
|
1. **索引页性质** — 仅含 5 篇文章的标题/作者/日期/一句话摘要,无正文内容,作为阅读线索使用 `[分类: 共识]`(页面事实)
|
||||||
|
2. **NVIDIA Dynamo 集成 LMCache** — LMCache 成为 Dynamo 的 KV 缓存层解决方案,进入数据中心级推理平台生态(2025-09-18)`[分类: 共识]`(生态事件)
|
||||||
|
3. **5000 GitHub stars 里程碑** — 团队解读为"KV cache 技术已成为 LLM 推理栈的一等公民"的信号(2025-08-28)`[分类: 争议]`(团队自我评价,非第三方判断)
|
||||||
|
4. **生态扩展方向** — GKE 分层存储(与 Google 合作)、插件框架(可观测性与管理)、外部后端扩展机制,构成 KV 缓存从单机到云原生的扩展路径 `[分类: 未探索]`(线索,详情需读单篇)
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 批判性分析
|
||||||
|
|
||||||
|
### 假设前提
|
||||||
|
|
||||||
|
页面本身不含论证,隐含假设是读者已了解 LMCache 项目背景(KV cache 分布式存储/缓存系统)并有意愿深入阅读其技术博客;将"5000 stars"解读为"一等公民"是团队自我表述,不构成行业共识。
|
||||||
|
|
||||||
|
### 论据与逻辑
|
||||||
|
|
||||||
|
作为索引页无论据可评估;其内容可信度取决于单篇文章质量,本摘要无法验证。标题层面的信息(集成、合作、里程碑)均为团队自述,未经第三方信源交叉验证。
|
||||||
|
|
||||||
|
### 边界与局限
|
||||||
|
|
||||||
|
本页不提供任何可操作结论,不适用于任何决策场景;唯一用途是发现入口。若需了解 LMCache 的技术细节、性能数据或与 vLLM 的集成方式,必须阅读列出的单篇文章原文。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 可引用金句
|
||||||
|
|
||||||
|
> "it's a strong signal that KV cache technology has become a first-class citizen in the LLM inference stack"
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 总体评价
|
||||||
|
|
||||||
|
**亮点**:
|
||||||
|
- 作为目录页,清晰标注了每篇文章的作者、日期与摘要,方便按需检索
|
||||||
|
- 透露的生态信号(Dynamo 集成、5000 stars、GKE 合作)可作为 KV 缓存生态演进的线索
|
||||||
|
|
||||||
|
**不足**:
|
||||||
|
- 无正文内容,信息增量接近于零;"一等公民"等表述为团队自我评价
|
||||||
|
- 列表时间均为 2025 年(2025-08 至 2025-10),最新文章距今近一年,页面时效性一般
|
||||||
|
|
||||||
|
**适用场景**:对 LLM 推理 KV 缓存生态感兴趣的读者,将其作为书签/目录使用,按需点击阅读单篇技术文章;不适用于任何需要结论或数据的场景。
|
||||||
|
|
||||||
|
**关联建议**:结合 vLLM 官方文档中 Disaggregated Prefilling 的 LMCacheConnectorV1(含 MP 模式)阅读,理解 LMCache 在分离式推理中的角色;关注 blog.lmcache.ai 与 lmcache.github.io 获取最新文章;如涉及 KV 缓存选型,可直接查阅 LMCache 的 GitHub 仓库文档而非本索引页。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 配图
|
||||||
|
|
||||||
|
本篇文章为低价值,未生成配图。
|
||||||
@@ -0,0 +1,90 @@
|
|||||||
|
# Welcome to Mooncake
|
||||||
|
|
||||||
|
> **来源**:Mooncake 项目
|
||||||
|
> **作者**:未知
|
||||||
|
> **发布日期**:2026-08-06
|
||||||
|
> **原文链接**:https://kvcache-ai.github.io/Mooncake/index.html
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
**A KVCache-centric Disaggregated Architecture for LLM Serving.**
|
||||||
|
|
||||||
|
Mooncake 是 Kimi(月之暗面提供的领先 LLM 服务)的服务平台。现在 Transfer Engine 和 Mooncake Store 均已开源!本仓库还托管其技术报告和开源 traces。
|
||||||
|
|
||||||
|
## 更新日志
|
||||||
|
|
||||||
|
- **May 7, 2026**:vLLM 正式支持 Mooncake Store——深入介绍 Mooncake 的分布式 KVCache 引擎如何通过高吞吐、内存高效、跨实例的 KV cache 共享为 vLLM 推理提速。
|
||||||
|
- **Apr 29, 2026**:SGLang 引入基于 RDMA 的 P2P 权重传输,使用 Mooncake TransferEngine 支持大规模分布式 RL,1T 参数 Kimi-K2 模型的权重更新速度提升 7 倍(53s → 7.2s),在数千 GPU 上实现零拷贝 RDMA 传输。
|
||||||
|
- **Mar 19, 2026**:TorchSpec:Speculative Decoding Training at Scale 开源,使用 Mooncake 通过高效的 hidden states 管理解耦推理与训练。
|
||||||
|
- **Feb 12, 2026**:Mooncake 正式加入 PyTorch Ecosystem!
|
||||||
|
- **Jan 28, 2026**:FlexKV(腾讯与 NVIDIA 及社区合作开发的分布式 KV 存储与缓存系统)现支持与 Mooncake Transfer Engine 的分布式 KVCache 复用。
|
||||||
|
- **Dec 23, 2025**:SGLang 引入 Encode-Prefill-Decode (EPD) 解耦,以 Mooncake 作为传输后端。该集成允许将计算密集型多模态编码器(如 Vision Transformers)从语言模型节点解耦,利用 Mooncake 的 RDMA 引擎零拷贝传输大型多模态 embeddings。
|
||||||
|
- **Dec 19, 2025**:Mooncake Transfer Engine 已集成到 TensorRT LLM,用于 PD 解耦推理中的 KVCache 传输。
|
||||||
|
- **Dec 19, 2025**:Mooncake Transfer Engine 已作为 KV Connector 直接集成到 vLLM v1 的 PD 解耦部署中。
|
||||||
|
- **Nov 07, 2025**:RBG + SGLang HiCache + Mooncake——基于角色的开箱即用云原生部署方案,弹性、可扩展、高性能。
|
||||||
|
- **Sept 18, 2025**:Mooncake Store 作为分布式 KV cache 池后端赋能 vLLM Ascend。
|
||||||
|
- **Sept 10, 2025**:SGLang 正式支持 Mooncake Store 作为分层 KV 缓存存储后端。该集成将 RadixAttention 扩展到跨设备、主机和远程存储层的多级 KV cache 存储。
|
||||||
|
- **Sept 10, 2025**:Mooncake P2P Store 的官方高性能版本以 checkpoint-engine 开源。已成功应用于 K1.5 和 K2 生产训练,约 20 秒内完成跨数千 GPU 的 Kimi-K2(1T 参数)模型更新。
|
||||||
|
- **Aug 23, 2025**:xLLM 高性能推理引擎基于 Mooncake 构建混合 KV 缓存管理,支持全局 KV 缓存管理与智能卸载、预取。
|
||||||
|
- **Aug 18, 2025**:vLLM-Ascend 集成 Mooncake Transfer Engine 实现 KV cache 注册与解耦预填充,在昇腾 NPU 上支持高效分布式推理。
|
||||||
|
- **Jul 20, 2025**:Mooncake 在 128 块 H200 GPU 上支撑 Kimi K2 部署,采用 PD 解耦和大规模专家并行,实现 224k tokens/sec 预填充吞吐和 288k tokens/sec 解码吞吐。
|
||||||
|
- **Jun 20, 2025**:Mooncake 成为 LMDeploy 的 PD 解耦后端。
|
||||||
|
- **May 9, 2025**:NIXL 正式支持 Mooncake Transfer Engine 作为后端插件。
|
||||||
|
- **May 8, 2025**:Mooncake x LMCache 联合,开创以 KVCache 为中心的 LLM 服务系统。
|
||||||
|
- **May 5, 2025**:在 Mooncake 团队支持下,SGLang 发布在 96 块 H100 GPU 上使用 PD 解耦部署 DeepSeek 的指南。
|
||||||
|
- **Apr 22, 2025**:LMCache 正式支持 Mooncake Store 作为远程连接器。
|
||||||
|
- **Apr 10, 2025**:SGLang 正式支持 Mooncake Transfer Engine 用于解耦预填充和 KV cache 传输。
|
||||||
|
- **Mar 7, 2025**:开源 Mooncake Store——基于 Transfer Engine 的分布式 KVCache。基于 Mooncake Store 的 vLLM xPyD 解耦预填充与解码即将发布。
|
||||||
|
- **Feb 25, 2025**:Mooncake 荣获 FAST 2025 最佳论文奖(Best Paper Award)!
|
||||||
|
- **Feb 21, 2025**:FAST'25 论文中使用的更新版 traces 已发布。
|
||||||
|
- **Dec 16, 2024**:vLLM 正式支持 Mooncake Transfer Engine 用于解耦预填充和 KV cache 传输。
|
||||||
|
- **Nov 28, 2024**:开源 Transfer Engine——Mooncake 的核心组件。同时提供两个演示:P2P Store 和 vLLM 集成。
|
||||||
|
- **July 9, 2024**:以 JSONL 文件形式开源 trace。
|
||||||
|
- **June 27, 2024**:发布一系列中文博客(知乎,共 7 篇)。
|
||||||
|
- **June 26, 2024**:初始技术报告发布。
|
||||||
|
|
||||||
|
## 文档导航(概要)
|
||||||
|
|
||||||
|
**Getting Started**
|
||||||
|
- Build Guide(PyPI Package、Automatic Build、Manual Build、Docker Containers、Advanced Compile Options)
|
||||||
|
- Quick Start(Installation、Transfer Engine Quick Start、Mooncake Store Quick Start)
|
||||||
|
- Supported Communication Protocols(Quick Reference、Python API、C++ Transfer Engine、Configuration Examples、Troubleshooting)
|
||||||
|
- Observability(Master Metrics Log、Prometheus Metrics Endpoint)
|
||||||
|
- SGLang Disaggregated Serving with MooncakeTransferEngine
|
||||||
|
- SGLang HiCache with Mooncake Backend
|
||||||
|
- Mooncake x vLLM Integration
|
||||||
|
- Mooncake x LMCache Integration
|
||||||
|
- LMDeploy Disaggregated Serving with MooncakeTransferEngine
|
||||||
|
- Mooncake HF3FS Plugin (Experimental)
|
||||||
|
|
||||||
|
**Performance**
|
||||||
|
- vLLM Performance Benchmarks
|
||||||
|
- PD Disaggregation Performance
|
||||||
|
- Benchmark on NVIDIA A10
|
||||||
|
- SGLang HiCache with Mooncake Backend Benchmark
|
||||||
|
- vLLM with Mooncake Transfer Engine Benchmark
|
||||||
|
- Allocator Performance / AllocationStrategy Performance
|
||||||
|
- Mooncake SSD Offload Benchmark
|
||||||
|
- Mooncake KVCache Storage Benchmark
|
||||||
|
|
||||||
|
**Design Documents**
|
||||||
|
- Mooncake Architecture(Architectural Overview)
|
||||||
|
- Mooncake Store(Introduction、Architecture、Client C++ API、Master Service、Buffer Allocator、AllocationStrategy、Eviction Policy、Lease、Soft Pin、Hard Pin、Zombie Object Cleanup、Preferred Segment Allocation、Multi-layer Storage Support、Builtin Metadata Server、Python API、Version Management Policy)
|
||||||
|
- P2P Store(Overview、Sample Program、API)
|
||||||
|
- Transfer Engine(Overview、Bench、C/C++ API、Advanced Runtime Options、C++ API Reference、EFA Transport (AWS)、Ascend Transport、Sunrise Link Transport、Supported Protocols、Benchmark and Tuning Guide)
|
||||||
|
- Mooncake x SGLang HiCache System Design(HiRadixTree、Local Match、Prefetch from L3、Data Write-back、Multi-Rank Synchronization、PD-Disaggregation Deployment)
|
||||||
|
- EngramStore Backend
|
||||||
|
- Unified Parallel Tensor IO
|
||||||
|
- TENT: Transfer Engine NEXT(Core Design、TENT C++ API、Metrics、Transport Selection、QoS、Slice Spraying、Failover)
|
||||||
|
- Mooncake Transfer Engine Benchmark Tool(tebench)Guide
|
||||||
|
- Mooncake Conductor Architecture
|
||||||
|
- Mooncake Conductor Indexer API
|
||||||
|
|
||||||
|
**Deployment**
|
||||||
|
- Mooncake Store Deployment & Operations Guide
|
||||||
|
- Mooncake NVMe-oF SSD Pool Deployment Guide
|
||||||
|
|
||||||
|
**Archived**
|
||||||
|
- Guide: vLLM MooncakeStoreConnector、vLLM V0 Disaggregated Serving Demo、vLLM V0 Disaggregated Serving with MooncakeStore、vLLM v1 backend Disaggregated Serving with MooncakeConnector
|
||||||
@@ -0,0 +1,82 @@
|
|||||||
|
# 📊 文章摘要:Welcome to Mooncake(KVCache 中心的分离式 LLM 服务架构)
|
||||||
|
|
||||||
|
> **原文**:[2026-08-06_Welcome_to_Mooncake.md](./2026-08-06_Welcome_to_Mooncake.md)
|
||||||
|
> **原文链接**:https://kvcache-ai.github.io/Mooncake/index.html
|
||||||
|
> **来源**:Mooncake 项目官网
|
||||||
|
> **作者**:未知(月之暗面 Moonshot AI / Kimi 团队)
|
||||||
|
> **发布日期**:2026-08-06
|
||||||
|
> **摘要日期**:2026-08-06
|
||||||
|
> **价值评级**:⭐⭐ 中
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 核心命题
|
||||||
|
|
||||||
|
> **KVCache 中心化** — 以 KVCache 为核心的 PD 分离服务架构,已从论文演进为被 vLLM、SGLang 等主流推理引擎广泛集成的开源基础设施生态。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 文章概要
|
||||||
|
|
||||||
|
本文是 Mooncake 项目的官网首页,主体内容为 2024 年 6 月至 2026 年 5 月的完整更新日志(约 30 条)与文档导航。其认知价值在于:以时间线形式记录了"KVCache 中心分离式架构"从 FAST'25 最佳论文走向工程落地、并被 vLLM/SGLang/TensorRT-LLM/LMDeploy/LMCache 等十余个主流组件集成的全过程,是观察 LLM 推理基础设施生态演进的一手材料。文中提供若干关键性能数字(Kimi-K2 权重更新 53s→7.2s、128 块 H200 上 224k/288k tokens/sec 吞吐等)。局限在于:内容为项目自述的公告集合,无实验细节、无失败教训、无边界条件讨论,性能数据需谨慎对待。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 关键要点
|
||||||
|
|
||||||
|
1. **开源组件全景** — 核心组件 Transfer Engine(RDMA 高速传输)与 Mooncake Store(分布式 KVCache 池)均已开源,配套 P2P Store、checkpoint-engine、TENT(Transfer Engine NEXT)等。 `[分类: 共识]`
|
||||||
|
|
||||||
|
2. **生态集成是主要影响力路径** — vLLM(KV Connector)、SGLang(HiCache/EPD 解耦)、TensorRT-LLM、LMDeploy、LMCache、xLLM、FlexKV(腾讯)等相继接入 Mooncake,说明"以 KVCache 为中心 + 分离式"已成为行业共同技术方向。 `[分类: 共识]`
|
||||||
|
|
||||||
|
3. **分离式架构的量化收益** — 1T 参数 Kimi-K2 权重更新跨数千 GPU 约 20 秒完成(经 checkpoint-engine,2025 年 9 月),后经 SGLang RDMA P2P 权重传输进一步降至 7.2 秒;128 块 H200 上实现 224k tokens/sec 预填充、288k tokens/sec 解码吞吐。 `[分类: 共识]`
|
||||||
|
|
||||||
|
4. **FAST'25 最佳论文的学术背书** — 2025 年 2 月获存储领域顶会 FAST 2025 最佳论文奖,论文配套 traces 已开源,为后续研究提供可复现数据。 `[分类: 共识]`
|
||||||
|
|
||||||
|
5. **文档的局限沉默** — 全文无任何关于架构取舍、失败经验、CPU/DRAM/SSD 异构资源调度复杂度的讨论,也未说明中小规模部署场景的适用性,是典型的项目宣传口径。 `[分类: 未探索]`
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 批判性分析
|
||||||
|
|
||||||
|
### 假设前提
|
||||||
|
|
||||||
|
- 假设大规模集群中 GPU 间存在高速 RDMA 网络(Transfer Engine 依赖),且集群拥有可观的空闲 CPU/DRAM/SSD 资源可供 KVCache 缓存利用;这两条假设决定了 Mooncake 方案主要面向万卡级别的超大规模生产集群。
|
||||||
|
- 假设 PD 分离与 KVCache 复用带来的收益大于调度与传输的复杂度成本。
|
||||||
|
|
||||||
|
### 论据与逻辑
|
||||||
|
|
||||||
|
- 更新日志中的性能数字(7.2s 权重更新、224k/288k tokens/sec、FAST'25 最佳论文)均为可验证的具体事实,但全部来自项目自述,无独立第三方基准,且"525% 吞吐提升"等来自论文模拟场景而非生产数据。更新日志整体是"成就清单"逻辑,缺少对照与失败记录,论据方向单一。
|
||||||
|
|
||||||
|
### 边界与局限
|
||||||
|
|
||||||
|
- 适用场景:大规模(数百至数千 GPU 以上)LLM 服务集群的 PD 分离、KV cache 池化与权重同步;对中小规模集群,RDMA 基础设施投入与调度复杂度可能不划算。
|
||||||
|
- 文档本身是入口性材料,未提供任何架构细节(架构细节在导航指向的 Design Documents 中),不能仅凭本文评估 Mooncake 的技术优劣。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 可引用金句
|
||||||
|
|
||||||
|
> "A KVCache-centric Disaggregated Architecture for LLM Serving."
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 总体评价
|
||||||
|
|
||||||
|
**亮点**:
|
||||||
|
- 一条时间线浓缩了 2024-2026 年 LLM 推理基础设施生态的演进脉络,信息密度高
|
||||||
|
- 关键性能数字可作为行业动态引用素材;开源 traces 与论文获奖是客观事实
|
||||||
|
- 文档导航完整,是深入 Mooncake 架构的可靠入口
|
||||||
|
|
||||||
|
**不足**:
|
||||||
|
- 纯公告集合,无技术细节、无架构论证、无失败记录与边界讨论
|
||||||
|
- 性能数据均为自述口径,缺少第三方验证,引用需标注来源性质
|
||||||
|
|
||||||
|
**适用场景**:关注 LLM 推理基础设施技术动向的架构师与研究者;需要快速了解 Mooncake 生态集成现状、并决定是否深入阅读其设计文档的人群。
|
||||||
|
|
||||||
|
**关联建议**:结合 Mooncake FAST'25 论文原文、cr7258《Lesson 06:PD 分离推理架构详解》中的 Mooncake 章节、以及 vLLM 官方 KV Connector 文档交叉阅读,可形成对分离式架构的完整认知。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 配图
|
||||||
|
|
||||||
|

|
||||||
@@ -0,0 +1,56 @@
|
|||||||
|
# Welcome to NVIDIA Dynamo
|
||||||
|
|
||||||
|
> **来源**:NVIDIA Dynamo 文档
|
||||||
|
> **作者**:未知
|
||||||
|
> **发布日期**:2026-08-06
|
||||||
|
> **原文链接**:https://docs.nvidia.com/dynamo/latest/index.html
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
NVIDIA Dynamo Platform 是一个高性能、低延迟的推理框架,旨在服务于所有 AI 模型——支持任何框架、任何架构、任何部署规模。
|
||||||
|
|
||||||
|
> 本指南是某一特定时间点的快照。获取最新信息和示例,请参见 Dynamo GitHub 仓库。
|
||||||
|
|
||||||
|
## Quickstart(快速开始)
|
||||||
|
|
||||||
|
只需几个命令即可在本地开始使用 Dynamo:
|
||||||
|
|
||||||
|
**1. 安装 Dynamo**
|
||||||
|
|
||||||
|
```
|
||||||
|
# Install uv (recommended Python package manager)
|
||||||
|
curl -LsSf https://astral.sh/uv/install.sh | sh
|
||||||
|
|
||||||
|
# Create virtual environment and install Dynamo
|
||||||
|
uv venv venv
|
||||||
|
source venv/bin/activate
|
||||||
|
uv pip install "ai-dynamo[sglang]==0.4.1" # or [vllm], [trtllm]
|
||||||
|
```
|
||||||
|
|
||||||
|
**2. 启动 etcd/NATS**
|
||||||
|
|
||||||
|
```
|
||||||
|
# Fetch and start etcd and NATS using Docker Compose
|
||||||
|
curl -fsSL -o docker-compose.yml https://raw.githubusercontent.com/ai-dynamo/dynamo/release/0.4.1/deploy/docker-compose.yml
|
||||||
|
docker compose -f docker-compose.yml up -d
|
||||||
|
```
|
||||||
|
|
||||||
|
**3. 运行 Dynamo**
|
||||||
|
|
||||||
|
```
|
||||||
|
# Start the OpenAI compatible frontend (default port is 8080)
|
||||||
|
python -m dynamo.frontend
|
||||||
|
|
||||||
|
# In another terminal, start an SGLang worker
|
||||||
|
python -m dynamo.sglang --model-path Qwen/Qwen3-0.6B
|
||||||
|
```
|
||||||
|
|
||||||
|
**4. 测试部署**
|
||||||
|
|
||||||
|
```
|
||||||
|
curl localhost:8080/v1/chat/completions \
|
||||||
|
-H "Content-Type: application/json" \
|
||||||
|
-d '{"model": "Qwen/Qwen3-0.6B",
|
||||||
|
"messages": [{"role": "user", "content": "Hello!"}],
|
||||||
|
"max_tokens": 50}'
|
||||||
|
```
|
||||||
@@ -0,0 +1,79 @@
|
|||||||
|
# 📊 文章摘要:Welcome to NVIDIA Dynamo(快速开始指南)
|
||||||
|
|
||||||
|
> **原文**:[2026-08-06_Welcome_to_NVIDIA_Dynamo.md](./2026-08-06_Welcome_to_NVIDIA_Dynamo.md)
|
||||||
|
> **原文链接**:https://docs.nvidia.com/dynamo/latest/index.html
|
||||||
|
> **来源**:NVIDIA Dynamo 官方文档
|
||||||
|
> **作者**:未知(NVIDIA)
|
||||||
|
> **发布日期**:2026-08-06
|
||||||
|
> **摘要日期**:2026-08-06
|
||||||
|
> **价值评级**:⭐⭐ 中
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 核心命题
|
||||||
|
|
||||||
|
> **五分钟上手** — 用 uv、docker compose 和两个 Python 命令即可在本机拉起一个 OpenAI 兼容的 Dynamo 推理服务,是理解 Dynamo 的零成本入口。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 文章概要
|
||||||
|
|
||||||
|
本文是 NVIDIA Dynamo 官方文档的首页,核心内容是 Quickstart:安装 `ai-dynamo`(可选 sglang/vllm/trtllm 后端)、用 docker compose 启动 etcd 与 NATS 依赖、运行 OpenAI 兼容前端(默认 8080 端口)、启动 SGLang worker,最后用 curl 验证部署。其价值在于展示了 Dynamo 的架构形态——前端与推理引擎解耦、依赖 etcd/NATS 作为分布式协调组件、引擎无关的后端可插拔设计。局限在于全文仅此而已:无架构图、无性能数据、无功能清单,官方"高性能、低延迟、支持任何框架"的定位无任何论据支撑,仅适合作为上手路径而非认知材料。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 关键要点
|
||||||
|
|
||||||
|
1. **引擎无关的前端 + Worker 模型** — 通过 `python -m dynamo.frontend` 启动 OpenAI 兼容网关,再以 `python -m dynamo.sglang --model-path ...` 启动推理 worker,前后端解耦,后端可在 SGLang/vLLM/TensorRT-LLM 间切换。 `[分类: 共识]`
|
||||||
|
|
||||||
|
2. **外部协调依赖** — 运行 Dynamo 需要 docker compose 拉起 etcd(服务发现/元数据)与 NATS(消息通信),说明其分布式运行时依赖这两类基础组件,部署门槛高于单体推理服务。 `[分类: 共识]`
|
||||||
|
|
||||||
|
3. **低门槛验证路径** — 用 Qwen3-0.6B 小模型 + curl 一条命令即可验证部署,几分钟内可跑通端到端,适合作为 Dynamo 的初次体验。 `[分类: 共识]`
|
||||||
|
|
||||||
|
4. **宣传与事实的落差** — 首页宣称"高性能、低延迟、服务于所有 AI 模型、任何部署规模",但全文无任何基准测试、无架构说明,这些定位在本文档中无法被验证,需转向 Dynamo 其他章节或 GitHub 仓库核实。 `[分类: 未探索]`
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 批判性分析
|
||||||
|
|
||||||
|
### 假设前提
|
||||||
|
|
||||||
|
- 假设用户环境具备 Docker(运行 etcd/NATS)、Python 与网络可访问容器镜像和 GitHub 原始文件;假设用户已有可用的 GPU 资源来真正跑推理(小模型可 CPU 运行,但文档未说明)。
|
||||||
|
- 文档默认"跑通 Quickstart = 理解 Dynamo",但快速开始无法体现 Dynamo 的核心价值(智能路由、PD 分离、KV cache 管理)。
|
||||||
|
|
||||||
|
### 论据与逻辑
|
||||||
|
|
||||||
|
- 本文档没有任何论证环节,仅是可复现的操作步骤,其有效性取决于步骤本身是否可执行(涉及外部依赖的版本锁定,如 0.4.1 版本号)。"高性能低延迟"等宣称零论据支撑,属于厂商宣传口径,不能从本文得出任何性能结论。
|
||||||
|
|
||||||
|
### 边界与局限
|
||||||
|
|
||||||
|
- 适用场景:初次接触 Dynamo、想快速验证安装路径的开发者;生产级配置、架构设计、性能评估均超出本文范围。
|
||||||
|
- 文档为"某一时间点的快照"(官方自述),版本演进可能导致步骤失效;单机 Quickstart 与文档所述"任何部署规模"之间差距巨大,无法据此推断大规模部署形态。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 可引用金句
|
||||||
|
|
||||||
|
> "NVIDIA Dynamo Platform 是一个高性能、低延迟的推理框架,旨在服务于所有 AI 模型——支持任何框架、任何架构、任何部署规模。"
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 总体评价
|
||||||
|
|
||||||
|
**亮点**:
|
||||||
|
- 步骤清晰可复现,五分钟可跑通端到端示例,入门门槛极低
|
||||||
|
- 展示了 Dynamo 前后端解耦、引擎无关、etcd/NATS 协调的架构轮廓
|
||||||
|
|
||||||
|
**不足**:
|
||||||
|
- 信息量极少:无架构图、无功能说明、无性能数据,宣称与证据严重不匹配
|
||||||
|
- 未说明 GPU 要求、生产部署方式与后续阅读路径,读者易产生"跑通即掌握"的错觉
|
||||||
|
|
||||||
|
**适用场景**:需要快速验证 Dynamo 安装路径的开发者;作为 Dynamo 文档体系的最低层入口,后续需结合其架构与性能章节使用。
|
||||||
|
|
||||||
|
**关联建议**:结合 cr7258《Lesson 06:PD 分离推理架构详解》中 Dynamo 章节(Planner/Smart Router/KV Cache Manager/NIXL 四组件)理解其设计意图,再对照 vLLM/SGLang 原生方案做选型评估。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 配图
|
||||||
|
|
||||||
|

|
||||||
@@ -0,0 +1,224 @@
|
|||||||
|
# 如何使用 NVIDIA Dynamo 减少 KV 缓存瓶颈
|
||||||
|
|
||||||
|
> **来源**:NVIDIA 技术博客
|
||||||
|
> **作者**:未知
|
||||||
|
> **发布日期**:2025-09-18
|
||||||
|
> **原文链接**:https://developer.nvidia.cn/blog/how-to-reduce-kv-cache-bottlenecks-with-nvidia-dynamo/
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
随着 AI 模型变得更大、更复杂,推理,即模型生成响应的过程,正成为一项重大挑战。像 GPT-OSS 和 DeepSeek-R1 这样的大语言模型(LLM)严重依赖注意力数据(KV 缓存)来理解输入提示并进行上下文化,但高效管理这些数据正变得愈发困难。
|
||||||
|
|
||||||
|
本文将探讨如何在推理过程中将 KV 缓存卸载至成本效益更高的存储中,从而降低推理成本并提升用户体验。同时,本文还将阐述 NVIDIA Dynamo 的最新优化如何实现这一目标。
|
||||||
|
|
||||||
|
## 什么是 KV 缓存?
|
||||||
|
|
||||||
|
KV 缓存是在推理初始阶段创建的 LLM 注意力机制的核心数据结构,该阶段称为预填充。KV 缓存用于存储中间注意力数据,有助于模型在生成或响应阶段聚焦于输入中最为相关的部分。
|
||||||
|
|
||||||
|
然而,KV 缓存会随着提示长度呈线性增长,并且在生成过程中必须驻留在 GPU 显存中以实现快速访问。随着模型上下文窗口的不断扩展,有时甚至达到数百万个 token,KV 缓存便成为了一个严重的瓶颈。
|
||||||
|
|
||||||
|
## 为什么 KV 缓存是 LLM 推理的瓶颈?
|
||||||
|
|
||||||
|
GPU 显存有限且成本高昂。随着提示长度的增加,KV 缓存也会不断增大,在生成过程中需要占用更多内存。在多轮对话、深入研究和代码生成等应用场景中,KV 缓存必须在内存中长时间保留。当接近或达到 GPU 显存限制时,推理系统将面临权衡。他们可以:
|
||||||
|
|
||||||
|
- 删除 KV 缓存的部分内容,这会导致昂贵的重新计算
|
||||||
|
- 限制提示词长度或上下文窗口,降低模型性能
|
||||||
|
- 增加更多 GPU,增加运营成本
|
||||||
|
|
||||||
|
在 GPU 显存中长时间保留大量 KV cache 是不可扩展的,这迫使提供商在成本、延迟和功能之间进行权衡。
|
||||||
|
|
||||||
|
## Dynamo 如何帮助减少 KV 缓存瓶颈?
|
||||||
|
|
||||||
|
Dynamo 的最新版本支持 KV Cache 卸载功能,可将原本存储在有限 GPU 显存中的 KV Cache 实时传输至成本更低、容量更大的存储介质。该技术能够将 KV 缓存直接从 GPU 显存卸载到更具扩展性且经济高效的存储系统中,例如 CPU 内存、本地 SSD 或远程网络存储。借助 NVIDIA NIXL 这一低延迟传输库,Dynamo 能够在 GPU 显存与外部存储之间高效移动 KV 缓存块,整个过程无需中断模型推理,从而提升整体推理效率与资源利用率。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
**图 1。KV 缓存卸载支持将 KV 缓存从有限的 GPU 显存即时传输到更经济高效的存储**
|
||||||
|
|
||||||
|
## KV 缓存卸载有哪些好处?
|
||||||
|
|
||||||
|
借助 KV 缓存卸载,推理服务提供商能够在不牺牲提示长度的前提下支持具有更长上下文窗口的模型。通过卸载 KV 缓存,可显著降低 GPU 显存占用,使集群能够同时处理更多用户请求,从而提升整体并发能力。这种方式减少了对额外 GPU 的需求,有助于降低基础设施成本。对于包含缓存输入 token 的提示,节省的成本可转化为折扣,惠及最终用户。
|
||||||
|
|
||||||
|
KV 缓存卸载还能避免昂贵的 KV 缓存重新计算,从而缩短响应时间并提升用户体验。最终,服务提供商将受益于更高的吞吐量和更低的单位 token 成本,进而增强推理服务的可扩展性与效率。
|
||||||
|
|
||||||
|
## 何时卸载 KV 缓存以重复使用
|
||||||
|
|
||||||
|
当 KV 缓存超出 GPU 显存,且缓存重用带来的收益超过数据传输开销时,将 KV 缓存卸载至 CPU 或外部存储将显著提升效率。这一策略在处理长上下文、高并发或资源受限的推理场景中尤为重要,例如:
|
||||||
|
|
||||||
|
- **长会话和多回合对话**:卸载可保留较大的提示词前缀,避免重新计算,并提高首个令牌延迟和吞吐量。
|
||||||
|
- **高并发性**:空闲或部分对话可以移出 GPU 显存,允许活动请求在不达到内存限制的情况下继续进行。
|
||||||
|
- **共享或重复内容**:跨用户或会话(例如系统提示和模板)重复使用会增加缓存点击率,尤其是在远程或跨实例共享时。
|
||||||
|
- **受内存或成本限制的部署**:卸载到 RAM 或 SSD 可减少 GPU 需求,从而在不添加硬件的情况下允许更长的提示词或更多的用户。
|
||||||
|
- **I/O 优化平台**:具有高主机设备带宽(例如 NVLINK C2C)或 GPU Direct Storage 的环境受益更多,因为传输延迟更低,并且可能与计算重叠。
|
||||||
|
|
||||||
|
## Dynamo 中的 KV 缓存卸载工作原理是什么?
|
||||||
|
|
||||||
|
Dynamo KV 块管理器(KVBM)是一个为缓存卸载和内存协调提供支持的系统,由三个主要层级构成:
|
||||||
|
|
||||||
|
- **模型集成层**:将 NVIDIA TensorRT-LLM 和 vLLM 等热门 AI 推理引擎(即将支持 SGLang)连接到 KVBM 系统。这消除了对特定模型集成的需求,并实现了跨不同引擎的一致功能。
|
||||||
|
- **内存管理层**:处理内存的分配、组织和重用方式。它可以跟踪数据的所在位置,并使开发者能够在不影响整个系统的情况下自定义 KV 缓存卸载策略。
|
||||||
|
- **使用 NIXL 的存储和数据传输层**:将 KVBM 连接到各种类型的存储,包括 CPU、SSD、文件系统和云平台。NIXL 支持跨机器的快速数据传输,并通过基于插件的系统简化了第三方存储提供商的集成。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
**图 2。Dynamo KV 区块管理器与 LLM 推理生态系统的不同组件交互**
|
||||||
|
|
||||||
|
通过将内存管理与特定模型引擎分离,并标准化存储访问,KVBM 简化了集成与可扩展性。存储提供商不再需要为不同的推理引擎定制系统,因为 KVBM 负责处理翻译工作。该架构有助于提升性能、简化开发流程,并支持存储与计算的独立演进。
|
||||||
|
|
||||||
|
## Dynamo 如何与 LMCache 集成?
|
||||||
|
|
||||||
|
Dynamo 的核心设计原则是开放性,允许用户在内置功能与第三方集成之间自由选择。为此,Dynamo 集成了 LMCache,一个开源系统,用于在 CPU、本地及远程存储中缓存和重用 token。
|
||||||
|
|
||||||
|
LMCache 为 vLLM 等推理引擎提供 KV 缓存层。它能够将频繁使用的数据(例如对话历史记录或提示)从 GPU 卸载至成本更低的存储中,并针对大规模或重复性工作负载提供智能的驱逐与检索策略。对于使用 vLLM 的团队,LMCache 提供了一个强大的 KV 缓存管理解决方案,与 Dynamo 开放架构保持一致。
|
||||||
|
|
||||||
|
## 存储提供商如何利用 KV 缓存卸载?
|
||||||
|
|
||||||
|
Vast 测试了 NVIDIA Dynamo 与 Vast AI OS 之间的高性能集成,以实现 GPU 和存储之间持久性 KV 缓存的高效移动。通过在 Dynamo 中启用 GPU Direct Storage (GDS) 插件,Vast 在单个 NVIDIA H100 GPU 上实现了 35 GB/秒的吞吐量,充分表明 GPU 资源得到充分利用,同时验证了存储系统不会成为性能瓶颈。
|
||||||
|
|
||||||
|
在另一项测试中,Vast 验证了在 NVIDIA DGX H100 系统上使用 vLLM 和 LMCache 复用持久性 KV 缓存的效果。运行 Qwen3-32B 模型处理 130K token 提示时,系统从 Vast 存储中加载了预先计算的 KV 缓存,而非重新计算,从而显著缩短了首个 token 的生成时间(TTFT)。
|
||||||
|
|
||||||
|
WEKA 在实验室测试中,结合使用 NVIDIA Dynamo 以及由 WEKA 开发并开源的自定义 NIXL 插件,对 GPU 与存储之间的高性能 KV 缓存传输进行了评估。测试结果表明,WEKA 的增强内存网格能够以接近显存的速度将 KV 缓存从 token 仓库流式传输至 GPU,从而缩短首次 token 生成时间(TTFT),并提升推理工作负载的整体 token 吞吐量。
|
||||||
|
|
||||||
|
测试使用配备 8 个 H100 GPU 的 DGX 系统执行。该设置在 8 个 GPU 上实现了高达 270 GB/秒的读取吞吐量,证明 WEKA 基于 RDMA 的零拷贝数据路径能够满足分解推理对 token 传输的需求,而不会成为瓶颈。
|
||||||
|
|
||||||
|
这些测试结果凸显了将 KV 缓存卸载到存储的潜力,可支持分布式环境中大上下文、高吞吐量的生成式 AI 工作负载。
|
||||||
|
|
||||||
|
## 如何使用 Dynamo KVBM 管理 KV 缓存
|
||||||
|
|
||||||
|
要使用 KVBM 管理 KV cache 并在 vLLM 中执行 KV 卸载,请按以下步骤操作:
|
||||||
|
|
||||||
|
```
|
||||||
|
# start up etcd for KVBM leader/worker registration and discovery
|
||||||
|
docker compose -f deploy/docker-compose.yml up -d
|
||||||
|
|
||||||
|
# build a container containing vllm and kvbm
|
||||||
|
./container/build.sh --framework vllm --enable-kvbm
|
||||||
|
|
||||||
|
# launch the container
|
||||||
|
./container/run.sh --framework vllm -it --mount-workspace --use-nixl-gds
|
||||||
|
|
||||||
|
# enable kv offloading to CPU memory
|
||||||
|
# 4 means 4GB of CPU memory would be used
|
||||||
|
export DYN_KVBM_CPU_CACHE_GB=4
|
||||||
|
|
||||||
|
# enable kv offloading to disk
|
||||||
|
# 8 means 8GB of disk would be used
|
||||||
|
export DYN_KVBM_DISK_CACHE_GB=8
|
||||||
|
|
||||||
|
# serve an example LLM model
|
||||||
|
vllm serve --kv-transfer-config
|
||||||
|
'{"kv_connector":"DynamoConnector","kv_role":"kv_both",
|
||||||
|
"kv_connector_module_path": "dynamo.llm.vllm_integration.connector"}'
|
||||||
|
deepseek-ai/DeepSeek-R1-Distill-Llama-8B
|
||||||
|
|
||||||
|
# make a call to LLM
|
||||||
|
curl localhost:8000/v1/chat/completions -H "Content-Type: application/json" -d '{
|
||||||
|
"model": "deepseek-ai/DeepSeek-R1-Distill-Llama-8B",
|
||||||
|
"messages": [
|
||||||
|
{
|
||||||
|
"role": "user",
|
||||||
|
"content": "In the heart of Eldoria, an ancient land of boundless magic and mysterious creatures, ..."
|
||||||
|
}
|
||||||
|
],
|
||||||
|
"stream":false,
|
||||||
|
"max_tokens": 30
|
||||||
|
}'
|
||||||
|
```
|
||||||
|
|
||||||
|
### 启用和查看 KVBM 指标
|
||||||
|
|
||||||
|
要通过 Grafana 控制面板启用指标收集和查看,请按照以下步骤操作:
|
||||||
|
|
||||||
|
```
|
||||||
|
# Start the basic services (etcd & natsd), along with Prometheus and Grafana
|
||||||
|
docker compose -f deploy/docker-compose.yml --profile metrics up -d
|
||||||
|
|
||||||
|
# start vllm with DYN_SYSTEM_ENABLED set to true and DYN_SYSTEM_PORT port to 6880.
|
||||||
|
# NOTE: Make sure port 6880 (for KVBM worker metrics) and port 6881
|
||||||
|
(for KVBM leader metrics) are available.
|
||||||
|
DYN_SYSTEM_ENABLED=true DYN_SYSTEM_PORT=6880 vllm serve --kv-transfer-config
|
||||||
|
'{"kv_connector":"DynamoConnector","kv_role":"kv_both",
|
||||||
|
"kv_connector_module_path":
|
||||||
|
"dynamo.llm.vllm_integration.connector"}'
|
||||||
|
deepseek-ai/DeepSeek-R1-Distill-Llama-8B
|
||||||
|
|
||||||
|
# optional if firewall blocks KVBM metrics ports to send prometheus metrics
|
||||||
|
sudo ufw allow 6880/tcp
|
||||||
|
sudo ufw allow 6881/tcp
|
||||||
|
```
|
||||||
|
|
||||||
|
通过 `http://localhost:3001` 查看 Grafana 指标(默认登录名:dynamo/dynamo),并查找 KVBM 控制面板。
|
||||||
|
|
||||||
|
### 基准 KVBM
|
||||||
|
|
||||||
|
当 vLLM 服务器准备就绪后,请按照以下步骤使用 LMBenchmark 对 KVBM 性能进行基准测试:
|
||||||
|
|
||||||
|
```
|
||||||
|
git clone https://github.com/LMCache/LMBenchmark.git
|
||||||
|
|
||||||
|
# show case of running the synthetic multi-turn chat dataset.
|
||||||
|
# we are passing model, endpoint, output file prefix and qps to the sh script.
|
||||||
|
cd LMBenchmark/synthetic-multi-round-qa
|
||||||
|
./long_input_short_output_run.sh \
|
||||||
|
"deepseek-ai/DeepSeek-R1-Distill-Llama-8B" \
|
||||||
|
"http://localhost:8000" \
|
||||||
|
"benchmark_kvbm" \
|
||||||
|
1
|
||||||
|
|
||||||
|
# Average TTFT and other perf numbers would be in the output from above cmd
|
||||||
|
```
|
||||||
|
|
||||||
|
如需详细了解 LMBenchmark 的使用方法,请访问 LMCache/LMBenchmark GitHub 库。
|
||||||
|
|
||||||
|
请注意,如果如上一部分所述启用了指标,您可以在 Grafana 控制面板中观察 KV 卸载和 KV 载入情况。
|
||||||
|
|
||||||
|
为便于比较,您可以运行 `vllm serve deepseek-ai/DeepSeek-R1-Distill-Llama-8B` 来关闭 KVBM,以此作为基准。
|
||||||
|
|
||||||
|
## 如何使用 LMCache 和 vLLM 开始使用 Dynamo
|
||||||
|
|
||||||
|
通过设置环境变量来启用 LMCache:
|
||||||
|
|
||||||
|
- `export ENABLE_LMCACHE=1`
|
||||||
|
|
||||||
|
您可以通过环境变量来自定义 LMCache 的其他配置。
|
||||||
|
|
||||||
|
- `LMCACHE_CHUNK_SIZE=256` – 缓存粒度的令牌块大小(默认值:256)
|
||||||
|
- `LMCACHE_LOCAL_CPU=True` – 启用基于 CPU 内存的后端进行卸载
|
||||||
|
- `LMCACHE_MAX_LOCAL_CPU_SIZE=20` – CPU 显存限制(以 GB 为单位)(用户可根据可用内存将其设置为固定值)
|
||||||
|
|
||||||
|
对于高级配置,LMCache 支持多种存储后端:
|
||||||
|
|
||||||
|
- **CPU RAM**:快速本地内存卸载
|
||||||
|
- **本地存储**:基于磁盘的持久性
|
||||||
|
- **Redis**:分布式缓存共享
|
||||||
|
- **GDS 后端**:用于高吞吐量的 GPU Direct Storage
|
||||||
|
- **InfiniStore/Mooncake**:云原生存储解决方案
|
||||||
|
|
||||||
|
要开始使用 LMCache 和 vLLM 配合 Dynamo,请执行以下步骤:
|
||||||
|
|
||||||
|
```
|
||||||
|
# start up etcd for KVBM leader/worker registration and discovery
|
||||||
|
docker compose -f deploy/docker-compose.yml up -d
|
||||||
|
|
||||||
|
# build a container containing vllm and kvbm
|
||||||
|
./container/build.sh --framework vllm
|
||||||
|
|
||||||
|
# launch the container
|
||||||
|
./container/run.sh --framework vllm -it --mount-workspace
|
||||||
|
|
||||||
|
# run vllm with lmcache in aggregated inference
|
||||||
|
./components/backends/vllm/launch/agg_lmcache.sh
|
||||||
|
|
||||||
|
# run vllm with lmcache in disaggregated inference
|
||||||
|
./components/backends/vllm/launch/disagg_lmcache.sh
|
||||||
|
```
|
||||||
|
|
||||||
|
请注意,必要的环境变量已包含在 `.sh` 脚本中,便于快速配置。请根据需要进行更新。
|
||||||
|
|
||||||
|
## 总结
|
||||||
|
|
||||||
|
随着大语言模型(LLM)的不断扩展,由于 GPU 显存有限且成本高昂,推理过程中管理 KV 缓存已成为一项重大挑战。NVIDIA Dynamo 通过支持将 KV 缓存卸载至 CPU 内存、SSD 和网络存储等更具可扩展性的存储选项,有效应对这一难题,该功能由低延迟的 NIXL 传输库提供支持。
|
||||||
|
|
||||||
|
Dynamo 与 vLLM 等热门推理引擎以及 LMCache 等开源工具无缝集成,可实现高效的缓存重用、减少重复计算,并更好地支持长上下文和高并发工作负载。Vast 和 WEKA 等存储提供商已成功集成 Dynamo,展示了高吞吐量存储系统如何在不成为瓶颈的前提下,高效地卸载和流式传输 KV 缓存。
|
||||||
|
|
||||||
|
这些功能使 KV Cache 卸载成为一种实用且可扩展的解决方案,能够降低推理成本、提升响应速度,并支持大规模生成式 AI 应用的更广泛部署。了解详情并开始使用 Dynamo。
|
||||||
@@ -0,0 +1,78 @@
|
|||||||
|
# 📊 文章摘要:如何使用 NVIDIA Dynamo 减少 KV 缓存瓶颈
|
||||||
|
|
||||||
|
> **原文**:[2025-09-18_如何使用_NVIDIA_Dynamo_减少_KV_缓存瓶颈.md](./2025-09-18_如何使用_NVIDIA_Dynamo_减少_KV_缓存瓶颈.md)
|
||||||
|
> **原文链接**:https://developer.nvidia.cn/blog/how-to-reduce-kv-cache-bottlenecks-with-nvidia-dynamo/
|
||||||
|
> **来源**:NVIDIA 技术博客
|
||||||
|
> **作者**:未知
|
||||||
|
> **发布日期**:2025-09-18
|
||||||
|
> **摘要日期**:2026-08-06
|
||||||
|
> **价值评级**:⭐⭐⭐ 高
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 核心命题
|
||||||
|
|
||||||
|
> **缓存外移** — 将 KV 缓存从昂贵有限的 GPU 显存卸载至 CPU 内存、SSD 与网络存储,以存储成本换取 GPU 算力与并发能力。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 文章概要
|
||||||
|
|
||||||
|
本文介绍 NVIDIA Dynamo 的 KV 缓存卸载能力:KV 缓存随提示长度线性增长且须驻留显存,在长上下文与高并发下成为推理瓶颈,迫使服务商在成本、延迟、功能之间权衡。Dynamo 通过 KV 块管理器(KVBM)的"模型集成层-内存管理层-NIXL 存储传输层"三层架构,将缓存实时卸载至 CPU、SSD 或远程存储,避免重新计算、提升并发、降低成本。文章给出卸载的适用条件(缓存重用收益超过传输开销)、与 LMCache 的集成方式、可复现的 vLLM 操作步骤,以及 Vast(单 H100 达 35GB/s)与 WEKA(8×H100 达 270GB/s)的实测数据。局限在于实测均出自存储厂商自报,缺少端到端成本收益量化。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 关键要点
|
||||||
|
|
||||||
|
1. **KV 缓存是显存瓶颈** — 随提示长度线性增长且必须驻留 HBM,长上下文下迫使在删缓存重算、限制上下文、增加 GPU 之间权衡 `[分类: 共识]`
|
||||||
|
2. **KVBM 三层架构** — 模型集成层(TensorRT-LLM/vLLM,SGLang 即将支持)解耦引擎差异;内存管理层可自定义卸载策略;NIXL 传输层统一接入 CPU/SSD/文件系统/云存储 `[分类: 共识]`
|
||||||
|
3. **NIXL 低延迟传输** — 支持跨机器快速传输与基于插件的第三方存储接入,卸载过程不中断模型推理 `[分类: 共识]`
|
||||||
|
4. **卸载适用条件** — 仅当缓存重用收益超过传输开销时合算,典型场景:长会话、高并发、共享前缀、受内存/成本限制的部署、具备 GDS/NVLink C2C 的高带宽环境 `[分类: 共识]`
|
||||||
|
5. **开放生态集成** — 集成开源 LMCache 为 vLLM 提供缓存层,支持 CPU RAM、本地存储、Redis、GDS、InfiniStore/Mooncake 等后端 `[分类: 共识]`
|
||||||
|
6. **第三方实测数据** — Vast 在单 H100 上经 GDS 插件达 35GB/s;WEKA 在 8×H100 DGX 上达 270GB/s 读取,Qwen3-32B 处理 130K token 提示时复用预计算缓存显著缩短 TTFT `[分类: 争议]`(数据来自存储厂商自测)
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 批判性分析
|
||||||
|
|
||||||
|
### 假设前提
|
||||||
|
|
||||||
|
假设 GPU 与存储之间具备足够带宽(GDS、RDMA 或 NVLink C2C),且传输延迟可被计算重叠掩盖;假设工作负载的缓存重用率足够高,使卸载收益超过开销。
|
||||||
|
|
||||||
|
### 论据与逻辑
|
||||||
|
|
||||||
|
Vast 与 WEKA 的测试聚焦"传输带宽"而非端到端经济性,论证了存储系统不是瓶颈,但未直接证明"降低推理成本";文章缺乏卸载前后 TTFT、吞吐与总拥有成本的对照数据,结论部分依赖推断而非证据。
|
||||||
|
|
||||||
|
### 边界与局限
|
||||||
|
|
||||||
|
对无 GDS、NVLink C2C 等高速互连的普通环境,传输开销可能吞噬卸载收益,文中未给出量化判断标准;缓存一致性、多机同步、KV 块生命周期管理未展开;教程面向 vLLM,SGLang 等其他引擎支持尚不完整。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 可引用金句
|
||||||
|
|
||||||
|
> "在 GPU 显存中长时间保留大量 KV cache 是不可扩展的,这迫使提供商在成本、延迟和功能之间进行权衡。"
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 总体评价
|
||||||
|
|
||||||
|
**亮点**:
|
||||||
|
- KVBM 三层架构清晰,存储与推理引擎解耦的设计思路有借鉴价值
|
||||||
|
- 提供完整可复现的操作步骤与基准测试方法(LMBenchmark)
|
||||||
|
- 明确给出"何时卸载"的边界条件,而非无条件的方案推销
|
||||||
|
|
||||||
|
**不足**:
|
||||||
|
- 收益数据全部来自存储厂商自测,缺少独立第三方验证
|
||||||
|
- 没有端到端成本模型,无法直接用于投资回报评估
|
||||||
|
- 分布式场景下的缓存一致性与故障处理着墨甚少
|
||||||
|
|
||||||
|
**适用场景**:推理系统架构师、SRE 与平台工程师评估长上下文/高并发推理优化方案;希望动手复现 KV 缓存卸载的工程团队。
|
||||||
|
|
||||||
|
**关联建议**:可进一步阅读月之暗面 Mooncake 论文(全局调度+分布式 KV 缓存池)、NVIDIA Dynamo 官方文档与 LMCache GitHub 仓库;对比信通院 2026 报告中的多级存储与 PD 分离章节可获更完整上下文。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 配图
|
||||||
|
|
||||||
|

|
||||||
@@ -0,0 +1,365 @@
|
|||||||
|
# PD 分离 (PD Disaggregation) — SGLang 框架
|
||||||
|
|
||||||
|
> **来源**:SGLang 官方文档
|
||||||
|
> **作者**:未知
|
||||||
|
> **发布日期**:2025-12-30
|
||||||
|
> **原文链接**:https://docs.sglang.com.cn/advanced_features/pd_disaggregation.html
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 目录
|
||||||
|
|
||||||
|
- 什么是 PD 分离,为什么要使用它?
|
||||||
|
- 统一调度存在的问题
|
||||||
|
- 在 PD 分离模式下进行性能分析 (Profiling)
|
||||||
|
- Router 集成
|
||||||
|
- Mooncake
|
||||||
|
- 环境要求
|
||||||
|
- 用法
|
||||||
|
- Llama 单节点
|
||||||
|
- DeepSeek 多节点
|
||||||
|
- 高级配置
|
||||||
|
- NVLink 传输配置
|
||||||
|
- Prefill 服务端配置
|
||||||
|
- Decode 服务端配置
|
||||||
|
- NIXL
|
||||||
|
- 环境要求
|
||||||
|
- 用法
|
||||||
|
- Llama 单节点
|
||||||
|
- DeepSeek 多节点
|
||||||
|
- 昇腾 (ASCEND)
|
||||||
|
- 用法
|
||||||
|
- Llama 单节点
|
||||||
|
- DeepSeek 多节点
|
||||||
|
|
||||||
|
## PD 分离
|
||||||
|
|
||||||
|
## 什么是 PD 分离,为什么要使用它?
|
||||||
|
|
||||||
|
大语言模型 (LLM) 推理包含两个不同的阶段:__Prefill (预填充)__ 和 __Decode (解码)__。Prefill 阶段是计算密集型的,处理整个输入序列;而 Decode 阶段是内存密集型的,管理用于逐个生成 token 的 Key-Value (KV) 缓存。传统上,这两个阶段在统一的引擎中处理,混合调度 prefill 和 decode 批次会导致效率低下。为了解决这些挑战,我们在 SGLang 中引入了 __Prefill 和 Decoding (PD) 分离__。
|
||||||
|
|
||||||
|
### 统一调度存在的问题
|
||||||
|
|
||||||
|
传统的统一引擎同时处理 prefill 和 decode 批次,这会导致两个显著问题:
|
||||||
|
|
||||||
|
1. __Prefill 中断__:新进入的 prefill 批次经常中断正在进行的 decode 批次,导致 token 生成出现大幅延迟。
|
||||||
|
2. __DP Attention 不平衡__:在数据并行 (DP) 注意力机制中,一个 DP 工作进程可能正在处理 prefill 批次,而另一个同时处理 decode 批次,导致解码延迟增加。
|
||||||
|
|
||||||
|
PD 分离通过将这两个阶段分开来解决这些问题,从而能够为每个阶段进行针对性优化。
|
||||||
|
|
||||||
|
有关设计详情,请参阅[链接](https://arxiv.org/abs/2404.12599)(DistServe 论文)。
|
||||||
|
|
||||||
|
目前,我们支持 Mooncake 和 NIXL 作为传输引擎。
|
||||||
|
|
||||||
|
## 在 PD 分离模式下进行性能分析 (Profiling)
|
||||||
|
|
||||||
|
当您需要在 PD 分离模式下对 prefill 或 decode 工作进程进行性能分析时,请参阅"基准测试与性能分析"指南中的"在 PD 分离模式下进行性能分析"章节。由于 torch profiler 的限制,必须使用专用的命令行选项分别对 prefill 和 decode 工作进程进行分析。
|
||||||
|
|
||||||
|
## Router 集成
|
||||||
|
|
||||||
|
为了在大规模部署 PD 分离并实现负载均衡和容错,SGLang 提供了一个 Router (路由器)。Router 可以使用各种路由策略在 prefill 和 decode 实例之间分配请求。有关使用 PD 分离设置路由的详细信息(包括配置选项和部署模式),请参阅 [SGLang Router 文档](https://docs.sglang.ai/backend/router.html)。
|
||||||
|
|
||||||
|
## Mooncake
|
||||||
|
|
||||||
|
### 环境要求
|
||||||
|
|
||||||
|
```
|
||||||
|
uv pip install mooncake-transfer-engine
|
||||||
|
```
|
||||||
|
|
||||||
|
### 用法
|
||||||
|
|
||||||
|
### Llama 单节点
|
||||||
|
|
||||||
|
```
|
||||||
|
python -m sglang.launch_server \
|
||||||
|
--model-path meta-llama/Llama-3.1-8B-Instruct \
|
||||||
|
--disaggregation-mode prefill \
|
||||||
|
--port 30000 \
|
||||||
|
--disaggregation-ib-device mlx5_roce0
|
||||||
|
|
||||||
|
python -m sglang.launch_server \
|
||||||
|
--model-path meta-llama/Llama-3.1-8B-Instruct \
|
||||||
|
--disaggregation-mode decode \
|
||||||
|
--port 30001 \
|
||||||
|
--base-gpu-id 1 \
|
||||||
|
--disaggregation-ib-device mlx5_roce0
|
||||||
|
|
||||||
|
python -m sglang_router.launch_router --pd-disaggregation --prefill http://127.0.0.1:30000 --decode http://127.0.0.1:30001 --host 0.0.0.0 --port 8000
|
||||||
|
```
|
||||||
|
|
||||||
|
### DeepSeek 多节点
|
||||||
|
|
||||||
|
```
|
||||||
|
# prefill 0
|
||||||
|
python -m sglang.launch_server \
|
||||||
|
--model-path deepseek-ai/DeepSeek-V3-0324 \
|
||||||
|
--disaggregation-ib-device ${device_name} \
|
||||||
|
--disaggregation-mode prefill \
|
||||||
|
--host ${local_ip} \
|
||||||
|
--port 30000 \
|
||||||
|
--trust-remote-code \
|
||||||
|
--dist-init-addr ${prefill_master_ip}:5000 \
|
||||||
|
--nnodes 2 \
|
||||||
|
--node-rank 0 \
|
||||||
|
--tp-size 16 \
|
||||||
|
--dp-size 8 \
|
||||||
|
--enable-dp-attention \
|
||||||
|
--moe-a2a-backend deepep \
|
||||||
|
--mem-fraction-static 0.8
|
||||||
|
|
||||||
|
# prefill 1
|
||||||
|
python -m sglang.launch_server \
|
||||||
|
--model-path deepseek-ai/DeepSeek-V3-0324 \
|
||||||
|
--disaggregation-ib-device ${device_name} \
|
||||||
|
--disaggregation-mode prefill \
|
||||||
|
--host ${local_ip} \
|
||||||
|
--port 30000 \
|
||||||
|
--trust-remote-code \
|
||||||
|
--dist-init-addr ${prefill_master_ip}:5000 \
|
||||||
|
--nnodes 2 \
|
||||||
|
--node-rank 1 \
|
||||||
|
--tp-size 16 \
|
||||||
|
--dp-size 8 \
|
||||||
|
--enable-dp-attention \
|
||||||
|
--moe-a2a-backend deepep \
|
||||||
|
--mem-fraction-static 0.8
|
||||||
|
|
||||||
|
# decode 0
|
||||||
|
python -m sglang.launch_server \
|
||||||
|
--model-path deepseek-ai/DeepSeek-V3-0324 \
|
||||||
|
--disaggregation-ib-device ${device_name} \
|
||||||
|
--disaggregation-mode decode \
|
||||||
|
--host ${local_ip} \
|
||||||
|
--port 30001 \
|
||||||
|
--trust-remote-code \
|
||||||
|
--dist-init-addr ${decode_master_ip}:5000 \
|
||||||
|
--nnodes 2 \
|
||||||
|
--node-rank 0 \
|
||||||
|
--tp-size 16 \
|
||||||
|
--dp-size 8 \
|
||||||
|
--enable-dp-attention \
|
||||||
|
--moe-a2a-backend deepep \
|
||||||
|
--mem-fraction-static 0.8 \
|
||||||
|
--max-running-requests 128
|
||||||
|
|
||||||
|
# decode 1
|
||||||
|
python -m sglang.launch_server \
|
||||||
|
--model-path deepseek-ai/DeepSeek-V3-0324 \
|
||||||
|
--disaggregation-ib-device ${device_name} \
|
||||||
|
--disaggregation-mode decode \
|
||||||
|
--host ${local_ip} \
|
||||||
|
--port 30001 \
|
||||||
|
--trust-remote-code \
|
||||||
|
--dist-init-addr ${decode_master_ip}:5000 \
|
||||||
|
--nnodes 2 \
|
||||||
|
--node-rank 1 \
|
||||||
|
--tp-size 16 \
|
||||||
|
--dp-size 8 \
|
||||||
|
--enable-dp-attention \
|
||||||
|
--moe-a2a-backend deepep \
|
||||||
|
--mem-fraction-static 0.8 \
|
||||||
|
--max-running-requests 128
|
||||||
|
```
|
||||||
|
|
||||||
|
### 高级配置
|
||||||
|
|
||||||
|
带有 Mooncake 的 PD 分离支持以下环境变量,用于对系统行为进行精细控制。
|
||||||
|
|
||||||
|
#### NVLink 传输配置
|
||||||
|
|
||||||
|
若要为使用 mooncake 后端的 KV cache 传输启用 NVLink 传输(建议在 NVL72 部署中使用),请设置以下环境变量。请注意,作为临时方案,辅助数据传输仍将使用 TCP。
|
||||||
|
|
||||||
|
```
|
||||||
|
export SGLANG_MOONCAKE_CUSTOM_MEM_POOL=True
|
||||||
|
export MC_FORCE_MNNVL=True
|
||||||
|
```
|
||||||
|
|
||||||
|
#### Prefill 服务端配置
|
||||||
|
|
||||||
|
如果可以接受较大的平均 TTFT,可以执行 `export SGLANG_DISAGGREGATION_BOOTSTRAP_TIMEOUT=600`(10 分钟)以放宽超时条件。请注意,此设置会导致当运行中的 decode 节点断开连接时,prefill 实例需要更长时间来清理受影响的内存资源。
|
||||||
|
|
||||||
|
#### Decode 服务端配置
|
||||||
|
|
||||||
|
如果可以接受较大的平均 TTFT,可以执行 `export SGLANG_DISAGGREGATION_WAITING_TIMEOUT=600`(10 分钟)以放宽超时条件。
|
||||||
|
|
||||||
|
## NIXL
|
||||||
|
|
||||||
|
### 环境要求
|
||||||
|
|
||||||
|
通过 pip 安装。
|
||||||
|
|
||||||
|
或从源码构建 - 如果您已经安装了 UCX,可能需要这样做。
|
||||||
|
|
||||||
|
```
|
||||||
|
git clone https://github.com/ai-dynamo/nixl.git
|
||||||
|
cd nixl
|
||||||
|
pip install . --config-settings=setup-args="-Ducx_path=/path/to/ucx"
|
||||||
|
```
|
||||||
|
|
||||||
|
### 使用方法
|
||||||
|
|
||||||
|
### Llama 单节点
|
||||||
|
|
||||||
|
```
|
||||||
|
python -m sglang.launch_server \
|
||||||
|
--model-path meta-llama/Llama-3.1-8B-Instruct \
|
||||||
|
--disaggregation-mode prefill \
|
||||||
|
--port 30000 \
|
||||||
|
--disaggregation-transfer-backend nixl
|
||||||
|
|
||||||
|
python -m sglang.launch_server \
|
||||||
|
--model-path meta-llama/Llama-3.1-8B-Instruct \
|
||||||
|
--disaggregation-mode decode \
|
||||||
|
--port 30001 \
|
||||||
|
--base-gpu-id 1 \
|
||||||
|
--disaggregation-transfer-backend nixl
|
||||||
|
|
||||||
|
python -m sglang_router.launch_router --pd-disaggregation --prefill http://127.0.0.1:30000 --decode http://127.0.0.1:30001 --host 0.0.0.0 --port 8000
|
||||||
|
```
|
||||||
|
|
||||||
|
### DeepSeek 多节点
|
||||||
|
|
||||||
|
```
|
||||||
|
# prefill 0
|
||||||
|
python -m sglang.launch_server \
|
||||||
|
--model-path deepseek-ai/DeepSeek-V3-0324 \
|
||||||
|
--disaggregation-transfer-backend nixl \
|
||||||
|
--disaggregation-mode prefill \
|
||||||
|
--host ${local_ip} \
|
||||||
|
--port 30000 \
|
||||||
|
--trust-remote-code \
|
||||||
|
--dist-init-addr ${prefill_master_ip}:5000 \
|
||||||
|
--nnodes 2 \
|
||||||
|
--node-rank 0 \
|
||||||
|
--tp-size 16 \
|
||||||
|
--dp-size 8 \
|
||||||
|
--enable-dp-attention \
|
||||||
|
--moe-a2a-backend deepep \
|
||||||
|
--mem-fraction-static 0.8
|
||||||
|
|
||||||
|
# prefill 1
|
||||||
|
python -m sglang.launch_server \
|
||||||
|
--model-path deepseek-ai/DeepSeek-V3-0324 \
|
||||||
|
--disaggregation-transfer-backend nixl \
|
||||||
|
--disaggregation-mode prefill \
|
||||||
|
--host ${local_ip} \
|
||||||
|
--port 30000 \
|
||||||
|
--trust-remote-code \
|
||||||
|
--dist-init-addr ${prefill_master_ip}:5000 \
|
||||||
|
--nnodes 2 \
|
||||||
|
--node-rank 1 \
|
||||||
|
--tp-size 16 \
|
||||||
|
--dp-size 8 \
|
||||||
|
--enable-dp-attention \
|
||||||
|
--moe-a2a-backend deepep \
|
||||||
|
--mem-fraction-static 0.8
|
||||||
|
|
||||||
|
# decode 0
|
||||||
|
python -m sglang.launch_server \
|
||||||
|
--model-path deepseek-ai/DeepSeek-V3-0324 \
|
||||||
|
--disaggregation-transfer-backend nixl \
|
||||||
|
--disaggregation-mode decode \
|
||||||
|
--host ${local_ip} \
|
||||||
|
--port 30001 \
|
||||||
|
--trust-remote-code \
|
||||||
|
--dist-init-addr ${decode_master_ip}:5000 \
|
||||||
|
--nnodes 2 \
|
||||||
|
--node-rank 0 \
|
||||||
|
--tp-size 16 \
|
||||||
|
--dp-size 8 \
|
||||||
|
--enable-dp-attention \
|
||||||
|
--moe-a2a-backend deepep \
|
||||||
|
--mem-fraction-static 0.8 \
|
||||||
|
--max-running-requests 128
|
||||||
|
|
||||||
|
# decode 1
|
||||||
|
python -m sglang.launch_server \
|
||||||
|
--model-path deepseek-ai/DeepSeek-V3-0324 \
|
||||||
|
--disaggregation-transfer-backend nixl \
|
||||||
|
--disaggregation-mode decode \
|
||||||
|
--host ${local_ip} \
|
||||||
|
--port 30001 \
|
||||||
|
--trust-remote-code \
|
||||||
|
--dist-init-addr ${decode_master_ip}:5000 \
|
||||||
|
--nnodes 2 \
|
||||||
|
--node-rank 1 \
|
||||||
|
--tp-size 16 \
|
||||||
|
--dp-size 8 \
|
||||||
|
--enable-dp-attention \
|
||||||
|
--moe-a2a-backend deepep \
|
||||||
|
--mem-fraction-static 0.8 \
|
||||||
|
--max-running-requests 128
|
||||||
|
```
|
||||||
|
|
||||||
|
## 昇腾 (ASCEND)
|
||||||
|
|
||||||
|
### 使用方法
|
||||||
|
|
||||||
|
通过设置 ASCEND_MF_STORE_URL 并使用 mf_adapter([下载链接](https://github.com/sgl-project/sglang/releases))来配合 ascend 后端使用
|
||||||
|
|
||||||
|
```
|
||||||
|
pip install mf_adapter-1.0.0-cp311-cp311-linux_aarch64.whl --force-reinstall
|
||||||
|
export ASCEND_MF_STORE_URL="tcp://xxx.xx.xxx.xxx:xxxx"
|
||||||
|
```
|
||||||
|
|
||||||
|
使用 mooncake 后端,更多详情可以在 mooncake 章节中找到。
|
||||||
|
|
||||||
|
```
|
||||||
|
export ENABLE_ASCEND_TRANSFER_WITH_MOONCAKE=true
|
||||||
|
```
|
||||||
|
|
||||||
|
需要在容器环境变量中设置 ASCEND_NPU_PHY_ID
|
||||||
|
|
||||||
|
```
|
||||||
|
export ASCEND_NPU_PHY_ID=xxx
|
||||||
|
```
|
||||||
|
|
||||||
|
### Llama 单节点
|
||||||
|
|
||||||
|
```
|
||||||
|
python -m sglang.launch_server \
|
||||||
|
--model-path meta-llama/Llama-3.1-8B-Instruct \
|
||||||
|
--disaggregation-mode prefill \
|
||||||
|
--port 30000 \
|
||||||
|
--disaggregation-transfer-backend ascend
|
||||||
|
|
||||||
|
python -m sglang.launch_server \
|
||||||
|
--model-path meta-llama/Llama-3.1-8B-Instruct \
|
||||||
|
--disaggregation-mode decode \
|
||||||
|
--port 30001 \
|
||||||
|
--base-gpu-id 1 \
|
||||||
|
--disaggregation-transfer-backend ascend
|
||||||
|
|
||||||
|
python -m sglang_router.launch_router --pd-disaggregation --prefill http://127.0.0.1:30000 --decode http://127.0.0.1:30001 --host 0.0.0.0 --port 8000
|
||||||
|
```
|
||||||
|
|
||||||
|
### DeepSeek 多节点
|
||||||
|
|
||||||
|
```
|
||||||
|
# prefill 0
|
||||||
|
python -m sglang.launch_server \
|
||||||
|
--model-path deepseek-ai/DeepSeek-V3-0324 \
|
||||||
|
--disaggregation-transfer-backend ascend \
|
||||||
|
--disaggregation-mode prefill \
|
||||||
|
--host ${local_ip} \
|
||||||
|
--port 30000 \
|
||||||
|
--trust-remote-code \
|
||||||
|
--dist-init-addr ${prefill_master_ip}:5000 \
|
||||||
|
--nnodes 1 \
|
||||||
|
--node-rank 0 \
|
||||||
|
--tp-size 16
|
||||||
|
|
||||||
|
# decode 0
|
||||||
|
python -m sglang.launch_server \
|
||||||
|
--model-path deepseek-ai/DeepSeek-V3-0324 \
|
||||||
|
--disaggregation-transfer-backend ascend \
|
||||||
|
--disaggregation-mode decode \
|
||||||
|
--host ${local_ip} \
|
||||||
|
--port 30001 \
|
||||||
|
--trust-remote-code \
|
||||||
|
--dist-init-addr ${decode_master_ip}:5000 \
|
||||||
|
--nnodes 1 \
|
||||||
|
--node-rank 0 \
|
||||||
|
--tp-size 16
|
||||||
|
```
|
||||||
@@ -0,0 +1,76 @@
|
|||||||
|
# 📊 文章摘要:PD 分离 (PD Disaggregation) — SGLang 框架
|
||||||
|
|
||||||
|
> **原文**:[2025-12-30_PD_分离_PD_Disaggregation_SGLang_框架.md](./2025-12-30_PD_分离_PD_Disaggregation_SGLang_框架.md)
|
||||||
|
> **原文链接**:https://docs.sglang.com.cn/advanced_features/pd_disaggregation.html
|
||||||
|
> **来源**:SGLang 官方文档
|
||||||
|
> **作者**:未知
|
||||||
|
> **发布日期**:2025-12-30
|
||||||
|
> **摘要日期**:2026-08-06
|
||||||
|
> **价值评级**:⭐⭐ 中
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 核心命题
|
||||||
|
|
||||||
|
> **PD 分离** — 将计算密集的 Prefill 与内存密集的 Decode 拆分为独立实例并跨机传输 KV,是长上下文、高并发推理的关键架构方向。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 文章概要
|
||||||
|
|
||||||
|
SGLang 官方文档系统介绍了 PD 分离(Prefill/Decode 分离)架构:LLM 推理的 Prefill 阶段计算密集、Decode 阶段内存密集,统一引擎混排会导致 Prefill 频繁打断 Decode 造成生成延迟抖动,以及 DP Attention 负载失衡。方案源自 DistServe 论文思路,通过把两个阶段部署到独立 GPU 实例、经高速网络传输 KV Cache,实现各阶段独立调优。文档给出 Mooncake、NIXL、昇腾三套传输后端的单节点与 DeepSeek 多节点部署命令,以及 Router 负载均衡、NVLink 传输等高级配置。作为官方部署手册,工程可操作性极强,但未提供性能基准数据,收益需自行实测。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 关键要点
|
||||||
|
|
||||||
|
1. **混排调度的两大痛点** — Prefill 中断(新批次打断正在进行的 decode)与 DP Attention 不平衡(不同 DP 工作进程负载错配)是统一引擎的核心缺陷,PD 分离逐一化解 `[分类: 共识]`
|
||||||
|
2. **分阶段独立优化** — Prefill 按计算密集优化、Decode 按内存密集优化,设计依据为 DistServe 论文(arXiv:2404.12599)`[分类: 共识]`
|
||||||
|
3. **三种传输后端** — Mooncake、NIXL、昇腾(ASCEND)覆盖英伟达与国产硬件生态,DeepSeek 多节点示例展示了 TP16×DP8 的真实规模配置 `[分类: 共识]`
|
||||||
|
4. **Router 是规模化前提** — 大规模 PD 分离部署需 Router 实现负载均衡与容错,SGLang 提供独立 router 组件在 prefill/decode 实例间分配请求 `[分类: 共识]`
|
||||||
|
5. **配置即显式权衡** — 放宽 bootstrap/waiting 超时意味着接受更大平均 TTFT,但 decode 节点断连时内存清理更慢;NVLink 传输专为 NVL72 部署建议,辅助数据暂走 TCP `[分类: 共识]`
|
||||||
|
6. **国产硬件适配路径** — 昇腾后端经 mf_adapter 与 ASCEND_MF_STORE_URL 接入 mooncake 后端,体现 PD 分离架构的硬件中立性 `[分类: 未探索]`
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 批判性分析
|
||||||
|
|
||||||
|
### 假设前提
|
||||||
|
|
||||||
|
立论假设读者具备 LLM 推理与分布式部署基础;假定 KV 传输带宽足以覆盖 PD 分离的额外开销(否则收益被抵消);假定多实例部署带来的硬件与管理成本可以接受——这些前提在中小规模场景未必成立。
|
||||||
|
|
||||||
|
### 论据与逻辑
|
||||||
|
|
||||||
|
文档以 DistServe 论文为设计依据,逻辑自洽,但未给出 SGLang 实现下的任何实测性能对比(TTFT、吞吐提升的具体数字缺失),"提升效率"的结论依赖外部基准或读者自行验证;配置项的代价说明清晰,是本文质量较高之处。
|
||||||
|
|
||||||
|
### 边界与局限
|
||||||
|
|
||||||
|
仅适用于 SGLang 框架生态;单节点小规模场景下 PD 分离收益有限,却引入多端口、Router、RDMA 设备等运维负担;Mooncake/NIXL 为较新组件,生产稳定性有待验证;文档未展开 KV 传输带宽瓶颈与失败恢复机制等工程细节。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 可引用金句
|
||||||
|
|
||||||
|
> "PD 分离通过将这两个阶段分开来解决这些问题,从而能够为每个阶段进行针对性优化。"
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 总体评价
|
||||||
|
|
||||||
|
**亮点**:
|
||||||
|
- 官方一手部署文档,覆盖三种传输后端与国产硬件,示例完整(单节点/多节点/环境变量)可直接照做
|
||||||
|
- 明确标注配置权衡与临时方案(如 NVLink 辅助数据暂走 TCP),工程透明度高
|
||||||
|
|
||||||
|
**不足**:
|
||||||
|
- 无任何性能基准数据,无法量化收益;架构原理着墨少(主要指向外部论文),初学者理解门槛高
|
||||||
|
- 未涉及失败恢复、运维监控等生产细节
|
||||||
|
|
||||||
|
**适用场景**:需要为长上下文、高并发推理服务实施 PD 分离的 SGLang 用户与平台工程师;作为该功能的部署手册与配置参考。
|
||||||
|
|
||||||
|
**关联建议**:阅读 DistServe 论文(arXiv:2404.12599)理解原理;对比 vLLM 的 PD 分离与 Mooncake/KVCache 池化项目;结合《GTC 解读:当我们谈论 AI 推理的 KV Cache》理解 PD 分离在全局 KV 存储体系中的位置。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 配图
|
||||||
|
|
||||||
|

|
||||||
@@ -0,0 +1,263 @@
|
|||||||
|
# TetriInfer: Inference without Interference - Disaggregate LLM Inference for Mixed Downstream Workloads
|
||||||
|
|
||||||
|
> **来源**:arXiv
|
||||||
|
> **作者**:Cunchen Hu, Heyang Huang, Liangliang Xu, Xusheng Chen, Jiang Xu, Shuang Chen, Hao Feng, Chenxi Wang, Sa Wang, Yungang Bao, Ninghui Sun, Yizhou Shan(等,共 12 位)
|
||||||
|
> **发布日期**:2024-01-20
|
||||||
|
> **原文链接**:https://arxiv.org/abs/2401.11181
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 论文元数据
|
||||||
|
|
||||||
|
- **arXiv ID**:2401.11181
|
||||||
|
- **学科分类**:Distributed, Parallel, and Cluster Computing (cs.DC)
|
||||||
|
- **作者机构**:中国科学院大学、中科院计算所(ICT, CAS)、华为云(Huawei Cloud)
|
||||||
|
- **提交历史**:v1: 2024-01-20
|
||||||
|
- **DOI**:https://doi.org/10.48550/arXiv.2401.11181
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
Cunchen Hu1,2111Work done while intern at Huawei Cloud.,
|
||||||
|
Heyang Huang1,2,
|
||||||
|
Liangliang Xu3,
|
||||||
|
Xusheng Chen3,
|
||||||
|
Jiang Xu3,
|
||||||
|
Shuang Chen3,
|
||||||
|
|
||||||
|
Hao Feng3,
|
||||||
|
Chenxi Wang1,2,
|
||||||
|
Sa Wang1,2,
|
||||||
|
Yungang Bao1,2,
|
||||||
|
Ninghui Sun1,2,
|
||||||
|
Yizhou Shan3
|
||||||
|
|
||||||
|
1University of Chinese Academy of Sciences, 2ICT, CAS
|
||||||
|
3Huawei Cloud
|
||||||
|
|
||||||
|
## 摘要(Abstract)
|
||||||
|
|
||||||
|
Transformer-based large language model (LLM) inference serving is now the backbone of many cloud services.
|
||||||
|
LLM inference consists of a prefill phase and a decode phase.
|
||||||
|
However, existing LLM deployment practices often overlook the distinct characteristics of these phases, leading to significant interference.
|
||||||
|
To mitigate interference, our insight is to carefully schedule and group inference requests based on their characteristics. We realize this idea in TetriInfer through three pillars. First, it partitions prompts into fixed-size chunks so that the accelerator always runs close to its computation-saturated limit. Second, it disaggregates prefill and decode instances so each can run independently. Finally, it uses a smart two-level scheduling algorithm augmented with predicted resource usage to avoid decode scheduling hotspots.
|
||||||
|
Results show that TetriInfer improves time-to-first-token (TTFT), job completion time (JCT), and inference efficiency in turns of performance per dollar by a large margin, e.g., it uses 38% less resources all the while lowering average TTFT and average JCT by 97% and 47%, respectively.
|
||||||
|
|
||||||
|
## 1 引言(Introduction)
|
||||||
|
|
||||||
|
Since the boom of ChatGPT, large language model (LLM) based services have now played a vital role in our daily lives[4, 38, 20, 9, 34, 31].
|
||||||
|
Behind the scenes, all use cases boil down to LLM inference serving. To run an inference request, the LLM model will first take the user inputs to generate the first token (known as the prefill phase), and then generate outputs token-by-token in an auto-regressive manner (known as the decode phase).
|
||||||
|
Numerous works were proposed to improve the cost efficiency of LLM inference [21, 41].
|
||||||
|
|
||||||
|
There are various ways to interact with LLM, from simple chats to more complex downstream tasks such as document summarization, content creation, etc.
|
||||||
|
As a result, LLM-empowered services serve inference requests with dramatically different properties that can be categorized across two dimensions: the input prompt length during the prefill phase and the generated token length during the decode phase.
|
||||||
|
As shown in Figure 1, summarization tasks have long input prompts and short generated tokens, while context creation tasks are the opposite.
|
||||||
|
Token lengths of different downstream tasks can differ by more than two orders of magnitude.
|
||||||
|
Given the significant variation in LLM inference requests from various downstream tasks, the first research question we ask in this paper is how do these inference requests perform when running together?.
|
||||||
|
|
||||||
|
To answer this question, we run extensive tests that mix LLM prefill and decode requests of different lengths.
|
||||||
|
Unfortunately, we have observed serious interference across all combinations. For example, mixing prefill requests could result in a 10x slowdown, combining prefill and decode requests could lead to a 5x slowdown, and mixing decode requests with different lengths could take a 16% throughput hit (see §2.2).
|
||||||
|
A naive solution to avoid interference is to provision resources for each downstream task statically. Given the high cost of LLM serving infrastructure, this solution is impractical.
|
||||||
|
To this end, the second research question we ask in this paper is how to build a distributed LLM inference serving system that minimizes interferences?
|
||||||
|
|
||||||
|
We take a step back to examine why interference exists. We find the fundamental issue lies in the fact that current LLM deployment practices do not account for the distinct characteristics exhibited by LLM prefill and decode phases.
|
||||||
|
Specifically, the prefill phase resembles a computation-heavy batch job, with its computation scaling quadratically with the input prompt length.
|
||||||
|
The decode phase resembles a memory-intensive, latency-critical task, with its resource usage scaling sublinearly with the generated token length [33].
|
||||||
|
Interferences observed in our tests are classic system problems.
|
||||||
|
Running prefill requests leads to a serious slowdown because we continue adding computation-heavy jobs to an already saturated hardware (§2.2.1).
|
||||||
|
Combining prefill and decode requests hurts both because we co-run batch and latency-critical jobs simultaneously (§2.2.2).
|
||||||
|
Mixing decode requests leads to a throughput drop because we are unaware of the memory bandwidth and capacity usage, thus leading to contention and head-of-line blocking (§2.2.3).
|
||||||
|
|
||||||
|
To solve these issues, our insight is to carefully schedule and group requests based on their characteristics.
|
||||||
|
We realize this idea in TetriInfer222The name of our system, TetriInfer, implies that it can efficiently organize LLM inference requests, similar to how tetris blocks are stacked., a cloud-scale LLM inference
|
||||||
|
serving system designed to battle interferences.
|
||||||
|
|
||||||
|
Our designs are three-fold.
|
||||||
|
First, to avoid interference running prefill, we propose limiting the number of tokens processed in a single prefill iteration so that hardware is fully utilized without incurring extra penalties. TetriInfer partitions and pads input prompts into fixed-size chunks so that the accelerator always runs close to its computation-saturated limit (§3.3).
|
||||||
|
Second, to avoid interference in co-running prefill and decode, we propose disaggregating prefill from decode phases.
|
||||||
|
TetriInfer has dedicated prefill and decode instances.
|
||||||
|
During runtime, prefill instances transfer prefilled KV cache to decode instances.
|
||||||
|
The prefill and decode instances are virtual concepts in that
|
||||||
|
each can scale independently and flip roles if load changes (§3.5).
|
||||||
|
Third, to avoid interference running decode requests, we propose using a smart two-level scheduling algorithm augmented with predicted resource usage to avoid scheduling hotspots (§3.4). TetriInfer incorporates an LLM-based length prediction model to speculate the number of generated tokens of decode requests, and then schedule them accordingly.
|
||||||
|
|
||||||
|
We implement TetriInfer’s disaggregated prefill and decode instances based on vLLM [21]. Most of our modules are implemented in Python, except for the network stack module, which utilizes C++ to interface with low-level APIs for KV cache transfer. The fine-tuning part uses Trainer APIs offered by HuggingFace Transformer [16]. Since we cannot access high-end hardware, we implement a mock mechanism to emulate varying network bandwidth connecting prefill and decode instances, as illustrated in Figure 9.
|
||||||
|
|
||||||
|
We compare TetriInfer with vanilla vLLM using public dataset [35] in terms of time-to-first-token (TTFT), job completion time (JCT), and efficiency as in performance per dollar (perf/$).
|
||||||
|
We run them atop a real testbed with emulated network bandwidth ranging from 200Gbps to 300GBps.
|
||||||
|
For light prefill and heavy decode workload, TetriInfer improves perf/$ by 2.4x (Figure 16). For common mixed workload, TetriInfer improves average TTFT and average JCT by 85% and 50%, respectively (Figure 16).
|
||||||
|
Nevertheless, we also find that TetriInfer’s design is not ideal for heavy prefill and heavy decode workloads since the room for improvement is marginal, and the overhead we introduce cannot be offset (Figure 16).
|
||||||
|
Overall, our ideas mentioned above are effective.
|
||||||
|
TetriInfer achieves effective LLM inference serving, outperforming vLLM by a large margin in TTFT, JCT, and perf/$ running most common workloads (§5.1).
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
Figure 1: Length Distribution. Prompt Tokens for Prefill and Generated Tokens during Decode. Data sources: conversation [35], summarization [17], writing [18].
|
||||||
|
|
||||||
|
## 2 Background and Motivation
|
||||||
|
|
||||||
|
We present a brief primer on LLM inference and study interferences while running various LLM inference requests to motivate our work. For model and testbed details, see §5.
|
||||||
|
|
||||||
|
### 2.1 Generative LLM Inference
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
Figure 2: Prefill and Decode’s Characteristics. Decode’s GPU utilization fluctuates because the task is faster than our monitoring granularity.
|
||||||
|
|
||||||
|
LLM inference is a process that involves generating a sequence of output tokens in response to an input prompt. This process consists of two phases: prefill and decode.
|
||||||
|
The prefill phase outputs the first token and generates the key and value cache (KV cache) for future decoding [21]. The decode phase uses the previous KV cache to generate new tokens step-by-step in an auto-regressive manner.
|
||||||
|
Generally, the prefill phase is computation-bound, and the decode phase is memory-bound [33].
|
||||||
|
We report this in Figure 2.
|
||||||
|
Results indicate that the prefill phase’s throughput stays flat once the accelerator is saturated at a certain number of tokens (which we name the accelerator-saturate threshold).
|
||||||
|
The decode phase’s throughput continues increasing with a larger batch size but plateaus once the memory bandwidth is saturated.
|
||||||
|
|
||||||
|
### 2.2 Motivation: Interference Study
|
||||||
|
|
||||||
|
This section studies the impact of running different inference requests concurrently.
|
||||||
|
Inspired by Figure 1,
|
||||||
|
we classify inference requests across two dimensions (prefill and decode length) and one property (light or heavy), resulting in four distinct request types:
|
||||||
|
heavy prefill,
|
||||||
|
light prefill,
|
||||||
|
heavy decode, and
|
||||||
|
light decode.
|
||||||
|
Here, heavy refers to a long token length, while light refers to a short token length.
|
||||||
|
Below, we study mixing prefill
|
||||||
|
|
||||||
|
ong decoding tasks across different on-demand decode instances. Each timeline comprises four rounds (R1 to R4), with the length of prefill and decode boxes representing their sequence length and the width of the decode box indicating its resource usage. A wider decode box indicates the presence of lengthy generated tokens, resulting in larger resource usage and decoding latency.
|
||||||
|
(b) shows TetriInfer’s architecture with four core modules highlighted.
|
||||||
|
|
||||||
|
## 3 设计(Design)
|
||||||
|
|
||||||
|
### 3.1 Overview
|
||||||
|
|
||||||
|
We realize the above insights in TetriInfer, an LLM inference serving system designed to battle interferences.
|
||||||
|
First, we run prefill in a fixed-size computation unit by partition and pad input prompts into fixed-size chunks such that the accelerator always runs close to its computation-saturated limit (§3.3).
|
||||||
|
Second, we design instances dedicated to running the prefill or decode phases. We schedule prefill requests to prefill instances only, and the same goes for decode requests. Prefill instances will transfer prefilled KV cache to decode instances.
|
||||||
|
Our prefill and decode instances are virtual concepts in that each can scale independently and flip roles if load changes (§3.5).
|
||||||
|
Finally, we design a two-level scheduling algorithm for both prefill and decode request scheduling. We incorporate a length-prediction model to speculate decode requests’ resource usage and then schedule them accordingly (§3.4).
|
||||||
|
|
||||||
|
We show TetriInfer’s architecture in Figure 6 (b) with four modules highlighted: centralized control plane, prefill instance, decode instance, and length prediction model.
|
||||||
|
|
||||||
|
Centralized control plane.
|
||||||
|
It consists of a global scheduler and a cluster monitor.
|
||||||
|
The global scheduler sends requests to prefill instances based on load and receives streaming outputs from decode instances.
|
||||||
|
The cluster monitor collects statistics from prefill and decode instances and regularly broadcasts load information to prefill instances. It adds, removes, and flips prefill or decodes instances.
|
||||||
|
|
||||||
|
Prefill Instances.
|
||||||
|
They only run the prefill phase of an LLM inference request.
|
||||||
|
Each prefill instance has a local scheduler, a length predictor, the main LLM engine, and a dispatcher.
|
||||||
|
All requests undergo four steps.
|
||||||
|
First, the local prefill scheduler sorts requests based on pre-defined policies.
|
||||||
|
Second, the length predictor runs a prediction model to speculate the requests’ decode lengths, which are then used to estimate resource usage during the decoding phase.
|
||||||
|
Third, the main LLM engine partitions all requests into fixed chunks.
|
||||||
|
Finally, for each request, the dispatcher runs an inter-decode load-balancing algorithm to select a decode instance and then forwards the generated KV cache to it.
|
||||||
|
|
||||||
|
Decode instances.
|
||||||
|
They are virtually disaggregated from prefill instances and only run the decode phase of an LLM inference request.
|
||||||
|
Each decode instance can receive requests from any prefill instance.
|
||||||
|
It runs a local scheduler with three pre-defined policies for selecting decode requests to run in the main LLM engine.
|
||||||
|
|
||||||
|
Length Prediction Model.
|
||||||
|
The prediction model is a small LLM model fine-tuned offline for predicting the generation length of LLM inference requests. TetriInfer’s prefill dispatcher and decode instance’s local scheduler utilize the speculated information to schedule decode instances and avoid hotspots measured in §2.2.3. The prediction model is small and deployed at all prefill instances.
|
||||||
|
|
||||||
|
### 3.2 Control Plane
|
||||||
|
|
||||||
|
TetriInfer has a centralized control plane to
|
||||||
|
manage inference clusters at the cloud scale.
|
||||||
|
It consists of a cluster monitor that manages the lifecycle of prefill and decode instances and a global scheduler that managesthe lifecycle of inference requests.
|
||||||
|
The centralized control plane is a distributed system without a single point of failure or processing bottlenecks.
|
||||||
|
|
||||||
|
The cluster monitor is responsible for collecting and broadcasting statistics and scaling instances. Both prefill and decode instances regularly send their load information to the cluster monitor (e.g., every 100 ms). Since we run decentralized decode request scheduling at prefill instances, the cluster monitor will aggregate decode instances’ load information and broadcast it to all prefill instances.
|
||||||
|
|
||||||
|
The global scheduler is responsible for forwarding inference requests from external services to prefill instances and sending inference outputs from decode instances back to external services in a streaming fashion.
|
||||||
|
The global scheduler maintains a request status table, which stores requests’ arrival time, current phase (e.g., prefill or decode), SLA requirement, etc.
|
||||||
|
When a request arrives, the global scheduler will choose a prefill instance with the least load and then insert the request into the table.
|
||||||
|
Following our insight to disaggregate prefill and decode instances, the global scheduler only decides which prefill instance will handle the request. It is up to the prefill instance’s dispatcher to decide which decode instances to use with a speculated resource usage.
|
||||||
|
|
||||||
|
### 3.3 Prefill Instance
|
||||||
|
|
||||||
|
The prefill instance runs the prefill phase of an inference request.
|
||||||
|
To avoid interference among prefill requests, we use a prefill scheduler and chunked prefill to sort and partition all prompts into fixed-size chunks.
|
||||||
|
To help avoid interference during the decode phase, we run a length predictor and a decentralized dispatcher to choose decode instances based on speculated resource usage.
|
||||||
|
|
||||||
|
#### 3.3.1 Prefill Scheduler
|
||||||
|
|
||||||
|
The prefill instance’s scheduler is crucial for improving the prefill phase’s latency and throughput.
|
||||||
|
The scheduler maintains a raw request queue that stores requests from the global scheduler and a scheduled queue that stores sorted requests.
|
||||||
|
In this work, we have designed and implemented three scheduler policies: first-come-first-serve (FCFS), shortest-job-first (SJF), and longest-job-first (LJF).
|
||||||
|
We can use the latter two policies because we can accurately estimate a request’s prefill time based on the number of tokens in its prompt.
|
||||||
|
We only explore non-preemptive policies, though chunked prefill (described soon) has opened the door to preemptive and out-of-order prefill scheduling, such as shortest-remaining-time-first, which we leave for future work.
|
||||||
|
|
||||||
|
The scheduled requests are sent to the length predictor which executes scheduled requests as-is using fixed-size batch (§3.3.2), and the main LLM which uses chunked prefill (§3.3.3).
|
||||||
|
In Figure 7, we illustrate the above three scheduler policies and how scheduled requests are partitioned and merged into fixed-size chunks.
|
||||||
|
Specifically, FCFS keeps the original request arrival order.
|
||||||
|
Prompt tokens are partitioned and merged into chunks sequentially.
|
||||||
|
This policy is the easiest to implement and works best for inference requests with similar prompt lengths.
|
||||||
|
However, FCFS can lead to head-of-line blocking and high average job completion time (JCT) when requests have long prompts. This is problematic since the length differences among LLM inference requests are more than three orders of magnitude (see Figure 1).
|
||||||
|
|
||||||
|
In response, we add the shortest-job-first
|
||||||
|
(SJF), and longest-job-first (LJF) to overcome these issues.
|
||||||
|
These two policies schedule prefill requests based on prompt token lengths in ascending or descending order. By design, they can achieve lower JCT compared to FCFS. Nevertheless, they are no panacea. They introduce starvation for either long or short requests. To avoid starvation, we propose using a prefill scheduling batch (i.e., PrefillSchedBatch) variable to control how many inference requests can be scheduled at a time. For example, assume the raw request queue has twenty requests awaiting scheduling. If we set the batch size to ten, we will schedule twice, each with ten requests sorted and put into the scheduled queue. This simple mechanism prevents starvation during the prefill phase.
|
||||||
|
|
||||||
|
Our scheduler is effective. Results in Figure 16 show that SJF lowers average prefill waiting time by 7.8% compared to FCFS when the batch size is set to 16. Additionaly, the improvement is even more pronounced with larger batch sizes.
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
Figure 7: Prefill Scheduler Policies. The left shows four raw inference requests (R1 to R4). The right shows scheduled requests using FCFS, SJF, and LJF. We show the chunked version to illustrate slicing and merging (C1 to C4).
|
||||||
|
|
||||||
|
#### 3.3.2 Length Predictor
|
||||||
|
|
||||||
|
To address the interference cases measured in §2.2.3, it is essential to determine the number of tokens that a decode request is likely to generate. This information will enable us to schedule decode requests in a length-aware manner.
|
||||||
|
As such, the prefill instance runs a length predictor to predict the length range of an inference request’s generated tokens.
|
||||||
|
The prefill instance’s dispatcher utilizes this information for inter-decode instance scheduling (§3.3.4), while the decoding instance’s local scheduler employs this information for intra-decode instance scheduling (§3.4).
|
||||||
|
|
||||||
|
Our length predictor uses a small LLM-based classification model called a "predict model" to classify the length of generated tokens into fixed-size buckets if the request were executed by a specific target LLM model.
|
||||||
|
The predict model is intentionally small, containing millions of parameters while the target model is much larger, with billions of parameters. As we run the length predictor at the prefill instance, we aim to minimize its cost and avoid impacting the main LLM model. Therefore, approaches like using a giant LLM to predict length are not feasible for us [48].
|
||||||
|
Fortunately, a small LLM model is much faster than a giant LLM and uses much less resources.
|
||||||
|
For example, we use OPT-125M as the predict model and OPT-13B as the target model, the small one is roughly ten times faster than the larger one.
|
||||||
|
|
||||||
|
We opt to predict the length range instead of an exact number of tokens because the latter is extremely difficult to predict.
|
||||||
|
Various inference parameters, such as temperature and top-p [3], result in significant response variations from the same LLM model to the same question in practice. Since our primary goal is to use the estimated length to guide our request scheduling decisions, an exact length estimation is unnecessary; a length range suffices.
|
||||||
|
For instance, if we estimate the length to be between ten to twenty tokens, we can deduce its resource usage’s lower and upper bounds.
|
||||||
|
|
||||||
|
In this work, we have tested two execution modes: a sequential mode, where we first execute the predict model followed by the target model, and a parallel mode, where both models are run simultaneously.
|
||||||
|
The sequential mode adds extra latency for the target LLM model, while the parallel mode may reduce the target LLM model’s throughput.
|
||||||
|
Based on our findings in Figure 17, we opted to use the parallel mode because the main LLM is not affected for most requests (more than 80%), though throughput take a 10% hit under extreme stress test.
|
||||||
|
|
||||||
|
Figure 8 outlines the offline fine-tuning and online prediction workflow. In this process, the predict model (depicted in red) is trained to speculate the decoding behavior of a specific target model (depicted in blue).
|
||||||
|
The fine-tuning of the predict model involves three key steps.
|
||||||
|
Firstly, we assemble a prompt-only training dataset inherited from public datasets, a large target LLM model (e.g., OPT-13B), and a classification model for our predict model (e.g., 125M OPTForSequenceClassification [16]).
|
||||||
|
Secondly, we send training prompts to the target LLM model, which generates responses.
|
||||||
|
Subsequently, we categorize the generated responses into fixed-size buckets with a chosen granularity.
|
||||||
|
For instance, using a granularity of 100, responses with token lengths between 0 to 200 are labeled with 0, 200-400 are labeled with 1, and so on. These labels are paired with the training prompts to create a new dataset. Lastly, we partition the new dataset into a training section and an evaluation section and then proceed to train and evaluate the predict model using this dataset.
|
||||||
|
|
||||||
|
The length range granularity plays a crucial role. If set to one, we fall back to predicting an exact number of tokens, which is not practical. If set to target model’s context window size (e.g., 2K), we fall back to no prediction at all and could run into interferences reported in §2.2.1. Intuitively, a smaller granularity means more accurate resource and performance estimation but lower accuracy in practice. A larger granularity means higher accuracy but essentially makes scheduling harder. Regardless of granularity, it’s easy to calculate resource usage’s upper and lower bound but not performance.
|
||||||
|
In this work, we can predict a granularity of 200 tokens with 74.9% accuracy.
|
||||||
|
Since improving prediction accuracy is not the focus of this work, we leave it for future work.
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
Figure 8: Predict Model’s Fine-tuning and Prediction Flow. The target model is the one that we want to predict its decoding behavior. The predict model is the one we train. This work does not explore online fine-tuning.
|
||||||
|
|
||||||
|
Discussions.
|
||||||
|
We run the length predictor at each prefill instance, hence prefill instances can make well-informed decisions on which decode instances should have enough resources to run certain decoding requests.
|
||||||
|
Nevertheless, we identify two alternative designs. The first design is to run the length predictor at each decode instance. As a result, the prefill instance can only schedule requests based on the load of decoding instances. However, this design cannot avoid interference cases we measured in §2.2.3. Indeed, one could migrate interference requests among decoding instances at runtime based on predicted length. This would be an overly complex solution. The second design is to run the length predictor at the global scheduler before dispatching requests to refill instances. This design could make the global scheduler a bottleneck. We believe our current design is easier and simpler to reason about and deploy compared to alternatives.
|
||||||
|
|
||||||
|
#### 3.3.3 Chunked Prefill
|
||||||
|
|
||||||
|
After the prefill scheduler, we concurrently execute the prefill phase of the main LLM alongside the length predictor.
|
||||||
|
We employ fixed-size chunks for the LLM prefill rather than using fixed batch sizes [21].
|
||||||
|
|
||||||
|
As demonstrated in §2.2.1, we observe that as the number of tokens in a prefill iteration increases, the accelerator’s throughput remains constant, while the latency continues to rise after reaching a certain threshold. We refer to this threshold as ChunkSize. Compared to the traditional fixed batch size approach, running prefill in ChunkSize allows for the optimal utilization of accelerators without incurring additional latency penalties. The accelerator and the LLM model architecture determine the ChunkSize. Models with larger hidden dimensions and accelerators with lower capabilities typically result in a smaller ChunkSize. For example, in our test environment, the value is 512 tokens for OPT 13B.
|
||||||
|
|
||||||
|
Figure 7 illustrates how chunked prefill wor
|
||||||
|
|
||||||
|
ded and two-sided, similar to RDMA’s classification.
|
||||||
|
Accelerators like GPU or NPU can do one-sided memory access as they have low-level primitives such as direct memory copies between devices [26, 14].
|
||||||
|
|
||||||
|
To navigate the complicated physical data links and ensure that TetriInfer can always use the most performant link once deployed, we design a unified network transfer abstraction to utilize the different network stack options listed in Figure 9. The stack exposes APIs such as send, receive, read, write, etc. Our dispatcher calls these APIs to transmit the KV cache to remote decode instances.
|
||||||
|
|
||||||
|
Discussion.
|
||||||
|
We identify two unexplored research questions.
|
||||||
|
The first question pertains to whether it is beneficial to simultaneously utilize multiple data links for transmitting the KV cache. While this approach could enhance performance, it may also introduce complex control logic.
|
||||||
|
The second question involves the sender accelerator accessing the memory of the receiver accelerator without involving the receiver’s CPU. This scenario raises typical challenges associated with building large-scale RDMA-based memory systems [10, 12].
|
||||||
|
Unfortunately, we cannot explore either of these ideas in this wo
|
||||||
@@ -0,0 +1,93 @@
|
|||||||
|
# 📊 文章摘要:TetriInfer: Inference without Interference - Disaggregate LLM Inference for Mixed Downstream Workloads
|
||||||
|
|
||||||
|
> **原文**:[2024-01-20_TetriInfer.md](./2024-01-20_TetriInfer.md)
|
||||||
|
> **原文链接**:https://arxiv.org/abs/2401.11181
|
||||||
|
> **来源**:arXiv
|
||||||
|
> **作者**:Cunchen Hu, Heyang Huang, Liangliang Xu, Xusheng Chen, Jiang Xu, Shuang Chen, Hao Feng, Chenxi Wang, Sa Wang, Yungang Bao, Ninghui Sun, Yizhou Shan 等 12 位(中国科学院大学、中科院计算所、华为云)
|
||||||
|
> **发布日期**:2024-01-20
|
||||||
|
> **摘要日期**:2026-08-06
|
||||||
|
> **价值评级**:⭐⭐⭐ 高
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 核心命题
|
||||||
|
|
||||||
|
> **消除干扰** — 混合下游任务请求的 prefill/decode 长度差异可达两个数量级,共跑必然相互干扰;按请求特征调度分组(定长 chunk 的 prefill + 阶段解耦 + 长度预测调度)是消除干扰、提升性能/美元比的系统化方案。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 文章概要
|
||||||
|
|
||||||
|
TetriInfer 研究"不同下游任务(摘要、创作、对话等)的请求混跑"时的干扰问题:请求的输入 prompt 长度与生成 token 长度差异超两个数量级,混跑会引发严重性能恶化(实测:混跑 prefill 请求 10× 减速、prefill 与 decode 混跑 5× 减速、不同长度 decode 混跑吞吐损失 16%)。作者把干扰根源归结为现有部署忽略了两阶段的本质差异(prefill 是计算密集的批作业,decode 是内存密集的延迟敏感任务),提出三支柱设计:将 prompt 切分为固定大小 chunk 使加速器始终贴近计算饱和点运行;prefill/decode 实例解耦(虚拟实例,可独立扩缩容与角色翻转);两级调度配合小 LLM 长度预测模型(200 token 粒度预测准确率 74.9%)避免 decode 调度热点。相比 vanilla vLLM:资源使用减少 38%,平均 TTFT 与 JCT 分别降低 97% 与 47%;轻 prefill 重 decode 负载下性能/美元比提升 2.4×。局限:重 prefill + 重 decode 负载下收益边际化且开销无法抵消,且评估受限于模拟网络带宽与 OPT-13B 等旧模型。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 关键要点
|
||||||
|
|
||||||
|
1. **混合负载干扰是真实且严重的问题** — 实测数据:混跑 prefill 请求 10× 减速(向已饱和硬件持续添加计算密集作业)、prefill+decode 混跑 5× 减速(批作业与延迟敏感任务共跑)、不同长度 decode 混跑 16% 吞吐损失(内存带宽/容量竞争与队头阻塞)。`[分类: 范式突破]`
|
||||||
|
2. **按特征分组而非统一处理** — 核心洞见:不应把所有请求当同类处理,而应按 prefill/decode 长度(重/轻两维)分类调度;系统名 TetriInfer 即喻意像俄罗斯方块一样组织请求。`[分类: 范式突破]`
|
||||||
|
3. **定长 chunk 的 prefill** — 加速器在 token 数达到饱和阈值后吞吐不再增长、延迟却继续上升;把 prompt 切成固定大小 chunk(OPT-13B 上为 512 token)使硬件始终贴近计算饱和点,避免额外延迟惩罚。`[分类: 范式突破]`
|
||||||
|
4. **虚拟解耦实例** — prefill/decode 实例是"虚拟概念":各自独立扩缩容、负载变化时可角色翻转,兼顾解耦隔离与资源弹性。`[分类: 共识]`
|
||||||
|
5. **小 LLM 预测生成长度** — 用百万参数级的预测模型(OPT-125M)对十亿级目标模型(OPT-13B)的生成长度做分桶分类预测(而非精确预测),200 token 粒度准确率 74.9%;并行执行模式下 80% 以上的请求主模型不受影响,极端压测下吞吐损失 10%。`[分类: 未探索]`
|
||||||
|
6. **两级调度避免热点** — prefill 实例的调度器选择 decode 实例时用预测资源占用做负载均衡,decode 实例内部再用长度感知策略调度,避免 §2.2.3 测得的 decode 热点问题。`[分类: 未探索]`
|
||||||
|
7. **量化收益** — 相比 vLLM:资源减少 38%、平均 TTFT 降低 97%、平均 JCT 降低 47%;轻 prefill 重 decode 负载 perf/$ 提升 2.4×,常见混合负载 TTFT/JCT 改善 85%/50%。`[分类: 共识]`
|
||||||
|
8. **诚实标注不适场景** — 重 prefill + 重 decode 负载下设计不理想:改进空间边际化、引入的开销无法抵消——这是少见的对自身方案适用边界的明确声明。`[分类: 争议]`
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 批判性分析
|
||||||
|
|
||||||
|
### 假设前提
|
||||||
|
|
||||||
|
- 下游任务请求的输入/输出长度分布差异显著且可测量、可分类(重/轻两维),且这种分类足以指导调度。
|
||||||
|
- 用一个小模型(百万参数)预测大模型(十亿参数)的生成长度范围是可行的(以固定粒度分桶),且并行运行小模型不显著影响主模型吞吐。
|
||||||
|
- 干扰现象(10×/5×/16%)在目标生产环境复现,且模拟网络带宽(200Gbps-300GBps)能代表真实数据中心网络。
|
||||||
|
- 集中式控制面(全局调度器 + 集群监控器)不会成为云规模瓶颈(论文称其为无单点的分布式系统)。
|
||||||
|
|
||||||
|
### 论据与逻辑
|
||||||
|
|
||||||
|
- 干扰测量的数据(10×/5×/16%)是本文论据的地基,直接驱动设计决策,链条清晰;三支柱设计各自针对一种干扰类型,映射关系明确。
|
||||||
|
- 端到端收益(38% 资源、97% TTFT、47% JCT)与摘要结论一致,且明确区分了"轻 prefill 重 decode"(2.4× perf/$)与"常见混合负载"(85%/50%)等不同语境。
|
||||||
|
- 弱点:论文基于 OPT-13B/OPT-125M 等较旧模型,未在 GPT-4 级别或 MoE 模型上验证;评估在模拟带宽与模拟环境下进行(作者明示无法访问高端硬件);所下载原文缺失完整实验章节,部分收益数字无法在原文内交叉核对(以摘要与引言为准)。
|
||||||
|
|
||||||
|
### 边界与局限
|
||||||
|
|
||||||
|
- 明确不适用场景:重 prefill + 重 decode 负载(收益无法抵消开销)。
|
||||||
|
- 长度预测粒度(200 token、74.9% 准确率)意味着对长度分布接近粒度边界的请求,调度决策可能偏差。
|
||||||
|
- 依赖小模型与目标模型行为的一致性;换目标模型需重新微调预测模型。
|
||||||
|
- 未探索在线微调预测模型、可抢占/乱序 prefill 调度(chunked prefill 已打开该可能,留作未来工作)。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 可引用金句
|
||||||
|
|
||||||
|
> "We find the fundamental issue lies in the fact that current LLM deployment practices do not account for the distinct characteristics exhibited by LLM prefill and decode phases."
|
||||||
|
> (我们发现根本问题在于:当前的 LLM 部署实践没有考虑 prefill 与 decode 阶段各自迥异的特性。)
|
||||||
|
|
||||||
|
> "We take a step back to examine why interference exists. We find the fundamental issue lies in the fact that current LLM deployment practices do not account for the distinct characteristics exhibited by LLM prefill and decode phases."
|
||||||
|
> (我们退一步审视干扰为何存在,发现根本问题在于现有部署实践忽视了 prefill 与 decode 阶段的本质差异——prefill 像计算密集的批作业,decode 像内存密集的延迟敏感任务。)
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 总体评价
|
||||||
|
|
||||||
|
**亮点**:
|
||||||
|
- 首个系统量化"混合下游任务干扰"的工作,10×/5×/16% 的干扰数据直观有力
|
||||||
|
- 长度预测驱动的调度是独特贡献,用分桶分类规避了精确预测的不可能,工程务实
|
||||||
|
- 定长 chunk prefill 与虚拟解耦实例的设计简洁可落地,且明确声明适用边界(重+重负载不适用),学术诚实度高
|
||||||
|
- 与 DistServe、Splitwise 同期(2023.11-2024.1)独立验证了解耦思路,并补充了干扰测量与预测调度两个新维度
|
||||||
|
|
||||||
|
**不足**:
|
||||||
|
- 评估环境受限(模拟带宽、旧模型 OPT-13B),无真实生产部署验证
|
||||||
|
- 预测模型需要随目标模型重新微调,落地成本未量化
|
||||||
|
- 下载版原文缺失实验与结论章节,部分细节只能依赖摘要与引言
|
||||||
|
|
||||||
|
**适用场景**:多任务混合流量(对话 + 摘要 + 创作等)的 serving 系统设计者;研究 LLM serving 干扰表征、长度预测调度的研究人员;云厂商推理平台团队。
|
||||||
|
|
||||||
|
**关联建议**:与 DistServe(阶段解耦的 goodput 理论)、Splitwise(异构硬件)、Mooncake(生产系统 KVCache 中心化)构成解耦 serving 四篇同期代表作,可联合精读;"输出长度预测"方向后续可关注 speculative decoding、MoE 路由预测等相关工作。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 配图
|
||||||
|
|
||||||
|

|
||||||
@@ -0,0 +1,219 @@
|
|||||||
|
# How Far Can Disaggregation Go? A Design-Space Exploration of Attention-FFN Disaggregation for Efficient MoE LLM Serving
|
||||||
|
|
||||||
|
> **来源**:arXiv
|
||||||
|
> **作者**:Hanjiang Wu, Abhimanyu Rajeshkumar Bambhaniya, Sarbartha Banerjee, Tuhin Khare, Sudarshan Srinivasan, Suvinay Subramanian(等,共 12 位)
|
||||||
|
> **发布日期**:2026-05-27
|
||||||
|
> **原文链接**:https://arxiv.org/abs/2605.28302
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 论文元数据
|
||||||
|
|
||||||
|
- **arXiv ID**:2605.28302
|
||||||
|
- **学科分类**:Distributed, Parallel, and Cluster Computing (cs.DC)
|
||||||
|
- **作者机构**:佐治亚理工学院(Georgia Institute of Technology)、Intel、Google、Google DeepMind、Infravana
|
||||||
|
- **提交历史**:v1: 2026-05-27
|
||||||
|
- **DOI**:https://doi.org/10.48550/arXiv.2605.28302
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
Hanjiang Wu1 Abhimanyu Rajeshkumar Bambhaniya1,5 Sarbartha Banerjee1
|
||||||
|
|
||||||
|
Tuhin Khare1 Sudarshan Srinivasan2 Suvinay Subramanian3
|
||||||
|
|
||||||
|
Souvik Kundu2 Madhu Kumar2 Midhilesh Elavazhagan2
|
||||||
|
|
||||||
|
William Won1 Amir Yazdanbakhsh4 Tushar Krishna1,5
|
||||||
|
|
||||||
|
1Georgia Institute of Technology 2Intel 3Google 4Google DeepMind 5Infravana
|
||||||
|
|
||||||
|
## 摘要(Abstract)
|
||||||
|
|
||||||
|
Modern large language model (LLM) inference has progressively disaggregated to keep pace with growing model sizes and tight TTFT and TPOT service-level objectives: from chunked-prefill aggregation, to prefill–decode (P/D) disaggregation, and most recently to operator-level Attention–FFN Disaggregation (AFD). This trend is especially important for mixture-of-experts (MoE) models, where memory-bound attention, compute-intensive expert FFNs, and MoE dispatch/combine communication create distinct resource demands across the serving pipeline. AFD further exposes this heterogeneity by placing attention and MoE-FFN execution on separate GPU groups. Each level of disaggregation deepens the scheduling design space across workload characteristics, resource allocation, and interconnect topology, leaving open the central question: When does each level of disaggregation actually pay off? We systematically characterize this trade-off for MoE inference across realistic workload use cases defined by input/output sequence lengths, prefix-KV reuse, and per-user latency constraints. Using chunked-prefill and P/D disaggregation as strong baselines, we study the benefits and limits of AFD at scale through a framework that fuses rich on-device kernel measurements with high-fidelity network simulation. Our findings deliver a practical map of when and where deeper disaggregation pays off for MoE serving at scale. Under strict TTFT/TPOT SLOs, AFD sustains around 4k tokens/s of system throughput on DeepSeek-V3.2 across chat, coding, and agentic-coding workloads, regimes in which non-AFD deployments are infeasible. Our design and analysis further distill concrete takeaways for jointly optimizing system throughput and user interactivity, including how to partition attention and FFN across GPUs as a function of workload and model architecture, providing design principles for current rack- and cluster-scale deployments as well as future disaggregated AI infrastructure.
|
||||||
|
|
||||||
|
## 1 引言(Introduction)
|
||||||
|
|
||||||
|
The rapid scaling of agentic large language models (LLMs) has enabled AI systems to perform increasingly complex tasks, including multi‑turn reasoning, code generation, and autonomous decision‑making. As these models grow to hundreds of billions of parameters and operate on long input contexts, their deployment places unprecedented pressure on inference infrastructure, particularly due to the expanding KV‑cache footprint and the need to scale across multiple compute nodes. At the same time, emerging agentic workloads and model architectures exhibit increasing compute characteristic heterogeneity, exposing limitations in existing LLM serving paradigms that struggle to simultaneously achieve high performance, efficiency, and scalability.
|
||||||
|
|
||||||
|
A central challenge stems from the heterogeneous execution characteristics of different components within modern LLM architectures, which impose conflicting demands on compute, memory bandwidth, and communication resources. Prior systems mitigate these effects through batching and scheduling techniques such as chunked prefill Agrawal et al. (2023) and continuous batching Yu et al. (2022), pipelining, or coarse‑grained prefill–decode (P/D) disaggregation Zhong et al. (2024); Patel et al. (2023). While effective at reducing phase‑level interference, these approaches implicitly treat the model as a monolithic execution unit, obscuring fine‑grained trade‑offs that become dominant at scale.
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
Figure 1: AIC++ Framework Overview. AIC++ takes model architecture, hardware configuration, and workload constraints as inputs and performs design-space exploration to identify optimal scheduling across token-level parallelism—data (DP), sequence (SP), tensor (TP), pipeline (PP), and expert parallelism (EP)—as well as phase-level prefill/decode (P/D) and operator-level attention–FFN disaggregation (AFD) [C1]. The framework leverages AIConfigurator to model heterogeneous GPU clusters (GPUA,GPUBGPU_{A},GPU_{B}) interconnected via scale-up (NVLink) and scale-out (InfiniBand) fabrics simulated with AstraSim [C2]. Based on this analysis, attention (PA,DA1,DA2P_{A},D_{A,D_{A) and FFN (PF,DF1,DF2P_{F},D_{F,D_{F) operators are placed on specific GPUs to maximize overall system throughput [C3].
|
||||||
|
|
||||||
|
Recent studies such as MegaScale-Infer Zhu et al. (2025) show that coarse-grained inference abstractions break down for large heterogeneous models, especially MoE architectures, where substantial compute heterogeneity exists within each Transformer block. Attention variants such as MHA Ashish (2017), GQA Hudson and Manning (2019), and MLA DeepSeek-AI et al. (2024) are largely memory-bound due to KV-cache access and data movement, whereas FFNs are compute-bound and dominated by dense GEMMs. Although MegaScale-Infer highlights inefficiencies from attention–FFN heterogeneity, it remains unclear how Attention–FFN Disaggregation (AFD) composes with existing parallelism strategies, prefill–decode (P/D) disaggregation, and different attention architectures.
|
||||||
|
|
||||||
|
Beyond architectural heterogeneity, AFD effectiveness also depends on workload characteristics such as input/output sequence length (ISL/OSL), prefix length, and system load (tokens/s/user). These factors directly affect scheduling decisions and determine when disaggregation is beneficial. Understanding these trade-offs is critical for current cluster-scale LLM serving and for future disaggregated inference platforms, including NVIDIA Groq 3 LPX NVIDIA (2026a) and Intel/SambaNova-style systems Intel (2026).
|
||||||
|
|
||||||
|
In this paper, we present a systematic study of AFD for LLM inference across diverse application domains. We analyze efficient deployment across three dimensions: distributed parallelism, including tensor, data, pipeline, sequence, and expert parallelism; phase-level P/D disaggregation; and operator-level attention–FFN disaggregation, as shown in Figure˜1(C1). We formulate scheduling selection as a design-space exploration (DSE) problem that captures operator-level compute heterogeneity and inter-node communication costs.
|
||||||
|
|
||||||
|
To support this study, we develop AIConfigurator++ (AIC++), a co-design framework that combines operator-level compute modeling from NVIDIA AIConfigurator Xu et al. (2026) with distributed communication modeling using AstraSim Rashidi et al. (2020). Grounded in a customized vLLM-based AFD prototype Kwon et al. (2023), AIC++ integrates kernel measurements with system-level simulation to evaluate compute–communication trade-offs across scheduling strategies, as illustrated in Figure˜1(C2).
|
||||||
|
|
||||||
|
We evaluate chatbot, coding, and agentic workloads using DeepSeek-V3.2, GPT-OSS-120B, Nemotron3-120B, and Qwen3-235B, covering MLA, GQA, sparse attention, and Mamba-based architectures. By varying ISL, OSL, prefix length, and system load, our framework identifies when AFD is beneficial, how micro-batching and operator placement improve compute–communication overlap, and which scheduling strategy maximizes throughput and interactivity under SLO constraints. Importantly, our analysis translates workload and model characteristics into concrete attention-to-FFN GPU ratios, providing actionable guidance for cluster-scale deployment.
|
||||||
|
|
||||||
|
More broadly, our findings suggest that as LLM workloads become increasingly heterogeneous, system optimization must move beyond coarse-grained placement toward operator-level disaggregation. Modeling-driven frameworks such as AIC++ can guide the co-design of future heterogeneous inference platforms. From Figure˜2, we observe that under stringent SLOs for TTFT and TPOT on DeepSeek-V3.2, AFD is able to achieve 4k tokens/s system throughput while the non-AFD deployment is infeasible to run. Through exhaustive design-space exploration to analyze the best deployment strategy on a cluster of 128 B200 GPUs (Section˜4), we see that AFD is not the best option when system throughput is the main target compared to the pure P/D disaggregation and chunked prefill. But our analysis that dynamically searches the attention-to-FFN ratios finds that it will always achieve the best latency and user interactivity with the AFD-specific microbatch overlapping technique that best utilizes the compute and communication resources. Finally, we present a case study highlighting AFD’s memory-segmentation benefit: by placing most model weights on FFN GPUs, AFD leaves more memory on attention GPUs for KV cache, enabling higher throughput under the same memory constraint.
|
||||||
|
|
||||||
|
Our key contributions are:
|
||||||
|
|
||||||
|
- C1:
|
||||||
|
|
||||||
|
Multi-dimensional DSE: We jointly optimize LLM serving across token-level parallelism, P/D disaggregation, and AFD, and translate workload characteristics into concrete attention-to-FFN GPU ratios.
|
||||||
|
- C2:
|
||||||
|
|
||||||
|
System modeling for disaggregated architectures: We build AIC++, which models compute and data-transfer costs for scaled-out disaggregated inference systems.
|
||||||
|
- C3:
|
||||||
|
|
||||||
|
Optimal AFD operator placement: We demonstrate that careful placement of attention and FFN operators is critical for effective AFD deployment.
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
Figure 2: System throughput at the best feasible deployment on DeepSeek-V3.2 (128× B200 with trtllm backend) under strict SLOs (TTFT<50/100/150 ms for Chat/Coding/Agentic Coding; TPOT caps 15 ms). Red cross marks infeasibility — the auto-con
|
||||||
|
|
||||||
|
advisory chatbots - typically exhibit large context length and small ISLs.
|
||||||
|
These workloads favor aggregated deployments, as frequent cross‑node data transfers in disaggregated systems incur high communication overheads.
|
||||||
|
In contrast, workloads with long ISLs, common in code‑completion and code‑generation tasks, benefit more from asynchronous function decomposition (AFD), which introduces an additional dimension to the scheduling design space.
|
||||||
|
In this work, we characterize different workloads with different ISL, OSL and context length to find the Pareto-optimal scheduling that balances system throughput and user interactivity under SLO constraints (detailed in section 4).
|
||||||
|
|
||||||
|
### 2.2 Finding the optimal scheduling with disaggregated architecture
|
||||||
|
|
||||||
|
The emergence of disaggregated architectures with heterogeneous compute units within a node—such as NVIDIA Groq‑3 LPX, Rubin CPX Nvidia (2024), and Intel SambaNova—has made fine‑grained AFD an effective scheduling strategy despite the increased communication volume. High‑bandwidth scale‑up interconnects in these heterogeneous clusters enable memory‑bound attention operators to execute on memory‑rich devices, while compute‑intensive FFN blocks benefit from accelerators optimized for high arithmetic throughput.
|
||||||
|
|
||||||
|
System modeling requirements of disaggregated architecture:
|
||||||
|
Exploring a large design space by evaluating hundreds of candidate configurations is prohibitively expensive for large‑scale disaggregated systems as observed by Miao et al. (2022); Zheng et al. (2022).
|
||||||
|
Hence, accurate system modeling of compute and communication infrastructure is necessary for evaluation.
|
||||||
|
AIConfigurator Xu et al. (2026) provides a compute modeling framework to estimate the compute and memory bandwidth of a wide range of modern GPUs.
|
||||||
|
However, we additionally need accurate estimation of the data-transfer cost for fine-grained operator-level AFD.
|
||||||
|
To address this, we augment AIConfigurator with the AstraSim Rashidi et al. (2020) network simulator to build AIC++,
|
||||||
|
a disaggregated modeling framework that captures the compute-communication effects, maximizing their overlap for fine-grained AFD.
|
||||||
|
Moreover, we evaluate the impact of AFD in heterogeneous scale-up AIC++ deployments.
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
Figure 3: (a) Runtime breakdown and (b) memory component breakdown for different model architectures running prompts with different context lengths.
|
||||||
|
|
||||||
|
Precise placement of attention and FFN operators:
|
||||||
|
Fine‑grained data transfers introduced by AFD can lead to significant interconnect congestion if attention and FFN operators are placed arbitrarily across a disaggregated infrastructure. Consequently, effective scheduling of fine‑grained operator disaggregation requires jointly reasoning about compute affinity and data‑movement costs—a challenge explicitly addressed in our work. In particular, optimal operator placement must account for compute–communication overlap by co‑locating operators with high data‑exchange intensity on nearby or tightly coupled compute nodes. Going beyond prior approaches that primarily model heterogeneous architectures, our work jointly optimizes operator placement by explicitly considering interconnect congestion, identifying optimal mappings of attention and FFN operators that maximize overall system efficiency.
|
||||||
|
|
||||||
|
## 3 AIC++ 框架总览
|
||||||
|
|
||||||
|
In this section, we present AIC++, a framework for exploring the design space of AFD‑enabled MoE serving at scale. AIC++ combines AIConfigurator Xu et al. (2026) for accelerator‑level performance modeling with ASTRA‑Sim Rashidi et al. (2020) for high‑fidelity network simulation, enabling evaluation across attention architectures and application domains. While AIConfigurator accurately models modern LLM kernels, it does not capture AFD‑specific communication paths; we extend it by partitioning execution into attention and MoE‑FFN phases and binding each phase to an independent GPU backend, faithfully modeling runtime and memory behavior on disaggregated devices.
|
||||||
|
|
||||||
|
### 3.1 AFD design for MoE architectures
|
||||||
|
|
||||||
|
As shown in Figure˜4, the transition between the Attention and MoE–FFN phases is mediated by the MoE-Dispatch and MoE-Combine communication operators. In non-AFD deployments, these operators involve matched source and destination counts, as communication is confined to GPU ranks participating in expert parallelism (EP). Under AFD, attention and MoE–FFN phases execute on physically disaggregated GPUs, resulting in asymmetric fan-out or fan-in communication patterns depending on the scheduling strategy. For example, while an MoE model deployed on 8 GPUs with EP=8 exchanges tokens among all 8 GPUs, an AFD configuration with 2 attention GPUs and 6 FFN GPUs induces a fan-out pattern, requiring tokens generated by the attention GPUs to be distributed to a larger set of FFN GPUs.
|
||||||
|
|
||||||
|
AIC++ models these interactions using AstraSim to simulate scale-up and
|
||||||
|
scale-out communication at packet granularity. By coupling AstraSim with
|
||||||
|
AIConfigurator, AIC++ enforces communication-dependent execution, capturing
|
||||||
|
contention, GPU utilization, and data-transfer efficiency under dynamic workloads.
|
||||||
|
|
||||||
|
Concretely, each transformer layer incurs two cross-AFD transfers. In the all-pairs mode used for the main results, the AFD worker establishes pairwise communicators between every attention rank and every FFN rank, so tokens generated by a single attention rank may be routed to any FFN rank hosting the selected experts.
|
||||||
|
A2F/A2E (MoE-Dispatch) transfers post-attention hidden states, token ids, and per-expert routing metadata from attention ranks
|
||||||
|
to FFN ranks hosting the selected experts, where each FFN rank filters tokens according to its hosted experts. Due to the top-kk routing and token dispatch, A2F exhibits a fan-out, making FFN-side ingress congestion dominant. F2A/E2A (MoE-Combine) aggregates expert outputs and
|
||||||
|
returns a single reduced hidden state per token to the originating attention rank,
|
||||||
|
forming a fan-in transfer in which attention-side ingress becomes the bottleneck. AIC++ expands both transfers into a full bipartite
|
||||||
|
traffic matrix and feeds them into AstraSim’s tiered, congestion-aware network model,
|
||||||
|
capturing contention when A2F egress and F2A ingress overlap on full-duplex
|
||||||
|
interconnects. This part of the implementation with its communication pattern is based on our prototype implementation (refer to subsection 6.1).
|
||||||
|
|
||||||
|
### 3.2 Batch Overlap (BO) in AFD
|
||||||
|
|
||||||
|
As shown in Figure˜4 (left), AFD decomposes execution into four stages mapped to separate compute or communication resources: attention computation on the attention GPUs, dispatch of post-attention hidden states, token ids, and per-expert routing metadata to experts, MoE-FFN computation on the FFN GPUs, and aggregation/transfer of expert outputs back to the attention side for the next layer.
|
||||||
|
|
||||||
|
The return communication may share the same channel on half-duplex links, or proceed concurrently over a dedicated channel on full-duplex networks, enabling the pipelined execution shown in Figure˜4(B). Since modern datacenter GPU deployments commonly provide full-duplex interconnects such as NVLink and InfiniBand, AFD can exploit compute-communication overlap across GPUs and the network fabric. Accordingly, in the following discussion, we assume an AFD implementation with four-stage micro-batch overlap enabled. In contrast, under aggregated execution, all devices jointly execute all stages as a single group, as shown in Figure˜4(A).
|
||||||
|
|
||||||
|
To model batch overlap behavior in AIC++, we partition the per-step token budget
|
||||||
|
Tbudget=batch_size×ISLT_{{budget}}=it{batch\_size}it{ISL} into MM microbatches.
|
||||||
|
The number of microbatches MM is chosen to match the effective pipeline depth—three
|
||||||
|
for half-duplex links and four for full-duplex links. For each microbatch,
|
||||||
|
AIC++ queries AIConfigurator’s empirically measured GPU-cluster cost database
|
||||||
|
to obtain the attention and FFN execution costs for a microbatch size of
|
||||||
|
Tbudget/MT_{{budget}}/M, thereby preserving the nonlinear scaling behavior of small
|
||||||
|
GEMMs and collective operations.
|
||||||
|
|
||||||
|
Let sis_{i} denote the measured per-microbatch execution cost of pipeline stage ii,
|
||||||
|
aggregated across all LL transformer layers, and let
|
||||||
|
smax=maxisis_{}=_{i}s_{i} be the bottleneck stage. Under steady-state cross-layer
|
||||||
|
pipelining, the bottleneck stage processes all MM microbatches back-to-back,
|
||||||
|
whereas each non-bottleneck stage incurs only a one-time pipeline fill and drain
|
||||||
|
overhead of si/Ls_{i}/L. This cost is amortized over the full execution rather than
|
||||||
|
charged per layer, consistent with the cross-layer scheduling strategies used by
|
||||||
|
MegaScale-Infer and Step-Fun. The resulting end-to-end pipelined latency is shown in Equation˜1.
|
||||||
|
|
||||||
|
| | | | |
|
||||||
|
| --- | --- | --- | --- |
|
||||||
|
| | tpipe=M⋅smax+∑i:si≠smaxsiL.t_{{pipe}}=M s_{}+_{i:s_{i} s_{}}{s_{i}}{L}. | | (1) |
|
||||||
|
|
||||||
|
The first term captures the steady-state throughput dictated by the bottleneck
|
||||||
|
resource, while the second term accounts for pipeline fill and drain bubbles
|
||||||
|
introduced by non-bottleneck stages. We apply this formulation to both prefill and
|
||||||
|
decode phases, enabling AIC++ to accurately reason about computation and
|
||||||
|
communication costs under batch-overlapped execution.
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
Figure 4: Mapping AFD to 4 different stages in the model execution
|
||||||
|
|
||||||
|
### 3.3 Location-aware GPU placement
|
||||||
|
|
||||||
|
Because AstraSim labels each GPU with its physical position—node, scale-up domain, and link tier—and resolves congestion at packet granularity, AIC++ additionally enables a study of optimal GPU placement under combined AFD and P/D disaggregation. The policy is frequency-driven: the most frequent intra-layer A2F/F2A traffic (𝒪(layer){O}({layer}) per request) is bound to the highest-bandwidth scale-up domain (intra-node NVLink), while the less frequent inter-node KV-cache transfer (𝒪(1){O}(1) per request) is deferred to the scale-out domain (InfiniBand). This grouping co-locates GPUs with high communication affinity onto faster interconnects, avoiding contention on slower links. The detailed placement study—including segregated vs. paired P/D layouts and the resulting KV-transfer speed-up—is given in Appendix 6.2.
|
||||||
|
|
||||||
|
We also consider asymmetric prefill and decode configurations reflecting their distinct compute characteristics. AIC++ enables such asymmetry through independent prefill/decode scheduling and asymmetric attention and FFN worker allocation, while the network simulator co‑locates operators to reduce interconnect congestion and improve efficiency.
|
||||||
|
|
||||||
|
## 4 Evaluation
|
||||||
|
|
||||||
|
### 4.1 Design-Space Exploration (DSE) of different serving strategies
|
||||||
|
|
||||||
|
#### 4.1.1 Input workloads
|
||||||
|
|
||||||
|
To demonstrate the applicability of AFD, we evaluate a diverse set of model architectures spanning multiple application domains, as summarized in Table˜1. Specifically, we consider recent production‑deployed models including Qwen3‑235B, commonly used for chatbot workloads; GPT‑OSS‑120B, targeting medium‑scale reasoning tasks; DeepSeek‑V3.2, designed for reasoning‑intensive and agentic coding workflows; and Nemotron3‑120B, optimized for large‑context applications such as RAG serving Nvidia (2026). The corresponding prefix sizes, ISL, OSL, and architectural characteristics for each workload are detailed in Table˜1.
|
||||||
|
|
||||||
|
Table 1: Representative application workloads and model architectures.
|
||||||
|
|
||||||
|
Application Workload
|
||||||
|
|
||||||
|
| | | | |
|
||||||
|
| --- | --- | --- | --- |
|
||||||
|
| Use Case | Prefix | ISL | OSL |
|
||||||
|
| Chat | 4096 | 512 | 256 |
|
||||||
|
| Coding | 2048 | 4096 | 1024 |
|
||||||
|
| Agentic Coding | 524k 111Models listed in this table may not natively support a 524k context window. We use 524k to model long-context agentic workloads and quantify the system impact of large KV-cache residency. | 256 | 8192 |
|
||||||
|
|
||||||
|
Model Architecture
|
||||||
|
|
||||||
|
| | | | |
|
||||||
|
| --- | --- | --- | --- |
|
||||||
|
| Model | Attention | # Experts | Precision |
|
||||||
|
| GPT-OSS-120B | Full GQA + Window GQA | 128 | FP8 |
|
||||||
|
| Qwen3-235B | GQA | 128 | FP8 |
|
||||||
|
| Nemotron3-120B | Mamba 2 + GQA | 512 | FP8 |
|
||||||
|
| DeepSeek V3.2 | MLA + Sparse Attention | 256 | FP8 |
|
||||||
|
|
||||||
|
#### 4.1.2 Cluster-scale DSE analysis
|
||||||
|
|
||||||
|
Figure˜5 reports the Pareto curve (tokens/s/user vs system tokens/s) produced by AIC++ on a 128 B200SXM cluster with TensorRT-LLM NVIDIA (2026b) as the performance backend, with each panel constrained by the workload’s SLO from Table˜1. To exhaustively probe the throughput frontier, our replica search enumerates every replica size from 2 to 128 GPUs and dynamically composes the per-replica parallelism plan across TP, DP, EP, and (for AFD) attention/FFN GPU groups. This lets the optimizer surface asymmetric layouts that only become feasible when prefill and decode have very different compute and memory profiles, including off-grid replica sizes that pack a long-context KV cache more efficiently than the obvious power-of-two choices. The cluster-scale results in this section are model-based DSE estimates that combine backend cost measurements with AstraSim communication modeling. Appendix 6.1 describes our vLLM-based AFD prototype, which we use to verify functional correctness of the all-pairs attention–FFN execution path and to ground the communication pattern modeled by AIC++.
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
Figure 5: Evaluation of a Cluster with 128 B200 GPUs for the representative model architectures and application workloads shown in Table 1, Y-axis denotes the system throughput (total tokens/s), X-axis denotes the interactivity (tokens/s/user)
|
||||||
|
|
||||||
|
No single strategy dominates the throughput frontier. Aggregated serving with chunked prefill, deployed as 16 single-node 8-GPU replicas that hold the expert FFNs through Expert Parallelism, wins most panels by amortizing the chunked-prefill bubble across the replica fleet and ingesting many disjoint token batches in parallel. Disaggregation takes the rest, but only after the wider search exposes asymmetric replica shapes: a single off-grid replica with many small 2-GPU prefill workers feeding a few large 8-GPU decode workers (Qwen3-235B-A22B chat, DeepSeek-V3.2 coding), or many tiny xPyD shards under _disagg+AFD_ that double aggregated’s throughput on Nemotron-3-Super coding. AFD on its own wins the throughput frontier on a single panel, GPT-OSS-120B chat, where the cheap sliding-window GQA layers let four 32-GPU replicas with a near-symmetric 16A+16F split outpace 16-replica agg. The wider TP-16 enumeration also unlocks a feasible _disagg-standard_ layout for DeepSeek-V3.2 agentic coding, where a narrower TP,≤,8 search returned no SLO-feasible configuration for the 524k-prefix workload.
|
||||||
|
|
||||||
|
On the latency axis, AFD wins every panel, with the optimal attention/FFN split tracking each model’s intrinsic attention/mixer cost relative to its FFN cost. DeepSeek-V3.2, whose MLA combined with sparse (DSA) attention shrinks both per-token attention compute and the KV-cache footprint, collapses the attention shard to its minimum on long-context workloads, dedicating almost the entire cluster to FFN (2A+126F on agentic, 16A+112F on chat). The 2A+126F layout is initially counter-intuitive given the 524k-token KV demand, but consistent with rate-matching: MLA compresses the latent KV cache so aggressively that the entire prefix fits in two GPUs’ HBM, and DSA keeps per-token attention cheap enou
|
||||||
|
|
||||||
|
manov.
|
||||||
|
Vidur: A large-scale simulation framework for llm inference, 2024.
|
||||||
|
URL https://arxiv.org/abs/2405.05465.
|
||||||
|
- Ashish [2017]
|
||||||
|
|
||||||
|
Vaswani Ashish.
|
||||||
|
Attention is all you need.
|
||||||
|
_Advances in neural information processing systems_, 30:I, 2017.
|
||||||
|
- Bambhaniya et al. [2026]
|
||||||
|
|
||||||
|
Abhimanyu Rajeshkumar Bambhaniya, Hanjiang Wu, Suvinay Subramanian, Sudarshan Srinivasan, Souvik Kundu, Amir Yazdanbakhsh, Midhilesh Elavazhagan, Madhu Kumar, Minlan Yu, Arijit Raychowdhury, and Tushar Krishna.
|
||||||
|
Mist: A co-design framework for heterogeneous, multi-stage llm inference, 2026.
|
||||||
|
URL https://arxiv.org/abs/2504.09775.
|
||||||
|
- DeepSeek-AI et al. [2024]
|
||||||
|
|
||||||
|
DeepSeek-AI, Aixin Liu, Bei Feng, Bin Wang, Bingxuan Wang, Bo Liu, Chenggang Zhao, Chengqi Dengr, Chong Ruan, Damai Dai, Daya Guo, Dejian Yang, Deli Chen, Dongjie Ji, Erhang Li, Fangyun Lin, Fuli Luo, Guangbo Hao, Guanting Chen, Guowei Li, H. Zhang, Hanwei Xu, Hao Yang, Haowei Zhang, Honghui Ding, Huajian Xin, Huazuo Gao, Hui Li, Hui Qu, J. L. Cai, Jian Liang, Jianzhong Guo, Jiaqi Ni, Jiashi Li, Jin Chen, Jingyang Yuan, Junjie Qiu, Junxiao Song, Kai Dong, Kaige Gao, Kang Guan, Lean Wang, Lecong Zhang, Lei Xu, Leyi Xia, Liang Zhao, Liyue Zhang, Meng Li, Miaojun Wang, Mingchuan Zhang, Minghua Zhang, Minghui Tang, Mingming Li, Ning Tian, Panpan Huang, Peiyi Wang, Peng Zhang, Qihao Zhu, Qinyu Chen, Qiushi Du, R. J. Chen, R. L. Jin, Ruiqi Ge, Ruizhe Pan, Runxin Xu, Ruyi Chen, S. S. Li, Shanghao Lu, Shangyan Zhou, Shanhuang Chen, Shaoqing Wu, Shengfeng
|
||||||
@@ -0,0 +1,94 @@
|
|||||||
|
# 📊 文章摘要:How Far Can Disaggregation Go? A Design-Space Exploration of Attention-FFN Disaggregation for Efficient MoE LLM Serving
|
||||||
|
|
||||||
|
> **原文**:[2026-05-27_AFD_How_Far_Can_Disaggregation_Go.md](./2026-05-27_AFD_How_Far_Can_Disaggregation_Go.md)
|
||||||
|
> **原文链接**:https://arxiv.org/abs/2605.28302
|
||||||
|
> **来源**:arXiv
|
||||||
|
> **作者**:Hanjiang Wu, Abhimanyu Rajeshkumar Bambhaniya, Sarbartha Banerjee, Tuhin Khare, Sudarshan Srinivasan, Suvinay Subramanian 等 12 位(佐治亚理工学院、Intel、Google、Google DeepMind、Infravana)
|
||||||
|
> **发布日期**:2026-05-27
|
||||||
|
> **摘要日期**:2026-08-06
|
||||||
|
> **价值评级**:⭐⭐⭐ 高
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 核心命题
|
||||||
|
|
||||||
|
> **算子级解耦** — 解耦不止于阶段(prefill/decode),可下探到算子级:把内存受限的 attention 与计算密集的 MoE-FFN 拆分到不同 GPU 组(AFD),并以设计空间探索给出"何时、何处更深层解耦才划算"的实用地图。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 文章概要
|
||||||
|
|
||||||
|
随着 MoE 模型(如 DeepSeek-V3.2)规模扩大与 TTFT/TPOT SLO 收紧,LLM serving 的解耦粒度不断加深:从 chunked-prefill 聚合,到 prefill/decode(P/D)解耦,再到算子级 attention-FFN 解耦(AFD)。本文系统回答"每一层解耦何时真正划算":基于 vLLM 的 AFD 原型 + AIConfigurator(算子级计算建模)+ AstraSim(包粒度网络模拟)构建 AIC++ 框架,对 128 卡 B200 集群上 4 种模型(DeepSeek-V3.2、GPT-OSS-120B、Nemotron3-120B、Qwen3-235B)× 3 类负载(chat/coding/agentic coding)做全维设计空间探索。核心发现:严格 SLO 下 AFD 在 DeepSeek-V3.2 上可维持约 4k tokens/s 系统吞吐,而非 AFD 部署不可行;吞吐维度没有单一策略通吃(chunked prefill 聚合常胜),但延迟/交互性维度 AFD 全胜,且最优 attention/FFN GPU 比例可依模型与负载导出(如 DeepSeek-V3.2 长上下文下 2A+126F 的极端配比)。局限:结果基于建模 + 模拟的 DSE 估计,原型仅验证功能正确性。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 关键要点
|
||||||
|
|
||||||
|
1. **解耦粒度演化谱系** — chunked-prefill 聚合 → P/D 阶段解耦 → AFD 算子级解耦,每一层解耦都加深调度设计空间(工作负载特性 × 资源分配 × 互连拓扑),本文首次系统回答"解耦能走多远"这一问题。`[分类: 范式突破]`
|
||||||
|
2. **MoE 架构放大算子异构** — attention(MHA/GQA/MLA)内存受限、FFN 计算密集,加上 MoE dispatch/combine 通信,一个 transformer 块内就存在显著计算异构;粗粒度抽象(MegaScale-Infer 已指出的问题)在 MoE 上尤其失效。`[分类: 共识]`
|
||||||
|
3. **严格 SLO 下 AFD 使不可能变为可能** — DeepSeek-V3.2 上以 TTFT<50/100/150ms、TPOT≤15ms 的严格约束(chat/coding/agentic coding),AFD 部署维持约 4k tokens/s 系统吞吐,而非 AFD 部署不可行(infeasible)。`[分类: 范式突破]`
|
||||||
|
4. **吞吐前沿无通吃方案** — 128×B200 集群 DSE:chunked prefill 聚合部署(16 个单节点 8-GPU 副本)赢得多数面板;AFD 单独赢得一个面板(GPT-OSS-120B chat,16A+16F 近似对称拆分);非对称副本形态(如 2-GPU prefill 工人喂 8-GPU decode 工人)是解耦方案胜出的关键。`[分类: 争议]`
|
||||||
|
5. **延迟维度 AFD 全胜** — 每个面板的最优 attention/FFN 拆分都追踪模型内在的 attention/mixer 成本与 FFN 成本之比;AFD 特定微批重叠(four-stage pipeline,全双工链路)最大化计算-通信重叠,始终给出最佳延迟与用户交互性。`[分类: 未探索]`
|
||||||
|
6. **反直觉的极端配比** — DeepSeek-V3.2 的 MLA + 稀疏注意力把每 token attention 计算与 KV cache 足迹压得极小,长上下文 agentic 负载(524k prefix)下最优配置为 2A+126F——整个 524k 前缀的 KV cache 可装入 2 个 GPU 的 HBM,几乎整个集群给 FFN。`[分类: 范式突破]`
|
||||||
|
7. **内存分割是隐藏收益** — 把多数模型权重放在 FFN GPU 上,attention GPU 腾出显存装 KV cache,同一内存约束下可支撑更高吞吐——AFD 的收益不止调度层面。`[分类: 未探索]`
|
||||||
|
8. **位置感知放置原则** — 最频繁的层内 A2F/F2A 流量(每请求 O(layer))绑定最高带宽 scale-up 域(NVLink),低频的跨节点 KV cache 传输(每请求 O(1))走 scale-out(InfiniBand);A2F 扇形广播(fan-out)使 FFN 侧入口拥塞、F2A 扇形汇聚(fan-in)使 attention 侧入口成为瓶颈。`[分类: 未探索]`
|
||||||
|
9. **AIC++ 方法论** — 内核级实测成本库(AIConfigurator)+ 包粒度拥塞感知网络模拟(AstraSim)联合建模,以 vLLM AFD 原型锚定通信模式与功能正确性;论文明示集群级结果均为"模型驱动 DSE 估计"。`[分类: 争议]`
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 批判性分析
|
||||||
|
|
||||||
|
### 假设前提
|
||||||
|
|
||||||
|
- 异构/解耦硬件时代将到来:节点内出现计算/内存不对称的加速器组(NVIDIA Groq-3 LPX、Rubin CPX、Intel/SambaNova 等),且存在 NVLink 级高带宽 scale-up 互连。
|
||||||
|
- AFD 的通信模式(all-pairs 的 A2F/F2A 双向传输)在真实网络上可被微批重叠技术有效隐藏。
|
||||||
|
- 内核级测量成本库 + AstraSim 网络模拟的组合足以逼近真实集群行为,从而替代全系统原型评估。
|
||||||
|
- 以系统吞吐与用户交互性(tokens/s/user)为目标的 SLO 框架能代表生产诉求。
|
||||||
|
|
||||||
|
### 论据与逻辑
|
||||||
|
|
||||||
|
- 论据结构严谨:先以运行时分解与内存分解数据(图 3)确立算子异构事实,再用 AIC++ 在 128 卡规模做穷举式 DSE(副本规模 2-128 卡全枚举 + TP/DP/EP/SP/PP 与 P/D、AFD 联合搜索),结论(无通吃方案、AFD 延迟全胜、配比可推导)有模拟数据支撑。
|
||||||
|
- 关键量化结论(约 4k tokens/s、2A+126F、2.35×/1.4× 类收益的可比性)均限定在各自严格语境中,未过度外推。
|
||||||
|
- 弱点:集群级结论全部来自建模估计,AIC++ 的准确性未与真实 AFD 集群端到端对照;vLLM 原型仅验证功能正确性,无法排除建模误差对"吞吐前沿无通吃方案"等核心结论的影响;对非 AFD 部署"不可行"的判定依赖 SLO 设定与搜索范围的完整性(论文也承认窄 TP≤8 搜索曾漏掉可行配置)。
|
||||||
|
|
||||||
|
### 边界与局限
|
||||||
|
|
||||||
|
- AFD 的优势集中于延迟/交互性维度与严格 SLO 场景;纯吞吐目标下 chunked prefill 聚合常更优——结论不可泛化为"AFD 总是更好"。
|
||||||
|
- 依赖高带宽 scale-up 互连;半双工/低带宽网络下微批重叠收益收缩(pipeline 深度由 4 降为 3)。
|
||||||
|
- 配比指导依赖模型架构(MLA/GQA/Mamba 差异显著),换架构需重跑 DSE。
|
||||||
|
- 结果基于模拟,需真实异构集群验证;524k prefix 属极端长上下文建模,超出部分模型原生窗口。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 可引用金句
|
||||||
|
|
||||||
|
> "Our findings deliver a practical map of when and where deeper disaggregation pays off for MoE serving at scale."
|
||||||
|
> (我们的发现提供了一张实用地图:在 MoE 规模化服务中,何时、何处更深层的解耦才真正划算。)
|
||||||
|
|
||||||
|
> "Under strict TTFT/TPOT SLOs, AFD sustains around 4k tokens/s of system throughput on DeepSeek-V3.2 across chat, coding, and agentic-coding workloads, regimes in which non-AFD deployments are infeasible."
|
||||||
|
> (在严格的 TTFT/TPOT SLO 下,AFD 在 DeepSeek-V3.2 上于 chat、coding 与 agentic-coding 负载中维持约 4k tokens/s 的系统吞吐,而这是非 AFD 部署不可行的场景。)
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 总体评价
|
||||||
|
|
||||||
|
**亮点**:
|
||||||
|
- 首次把解耦粒度推进到算子级(AFD)并系统回答"解耦能走多远",把 2023-2024 年的阶段解耦共识延伸为新范式
|
||||||
|
- "吞吐无通吃方案、延迟 AFD 全胜"的差异化结论打破了"解耦必然更好"的朴素预期,结论颗粒度精细
|
||||||
|
- 给出可操作的 attention/FFN GPU 配比指导(含 2A+126F 这类反直觉结论背后的推理),并揭示内存分割这一隐藏收益
|
||||||
|
- AIC++ 把内核实测与网络模拟结合的建模方法论,为异构推理基础设施设计提供了可复用工具
|
||||||
|
|
||||||
|
**不足**:
|
||||||
|
- 集群级结论全部基于建模与模拟,缺少真实 AFD 集群的端到端验证
|
||||||
|
- 部分结论(如"非 AFD 不可行")对 SLO 设定与搜索范围敏感,泛化需谨慎
|
||||||
|
- 评估硬件模型(B200 + TensorRT-LLM)与实际异构平台(Groq-3 LPX 等)仍有差距
|
||||||
|
|
||||||
|
**适用场景**:MoE 模型 serving 的系统架构师;面向异构加速器(Groq-3 LPX、Rubin CPX 等)与解耦集群的设计者;研究 LLM serving 设计空间探索的研究人员。
|
||||||
|
|
||||||
|
**关联建议**:向上游追溯 DistServe(P/D 解耦起点)、Splitwise(异构硬件)、Mooncake(生产实践),可看出"解耦粒度深化"的完整脉络;后续可关注 MegaScale-Infer(同方向的算子级优化)、Mist(同团队的异构多阶段 co-design 框架)以及 NVIDIA 解耦平台(LPX/CPX)的真实部署验证。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 配图
|
||||||
|
|
||||||
|

|
||||||
@@ -0,0 +1,388 @@
|
|||||||
|
# Splitwise: Efficient Generative LLM Inference Using Phase Splitting
|
||||||
|
|
||||||
|
> **来源**:arXiv
|
||||||
|
> **作者**:Pratyush Patel, Esha Choukse, Chaojie Zhang, Aashaka Shah, Íñigo Goiri, Saeed Maleki, Ricardo Bianchini
|
||||||
|
> **发布日期**:2023-11-30
|
||||||
|
> **原文链接**:https://arxiv.org/abs/2311.18677
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 论文元数据
|
||||||
|
|
||||||
|
- **arXiv ID**:2311.18677
|
||||||
|
- **学科分类**:Distributed, Parallel, and Cluster Computing (cs.DC)
|
||||||
|
- **作者机构**:华盛顿大学(University of Washington)、微软(Microsoft)
|
||||||
|
- **提交历史**:v1: 2023-11-30;v2: 2024-05-20
|
||||||
|
- **DOI**:https://doi.org/10.48550/arXiv.2311.18677
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
Pratyush Patel1,
|
||||||
|
Esha Choukse2,
|
||||||
|
Chaojie Zhang2,
|
||||||
|
|
||||||
|
Aashaka Shah2,
|
||||||
|
Íñigo Goiri2,
|
||||||
|
Saeed Maleki2,
|
||||||
|
Ricardo Bianchini2
|
||||||
|
|
||||||
|
1University of Washington 2Microsoft
|
||||||
|
|
||||||
|
## 摘要(Abstract)
|
||||||
|
|
||||||
|
Generative large language model (LLM) applications are growing rapidly, leading to large-scale deployments of expensive and power-hungry GPUs.
|
||||||
|
Our characterization of LLM inference shows that each inference request undergoes two phases: a compute-intensive prompt computation phase and a memory-intensive token generation phase, each with distinct latency, throughput, memory, and power characteristics.
|
||||||
|
Despite state-of-the-art batching and scheduling, the token generation phase underutilizes compute resources.
|
||||||
|
Unlike prompt computation, token generation does not need the compute capability of the latest GPUs and can be run with lower power and cost.
|
||||||
|
|
||||||
|
Based on these insights, we propose Splitwise, a model deployment and scheduling technique that splits the two phases of LLM inference requests on to separate machines.
|
||||||
|
Splitwise enables phase-specific resource management using hardware that is well suited for each phase.
|
||||||
|
Request state is transferred efficiently between machines using optimized network libraries on the fast back-plane interconnects available in today’s GPU clusters.
|
||||||
|
Using Splitwise, we design homogeneous and heterogeneous LLM inference clusters optimized for throughput, cost, and power.
|
||||||
|
Compared to current designs, Splitwise clusters achieve up to 1.4×1.4 × higher throughput at 20% lower cost. Alternatively, they can deliver 2.35×2.35 × more throughput under the same power and cost budgets.
|
||||||
|
|
||||||
|
## I 引言(Introduction)
|
||||||
|
|
||||||
|
Recent advancements in generative large language models (LLMs) have significantly improved their response quality and accuracy [18, 71].
|
||||||
|
These trends have led to the widespread adoption of LLMs across various domains [6, 21].
|
||||||
|
Most modern LLMs are built using the transformer architecture [78, 77] and exhibit similar characteristics [63].
|
||||||
|
Transformer model sizes have grown steadily, from the early BERT models [36] having 340 million parameters, to GPT-3 [28] with a staggering 175 billion parameters, and GPT-4 rumored to have even more.
|
||||||
|
|
||||||
|
LLMs typically run on expensive and power-hungry GPUs [16].
|
||||||
|
The sudden and large-scale deployment of LLMs has led to a worldwide GPU capacity crunch [14].
|
||||||
|
The computational demand for LLM inference far exceeds that of training due to the vast number of applications leveraging LLMs.
|
||||||
|
Furthermore, since training LLMs requires expensive and dedicated supercomputers [60, 56], a large number of inferences are necessary to amortize the high training costs.
|
||||||
|
LLM inference jobs, although orders of magnitude smaller than training, are still expensive given the compute involved.
|
||||||
|
11脚注: Work partly done as an intern at Microsoft.
|
||||||
|
|
||||||
|
TABLE I: NVIDIA A100 vs. H100 specifications.
|
||||||
|
|
||||||
|
Generative LLM inference for a single request consists of several forward passes through the model, since the output tokens are generated one by one.
|
||||||
|
This inherently has two contrasting phases of computation.
|
||||||
|
First, the _prompt computation phase_, in which all the input prompt tokens run through the forward pass of the model in parallel to generate the first output token.
|
||||||
|
This phase tends to be computationally intensive and requires the high FLOPs (floating point operations per second) of the latest GPUs today.
|
||||||
|
Second, the _token generation phase_, in which subsequent output tokens are generated sequentially based on the forward pass of the last token and all the cached context from previous tokens in the sequence.
|
||||||
|
Given the lack of compute parallelism, this phase tends to be more memory bandwidth and capacity bound, despite state-of-the-art batching.
|
||||||
|
Running both phases on the same machine often leads to inconsistent end-to-end latencies due to the arbitrary batching of prompt and token phases.
|
||||||
|
Due to these challenges, services need to over-provision expensive GPUs to meet tight inference service level objectives (SLOs) for interactive applications.
|
||||||
|
At the same time, cloud service providers (CSPs) are having to build a lot of new datacenters to meet the GPU demand, and are running into a power wall [19].
|
||||||
|
|
||||||
|
The industry continues to release new computationally powerful GPUs, each much more power hungry and expensive than the last.
|
||||||
|
However, as shown in Table I, the high-bandwidth memory (HBM) capacity and bandwidth on these GPUs has not scaled at the same rate recently.
|
||||||
|
The latest NVIDIA H100 GPUs have 3.43×3.43 × more compute and 1.75×1.75 × more power compared to their predecessor A100 GPUs.
|
||||||
|
However, their memory bandwidth only grew by 1.6×1.6 ×, with no increase in memory capacity.
|
||||||
|
|
||||||
|
Our work.
|
||||||
|
Given the distinct properties of prompt computation and token generation phases, we propose splitting the inference request and running them on separate machines.
|
||||||
|
Doing so allows us to separately manage hardware resources for each phase, thereby increasing the GPU utilization and the overall efficiency of the system.
|
||||||
|
It also enables using different, better-suited hardware for each phase.
|
||||||
|
To realize such a setup, the cached context from the prompt computation needs to be communicated over from the prompt processing machine to the token generation machine at low latency.
|
||||||
|
We implement these transfers in an optimized manner over the back-end Infiniband interconnects avaialble in datacenters today, allowing us to increase efficiency without any perceived performance loss.
|
||||||
|
|
||||||
|
With Splitwise, we design clusters optimized for cost, throughput, and power, using production traces of LLM inference requests [4].
|
||||||
|
Given the diverging memory and compute scaling rates across GPU generations, we also evaluate different GPUs and power caps for the different inference phases.
|
||||||
|
This allows us to target better performance per dollar (Perf/$) for users, and better performance per watt (Perf/W) for CSPs.
|
||||||
|
Additionally, users can target older GPUs, which are likely more readily available to them.
|
||||||
|
|
||||||
|
We show that Splitwise-based LLM inference clusters can achieve 1.4× higher throughput at 20% lower cost than existing clusters. Alternatively, they can deliver 2.35× more throughput with the same cost and power budgets.
|
||||||
|
|
||||||
|
Summary.
|
||||||
|
We make the following contributions:
|
||||||
|
|
||||||
|
1. 1.
|
||||||
|
|
||||||
|
An extensive characterization of the differences in the execution and utilization patterns of the prompt and token generation phases in LLM inference on the NVIDIA A100 and H100 GPUs using production traces.
|
||||||
|
2. 2.
|
||||||
|
|
||||||
|
Splitwise, our technique for optimized utilization of available hardware, which splits the prompt computation and token generation phases onto separate machines.
|
||||||
|
3. 3.
|
||||||
|
|
||||||
|
A design exploration of homogeneous and heterogeneous cluster deployments with Splitwise to optimize the overall cost, request throughput, and provisioned power.
|
||||||
|
4. 4.
|
||||||
|
|
||||||
|
An evaluation of the systems designed with Splitwise using production traces.
|
||||||
|
|
||||||
|
## II Background
|
||||||
|
|
||||||
|
### II-A Large Language Models
|
||||||
|
|
||||||
|
Modern LLMs are based on transformers.
|
||||||
|
Transformer models use attention [77] and multi-layer-perceptron layers to understand the inputs and generate an output, respectively.
|
||||||
|
Transformer-based LLMs include encoder-only [36, 54], decoder-only [67, 69, 71], and encoder-decoder [70] models.
|
||||||
|
Generative LLMs, the focus of this paper, are usually either decoder-only, or encoder-decoder models.
|
||||||
|
|
||||||
|
### II-B Generative LLM inference phases
|
||||||
|
|
||||||
|
Figure 1 shows an example of generative LLM inference.
|
||||||
|
Once the prompt query is received, all the input tokens are computed in parallel, within a single iteration, to generate the first token.
|
||||||
|
We call this the prompt processing phase.
|
||||||
|
The context generated from the attention layers during the prompt computation is saved in the key-value (KV) cache, since it is needed for all the future token generation iterations.
|
||||||
|
After the first token is generated, the following tokens only use the last generated token and the KV-cache as inputs to the forward pass of the model.
|
||||||
|
This makes the subsequent token generation more memory bandwidth and capacity intensive than the computationally heavy prompt phase.
|
||||||
|
|
||||||
|
Figure 1: An LLM inference example.
|
||||||
|
|
||||||
|
### II-C Performance metrics for LLMs
|
||||||
|
|
||||||
|
Prior work has proposed three main metrics for LLM inference: end-to-end (E2E) latency, time to first token (TTFT), and throughput.
|
||||||
|
We add another latency metric: time between tokens (TBT), to track the online streaming throughput of the tokens as they are generated serially.
|
||||||
|
Table II summarizes the key performance metrics that we consider in this work.
|
||||||
|
|
||||||
|
TABLE II: Performance metrics for LLMs.
|
||||||
|
|
||||||
|
Generative LLMs may be used for a variety of tasks with different kinds of SLOs.
|
||||||
|
For batch tasks (_e.g._, summarization), TTFT or TBT latency metrics are less important than throughput.
|
||||||
|
On the other hand, for latency-sensitive tasks (_e.g._, conversational APIs), TTFT and TBT are the more important metrics with tighter SLOs.
|
||||||
|
|
||||||
|
Figure 2: Batching mechanisms and their latency impact on the pro
|
||||||
|
|
||||||
|
ut keeps scaling up with the batch size until the machine runs out of memory.
|
||||||
|
For this reason, the MLS tracks the memory and starts queueing tokens once the machine is close to running out of memory.
|
||||||
|
|
||||||
|
Mixed machines.
|
||||||
|
To meet the TTFT SLO, the MLS must prioritize running prompts and schedule any new prompts in the pending queue immediately.
|
||||||
|
If the machine is running token phases and has no additional capacity to run the prompt phase, the MLS will _preempt_ tokens.
|
||||||
|
To avoid _starvation_ of the token phase due to preemption, we increase the priority of the token with age and limit the number of preemptions that each request can have.
|
||||||
|
|
||||||
|
### IV-C KV-cache transfer
|
||||||
|
|
||||||
|
As discussed in Section II, the KV-cache is generated during the prompt phase of the request, and it continuously grows during the token generation phase.
|
||||||
|
In Splitwise, we need to transfer the KV-cache from the prompt machine to the token machine (shown in Figure 10) to complete the inference.
|
||||||
|
This transfer delay is the main overhead associated with Splitwise.
|
||||||
|
In this section, we discuss the impact of KV-cache transfer and how we optimize it.
|
||||||
|
|
||||||
|
(a)
|
||||||
|
|
||||||
|
(b)
|
||||||
|
|
||||||
|
Figure 11: Optimizing KV-cache transfer in Splitwise.
|
||||||
|
|
||||||
|
Figure 11(a) shows the Gantt chart for the prompt phase, the KV-cache transfer, and the token generation phase for a single batch of requests when naively transferring the KV cache in a serialized way.
|
||||||
|
The KV-cache transfer starts only after the prompt phase has finished and the first token is generated.
|
||||||
|
Further, it needs to complete before the next output token can be generated in the token generation phase.
|
||||||
|
This directly impacts the maximum TBT and end-to-end latency of inference.
|
||||||
|
|
||||||
|
The time required for the transfer depends on the size of the KV cache (which is directly proportional to the number of prompt tokens) and on the bandwidth of the interconnect between the prompt and the token machines.
|
||||||
|
Even when using fast InfiniBand links, the transfer overhead for large prompt sizes could become a significant fraction of the TBT.
|
||||||
|
|
||||||
|
In Splitwise, we optimize the KV-cache transfer by overlapping it with the computation in the prompt phase.
|
||||||
|
As each layer in the LLM gets calculated in the prompt machine, the KV cache corresponding to that layer is also generated.
|
||||||
|
At the end of each layer, we trigger an asynchronous transfer of the KV-cache for that layer while the prompt computation continues to the next layer.
|
||||||
|
Figure 11(b) shows this asynchronous transfer which reduces the transfer overheads.
|
||||||
|
Layer-wise transfer also enables other optimizations, such as earlier start of the token phase in the token machines, as well as earlier release of KV-cache memory on the prompt machines.
|
||||||
|
|
||||||
|
Layer-wise KV-cache transfer happens in parallel with the prompt computation for the next layer.
|
||||||
|
This requires fine-grained synchronization per layer for correctness.
|
||||||
|
Thus, it is possible to incur performance interference and increase the TTFT, especially for smaller prompts.
|
||||||
|
However, for small prompts the total KV-cache size is small and does not need the layer-wise transfer to hide the latency.
|
||||||
|
Since the number of tokens in a batch is already known at the start of computation, Splitwise picks the best technique for KV-cache transfer.
|
||||||
|
It uses serialized KV-cache transfer for smaller prompts and layer-wise transfer and for larger prompts.
|
||||||
|
We show that the overall transfer and interference overheads are relatively small in Section VI-A.
|
||||||
|
|
||||||
|
TABLE V: Evaluated Splitwise designs all normalized to DGX-A100
|
||||||
|
|
||||||
|
### IV-D Provisioning with Splitwise
|
||||||
|
|
||||||
|
We leverage Splitwise to optimize LLM inference cluster deployments for power, cost, and throughput.
|
||||||
|
|
||||||
|
Type of machines.
|
||||||
|
We propose four main variants of Splitwise-based systems:
|
||||||
|
_Splitwise-AA_,
|
||||||
|
_Splitwise-HH_,
|
||||||
|
_Splitwise-HA_,
|
||||||
|
and _Splitwise-HHcap_.
|
||||||
|
The nomenclature is simply drawn from the first letter representing the Prompt machine type, and the second letter representing the Token machine type.
|
||||||
|
“A” represents a DGX-A100 machine, “H” represents a DGX-H100 machine,
|
||||||
|
and “Hcap” represents a power-capped DGX-H100 machine.
|
||||||
|
Table V shows a summary of the cost, power, and hardware in each of our evaluated systems.
|
||||||
|
|
||||||
|
Splitwise-AA uses DGX-A100 for both prompt and token pools, while Splitwise-HH uses DGX-H100 for both.
|
||||||
|
These two variants represent the commonly available setups in providers where machines are homogeneous and interchangeable.
|
||||||
|
|
||||||
|
Splitwise-HA uses DGX-H100 for the prompt pool and DGX-A100 for the token pool.
|
||||||
|
We choose this configuration based on Table IV, and the Insight VII (_i.e._, A100s can be more cost- and power-efficient for the token phase).
|
||||||
|
|
||||||
|
Splitwise-HHcap uses DGX-H100 machines for both prompt and token pools.
|
||||||
|
However, we power cap the token machines down to 70% of their rated power, with each GPU capped by 50% of the power.
|
||||||
|
We propose this design based on Figure 9 and Insight VII (_i.e._, the prompts phase is impacted by power caps while token has no performance impact with 50% lower power cap per GPU).
|
||||||
|
|
||||||
|
Number of machines.
|
||||||
|
The LLM inference cluster deployment must be sized with the appropriate number of prompt and token machines.
|
||||||
|
Our methodology involves searching the design space using our event-driven cluster simulator, which is described in detail in Section V.
|
||||||
|
We need to provide as input:
|
||||||
|
(1) the target cluster design (_e.g._, Splitwise-HA or Splitwise-HHcap),
|
||||||
|
(2) an LLM-specific performance model that can estimate the TTFT and TBT at various input, output, and batch sizes,
|
||||||
|
(3) a short trace derived from the target prompt and token size distributions for the service (_e.g._, Figure 3),
|
||||||
|
(4) the SLOs (_e.g._, Table VI),
|
||||||
|
(5) the constraints (_e.g._, throughput),
|
||||||
|
and (6) the optimization goal (_e.g._, minimize cost).
|
||||||
|
Using this information, our provisioning framework searches the space for the desired optimal point.
|
||||||
|
For example, searching with a throughput constraint and a cost minimization goal gives us iso-throughput cost-optimized clusters across different designs.
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
Figure 12: Design space for provisioning a Splitwise-HH cluster.
|
||||||
|
Cluster configurations targets a peak throughput of 70 RPS.
|
||||||
|
The cost-optimal Splitwise-HH configuration is marked with ⋆⋆⋆ (27 prompt and 3 token machines).
|
||||||
|
|
||||||
|
Search space.
|
||||||
|
Figure 12 shows an example of the two-dimensional search space for the number of prompt and token machines under Splitwise-HH for the coding workload (using a 2-minute trace).
|
||||||
|
The simulator outputs the various percentiles for TTFT, TBT, and E2E latencies.
|
||||||
|
Then, we select the clusters that meet the SLOs for each of these metrics and optimize our target function.
|
||||||
|
For example, Figure 12 shows a ⋆⋆⋆ for the setup with 27 prompt and 3 token machines with the lowest cost that achieves 70 RPS.
|
||||||
|
We call this setup _iso-throughput cost-optimized_.
|
||||||
|
|
||||||
|
Optimization.
|
||||||
|
We can use three optimization goals:
|
||||||
|
_throughput_, _cost_, and _power_.
|
||||||
|
Throughput optimization is important for both, the cloud service provider (CSP) and the user.
|
||||||
|
Cost optimization has different importance levels to the CSP and the user.
|
||||||
|
For the CSP, a higher cost for the same throughput might be acceptable if there are gains in power and space requirements for the cluster.
|
||||||
|
However, for the end-user, a higher cost at the same throughput is generally unacceptable.
|
||||||
|
Finally, power optimization is attractive for a CSP, since it enables more GPUs to be deployed in the same datacenter [62, 63], but it may not be as important to the user.
|
||||||
|
We only consider the provisioned power, and not the dynamic power utilization, in our study.
|
||||||
|
|
||||||
|
### IV-E Practical Considerations
|
||||||
|
|
||||||
|
Accuracy impact.
|
||||||
|
Splitwise does not impact accuracy since it uses lossless KV-cache transfer and does not add any randomization.
|
||||||
|
It executes inference with the same parameters and state as on a single machine.
|
||||||
|
|
||||||
|
Scalability.
|
||||||
|
Since LLM requests are much longer than typical ML requests [37, 38], they incur lower scheduling overhead for similar cluster sizes.
|
||||||
|
However, the CLS may become a scalability bottleneck for large clusters.
|
||||||
|
Insights from prior work on partitioned or replicated scheduling could help improve scalability [61, 27, 72] and are orthogonal to Splitwise.
|
||||||
|
|
||||||
|
Reliability and fault tolerance.
|
||||||
|
If the prompt or the token machine fail, Splitwise simply restarts requests from scratch, similar to today’s LLM serving systems [51, 44].
|
||||||
|
Alternatively, Splitwise could checkpoint the KV-cache generated after prompt computation into an in-memory database.
|
||||||
|
To recover, Splitwise can use this cache to skip prompt recomputation, and start right away with the token phase.
|
||||||
|
The KV-cache could also be checkpointed periodically during the token phase.
|
||||||
|
Designing safe and efficient failure recovery is out of scope for our paper.
|
||||||
|
|
||||||
|
## V Methodology
|
||||||
|
|
||||||
|
### V-A Experimental setup
|
||||||
|
|
||||||
|
To evaluate our proposal on real hardware, we implement Splitwise’s KV-cache transfer mechanism on top of vLLM [51]. Our implementation is open source [1].
|
||||||
|
We run this modified vLLM on two DGX-A100 and two DGX-H10 virtual machines (VMs) on Microsoft Azure with specifications from Table I.
|
||||||
|
These are the VMs used to collect the characterization data in Section III.
|
||||||
|
These machines are connected with InfiniBand and the DGX-H100s have double the bandwidth (_i.e._, 400 Gbps).
|
||||||
|
|
||||||
|
Since vanilla vLLM only supports continuous batching with token preemption which can lead to much higher TBT, we implement state-of-the-art mixed continuous batching [81] as discussed earlier in Figure 2(c).
|
||||||
|
|
||||||
|
Our implementation of the Splitwise technique assigns machines either a prompt role, or a token role.
|
||||||
|
As the prompt machine generates the first token, it transfers the KV-cache to the token machine using the technique described in Section IV-C.
|
||||||
|
We use MSCCL++ [11], an optimized GPU-driven communication library, to implement the naive and layer-wise KV cache transfers.
|
||||||
|
|
||||||
|
In our implementation, the prompt machine uses the zero-copy one-sided put primitive of MSCCL++ to send KV-cache data over InfiniBand as soon as it is ready, without requiring the token machine to issue any receive instructions.
|
||||||
|
Once we have issued a put for all layers, the prompt machine signals a semaphore that the token machine waits on.
|
||||||
|
The synchronization done with the help of semaphores uses the same InfiniBand connection used to send KV-cache data.
|
||||||
|
When processing a batch of prompts, each request is assigned a different semaphore since it may be routed to different token machines.
|
||||||
|
We ship the KV-caches block-by-block in vLLM.
|
||||||
|
To minimize the number of transfers, we also consider the contiguity of KV blocks as long as they use the same semaphore.
|
||||||
|
|
||||||
|
### V-B Simulator setup
|
||||||
|
|
||||||
|
We build a simulator to explore cluster designs and evaluate Splitwise at scale.
|
||||||
|
The simulator code is open source [20].
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
Figure 13: Overview of the design of the Splitwise simulator.
|
||||||
|
|
||||||
|
Figure 13 shows the design of our simulator.
|
||||||
|
The simulator is event-driven and faithfully models the Splitwise machine pools, schedulers, machine-level memory and queues, and KV-cache transfer.
|
||||||
|
We first profile the LLM on the target hardware with various input/output sizes .
|
||||||
|
Based on the characterization profiles, we build a performance model.
|
||||||
|
The simulator takes as input the request traces, SLOs, the performance model, and the configurations for cluster and scheduler .
|
||||||
|
For our evaluation, we use the prompt and token size distributions from the production traces in Section III.
|
||||||
|
We tune the Poisson arrival rate to increase and decrease the load (requests per second) for cluster sizing.
|
||||||
|
The simulator provides the achieved metrics per request (TTFT, TBT, E2E), and the machine utilization levels .
|
||||||
|
We cross-validated the performance model with hardware experiments to ensure accuracy; we also validated the simulator end-to-end using production load with over 50K iterations to ensure fidelity .
|
||||||
|
|
||||||
|
Performance model.
|
||||||
|
We build a piece-wise linear performance model using performance profiles at various batch sizes, input sizes, output sizes, in the required parallelism configuration on A100 and H100 machines from Section III.
|
||||||
|
We validate that our performance model has high accuracy; it incurs a mean absolute percentage error (MAPE) of less than 3% when evaluated with a 80:20 train:test dataset split.
|
||||||
|
|
||||||
|
Communication model.
|
||||||
|
In our evaluation, KV-cache transfers cause inter-machine communication, whereas tensor parallelism only causes intra-machine communication.
|
||||||
|
We model inter-machine communication overheads by benchmarking our KV-cache transfer implementation over Infiniband in Section VI-A.
|
||||||
|
|
||||||
|
SLOs.
|
||||||
|
To determine the maximum throughput that can be supported by a given cluster design, we use P50, P90, and P99 SLOs for TTFT, TBT, and E2E latency metrics.
|
||||||
|
Table VI shows our SLO definition using DGX-A100 as a reference.
|
||||||
|
We require all nine SLOs to be met.
|
||||||
|
SLOs on TTFT are slightly looser, since it has a much smaller impact on the E2E latency.
|
||||||
|
|
||||||
|
TABLE VI: SLO expressed as slowdown compared to a request running on DGX-A100 under no contention.
|
||||||
|
|
||||||
|
Baselines.
|
||||||
|
We compare our Splitwise designs against Baseline-A100 and Baseline-H100.
|
||||||
|
The clusters in these baselines consist of just DGX-A100s and DGX-H100s, respectively.
|
||||||
|
Both baselines use the same mixed continuous batching that Splitwise uses for mixed pool machines (described in Section IV-A).
|
||||||
|
|
||||||
|
## VI Evaluation
|
||||||
|
|
||||||
|
### VI-A Experimental results
|
||||||
|
|
||||||
|
KV-cache transfer latency.
|
||||||
|
We first measure the latency to transfer the KV-cache as the prompt size grows.
|
||||||
|
Figure 14 shows the visible transfer latency on both A100 and H100 setups with the naive and optimized transfer design as discussed in Figure 11.
|
||||||
|
Compared to the prompt computation time, the overhead is minimal (<7%7<7\%< 7 %).
|
||||||
|
The time for serialized transfers linearly increases with the prompt size since the size of the KV-cache also increases.
|
||||||
|
The optimized per-layer transfer, on the other hand, hides much of the latency.
|
||||||
|
For these transfers, we see a constant non-overlapped transfer time of around 8ms for the A100 and around 5ms for the H100 setup.
|
||||||
|
The H100 setup has double the bandwidth of the A100 setup (_i.e._, 200 vs 400 Gbps), and the impact of this can be clearly seen with transfers in the H100 setup happening about twice as fast as those in the A100 setup.
|
||||||
|
|
||||||
|
As discussed in Section IV-C, for small prompt sizes (<512absent512<512< 512 in H100), Splitwise uses the serialized KV-cache transfer and for larger prompts, it uses per-layer transfers.
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
Figure 14: Overhead of the KV-cache transfer as the prompt size increases on A100s and H100s.
|
||||||
|
|
||||||
|
End-to-end impact.
|
||||||
|
Next, we run the coding trace on the 2-machine Splitwise setups without batching, and compare the observed latency metrics to a 1-machine baseline setup with no batching.
|
||||||
|
Figure 15 shows our results.
|
||||||
|
The latency impact of serially transferring the KV-cache grows up to 3% of the E2E with large prompts.
|
||||||
|
However, Splitwise only incurs 0.8% of E2E.
|
||||||
|
In a user-facing inference, the only visible impact of KV-cache transfer overhead is the latency for the second token.
|
||||||
|
Splitwise adds a 16.5% latency to the second token, as compared to the 64% overhead from a serialized transfer.
|
||||||
|
Overall, the transfer impact in Splitwise is hardly perceivable even in a user-facing inference.
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
Figure 15: Overhead of KV cache transfer on TTFT, E2E latency for coding trace for A100 and H100.
|
||||||
|
|
||||||
|
### VI-B Iso-power throughput-optimized clusters
|
||||||
|
|
||||||
|
Cluster provisioning.
|
||||||
|
We provision clusters using the methodology described in Section IV-D.
|
||||||
|
We target a specific workload (_e.g._, conversation) at a peak load with the same power (_i.e._, iso-power) for each cluster design.
|
||||||
|
For the baseline, we use the power for 40 DGX-H100 machines as our target peak power.
|
||||||
|
For the A100 baseline, we can fit 70 DGX-A100 machines under the same power budget.
|
||||||
|
We denote these two designs as 40P/T and 70P/T respectively, since they both use mixed batching in all machines.
|
||||||
|
|
||||||
|
For Splitwise cluster designs under the coding trace, Splitwise-AA provisions 55 prompt machines and 15 for the token pool, denoted as (55P, 15P).
|
||||||
|
Note that like Baseline-A100, Splitwise-AA also provisions 75% more machines than Baseline-H100.
|
||||||
|
The legends in Figure 16 show the different provisioning choices under coding and conversation workloads.
|
||||||
|
Request size distributions reflect in the machine pool sizing.
|
||||||
|
For example, we provision
|
||||||
|
|
||||||
|
[18].
|
||||||
|
However, in the future, services may have enough GPU capacity to cache the context and avoid recomputation.
|
||||||
|
This could sway the memory utilization pattern of the prompt phase from our characterization.
|
||||||
|
Furthermore, it may require transferring the KV-cache back to a prompt machine to be ready for the next conversation request.
|
||||||
|
|
||||||
|
## VIII Related Work
|
||||||
|
|
||||||
|
Heterogeneous scheduling and dataflow systems.
|
||||||
|
Prior work has studied heterogeneous scheduling for a variety of interactive services [83, 65, 68].
|
||||||
|
These works exploit hardware heterogeneity to strike a balance between different objectives such as cost, energy, and performance.
|
||||||
|
However, they run the entire workload on the same machine.
|
||||||
|
Research on heterogeneous multiprocessor CPU scheduling attempts to match workload heterogeneity to hardware heterogeneity [40, 76, 41, 50, 80, 29].
|
||||||
|
These works use profiling or online monitoring with metrics like request length or hardware performance counters to identify workload phases and allocate them appropriately on heterogeneous processors.
|
||||||
|
However, they do not consider the complexities with batching.
|
||||||
|
Distributed dataflow systems orchestrate large-scale computational graphs and aim to provide general-purpose programmability [34, 46, 75, 82].
|
||||||
|
LLM inference under Splitwise can be viewed as a static computational graph with two stages, so it could be implemented using distributed frameworks that provide efficient GPU abstractions [59].
|
||||||
|
Splitwise differs from these works since it uses a spe
|
||||||
@@ -0,0 +1,93 @@
|
|||||||
|
# 📊 文章摘要:Splitwise: Efficient Generative LLM Inference Using Phase Splitting
|
||||||
|
|
||||||
|
> **原文**:[2023-11-30_Splitwise.md](./2023-11-30_Splitwise.md)
|
||||||
|
> **原文链接**:https://arxiv.org/abs/2311.18677
|
||||||
|
> **来源**:arXiv
|
||||||
|
> **作者**:Pratyush Patel, Esha Choukse, Chaojie Zhang, Aashaka Shah, Íñigo Goiri, Saeed Maleki, Ricardo Bianchini(华盛顿大学、微软)
|
||||||
|
> **发布日期**:2023-11-30
|
||||||
|
> **摘要日期**:2026-08-06
|
||||||
|
> **价值评级**:⭐⭐⭐ 高
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 核心命题
|
||||||
|
|
||||||
|
> **相位拆分** — LLM 推理的两阶段(计算密集的 prompt 处理、内存密集的 token 生成)对硬件的需求截然不同,把它们拆分到各自合适的机器(含异构、降配硬件),是突破"GPU 算力与内存带宽增长失衡"约束的成本与功耗优化路径。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 文章概要
|
||||||
|
|
||||||
|
本文用生产 trace 对 A100/H100 上的 LLM 推理做表征分析,发现同一请求的两个阶段特性对立:prompt 计算阶段吃算力(FLOPs),token 生成阶段受内存带宽与容量约束、即使最优批处理也浪费算力。由此提出 Splitwise:把两阶段拆分到不同机器,用层级异步传输把 KV cache 的迁移开销与 prompt 计算重叠(小 prompt 走串行传输),并利用生产 trace + 事件驱动模拟器探索同构/异构集群设计(AA、HH、HA、HHcap 四类)。相比现有集群,Splitwise 可在成本降低 20% 的同时提升 1.4× 吞吐,或在同等成本与功耗预算下提供 2.35× 吞吐。局限:KV cache 传输是固有开销、依赖数据中心高速互连(InfiniBand/NVLink),集中式调度器在超大集群下可能成为扩展性瓶颈。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 关键要点
|
||||||
|
|
||||||
|
1. **硬件失衡是动因** — H100 相对 A100 算力提升 3.43×、功耗提升 1.75×,但内存带宽仅增长 1.6×、容量零增长;最新 GPU 的算力优势在内存密集的 token 生成阶段被浪费。`[分类: 共识]`
|
||||||
|
2. **两阶段资源画像对立** — prompt 阶段计算密集、受 FLOPs 约束;token 生成阶段内存带宽/容量受限,即使 state-of-the-art 批处理也显著低效利用算力,可降配硬件运行。`[分类: 范式突破]`
|
||||||
|
3. **拆分而非解耦竞争** — 与 DistServe 同期提出阶段拆分思路,但出发点不同:DistServe 追求 goodput/SLO,Splitwise 强调异构硬件选型与成本/功耗优化(Perf/$ 与 Perf/W)。`[分类: 共识]`
|
||||||
|
4. **KV cache 传输的工程化优化** — 逐层异步传输与 prompt 计算重叠,使 E2E 延迟影响仅 0.8%(串行传输为 3%);第二 token 延迟增加 16.5%(串行方案 64%),用户几乎无感知;传输总开销 <7% 的 prompt 计算时间。`[分类: 范式突破]`
|
||||||
|
5. **异构集群设计矩阵** — 四种设计:AA(A100 全同构)、HH(H100 全同构)、HA(H100 跑 prompt + A100 跑 token,token 阶段 A100 更划算)、HHcap(H100 双池但 token 机功耗上限 70%、单 GPU 限 50% 功耗——token 阶段对功耗限制不敏感)。`[分类: 范式突破]`
|
||||||
|
6. **量化收益** — 同等功耗预算下:40 台 H100 baseline 被 55 prompt + 15 token 的 Splitwise-AA 方案超越;相比现有集群吞吐提升 1.4× 且成本降 20%,同成本同功耗下吞吐可达 2.35×。`[分类: 共识]`
|
||||||
|
7. **模拟驱动的集群供给** — 事件驱动模拟器 + 分段线性性能模型(MAPE < 3%,与真实硬件实验交叉验证,端到端 5 万+ 迭代验证),在 TTFT/TBT/E2E 九个 SLO 约束下搜索异构机群配比(如 70 RPS 目标的成本最优配置为 27 prompt + 3 token 机器)。`[分类: 未探索]`
|
||||||
|
8. **可靠性以重启为代价** — 节点故障时从头重启请求;论文提出可将 KV cache 检查点化到内存数据库以跳过 prompt 重算,但安全高效的故障恢复留作未来工作。`[分类: 未探索]`
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 批判性分析
|
||||||
|
|
||||||
|
### 假设前提
|
||||||
|
|
||||||
|
- GPU 集群存在(或未来将出现)供异构部署的多种机型,且异构机型间的价格/功耗/可用性差异足以驱动拆分决策。
|
||||||
|
- 数据中心普遍具备高速后端互连(InfiniBand 等),KV cache 跨机传输可被有效隐藏。
|
||||||
|
- token 生成阶段使用上一代或降配硬件不影响 SLO 达标(对交互式负载尤其依赖此假设)。
|
||||||
|
- 生产请求的 prompt/token 长度分布可表征,且集群按峰值负载供给(论文只考虑供给功耗而非动态功耗)。
|
||||||
|
|
||||||
|
### 论据与逻辑
|
||||||
|
|
||||||
|
- 论据扎实:表征数据来自真实硬件(Azure 上的 DGX-A100/H100)+ 生产 trace;KV cache 传输开销有端到端实测(0.8% E2E、16.5% 第二 token);模拟器性能模型 MAPE <3% 且经 5 万+ 迭代端到端验证,结论的量化支撑较强。
|
||||||
|
- 逻辑链条完整:硬件失衡观测 → 阶段资源画像差异 → 拆分设计 → 传输优化 → 异构供给搜索 → 收益量化。
|
||||||
|
- 弱点:1.4×/2.35× 等收益来自模拟器而非全系统真实部署;"第二 token 延迟"这类交互体验指标的受众感知评估主观;对大规模集群下集中式调度器(CLS)瓶颈仅以"正交于 Splitwise"带过,未量化。
|
||||||
|
|
||||||
|
### 边界与局限
|
||||||
|
|
||||||
|
- 结论适用于两阶段分离收益大于传输开销的场景:batch 处理类任务(摘要等)收益最大,交互式任务受第二 token 延迟影响。
|
||||||
|
- 前提是高速互连数据中心;无 InfiniBand/NVLink 级带宽的环境下拆分收益会显著缩水。
|
||||||
|
- 未来若 GPU 缓存技术(如长上下文缓存避免重算)改变 prompt 阶段的内存画像,表征结论可能失效(论文自身也承认此点)。
|
||||||
|
- 容错、调度器扩展性、动态功耗等生产关键问题未解决。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 可引用金句
|
||||||
|
|
||||||
|
> "Unlike prompt computation, token generation does not need the compute capability of the latest GPUs and can be run with lower power and cost."
|
||||||
|
> (与 prompt 计算不同,token 生成并不需要最新 GPU 的计算能力,可以用更低的功耗与成本运行。)
|
||||||
|
|
||||||
|
> "Running both phases on the same machine often leads to inconsistent end-to-end latencies due to the arbitrary batching of prompt and token phases."
|
||||||
|
> (在同一台机器上运行两个阶段,常因 prompt 与 token 阶段的随意混合批处理而导致端到端延迟不稳定。)
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 总体评价
|
||||||
|
|
||||||
|
**亮点**:
|
||||||
|
- 系统化表征了 LLM 推理两阶段的硬件资源画像差异,数据一手且翔实(A100/H100 实测)
|
||||||
|
- "异构降配 + 功耗上限"的集群设计思路(HA、HHcap)直接把成本/功耗优化落到集群拓扑层面,工程可操作性强
|
||||||
|
- KV cache 逐层异步传输的工程方案精炼,与 Mooncake 的逐层 prefill 形成呼应
|
||||||
|
- 模拟器 + 性能模型方法论严谨(MAPE <3%),可复用于集群供给规划
|
||||||
|
|
||||||
|
**不足**:
|
||||||
|
- 收益数字主要来自模拟器评估,缺大规模真实部署验证
|
||||||
|
- 对调度器扩展性、容错等生产约束讨论偏简略
|
||||||
|
- 未考虑动态功耗、缓存普及对未来硬件画像的影响
|
||||||
|
|
||||||
|
**适用场景**:云厂商推理集群规划者、追求成本/功耗优化的 serving 基础设施团队;研究异构调度与数据中心级 LLM 部署的研究人员。
|
||||||
|
|
||||||
|
**关联建议**:与 DistServe(goodput 视角的阶段解耦)、TetriInfer(混合负载干扰)、Mooncake(生产系统 KVCache 中心化)对照,可形成"解耦 serving"的完整谱系;后续可关注微软相关后续工作与 vLLM 解耦功能的演进。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 配图
|
||||||
|
|
||||||
|

|
||||||
@@ -0,0 +1,276 @@
|
|||||||
|
# Mooncake: A KVCache-centric Disaggregated Architecture for LLM Serving
|
||||||
|
|
||||||
|
> **来源**:arXiv
|
||||||
|
> **作者**:Ruoyu Qin, Zheming Li, Weiran He, Mingxing Zhang, Yongwei Wu, Weimin Zheng, Xinran Xu
|
||||||
|
> **发布日期**:2024-06-24
|
||||||
|
> **原文链接**:https://arxiv.org/abs/2407.00079
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 论文元数据
|
||||||
|
|
||||||
|
- **arXiv ID**:2407.00079
|
||||||
|
- **学科分类**:Distributed, Parallel, and Cluster Computing (cs.DC); Artificial Intelligence (cs.AI); Hardware Architecture (cs.AR)
|
||||||
|
- **作者机构**:月之暗面(Moonshot AI)、清华大学
|
||||||
|
- **提交历史**:v1: 2024-06-24;v2: 2024-07-02;v3: 2024-07-09;v4: 2025-09-03
|
||||||
|
- **DOI**:https://doi.org/10.48550/arXiv.2407.00079
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
11脚注: Ruoyu Qin’s part of work done as an intern at Moonshot AI, contributed equally with Zheming Li.22脚注: Corresponding to zhang_mingxing@mail.tsinghua.edu.cn, xuxinran@moonshot.ai.
|
||||||
|
|
||||||
|
Ruoyu Qin♠♡1 Zheming Li♠1 Weiran He♠
|
||||||
|
|
||||||
|
&Mingxing Zhang♡2 Yongwei Wu♡ Weimin Zheng♡ Xinran Xu♠2
|
||||||
|
|
||||||
|
♠Moonshot AI ♡Tsinghua University
|
||||||
|
|
||||||
|
## 摘要(Abstract)
|
||||||
|
|
||||||
|
Mooncake is the serving platform for Kimi, a leading LLM service provided by Moonshot AI. It features a KVCache-centric disaggregated architecture that separates the prefill and decoding clusters. It also leverages the underutilized CPU, DRAM, and SSD resources of the GPU cluster to implement a disaggregated cache of KVCache. The core of Mooncake is its KVCache-centric scheduler, which balances maximizing overall effective throughput while meeting latency-related Service Level Objectives (SLOs). Unlike traditional studies that assume all requests will be processed, Mooncake faces challenges due to highly overloaded scenarios. To mitigate these, we developed a prediction-based early rejection policy. Experiments show that Mooncake excels in long-context scenarios. Compared to the baseline method, Mooncake can achieve up to a 525% increase in throughput in certain simulated scenarios while adhering to SLOs. Under real workloads, Mooncake’s innovative architecture enables Kimi to handle 75% more requests.
|
||||||
|
|
||||||
|
## 1 引言(Introduction)
|
||||||
|
|
||||||
|
### 1.1 Motivation of Developing Mooncacke
|
||||||
|
|
||||||
|
With the rapid adoption of large language models (LLMs) in various scenarios [1, 2, 3, 4], the workloads for LLM serving have become significantly diversified. These workloads differ in input/output length, frequency and distribution of arrival, and, most importantly, demand different kinds of Service Level Objectives (SLOs). As a Model as a Service (MaaS) provider, one of the primary goals of Kimi [5] is to solve an optimization problem with multiple complex constraints. The optimization goal is to maximize overall effective throughput, which directly impacts revenue, while the constraints reflect varying levels of SLOs. These SLOs typically involve meeting latency-related requirements, mainly the time to first token (TTFT) and the time between tokens (TBT).
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
Figure 1: Mooncake Architecture.
|
||||||
|
|
||||||
|
To achieve this goal, a prerequisite is to make the best use of the various kinds of resources available in the GPU cluster.
|
||||||
|
Specifically, although GPU servers are currently provided as highly integrated nodes (e.g., DGX/HGX supercomputers [6]), it is necessary to decouple and restructure them into several disaggregated resource pools, each optimized for different but collaborative goals. For example, many researchers [7, 8, 9] have suggested separating prefill servers from decoding servers because these two stages of LLM serving have very different computational characteristics, in which the KVCache shifts with requests moving from prefill to decoding servers.
|
||||||
|
|
||||||
|
Building on this idea, we found that the scheduling of KVCache is central to LLM serving scheduling. To improve overall throughput, there are typically two general approaches: 1) reuse KVCache as much as possible to reduce the required computation resources; and 2) maximize the number of tokens in each batch to improve the Model FLOPs Utilization (MFU). However, reusing KVCache from a remote location will prolong the TTFT, and a large batch size will lead to a larger TBT. Thus, the utilization of both these throughput-oriented optimizations may lead to violations of latency-related SLOs.
|
||||||
|
|
||||||
|
According to the above guidelines, we propose a disaggregated design that is centered around KVCache for scheduling and optimization. Figure 1 presents our current KVCache-centric disaggregated architecture for LLM serving, named Mooncake. For each request, the global scheduler (Conductor) needs to select a pair of prefill and decoding instances and schedule the request in the following steps: 1) transfer as much reusable KVCache as possible to the selected prefill instance; 2) complete the prefill stage in chunks/layers and continuously stream the output KVCache to the corresponding decoding instance; 3) load the KVCache and add the request to the continuous batching process at the decoding instance for generating request outputs.
|
||||||
|
|
||||||
|
Although this process seems straightforward, the selection policy is complex due to many restrictions. In the prefill stage, the main objective is to reuse the KVCache as much as possible to avoid redundant computation. However, waiting for KVCache stored on lower-tier storage may violate the TTFT SLO. Additionally, high demand on the KVCache server can lead to network congestion, prolonging the waiting time.
|
||||||
|
Thus Conductor is also responsible for predicting the future usage of KVCache blocks and executing scheduling operations such as swapping and replication accordingly.
|
||||||
|
The hottest blocks should be replicated to multiple nodes to avoid fetching congestion, while the coldest ones should be swapped out to reduce reserving costs.
|
||||||
|
Prefill scheduling is also constrained by the availability of DRAM space in the prefill node, especially when much of the memory is reserved for the global KVCache pool.
|
||||||
|
|
||||||
|
In contrast, the decoding stage has different optimization goals and constraints. The aim is to aggregate as many tokens as possible in a decoding batch to improve MFU.
|
||||||
|
However, this objective is restricted not only by the TBT SLO but also by the total size of the aggregated KVCache that can be contained in the VRAM.
|
||||||
|
|
||||||
|
More importantly, existing research on LLM serving assumes sufficient resources and focuses on improving resource utilization. In contrast, the current GPU/accelerator supply is limited, and many MaaS providers face severe overload problems, especially during peak times. Scheduling in such scenarios presents unique challenges that existing works have not explored. For example, we need to predict future loads and reject certain requests early if there will be no available decoding slots after the prefill stage, to save wasted computation resources.
|
||||||
|
However, a straightforward implementation of such an early reject policy surprisingly leads to fluctuations in the overloads. This has led us to aim at predicting the generation length of specific queries and making overall load predictions in the short-term future to implement a better rejection policy. It is also necessary to classify different request priorities to implement priority-based scheduling.
|
||||||
|
In this paper, we summarize these problems as overload-oriented scheduling and present our preliminary study results.
|
||||||
|
|
||||||
|
### 1.2 Design and Results of Mooncacke
|
||||||
|
|
||||||
|
In the following sections of this paper, we first present an overview of Mooncake’s architecture, including its main components and the typical workflow for processing a request (§3). Then, we describe the main design choices made during its implementation, especially those not covered in current research.
|
||||||
|
|
||||||
|
First, in §5, we discuss how to implement a separate prefill node pool that seamlessly handles the dynamic distribution of context length. We employ a chunked pipeline parallelism (CPP) mechanism to scale the processing of a single request across multiple nodes, which is necessary for reducing the TTFT of long-context inputs. Compared to traditional sequence parallelism (SP) based solutions, CPP reduces network consumption and simplifies the reliance on frequent elastic scaling. This mechanism is further supplemented with layer-wise prefill that enables stream transferring of KVCache to overlap latency.
|
||||||
|
|
||||||
|
Next, in §6, we detail our KVCache-centric request scheduling algorithm, which balances instance loads and user experience as measured by TTFT and TBT SLOs. This includes a heuristic-based automated hot-spot migration scheme that replicates hot KVCache blocks without requiring precise predictions of future KVCache usage. Experimental results show that our cache-aware scheduling can significantly lower TTFT in real-world scenarios. In end-to-end experiments using public datasets, simulated data, and real workloads, Mooncake excels in long-context scenarios. Compared to the baseline method, Mooncake can achieve up to a 525% increase in throughput while meeting SLOs. Under real workloads, Mooncake enables Kimi to handle 75% more requests.
|
||||||
|
|
||||||
|
Finally, unlike existing work on LLM serving that assumes all requests will be processed, Mooncake consistently faces overload due to Kimi’s rapid growth in user requests. Thus, Mooncake’s scheduling involves determining whether to accept or reject incoming requests based on the system load. In §7, we discuss our implementation of a unique early rejection policy that reduces wasted computational resources in overloaded scenarios. We further explore the load fluctuation problem caused by straightforward early rejection and how predicting future load can mitigate this issue.
|
||||||
|
|
||||||
|
Mooncake is currently the primary platform for serving Kimi and has successfully handled exponential workload growth, proving its effectiveness in scaling out to large and highly overloaded workloads. However, many more problems need to be explored, and these future directions are also included in the paper.
|
||||||
|
|
||||||
|
To protect proprietary information and facilitate reproducibility, all the experimental results reported in this paper are based on replayed traces of real workloads, but using a dummy model that follows the same architecture as LLaMA2-70B. The trace includes only the timing of request arrivals, the number of input tokens, and the number of output tokens, the remaped block hash, without any real user content. The trace is open-sourced at https://github.com/kvcache-ai/Mooncake.
|
||||||
|
|
||||||
|
## 2 Preliminary and Problem Definition
|
||||||
|
|
||||||
|
Modern large language models (LLMs) are based on the Transformer architecture, which utilizes attention mechanisms and multilayer perceptrons (MLPs) to process input. Popular Transformer-based models, such as GPT [10] and LLaMA [11], employ a decoder-only structure. Each inference request is logically divided into two stages: the prefill stage and the decoding stage.
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
Figure 2: Normalized throughput and latency of prefill and decoding stages with different sequence lengths or batch sizes for the dummy
|
||||||
|
LLaMA2-70B model.
|
||||||
|
|
||||||
|
In the prefill stage, all input tokens are processed in parallel. This stage generates the first output token while storing intermediate results of computed keys and values, referred to as the KVCache. The decoding stage then uses this KVCache to autoregressively generate new tokens, adding new keys and values from the computation to the KVCache. The ability to process input tokens simultaneously in the prefill stage typically makes it computationally intensive, except for short requests. Since the computational complexity of attention networks scales quadratically with input length while the complexity of MLP scales linearly, computation time in the prefill stage generally increases superlinearly with input length, as shown in the left part of Figure 2.
|
||||||
|
|
||||||
|
In contrast, the decoding stage processes only one token at a time per batch due to the limitation of autoregressive generation. This makes it memory-constrained and causes computation time to increase sublinearly with batch size, as shown in the right part of Figure 2. A widely used optimization in the decoding stage is continuous batching [12, 13]. Before each iteration, the scheduler checks the status of all requests, adding newly arrived requests to the batch’s prefill stage while
|
||||||
|
|
||||||
|
ng contexts, bringing no significant overhead for short context prefill and avoiding frequent dynamic adjustment of node partitioning.
|
||||||
|
This pipeline-based acceleration method has been explored in training systems [24], but to our knowledge, this is the first application in the inference stage, as long context inference has only recently emerged.
|
||||||
|
|
||||||
|
### 5.2 Layer-wise Prefill
|
||||||
|
|
||||||
|
Beyond computational power, the limited size of VRAM is also a precious resource, and we aim to minimize the VRAM occupation by states, primarily the KVCache.
|
||||||
|
Theoretically, if the KVCache size of a request is SS and the processing time is TT, its occupation cost is S∗TS*T.
|
||||||
|
If a request is chunked and the processing of each chunk is inlined with other decoding requests in chunked prefill, TT will increase, leading to a larger occupation cost.
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
Figure 7: Latency of storing KVCache of different request lengths (Layer-wise latency refers to the difference in latency between Layer-wise Prefill and Prefill without storing KVCache).
|
||||||
|
|
||||||
|
Moreover, since prefill is processed layer-by-layer and is computation-bound, it is possible to overlap the transferring and dumping of KVCache with computation, further reducing its occupation cost.
|
||||||
|
In Mooncake, KVCache loading and storing are executed asynchronously via launch and wait operations. Before each layer’s attention computation begins, the model waits for the asynchronous loading of that layer’s KVCache to complete and triggers the next layer’s asynchronous KVCache loading. After the attention calculation is complete, asynchronous storage of that layer’s KVCache is launched. Once all layers’ computations are finished, the process waits for the completion of all asynchronous storage operations. Transfer overlapping allows the prefill instance’s execution time to be roughly equivalent to either the KVCache loading time or the standard prefilling time, depending on the prefix cache proportion relative to the input length. The experimental result of KVCache storing latency, as shown in Figure 7, demonstrates that the layer-wise prefill can effectively reduce the latency for long-context requests.
|
||||||
|
|
||||||
|
The main advantage of this overlap effectiveness is that it enables us to disregard the available VRAM size in prefill scheduling, as long as it can contain a single request.
|
||||||
|
As shown in Figure 1, the scheduling of prefill nodes only considers the KVCache distribution and the available DRAM size.
|
||||||
|
|
||||||
|
In the future, we intend to explore more uses for this free VRAM. For example, OpenAI recently proposed the use of batch APIs [25], which enable users to send asynchronous groups of requests at 50% lower costs, but with only a clear 24-hour turnaround time. This service is ideal for processing jobs that do not require immediate responses. Since there is no stringent TBT for these batch requests, we can inline even the decoding stage of these requests into prefill processing for better MFU, if there is enough VRAM space to hold the corresponding KVCache.
|
||||||
|
|
||||||
|
## 6 以 KV Cache 为中心的调度
|
||||||
|
|
||||||
|
In this section, we mainly discuss how Conductor schedules the requests and KVCache blocks under normal conditions, leaving the discussion on overload scenarios for the next section.
|
||||||
|
|
||||||
|
Algorithm 1 KVCache-centric Scheduling Algorithm
|
||||||
|
|
||||||
|
1:prefill instance pool PP, decoding instance pool DD, request RR, cache block size BB.
|
||||||
|
|
||||||
|
2:the prefill and decoding instances (p,d)(p,d) to process RR.
|
||||||
|
|
||||||
|
3:𝑏𝑙𝑜𝑐𝑘_𝑘𝑒𝑦𝑠←PrefixHash(R.𝑝𝑟𝑜𝑚𝑝𝑡_𝑡𝑜𝑘𝑒𝑛𝑠,B){block\_keys}{PrefixHash}(R.{prompt\_tokens},B)
|
||||||
|
|
||||||
|
4:𝑇𝑇𝐹𝑇←inf{TTFT}
|
||||||
|
|
||||||
|
5:p←∅p
|
||||||
|
|
||||||
|
6:𝑏𝑒𝑠𝑡_𝑝𝑟𝑒𝑓𝑖𝑥_𝑙𝑒𝑛,𝑏𝑒𝑠𝑡_𝑚𝑎𝑡𝑐ℎ𝑒𝑑_𝑖𝑛𝑠𝑡𝑎𝑛𝑐𝑒←FindBestPrefixMatch(P,𝑏𝑙𝑜𝑐𝑘_𝑘𝑒𝑦𝑠){best\_prefix\_len},{best\_matched\_instance}{FindBestPrefixMatch}(P,{block\_keys})
|
||||||
|
|
||||||
|
7:for 𝑖𝑛𝑠𝑡𝑎𝑛𝑐𝑒∈P{instance} P do
|
||||||
|
|
||||||
|
8: 𝑝𝑟𝑒𝑓𝑖𝑥_𝑙𝑒𝑛←𝑖𝑛𝑠𝑡𝑎𝑛𝑐𝑒.𝑝𝑟𝑒𝑓𝑖𝑥_𝑙𝑒𝑛{prefix\_len}{instance.prefix\_len}
|
||||||
|
|
||||||
|
9: T𝑞𝑢𝑒𝑢𝑒←EstimatePrefillQueueTime(𝑖𝑛𝑠𝑡𝑎𝑛𝑐𝑒){T_{queue}}{EstimatePrefillQueueTime}({instance})
|
||||||
|
|
||||||
|
10: if 𝑏𝑒𝑠𝑡_𝑝𝑟𝑒𝑓𝑖𝑥_𝑙𝑒𝑛𝑝𝑟𝑒𝑓𝑖𝑥_𝑙𝑒𝑛<𝐤𝐯𝐜𝐚𝐜𝐡𝐞_𝐛𝐚𝐥𝐚𝐧𝐜𝐢𝐧𝐠_𝐭𝐡𝐫𝐞𝐬𝐡𝐨𝐥𝐝{{best\_prefix\_len}}{{prefix\_len}}<{ kvcache\_balancing\_threshold} then
|
||||||
|
⊳ Cache-aware prefill scheduling
|
||||||
|
|
||||||
|
11: T𝑝𝑟𝑒𝑓𝑖𝑙𝑙←EstimatePrefillExecutionTime(len(R.𝑝𝑟𝑜𝑚𝑝𝑡_𝑡𝑜𝑘𝑒𝑛𝑠),𝑝𝑟𝑒𝑓𝑖𝑥_𝑙𝑒𝑛){T_{prefill}}{EstimatePrefillExecutionTime}({len}(R.{prompt\_tokens}),{prefix\_len})
|
||||||
|
|
||||||
|
12: if 𝑇𝑇𝐹𝑇>T𝑞𝑢𝑒𝑢𝑒+T𝑝𝑟𝑒𝑓𝑖𝑙𝑙{TTFT}>{T_{queue}}+{T_{prefill}} then
|
||||||
|
|
||||||
|
13: 𝑇𝑇𝐹𝑇←T𝑞𝑢𝑒𝑢𝑒+T𝑝𝑟𝑒𝑓𝑖𝑙𝑙{TTFT}{T_{queue}}+{T_{prefill}}
|
||||||
|
|
||||||
|
14: p←𝑖𝑛𝑠𝑡𝑎𝑛𝑐𝑒p{instance}
|
||||||
|
|
||||||
|
15: end if
|
||||||
|
|
||||||
|
16: else⊳ Cache-aware and -balancing prefill scheduling
|
||||||
|
|
||||||
|
17: 𝑡𝑟𝑎𝑛𝑠𝑓𝑒𝑟_𝑙𝑒𝑛←𝑏𝑒𝑠𝑡_𝑝𝑟𝑒𝑓𝑖𝑥_𝑙𝑒𝑛−𝑝𝑟𝑒𝑓𝑖𝑥_𝑙𝑒𝑛{transfer\_len}{best\_prefix\_len}-{prefix\_len}
|
||||||
|
|
||||||
|
18: T𝑡𝑟𝑎𝑛𝑠𝑓𝑒𝑟←EstimateKVCacheTransferTime(𝑖𝑛𝑠𝑡𝑎𝑛𝑐𝑒,𝑏𝑒𝑠𝑡_𝑚𝑎𝑡𝑐ℎ𝑒𝑑_𝑖𝑛𝑠𝑡𝑎𝑛𝑐𝑒,𝑡𝑟𝑎𝑛𝑠𝑓𝑒𝑟_𝑙𝑒𝑛){T_{transfer}}{EstimateKVCacheTransferTime}({instance},{best\_matched\_instance},{transfer\_len})
|
||||||
|
|
||||||
|
19: T𝑝𝑟𝑒𝑓𝑖𝑙𝑙←EstimatePrefillExecutionTime(len(R.𝑝𝑟𝑜𝑚𝑝𝑡_𝑡𝑜𝑘𝑒𝑛𝑠),𝑏𝑒𝑠𝑡_𝑝𝑟𝑒𝑓𝑖𝑥_𝑙𝑒𝑛){T_{prefill}}{EstimatePrefillExecutionTime}({len}(R.{prompt\_tokens}),{best\_prefix\_len})
|
||||||
|
|
||||||
|
20: if 𝑇𝑇𝐹𝑇>T𝑡𝑟𝑎𝑛𝑠𝑓𝑒𝑟+T𝑞𝑢𝑒𝑢𝑒+T𝑝𝑟𝑒𝑓𝑖𝑙𝑙{TTFT}>{T_{transfer}}+{T_{queue}}+{T_{prefill}} then
|
||||||
|
|
||||||
|
21: 𝑇𝑇𝐹𝑇←T𝑡𝑟𝑎𝑛𝑠𝑓𝑒𝑟+T𝑞𝑢𝑒𝑢𝑒+T𝑝𝑟𝑒𝑓𝑖𝑙𝑙{TTFT}{T_{transfer}}+{T_{queue}}+{T_{prefill}}
|
||||||
|
|
||||||
|
22: p←𝑖𝑛𝑠𝑡𝑎𝑛𝑐𝑒p{instance}
|
||||||
|
|
||||||
|
23: end if
|
||||||
|
|
||||||
|
24: end if
|
||||||
|
|
||||||
|
25:end for
|
||||||
|
|
||||||
|
26:d,𝑇𝐵𝑇←SelectDecodingInstance(D)d,{TBT}{SelectDecodingInstance}(D)
|
||||||
|
⊳ Load-balancing decoding scheduling
|
||||||
|
|
||||||
|
27:if 𝑇𝑇𝐹𝑇>𝑇𝑇𝐹𝑇_𝑆𝐿𝑂{TTFT}>{TTFT\_SLO} or 𝑇𝐵𝑇>𝑇𝐵𝑇_𝑆𝐿𝑂{TBT}>{TBT\_SLO} then
|
||||||
|
|
||||||
|
28: reject RR; return
|
||||||
|
|
||||||
|
29:end if
|
||||||
|
|
||||||
|
30:if 𝑏𝑒𝑠𝑡_𝑝𝑟𝑒𝑓𝑖𝑥_𝑙𝑒𝑛p.𝑝𝑟𝑒𝑓𝑖𝑥_𝑙𝑒𝑛>𝐤𝐯𝐜𝐚𝐜𝐡𝐞_𝐛𝐚𝐥𝐚𝐧𝐜𝐢𝐧𝐠_𝐭𝐡𝐫𝐞𝐬𝐡𝐨𝐥𝐝{{best\_prefix\_len}}{p.{prefix\_len}}>{ kvcache\_balancing\_threshold} then
|
||||||
|
|
||||||
|
31: TransferKVCache(𝑏𝑒𝑠𝑡_𝑚𝑎𝑡𝑐ℎ𝑒𝑑_𝑖𝑛𝑠𝑡𝑎𝑛𝑐𝑒,p){TransferKVCache}({best\_matched\_instance},p)
|
||||||
|
⊳ KVCache hot-spot migration
|
||||||
|
|
||||||
|
32:end if
|
||||||
|
|
||||||
|
33:return (p,d)(p,d)
|
||||||
|
|
||||||
|
### 6.1 Prefill Global Scheduling
|
||||||
|
|
||||||
|
Previous research on LLM servi
|
||||||
|
|
||||||
|
ng typically uses a load-balancing strategy that evaluates the load on each instance based on the number of assigned requests. In Mooncake, however, the selection of prefill instances considers additional factors—not just load but also the prefix cache hit length and the distribution of reusable KVCache blocks. While there is a preference to route requests to prefill instances with longer prefix cache lengths to reduce computation costs, it may be beneficial to schedule them to other nodes to ensure overall system balance and meet TTFT SLOs. To address these complexities, we propose a cache-aware global scheduling algorithm that accounts for both the prefill time due to the prefix cache and the queuing time associated with the load on the instance.
|
||||||
|
|
||||||
|
Algorithm 1 details the mechanism for our cache-aware prefill scheduling. For every new request, its input tokens are divided into several blocks, and a hash key is computed for each block. This involves generating a hash key of tokens in a block concatenated with the hash key of the previous block (if available). The request’s block keys are then compared one by one against each prefill instance’s cache keys to identify the prefix match length (prefix_lenprefix\_len). Similar reuse logic is already implemented in vLLM, but the open-source version of vLLM only supports local KVCache caching.
|
||||||
|
|
||||||
|
With this matching information, Conductor estimates the corresponding execution time based on the request length and prefix_lenprefix\_len (which varies by instance). It then adds the estimated waiting time for that request to get the TTFT on that instance. Finally, Conductor assigns the request to the instance with the shortest TTFT and updates the cache and queue times for that instance accordingly. If the SLO is not achievable, Conductor directly returns the HTTP 429 Too Many Requests response status code to the upper layers.
|
||||||
|
|
||||||
|
The backbone of this scheduling framework is straightforward, but complexities are hidden in the engineering implementation of various components. For example, to predict the computation time of the prefill stage for a request, we employ a predictive model derived from offline test data. This model estimates the prefill duration based on the request’s length and prefix cache hit length. Thanks to the regular computation pattern of Transformers, the error bound of this prediction is small as long as enough offline data is available. The queuing time for a request is calculated by aggregating the prefill times of all queued requests. In practical implementations, TTFTs are computed in parallel, rendering the processing time negligible compared to the inference time.
|
||||||
|
|
||||||
|
More difficulty lies in predicting the transfer time because it is determined not only by the size of the transferred data but also by the current network status, especially whether the sending node is under congestion. This also necessitates the replication of hot KVCache blocks, which will be discussed in the next section.
|
||||||
|
|
||||||
|
### 6.2 Cache Load Balancing
|
||||||
|
|
||||||
|
In our Mooncake cluster, each prefill machine manages its own set of local prefix caches. The usage frequency of these caches varies significantly. For example, system prompts are accessed by almost every request, whereas caches storing content from a local long document may be used by only one user. As discussed in §6.1, Conductor’s role is crucial in achieving an optimal balance between cache matching and instance load. Thus, from the perspective of the distributed cache system, load balancing also plays an important role. Specifically, it involves strategizing on how to back up caches to ensure that global prefill scheduling can achieve both high cache hits and low load.
|
||||||
|
|
||||||
|
A straw-man solution to this KVCache scheduling problem could be collecting the global usages of each block, using a prediction model to forecast their future usages, and making scheduling decisions accordingly. However, unlike the estimation of prefill time, workloads are highly dynamic and change significantly over time. Especially for a MaaS provider experiencing rapid growth in its user base, it is impossible to accurately predict future usage. Thus, we propose a heuristic-based automated hot-spot migration scheme to enhance cache load balancing.
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
Figure 8: The prefill scheduling experiment in the Mooncake cluster.
|
||||||
|
|
||||||
|
As previously noted, requests may not always be directed to the prefill instance with the longest prefix cache length due to high instance load. In such cases, the conductor forwards the cache’s location and the request to an alternative instance if the estimated additional prefill time is shorter than the transfer time. This instance proactively retrieves the KVCache from the holder and stores it locally. More importantly, we prefer to compute the input tokens if the best remote prefix match length is no larger than the current local reusable prefix multiplied by a threshold111This threshold is currently adjusted manually, but can be adaptively adjusted by an algorithm in the future. Both strategies not only reduce the prefill time for requests but also facilitate the automatic replication of hot-spot caches, allowing for their broader distribution across multiple machines.
|
||||||
|
|
||||||
|
To validate the effectiveness of our strategy, we conducted a scheduling experiment that compares random scheduling and load-balancing scheduling with our strategy. We further compare the cache-aware scheduling described in §6.1 and the KVCache-centric scheduling described in this section that considers cache load balancing. In random scheduling, a prefill instance is selected arbitrarily for each request. In load-balancing scheduling, the instance with the lightest load is chosen. To evaluate, we built a Mooncake cluster consisting of 8 prefill instances and 8 decoding instances, using idle machines overnight, and replayed 23,000 real-world requests for the experiment. We assessed the performance of each scheduling algorithm using the average TTFT and the TTFT SLO attainment rate. The experimental results, depicted in Figure 8, demonstrate that both the cache-aware strategy and the cache load balancing strategy significantly reduce the TTFT of requests. Our KVCache-centric scheduling algorithm outperforms both random and load-balancing scheduling across both metrics. More experiment results can be found in §8.
|
||||||
|
|
||||||
|
## 7 面向过载的调度
|
||||||
|
|
||||||
|
Most existing work on LLM serving assumes that all requests will be processed, optimizing the throughput or the TTFT and TBT of requests accordingly. However, in real scenarios, processing every incoming request is neither economical nor realistic. For commercial inference services facing rapidly increasing volumes of user requests, the growth rate of the cluster’s inference resources is far slower than the increase in incoming requests. As a result, overload is a common issue in current LLM serving, especially during peak times.
|
||||||
|
|
||||||
|
To balance costs and user experience, the system should process as many requests as possible until the system load reaches a predefined threshold. After this point, remaining requests will be either directly rejected or deferred for later retry. Mooncake, implemented as a disaggregated inference system, allows for more flexible scheduling strategies but also confronts unique scheduling challenges not present in non-disaggregated systems and not mentioned in previous works[7, 8, 9].
|
||||||
|
|
||||||
|
In this section, we describe an early rejection policy designed specifically for a disaggregated architecture and address the load fluctuation caused by this approach. We then explore how predicting the generation length is necessary to mitigate these problems.
|
||||||
|
|
||||||
|
### 7.1 Scheduling in Overload Scenarios
|
||||||
|
|
||||||
|
In scenarios where system overload occurs, scheduling involves determining whether to accept or reject incoming requests based on the system load. A critical aspect of this process is defining what constitutes the “system load”, as this definition influences the threshold at which requests are rejected. In conventional coupled systems, the prediction of TTFT and TBT can be complicated by interference between the prefill and decoding stages. Therefore, the load is often measured simply by the ratio of the number of requests being processed to the system’s maximum capacity.
|
||||||
|
|
||||||
|
In contrast, Mooncake, with its disaggregated architecture, processes the prefill and decoding stages independently. Thus we use SLO satisfaction as a direct load measurement. Specifically, we define lttftl_{ttft} and ltbtl_{tbt} as the TTFT and TBT SLO constraints for requests, respectively. The load for prefill and decoding instances is then determined by comparing the predicted maximum TTFT and TBT on an instance against lttftl_{ttft} and ltbtl_{tbt}. With these two criteria, Mooncake’s scheduling requires two key decisions: first, whether to accept the prefill stage based on the prefill instance’s load, and second, whether to proceed with the decoding stage depending on the decoding instance’s load.
|
||||||
|
|
||||||
|
### 7.2 Early Rejection
|
||||||
|
|
||||||
|
In practice, the individual load on prefill or decoding instances does not accurately reflect the actual number of requests processed by the system. This discrepancy arises due to a time lag between scheduling prefill and decoding instances for a single request. If a request is rejected by the decoding instance due to high load after the prefill stage has been completed, the computational resources expended during the prefill stage are wasted. Consequently, the actual number of successfully processed requests during prefill is less than that indicated by the load metric.
|
||||||
|
|
||||||
|
To address this issue, it is natural to advance the load assessment of the decoding instance to precede the beginning of the prefill stage. We refer to this strategy as Early Rejection. Upon the arrival of a request, Conductor evaluates whether to accept the request based on the greater load between the prefill and decoding pools. Early Rejection significantly reduces ineffective computations from rejected requests and enhances load balancing.
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
Figure 9: The load of prefill and decoding instances over 20 minutes, before using the prediction-based early rejection.
|
||||||
|
|
||||||
|
### 7.3 Load Fluctuation Caused by Early Rejection
|
||||||
|
|
||||||
|
However, Early Rejection introduces new challenges. Figure 9 shows the observed real-world instance load over a 20-minute period in a cluster of 20 machines after using the Early Rejection strategy. It highlights significant anti-phase fluctuations between prefill and decoding machines. This phenomenon becomes more pronounced in clusters with fewer prefill machines and in scenarios where the prefill stage takes longer.
|
||||||
|
|
||||||
|
Upon further exploration, we found that this load fluctuation problem is rooted in the time lag between predicting the decoding load and its actual execution. Scheduling based on the current decoding load is inherently delayed. This delay causes fluctuations and phase staggering between the loads on prefill and decoding instances, as illustrated in the theoretical example described in Figure 10(a). The green curve represents the load of prefill instances (scaled from 0 to 1), and the yellow curve represents the load of decoding instances.
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
(a) Early Rejection.
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
(b) Early Rejection Based on Prediction.
|
||||||
|
|
||||||
|
Figure 10: Instance load when applying Early Rejection and Early Rejection Based on Prediction.
|
||||||
|
|
||||||
|
In Stage 1, the load on both prefill and decoding instances is low, so Conductor accepts a large number of requests until the load on prefill instances reaches its limit. In Stage 2, requests processed by prefill instances are scheduled to decoding instances, causing the load on decoding instances to be high. Consequently, Conductor rejects incoming requests, leading to a lower load on prefill instances. In Stage 3, no new requests enter the decoding stage, resulting in a decreased load. At this point, Conductor again accepts a large number of requests until the prefill instances are fully loaded. In Stage 4, as the load on decoding instances increases, Conductor rejects requests, causing a low load on prefill instances. This severe fluctuation in load between prefill and decoding instances results in poor resource utilization of the inference cluster.
|
||||||
|
|
||||||
|
### 7.4 Early Rejection Based on Prediction
|
||||||
|
|
||||||
|
To solve the load fluctuation problem, we propose a framework of Early Rejection Based on Prediction to address scheduling challenges in overload scenarios for disaggregated LLM serving systems like Mooncake. As illustrated in Figure 10(b), this framework predicts the decoding load after the prefill stage of incoming requests and uses this prediction to decide whether to accept the requests, which helps mitigate the fluctuation problem. The core component of this strategy is the accurate prediction of the decoding load for the subsequent period. We introduce two approaches for this:
|
||||||
|
|
||||||
|
Request level: Previous work highlights a significant challenge in predicting loads for LLM serving: the unknown output length of each request. If we could determine the output length in advance, it would be possible to estimate the TTFT and TBT much more accurately. This, in turn, would help predict the number of requests a decoding instance can complete and the number of new requests that will be added after a specified time, thereby obtaining the load at that time. However, predicting each request’s output length is challenging due to high costs [9] or low accuracy, especially under overload conditions where resources are scarce and accurate predictions are necessary, making request-level predictions particularly difficult.
|
||||||
|
|
||||||
|
System level: In contrast to request-level predictions, system-level predictions do not attempt to predict the completion time
|
||||||
|
|
||||||
|
e TTFT SLO. However, while approximately 100% of the requests for Mooncake-[10P+10D] satisfy the TBT SLO, only 57% of the requests for vLLM-[20M] meet this criterion, with some requests exhibiting extremely high TBTs. In this experiment, Mooncake can process approximately 75% more requests while adhering to the SLOs.
|
||||||
|
|
||||||
|
### 8.2 Performance in Overload Scenarios
|
||||||
|
|
||||||
|
In this section, we evaluate performance under overload scenarios, focusing on the maximum number of requests the system can handle, as discussed in §7. The baseline strategy, which rejects requests based on load before both stages start, leads to resource wastage by rejecting requests already processed in the prefill stage. In contrast, we propose the Early Rejection and Early Rejection based on Prediction strategies, detailed in §7.2 and §7.4, respectively. These strategies take the system’s load into comprehensive consideration, and hence reduce unnecessary request rejections.
|
||||||
|
|
||||||
|
Specifically, we built a Mooncake cluster with 8 prefill instances and 8 decoding instances and tested it using real traces from 23,000 requests. To simulate overload scenarios, we increased the replay speed to 2x.
|
||||||
|
|
||||||
|
Table 3: Number of requests rejected by the system under the overloaded-scenario experiment.
|
||||||
|
|
||||||
|
Table 3 shows Mooncake’s performance under different strategies. With the baseline strategy, the system rejects 4,183 requests. In contrast, under the Early Rejection and Early Rejection based on Prediction strategies, Mooncake rejects 3,771 and 3,589 requests, respectively. This demonstrates that by rejecting requests early, Mooncake can avoid unnecessary prefill computations, thereby improving the effective utilization of system resources. Furthermore, by predicting the load of decoding instances, Mooncake can mitigate load fluctuations, increasing the request handling capacity.
|
||||||
|
|
||||||
|
## 9 Related Work
|
||||||
|
|
||||||
|
Significant efforts have been dedicated to enhancing the efficiency of LLM serving systems through scheduling, memory management, a
|
||||||
@@ -0,0 +1,92 @@
|
|||||||
|
# 📊 文章摘要:Mooncake: A KVCache-centric Disaggregated Architecture for LLM Serving
|
||||||
|
|
||||||
|
> **原文**:[2024-06-24_Mooncake.md](./2024-06-24_Mooncake.md)
|
||||||
|
> **原文链接**:https://arxiv.org/abs/2407.00079
|
||||||
|
> **来源**:arXiv
|
||||||
|
> **作者**:Ruoyu Qin, Zheming Li, Weiran He, Mingxing Zhang, Yongwei Wu, Weimin Zheng, Xinran Xu(月之暗面 Moonshot AI、清华大学)
|
||||||
|
> **发布日期**:2024-06-24
|
||||||
|
> **摘要日期**:2026-08-06
|
||||||
|
> **价值评级**:⭐⭐⭐ 高
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 核心命题
|
||||||
|
|
||||||
|
> **缓存为中心** — LLM serving 调度的核心不是 GPU 算力而是 KVCache:以缓存复用与分发为中心组织解耦架构,并面向真实过载场景设计预测式早期拒绝,是生产级 MaaS 平台的实践范式。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 文章概要
|
||||||
|
|
||||||
|
Mooncake 是 Kimi 的生产 serving 平台,在 prefill/decoding 集群解耦的基础上,把 GPU 集群中闲置的 CPU、DRAM、SSD 组织成分层 KVCache 池,并以 Conductor 全局调度器为中心做"缓存感知"调度:复用尽可能多的前缀缓存、把热块复制到多节点、冷块换出到低层存储。与主流研究"假设所有请求都会被处理"不同,Mooncake 直面用户爆发式增长带来的过载问题,提出基于预测的早期拒绝策略(Early Rejection Based on Prediction),避免为注定被拒绝的请求浪费 prefill 算力,并缓解简单拒绝策略引起的 prefill/decoding 负载反相波动。模拟场景下相比 baseline 吞吐提升最高 525%(同时满足 SLO),真实负载下让 Kimi 多处理 75% 的请求。局限:实验基于 dummy 模型 + trace 重放,部分阈值靠人工调节,拒绝策略以牺牲低价值请求换取整体效率。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 关键要点
|
||||||
|
|
||||||
|
1. **KVCache 是调度的中心矛盾** — 提升吞吐的两条路径(复用 KVCache 减少计算、增大 batch 提高 MFU)都会伤及延迟 SLO:远程取缓存拖长 TTFT,大 batch 放大 TBT;调度本质是在缓存复用与 SLO 之间做权衡。`[分类: 范式突破]`
|
||||||
|
2. **分层解耦缓存池** — 利用 GPU 集群未充分利用的 CPU/DRAM/SSD 构建 KVCache 的分层存储与分发网络,让冷热块各得其所(热块复制防拥塞、冷块换出降成本)。`[分类: 未探索]`
|
||||||
|
3. **缓存感知的全局调度** — Conductor 按前缀匹配长度、排队时间、传输时间估算各 prefill 实例的 TTFT,选择最优实例;不满足 SLO 时直接返回 HTTP 429。与仅看负载的调度相比,显著降低平均 TTFT。`[分类: 未探索]`
|
||||||
|
4. **启发式热点迁移替代预测** — 工作负载高度动态、无法准确预测未来缓存使用,因此用"请求偏离最优缓存实例时按需迁移/复制缓存"的启发式方案实现热点块的自动复制,而非预测模型。`[分类: 未探索]`
|
||||||
|
5. **长上下文利器:CPP + 逐层 prefill** — Chunked pipeline parallelism 把单个长请求跨节点流水处理(相对 sequence parallelism 降低网络消耗、简化弹性扩缩);逐层异步加载/存储 KVCache 与计算重叠,使 prefill 实例调度几乎不再受 VRAM 大小约束。`[分类: 范式突破]`
|
||||||
|
6. **面向过载的调度是全新问题域** — 用 SLO 满足度而非请求数/容量比衡量系统负载;把 decode 侧负载评估提前到 prefill 之前(早期拒绝),避免 prefill 算力浪费。`[分类: 范式突破]`
|
||||||
|
7. **预测式早期拒绝抑制负载波动** — 简单早期拒绝会引发 prefill/decode 实例负载反相振荡(20 台机器实测),根因是预测与实际执行的时间差;预测未来 decode 负载可显著平抑波动:过载实验中拒绝请求数从 baseline 的 4183 降到 3771(早期拒绝)与 3589(预测式早期拒绝)。`[分类: 未探索]`
|
||||||
|
8. **生产验证与信息保护的平衡** — 全部实验基于重放真实 trace(仅含到达时间、输入/输出 token 数、块哈希,不含用户内容)+ 与 LLaMA2-70B 同架构的 dummy 模型,兼顾可复现与商业机密保护。`[分类: 争议]`
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 批判性分析
|
||||||
|
|
||||||
|
### 假设前提
|
||||||
|
|
||||||
|
- 大规模 MaaS 提供商的 GPU 集群长期处于过载状态,且资源增长速度远慢于请求增长——拒绝部分请求是合理且必要的商业决策。
|
||||||
|
- 前缀缓存命中是长上下文负载中的常见现象,值得为缓存复用投入全局协调开销。
|
||||||
|
- 集群中存在大量闲置 CPU/DRAM/SSD 资源可供缓存池使用,且 GPU 服务器的集成形态可以重构为解耦资源池。
|
||||||
|
- Transformer 计算模式规则,prefill 执行时间可通过离线数据建模准确预测。
|
||||||
|
|
||||||
|
### 论据与逻辑
|
||||||
|
|
||||||
|
- 论据结构合理:先以 23000 条真实请求在 8+8 实例集群上对比随机/负载均衡/缓存感知/缓存均衡四种调度,证明 KVCache-centric 调度全面占优;再以 20 台机器 20 分钟负载曲线揭示反相波动现象,并给出理论示例与预测方案的改进数据。
|
||||||
|
- 525% 吞吐提升与 75% 请求承载提升均有明确实验来源(模拟场景与真实负载),且文中明确区分两者语境,未混淆。
|
||||||
|
- 弱点:dummy 模型无法完全代表真实模型的 KV cache 分布与内存行为;"up to"表述下的最大提升场景条件不明;阈值(如 kvcache_balancing_threshold)依赖人工调整,可复现性打折。
|
||||||
|
|
||||||
|
### 边界与局限
|
||||||
|
|
||||||
|
- 结论面向"高过载 + 长上下文"的 MaaS 生产场景;负载未饱和、前缀命中率低的场景下,全局缓存协调的收益可能被协调开销抵消。
|
||||||
|
- 拒绝策略会牺牲尾部用户的请求质量(以 429 拒绝),对用户体感与商业口碑的影响论文未量化。
|
||||||
|
- 早期拒绝依赖输出长度预测,而过载条件下请求级长度预测本身困难(论文承认成本高、精度低),系统级预测是妥协方案。
|
||||||
|
- 实验保护商业信息的手段(dummy 模型 + trace 重放)本身限制了结果的真实性边界。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 可引用金句
|
||||||
|
|
||||||
|
> "Unlike traditional studies that assume all requests will be processed, Mooncake faces challenges due to highly overloaded scenarios."
|
||||||
|
> (与传统研究假设所有请求都会被处理不同,Mooncake 面对的是严重过载场景的挑战。)
|
||||||
|
|
||||||
|
> "We found that the scheduling of KVCache is central to LLM serving scheduling."
|
||||||
|
> (我们发现 KVCache 的调度是 LLM serving 调度的核心所在。)
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 总体评价
|
||||||
|
|
||||||
|
**亮点**:
|
||||||
|
- 首个公开的、经受真实爆发式增长验证的"缓存为中心"解耦 serving 架构,工业界一手的工程视角稀缺
|
||||||
|
- 把"过载调度"引入 LLM serving 问题域,早期拒绝与负载波动分析(反相振荡的根因剖析)极具启发性
|
||||||
|
- 缓存感知调度 + 热点迁移 + 逐层 prefill 的组合拳,直接服务长上下文这一当前关键场景
|
||||||
|
|
||||||
|
**不足**:
|
||||||
|
- 实验体系(dummy 模型、trace 重放、人工阈值)的科学严格性弱于学术性较强的对照工作
|
||||||
|
- 关键阈值与工程细节披露有限,可复现性受限
|
||||||
|
- 拒绝策略对用户体感、商业指标的长期影响未讨论
|
||||||
|
|
||||||
|
**适用场景**:LLM serving 系统设计者、MaaS 平台(Kimi 类长上下文助手)基础设施团队;研究过载调度与缓存管理的研究人员。
|
||||||
|
|
||||||
|
**关联建议**:与 DistServe(解耦的 goodput 优化理论框架)、Splitwise(异构硬件部署)、TetriInfer(长度预测调度)对照阅读,可拼出解耦 serving 的全景;后续可关注 Mooncake 开源仓库(github.com/kvcache-ai/Mooncake)的演进与 vLLM 社区对前缀缓存调度的采纳。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 配图
|
||||||
|
|
||||||
|

|
||||||
@@ -0,0 +1,237 @@
|
|||||||
|
# DistServe: Disaggregating Prefill and Decoding for Goodput-optimized Large Language Model Serving
|
||||||
|
|
||||||
|
> **来源**:arXiv
|
||||||
|
> **作者**:Yinmin Zhong, Shengyu Liu, Junda Chen, Jianbo Hu, Yibo Zhu, Xuanzhe Liu, Xin Jin, Hao Zhang
|
||||||
|
> **发布日期**:2024-01-18
|
||||||
|
> **原文链接**:https://arxiv.org/abs/2401.09670
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 论文元数据
|
||||||
|
|
||||||
|
- **arXiv ID**:2401.09670
|
||||||
|
- **学科分类**:Distributed, Parallel, and Cluster Computing (cs.DC); Artificial Intelligence (cs.AI)
|
||||||
|
- **作者机构**:北京大学(School of Computer Science, Peking University)、StepFun、UC San Diego
|
||||||
|
- **提交历史**:v1: 2024-01-18;v2: 2024-03-19;v3: 2024-06-06
|
||||||
|
- **DOI**:https://doi.org/10.48550/arXiv.2401.09670
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
Yinmin Zhong Shengyu Liu Junda Chen Jianbo Hu Yibo Zhu Xuanzhe Liu
|
||||||
|
|
||||||
|
Xin Jin Hao Zhang
|
||||||
|
|
||||||
|
School of Computer Science, Peking University StepFun UC San Diego
|
||||||
|
|
||||||
|
## 摘要(Abstract)
|
||||||
|
|
||||||
|
DistServe improves the performance of large language models (LLMs) serving by disaggregating the prefill and decoding computation. Existing LLM serving systems colocate the two phases and batch the computation of prefill and decoding across all users and requests.
|
||||||
|
We find that this strategy not only leads to strong prefill-decoding interferences but also couples the resource allocation and parallelism plans for both phases. LLM applications often emphasize individual latency for each phase: time to first token (TTFT) for the prefill phase and time per output token (TPOT) of each request for the decoding phase.
|
||||||
|
In the presence of stringent latency requirements, existing systems have to prioritize one latency over the other, or over-provision compute resources to meet both.
|
||||||
|
|
||||||
|
DistServe assigns prefill and decoding computation to different GPUs, hence eliminating prefill-decoding interferences. Given the application’s TTFT and TPOT requirements, DistServe co-optimizes the resource allocation and parallelism strategy _tailored_ for each phase. DistServe also places the two phases according to the serving cluster’s bandwidth to minimize the communication caused by disaggregation. As a result, DistServe significantly improves LLM serving performance in terms of the maximum rate that can be served within both TTFT and TPOT constraints on each GPU.
|
||||||
|
Our evaluations show that on various popular LLMs, applications, and latency requirements, DistServe can serve 7.4× more requests or 12.6× tighter SLO, compared to state-of-the-art systems, while staying within latency constraints for >90%90>90\%> 90 % of requests.
|
||||||
|
|
||||||
|
## 1 引言(Introduction)
|
||||||
|
|
||||||
|
Large language models (LLMs), such as GPT-4 [37], Bard [2], and LLaMA [51], represent a groundbreaking shift in generative AI. They start to reshape existing Internet services, ranging from search engines to personal assistants [4], and enable fundamentally new applications, like universal chatbots [1, 16] and programming assistants [15, 42]. Yet, these advances come with a significant challenge: processing an end-to-end LLM query can be substantially slower than a standard search query [41]. In order to meet the stringent latency requirements of various applications, service providers need to over-provision compute resources, particularly many GPUs, leading to a shortfall in cost efficiency. Therefore, optimizing the cost per LLM query while adhering to high SLO attainment (the proportion of requests that meet the SLOs) is becoming increasingly essential for all LLM services.
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
Figure 1:
|
||||||
|
Performance when serving an LLM with 13B parameters under a synthetic workload with input length = 512 and output length = 64 on one NVIDIA 80GB A100. Upper: The P90 time-to-first-token (TTFT) latency comparing existing systems vs. a system serving only the prefill phase. Down: The P90 time-per-output-token (TPOT) latency comparing existing systems vs. a system serving only the decoding phase.
|
||||||
|
|
||||||
|
An LLM service responds to a user query in two phases. The _prefill phase_ processes a user’s prompt, composed of a sequence of tokens, to generate the first token of the response _in one step_. Following it, the _decoding phase_ sequentially generates subsequent tokens _in multiple steps_; each decoding step generates a new token based on tokens generated in previous steps, until reaching a termination token.
|
||||||
|
This dual-phase process distinguishes LLM services from traditional services
|
||||||
|
– an LLM service’s latency is uniquely measured by two key metrics: the _time to first token_ (TTFT), which is the duration of the prefill phase, and the _time per output token_ (TPOT), which represents the average time taken to generate a token for each request (except for the first token)111The overall request latency equals TTFT plus TPOT times the number of generated tokens in the decoding phase..
|
||||||
|
Different applications place varying demands on each metric. For example, real-time chatbots [1] prioritize low TTFT for response promptness, while TPOT only remains important until it is faster than human reading speed (i.e., 250 words/min).
|
||||||
|
Conversely, document summarization emphasizes low TPOT for faster generation of the summary.
|
||||||
|
|
||||||
|
Hence, given the application’s TTFT and TPOT requirements, an effective LLM serving system should balance these needs and maximize _per-GPU goodput_, defined as the maximum request rate that can be served adhering to the SLO attainment goal (say, 90%) for each GPU provisioned – higher per-GPU goodput directly translates into lower cost per query.
|
||||||
|
|
||||||
|
As the prefill and decoding phases share the LLM weights and working memory,
|
||||||
|
existing LLM serving systems typically colocate both phases on GPUs and maximize the overall system throughput – tokens generated per second across all users and requests – by batching the prefill and decoding steps across requests [54, 31]. However, to meet latency requirements, we find these systems must over-provision compute resources. To see this, Figure 1 illustrates how the P90 TTFT and TPOT shift with increasing request rates when serving a 13B LLM using existing systems [32], with workload pattern and two latency constraints set to emulate using LLM to generate a short summary for an article. Under the SLO attainment of 90%, the maximum achievable goodput on a single A100 GPU, which is constrained by the more stringent one of TTFT and TPOT requirements, is about 1.6 requests per second (rps).
|
||||||
|
The performance contrasts sharply when each phase is served independently on a separate GPU, shown by the orange and green curves, which achieve per-GPU goodput of 5.6 rps for the prefill phase and 10 rps for decoding. Ideally, by allocating 2 GPUs for prefill and 1 GPU for decoding, we can effectively serve the model with an overall goodput of 10 rps, or equally 3.3 rps per GPU, which is 2.1x higher than existing systems.
|
||||||
|
The gap in goodput primarily stems from the colocation of the prefill and decoding – two phases with very distinct computational characteristics and latency requirements (§2.1).
|
||||||
|
|
||||||
|
First, colocation leads to strong _prefill-decoding interference_.
|
||||||
|
A prefill step often takes much longer than a decoding step. When batched together, decoding steps in the batch are delayed by the prefill steps, significantly elongating their TPOT; similarly, the inclusion of decoding steps contributes to a non-trivial increase in TTFT, as evidenced in Figure 2.
|
||||||
|
Even if we schedule them separately, issues persist as they begin to compete for resources. Decoding tasks awaiting GPU execution are subject to increased queuing delays due to ongoing prefill tasks, and vice versa. Prioritized scheduling of one phase risks failing the latency requirements of the other.
|
||||||
|
|
||||||
|
Second, the prefill and decoding computation differ in latency requirements and preference for different forms of parallelism (§3). Colocating prefill and decoding, however, couples their resource allocation, and prevents implementing different parallelism strategies more suited to meeting the specific latency requirements of each phase.
|
||||||
|
|
||||||
|
To overcome these challenges, we propose to disaggregate the prefill and decoding phases of LLM inference, assigning them to separate GPUs. Our approach has two benefits.
|
||||||
|
First, operating each phase independently on different GPUs eliminates prefill-decoding interference. Second, it allows to scale each phase independently with tailored resource allocation and model parallelism strategies to meet their specific latency requirements.
|
||||||
|
Although disaggregation causes communication of intermediate states between GPUs, we show that the communication overhead is insubstantial (§3.3) in modern GPU clusters, and when managed appropriately, disaggregation significantly improves per-GPU goodput.
|
||||||
|
|
||||||
|
Based on the above insights, in this work, we build DistServe 222https://github.com/LLMServe/DistServe, a goodput-optimized LLM serving system by disaggregating the prefill and decoding phases. Given TTFT and TPOT requirements, DistServe first scales each phase independently by co-optimizing the GPU allocation and parallelism strategies of the prefill and decoding phase assuming serving a single model replica. The optimization ensures maximizing the per-GPU goodput and may assign different numbers of GPUs and parallelism strategies to each phase depending on their respective latency requirements. DistServe then scales this allocation to multiple instances via replication until meeting the user-required traffic rate (§4).
|
||||||
|
DistServe also features an algorithm to place the prefill and decoding computation according to their allocation schemes and the cluster’s bandwidth to minimize the overhead of communicating intermediate states between phases.
|
||||||
|
|
||||||
|
We implement DistServe as an orchestration layer on top of the LLM inference engine. We
|
||||||
|
evaluate DistServe on various LLMs, varying the workloads based on three important real-world LLM applications: chatbots, programming assistant, and document summary. Compared to state-of-the-art solutions, DistServe can serve up to 7.4×7.4 × more requests or 12.6×12.6 × tighter SLO under various latency constraints. Our contributions are:
|
||||||
|
|
||||||
|
- •
|
||||||
|
|
||||||
|
Identify the problems of prefill-decoding interference and resource coupling in existing LLM serving systems and propose to disaggregate the two phases.
|
||||||
|
- •
|
||||||
|
|
||||||
|
Design a novel placement algorithm to choose the goodput-optimal schema for prefill and decoding instances automatically.
|
||||||
|
- •
|
||||||
|
|
||||||
|
Conduct a comprehensive evaluation of DistServe with realistic workloads.
|
||||||
|
|
||||||
|
## 4 方法(Method)
|
||||||
|
|
||||||
|
We built DistServe to solve the above challenges. Given the model, workload characteristic, latency requirements, and SLO attainment target, DistServe will determine (a) the parallelism strategies for prefill and decoding instances, (b) the number of each instance type to deploy, as well as (c) how to place them onto the physical cluster. We call the solution a placement. Our goal is to find a placement that maximizes the per-gpu goodput.
|
||||||
|
|
||||||
|
As explained in §3.3, a key design consideration is to manage communications between disaggregated prefill and decoding phases, given varying cluster setups.
|
||||||
|
In this section, we first present two placement algorithms: one for clusters with high-speed cross-node networks (§4.1) and the other for environments lacking such infrastructure (§4.2); the latter introduces additional constraints. We then develop online scheduling optimizations that adapt to the nuances of real-world workloads (§4.3).
|
||||||
|
|
||||||
|
### 4.1 Placement for High Node-Affinity Cluster
|
||||||
|
|
||||||
|
Algorithm 1 High Node-Affinity Placement Algorithm
|
||||||
|
|
||||||
|
LLM G𝐺Gitalic_G, #node limit per-instance N𝑁Nitalic_N, #GPU per-node M𝑀Mitalic_M, GPU memory capacity C𝐶Citalic_C, workload W𝑊Witalic_W, traffic rate R𝑅Ritalic_R.
|
||||||
|
|
||||||
|
the placement 𝑏𝑒𝑠𝑡_𝑝𝑙𝑚.𝑏𝑒𝑠𝑡_𝑝𝑙𝑚{best\_plm}.italic_best _ italic_plm .
|
||||||
|
|
||||||
|
𝑐𝑜𝑛𝑓𝑖𝑔p,𝑐𝑜𝑛𝑓𝑖𝑔d←∅,∅formulae-sequence←
|
||||||
|
|
||||||
|
subscript𝑐𝑜𝑛𝑓𝑖𝑔𝑝subscript𝑐𝑜𝑛𝑓𝑖𝑔𝑑
|
||||||
|
{config_{p}},{config_{d}},_config start_POSTSUBSCRIPT italic_p end_POSTSUBSCRIPT , italic_config start_POSTSUBSCRIPT italic_d end_POSTSUBSCRIPT ← ∅ , ∅
|
||||||
|
|
||||||
|
for 𝑖𝑛𝑡𝑟𝑎_𝑜𝑝∈{1,2,…,M}𝑖𝑛𝑡𝑟𝑎_𝑜𝑝12…𝑀{intra\_op}\{1,2,...,M\}italic_intra _ italic_op ∈ { 1 , 2 , … , italic_M } do
|
||||||
|
|
||||||
|
for 𝑖𝑛𝑡𝑒𝑟_𝑜𝑝∈{1,2,…,N×M𝑖𝑛𝑡𝑟𝑎_𝑜𝑝}𝑖𝑛𝑡𝑒𝑟_𝑜𝑝12…𝑁𝑀𝑖𝑛𝑡𝑟𝑎_𝑜𝑝{inter\_op}\{1,2,...,{N M}{{intra\_op}}\}italic_inter _ italic_op ∈ { 1 , 2 , … , divide start_ARG italic_N × italic_M end_ARG start_ARG italic_intra _ italic_op end_ARG } do
|
||||||
|
|
||||||
|
if G.size𝑖𝑛𝑡𝑒𝑟_𝑜𝑝×𝑖𝑛𝑡𝑟𝑎_𝑜𝑝<Cformulae-sequence𝐺𝑠𝑖𝑧𝑒𝑖𝑛𝑡𝑒𝑟_𝑜𝑝𝑖𝑛𝑡𝑟𝑎_𝑜𝑝𝐶{G.size}{{inter\_op}{intra\_op}}<Cdivide start_ARG italic_G . italic_s italic_i italic_z italic_e end_ARG start_ARG italic_inter _ italic_op × italic_intra _ italic_op end_ARG < italic_C then
|
||||||
|
|
||||||
|
𝑐𝑜𝑛𝑓𝑖𝑔←(𝑖𝑛𝑡𝑒𝑟_𝑜𝑝,𝑖𝑛𝑡𝑟𝑎_𝑜𝑝)←𝑐𝑜𝑛𝑓𝑖𝑔𝑖𝑛𝑡𝑒𝑟_𝑜𝑝𝑖𝑛𝑡𝑟𝑎_𝑜𝑝{config}({inter\_op},{intra\_op})italic_config ← ( italic_inter _ italic_op , italic_intra _ italic_op )
|
||||||
|
|
||||||
|
G^←parallel(G,𝑐𝑜𝑛𝑓𝑖𝑔)←^𝐺parallel𝐺𝑐𝑜𝑛𝑓𝑖𝑔{G}{parallel}(G,{config})over^ start_ARG italic_G end_ARG ← parallel ( italic_G , italic_config )
|
||||||
|
|
||||||
|
𝑐𝑜𝑛𝑓𝑖𝑔.𝑔𝑜𝑜𝑑𝑝𝑢𝑡←simu_prefill(G^,W)formulae-sequence𝑐𝑜𝑛𝑓𝑖𝑔←𝑔𝑜𝑜𝑑𝑝𝑢𝑡simu_prefill^𝐺𝑊{config.goodput}{simu\_prefill}({G},W)italic_config . italic_goodput ← simu_prefill ( over^ start_ARG italic_G end_ARG , italic_W )
|
||||||
|
|
||||||
|
if 𝑐𝑜𝑛𝑓𝑖𝑔p.𝑔𝑜𝑜𝑑𝑝𝑢𝑡configp.num_gpus<𝑐𝑜𝑛𝑓𝑖𝑔.𝑔𝑜𝑜𝑑𝑝𝑢𝑡config.num_gpusformulae-sequencesubscript𝑐𝑜𝑛𝑓𝑖𝑔𝑝𝑔𝑜𝑜𝑑𝑝𝑢𝑡formulae-sequence𝑐𝑜𝑛𝑓𝑖subscript𝑔𝑝𝑛𝑢𝑚_𝑔𝑝𝑢𝑠formulae-sequence𝑐𝑜𝑛𝑓𝑖𝑔𝑔𝑜𝑜𝑑𝑝𝑢𝑡formulae-sequence𝑐𝑜𝑛𝑓𝑖𝑔𝑛𝑢𝑚_𝑔𝑝𝑢𝑠{{config_{p}.goodput}}{config_{p}.num\_gpus}<{{config.%
|
||||||
|
goodput}}{config.num\_gpus}divide start_ARG italic_config start_POSTSUBSCRIPT italic_p end_POSTSUBSCRIPT . italic_goodput end_ARG start_ARG italic_c italic_o italic_n italic_f italic_i italic_g start_POSTSUBSCRIPT italic_p end_POSTSUBSCRIPT . italic_n italic_u italic_m _ italic_g italic_p italic_u italic_s end_ARG < divide start_ARG italic_config . italic_goodput end_ARG start_ARG italic_c italic_o italic_n italic_f italic_i italic_g . italic_n italic_u italic_m _ italic_g italic_p italic_u italic_s end_ARG then
|
||||||
|
|
||||||
|
𝑐𝑜𝑛𝑓𝑖𝑔p←𝑐𝑜𝑛𝑓𝑖𝑔←subscript𝑐𝑜𝑛𝑓𝑖𝑔𝑝𝑐𝑜𝑛𝑓𝑖𝑔{config_{p}}{config}italic_config start_POSTSUBSCRIPT italic_p end_POSTSUBSCRIPT ← italic_config
|
||||||
|
|
||||||
|
𝑐𝑜𝑛𝑓𝑖𝑔.𝑔𝑜𝑜𝑑𝑝𝑢𝑡←simu_decode(G^,W)formulae-sequence𝑐𝑜𝑛𝑓𝑖𝑔←𝑔𝑜𝑜𝑑𝑝𝑢𝑡simu_decode^𝐺𝑊{config.goodput}{simu\_decode}({G},W)italic_config . italic_goodput ← simu_decode ( over^ start_ARG italic_G end_ARG , italic_W )
|
||||||
|
|
||||||
|
if 𝑐𝑜𝑛𝑓𝑖𝑔d.𝑔𝑜𝑜𝑑𝑝𝑢𝑡configd.num_gpus<𝑐𝑜𝑛𝑓𝑖𝑔.𝑔𝑜𝑜𝑑𝑝𝑢𝑡config.num_gpusformulae-sequencesubscript𝑐𝑜𝑛𝑓𝑖𝑔𝑑𝑔𝑜𝑜𝑑𝑝𝑢𝑡formulae-sequence𝑐𝑜𝑛𝑓𝑖subscript𝑔𝑑𝑛𝑢𝑚_𝑔𝑝𝑢𝑠formulae-sequence𝑐𝑜𝑛𝑓𝑖𝑔𝑔𝑜𝑜𝑑𝑝𝑢𝑡formulae-sequence𝑐𝑜𝑛𝑓𝑖𝑔𝑛𝑢𝑚_𝑔𝑝𝑢𝑠{{config_{d}.goodput}}{config_{d}.num\_gpus}<{{config.%
|
||||||
|
goodput}}{config.num\_gpus}divide start_ARG italic_config start_POSTSUBSCRIPT italic_d end_POSTSUBSCRIPT . italic_goodput end_ARG start_ARG italic_c italic_o italic_n italic_f italic_i italic_g start_POSTSUBSCRIPT italic_d end_POSTSUBSCRIPT . italic_n italic_u italic_m _ italic_g italic_p italic_u italic_s end_ARG < divide start_ARG italic_config . italic_goodput end_ARG start_ARG italic_c italic_o italic_n italic_f italic_i italic_g . italic_n italic_u italic_m _ italic_g italic_p italic_u italic_s end_ARG then
|
||||||
|
|
||||||
|
𝑐𝑜𝑛𝑓𝑖𝑔d←𝑐𝑜𝑛𝑓𝑖𝑔←subscript𝑐𝑜𝑛𝑓𝑖𝑔𝑑𝑐𝑜𝑛𝑓𝑖𝑔{config_{d}}{config}italic_config start_POSTSUBSCRIPT italic_d end_POSTSUBSCRIPT ← italic_config
|
||||||
|
|
||||||
|
n,m←⌈R𝑐𝑜𝑛𝑓𝑖𝑔p.𝑔𝑜𝑜𝑑𝑝𝑢𝑡⌉,⌈R𝑐𝑜𝑛𝑓𝑖𝑔d.𝑔𝑜𝑜𝑑𝑝𝑢𝑡⌉formulae-sequence←
|
||||||
|
|
||||||
|
𝑛𝑚
|
||||||
|
𝑅formulae-sequencesubscript𝑐𝑜𝑛𝑓𝑖𝑔𝑝𝑔𝑜𝑜𝑑𝑝𝑢𝑡𝑅formulae-sequencesubscript𝑐𝑜𝑛𝑓𝑖𝑔𝑑𝑔𝑜𝑜𝑑𝑝𝑢𝑡n,m{R}{{config_{p}.goodput}},{R}{%
|
||||||
|
{config_{d}.goodput}}_n , italic_m ← ⌈ divide start_ARG italic_R end_ARG start_ARG italic_config start_POSTSUBSCRIPT italic_p end_POSTSUBSCRIPT . italic_goodput end_ARG ⌉ , ⌈ divide start_ARG italic_R end_ARG start_ARG italic_config start_POSTSUBSCRIPT italic_d end_POSTSUBSCRIPT . italic_goodput end_ARG ⌉
|
||||||
|
|
||||||
|
𝑏𝑒𝑠𝑡_𝑝𝑙𝑚←(n,𝑐𝑜𝑛𝑓𝑖𝑔p,m,𝑐𝑜𝑛𝑓𝑖𝑔d)←𝑏𝑒𝑠𝑡_𝑝𝑙𝑚𝑛subscript𝑐𝑜𝑛𝑓𝑖𝑔𝑝𝑚subscript𝑐𝑜𝑛𝑓𝑖𝑔𝑑{best\_plm}(n,{config_{p}},m,{config_{d}})italic_best _ italic_plm ← ( italic_n , italic_config start_POSTSUBSCRIPT italic_p end_POSTSUBSCRIPT , italic_m , italic_config start_POSTSUBSCRIPT italic_d end_POSTSUBSCRIPT )
|
||||||
|
|
||||||
|
return 𝑏𝑒𝑠𝑡_𝑝𝑙𝑚𝑏𝑒𝑠𝑡_𝑝𝑙𝑚{best\_plm}italic_best _ italic_plm
|
||||||
|
|
||||||
|
On high node-affinity clusters equipped with Infiniband, KV caches transmission overhead across nodes is negligible, DistServe can deploy prefill and decoding instances across any two nodes without constraints.
|
||||||
|
We propose a two-level placement algorithm for such scenarios: we first optimize the parallelism configurations for prefill and decoding instances separately to attain phase-level optimal per-gpu goodput; then, we use replication to match the overall traffic rate.
|
||||||
|
|
||||||
|
However, finding the optimal parallel configuration for a single instance type, such as for the prefill instance, is still challenging, due to the lack of a simple analytical formula to calculate the SLO attainment (a.k.a., percentage of requests that meet TTFT requirement), given that the workload has diverse input, output lengths, and irregular arrival patterns. Gauging the SLO via real-testbed profiling is time-prohibitive. We thus resort to building a simulator to estimate the SLO attainment, assuming prior knowledge of the workload’s arrival process and input and output length distributions.
|
||||||
|
Although short-term interval is impossible to predict, the workload pattern over longer timescales (e.g.,
|
||||||
|
hours or days) is often predictable [33, 55]. DistServe fits a distribution from the history request traces and resamples new traces from the distribution as the input workload to the simulator to compute the SLO attainment. Next, DistServe simply enumerates the placements and finds the maximum rate that meets the SLO attainment target with binary search and simulation trials.
|
||||||
|
|
||||||
|
Algorithm 1 outlines the process. We enumerate all feasible parallel configurations, subject to cluster capacity limit, for both prefill and decoding instances. Then, for a specific prefill phase configuration, we use `simu_prefill` to simulate and find its maximum goodput via binary search (similarly for using `simu_decode` for decoding).
|
||||||
|
After determining the optimal parallel configurations for both prefill and decoding instances, we replicate them to achieve the user-required overall traffic rate according to their goodput.
|
||||||
|
|
||||||
|
The complexity of Algorithm 1 is O(NM2)𝑂𝑁superscript𝑀2O(NM^{)italic_O ( italic_N italic_M start_POSTSUPERSCRIPT 2 end_POSTSUPERSCRIPT ), with N𝑁Nitalic_N as the node limit per instance and M𝑀Mitalic_M representing the typical number of GPUs per node in modern clusters (e.g., 8). The search space is manageable and the solving time is under 1.3 minutes in our largest setting, as demonstrated in §6.5.
|
||||||
|
|
||||||
|
Simulator building. Algorithm 1 relies on a simulator to estimate the goodput under various SLOs and SLO attainment goals given the workload and the parallelism plan.
|
||||||
|
To build an accurate simulator, we analyze the FLOPs and the number of memory accesses for prefill and decoding phases respectively, and use a latency model to approximate the inference execution time. See details in Appendix A. The simulator aligns well with real profiling results, thanks to the high predictability of DNN workloads [23, 33], verified in §6.4.
|
||||||
|
|
||||||
|
By far, we have developed Algorithm 1 assuming we can place the prefill and decoding instance between any two nodes (or on the same node) of the cluster, and the KV cache transmission utilizes high bandwidth network. In many real clusters, GPUs inside a node access to high-bandwidth NVLINK while GPUs distributed across nodes have limited bandwidth. We next develop an algorithm to address this constraint.
|
||||||
|
|
||||||
|
Algorithm 2 Low Node-Affinity Placement Algorithm
|
||||||
|
|
||||||
|
LLM G𝐺Gitalic_G, #node limit per-instance N𝑁Nitalic_N, #GPU per-node M𝑀Mitalic_M, GPU memory capacity C𝐶Citalic_C, workload W𝑊Witalic_W, traffic rate R𝑅Ritalic_R.
|
||||||
|
|
||||||
|
the placement 𝑏𝑒𝑠𝑡_𝑝𝑙𝑚.𝑏𝑒𝑠𝑡_𝑝𝑙𝑚{best\_plm}.italic_best _ italic_plm .
|
||||||
|
|
||||||
|
𝑐𝑜𝑛𝑓𝑖𝑔∗←∅←superscript𝑐𝑜𝑛𝑓𝑖𝑔_config start_POSTSUPERSCRIPT ∗ end_POSTSUPERSCRIPT ← ∅
|
||||||
|
|
||||||
|
for 𝑖𝑛𝑡𝑒𝑟_𝑜𝑝∈{1,2,…,N}𝑖𝑛𝑡𝑒𝑟_𝑜𝑝12…𝑁{inter\_op}\{1,2,...,N\}italic_inter _ italic_op ∈ { 1 , 2 , … , italic_N } do
|
||||||
|
|
||||||
|
𝒫←get_intra_node_configs(G,M,C,𝑖𝑛𝑡𝑒𝑟_𝑜𝑝)←𝒫get_intra_node_configs𝐺𝑀𝐶𝑖𝑛𝑡𝑒𝑟_𝑜𝑝{P}{get\_intra\_node\_configs}(G,M,C,{inter\_op})caligraphic_P ← get_intra_node_configs ( italic_G , italic_M , italic_C , italic_inter _ italic_op )
|
||||||
|
|
||||||
|
for Pp∈𝒫subscript𝑃𝑝𝒫P_{p}{P}italic_P start_POSTSUBSCRIPT italic_p end_POSTSUBSCRIPT ∈ caligraphic_P do
|
||||||
|
|
||||||
|
for Pd∈𝒫subscript𝑃𝑑𝒫P_{d}{P}italic_P start_POSTSUBSCRIPT italic_d end_POSTSUBSCRIPT ∈ caligraphic_P do
|
||||||
|
|
||||||
|
if Pp.𝑛𝑢𝑚_𝑔𝑝𝑢𝑠+Pd.𝑛𝑢𝑚_𝑔𝑝𝑢𝑠≤Mformulae-sequencesubscript𝑃𝑝𝑛𝑢𝑚_𝑔𝑝𝑢𝑠subscript𝑃𝑑𝑛𝑢𝑚_𝑔𝑝𝑢𝑠𝑀P_{p}.{num\_gpus}+P_{d}.{num\_gpus} Mitalic_P start_POSTSUBSCRIPT italic_p end_POSTSUBSCRIPT . italic_num _ italic_gpus + italic_P start_POSTSUBSCRIPT italic_d end_POSTSUBSCRIPT . italic_num _ italic_gpus ≤ italic_M then
|
||||||
|
|
||||||
|
𝑐𝑜𝑛𝑓𝑖𝑔←(𝑖𝑛𝑡𝑒𝑟_𝑜𝑝,Pp,Pd)←𝑐𝑜𝑛𝑓𝑖𝑔𝑖𝑛𝑡𝑒𝑟_𝑜𝑝subscript𝑃𝑝subscript𝑃𝑑{config}({inter\_op},P_{p},P_{d})italic_config ← ( italic_inter _ italic_op , italic_P start_POSTSUBSCRIPT italic_p end_POSTSUBSCRIPT , italic_P start_POSTSUBSCRIPT italic_d end_POSTSUBSCRIPT )
|
||||||
|
|
||||||
|
G^p,G^d←parallel(G,𝑐𝑜𝑛𝑓𝑖𝑔)←
|
||||||
|
|
||||||
|
subscript^𝐺𝑝subscript^𝐺𝑑
|
||||||
|
parallel𝐺𝑐𝑜𝑛𝑓𝑖𝑔{G}_{p},{G}_{d}{parallel}(G,{config})over^ start_ARG italic_G end_ARG start_POSTSUBSCRIPT italic_p end_POSTSUBSCRIPT , over^ start_ARG italic_G end_ARG start_POSTSUBSCRIPT italic_d end_POSTSUBSCRIPT ← parallel ( italic_G , italic_config )
|
||||||
|
|
||||||
|
𝑐𝑜𝑛𝑓𝑖𝑔.𝑔𝑜𝑜𝑑𝑝𝑢𝑡←simulate(G^p,G^d,W)formulae-sequence𝑐𝑜𝑛𝑓𝑖𝑔←𝑔𝑜𝑜𝑑𝑝𝑢𝑡simulatesubscript^𝐺𝑝subscript^𝐺𝑑𝑊{config.goodput}{simulate}({G}_{p},{G}_{d},W)italic_config . italic_goodput ← simulate ( over^ start_ARG italic_G end_ARG start_POSTSUBSCRIPT italic_p end_POSTSUBSCRIPT , over^ start_ARG italic_G end_ARG start_POSTSUBSCRIPT italic_d end_POSTSUBSCRIPT , italic_W )
|
||||||
|
|
||||||
|
if 𝑐𝑜𝑛𝑓𝑖𝑔.∗𝑔𝑜𝑜𝑑𝑝𝑢𝑡𝑐𝑜𝑛𝑓𝑖𝑔.∗𝑛𝑢𝑚_𝑔𝑝𝑢𝑠<𝑐𝑜𝑛𝑓𝑖𝑔.𝑔𝑜𝑜𝑑𝑝𝑢𝑡𝑐𝑜𝑛𝑓𝑖𝑔.𝑛𝑢𝑚_𝑔𝑝𝑢𝑠{{config.^{*}goodput}}{{config.^{*}num\_gpus}}<{%
|
||||||
|
{config.goodput}}{{config.num\_gpus}}divide start_ARG italic_config . start_POSTSUPERSCRIPT ∗ end_POSTSUPERSCRIPT italic_goodput end_ARG start_ARG italic_config . start_POSTSUPERSCRIPT ∗ end_POSTSUPERSCRIPT italic_num _ italic_gpus end_ARG < divide start_ARG italic_config . italic_goodput end_ARG start_ARG italic_config . italic_num _ italic_gpus end_ARG then
|
||||||
|
|
||||||
|
𝑐𝑜𝑛𝑓𝑖𝑔∗←𝑐𝑜𝑛𝑓𝑖𝑔←superscript𝑐𝑜𝑛𝑓𝑖𝑔𝑐𝑜𝑛𝑓𝑖𝑔{config^{*}}{config}italic_config start_POSTSUPERSCRIPT ∗ end_POSTSUPERSCRIPT ← italic_config
|
||||||
|
|
||||||
|
n←⌈R𝑐𝑜𝑛𝑓𝑖𝑔.∗𝑔𝑜𝑜𝑑𝑝𝑢𝑡⌉n{R}{{config.^{*}goodput}}_n ← ⌈ divide start_ARG italic_R end_ARG start_ARG italic_config . start_POSTSUPERSCRIPT ∗ end_POSTSUPERSCRIPT italic_goodput end_ARG ⌉
|
||||||
|
|
||||||
|
𝑏𝑒𝑠𝑡_𝑝𝑙𝑚←(n,𝑐𝑜𝑛𝑓𝑖𝑔∗)←𝑏𝑒𝑠𝑡_𝑝𝑙𝑚𝑛superscript𝑐𝑜𝑛𝑓𝑖𝑔{best\_plm}(n,{config^{*}})italic_best _ italic_plm ← ( italic_n , italic_config start_POSTSUPERSCRIPT ∗ end_POSTSUPERSCRIPT )
|
||||||
|
|
||||||
|
return 𝑏𝑒𝑠𝑡_𝑝𝑙𝑚𝑏𝑒𝑠𝑡_𝑝𝑙𝑚{best\_plm}italic_best _ italic_plm
|
||||||
|
|
||||||
|
### 4.2 Placement for Low Node-Affinity Cluster
|
||||||
|
|
||||||
|
A straightforward solution is to always colocate prefill and decoding instances on the same node, utilizing the NVLINK, which is commonly available inside a GPU node.
|
||||||
|
For large models, e.g. with 175B parameters (350GB), we may be unable to even host a single pair of prefill and decoding instances in an 8-GPU node (80G×8=640G<350×2GB80𝐺8640𝐺3502𝐺𝐵80G 8=640G<350 2GB80 italic_G × 8 = 640 italic_G < 350 × 2 italic_G italic_B). We incorporate this as additional placement constraints and co-optimize it with model parallelism, presented in Algorithm 2.
|
||||||
|
|
||||||
|
The key insight is that KV cache transfer occurs exclusively between corresponding layers of prefill and decoding instances.
|
||||||
|
Leveraging inter-op parallelism, we group layers into stages and divide each instance into segments, termed as instance segments, with each segment maintaining one specific inter-op stage.
|
||||||
|
By colocating prefill and decoding segments of the same stage within a single node, we force the transfer of intermediate states to occur only via NVLINK. Inside a node, we set the same parallelism and resource allocation for segments of the same instance. Given the typical limitation of GPUs per node (usually 8), we can enumerate possible configurations inside one node and use the simulator to identify the configurations that yield the best goodput.
|
||||||
|
|
||||||
|
As outlined in Algorithm 2, we begin by enumerating inter-op parallelism degrees to get all the possible instance segments. For each segment, we get all possible intra-node parallelism configurations by calling `get_intra_node_configs`. Then we use simulation to find the optimal one and replicate it to satisfy the target traffic rate.
|
||||||
|
|
||||||
|
### 4.3 Online scheduling
|
||||||
|
|
||||||
|
The runtime architecture of DistServe is shown in Figure 6. DistServe operates with a simple FCFS scheduling policy. All incoming requests arrive at a centralized controller, then dispatched to the prefill instance with the shortest queue for prefill processing, followed by dispatch to the least loaded decoding instance for decoding steps. This setup, while simple, is optimized with several key enhancements tailored to the nuances of real-world workloads.
|
||||||
|
|
||||||
|
Reducing pipeline bubbles.
|
||||||
|
To mitigate the pipeline bubbles caused by non-uniform prompt lengths (§3.3), we schedule the requests in a way that balances the execution time across all batches in the pipeline. This is achieved by noting that, for both prefill and decoding instances, the number of new tokens in the batch is a reliable indicator of the batch’s real execution time.
|
||||||
|
For prefill instances, we profile the target model and GPU to figure out the shortest prompt length Lmsubscript𝐿𝑚L_{m}italic_L start_POSTSUBSCRIPT italic_m end_POSTSUBSCRIPT needed to saturate the GPU. We schedule prefill batches with a total sequence length close to Lmsubscript𝐿𝑚L_{m}italic_L start_POSTSUBSCRIPT italic_m end_POSTSUBSCRIPT, by either batching multiple requests shorter than Lmsubscript𝐿𝑚L_{m}italic_L start_POSTSUBSCRIPT italic_m end_POSTSUBSCRIPT or individually scheduling requests longer than Lmsubscript𝐿𝑚L_{m}italic_L start_POSTSUBSCRIPT italic_m end_POSTSUBSCRIPT. For decoding instances, we set Lmsubscript𝐿𝑚L_{m}italic_L start_POSTSUBSCRIPT italic_m end_POSTSUBSCRIPT as the largest batch size.
|
||||||
|
|
||||||
|
Combat busrtiness.
|
||||||
|
Burstiness in workloads can cause a deluge of KV caches to transfer from prefill to decoding instances, risking memory overload on decoding instances.
|
||||||
|
To circumvent this, DistServe employs a “pull” method for KV cache transmission rather than a “push” approach – decoding instances fetch KV cache from prefill instances _as needed_, using the GPU memory of prefill instances as a queuing buffer. This way, the prefill instance can continue handling other prefill jobs by simply retaining the KV Cache in the GPU memory after processing the prompt. Hence, each type of instance operates at its own pace without complex coordination.
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
Figure 6: DistServe Runtime System Architecture
|
||||||
|
|
||||||
|
Replaning. The resource and parallelism plan in DistServe is optimized for a specific workload pattern, which may become suboptimal if the workload pattern changes over time. DistServe implement periodic replanning. A workload profiler monitors key parameters such as the average input and output length of the requests, the average arrival rate, etc. If a significant pattern shift is detected, DistServe will trigger a rerun of the placement algorithm based on recent historical data. This process is expedient – the proposed algorithm runs in seconds (§6.5) and reloading LLM weights can be completed within minutes – far shorter than the hourly scale at which real-world workload variations tend to occur.
|
||||||
|
|
||||||
|
Preemption and fault tolerance. DistServe does not implement advanced runtime policies like preemption [26] and fault tolerance [58], which are complementary to disaggregation. Nevertheless, we discuss how they fit into DistServe.
|
||||||
|
In DistServe, the FCFS policy can lead to a “convoy effect”, where longer requests block shorter ones in the prefill stage. Incorporating preemptive strategies, as suggested in existing literature [53], could enhance efficiency and is feasible within our system’s architecture.
|
||||||
|
While not a primary focus in the current DistServe, fault tolerance is a critical aspect for consideration. In traditional colocation- and replication-based systems, a fault in one instance typically does not disrupt other replica instances. However, in DistServe, the dependency between prefill and decoding instances introduces the risk of fault propagation. For example, a fault in a single decoding instance mapped to multiple prefill instances could potentially cripple the entire service and cluster. We leave both as future work.
|
||||||
|
|
||||||
|
## 9 结论(Conclusion)
|
||||||
|
|
||||||
|
We present DistServe, a new LLM serving architecture that disaggregates the prefill and decoding computation. DistServe maximizes the per-gpu goodput – the maximum request rate that can be served adhering to the SLO attainment goal for each GPU provisioned, hence resulting in up to 7.4×7.4 × lower cost per LLM query with guaranteed satisfaction of SLOs.
|
||||||
|
Our findings affirm that as latency becomes an increasingly important metric for LLM services, prefill and decoding disaggregation is a vital strategy in promising improved performance and service quality guarantees.
|
||||||
|
|
||||||
|
Acknowledgments. We sincerely thank our shepherd and
|
||||||
|
the anonymous reviewers for their valuable feedback. This work was
|
||||||
|
supported by the National Natural Science Foundation of China under the grant numbers
|
||||||
|
62172008, 62325201, and the National Natural Science Fund for the Excellent Young Scientists Fund
|
||||||
|
Program (Overseas). Junda Chen is supported by UCSD fellowship and Hao Zhang is supported by UCSD faculty startup fund. Xin Jin is
|
||||||
|
the corresponding author. Yinmin Zhong, Xuanzhe Liu, and Xin Jin are
|
||||||
|
also with the Key Laboratory of High Confidence Software Technologies (Peking
|
||||||
|
University), Ministry of Education.
|
||||||
@@ -0,0 +1,91 @@
|
|||||||
|
# 📊 文章摘要:DistServe: Disaggregating Prefill and Decoding for Goodput-optimized Large Language Model Serving
|
||||||
|
|
||||||
|
> **原文**:[2024-01-18_DistServe.md](./2024-01-18_DistServe.md)
|
||||||
|
> **原文链接**:https://arxiv.org/abs/2401.09670
|
||||||
|
> **来源**:arXiv
|
||||||
|
> **作者**:Yinmin Zhong, Shengyu Liu, Junda Chen, Jianbo Hu, Yibo Zhu, Xuanzhe Liu, Xin Jin, Hao Zhang(北京大学、StepFun、UC San Diego)
|
||||||
|
> **发布日期**:2024-01-18
|
||||||
|
> **摘要日期**:2026-08-06
|
||||||
|
> **价值评级**:⭐⭐⭐ 高
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 核心命题
|
||||||
|
|
||||||
|
> **阶段解耦** — 将 prefill 与 decoding 两个计算特性迥异的阶段拆分到独立 GPU 池并各自定制资源与并行策略,以"每 GPU goodput"而非系统总吞吐为优化目标,是 LLM serving 成本优化的范式转折点。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 文章概要
|
||||||
|
|
||||||
|
现有 LLM serving 系统(vLLM 等)将 prefill 与 decoding 两阶段放在同一批 GPU 上混合批处理,本文指出这一策略产生两类问题:一是强烈的 prefill-decoding 相互干扰(混合批处理时解码步被 prefill 步拖慢、TTFT 与 TPOT 相互挤压);二是两阶段被耦合的资源配置与并行策略所绑定,无法各取所需。DistServe 将两阶段分配到不同 GPU,在 TTFT/TPOT 约束下联合优化各阶段的 GPU 数量与并行配置(含高低节点亲和集群两套放置算法),并用"拉取式"KV cache 传输、流水线气泡削减与周期性重规划支撑运行。在多种 LLM 与应用负载下,DistServe 相比当时 SOTA 系统可服务 7.4× 更多请求或满足 12.6× 更严格的 SLO(>90% 请求达标)。局限在于依赖工作负载可预测性(配置搜索基于模拟器)且未实现抢占与容错。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 关键要点
|
||||||
|
|
||||||
|
1. **两阶段特性迥异是问题根源** — prefill 是计算密集型单步操作、吃 FLOPs;decoding 是内存带宽受限的多步自回归,延迟敏感。混合批处理必然顾此失彼。`[分类: 共识]`
|
||||||
|
2. **"干扰 + 耦合"双重病因** — 同批共存导致解码步延迟(TPOT 变长)、prefill 排队恶化(TTFT 变长);且共享权重与显存迫使两阶段用同一并行策略,无法分别优化。`[分类: 范式突破]`
|
||||||
|
3. **解耦收益量化** — 13B 模型单 A100 上,混合部署仅 1.6 rps goodput;分离后 prefill 单 GPU 达 5.6 rps、decoding 达 10 rps,按 2:1 GPU 配比整体 goodput 为 10 rps(每 GPU 3.3 rps),是原方案的 2.1×。`[分类: 共识]`
|
||||||
|
4. **goodput 目标重塑优化函数** — 以"每 GPU 满足 SLO 达标率(90%)的最大请求率"为优化目标,直接对应单次查询成本;相比传统的最大 token 吞吐目标更贴合商业诉求。`[分类: 范式突破]`
|
||||||
|
5. **两套放置算法适配不同网络** — 高节点亲和集群(Infiniband,跨节点 KV cache 传输开销可忽略)用枚举并行配置 + 二进制搜索模拟;低节点亲和集群利用"KV cache 只在对应层之间传输"的特性,将 prefill/decoding 的同层段共置单节点内走 NVLINK,避免跨节点慢速传输。`[分类: 未探索]`
|
||||||
|
6. **"拉取"式 KV cache 传输抗突发** — decoding 实例按需从 prefill 实例拉取 KV cache,prefill 显存充当排队缓冲,避免突发流量压垮 decoding 内存,两类实例无需复杂协调。`[分类: 未探索]`
|
||||||
|
7. **故障传播是新风险** — 解耦引入 prefill↔decoding 实例依赖:单个 decoding 实例故障可能连带多个 prefill 实例、瘫痪整个服务;抢占(如缓解 convoy 效应)与容错均留作未来工作。`[分类: 未探索]`
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 批判性分析
|
||||||
|
|
||||||
|
### 假设前提
|
||||||
|
|
||||||
|
- 工作负载的到达过程与输入/输出长度分布在较长时间尺度上可预测(论文以小时/天级可预测为前提,用历史 trace 拟合分布驱动配置搜索)。
|
||||||
|
- 现代集群具备足够的跨节点带宽,使解耦通信开销"不实质"(KV cache 传输相对推理时间可忽略)。
|
||||||
|
- 应用对 TTFT 与 TPOT 的要求可明确量化并作为输入给定。
|
||||||
|
- 单模型副本的优化可先于多实例扩展完成(分两步:先求最优单副本配置,再复制满足流量)。
|
||||||
|
|
||||||
|
### 论据与逻辑
|
||||||
|
|
||||||
|
- 论据链条完整:先以 Figure 1 的 13B 单卡实验证明"混合部署 goodput 远低于分阶段独立运行"(1.6 vs 5.6/10 rps),再推导出解耦的必要性;随后用模拟器 + 真实测试床验证配置搜索与 SLO 达标率对齐(论文声称模拟器与真实 profiling 高度吻合)。
|
||||||
|
- 端到端评估覆盖三种真实应用(聊天、编程助手、文档摘要)与多模型,7.4×/12.6× 的收益数字有实验支撑。
|
||||||
|
- 潜在弱点:7.4×/12.6× 是"up to"峰值表述,具体负载下提升幅度不同;解耦收益高度依赖集群网络质量,论文对此的敏感度分析着墨较少。
|
||||||
|
|
||||||
|
### 边界与局限
|
||||||
|
|
||||||
|
- 结论适用于两阶段特性差异明显、SLO 严格的场景;若 TTFT/TPOT 要求宽松,解耦收益会收窄。
|
||||||
|
- 未处理抢占调度与故障容错,且解耦使故障传播范围扩大——生产部署需另行补充。
|
||||||
|
- 配置搜索依赖 workload 预测,负载模式剧烈变化(短时间尺度不可预测)时可能退化为次优。
|
||||||
|
- 评估硬件为 A100 世代,未覆盖 H100/Groq 等后续异构平台(此边界由后续论文补足)。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 可引用金句
|
||||||
|
|
||||||
|
> "We find that this strategy not only leads to strong prefill-decoding interferences but also couples the resource allocation and parallelism plans for both phases."
|
||||||
|
> (我们发现,这种策略不仅导致强烈的 prefill-decoding 干扰,还耦合了两个阶段的资源分配与并行计划。)
|
||||||
|
|
||||||
|
> "Our findings affirm that as latency becomes an increasingly important metric for LLM services, prefill and decoding disaggregation is a vital strategy in promising improved performance and service quality guarantees."
|
||||||
|
> (我们的发现证实:随着延迟成为 LLM 服务日益重要的指标,prefill 与 decoding 解耦是带来性能与服务质量的提升的关键策略。)
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 总体评价
|
||||||
|
|
||||||
|
**亮点**:
|
||||||
|
- 首个系统化论证并实现 prefill/decoding 解耦的 serving 系统之一,直击当时 colocation 共识的软肋,开启后续解耦架构浪潮
|
||||||
|
- "per-GPU goodput"优化目标将系统性能与商业成本直接挂钩,视角独特且可操作
|
||||||
|
- 同时覆盖高/低节点亲和两类集群的放置算法,工程完备度高;KV cache"拉取"机制与流水线气泡消减是实用的系统细节
|
||||||
|
|
||||||
|
**不足**:
|
||||||
|
- 依赖工作负载可预测性做离线配置搜索,在线自适应能力有限
|
||||||
|
- 抢占与容错缺失,且未充分讨论解耦故障传播的工程应对
|
||||||
|
- "up to"峰值收益表述下,对网络带宽敏感度的量化分析不够深入
|
||||||
|
|
||||||
|
**适用场景**:面向 LLM serving 系统设计者、云厂商推理基础设施团队;为理解后续(Mooncake、Splitwise、vLLM 解耦版等)全部解耦系工作提供理论基础。
|
||||||
|
|
||||||
|
**关联建议**:可与同期论文对照阅读——Splitwise(异构硬件视角的阶段拆分)、TetriInfer(混合负载干扰 + 长度预测调度)、Mooncake(KVCache 为中心的规模化生产实践);后续可追踪 vLLM 官方对 prefill/decode 解耦的采纳与 DistServe 作者后续工作(如 DeepSeek 的 DeepEP/EP 解耦方向)。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 配图
|
||||||
|
|
||||||
|

|
||||||
@@ -0,0 +1,191 @@
|
|||||||
|
# PD(Prefill&Decode)分离
|
||||||
|
|
||||||
|
> **来源**:John's Blog(johng.cn)
|
||||||
|
> **作者**:John Guo
|
||||||
|
> **发布日期**:2026-08-05(原文未标注发布日期,按下载日占位)
|
||||||
|
> **原文链接**:https://johng.cn/ai/pd-separation
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 引言
|
||||||
|
|
||||||
|
随着大型语言模型(`LLM`)在各个领域的广泛应用,如何高效地部署和推理这些模型成为了一个关键挑战。传统的 `LLM` 推理架构将整个推理过程视为一个整体,但这种做法往往无法充分利用硬件资源,导致性能瓶颈和用户体验下降。
|
||||||
|
|
||||||
|
`PD(Prefill & Decode)`分离技术作为一种创新的架构设计,通过将 `LLM` 推理过程分解为两个独立的阶段,并针对每个阶段的特性进行专门优化,显著提升了推理效率和用户体验。本文将深入探讨 `PD` 分离技术的原理、实现方案以及带来的优势。
|
||||||
|
|
||||||
|
### 推理过程概述
|
||||||
|
|
||||||
|
在深入了解 `PD` 分离之前,我们需要先理解 `LLM` 的推理过程。整个 `LLM` 推理过程可以分为两个截然不同的阶段:
|
||||||
|
|
||||||
|
- **Prefill 阶段(预填充阶段)**:这是计算密集型阶段,`LLM` 并行处理所有用户输入的 `token`,计算出对应的 `KV Cache`,并生成第一个输出 `token`。
|
||||||
|
- **Decode 阶段(解码阶段)**:这是显存密集型阶段,模型基于已有的 `KV Cache`,通过自回归方式顺序生成后续的 `token`,每次迭代只产生一个新 `token`。
|
||||||
|
|
||||||
|
### 性能评估指标
|
||||||
|
|
||||||
|
为了准确衡量 `LLM` 推理系统的性能,业界定义了几个关键指标:
|
||||||
|
|
||||||
|
#### Prefill 性能评估指标
|
||||||
|
|
||||||
|
- **TTFT(Time To First Token)**:表示从接收用户请求到生成第一个 `token` 所用的时间
|
||||||
|
|
||||||
|
例如:`P90 TTFT SLO = 0.4s` 意味着 `90%` 的请求的 `TTFT` 值都必须 `≤0.4` 秒
|
||||||
|
|
||||||
|
#### Decode 性能评估指标
|
||||||
|
|
||||||
|
- **TPOT(Time Per Output Token)**:表示生成每一个响应 `token` 所用的平均时间
|
||||||
|
|
||||||
|
例如:`P90 TPOT SLO = 0.04s` 意味着 `90%` 的请求的 `TPOT` 值都必须 `≤0.04` 秒
|
||||||
|
- **TBT(Token By Token)**:表示连续生成两个 `token` 之间的时间间隔,这是衡量用户体验流畅度的重要指标。`TBT` 越稳定,用户感知到的响应就越连贯
|
||||||
|
|
||||||
|
### 两阶段特性深度对比
|
||||||
|
|
||||||
|
通过下表我们可以清晰地看到 `Prefill` 和 `Decode` 阶段在各个维度上的显著差异:
|
||||||
|
|
||||||
|
| **特性** | **Prefill(预填充)阶段** | **Decode(解码)阶段** |
|
||||||
|
| --- | --- | --- |
|
||||||
|
| **计算模式** | 并行计算(所有输入 `Token` 同时处理) | 串行计算(逐个 `Token` 生成) |
|
||||||
|
| **计算强度** | 计算密集型(矩阵乘法为主) | 内存带宽受限(访存频繁) |
|
||||||
|
| **GPU 利用率** | 高(接近 `100%`) | 极低(约 `1%`) |
|
||||||
|
| **关键性能指标** | 首次 `Token` 时间(`TTFT`) | `Token` 生成时间(`TPOT`) |
|
||||||
|
| **主要瓶颈** | 算力(`FLOPs`) | 内存带宽(`Memory Bandwidth`) |
|
||||||
|
| **显存占用** | 临时高(需缓存输入序列) | 持续高(需保存 `KV Cache`) |
|
||||||
|
| **批处理优化空间** | 大(可合并多请求输入) | 小(动态调整生成任务) |
|
||||||
|
| **典型延迟** | 短(毫秒级,如 `0.2` 秒处理 `255 Token`) | 长(秒级,如 `32` 秒生成 `256 Token`) |
|
||||||
|
| **加速手段** | `Tensor Core` 加速、`FP16/INT8` 量化 | 内存访问优化、`KV Cache` 压缩 |
|
||||||
|
| **通信需求** | 低(单节点可完成) | 高(分布式需同步 `KV Cache`) |
|
||||||
|
| **调度优先级** | 高(优先保证 `TTFT`) | 中(需稳定 `TPOT`) |
|
||||||
|
|
||||||
|
## 为什么需要 PD 分离?
|
||||||
|
|
||||||
|
### Continuous Batching 的挑战
|
||||||
|
|
||||||
|
现代 `LLM` 推理系统广泛采用 `Continuous Batching` 技术来提高吞吐量。然而,`Prefill` 和 `Decode` 阶段对批处理的响应特性截然不同:
|
||||||
|
|
||||||
|
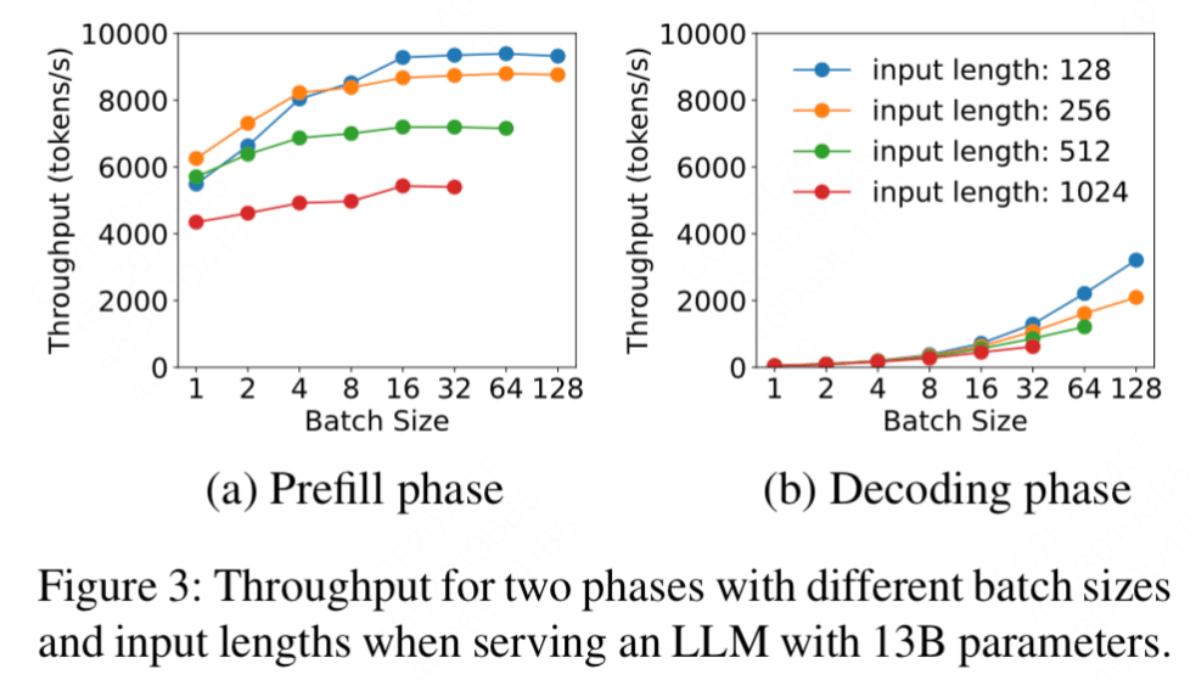
|
||||||
|
|
||||||
|
- **Prefill 阶段**:由于是计算密集型,随着 `Batch Size` 的增加,受算力限制,吞吐量增长趋势逐渐平缓
|
||||||
|
- **Decode 阶段**:由于是内存带宽密集型,随着 `Batch Size` 的增加,吞吐量增长趋势越来越显著
|
||||||
|
|
||||||
|
### 传统架构的性能瓶颈
|
||||||
|
|
||||||
|
在传统的一体化部署模式中,当 `Prefill` 和 `Decode` 在同一设备上执行时,会出现严重的资源竞争问题:
|
||||||
|
|
||||||
|
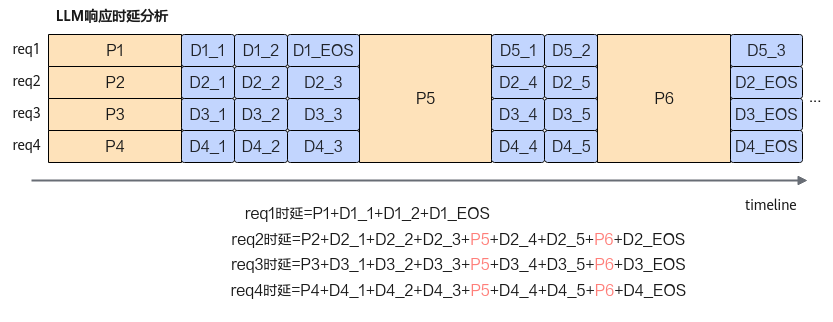
|
||||||
|
|
||||||
|
如上图所示,当新的请求(`request5` 或 `request6`)到达时,系统会优先处理新请求的 `Prefill` 阶段,这会直接影响正在进行的 `Decode` 任务(`request2/3/4`),导致:
|
||||||
|
|
||||||
|
1. **TBT 不稳定**:正在生成 `token` 的请求被打断,响应时延增加
|
||||||
|
2. **用户体验下降**:`token` 生成的连贯性被破坏
|
||||||
|
3. **资源利用率低**:两个阶段的资源需求特性无法得到针对性优化
|
||||||
|
|
||||||
|
### PD 分离的解决方案
|
||||||
|
|
||||||
|
为了解决上述问题,`PD` 分离架构将 `Prefill` 和 `Decode` 部署在不同规格的集群中:
|
||||||
|
|
||||||
|
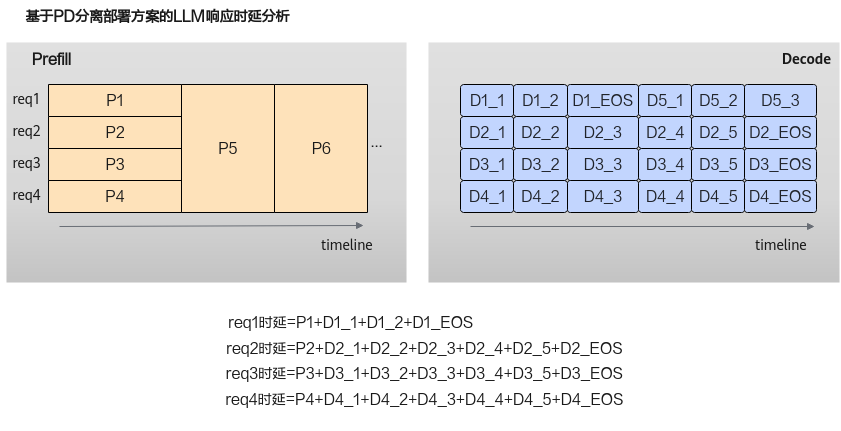
|
||||||
|
|
||||||
|
通过这种分离部署方案,配合智能的任务调度策略,可以在满足 `TTFT` 和 `TBT` 指标的前提下,结合 `Continuous Batching` 机制最大化 `Decode` 阶段的并发处理能力,从而在提供更好用户体验的同时,显著提升算力利用率。
|
||||||
|
|
||||||
|
## PD 分离的核心原理
|
||||||
|
|
||||||
|
### PD 分离的技术思路
|
||||||
|
|
||||||
|
`PD` 分离技术的核心思想是**解耦和专门化**:
|
||||||
|
|
||||||
|
1. **阶段解耦**:将 `Prefill` 和 `Decode` 这两个阶段从逻辑和物理上完全分离
|
||||||
|
2. **设备专门化**:为每个阶段选择最适合其特性的硬件配置
|
||||||
|
3. **优化独立化**:为每个阶段采用最优的并行策略和优化技术
|
||||||
|
|
||||||
|
### 具体实现架构
|
||||||
|
|
||||||
|
在 `PD` 分离架构中:
|
||||||
|
|
||||||
|
- **Prefill 集群**:部署在高算力 `GPU`(如 `A100`、`H100`)上,充分利用其强大的并行计算能力,专注于快速处理输入序列
|
||||||
|
- **Decode 集群**:部署在大显存、高内存带宽的 `GPU`(如大内存的 `L40` 等)上,专注于高效的 `token` 生成和 `KV Cache` 管理
|
||||||
|
- **网络互连**:两个集群通过高速网络(如 `NVLink` 或 `RDMA`)传输中间状态,主要是 `KV Cache` 数据
|
||||||
|
|
||||||
|
### 关键技术挑战
|
||||||
|
|
||||||
|
`PD` 分离系统需要解决几个核心技术问题:
|
||||||
|
|
||||||
|
1. **高效数据传输**:如何在 `Prefill` 和 `Decode` 节点间高效传输大量的 `KV Cache` 数据
|
||||||
|
2. **智能调度策略**:如何设计调度算法确保请求在不同阶段间的平滑流转
|
||||||
|
3. **并行策略优化**:如何为每个阶段选择最优的张量并行、流水线并行等策略
|
||||||
|
4. **状态一致性**:如何保证分布式环境下 `KV Cache` 的一致性和正确性
|
||||||
|
|
||||||
|
### 技术发展现状
|
||||||
|
|
||||||
|
现代 `PD` 分离系统(如 `DistServe`、`Mooncake` 等)通过以下创新技术已经成功解决了这些挑战:
|
||||||
|
|
||||||
|
- **压缩传输算法**:减少 `KV Cache` 传输开销
|
||||||
|
- **预测调度策略**:基于负载预测的智能任务分配
|
||||||
|
- **异步处理机制**:`overlap` 计算和通信操作
|
||||||
|
- **动态负载均衡**:根据实时负载调整资源分配
|
||||||
|
|
||||||
|
这些技术创新使得 `PD` 分离架构能够将额外开销控制在可接受范围内,同时实现显著的性能提升。
|
||||||
|
|
||||||
|
## PD 分离部署下的用户访问时序
|
||||||
|
|
||||||
|
在 `PD` 分离部署架构中,一次完整的用户请求涉及三个角色的协同工作:用户(`Client`)、`Prefill` 节点(`P`)和 `Decode` 节点(`D`)。下图详细展示了这三方之间完整的数据交互时序。
|
||||||
|
|
||||||
|
### 时序关键环节说明
|
||||||
|
|
||||||
|
| 阶段 | 参与方 | 核心动作 | 关键指标 |
|
||||||
|
| --- | --- | --- | --- |
|
||||||
|
| ① 请求接入 | `Client` → 调度层 → `P` | 用户发起请求,调度层将完整 `Prompt` 路由至 `Prefill` 节点 | - |
|
||||||
|
| ② `Prefill` 计算 | `P` | 并行处理所有输入 `Token`,构建完整 `KV Cache`,产出第一个 `Token` | `TTFT` |
|
||||||
|
| ③ `KV Cache` 传输 | `P` → `D` | 通过高速网络(`RDMA`/`NVLink`)将 `KV Cache` 从 `P` 传输至 `D` | 传输延迟 |
|
||||||
|
| ④ `Decode` 接管 | `D` | 加载 `KV Cache` 后以自回归方式逐步生成后续 `Token` | `TPOT`/`TBT` |
|
||||||
|
| ⑤ 流式推送 | 调度层 → `Client` | 每生成一个 `Token` 即实时推送给用户,保证响应连贯性 | `TBT` |
|
||||||
|
| ⑥ 请求结束 | `D` → 调度层 → `Client` | 遇到终止条件后发送结束信号,关闭流式连接 | - |
|
||||||
|
|
||||||
|
### 与传统一体化架构的对比
|
||||||
|
|
||||||
|
在传统一体化部署中,`Prefill` 和 `Decode` 在同一节点串行执行,新请求的 `Prefill` 计算会抢占正在进行 `Decode` 的 `GPU` 资源,导致 `TBT` 抖动。`PD` 分离后:
|
||||||
|
|
||||||
|
- `P` 节点专注于 `Prefill` 计算,完成后立即释放资源处理下一个新请求,不影响 `D` 节点的 `Decode` 流程
|
||||||
|
- `D` 节点持续稳定地执行自回归生成,`TBT` 不受新请求到达的干扰
|
||||||
|
- 调度层可以独立控制 `P` 和 `D` 集群的并发规模,实现精细化弹性扩缩容
|
||||||
|
|
||||||
|
## PD 分离带来的优势
|
||||||
|
|
||||||
|
通过将 `Prefill` 和 `Decode` 阶段分离部署,这种架构在多个方面带来了显著的改进,特别是在处理长上下文(`long context`)场景时,其优势更加明显。
|
||||||
|
|
||||||
|
### 资源分配与利用的优化
|
||||||
|
|
||||||
|
#### 异构设备的充分利用
|
||||||
|
|
||||||
|
- **成本效益最大化**:`Prefill` 阶段计算密集,适合部署在高算力 `GPU`(如 `A100`、`H100` 等高端计算卡)上;而 `Decode` 阶段显存密集,可以采用低算力但大显存的 `GPU`(如大内存的 `L40` 等)。这种差异化配置能够显著降低硬件总成本,同时提高每种设备的利用率。
|
||||||
|
- **弹性资源管理**:可以根据实际负载情况独立地为 `Prefill` 和 `Decode` 集群进行扩缩容。在业务高峰期,可以针对性地为瓶颈阶段分配更多资源,而不必为整个系统进行等比例扩容,大大提高了系统的弹性和成本效益。
|
||||||
|
|
||||||
|
### 性能指标的全面提升
|
||||||
|
|
||||||
|
#### 多指标同步优化
|
||||||
|
|
||||||
|
- **避免性能权衡**:在传统架构中,优化 `TTFT` 往往会影响 `TPOT`,反之亦然。`PD` 分离允许在 `Prefill` 阶段限制 `Batch Size` 以减少 `TTFT`,同时在 `Decode` 阶段增大 `Batch Size` 以提高并发处理能力。这种策略能够同时改善所有关键性能指标,而不需要在不同指标之间做权衡。
|
||||||
|
- **稳定的用户体验**:通过分离部署,新请求的 `Prefill` 计算不会占用 `Decode` 阶段的资源,从而保证了稳定的 `TBT`,为用户提供更加流畅和一致的交互体验。
|
||||||
|
|
||||||
|
### 技术实现的灵活性
|
||||||
|
|
||||||
|
#### 独立优化策略
|
||||||
|
|
||||||
|
- **阶段特化优化**:可以为 `Prefill` 和 `Decode` 阶段分别采用最适合的模型优化技术。例如,在 `Prefill` 阶段采用量化、矩阵分解等计算优化技术,而在 `Decode` 阶段专注于 `Continuous Batching` 和 `KV Cache` 管理优化。
|
||||||
|
- **硬件生态扩展**:这种分离架构为使用不同类型的硬件加速器打开了可能性。可以在 `Prefill` 阶段使用传统 `GPU`,而在 `Decode` 阶段尝试使用专用的推理芯片或其他新兴硬件,进一步降低成本并提高效率。
|
||||||
|
|
||||||
|
### 系统可靠性与可维护性提升
|
||||||
|
|
||||||
|
#### 故障隔离与高可用
|
||||||
|
|
||||||
|
- **单点故障消除**:当 `Prefill` 或 `Decode` 集群中的某个节点出现故障时,不会直接影响另一阶段的正常运行,显著提高了系统的整体可靠性和可用性。
|
||||||
|
- **运维灵活性**:可以独立地对 `Prefill` 或 `Decode` 集群进行版本升级、配置调整或维护操作,大大减少了系统维护对线上服务的影响,提高了运维效率。
|
||||||
|
|
||||||
|
#### 扩展性与未来适应性
|
||||||
|
|
||||||
|
- **技术演进适应**:随着新的硬件技术和算法优化的出现,可以独立地在某一阶段应用新技术,而不需要重新设计整个系统架构。
|
||||||
|
- **业务场景适配**:不同的业务场景对 `Prefill` 和 `Decode` 的性能要求不同,分离架构允许根据具体业务需求灵活调整两个阶段的资源配比和优化策略。
|
||||||
|
|
||||||
|
通过这些全方位的优势,`PD` 分离架构不仅解决了传统 `LLM` 推理系统的性能瓶颈问题,还为大模型的高效部署和应用提供了一个更加灵活、可扩展的技术方案。
|
||||||
|
|
||||||
|
## 参考资料
|
||||||
|
|
||||||
|
- https://www.eet-china.com/mp/a412848.html
|
||||||
@@ -0,0 +1,79 @@
|
|||||||
|
# 📊 文章摘要:PD(Prefill&Decode)分离
|
||||||
|
|
||||||
|
> **原文**:[2026-08-05_PD_PrefillDecode分离_johng.md](./2026-08-05_PD_PrefillDecode分离_johng.md)
|
||||||
|
> **原文链接**:https://johng.cn/ai/pd-separation
|
||||||
|
> **来源**:John's Blog(johng.cn)
|
||||||
|
> **作者**:John Guo
|
||||||
|
> **发布日期**:2026-08-05(原文未标注发布日期,按下载日占位)
|
||||||
|
> **摘要日期**:2026-08-06
|
||||||
|
> **价值评级**:⭐ 低
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 核心命题
|
||||||
|
|
||||||
|
> **解耦专门化** — 以"阶段解耦、设备专门化、优化独立化"三原则系统梳理 PD 分离的概念、原理、架构与优势,是合格的入门科普。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 文章概要
|
||||||
|
|
||||||
|
本文系统介绍 PD 分离:先对比 Prefill(计算密集、GPU 利用率近 100%)与 Decode(内存带宽受限、利用率约 1%)两阶段的特性差异与指标(TTFT/TPOT/TBT),再说明连续批处理下 Prefill 抢占 Decode 导致 TBT 抖动的问题,进而提出"解耦和专门化"的分离架构——P 集群用高算力卡、D 集群用大显存高带宽卡、经高速网络传输 KV Cache。文章还给出了完整的用户访问时序与六类优势(异构设备、指标解耦、独立优化、故障隔离、弹性扩缩容等)。价值在于对比表与时序梳理清晰、适合作入门资料;局限是全程无实验数据与量化分析,对传输开销与调度复杂度等代价仅一笔带过,结论偏乐观。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 关键要点
|
||||||
|
|
||||||
|
1. **两阶段特性对比表** — 算力 vs 内存带宽、GPU 利用率近 100% vs 约 1%、批处理优化空间大 vs 小、加速手段各异(Tensor Core/量化 vs 访存优化/KV 压缩),是全篇文章信息密度最高的部分。 `[分类: 共识]`
|
||||||
|
2. **传统架构的 TBT 抖动** — 新请求 Prefill 抢占正在 Decode 的 GPU,导致 token 生成连贯性被破坏、用户体验下降。 `[分类: 共识]`
|
||||||
|
3. **分离架构三要素** — 阶段解耦(逻辑与物理分离)、设备专门化(P 用 A100/H100 类高算力卡、D 用 L40 类大显存卡)、优化独立化(两阶段分别采用最优并行策略)。 `[分类: 共识]`
|
||||||
|
4. **四大技术挑战** — 高效数据传输、智能调度策略、并行策略优化、KV Cache 状态一致性;作者称现代系统(DistServe、Mooncake)已通过压缩传输、预测调度、异步 overlap、动态负载均衡"成功解决"。 `[分类: 共识]`
|
||||||
|
5. **六类优势清单** — 异构设备降本、多指标同步优化、阶段特化优化、故障隔离、独立运维升级、按业务灵活扩缩容。 `[分类: 共识]`
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 批判性分析
|
||||||
|
|
||||||
|
### 假设前提
|
||||||
|
|
||||||
|
立论假设"KV Cache 传输等额外开销能被控制在可接受范围内"(文中仅一句带过,无论证);假设读者为零基础入门者,故全篇以概念梳理为主;对分离的红利描述默认 P:D 配比合理、调度器智能——这些恰是落地中最难的环节。
|
||||||
|
|
||||||
|
### 论据与逻辑
|
||||||
|
|
||||||
|
无任何实验数据或量化计算支撑结论,属于概念综述而非论证型文章;"现代 PD 分离系统通过以下创新技术已经成功解决了这些挑战"的论断乐观且缺乏证据支撑——同批丁师兄文章恰好展示了这些挑战在真实生产中的棘手程度;对比表与结论之间的逻辑依赖多为断言而非推演。
|
||||||
|
|
||||||
|
### 边界与局限
|
||||||
|
|
||||||
|
未讨论 KV 传输开销量级、P:D 比例敏感性、调度复杂度、显存碎片化等落地代价,也未引用任何论文数据(仅文末一个 EET-China 链接);结论适用于"PD 分离值得做"的定性理解,对成本收益评估、方案选型等决策场景不适用;与同批其他文章相比无独立观点与增量信息。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 可引用金句
|
||||||
|
|
||||||
|
> "PD 分离技术的核心思想是**解耦和专门化**"
|
||||||
|
|
||||||
|
> "这种策略能够同时改善所有关键性能指标,而不需要在不同指标之间做权衡。"
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 总体评价
|
||||||
|
|
||||||
|
**亮点**:
|
||||||
|
- Prefill 与 Decode 的 12 维特性对比表清晰完整,入门阶段信息密度高
|
||||||
|
- 用户访问时序六环节梳理(请求接入→Prefill→KV 传输→Decode→流式推送→结束)直观易懂
|
||||||
|
- 结构完整,覆盖概念、原理、架构、时序、优势全链条
|
||||||
|
|
||||||
|
**不足**:
|
||||||
|
- 无实验数据与量化分析,关键论断("挑战已被成功解决")缺乏证据
|
||||||
|
- 对落地代价与边界条件基本缺席,结论乐观
|
||||||
|
- 与同批文章相比无独立观点,认知增量低
|
||||||
|
|
||||||
|
**适用场景**:零基础读者建立 PD 分离整体概念的入门资料;需要向非技术角色解释 PD 分离的科普素材;作为深入阅读前的背景铺垫。
|
||||||
|
|
||||||
|
**关联建议**:入门后建议按序阅读本批 DistServe 解读(理论依据与量化收益)、marcus 的 vLLM 源码剖析(实现机制)、丁师兄文章(落地代价),三者可完整覆盖"是什么—为什么—怎么实现—有何代价";该文文末参考的 EET-China 链接(https://www.eet-china.com/mp/a412848.html)亦可溯源。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 配图
|
||||||
|
|
||||||
|
本篇文章为低价值,未生成配图。
|
||||||
@@ -0,0 +1,72 @@
|
|||||||
|
# llm-d:K8s 原生的分布式推理栈架构文档
|
||||||
|
|
||||||
|
> **来源**:llm-d
|
||||||
|
> **作者**:llm-d 项目团队(CNCF Sandbox 项目)
|
||||||
|
> **发布日期**:2026-08-06
|
||||||
|
> **原文链接**:https://llm-d.ai/docs/architecture
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
# Architecture
|
||||||
|
|
||||||
|
llm-d 架构高级指南。从这里开始,然后深入阅读具体指南。
|
||||||
|
|
||||||
|
## Core Components(核心组件)
|
||||||
|
|
||||||
|
llm-d 架构围绕三个主要概念构建:**Router(路由器)**、**InferencePool(推理池)** 和 **Model Server(模型服务器)**。
|
||||||
|
|
||||||
|
- **llm-d Router** —— 推理请求的智能入口点。它提供 LLM 感知的负载均衡、请求排队和策略执行。由两个功能部分组成:
|
||||||
|
- **Proxy**:一个高性能 L7 代理(通常是 Envoy),接受用户请求,并通过 `ext-proc` 协议咨询 EPP 以确定最佳目标。
|
||||||
|
- **Endpoint Picker (EPP)**:路由引擎,基于实时指标、KV-cache 亲和性和配置的策略,对模型服务器 Pod 进行评分和选择。
|
||||||
|
- **InferencePool** —— 通过标签选择器对服务同一基础模型的 Model Server Pod 进行分组的 API。被概念化为"面向 LLM 优化的 Service",是 Router 的发现目标。此外:
|
||||||
|
- **Variant**:InferencePool 内 Model Server Pod 的逻辑子分组,通过 Pod 标签而非专用资源来表达。Variant 根据共享特征(如服务角色(例如 prefill 或 decode)、成本概况、性能概况(吞吐量、延迟)或其他运营属性)来区分模型服务器。
|
||||||
|
- **Model Server** —— 在硬件加速器(GPU、TPU、HPU)上执行模型的推理引擎(如 vLLM 或 SGLang)。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
## Advanced Patterns(高级模式)
|
||||||
|
|
||||||
|
llm-d 的核心设计可以扩展出可选的高级模式:
|
||||||
|
|
||||||
|
### KV Cache Management(KV Cache 管理)
|
||||||
|
|
||||||
|
llm-d 提供了一个全面的生态系统,用于跨推理池管理和复用 KV cache,包括:
|
||||||
|
|
||||||
|
- **Prefix-Cache Aware Routing(前缀缓存感知路由)**:启发式和精确的技术以最大化缓存命中。
|
||||||
|
- **KV-Cache Indexing(KV Cache 索引)**:跨所有模型服务器对缓存状态进行事件驱动的跟踪。
|
||||||
|
- **KV Offloading(KV 卸载)**:分层存储体系(CPU、SSD)以扩展缓存容量。
|
||||||
|
|
||||||
|
参见 KV Cache Management 了解这些组件如何组合的概述。
|
||||||
|
|
||||||
|
### Disaggregated Serving(分离式服务)
|
||||||
|
|
||||||
|
在分离式服务中,单个推理请求被拆分为多个阶段(例如 Prefill 和 Decode),由专门的 worker 处理。llm-d Router 通过同时选择 prefill 和 decode 端点并协调它们之间的 KV-cache 传输来编排这一流程。
|
||||||
|
|
||||||
|
参见 Disaggregation 了解完整细节。
|
||||||
|
|
||||||
|
### Predicted Latency-Based Routing(基于预测延迟的路由)
|
||||||
|
|
||||||
|
llm-d Router 可以通过"consultant"边车扩展,以提供用于路由决策的高级信号。主要实现是 **Latency Predictor**,它支持基于预测的 ITL 和 TTFT 的路由。
|
||||||
|
|
||||||
|
- **Latency Predictor**:在线训练 XGBoost 模型以预测请求延迟,用于更好的端点评分和 SLO 执行。
|
||||||
|
|
||||||
|
### Batch Inference(批推理)
|
||||||
|
|
||||||
|
批处理和离线推理工作负载由两个模块处理,可以独立或一起部署。**Batch Gateway** 提供 OpenAI 兼容的 Batch API 用于作业管理,而 **Async Processor** 通过流控门控分发排队的请求。组合使用时,Batch Gateway 将分发委托给 Async Processor。
|
||||||
|
|
||||||
|
参见 Batch Inference 了解批推理设计的细节。
|
||||||
|
|
||||||
|
### Autoscaling(自动扩缩容)
|
||||||
|
|
||||||
|
llm-d 通过两种互补的方法支持主动的、SLO 感知的自动扩缩容:
|
||||||
|
|
||||||
|
- **HPA/KEDA**:标准 Kubernetes 原生扩缩容,使用 EPP 导出的指标(如队列深度)。
|
||||||
|
- **Workload Variant Autoscaler (WVA)**:全局优化的扩缩容,通过在不同 variant 之间或跨推理池放置副本,在满足延迟目标的同时最小化成本。
|
||||||
|
|
||||||
|
参见 Autoscaling 了解完整细节。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
> 文档版本:llm-d 0.8(Docusaurus 文档站,CNCF 托管项目)。llm-d 是 Kubernetes 原生的分布式推理服务栈,使用 vLLM 作为模型服务引擎,Inference Gateway 作为请求调度器与负载均衡器,Kubernetes 作为基础设施编排与控制平面,面向大规模生产环境的 P/D 分离、分布式 KV Cache 与 SLO 感知调度。
|
||||||
@@ -0,0 +1,85 @@
|
|||||||
|
# 📊 文章摘要:llm-d:K8s 原生分布式推理栈架构
|
||||||
|
|
||||||
|
> **原文**:[2026-08-06_llm-d_K8s原生分布式推理栈架构.md](./2026-08-06_llm-d_K8s原生分布式推理栈架构.md)
|
||||||
|
> **原文链接**:https://llm-d.ai/docs/architecture
|
||||||
|
> **来源**:llm-d 官方文档(CNCF Sandbox 项目)
|
||||||
|
> **作者**:llm-d 项目团队(CNCF Sandbox)
|
||||||
|
> **发布日期**:2026-08-06
|
||||||
|
> **摘要日期**:2026-08-06
|
||||||
|
> **价值评级**:⭐⭐⭐ 高
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 核心命题
|
||||||
|
|
||||||
|
> **K8s 原生推理栈** — 用 Router(Proxy + EPP)、InferencePool(含 Variant 子分组)、Model Server 三个抽象,把 LLM 推理的调度、缓存、扩缩容全部收敛为 Kubernetes 原生的声明式模式。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 文章概要
|
||||||
|
|
||||||
|
本文是 CNCF Sandbox 项目 llm-d 的架构指南,系统阐述其三层核心组件:llm-d Router(Envoy L7 代理 + Endpoint Picker 路由引擎,基于实时指标、KV-cache 亲和性与策略打分选端)、InferencePool(按模型分组的"LLM 优化的 Service",Variant 通过 Pod 标签表达 prefill/decode 等服务角色)、Model Server(vLLM/SGLang 等推理引擎)。高级模式覆盖 KV Cache 管理(前缀缓存感知路由、事件驱动索引、CPU/SSD 分层卸载)、PD 分离编排(同时选择 prefill/decode 端点并协调 KV 传输)、基于 XGBoost 在线训练的延迟预测路由、批推理(Batch Gateway + Async Processor)与双通道扩缩容(HPA/KEDA + 全局优化的 Workload Variant Autoscaler)。价值在于提供了一套结构完整、可借鉴的 K8s 原生推理平台设计范式。局限在于全文为纯架构描述,无任何性能数据、对比实验或生产验证,且未讨论各模式之间的依赖关系与适用边界。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 关键要点
|
||||||
|
|
||||||
|
1. **三层抽象解耦清晰** — Router(路由决策)/ InferencePool(服务发现与分组)/ Model Server(算力执行)各司其职,将"面向 LLM 的调度逻辑"从基础设施中显式分离,是对传统 K8s Service 模式的 LLM 化扩展。 `[分类: 范式突破]`
|
||||||
|
|
||||||
|
2. **Variant 用标签表达服务角色** — prefill/decode、成本档位、性能档位等差异通过 Pod 标签而非专用资源表达,使同一 InferencePool 内可运行异构实例且无需新建 CRD 类型,设计轻巧。 `[分类: 共识]`
|
||||||
|
|
||||||
|
3. **KV cache 成为一等调度信号** — 前缀缓存感知路由 + 事件驱动 KV 索引 + 分层卸载(CPU/SSD),把"缓存命中率"纳入路由打分,这是 2025 年以来推理网关的公认演进方向。 `[分类: 共识]`
|
||||||
|
|
||||||
|
4. **SLO 感知的主动扩缩容** — WVA 在满足延迟目标的前提下跨 variant/跨池全局放置副本以最小化成本,与 HPA/KEDA 的反应式扩缩互补,代表了"成本最优 + SLO 驱动"的编排思路。 `[分类: 未探索]`
|
||||||
|
|
||||||
|
5. **无验证数据是硬伤** — 全文档零基准测试、零生产案例,XGBoost 延迟预测的在线训练稳定性、EPP 打分开销、PD 分离下的传输瓶颈等关键工程问题均未触及,方案成熟度无从判断。 `[分类: 未探索]`
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 批判性分析
|
||||||
|
|
||||||
|
### 假设前提
|
||||||
|
|
||||||
|
- 假设集群以 Kubernetes 为唯一控制平面,且团队具备 K8s 运维能力(Envoy、HPA/KEDA、CRD 生态);
|
||||||
|
- 假设以 vLLM 为默认引擎(其 EPP 协议、KV connector 机制是设计底座),其他引擎支持依赖社区生态;
|
||||||
|
- 假设"LLM 感知的集中式路由"在超大规模集群上的扩展性成立——文档未讨论 EPP 作为单点路由引擎的性能边界。
|
||||||
|
|
||||||
|
### 论据与逻辑
|
||||||
|
|
||||||
|
- 架构叙述内部自洽、模式描述符合业界主流实践(与 vLLM 的 KV connector、IGW 的 EPP 协议等既有机制对应),可视为对社区方案的整合与提炼,论据质量在于"结构可信"而非"数据可信"——没有任何性能数字或对比实验支撑其宣称的"最快落地速度""大规模生产环境"等表述,这些属于项目宣传口径。
|
||||||
|
|
||||||
|
### 边界与局限
|
||||||
|
|
||||||
|
- 适用场景:中型以上团队自建 LLM 推理平台时的架构蓝图参考;对 K8s 熟悉度高、愿意接受 CRD/Operator 生态的团队。
|
||||||
|
- 不适用于:单机/小集群简单部署(复杂度不划算)、对延迟极度敏感且需绕过 K8s 调度开销的场景、非 K8s 基础设施环境。
|
||||||
|
- 高级模式(延迟预测、WVA)均标注为可选扩展,但其交互关系(如延迟预测与 KV 亲和路由的优先级冲突)未说明。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 可引用金句
|
||||||
|
|
||||||
|
> "llm-d 是 Kubernetes 原生的分布式推理服务栈,使用 vLLM 作为模型服务引擎,Inference Gateway 作为请求调度器与负载均衡器,Kubernetes 作为基础设施编排与控制平面。"
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 总体评价
|
||||||
|
|
||||||
|
**亮点**:
|
||||||
|
- 三层抽象 + Variant 设计结构清晰,是 K8s 原生推理平台的可直接借鉴的架构范式
|
||||||
|
- 将 KV cache、SLO、成本三个维度显式纳入调度决策,覆盖了业界最新关注点
|
||||||
|
- CNCF Sandbox 托管 + 0.8 版本迭代,项目活跃度可信
|
||||||
|
|
||||||
|
**不足**:
|
||||||
|
- 零性能数据、零对比实验、零生产案例,无法评估方案真实收益
|
||||||
|
- 未讨论 EPP 单点扩展性、延迟预测在线学习稳定性等关键工程边界
|
||||||
|
- "可选高级模式"之间的依赖与取舍缺乏说明
|
||||||
|
|
||||||
|
**适用场景**:K8s 工程团队设计 LLM 推理平台时的架构参考;对比 AIBrix、Dynamo 等同类方案时的横向认知材料;技术选型评审的输入之一。
|
||||||
|
|
||||||
|
**关联建议**:对照阅读 AIBrix(字节跳动,K8s 原生)、NVIDIA Dynamo(Planner/路由/KV 管理四组件)与 vLLM 官方 KV Connector 文档,横向比较三者对"路由、缓存、扩缩容"三大问题的解决路径;关注 llm-d 后续版本是否补充基准数据。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 配图
|
||||||
|
|
||||||
|

|
||||||
@@ -0,0 +1,143 @@
|
|||||||
|
# Disaggregated Prefilling (experimental) - vLLM
|
||||||
|
|
||||||
|
> **来源**:vLLM 官方文档
|
||||||
|
> **作者**:未知
|
||||||
|
> **发布日期**:2026-07-29
|
||||||
|
> **原文链接**:https://docs.vllm.ai/en/latest/features/disagg_prefill/
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
# Disaggregated Prefilling (experimental)
|
||||||
|
|
||||||
|
This page introduces you to the disaggregated prefilling feature in vLLM.
|
||||||
|
|
||||||
|
Note
|
||||||
|
|
||||||
|
This feature is experimental and subject to change.
|
||||||
|
|
||||||
|
## Why disaggregated prefilling?
|
||||||
|
|
||||||
|
Two main reasons:
|
||||||
|
|
||||||
|
- __Tuning time-to-first-token (TTFT) and inter-token-latency (ITL) separately__. Disaggregated prefilling put prefill and decode phase of LLM inference inside different vLLM instances. This gives you the flexibility to assign different parallel strategies (e.g. `tp` and `pp`) to tune TTFT without affecting ITL, or to tune ITL without affecting TTFT.
|
||||||
|
- __Controlling tail ITL__. Without disaggregated prefilling, vLLM may insert some prefill jobs during the decoding of one request. This results in higher tail latency. Disaggregated prefilling helps you solve this issue and control tail ITL. Chunked prefill with a proper chunk size also can achieve the same goal, but in practice it's hard to figure out the correct chunk size value. So disaggregated prefilling is a much more reliable way to control tail ITL.
|
||||||
|
|
||||||
|
Note
|
||||||
|
|
||||||
|
Disaggregated prefill DOES NOT improve throughput.
|
||||||
|
|
||||||
|
## Usage example
|
||||||
|
|
||||||
|
Now supports 9 types of connectors:
|
||||||
|
|
||||||
|
- __ExampleConnector__: refer to examples/disaggregated/example_connector/run.sh for the example usage of ExampleConnector disaggregated prefilling.
|
||||||
|
- __LMCacheConnectorV1__: refer to examples/disaggregated/lmcache/disagg_prefill_lmcache_v1/disagg_example_nixl.sh for the example usage of LMCacheConnectorV1 disaggregated prefilling which uses NIXL as the underlying KV transmission. LMCache also offers a multi-process (MP) mode via `LMCacheMPConnector`, where a standalone `lmcache server` holds the KV cache shared by one or more vLLM instances; see the LMCache examples and the LMCache docs for setup.
|
||||||
|
- __NixlConnector__: refer to tests/v1/kv_connector/nixl_integration/run_accuracy_test.sh for the example usage of NixlConnector disaggregated prefilling which support fully async send/recv. For detailed usage guide, see NixlConnector Usage Guide. For feature compatibility details, see NixlConnector Compatibility Matrix. You may specify one or multiple NIXL transfer backends, such as:
|
||||||
|
|
||||||
|
```
|
||||||
|
--kv-transfer-config '{"kv_connector":"NixlConnector","kv_role":"kv_both", "kv_buffer_device":"cuda", "kv_connector_extra_config":{"backends":["UCX", "GDS"]}}'
|
||||||
|
```
|
||||||
|
|
||||||
|
- __MooncakeConnector__: refer to examples/disaggregated/mooncake_connector/run_mooncake_connector.sh for the example usage of MooncakeConnector disaggregated prefilling. For detailed usage guide, see MooncakeConnector Usage Guide.
|
||||||
|
- __MoRIIOConnector__ (ROCm only): see MoRI-IO Usage Guide for example usage and detailed documentation.
|
||||||
|
- __MultiConnector__: take advantage of the kv_connector_extra_config: dict[str, Any] already present in KVTransferConfig to stash all the connectors we want in an ordered list of kwargs.such as:
|
||||||
|
|
||||||
|
```
|
||||||
|
--kv-transfer-config '{"kv_connector":"MultiConnector","kv_role":"kv_both","kv_connector_extra_config":{"connectors":[{"kv_connector":"NixlConnector","kv_role":"kv_both"},{"kv_connector":"ExampleConnector","kv_role":"kv_both","kv_connector_extra_config":{"shared_storage_path":"local_storage"}}]}}'
|
||||||
|
```
|
||||||
|
|
||||||
|
- __OffloadingConnector__: enable offloading of KV data to CPU memory, customizing the CPU block size (in tokens) and total CPU memory bytes to allocate:
|
||||||
|
|
||||||
|
```
|
||||||
|
--kv-transfer-config '{"kv_connector":"OffloadingConnector","kv_role":"kv_both","kv_connector_extra_config":{"block_size": 64, "cpu_bytes_to_use": 1000000000}}'
|
||||||
|
```
|
||||||
|
|
||||||
|
For multi-tier offloading (e.g., CPU + filesystem tier) and the full configuration reference, see the KV Offloading Usage Guide.
|
||||||
|
|
||||||
|
- __FlexKVConnectorV1__: refer to examples/disaggregated/flexkv_connector/prefix_caching_flexkv.py for the example usage of FlexKVConnectorV1. FlexKV is a distributed KV Store and multi-level cache management system for ultra-large-scale LLM inference.
|
||||||
|
|
||||||
|
```
|
||||||
|
--kv-transfer-config '{"kv_connector":"FlexKVConnectorV1","kv_role":"kv_both"}'
|
||||||
|
```
|
||||||
|
|
||||||
|
## Reusing prefill token ids on decode
|
||||||
|
|
||||||
|
Note
|
||||||
|
|
||||||
|
This applies to disaggregated prefill and decode serving on the `/v1/chat/completions` endpoint, using a KV connector configured as in the Usage example above. It is experimental and subject to change.
|
||||||
|
|
||||||
|
In disaggregated serving, the prefill and decode stages both render the chat prompt from `messages` and tokenize it. Because the prefill stage has already produced the token ids, the decode stage can reuse them and skip its own templating and tokenization. The output is otherwise identical to a normal chat completion: it is detokenized to text, and tool and reasoning parsing, streaming, and structured output constraints all still apply.
|
||||||
|
|
||||||
|
The token ids are passed to the decode stage through `kv_transfer_params`, the dict already attached to the decode request to coordinate the transfer:
|
||||||
|
|
||||||
|
1. Send the prefill request with `return_token_ids` enabled, and read `prompt_token_ids` from the response.
|
||||||
|
2. Set `kv_transfer_params["prompt_token_ids"]` to those ids on the decode request. `messages` is still required, but its content is not tokenized when the ids are present.
|
||||||
|
|
||||||
|
```
|
||||||
|
prefill = client.chat.completions.create(
|
||||||
|
model=model,
|
||||||
|
messages=messages,
|
||||||
|
extra_body={"return_token_ids": True, "kv_transfer_params": {"do_remote_decode": True}},
|
||||||
|
)
|
||||||
|
ids = prefill.prompt_token_ids
|
||||||
|
|
||||||
|
decode = client.chat.completions.create(
|
||||||
|
model=model,
|
||||||
|
messages=messages,
|
||||||
|
stream=True,
|
||||||
|
extra_body={"kv_transfer_params": {"do_remote_prefill": True, "prompt_token_ids": ids}},
|
||||||
|
)
|
||||||
|
```
|
||||||
|
|
||||||
|
## Development
|
||||||
|
|
||||||
|
We implement disaggregated prefilling by running 2 vLLM instances. One for prefill (we call it prefill instance) and one for decode (we call it decode instance), and then use a connector to transfer the prefill KV caches and results from prefill instance to decode instance.
|
||||||
|
|
||||||
|
All disaggregated prefilling implementation is under `vllm/distributed/kv_transfer`.
|
||||||
|
|
||||||
|
Key abstractions for disaggregated prefilling:
|
||||||
|
|
||||||
|
- __Connector__: Connector allows __kv consumer__ to retrieve the KV caches of a batch of request from __kv producer__.
|
||||||
|
- __LookupBuffer__: LookupBuffer provides two API: `insert` KV cache and `drop_select` KV cache. The semantics of `insert` and `drop_select` are similar to SQL, where `insert` inserts a KV cache into the buffer, and `drop_select` returns the KV cache that matches the given condition and drop it from the buffer.
|
||||||
|
- __Pipe__: A single-direction FIFO pipe for tensor transmission. It supports `send_tensor` and `recv_tensor`.
|
||||||
|
|
||||||
|
Note
|
||||||
|
|
||||||
|
`insert` is non-blocking operation but `drop_select` is blocking operation.
|
||||||
|
|
||||||
|
Here is a figure illustrating how the above 3 abstractions are organized:
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
The workflow of disaggregated prefilling is as follows:
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
The `buffer` corresponds to `insert` API in LookupBuffer, and the `drop_select` corresponds to `drop_select` API in LookupBuffer.
|
||||||
|
|
||||||
|
Now every process in vLLM will have a corresponding connector. Specifically, we have:
|
||||||
|
|
||||||
|
- Scheduler connector: the connector that locates in the same process as the scheduler process. It schedules the KV cache transfer ops.
|
||||||
|
- Worker connectors: the connectors that locate in the worker processes. They execute KV cache transfer ops.
|
||||||
|
|
||||||
|
Here is a figure illustrating how the above 2 connectors are organized:
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
The figure below shows how the worker connector works with the attention module to achieve layer-by-layer KV cache store and load:
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
## Third-party contributions
|
||||||
|
|
||||||
|
Disaggregated prefilling is highly related to infrastructure, so vLLM relies on third-party connectors for production-level disaggregated prefilling (and vLLM team will actively review and merge new PRs for third-party connectors).
|
||||||
|
|
||||||
|
We recommend three ways of implementations:
|
||||||
|
|
||||||
|
- __Fully-customized connector__: Implement your own `Connector`, and call third-party libraries to send and receive KV caches, and many many more (like editing vLLM's model input to perform customized prefilling, etc.). This approach gives you the most control, but at the risk of being incompatible with future vLLM versions.
|
||||||
|
- __Database-like connector__: Implement your own `LookupBuffer` and support the `insert` and `drop_select` APIs just like SQL.
|
||||||
|
- __Distributed P2P connector__: Implement your own `Pipe` and support the `send_tensor` and `recv_tensor` APIs, just like `torch.distributed`.
|
||||||
|
|
||||||
|
|
||||||
|
Back to top
|
||||||
|
|
||||||
@@ -0,0 +1,80 @@
|
|||||||
|
# 📊 文章摘要:Disaggregated Prefilling (experimental) - vLLM
|
||||||
|
|
||||||
|
> **原文**:[2026-07-29_Disaggregated_Prefilling_experimental_vLLM.md](./2026-07-29_Disaggregated_Prefilling_experimental_vLLM.md)
|
||||||
|
> **原文链接**:https://docs.vllm.ai/en/latest/features/disagg_prefill/
|
||||||
|
> **来源**:vLLM 官方文档
|
||||||
|
> **作者**:未知
|
||||||
|
> **发布日期**:2026-07-29
|
||||||
|
> **摘要日期**:2026-08-06
|
||||||
|
> **价值评级**:⭐⭐ 中
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 核心命题
|
||||||
|
|
||||||
|
> **预填充与解码分离** — 将 prefill 与 decode 阶段部署在不同 vLLM 实例、通过 KV 传输连接器协同,以独立调优 TTFT/ITL 并控制尾部延迟
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 文章概要
|
||||||
|
|
||||||
|
本文是 vLLM 官方文档,介绍实验性的分离式预填充(disaggregated prefilling)特性:将 LLM 推理的 prefill(预填充)与 decode(解码)阶段分别部署在两个 vLLM 实例中,通过连接器(Connector)把 KV cache 从 prefill 实例传输到 decode 实例,从而实现两个目标的独立调优——TTFT(首 token 延迟)与 ITL(token 间延迟),以及控制尾部 ITL(避免 decode 期间插入 prefill 任务导致尾延迟升高)。文档明确声明该特性不提升吞吐,并给出 9 种传输连接器(Nixl/Mooncake/FlexKV/LMCache/Offloading 等)、三大核心抽象(Connector/LookupBuffer/Pipe)与三方实现路径。其价值在于这是分离式推理架构的权威落地参考;局限是纯架构文档,无性能基准数据,生产级实现依赖第三方连接器。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 关键要点
|
||||||
|
|
||||||
|
1. **分离的两个动机** — 一是独立调优 TTFT 与 ITL(可为 prefill 与 decode 实例配置不同并行策略如 tp/pp 而不互相影响);二是控制尾部 ITL(chunked prefill 也能达到但 chunk size 难以调准,分离式更可靠)`[分类: 共识]`
|
||||||
|
2. **明确边界:不提升吞吐** — 文档以警示形式声明 "Disaggregated prefill DOES NOT improve throughput",避免用户误用;其收益在延迟控制与资源分配灵活性 `[分类: 范式突破]`(反直觉的官方边界声明,值得注意)
|
||||||
|
3. **9 种 KV 传输连接器** — 覆盖多条技术路线:NixlConnector(异步 send/recv,UCX/GDS 后端)、MooncakeConnector、MoRIIOConnector(ROCm)、FlexKV(分布式 KV 存储)、LMCacheConnectorV1(含 MP 模式)、OffloadingConnector(KV 卸载至 CPU)、MultiConnector(组合)等 `[分类: 共识]`(生态处于快速演进中)
|
||||||
|
4. **三大核心抽象** — Connector(kv producer/consumer 间的 KV 检索)、LookupBuffer(SQL 式 `insert`/`drop_select` 语义)、Pipe(单向 FIFO 张量管道 `send_tensor`/`recv_tensor`);`insert` 非阻塞、`drop_select` 阻塞 `[分类: 范式突破]`(可复用的架构设计)
|
||||||
|
5. **decode 阶段复用 prefill token ids** — 经 `kv_transfer_params` 传递 `prompt_token_ids`,decode 实例跳过模板化与 tokenization;输出与普通对话一致,工具解析/流式/结构化输出约束仍生效 `[分类: 共识]`
|
||||||
|
6. **三种第三方实现路径** — 完全定制 Connector(控制力最强但可能与未来版本不兼容)/ 数据库式 LookupBuffer / 分布式 P2P Pipe;vLLM 团队声明生产级实现依赖第三方贡献并会积极合入 PR `[分类: 未探索]`(生态治理模式本身是开放性话题)
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 批判性分析
|
||||||
|
|
||||||
|
### 假设前提
|
||||||
|
|
||||||
|
文档默认读者接受以下前提:部署两套实例的额外基础设施与运维成本可接受;KV 跨机传输的带宽/延迟开销低于分离带来的收益;用户场景存在 TTFT 与 ITL 独立调优或尾部延迟控制的真实需求(如长上下文、交互式服务)。对单机或小规模部署,这些前提通常不成立。
|
||||||
|
|
||||||
|
### 论据与逻辑
|
||||||
|
|
||||||
|
作为工程文档,其结论(能控制尾部 ITL、不提升吞吐)来自架构层面的定性论证而非基准数据——全文没有任何性能对比数字,文档亦未声称做了 benchmark。"chunked prefill 的 chunk size 在实践中难以调准"这一论据是经验性陈述,缺乏数据支撑,但符合社区普遍观察。论点-实现(抽象设计)之间的对应关系清楚,逻辑链完整。
|
||||||
|
|
||||||
|
### 边界与局限
|
||||||
|
|
||||||
|
特性标注为 experimental and subject to change,接口可能变动;仅适用于配置了对应 KV 连接器的 `/v1/chat/completions` 端点(token 复用部分);生产级连接器依赖第三方(vLLM 团队不提供内置生产实现);对吞吐敏感而非延迟敏感的场景无收益,对部署复杂度敏感的小团队场景收益为负。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 可引用金句
|
||||||
|
|
||||||
|
> "Disaggregated prefill DOES NOT improve throughput."
|
||||||
|
|
||||||
|
> "Chunked prefill with a proper chunk size also can achieve the same goal, but in practice it's hard to figure out the correct chunk size value. So disaggregated prefilling is a much more reliable way to control tail ITL."
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 总体评价
|
||||||
|
|
||||||
|
**亮点**:
|
||||||
|
- 边界意识突出:开篇标注 experimental,并专门以警示形式澄清"不提升吞吐",避免工程误用
|
||||||
|
- 三大抽象(Connector/LookupBuffer/Pipe)简洁清晰,SQL 类比与 torch.distributed 类比降低了理解门槛
|
||||||
|
- 给出 9 种连接器与三种实现路径,为选型和自研提供明确地图
|
||||||
|
|
||||||
|
**不足**:
|
||||||
|
- 无任何性能基准或对比实验数据,收益大小需读者自行验证
|
||||||
|
- 中文社区读者需注意:文档为英文,示例以命令行配置为主,缺乏端到端的部署架构图(仅有内部组件图)
|
||||||
|
- 生态碎片化明显(9 种连接器并存),缺乏选型决策树
|
||||||
|
|
||||||
|
**适用场景**:大模型推理服务工程师、SRE 与架构师——尤其部署长上下文或交互式 LLM 服务、受尾部延迟困扰、或已在规划 prefill/decode 分离架构的团队;也适合需要为推理集群做资源隔离(prefill 与 decode 按需扩缩)的平台团队。
|
||||||
|
|
||||||
|
**关联建议**:结合 LMCache 博客(LMCacheConnector 的 MP 模式与 NVIDIA Dynamo 集成)阅读,了解 KV 缓存层在分离式推理中的生态位置;对照 Moonshot 的 Mooncake 项目(KVCache-centric 架构)理解分离式推理在超大集群中的完整形态;实践层面先跑通 examples/disaggregated/ 下的示例脚本再决定选型。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 配图
|
||||||
|
|
||||||
|

|
||||||
@@ -0,0 +1,188 @@
|
|||||||
|
# AI时代的最大误会:注意力不是你需要的一切
|
||||||
|
|
||||||
|
> **来源**:不懂经
|
||||||
|
> **作者**:不懂经也叔的Rust
|
||||||
|
> **发布日期**:2026-08-10
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/U1r3V-mh3zoCBbjzTB_xTg
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
2017 年,Google 的几位研究者发表了一篇后来改变 AI 历史的论文,标题叫《Attention Is All You Need》。
|
||||||
|
|
||||||
|
这句话现在几乎成了 AI 时代的咒语,注意力就是你所需要的一切。
|
||||||
|
|
||||||
|
它听起来像一句哲学断言,甚至像某种修行口诀,但它最初说的是一件非常具体的技术问题:在处理语言序列时,机器不必像过去那样一个词接一个词地往后读,也不必依赖复杂的循环结构,而是可以通过 attention 机制,在整个上下文里判断不同词之间的关系,再给它们分配不同权重。
|
||||||
|
|
||||||
|
这就是 Transformer 架构的核心。今天的大语言模型、聊天机器人、代码生成工具、图像生成系统,背后都绕不开这场技术转向。
|
||||||
|
|
||||||
|
机器突然变得"像是在理解",不是因为它拥有了人类意义上的意识,而是因为它学会了一种更有效的"看法":在庞大的信息场里,判断什么和什么有关,什么应该被赋予更高权重。
|
||||||
|
|
||||||
|
而更早一些时候,另一个世界也在围绕注意力疯狂运转。社交媒体、短视频、推荐算法、广告系统、自媒体、个人 IP,都建立在一个共同前提上:谁能抓住注意力,谁就能获得流量、金钱、影响力和权力。
|
||||||
|
|
||||||
|
于是,注意力成了这个时代最拥挤的词。平台把它当作商业资源,AI 把它当作计算机制,自我管理系统把它当作生产力工具,普通人则每天抱怨自己的注意力越来越差。
|
||||||
|
|
||||||
|
这个时代从来没有这么迷恋过注意力,也从来没有这么误解过它。机器也许可以只需要注意力,但人不一样。
|
||||||
|
|
||||||
|
最近在《哈泼斯》杂志上看到一篇文章,其中提到西蒙娜·韦依的一句话,提供了关于注意力的另外一个视角,非常有启发,和大家分享下。
|
||||||
|
|
||||||
|
## 一、注意力经济把人变成资源
|
||||||
|
|
||||||
|
注意力经济最早的洞察并不复杂。美国经济学家赫伯特·西蒙在1997就说过,信息消耗的东西很明显,就是接收者的注意力。信息越丰富,注意力越贫困。
|
||||||
|
|
||||||
|
这句话在互联网时代几乎变成常识。过去,人类长期面对的是信息稀缺。知识被锁在书本、大学、图书馆、报纸和少数权威机构里。互联网出现之后,问题突然反过来了:信息多到无法处理,观点多到无法判断,刺激多到无法消化。
|
||||||
|
|
||||||
|
平台当然不会把这种状态理解成危机。对它来说,这是商业模式成立的前提。你的每一次点击、停留、滑动、转发、评论,都可以被记录、量化、建模,然后转化成广告系统和推荐系统的燃料。
|
||||||
|
|
||||||
|
平台关心的不是你是否理解了世界,而是你有没有留下来。它不需要你变得更清醒,只需要你持续刷下去。愤怒比平静更值钱,阴谋比常识更有传播力,极端比审慎更容易被推荐。
|
||||||
|
|
||||||
|
算法未必有邪恶意志,它只是忠实追逐一个指标:参与度。
|
||||||
|
|
||||||
|
这也是为什么很多人明明知道自己不该刷,却还是停不下来。问题不只是"自制力差",而是你面对的系统,本来就是为了绕开你的自制力而设计的。它研究你的冲动、疲惫、孤独、愤怒和虚荣,然后在你最容易松动的地方点火。
|
||||||
|
|
||||||
|
更深一层,注意力经济并不满足于占用你的时间,它还会改变你的欲望。一个人每天被什么东西召唤,就会慢慢习惯被什么东西召唤。你反复看愤怒,愤怒就会成为理解世界的默认姿势。你反复看比较,比较就会成为理解自我的默认姿势。你反复看即时反馈,就会越来越难忍受没有回报的等待。
|
||||||
|
|
||||||
|
很多人说自己注意力差,其实真正变差的是欲望结构。他们不是单纯无法专注,而是越来越难对缓慢、复杂、无即时奖励的东西产生真实兴趣。浪费时间只是表层损耗,更麻烦的是,内在奖励系统已经被外部系统重新训练过了。
|
||||||
|
|
||||||
|
## 二、AI把注意力变成了计算机制
|
||||||
|
|
||||||
|
AI 进一步加深了这种误解。
|
||||||
|
|
||||||
|
在 Transformer 模型里,attention 是一种极其有效的数学机制。一个词被转换成向量之后,会和其他词发生关系。模型计算这些关系,再决定哪些信息应该被保留,哪些信息应该被弱化。它处理的是权重,是相关性,是上下文里的连接强度。
|
||||||
|
|
||||||
|
这套机制强大到改变了世界。它让机器可以在长文本里捕捉复杂关系,把相隔很远的信息连接起来,可以在生成下一个词之前,调动整个上下文。换句话说,AI 的 attention 让机器学会了如何在信息里分配重要性。
|
||||||
|
|
||||||
|
但人的注意力不只是这个东西。
|
||||||
|
|
||||||
|
机器的 attention 解决的是相关性问题,人的 attention 解决的是朝向问题。AI 可以知道一句话里哪些词彼此相关,却不知道一个痛苦的人为什么不能被轻轻带过。
|
||||||
|
|
||||||
|
AI 可以判断某段上下文里哪个信息最有用,却不知道什么值得一个人用一生去凝视。AI 可以生成关于善、爱、真理、信仰的漂亮段落,但没有任何东西会在它那里成为负担、承诺或命运。
|
||||||
|
|
||||||
|
这不是贬低 AI。相反,正因为 AI 在处理信息层面越来越强,我们才更需要区分两种完全不同的注意力:一种负责加工信息,另一种负责改变人。
|
||||||
|
|
||||||
|
今天的危险在于,我们正在用第一种注意力替代第二种注意力。我们越来越熟悉如何让 AI 处理资料、总结文章、提炼观点、生成方案。我们在提示词里告诉模型:请关注这些重点,请忽略那些噪音,请按照这个目标组织输出。看起来,我们变得更会使用注意力了。
|
||||||
|
|
||||||
|
可人的问题从来不只是"该把信息权重分配给谁"。人的问题还包括:我愿意被什么东西改变?
|
||||||
|
|
||||||
|
我们是否能面对一个不服务于我的真相?能不能长时间看着一件无利可图、无法炫耀、短期没有反馈的东西?
|
||||||
|
|
||||||
|
AI 可以帮我们加工世界,却不能替我们感受世界。
|
||||||
|
|
||||||
|
## 三、韦伊说的注意力,不是现代人理解的专注
|
||||||
|
|
||||||
|
我最近在 Harper's 杂志上看到一篇关于意志力的文章,其中提到法国思想家西蒙娜·韦伊的一句话,给了我很大启发。韦伊说,我们必须尝试用注意力,而不是意志,来疗愈自己的过错。
|
||||||
|
|
||||||
|
这句话很容易被读成一种心灵鸡汤,好像她是在说,不要太用力,要放松一点,要多觉察自己。这样理解有点浅了。
|
||||||
|
|
||||||
|
韦伊讲的"过错",并不是日常小毛病,而更接近一种灵魂结构上的失序:成瘾、自我憎恨、信仰动摇、无法停止的自毁冲动,以及那些你明明知道不该做,却还是一遍遍回去做的事情。
|
||||||
|
|
||||||
|
Harper's 那篇文章的作者,年轻时曾长期酗酒,后来戒酒多年,又在中年时秘密复饮了将近一年。她也曾经离开自己成长于其中的基要主义信仰,后来又尝试成为天主教徒。她非常清楚酒精和某种宗教结构曾经如何伤害她,也非常清楚自己并不想再回到那些旧陷阱里。
|
||||||
|
|
||||||
|
问题是,仅仅知道并没有用。
|
||||||
|
|
||||||
|
她真正面对的并不是无知,而是意志的分裂。我们很多人都是如此。
|
||||||
|
|
||||||
|
她不是不知道什么是好,也不是完全不想变好。恰恰相反,她太想变好了。她想要清醒,也想要消失;想要自由,也想要被某种熟悉的东西吞没;想要一条更好的生活,也想要旧陷阱里那种已经知道结局的安慰。
|
||||||
|
|
||||||
|
现代人处理这类问题,第一反应通常是意志力。我要戒掉,要控制,要战胜自己,要变成更好的人。这套语言听起来积极,背后却隐藏着一个危险结构:它把人理解成一个可以被自我管理系统修好的项目。
|
||||||
|
|
||||||
|
如果失败,那就是你执行不够。如果复发,那就是你意志太弱。如果做不到,那就是你还不够想要。可是,很多最深的失败,恰恰发生在一个人非常想变好的时候。失败不是因为欲望太少,而是因为欲望太多,方向太乱,自我内部同时站着几个发号施令的人。
|
||||||
|
|
||||||
|
所谓意志薄弱,很多时候不是匮乏,而是过剩。
|
||||||
|
|
||||||
|
你想喝酒,也想戒酒。你想刷手机,也想成为一个深度阅读的人。你想获得即时刺激,也想拥有长期作品。你想逃避现实,也想成为一个能承担现实的人。
|
||||||
|
|
||||||
|
这个时候,如果继续用意志力解决问题,就像让一支分裂的军队继续打内战。你越用力,消耗越大;你越想赢,越证明那场战争还在继续。
|
||||||
|
|
||||||
|
韦伊提供的不是另一种更高效的控制术。她不是问你如何战胜欲望,而是问你能不能学会欲望别的东西。
|
||||||
|
|
||||||
|
## 四、注意力不是用力,而是等待
|
||||||
|
|
||||||
|
这就进入了韦伊所谓注意力最难理解的部分。韦伊说的 attention,不是今天商业社会讲的 focus。
|
||||||
|
|
||||||
|
Focus 属于生产力语言。它关心你能不能排除干扰、完成任务、提高效率,把一个小时变成更高产出的一个小时。韦伊说的 attention 更接近一种等待,一种把自我放低的姿态,一种不急着索取、不急着占有、不急着把对象变成工具的能力。
|
||||||
|
|
||||||
|
她在谈学习时说,学业真正的目的,不只是拿高分、通过考试、赢得成功,而是训练一种注意力。解一道几何题,本身未必多么神圣,但它可以训练一个人面对真理时的姿势:耐心、谦卑、持续、不走捷径。
|
||||||
|
|
||||||
|
这和我们今天对学习的理解几乎相反。今天的学习越来越像信息提取。读一本书,是为了提炼观点;听一门课,是为了拿到方法;看一篇文章,是为了获得谈资。甚至连哲学和宗教,也很容易被处理成更高级的自我优化材料。
|
||||||
|
|
||||||
|
我读韦伊,是为了缓解焦虑;学冥想,是为了提高效率;研究信仰,是为了获得内在稳定;训练注意力,是为了工作表现更好。
|
||||||
|
|
||||||
|
这样做的问题不在于功利,人当然可以有功利目标。问题在于,当你总是把一切东西变成"对我有什么用",你就永远无法真正注意它。
|
||||||
|
|
||||||
|
你只是在使用它。
|
||||||
|
|
||||||
|
韦伊意义上的注意力,恰恰要求人暂时停止这种使用冲动。看一件事,不是为了马上提炼方法;面对一个人,不是为了迅速归类;读一句话,不是为了把它变成社交媒体上的金句。你只是看着它,等着它,让它以自己的样子出现。
|
||||||
|
|
||||||
|
这很难做到,因为人的自我天然会投射、解释、占有、辩护。我们看见一个人受苦,马上想把他放进某个类别:弱者、失败者、受害者,或者活该如此的人。我们看见一个观点,马上判断它是否支持自己原来的立场。我们看见一段经历,马上问它能不能转化成自己的素材。
|
||||||
|
|
||||||
|
我们的自我太勤奋了,它永远停不下来。它总是在世界出现之前,抢先把世界改写成自己的版本。韦伊说的注意力,就是让这个自我退后一步。
|
||||||
|
|
||||||
|
## 五、注意力改变的不是行为,而是欲望的方向
|
||||||
|
|
||||||
|
这也解释了为什么注意力能疗愈过错。它并不是直接修正行为,而是改变欲望的方向。
|
||||||
|
|
||||||
|
一个人无法靠命令自己喜欢某个东西,来真的喜欢上它。你不能靠意志力爱一个人,不能靠意志力相信上帝,不能靠意志力拥有创造力,也不能靠意志力从成瘾里彻底出来。你可以命令身体做事,比如把手放在桌上、站起来、关掉手机、删除 App,但你很难命令灵魂转向。
|
||||||
|
|
||||||
|
灵魂需要被吸引。
|
||||||
|
|
||||||
|
注意力真正发生作用的地方就在这里。你长期看向什么,什么就会在你的内在世界里获得重量。你每天回到什么,什么就会慢慢塑造你的欲望。你持续凝视什么,什么就会成为你判断世界的中心。
|
||||||
|
|
||||||
|
平台知道这一点,所以它不断让你看向刺激。广告系统知道这一点,所以它不断让你看向缺失。AI 产品知道这一点,所以它不断让你看向更快、更顺、更轻松的答案。韦伊也知道这一点,但她把这个机制从商业和控制那里夺了回来。
|
||||||
|
|
||||||
|
她说,如果我们把心智转向善,久而久之,整个灵魂会被它吸引。这句话不适合被理解成鸡汤,它更像一种严酷的现实主义。
|
||||||
|
|
||||||
|
人不是抽象地变好。人是通过每天看向某些东西,慢慢变成会被那些东西吸引的人。
|
||||||
|
|
||||||
|
如果你每天看的是热点,你会变成即时反馈机器。如果你每天看的是排名,你会变成攀比装置。如果你每天看的是流量,你会开始相信只有被看见的东西才存在。
|
||||||
|
|
||||||
|
反过来也一样。如果你每天看向复杂而诚实的文本,你会慢慢长出承受复杂的能力。如果你每天看向真实的人,而不是人设和标签,你会慢慢恢复同情。如果你每天看向一种比自我更大的秩序,你会慢慢不再把自己的情绪当成宇宙中心。
|
||||||
|
|
||||||
|
注意力不是中性的,它会把你带向某个地方。
|
||||||
|
|
||||||
|
## 六、AI 时代真正危险的,是注意力被降级
|
||||||
|
|
||||||
|
很多人说 AI 和短视频让人注意力下降。这个说法没错,但还不够深刻。
|
||||||
|
|
||||||
|
短视频、即时消息、社交媒体、无限刷屏,确实在把人的认知系统切成碎片。很多人已经很难完整读完一本书,很难独自想一个问题超过半小时,也很难忍受没有反馈的空白。
|
||||||
|
|
||||||
|
但更深的危机不是注意力变短,而是注意力被降级了,从人的维度降到了机器的维度。
|
||||||
|
|
||||||
|
它被降级成一种可计量资源:停留时长、完播率、点击率、互动率。它被降级成一种计算机制:query、key、value、权重分配、上下文窗口。它被降级成一种生产力技巧:番茄钟、深度工作、信息节食、专注训练。
|
||||||
|
|
||||||
|
这些东西都有价值,但它们都没有碰到韦伊关心的核心。她关心的不是你能不能盯住一个任务,而是你能不能让世界摆脱你的投射;不是你能不能排除干扰,而是你能不能把自己从中心位置挪开;不是你能不能更有效率地处理信息,而是你能不能被真理、善和他人重新教育。
|
||||||
|
|
||||||
|
这也是为什么注意力和意志力的差别如此关键。意志力的姿态是控制,注意力的姿态是接受。控制当然必要,没有控制,人会被冲动拖走。
|
||||||
|
|
||||||
|
可如果一个人的全部生活都建立在控制上,他会变得越来越硬,也越来越脆,非常容易崩溃和猝死。因为他始终把自己放在操作者的位置上:要管理欲望,要优化人生,要提高认知,要升级系统,最终我要成为更好的版本。
|
||||||
|
|
||||||
|
这套语言听起来很现代,底层却充满紧张。它让人永远像一个正在维修自己的工程师。韦伊让我们看到另一种可能:人也可以不是项目。人可以被某种东西吸引、等待、改变。
|
||||||
|
|
||||||
|
## 七、真正的注意力,是选择被什么改变
|
||||||
|
|
||||||
|
Harper's 那篇文章里有一个很好的细节。作者把韦伊那句话写在一张索引卡上,贴在书桌上方。她每天坐下来工作时都会看见它。起初,她以为只要看得足够久,就会突然理解,好像某种神秘的知识会从纸片里渗进灵魂。
|
||||||
|
|
||||||
|
后来她意识到,真正发生的也许不是理解。她是在调校自己的心智。
|
||||||
|
|
||||||
|
这个转变很微妙。现代人对理解有一种强烈占有欲。我们读一篇文章,就想提炼核心观点;读一本书,就想拿到思维模型;遇到一句深刻的话,就想马上把它变成可转述、可应用、可展示的东西。一旦理解完成,这件东西就被归档了。我们拥有了它,也结束了它。
|
||||||
|
|
||||||
|
韦伊式注意力恰恰相反。它不是马上把一句话吃掉,而是允许一句话长期悬在自己面前,不急于结案,不急于蒸馏成方法,也不急于证明自己已经懂了。
|
||||||
|
|
||||||
|
有些真理不是用来快速理解的,它们需要被反复返回。在一次次返回里,你不是获得了更多新信息,而是让同一个已经知道的真理,慢慢进入身体、欲望和行动。
|
||||||
|
|
||||||
|
这也是今天 AI 最难替代的部分。AI 可以总结韦伊,可以解释注意力,可以生成一篇关于注意力的文章,甚至可以模仿一个人沉思的语气。但它不能替你日复一日地回到那张索引卡前,不能替你在想逃跑的时候继续看着它,不能替你经历那种缓慢、无用、没有观众的调校。
|
||||||
|
|
||||||
|
这件事必须由人自己完成,因为只有人会被自己看见的东西改变。
|
||||||
|
|
||||||
|
AI 时代关于注意力的最大误会,不是我们低估了注意力,而是我们太高估了一种低版本的注意力。
|
||||||
|
|
||||||
|
我们以为只要能分配权重,就是智能;只要能抓住眼球,就是影响力;只要能保持专注,就是深度;只要能管理时间,就是掌控人生。
|
||||||
|
|
||||||
|
这些都只触及注意力的外壳。
|
||||||
|
|
||||||
|
更高版本的注意力,是一个人愿意把自己暴露在某种真实面前,并且不急着逃走。这在今天越来越稀缺,因为我们的环境鼓励一切东西迅速转化:转化成观点,转化成内容,转化成流量,转化成方案,转化成收益,转化成个人成长的证据。
|
||||||
|
|
||||||
|
真正的注意力常常没有这么快的回报。它更像等待,像守夜,像坐在一扇迟迟不开的门前。也像每天看同一句话,直到某一天发现,不是你理解了它,而是它终于改变了你想要什么。
|
||||||
|
|
||||||
|
机器也许真的只需要 attention。
|
||||||
|
|
||||||
|
但人不一样。人还需要知道,自己的注意力应该献给什么,自己要成为什么样的人。【懂】
|
||||||
@@ -0,0 +1,103 @@
|
|||||||
|
# 📊 文章摘要:AI时代的最大误会:注意力不是你需要的一切
|
||||||
|
|
||||||
|
> **原文**:[2026-08-10_AI时代的最大误会_注意力不是你需要的一切.md](./2026-08-10_AI时代的最大误会_注意力不是你需要的一切.md)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/U1r3V-mh3zoCBbjzTB_xTg
|
||||||
|
> **来源**:不懂经
|
||||||
|
> **作者**:不懂经也叔的Rust
|
||||||
|
> **发布日期**:2026-08-10
|
||||||
|
> **摘要日期**:2026-08-10
|
||||||
|
> **价值评级**:⭐⭐⭐ 高
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 核心命题
|
||||||
|
|
||||||
|
> **注意力降级** — AI 时代对注意力的最大误会,是把一种"负责改变人"的高版本注意力,降级为机器式的"加工信息"机制:可计量资源、权重分配、生产力技巧。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 文章概要
|
||||||
|
|
||||||
|
文章从 2017 年《Attention Is All You Need》切入:一句技术论文标题被上升为时代咒语,而人类正在用机器的注意力概念理解自己的注意力。作者区分两种注意力——一种加工信息(机器的 attention,解决相关性),一种改变人(韦伊式注意力,解决朝向),并论证今天的危险是用前者替代后者。文章借西蒙娜·韦伊(Harper's 杂志引述)提出:意志薄弱不是匮乏而是过剩,注意力不是用力而是等待,它改变的不是行为而是欲望的方向。核心论点是"注意力不是中性的,它会把你带向某个地方"——这也解释了为什么注意力经济与 AI 都在重塑人的欲望结构。局限在于全文是哲学论证与个人叙事,无实证支撑,且对"注意力降级"的断言带有自媒体式的绝对化。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 关键要点
|
||||||
|
|
||||||
|
1. **机器 attention 与人的注意力是两种东西** — attention 解决相关性(哪些词相关、权重如何分配),人的注意力解决朝向(我愿意被什么改变)。AI 能加工世界,不能替人感受世界 `[分类: 范式突破]`
|
||||||
|
2. **注意力差的本质是欲望结构被重训** — 注意力经济不只占用时间,还改变欲望:反复看愤怒就习惯愤怒,反复看即时反馈就难忍等待。浪费时间只是表层,内在奖励系统已被外部系统改写 `[分类: 共识]`
|
||||||
|
3. **意志薄弱不是匮乏,而是过剩** — 酗酒者"太想变好了":想要清醒也想要消失,自我内部站着几个发号施令的人。此时用意志力(控制)解决问题,就像让分裂的军队打内战,越用力消耗越大 `[分类: 范式突破]`
|
||||||
|
4. **韦伊式注意力不是 focus** — Focus 是生产力语言(排除干扰、提高产出);attention 是等待——把自我放低的姿态,不急着把对象变成工具。"当你总是把一切变成'对我有什么用',你就永远无法真正注意它,你只是在使用它" `[分类: 范式突破]`
|
||||||
|
5. **注意力改变欲望方向而非直接修正行为** — 人无法靠意志力命令灵魂转向(不能靠意志力爱一个人、拥有创造力)。你长期看向什么,什么就在内在世界获得重量——平台用此机制让你看向刺激,韦伊把同一机制夺回,让你看向善 `[分类: 范式突破]`
|
||||||
|
6. **更深的危机是注意力被降级,而非变短** — 被降级为可计量资源(停留时长、完播率)、计算机制(query/key/value、上下文窗口)、生产力技巧(番茄钟、深度工作)。控制型生活方式让人越来越硬也越来越脆,容易崩溃和猝死 `[分类: 范式突破]`
|
||||||
|
7. **AI 最难替代的是缓慢无回报的自我调校** — AI 能总结韦伊、模仿沉思语气,但不能替你日复一日回到那张索引卡前。有些真理需要被反复返回,直到"不是你理解了它,而是它终于改变了你想要什么" `[分类: 未探索方向]`
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 批判性分析
|
||||||
|
|
||||||
|
### 假设前提
|
||||||
|
|
||||||
|
- 假设一:注意力经济对欲望结构的塑造是不可逆的、系统性的("你反复看什么,就会习惯什么")——这是一个强因果假设,缺少个体差异与抵抗机制的讨论。
|
||||||
|
- 假设二:机器的 attention 与人的注意力是完全异质的,不可通约——技术侧(如深度学习研究者谈"机器注意力")未必同意这种截然二分。
|
||||||
|
- 假设三:韦伊的注意力观(来自基督教神秘主义传统)可以被世俗化移植为普适的现代人疗愈方案——原文中韦伊的原话语境是灵魂对善的朝向,作者做了相当大的语义迁移。
|
||||||
|
- 假设四:人对"改变"的需求优先于人对"效率"的需求——全文默认被注意力经济困扰的现代读者应当放弃控制叙事。
|
||||||
|
|
||||||
|
### 论据与逻辑
|
||||||
|
|
||||||
|
- 论据类型为哲学引证(西蒙娜·韦伊,二手转引自 Harper's)+ 个人/他者叙事(Harper's 作者戒酒经历)+ 一位经济学家引言(赫伯特·西蒙 1997)。没有任何实验、数据或系统观察支撑"注意力降级"的核心命题。
|
||||||
|
- 逻辑链条有跳跃:从"注意力经济改变欲望"到"意志薄弱=过剩",中间依赖 Harper's 单一案例外推;从"AI 解决相关性"到"人的注意力被降级",依赖概念类比而非实证。
|
||||||
|
- 值得肯定的是论证结构清晰:七节层层递进(经济→AI→哲学→实践→机制→危机→出路),且"机器也许真的只需要 attention,但人不一样"是对《Attention Is All You Need》最有力的反诘。
|
||||||
|
|
||||||
|
### 边界与局限
|
||||||
|
|
||||||
|
- 适用人群:被信息过载、成瘾行为、自我优化焦虑困扰的现代知识工作者——对这类人"意志薄弱=过剩"的洞察有真实临床感。
|
||||||
|
- 不适用场景:①纯粹的认知效率场景(信息检索、工作产出)中,机器式注意力分配完全够用,作者也承认"这些东西都有价值";②意志力真正匮乏者(如重度抑郁)——"注意力等待"可能成为不作为的合理化;③组织/社会层面——个体注意力自救无法对抗结构性算法设计。
|
||||||
|
- 未回应的重要反例:注意力经济批判者本身也在利用注意力变现(作者文末即推销付费网站与知识星球),这个自指矛盾未被讨论。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 可引用金句
|
||||||
|
|
||||||
|
> "注意力被降级了,从人的维度降到了机器的维度。"
|
||||||
|
|
||||||
|
> "所谓意志薄弱,很多时候不是匮乏,而是过剩。"
|
||||||
|
|
||||||
|
> "灵魂需要被吸引。"
|
||||||
|
|
||||||
|
> "AI 可以帮我们加工世界,却不能替我们感受世界。"
|
||||||
|
|
||||||
|
> "人不是抽象地变好。人是通过每天看向某些东西,慢慢变成会被那些东西吸引的人。"
|
||||||
|
|
||||||
|
> "注意力不是中性的,它会把你带向某个地方。"
|
||||||
|
|
||||||
|
> "我们以为只要能分配权重,就是智能;只要能抓住眼球,就是影响力;只要能保持专注,就是深度。"
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 总体评价
|
||||||
|
|
||||||
|
**亮点**:
|
||||||
|
- "注意力降级论"提供了一个解释当代认知困境的新框架:比"注意力变短"更深一层,且把 AI 的 attention、注意力经济、自我优化三种语境统一进一个批判
|
||||||
|
- "意志薄弱=过剩"是对主流自我管理话语(意志力、自律、战胜自己)的有力解毒,与当代心理学中关于自我控制耗竭的讨论形成呼应
|
||||||
|
- 对学习异化的观察极准:今天的学习越来越像信息提取,"读一本书是为了提炼观点"——这恰好是 AI 摘要时代每个知识工作者的自况
|
||||||
|
- 金句密度高,几乎每节都有可独立引用的句子
|
||||||
|
|
||||||
|
**不足**:
|
||||||
|
- 无实证支撑,"注意力降级"作为宏大断言缺少可检验性;单一戒酒案例支撑"意志=过剩"略显单薄
|
||||||
|
- 自媒体文风:绝对化断言多("它研究你的冲动、疲惫、孤独、愤怒和虚荣"),韦伊思想被大幅通俗化,可能丢失其神学语境的严谨性
|
||||||
|
- 自指矛盾:批判注意力经济的同时以注意力变现(文末付费推广);未回应"如何对抗被设计的系统"这一结构性问题,解决方案停留在个体修行层面
|
||||||
|
|
||||||
|
**适用场景**:AI 产品设计者、知识工作者、内容消费者反思自身注意力结构时的高价值参照;可作为"AI 与人性边界"讨论的引文来源。
|
||||||
|
|
||||||
|
**关联建议**:
|
||||||
|
- 西蒙娜·韦伊《扎根:人类责任宣言》——注意力的神学/哲学源头
|
||||||
|
- 赫伯特·西蒙(1997)注意力经济论述——本文的学术起点
|
||||||
|
- 《Attention Is All You Need》(Vaswani et al., 2017)——被本文反诘的技术文本
|
||||||
|
- 麦克卢汉"媒介即讯息"——同一作者知识星球提到的媒介理论,与"注意力改变欲望"可互证
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 配图
|
||||||
|
|
||||||
|

|
||||||

Binary file not shown.
|
After Width: | Height: | Size: 2.8 MiB |
@@ -0,0 +1,376 @@
|
|||||||
|
# 大模型推理优化关键技术与应用实践研究报告(2026年)
|
||||||
|
|
||||||
|
> **来源**:中国信通院
|
||||||
|
> **作者**:中国信息通信研究院人工智能研究所
|
||||||
|
> **发布日期**:2026-03-31
|
||||||
|
> **原文链接**:https://www.caict.ac.cn/kxyj/qwfb/ztbg/202604/P020260415615308750699.pdf
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
出版单位:中国信息通信研究院人工智能研究所、中国人工智能产业发展联盟,2026年3月。
|
||||||
|
|
||||||
|
**版权声明**:本报告版权属于中国信息通信研究院、中国人工智能产业发展联盟,并受法律保护。转载、摘编或利用其它方式使用本报告文字或者观点的,应注明"来源:中国信息通信研究院、中国人工智能产业发展联盟"。违反上述声明者,编者将追究其相关法律责任。
|
||||||
|
|
||||||
|
## 前言
|
||||||
|
|
||||||
|
大模型推理作为人工智能技术从实验室走向产业应用的"最后一公里",承载着将模型能力转化为实际业务价值、平衡服务质量与成本投入的核心使命。随着生成式 AI、智能体(Agent)、多模态交互等技术的爆发式发展,推理需求呈现指数级增长。行业数据显示,2025年全球大模型推理计算量较上年提升100倍以上,同时,推理预算也在持续攀升,成为企业规模化落地的关键瓶颈。与此同时,不同场景对推理服务的差异化诉求(如低时延、高并发、长上下文处理)日益凸显,传统单点优化技术已难以应对"效果-性能-成本"的多目标协同,亟需构建全链路、系统性的推理优化体系。
|
||||||
|
|
||||||
|
本报告立足产业实践与技术演进,系统梳理大模型推理优化的技术路径与落地脉络。首先,剖析推理优化催生背景与概念特性;梳理当前围绕多样化场景适配、算力成本平衡、模型特性适配的核心挑战,揭示产业落地痛点。然后,根据关键技术发展,拆解模型、引擎、系统三级优化体系的核心方法与适配逻辑;结合产业生态演进趋势,分析从单点优化到"模型-架构-场景"协同优化的发展方向。再次,通过金融、运营商、电力、农业等行业案例验证技术落地价值。最后,提出技术与产业展望与建议。
|
||||||
|
|
||||||
|
## 目录
|
||||||
|
|
||||||
|
1. 大模型推理优化概况
|
||||||
|
2. 大模型推理的主要挑战
|
||||||
|
3. 大模型推理优化关键技术(模型层面、引擎层面、系统层面)
|
||||||
|
4. 大模型推理优化应用实践
|
||||||
|
5. 大模型推理优化典型案例(金融、运营商、电力、司法检察、农畜领域)
|
||||||
|
6. 展望
|
||||||
|
|
||||||
|
## 一、大模型推理优化概况
|
||||||
|
|
||||||
|
大模型推理平台是指为千亿级参数模型提供高效推理服务的工程化基座,涵盖轻量化工具(如推理引擎、工具包)与集成化系统(如公有云服务、私有化部署系统、混合部署系统、边缘计算系统),一般通过"硬件-软件-模型-服务"的协同优化,实现高精度、低延迟、高并发与低成本的规模化服务输出,支持全场景AI服务化落地。随着大模型技术的飞速发展和企业智能化转型需求的不断攀升,大模型落地应用关注焦点正从训练环节转向推理环节。在此过程中,行业需求已从构建功能全面、用户友好且灵活的推理平台,逐步深化到解决实际落地中由"效果-性能-成本"构成的多目标协同难题。推理优化技术作为破解该难题的核心抓手,其重要价值正在大模型规模化应用中愈发凸显。
|
||||||
|
|
||||||
|
### (一)大模型推理成为新的落地焦点
|
||||||
|
|
||||||
|
大模型产业正迈向规模化落地的关键转型期,其落地焦点正从训练走向推理。作为连接技术创新与产业应用的核心枢纽,大模型推理正推动技术创新加速从验证迈向规模化应用。这一变革由市场需求、算存供给、成本经济与应用场景等多重因素共同驱动,标志着大模型正式进入规模化商业落地与价值兑现的新阶段。
|
||||||
|
|
||||||
|
**需求侧,大模型服务调用量与推理计算量呈现爆发式增长。** 推理服务调用量暴增,OpenAI 2025年12月发布的《2025年企业人工智能状况报告》显示,过去12个月,ChatGPT企业版API推理Token消耗暴增320倍,企业端消息量增长8倍。推理计算量翻倍,黄仁勋在2025年英伟达GTC大会上表示,由于代理型AI(Agentic AI)和推理能力的发展,目前所需的计算量轻松达到了去年预估的100倍。
|
||||||
|
|
||||||
|
服务平均序列长度攀增,从2023年最大序列长度4K增长到当前达128K,两年间增长至32倍,体现了当前大模型推理服务的任务复杂性与交互深度性。
|
||||||
|
|
||||||
|
**供给侧,算存资源、成本投入等配置重心正在向推理倾斜。** 算力供给层面,全球推理算力持续增长,2026年计算工作负载中推理占比将提升至66%;我国市场亦增速迅猛,2026年推理算力市场规模将达876.5亿元,较25年的438.3亿元接近翻倍(弗若斯特沙利文,《中国推理算力市场追踪报告2025H1》)。存储供给层面,推理应用对长记忆数据存储的需求显著提升,2025年,DRAM/SSD(闪存存储)/HDD(机械硬盘存储)价格指数累计增长327.59%/166.28%/66%。业务预算层面,2024年OpenAI推理业务预算达23亿美元,为训练GPT-4的1.5亿美元的15倍。可见大模型推理不同于训练的一次性投入,其伴随部署服务的持续性消耗,进一步导致推理账单的占比增长。
|
||||||
|
|
||||||
|
### (二)大模型推理优化的概念与目标
|
||||||
|
|
||||||
|
**1. 定义与范围**
|
||||||
|
|
||||||
|
大模型推理优化是指在保障模型服务等级目标(SLO)的前提下,通过一系列覆盖模型、引擎、系统(软/硬件)及服务全链路的技术手段与工程实践,系统性提升推理性能、降低运营成本的过程。其核心目标在于兼顾"效果-性能-成本"的协同优化,实现三者之间的动态平衡与最优权衡,从而支撑大模型技术规模化、可持续化的商业落地。
|
||||||
|
|
||||||
|
从AI全生命周期看,训练阶段的核心任务是通过海量数据学习模型参数,追求的是模型能力的上限,其过程一般具备离线、长周期、计算密集的特点。而推理阶段则是将已训练好的模型部署为在线或离线服务。在线服务一般要求实时响应用户请求,其核心诉求是效率、稳定与经济性;离线服务一般要求大批量生成结果,其核心诉求是吞吐、稳定与经济性。
|
||||||
|
|
||||||
|
从推理内部环节看,大模型推理优化贯穿于"压缩-部署-推理-服务"四个环节。压缩环节关注如何在可接受的精度损失范围内,通过量化、剪枝、蒸馏等技术减小模型体积与计算复杂度;部署环节关注如何高效地将模型加载至目标硬件环境,涉及容器化、冷启动加速,以及初始的网络/存储/计算资源配置等;推理环节是核心执行阶段,涵盖批处理调度、显存管理、高性能算子等引擎级优化,以及分布式推理、推理架构设计等系统级优化;服务环节则面向最终用户体验,包括API能力、请求调度、资源调度、负载均衡、弹性扩缩容、监控告警等能力。
|
||||||
|
|
||||||
|
从面向对象来看,推理优化的实施对象呈现出多层次、多样化的特征。在工具层面,以轻量化推理引擎与压缩工具为代表,可提供高性能的底层执行能力,迅速集成新兴技术并实现产业赋能。在系统层面,涵盖轻量化按需订阅模式的模型即服务(MaaS),自主可控定制化模式的私有化部署平台,本地化即插即用模式推理一体机,分布式实时响应模式的云-边-端协同推理系统,弹性伸缩平衡模式的混合部署系统等多种类型。
|
||||||
|
|
||||||
|
**2. 主要发展阶段**
|
||||||
|
|
||||||
|
大模型推理基础设施已完成初期功能集成,正走向系统级推理优化的深水区,各阶段围绕技术能力升级与产业价值落地,形成递进式目标。
|
||||||
|
|
||||||
|
- **第一阶段为功能集成阶段**,核心目标是实现推理服务的功能完备与可扩展。该阶段聚焦基础能力搭建,通过集成模型管理、部署调度、接口服务、运行监控等功能,打通从"训练输出模型"到"推理提供服务"的全流程链路。实践中,平台重点支持RAG、Agent等扩展能力,并提供标准化API接口,确保大模型推理服务能适配多样化业务接入需求,完成从"技术可用"到"服务可用"的跨越。
|
||||||
|
- **第二阶段为初步性能提效阶段**,核心目标是实现服务局部性能提升与推理单点优化。该阶段通过压缩技术精细化,以及并行策略、显存优化、计算优化、批调度优化等实例内推理优化技术演进,实现服务请求计算效率的提升;同时,平台集成压缩工具库、推理引擎等工具,以降低请求时延(TTFT/TPOT/端到端时延)、提升系统吞吐(TPS/QPS)为核心指标,实现推理性能的单点突破。
|
||||||
|
- **第三阶段为深化提效与经济落地阶段**,核心目标是实现场景协同优化与系统架构重构。该阶段不再局限于单点的技术优化与性能提升,而是结合模型特性与场景需求,以SLO为导向,推动"模型-架构-场景"的协同优化。实践中,预填充-解码(PD)分离、KV Cache多级存储、混合专家(MoE)分布式架构、注意力-前向反馈(AF)分离等新型系统架构成为主流,在满足场景化性能要求的同时,显著降低推理成本,实现高效与经济的双重目标。当前大模型推理基础设施正处于第二、第三阶段。
|
||||||
|
- **第四阶段为深度融合与变革阶段**,核心目标是构建更具性价比与自适应性的推理基础设施。该阶段通过自适应感知、系统级兼容性设计、全链路成本压缩等方式,推动推理服务与业务场景深度融合,形成具备自优化、高兼容、低能耗的新一代推理体系。
|
||||||
|
|
||||||
|
**3. 核心目标**
|
||||||
|
|
||||||
|
初期聚焦单一指标的性能提升,主要关注时延、吞吐等关键指标的局部优化。当前目标为面向SLO约束的多目标协同优化:随着大模型进入规模化商业落地阶段,推理优化的目标转向"模型-架构-场景"的协同平衡,即在满足特定场景SLO的前提下,实现系统有效吞吐、成本压缩与效果保障的综合最优。其中,效果主要体现在特定业务场景下生成结果的可用性、相关性、准确性与安全性;性能主要体现在时延、吞吐量、服务稳定性(如失败率、P99延迟)等可量化的服务质量(QoS)指标上;成本涵盖算力成本(GPU/NPU小时数、显存占用),以及人力与时间成本(如模型迁移、适配、运维的复杂度)。
|
||||||
|
|
||||||
|
## 二、大模型推理的主要挑战
|
||||||
|
|
||||||
|
### (一)多样化场景的适配
|
||||||
|
|
||||||
|
不同场景对推理服务的核心诉求存在显著差异,形成了以低时延、高并发、流量波动与长上下文为代表的四大典型场景。一是低时延场景,如智能客服、实时对话系统,要求服务在用户可感知的时间内(通常为数百毫秒内)返回首个Token(Time to First Token, TTFT);二是高并发场景,如批量内容生成、大规模数据标注、离线报告撰写等,追求高吞吐量(RPS/TPS),以最大化单位时间内的任务处理能力;三是长上下文场景,如基于RAG的知识问答、多轮Agent协作,随着上下文窗口从数千Token扩展至百万级别,KV Cache的显存占用呈线性甚至超线性增长,迅速耗尽GPU高带宽内存(HBM),成为长上下文场景下的主要瓶颈。此外,流量波动是几乎所有在线服务都面临的现实挑战。部分场景的业务流量呈现周期性(如工作日高峰、节假日低谷)或突发性(如营销活动、热点事件)特点。静态推理系统在闲时会造成资源浪费,在忙时则会因过载而拒绝服务或延迟飙升。
|
||||||
|
|
||||||
|
### (二)高质量算力需求与成本控制的平衡
|
||||||
|
|
||||||
|
一方面,复杂场景对算力的性能、稳定性提出严苛要求,需依托高性能硬件与优化技术保障服务质量;另一方面,推理阶段持续的算力消耗已成为企业核心成本负担,如何高效有机复用起存量算力、适配异构算力资源、实现跨场景协同调度,成为破解这一矛盾的关键。
|
||||||
|
|
||||||
|
前序算力资源的整合、复用面临多重阻碍。企业存量的早期GPU等资源,因硬件架构、软件生态与大模型推理需求可能存在不兼容问题,直接部署易出现性能短板。跨场景算力协同调度面临多重困境。异构算力的广泛应用,要求调度系统实现资源动态按需分配,但调度决策、资源隔离、动态适配三大挑战凸显。
|
||||||
|
|
||||||
|
### (三)模型特性与发展需求的适配
|
||||||
|
|
||||||
|
从传统的Dense架构向MoE架构、从单一语言向原生多模态、从数千Token上下文向百万级长序列持续跃迁。大模型的飞速发展对底层推理基础设施亦提出了严峻挑战:工程化方案必须具备高度的前瞻性与灵活性,能够快速适配新型模型的计算与存储特性,避免成为性能瓶颈,制约模型能力的充分释放。模型的快速演进推动推理优化从"适配模型"迈向"协同演进"的新阶段。未来的大模型推理平台需提供对MoE、多模态、超长序列等前沿特性的原生支持能力,构建从硬件存储到软件调度的全栈优化体系。
|
||||||
|
|
||||||
|
## 三、大模型推理优化关键技术
|
||||||
|
|
||||||
|
### (一)模型层面
|
||||||
|
|
||||||
|
模型层是大模型推理优化体系的源头,该层聚焦如何让模型本身更轻、更快、更易部署,通过结构升级、参数压缩、算子重构与算法创新,从根本上削减推理阶段的计算与存储开销。主要方向包括模型压缩、MoE稀疏化架构以及算法创新。
|
||||||
|
|
||||||
|
**1. 模型压缩**
|
||||||
|
|
||||||
|
模型压缩技术是解决大模型在资源受限环境中部署难题的关键途径,其核心目标是在尽可能保持模型性能的前提下,显著降低模型的存储占用和计算需求。通用压缩技术主要包括量化、知识蒸馏、剪枝和稀疏化等方法。量化通过降低权重和激活的数值精度减少存储开销,剪枝通过去除冗余连接降低模型密度,蒸馏则通过"教师-学生"机制保留模型的关键知识,低秩分解进一步在矩阵层面削减计算需求。这些方法的共性目标,是在最小化精度损失的同时,实现显存占用与计算时延的显著下降。
|
||||||
|
|
||||||
|
大模型推理场景下更强调"高比例压缩-低精度损失-高性能推理"的均衡。研究表明,适度的量化与结构化剪枝可以在精度下降不足1%的前提下,使推理速度提升30%—50%,显著改善服务响应时延。同时,低秩分解与混合精度推理技术正在成为主流方向。大模型压缩技术逐步向"无重训练压缩"与"自适应压缩"演进。近年来出现的自动压缩与敏感度感知量化方法,可在不额外训练的情况下,自动识别重要参数并进行动态压缩,从而降低部署复杂度,提升推理阶段的可迁移性与可扩展性。
|
||||||
|
|
||||||
|
**2. MoE架构**
|
||||||
|
|
||||||
|
混合专家(Mixture of Experts, MoE)模型架构以"按需激活"的稀疏计算模式,为推理优化提供了新的思路。MoE架构通过在推理阶段仅激活少量"专家网络",可显著降低计算负载。其核心机制在于门控网络(Gating Network)根据输入特征动态选择专家,使每次推理仅涉及少量参数计算,从而实现计算稀疏化与显存占用优化。这种结构使得模型整体参数规模可扩展至万亿级,而单次推理计算量保持在可控范围。
|
||||||
|
|
||||||
|
MoE架构在带来效率优势的同时,也引入新的工程挑战。由于推理阶段需完成专家选择、激活分配与通信调度等核心步骤,额外引入了路由开销与负载不均问题。针对这一挑战,多种负载均衡策略与专家选择算法不断提出,如基于梯度统计或样本重要性的门控机制,可在保证推理稳定性的同时提升专家利用率。
|
||||||
|
|
||||||
|
专家细粒度分割与动态负载均衡是MoE模型的主要优化趋势。一方面,专家细粒度分割通过将原有大规模专家进一步拆分为更小的子专家单元,使模型能够以更高的分辨率匹配不同输入模式,显著提升专家利用率与激活灵活性。以DeepSeekMoE为代表的研究提出,将专家划分为多层子专家结构,通过共享专家参数与跨层专家融合,实现"多任务共享+精准激活"的稀疏计算机制。另一方面,在推理阶段通过监测专家激活分布与实时算力利用率,动态调整门控策略与专家调度策略,避免高频专家过载以及低频专家闲置引发资源浪费。研究表明,引入自适应门控与分层负载反馈后,模型整体吞吐可提升2–3倍,且可显著降低通信瓶颈。
|
||||||
|
|
||||||
|
**3. 算法优化**
|
||||||
|
|
||||||
|
注意力机制改造与解码并行加速是当前模型提效热点。一方面,高效注意力机制持续改造。大模型推理多为自回归生成,Transformer的KV Cache成为解码(Decode)阶段显存消耗的主要瓶颈。产学界围绕这一问题陆续提出多种注意力改进方案:多查询注意力(Multi-Query Attention, MQA)通过共享一套KV实现缓存压缩,分组查询注意力(Grouped-Query Attention, GQA)在性能与显存间进行折中。DeepSeek-V2提出多头潜在注意力(Multi-head Latent Attention, MLA),进一步引入低秩压缩机制,在保留各头独立权重的同时显著压缩KVCache,实现显存压缩与模型性能提升的兼顾。
|
||||||
|
|
||||||
|
另一方面,通过将Decode阶段并行化实现加速的算法已得到普遍落地。投机采样(Speculative Decoding)关注生成–验证过程的并行路径。通过引入一个草稿生成阶段和一个目标模型验证阶段,将推理中多个Token的生成与验证并行执行,从而打破了纯自回归的串行瓶颈。其在小批量场景下可将延迟降低约2-3倍。DeepSeek提出的多Token预测(Multi-Token Prediction, MTP)关注生成本身的并行化。通过让模型在每次前向过程中预测多个未来Token,从模型内部优化设计出发,削减自回归推理中每个Token生成的延迟。
|
||||||
|
|
||||||
|
### (二)引擎层面
|
||||||
|
|
||||||
|
引擎层是大模型推理体系中的关键枢纽,承担着将模型能力转化为可被系统高效执行、可直接支撑服务化部署的核心功能。其优化边界聚焦于单实例或轻量集群内的执行效率,为上层系统架构提供高性能、低延迟的基础计算能力支撑。当前的核心技术围绕显存管理、计算优化、并行加速、调度策略等关键环节展开。
|
||||||
|
|
||||||
|
**1. 显存优化**
|
||||||
|
|
||||||
|
显存优化是破解大模型推理性能瓶颈的关键突破口,其核心在于高效管理随序列长度线性增长的KV Cache,避免显存浪费、碎片化与容量溢出。传统推理引擎为每个请求按预设最大上下文长度静态分配连续显存空间存储KV Cache,导致实际短请求场景下显存利用率低下,并在动态批处理中产生严重碎片问题。
|
||||||
|
|
||||||
|
PagedAttention技术借鉴操作系统虚拟内存分页机制,将KV Cache划分为固定大小的逻辑页,并将其映射至非连续的物理显存页,实现按需分配与灵活复用,可显著提升显存利用率,实验表明vLLM采用该技术后在相同硬件下可支持的并发请求数提升3倍以上。Prefix Caching(如RadixAttention)通过识别并缓存系统提示词、历史对话等共享前缀的KV Cache,在多轮对话或批量相似请求场景下避免重复计算,有效降低首Token延迟并提升整体吞吐。此外,面对上下文窗口持续扩展(如百万Token级别)带来的显存压力,KV Cache卸载(Offloading)策略将非活跃或低频访问的缓存数据迁移至CPU内存、SSD甚至远程存储,构建"显存-内存-存储"的多级缓存体系,在保障推理连续性的同时显著扩展可处理上下文长度,并降低对高成本GPU资源的依赖。
|
||||||
|
|
||||||
|
**2. 计算优化**
|
||||||
|
|
||||||
|
计算优化聚焦提升硬件计算单元的利用率,通过减少冗余浮点运算(FLOPs)与内存访问开销,突破大模型推理中的计算与带宽瓶颈。
|
||||||
|
|
||||||
|
一是通过算子融合降低访存消耗。算子融合技术将多个细粒度算子(如矩阵乘法、加法、激活函数)合并为复合算子,减少内核启动次数和中间结果的显存读写操作。通过将中间张量保留在高速片上缓存或寄存器中,算子融合可显著降低内存带宽消耗并提高运算吞吐。FlashAttention通过重新组织注意力计算流程,将完整的注意力操作过程融合为单一CUDA内核,在执行中采用I/O感知和分块策略,避免中间结果矩阵在显存中的频繁读写,从而显著提升注意力计算性能。其升级版本FlashAttention-2进一步通过优化线程块划分与减少非GEMM操作,在NVIDIA A100 GPU上实现50–73%的FLOPs利用率。
|
||||||
|
|
||||||
|
二是结合硬件进行内核级优化(Kernel Optimization)。通过结合特定硬件架构(如NVIDIA Tensor Core)定制高频算子、性能瓶颈算子,实现最大化计算吞吐。DeepGEMM代表了通用矩阵乘法(GEMM)在硬件协同优化方向的先进实践。DeepGEMM针对NVIDIA Hopper架构(H100)进行深度优化,通过FP8低精度计算充分利用Tensor Core指令集,在保持模型精度可控的前提下,显著提高矩阵运算吞吐率。
|
||||||
|
|
||||||
|
**3. 并行加速**
|
||||||
|
|
||||||
|
并行加速策略通过多维度并行方法提升系统吞吐率、降低显存压力,优化计算资源利用率。
|
||||||
|
|
||||||
|
- **数据并行(DP)**:将模型副本部署到多个设备上,通过划分输入数据实现并行处理,从而提升系统整体吞吐量。适用于处理大规模并发请求,但对单卡内存压力无直接缓解作用。
|
||||||
|
- **张量并行(TP)**:通过对模型内部参数矩阵按行或列进行切分,将单个算子的计算分布到多个设备上,解决单层模型参数过大无法被单个GPU承载的问题。然而TP通常伴随较高的通信开销,需要通过高效的通信策略和分块矩阵乘法进行优化。
|
||||||
|
- **流水线并行(PP)**:按模型层级划分阶段,构建计算流水线。由于阶段之间存在依赖关系,后一阶段必须等待前一阶段完成首个微批次(micro-batch)数据的计算才能开始,从而产生流水线"气泡",影响部分设备的利用率。
|
||||||
|
- **专家并行(EP)**:主要用于MoE模型,通过将不同专家分配到不同GPU上,并优化负载均衡与通信效率,实现对大规模专家网络的高效计算,同时降低单卡显存占用。
|
||||||
|
- **序列并行(SP)**:沿序列长度维度划分输入激活值,在张量并行基础上进一步降低显存压力,对长上下文推理尤为关键。
|
||||||
|
|
||||||
|
在实际部署中,混合并行策略成为主流方案,通过组合DP、TP、PP、EP和SP,可充分发挥各策略优势,实现吞吐率、显存占用及通信开销的综合优化。
|
||||||
|
|
||||||
|
**4. 批调度优化**
|
||||||
|
|
||||||
|
批调度优化旨在通过智能组织和处理推理请求队列,尤其应对推理解码阶段输出长度不定的特性。传统静态批处理(Static Batching)需等待批次中最慢请求完成,在大模型生成长度不定情况下,将引发资源浪费。动态批处理(Dynamic Batching)通过将多个推理请求组合成统一批次计算,根据实时请求队列动态调整批次大小,在等待时间与吞吐量之间实现更好的平衡。连续批处理(Continuous Batching)采用迭代级调度,在每轮迭代中动态决定批次大小,请求一旦完成生成便立即从批次中移除,并动态地将等待队列中的新请求加入批次,从而显著提升了GPU的利用率和整体吞吐量。此外,针对长上下文推理中存在的显存瓶颈与延迟挑战,分块预填充(Chunked-Prefills)将长输入序列分割为多个较小块按顺序处理,而非一次性处理整个序列,在适当边界处允许块处理与后续计算重叠,同时缓存已处理块的键值状态,避免重复计算。这种方法平衡了显存使用与计算效率,使长序列推理更加可行,同时降低峰值显存使用和首Token等待时间,是PD(Prefill-Decode)分离的引擎级实现。
|
||||||
|
|
||||||
|
### (三)系统层面
|
||||||
|
|
||||||
|
系统层是大模型推理体系全局控制与服务执行的核心,负责在跨节点、跨实例、跨资源的复杂环境中实现推理任务的高效协同与稳定交付。其关键技术包括结合模型、服务特性的分布式系统架构优化、分布式调度策略优化以及高性能存储等。
|
||||||
|
|
||||||
|
**1. PD分离架构**
|
||||||
|
|
||||||
|
预填充-解码(Prefill-Decode, PD)分离式推理架构已成为业界主流优化方案。大模型推理一般由预填充(Prefill)和解码(Decode)两阶段构成,其中预填充阶段是计算密集型(compute-bound)对算力需求高,容易迅速使GPU达到饱和;解码阶段是存储密集型(memory-bound)对显存需求高,在大批量(batch size)请求下才可充分利用计算资源,同时受到带宽限制。传统方式通常直接将推理服务部署到集群中,使得PD两阶段在同一节点上执行,引发两阶段资源争夺、并行策略互相掣肘难以优化,进一步导致资源利用率低、服务性能差、系统构建成本高等问题。
|
||||||
|
|
||||||
|
PD分离架构通过结构性解耦,将推理过程拆分为预填充与解码两个独立阶段,从根本上缓解计算资源与内存带宽的冲突。其核心思路是"阶段解耦、专用部署、并行调度":预填充阶段可部署在高算力GPU节点以集中执行大规模矩阵运算;解码阶段则运行在优化了内存访问路径的节点上,以低延迟方式持续生成Token。该设计不仅提升了各阶段资源利用率,还显著降低了请求延迟,并提升了系统的并发处理能力。在该架构中,KV Cache是连接两阶段的关键枢纽。预填充阶段生成的KV Cache可被多个解码实例复用,尤其在不同请求共享相似Prompt前缀时,可避免重复计算历史上下文。此外,通过缓存持久化技术,系统能够在多轮对话中跨轮次复用缓存,有效降低重复推理开销。动态缓存管理策略进一步根据访问频率、优先级与显存状态自动决定缓存的分配与淘汰策略,确保有限显存资源下的最高命中率。
|
||||||
|
|
||||||
|
尽管PD分离架构在性能与扩展性方面表现优秀,但仍面临三大核心挑战:一是传输开销,大量KV Cache跨节点传输可能引入显著延迟;二是显存压力,解码阶段需同时维护大量并发请求的KV Cache,而HBM/DRAM等高带宽存储资源有限;三是缓存协同复杂,预填充生成与解码访问需精准匹配,否则缓存失配或冗余访问将削弱优化效果。为应对上述问题,业界提出多层次优化路径:在通信层采用RDMA/NVLink等高速互联技术,并结合KV Cache量化与按层流式传输策略以降低传输延迟;在存储层通过HBM-DRAM-SSD分级架构与缓存复用技术减轻显存占用;在调度层实现预填充与解码异步重叠执行、计算与传输并行,从而全面提升系统推理效率及扩展能力。
|
||||||
|
|
||||||
|
**2. AF分离架构**
|
||||||
|
|
||||||
|
在MoE架构模型的推理场景中,注意力(Attention)层与前向反馈(Feedforward)层呈现出显著的计算特征差异:前者为访存密集型,依赖KV Cache的频繁访问;后者为计算密集型,主要执行大规模矩阵乘运算。这种计算异构性使得在同一GPU上混合执行两类操作时,资源利用率往往受限,GPU计算单元与显存带宽难以同时饱和。
|
||||||
|
|
||||||
|
为应对此问题,业界提出了AF分离(Attention–Feedforward Disaggregation, AFD)架构,继承了PD分离"按任务性质分治优化"的系统思想。AF分离通过在系统层面将Attention模块与Feedforward模块拆分至不同计算节点,使两类任务可独立优化并并行执行。Attention节点(A节点)部署在具备高显存带宽与大容量缓存的GPU上,用于处理KV Cache与注意力计算;Feedforward节点(F节点)则部署在高算力、性价比更优的GPU上以执行Dense计算。该设计消除了计算与访存冲突,实现了异构资源的协同最优利用。
|
||||||
|
|
||||||
|
AF分离架构支持异构部署与独立扩展。当模型输入长度变化或系统SLO收紧时,A与F节点可分别按需扩展规模以维持目标延迟与吞吐的平衡。可分级伸缩的特性使得AF分离在多租户、长上下文、高并发场景下具有显著优势。此外,从模型系统协同设计的角度看,AF分离亦为模型结构优化提供了理论依据。例如,分析表明FFN层稀疏度与通信带宽呈正相关关系,合理引入低秩映射可在不增加通信负担的情况下提高稀疏度,从而实现更优的性能–精度–成本平衡。AF分离架构标志着大模型系统架构从PD分离为代表的阶段分治,迈向AF分离为代表的模块分治。
|
||||||
|
|
||||||
|
**3. 系统调度策略**
|
||||||
|
|
||||||
|
调度策略作为系统架构的智能中枢,协调着整个推理系统的运行效率。通过智能化请求分发与资源分配,使推理系统在满足SLO要求的同时,最大化算、网、存的资源利用率,最小化成本与长尾延迟,并能动态应对请求异构性与节点故障。现代调度系统主要围绕请求调度和资源调度两个维度展开优化。请求调度负责将用户请求智能分配给最合适的计算实例,综合考虑请求特性、实例负载和系统状态等多重因素。资源调度则关注硬件资源的动态分配与再平衡,根据工作负载变化实时调整计算、显存和带宽资源的分配。在MoE模型场景中,资源调度尤为重要,需要根据专家激活模式动态调整各专家的计算资源,以充分发挥MoE架构的效能。
|
||||||
|
|
||||||
|
缓存亲和性调度策略通过分析请求特征,将相似请求路由到具有对应KV Cache的实例处理,极大提升了请求处理效率。这种策略与PD分离架构完美契合,使得预填充阶段生成的KV Cache能够在多个解码请求间高效共享。负载感知调度策略通过实时监控各推理实例的GPU利用率、显存使用率、请求队列长度等关键指标,实现系统负载的动态均衡,避免部分实例过载而其他实例闲置的情况。故障感知与容错调度策略则通过多层次健康检查和自动故障转移机制保障服务连续性,结合请求重试和结果缓存策略,确保在部分组件故障时系统仍能维持基本服务能力。
|
||||||
|
|
||||||
|
**4. 高性能存储**
|
||||||
|
|
||||||
|
随着模型参数与上下文长度的快速增长,KV Cache作为模型的"工作记忆",其存储开销呈平方级增长,对GPU显存构成巨大压力。传统单一依赖高带宽内存(HBM)的方案,在面临长上下文、高并发推理任务时,常因显存容量限制而导致吞吐下降、成本激增。为此,构建智能、高效的多级存储体系,已成为保障推理服务性能与经济效益的必经之路。
|
||||||
|
|
||||||
|
为应对显存资源稀缺性与成本挑战,动态多级长记忆存储架构被普遍使用。业界通常使用"HBM-DRAM-SSD"构成的三级动态存储架构。该体系将KV Cache依据访问特性与生命周期,智能调度于不同层级的存储介质中,其中高频访问的"极热"数据驻留于高带宽的HBM,中低频的"热"或"温冷"数据则迁移至容量更大、成本更低的DRAM和外置存储,实现性能与容量的最优平衡。这一架构设计旨在突破物理显存容量限制,支持更长上下文与更大批次并发,同时,通过低成本、高性能、大容量的外置存储有效扩展系统数据容量,优化"内存墙"和"容量墙",进而显著降低系统整体成本。
|
||||||
|
|
||||||
|
多级存储架构的有效性依赖于一系列关键技术的深度协同。系统通过实时监控访问频率、时序局部性等指标,精准识别KV Cache的"冷热"状态,并借助后台异步任务,在各级存储间执行数据的智能换入换出。为最大化存储效率,系统引入前缀缓存等复用机制,当不同请求共享相同提示前缀时,直接复用已生成的KV Cache,避免重复计算。同时,通过RDMA与加速卡直通存储等底层技术,构建GPU与存储设备间的直接数据通道,消除CPU拷贝瓶颈,确保数据迁移的高效性。
|
||||||
|
|
||||||
|
PD分离架构为存储系统创造了独特的优化空间。在PD分离架构场景下,多级存储体系为Prefill阶段生成的KV Cache提供了跨节点的缓存共享与持久化能力,使得解码节点能够按需、低延迟地获取缓存。同时,通过将非活跃的历史缓存数据卸载至DRAM和外置存储,显著缓解了解码节点对昂贵HBM的依赖,使其支持更高并发度。存储系统还可与调度器协同,实现KV Cache的异步流式传输与智能预取,有效隐藏数据访问延迟。
|
||||||
|
|
||||||
|
尽管多级存储架构优势显著,其落地仍面临诸多挑战并驱动着技术持续演进。在缓存数据于多层级、多节点间动态迁移时,如何确保解码阶段访问到的KV Cache始终保持完整性与一致性,是维护推理正确性的关键挑战。同时,HBM、DRAM、SSD等存储器在带宽与延迟上存在数量级差异,系统需要精细设计数据放置与迁移策略,避免低速I/O成为整个推理管道的性能瓶颈。未来,多级KV Cache存储需要与并行文件系统、数据编织等跨域数据调度技术深度融合,实现跨集群的缓存资源池化与统一管理,为超大规模模型推理服务系统奠定坚实基础。
|
||||||
|
|
||||||
|
## 四、大模型推理优化应用实践
|
||||||
|
|
||||||
|
### (一)前期:聚焦平台功能完备
|
||||||
|
|
||||||
|
早期阶段,产业界普遍聚焦于构建功能完备的推理服务平台,以实现从模型调优到部署推理、服务化交付的全流程贯通。
|
||||||
|
|
||||||
|
一是,平台体系化能力初步形成,构建了模型推理的基础运行框架。早期平台重点在于整合模型管理、部署调度、接口服务、运行监控等核心功能,形成从"训练输出模型"到"推理提供服务"的闭环机制。
|
||||||
|
|
||||||
|
二是,平台功能从通用大语言模型部署扩展至多场景、多模态服务。典型特征包括支持文本生成、图像生成、语音理解等多模态推理接口,以及在线推理、离线批处理、RAG(检索增强生成)等多样化运行模式。这类多模态与多场景的扩展,使平台从"功能完备"进一步迈向"业务可复用"。
|
||||||
|
|
||||||
|
三是,平台能力向标准化与易用化方向深化。云服务厂商普遍提供一键部署、弹性伸缩、监控可视化等特性,显著降低了企业构建推理服务的门槛。
|
||||||
|
|
||||||
|
### (二)现状和趋势:方案迭代,从单点优化走向系统优化
|
||||||
|
|
||||||
|
**1. 单点优化:压缩工具与推理引擎是两大关键方向**
|
||||||
|
|
||||||
|
模型压缩工具核心目标是在可接受精度下降范围内,尽可能降低模型的存储与计算代价,以增强模型的可部署性以及成本效率。一是,压缩技术逐步演进为面向大模型特性的精细化轻量化方案。Meta采用的GPTQ与MIT提出的AWQ量化方法在权重量化过程中引入误差补偿、激活感知等机制,实现量化后精度保证的同时,降低显存占用并提升推理速度。二是,压缩工具化与平台化集成,成为推理优化体系中标准化模块。微软推出的DeepSpeed Compression将量化、剪枝、蒸馏功能封装为统一API接口;英伟达在TensorRT Toolkit中集成高精度量化与校准模块,核心通过校准技术(如KL散度校准、最小化量化误差校准),在INT8/INT4低精度下将精度损失控制在1%-3%以内;阿里云PAI平台推出PAI-Blade、PAI-EasyDistill、PAI-Model Gallery等模型轻量化组件,可提供丰富的模型压缩功能支持;百度千帆大模型平台集成PaddleSlim压缩工具,实现结构化剪枝、蒸馏与动态量化的统一管理。三是,与模型、硬件协同的高效压缩方案正成为新的趋势。英伟达在Hopper架构GPU中引入对FP8量化的原生支持,并通过TensorRT-LLM自动调用低精度算子实现算力加速。
|
||||||
|
|
||||||
|
推理引擎作为大模型推理体系中连接模型与算力的执行核心,是推理优化早期阶段单点性能提升的主要抓手。一是,通用推理引擎经历"多点爆发-功能富集-逐步收敛"的演化轨迹。从前期学术机构、初创企业、大型科技公司、技术社区等推出的几十种推理引擎,逐渐收敛至vLLM(技术社区)、SGLang(技术社区)、llama.cpp(技术社区)、Text Generation Inference(HuggingFace)、DeepSpeed-FastGen(Microsoft)、TensorRT-LLM(NVIDIA)等几个主流推理引擎,其中vLLM、SGLang因兼具推理优化特性丰富、功能更新迅速、社区支持充分、分布式支持能力强、二次开发支持性好、多硬件支持好、与DeepSeek/MoE等主流模型深度协同等优势,其产业应用普及性尤为突出。二是,围绕服务化场景特点,主流推理引擎不断纳入新特性,同时也衍生出一系列差异化、专用化推理引擎。LMDeploy在语言模型之外还关注视觉语言模型(VLM),主要围绕GPU进行深度优化,适用于企业级大规模、高稳定性、高性能应用和实时系统。SGLang对于分布式部署、长文本场景支持优异,尤其自DeepSeek-V2开始SGLang与DeepSeek深度整合,在性能测试中对于高并发、低时延等差异化场景均能完美胜任。三是,随着MoE模型架构逐渐成为主流趋势,主流大模型框架如vLLM、DeepSpeed等均强化了对MoE特性的支持,同时产业界也推出了一批聚焦MoE训推的AI框架,如清华的KTransformers通过优化底层算子、引入专家延迟机制(Expert Deferral)等创新技术,实现了CPU与GPU的高效协同。此外,DeepSeek也推出了为MoE架构中专家并行(EP)定向优化的DeepEP通信库。
|
||||||
|
|
||||||
|
**2. 协同优化基础:PD分离开启"模型-架构-场景"协同优化新篇章**
|
||||||
|
|
||||||
|
随着PD分离式推理架构逐渐成熟,场景落地显著加速。2024年陆续推出了DistServe(北大&USCD)、Splitwise(微软)、TetriInfer(华为云)和MemServe(华为云)等PD分离式推理架构方案。
|
||||||
|
|
||||||
|
2024年,DistServe提出了基础的PD分离架构,详细分析了PD分离架构对于大模型推理的适配性。该方案虽未涉及异构资源、复杂调度等针对场景特性的策略设计,但其开源代码仍为后续PD分离方向的方案演进奠定了基础。2024年5月,Splitwise初步验证了PD分离方案在异构硬件资源运行,可在保证性能要求下实现成本压缩;同时,提出了针对节点内、节点间的调度策略以及KV Cache传输策略的优化方向。同年,TetriInfer从工业落地角度进一步细化系统模块划分与调度策略,从实际应用中常见的分布式架构角度,提出结合P/D实例负载的调度策略,以保障负载均衡;同时,提出P/D实例转化机制,提升内部可扩展性。MemServe则从实际应用中常见的请求调度策略角度,提出基于全局请求的Global Prompt Tree管理机制,通过构建弹性内存池配合全局调度器,管理集群中的KV Cache与路由方式,突破当时传统架构主要聚焦实例内的局限性。
|
||||||
|
|
||||||
|
**大模型推理 Prefill-Decode 阶段对比:**
|
||||||
|
|
||||||
|
| 特性 | Prefill阶段 | Decode阶段 |
|
||||||
|
|------|-------------|------------|
|
||||||
|
| 操作 | 一般对应提示词处理 | 一般对应解码生成 |
|
||||||
|
| 处理单元 | 整个提示词(N个词元) | 单个新词元(1个词元) |
|
||||||
|
| 计算模式 | 并行计算 | 串行(自回归)计算 |
|
||||||
|
| 计算复杂度 | O(n²),n为prompt长度 | O(1)/token |
|
||||||
|
| 瓶颈 | 计算密集型(Compute-Bound) | 内存带宽密集型(Memory-Bound) |
|
||||||
|
| 主要操作 | 矩阵-矩阵运算(GEMM) | 矩阵-向量运算(GEMV) |
|
||||||
|
| 核心指标 | 首字输出延迟(TTFT) | 每字生成时间(TBT) |
|
||||||
|
|
||||||
|
**3. 协同优化趋势一:以KV Cache为核心的架构优化**
|
||||||
|
|
||||||
|
当前,以Mooncake(月之暗面)、Dynamo(英伟达)、UCM(华为)等为代表的工业级方案迭出,以上方案均在PD分离架构基础上,提出针对KV Cache的"存储-计算-调度"方案,持续推动以KV Cache为核心的推理系统路线演进。
|
||||||
|
|
||||||
|
**1) Mooncake 架构方案**
|
||||||
|
|
||||||
|
2025年2月,月之暗面与清华联合阿里云、华为存储、面壁智能、趋境科技等共同发布了Mooncake开源项目,引起产业热烈轰动。该方案核心创新在于重构了推理服务的资源组织模式,通过全局调度器(Conductor)、P/D集群及分布式KV Cache池(Mooncake Store)的协同架构,实现计算与存储的深度解耦。
|
||||||
|
|
||||||
|
一方面,Mooncake Store作为统一存储池,创新性整合AI芯片原生的HBM以及集群闲置且成本更低的CPU、DRAM、SSD等存储资源,建立分级存储机制:高频访问的KV Cache块优先驻留HBM保障低延迟,历史缓存与低频数据动态下沉至DRAM与SSD,通过"以存换算"策略大幅降低HBM资源占用,同时借助RDMA的高带宽、低延迟特性实现跨介质数据高效流转。另一方面,针对长上下文处理与过载场景等产业痛点,Mooncake设计了多层次优化机制:在Prefill阶段采用分块流水线并行(CPP)技术,将超长输入令牌拆分后由多节点协同处理,结合计算与缓存操作的异步执行优化,有效降低长文本场景的TTFT;全局调度器采用KV Cache感知策略,优先路由请求至存在最长可重用前缀缓存的节点,并通过启发式热点迁移机制复制高频缓存块,最大化跨会话缓存重用价值。针对流量波动场景,引入预测式早拒绝策略,基于历史负载数据预测Decoding节点未来容量,提前筛选无法满足SLO的请求,避免无效Prefill计算导致的资源浪费。
|
||||||
|
|
||||||
|
该方案已在Kimi大模型实现生产级规模化落地,承接其80%以上的线上流量,可实现在真实工作负载下,系统有效吞吐量较基线方案提升75%,100%满足TBT约束(vLLM仅57%),TTFT分布与vLLM基本一致;在16k~128k输入长度的长上下文模拟场景中,吞吐量最高提升525%,且严格满足TTFT和TBT的SLO约束。Mooncake提出的"以存换算"理念为产业后续方案迭代奠定坚实基础。
|
||||||
|
|
||||||
|
**2) Dynamo 架构方案**
|
||||||
|
|
||||||
|
2025年3月,英伟达在GTC 2025推出NVIDIA Dynamo分布式推理加速项目。该方案的核心创新在于构建了模块化协同架构,通过SLO-based Planner、KV Cache感知路由、多级存储管理及高效传输组件(NIXL)的深度联动,实现Prefill与Decoding阶段的柔性解耦,为分布式推理提供性能、成本与扩展性的最优平衡。
|
||||||
|
|
||||||
|
一方面,针对分布式推理中的缓存复用、跨介质传输与成本优化等核心痛点,Dynamo设计了多层次技术方案:KV Cache感知路由器(Smart Router)通过实时追踪全集群KV Cache命中情况与节点负载,将请求路由至最优实例,显著降低TTFT;分布式KV Cache管理器构建四级存储体系,将高频缓存驻留GPU显存,中低频数据下沉至CPU内存、本地SSD及外置存储,避免KV Cache重复计算,大幅降低高端显存占用成本;推理传输库(NIXL)兼容多种后端,提供高带宽、低延迟的跨介质数据传输支撑,为解耦架构提供高效通信保障。另一方面,系统设计"实时监控-智能决策-资源调度"机制,基于持续采集的GPU资源指标、请求特征(输入/输出序列长度,ISL/OSL)与SLO目标(TTFT/ITL阈值)等信息,自动调整最优PD分离配置与并行策略,实现资源按需分配与自动扩缩容,大幅降低部署与运维复杂度。此外,Dynamo构建了全栈兼容的技术生态,原生支持TensorRT-LLM、vLLM、SGLang三大主流推理引擎,支持多引擎并行评估与业务灵活适配。
|
||||||
|
|
||||||
|
**3) UCM架构方案**
|
||||||
|
|
||||||
|
2025年11月,华为正式开源UCM(Unified Cache Manager)推理记忆数据管理套件,以加速AI推理性能。UCM以KV Cache多级缓存和推理记忆管理为中心,通过推理框架、算力、存储的三层协同,提供自适应全局Prefix Cache、全流程稀疏注意力、后缀检索预测等关键推理加速技术,破解长序列推理效率低、成本高的难题,实现推理TTFT最高可降低90%、系统吞吐最大可提升22倍和上下文窗口序列长度扩展10倍级。
|
||||||
|
|
||||||
|
一方面,UCM在底层框架和机制上提供了多级缓存空间的分层管理与智能流动能力:实时数据存放在高性能缓存HBM中,短期数据存放在DRAM中,其他数据存放在共享的外置存储中,以提升整体系统效率。另一方面,UCM实现了一系列创新的推理加速算法:自适应全局Prefix Cache提供任意位置、任意介质、任意组合的前缀命中能力,可实现KV Cache在单机HBM、单机DRAM、跨机DRAM、以及SSD池化存储等不同类型、范围中的精准查找和匹配,同时支持公共前缀、历史对话和RAG知识块多种拼接组合场景的复用,以提升推理TTFT指标;全流程稀疏加速算法提供Prefill阶段的超长KV分片卸载和增量稀疏,以及Decode阶段的动态稀疏,支持覆盖全流程的稀疏加速套件,可倍数级提升长序列推理吞吐及时延;后缀检索预测加速算法将行业的私域数据和用户习惯等隐私数据构建为Token级后缀索引,突破推理自回归瓶颈,实现单次输出多词,效果优于传统MTP。此外,UCM北向支持多样化的推理引擎,南向可接入多样化的存储系统。
|
||||||
|
|
||||||
|
该方案已在金融行业典型推理应用场景得到效果验证。在舆情分析系统中,将长文本分类知识库提前预热至KV Cache Pool中存储,避免每次推理时重复计算,将推理时延由10分钟降低至10秒,分类准确率提升至80%以上,实现客户之声高效精准分析。在会议纪要生成等长文档处理场景中,采用KV Cache稀疏去噪技术,将原始上下文进行压缩,突破上下文窗口限制,满足客户对会议纪要准确性与完整性的要求。
|
||||||
|
|
||||||
|
**4. 协同优化趋势二:结合MoE模型特性的架构优化**
|
||||||
|
|
||||||
|
当前,以DeepSeek(深度求索)、MegaScale-Infer(字节跳动)、Step-3(阶跃星辰)等为代表的工业级方案持续推出,以上方案基于PD分离的系统架构,同时针对MoE模型结构在系统层面实现协同优化。其中,MegaScale-Infer(字节跳动)与Step-3(阶跃星辰)在PD分离基础上,针对解码阶段MoE层注意力模块与前馈网络模块的计算差异,进一步细化提出了AF分离架构,推动推理系统在MoE架构下的范式演进。
|
||||||
|
|
||||||
|
**1) DeepSeek 架构方案**
|
||||||
|
|
||||||
|
2025年2月,我国深度求索推出的DeepSeek V3/R1技术方案。该方案实现超大规模模型高效训推、高阶推理能力等突破,凭借模型架构创新与全链路工程优化,在性能、成本与实用性间实现精准平衡,一经推出便引发国内外广泛关注,迅速渗透产业应用,成为大模型推理落地的主流选择。
|
||||||
|
|
||||||
|
其推理阶段方案同样基于PD分离架构,核心目标为在保证在线SLO的同时最大化吞吐量,该方案围绕大规模DeepSeekMoE模型特性进行了深度与细致的工程优化。并行策略层面,根据预填充、解码两阶段的计算特性,分别采用不同规模专家并行进行策略组合,以实现预填充阶段充分提升计算效率,解码阶段最大化并行度。负载均衡层面,通过在线监测识别热点专家并创建副本,以及冗余专家部署配合动态路由方案,解决推理阶段专家负载不均导致的"木桶效应"。通信优化层面,提出双微批次重叠执行实现计算-通信重叠。在预填充阶段将一个微批次的"attention+MoE"与另一个微批次的"dispatch+combine"重叠执行,使通信开销被计算开销覆盖;在解码阶段将一个微批次的"attention"与另一个微批次的"dispatch+MoE+combine"重叠执行,减少解码阶段注意力计算的高耗时占比。存储优化层面,通过3FS高性能并行文件存储系统和KVCache多级存储架构,将服务成本降低了90%,并显著降低推理时延。
|
||||||
|
|
||||||
|
该方案已实现大规模生产级落地,基于H800 GPU部署的推理服务,平均每台预填充吞吐达73.7k tokens/s(含缓存命中),解码输出吞吐约14.8k tokens/s。成本层面,通过架构优化与缓存复用,理论成本利润率可高达545%。其进一步围绕MoE架构模型深度优化的技术路径,为大模型推理方案提供了又一成熟范式。
|
||||||
|
|
||||||
|
**2) MegaScale-Infer架构方案**
|
||||||
|
|
||||||
|
2025年7月,字节跳动与北京大学联合发布MegaScale-Infer推理系统,核心突破在于通过"A/F模块解耦+乒乓流水线并行+高性能M2N通信库",解决MoE模型在推理过程中,尤其在解码阶段由于FFN与Attention模块计算需求不同引发的GPU利用率低问题,以及数据在专家间分发调度引发的通信延迟问题。该优化方案普遍适用于MoE架构模型,已在字节跳动内部大规模部署,为超大规模MoE模型的工业化落地提供了系统级范式。
|
||||||
|
|
||||||
|
该方案专为MoE模型设计,创新性重构了MoE推理的模块组织与资源调度模式。一是,提出离散化专家并行(Disaggregated Expert Parallelism)架构(即AF分离),实现MoE模型层内Attention模块与FFN模块的物理解耦。同时,进一步为两类节点设计差异化的并行策略,以匹配其计算与内存特性。二是,提出乒乓流水线并行(Ping-Pong Pipeline Parallelism),通过拆分批次与流水线调度,实现计算-通信重叠,消除A/F两类节点间因等待计算/通信引发的频繁闲置,以及跨界点通信带来的时延消耗。三是,针对解耦架构下注意力节点(M个发送方)与专家节点(N个接收方)形成的"M2N通信模式",提出了定制化的高性能M2N通信库。通过消除冗余操作、优化流量调度与保障硬件直连,为解耦架构下的MoE推理系统提供低延迟、高可靠的通信支撑。
|
||||||
|
|
||||||
|
MegaScale-Infer方案整体更侧重系统层创新,以A/F模块解耦打破MoE模型层困境与硬件资源限制,支持两类节点的异构硬件配置,适配所有大规模MoE架构模型,适用于云原生AI服务、弹性推理平台、大规模API服务等对吞吐量与成本敏感的场景。该方案已在字节跳动内部实现生产级部署,支撑Mixtral 8x22B、DBRX等主流MoE模型的线上服务。真实负载下,单GPU解码吞吐量较vLLM等基线方案最高提升7.11倍,异构集群中单位成本吞吐量较vLLM提升224%。
|
||||||
|
|
||||||
|
**3) Step-3架构方案**
|
||||||
|
|
||||||
|
2025年7月,我国阶跃星辰推出基于MoE架构的Step-3自研多模态大模型(VLM),并结合模型进一步提出高效推理架构方案。该方案同样加入了AF分离元素,实现"AF分离+多矩阵分解注意力(MFA)+StepMesh通信库"的模型-系统协同设计,该优化方案适用于MoE架构模型,且已实现对于主流国产芯片的深度适配。
|
||||||
|
|
||||||
|
该推理系统方案深度结合大规模MoE模型特性。一是,提出多矩阵分解注意力(MFA)的模型结构创新,可在保持与DeepSeek-V3相当的高注意力表达能力的同时,显著降低KV缓存大小和计算量。二是,提出注意-前馈网络解耦(AFD, Attention-FFN Disaggregation)架构,各自采用最优并行策略和硬件配置。三是,提出StepMesh通信库以更好支持AFD的模块解耦和异构部署。
|
||||||
|
|
||||||
|
该方案已通过生产级场景验证,在Hopper GPU集群上实现4039 tokens/GPU/s的推理吞吐量(在50ms的SLA约束下),是DeepSeek-V3(2324 tokens/GPU/s)的1.73倍;在国产芯片部署时,推理效率较主流方案提升显著,充分适配国产化算力生态。成本控制方面,其8K上下文每百万令牌推理成本低至0.055美元,为DeepSeek-V3(0.068美元)的80%,32K长上下文场景成本低至0.129美元,优势进一步扩大,仅为DeepSeek-V3(0.211美元)的61%。
|
||||||
|
|
||||||
|
## 五、大模型推理优化典型案例
|
||||||
|
|
||||||
|
### (一)金融领域:金融领域大模型高性能推理加速方案
|
||||||
|
|
||||||
|
案例实施单位:某金融清算机构、华为技术有限公司。
|
||||||
|
|
||||||
|
项目总体投资达数亿元,建设周期为三年,旨在构建一个覆盖"一个算力底座、两大平台(模型平台与数据平台)、六大中心"的先进技术体系。项目的核心目标是在金融普惠、风控合规、消费拉动及质效提升四大关键领域,成功落地超过十个示范性AI应用场景。
|
||||||
|
|
||||||
|
**1) 整体方案**
|
||||||
|
|
||||||
|
金融机构在核心的智能客服、舆情分析、会议纪要生成等场景中,遭遇了两个突出的技术瓶颈:"推不动"——在处理坐席记录、调研报告、会议文本等长文档时,文本序列长度经常超过模型32K的上下文窗口限制,导致推理任务无法执行;"推得慢"——在企业级智能问答等高并发场景下,随着输入序列变长,系统响应速度急剧下降,30路并发时TTFT超过30秒。为解决这些挑战,金融机构引入了华为的AI推理加速与存储优化一体化方案,并针对不同业务场景进行了深度适配。
|
||||||
|
|
||||||
|
**2) 创新情况**
|
||||||
|
|
||||||
|
- **基于AI存储的KV Cache管理技术**:在舆情分析系统中,创新性的将长文本分类知识库以60KB的KV Cache形式提前预热并持久化在OceanStor A系列存储池中。该技术避免了每次推理时对固定知识的重复计算,从根本上降低了长文本处理的时延。
|
||||||
|
- **KV Cache动态稀疏与去噪技术**:针对会议纪要等超长文本场景,该技术能对原始上下文进行智能压缩,在不损失关键信息的前提下,将80K的上下文负载有效压缩至16K进行加载,从而突破了模型固有的上下文窗口限制。
|
||||||
|
- **融合"以查代算"的多轮对话记忆机制**:在智能问答场景中,系统将"多轮对话历史记忆"与高命中率的缓存查询机制相结合。这不仅有效扩展了有效的对话上下文长度,还通过直接调用缓存结果替代重复计算,显著提升了系统吞吐与响应速度。
|
||||||
|
|
||||||
|
**3) 应用实效**
|
||||||
|
|
||||||
|
性能大幅提升:在舆情分析场景中,端到端推理时延从超过15分钟缩短至近90%,实现了近乎实时的分析能力。在智能问答场景中,8卡部署下30并发TTFT降至9秒,降低66%,同时集群吞吐量提升43%。处理能力突破:成功突破模型上下文窗口限制,能够一次性处理完整的超长会议内容与多轮对话历史,解决了"推不动"的核心痛点。输出质量保障:以会议纪要生成为例,长会议纪要可直接推理,推理结果准确度大幅提升。用户体验飞跃:智能助手实现了从"答非所问的伪助手"到"精准连贯的真助手"的体验跃升。
|
||||||
|
|
||||||
|
### (二)运营商领域:九天人工智能平台
|
||||||
|
|
||||||
|
案例实施单位:中移九天人工智能科技(北京)有限公司(九天人工智能研究院)。
|
||||||
|
|
||||||
|
九天人工智能平台针对大模型推理业务规模化扩张中的核心痛点,构建全栈优化体系,目前已在能源、航空、农业、物流交通等关键行业的大模型生产级业务中实现深度落地。其痛点包括:一是模型训练与推理链路不连贯,不同参数规模模型推理适配流程重复繁琐、部署周期长;二是模型推理业务的资源利用率有待提升,采用PD混部的方式使得平台难以在保证稳定时延的前提下承载更多并发会话和更长的上下文长度;三是传统推理框架在底层逐层执行独立算子的过程中,频繁显存读写占据了大量带宽。
|
||||||
|
|
||||||
|
**1) 整体方案**
|
||||||
|
|
||||||
|
在整体架构上,采用训推一体框架打通训练-推理全链路,统一计算图与并行策略,实现模型的快速迁移与高效运行;在系统层面,引入PD分离部署,对不同阶段的计算与存储负载进行精细拆分和调度,提升算力利用率并降低大规模服务的硬件投入;在算子层面,围绕矩阵乘、Attention与位置编码等关键算子开展融合与深度优化,释放长上下文和高并发场景下的大模型推理性能。
|
||||||
|
|
||||||
|
- (1) 训推一体架构:大模型在训练与推理阶段共享同一套计算图和并行策略,兼顾大吞吐训练与低延迟推理。通过增量推理、Flash Attention、Paged Attention等融合算子的统一加速技术,在保证数值一致性的同时显著提升长上下文推理性能(支持最大128k序列长度)。统一训练与推理并行策略接口,对推理加速能力的模块化封装,无需导出、切分和转换模型,实现从训练到高性能推理的平滑迁移,整体部署周期缩短至天级。平台层面,围绕训推一体框架构建统一的算力资源池,整合训练集群与推理集群,并通过统一的调度策略实现跨业务协同编排,低成本实现"昼推夜训"、"闲时训练"等弹性调度策略。
|
||||||
|
- (2) PD分离:通过将计算密集型的Prefill阶段与存储密集型的Decoding阶段解耦并分布式部署,实现了资源与阶段特性的精细匹配。同时基于以KV Cache为中心的分布式存储架构实现全局多级KV Cache管理,显著降低了因资源竞争导致的OOM风险与时延抖动。并且在资源动态调度的场景中,通过自动扩展机制,实时监控业务负载情况,动态调整P/D集群的规模。相比混部的推理方式,某稠密模型在引入PD分离架构后单卡吞吐量提升1倍以上,同时在生产场景中显著降低了大规模服务的硬件成本。
|
||||||
|
- (3) 算子融合:引入流水线并行与Swizzle数据重排策略,通过"以算代搬"掩蔽数据搬运开销、提升缓存命中率,从而挖掘矩阵乘算子的极致性能;依托Cube/Vector并行能力,将矩阵乘后的后处理计算与相邻Vector类算子进行跨界融合,减少内核调用与中间结果回写;结合芯片特性设计Tiled-Attention算法,充分利用片上缓存高带宽,通过构建多级流水与重组query计算路径,实现Attention相关算子的深度融合与流水并行最大化;同时,将RoPE抽象为可融合的编码算子,结合位置编码特性重构计算逻辑与数据布局,最大化硬件缓冲利用率,完成高性能编码算子的融合实现。
|
||||||
|
|
||||||
|
### (三)电力领域:面向中压配网检修业务的推理优化
|
||||||
|
|
||||||
|
案例实施单位:中国电力科学研究院。
|
||||||
|
|
||||||
|
传统大模型推理在此场景中存在三大突出问题:一是推理时延过高,难以满足时效性要求(夜间窗口期完成次日计划推理,传统系统单次耗时远超窗口期);二是长上下文处理能力不足,制约推理精度(受KV Cache显存限制,仅能截取近期部分数据,丢失设备老化规律等关键信息);三是场景适配性差,无法应对复杂工况(常规检修、故障抢修、特殊保电等场景需求差异显著)。
|
||||||
|
|
||||||
|
**1) 整体方案**
|
||||||
|
|
||||||
|
- 模型层优化:进行MoE架构重构与轻量化改造。按配网检修核心需求拆分多个专家网络,各专家网络聚焦设备评估、故障识别等专项任务,通过门控网络动态激活2-3个相关专家网络,降低算力消耗。采用混合精度量化策略,关键层保高精度、非关键层低精度处理,同时量化压缩KV Cache并修正误差,减小模型体积与显存占用,支撑长上下文全量数据推理。
|
||||||
|
- 推理引擎层优化:设计KV Cache多级存储架构与时序预取机制,解决显存瓶颈并降低I/O延迟;通过算子融合、硬件适配、计算复用技术加速计算;采用场景感知批处理策略,结合线路优先级调度,按常规检修、故障抢修、特殊保电场景动态调整参数。
|
||||||
|
- 调度层优化:构建"场景感-策略匹配-资源调度"闭环机制。通过场景识别模型精准判断业务场景,基于预设"场景-推理参数"映射关系自动匹配最优参数。依托分布式推理集群,采用负荷感知动态分配策略,搭配弹性扩容机制,适配不同场景需求并应对业务波动。
|
||||||
|
|
||||||
|
**2) 场景适配**
|
||||||
|
|
||||||
|
多源数据适配:针对配网时序运行数据、结构化台账、非结构化报告与图像等多样数据类型,开发专用预处理插件;预处理与推理引擎异步并行,缩短数据处理耗时。安全合规适配:严格遵循电力行业等保要求与监控系统安全防护规定;数据传输采用加密算法;推理结果添加数字签名;系统部署于电力专用安全区域;集成操作日志审计模块。业务流程适配:贴合检修"计划生成-审核-下发"全流程,增设针对性功能模块。推理后自动比对设备禁止检修时段,冲突时触发告警;支持运维人员可视化查看调整结果,修改后系统自动重算关联线路影响。
|
||||||
|
|
||||||
|
### (四)司法检察领域:检察院"数字检察"项目
|
||||||
|
|
||||||
|
案例实施单位:某人民检察院、华为技术有限公司。
|
||||||
|
|
||||||
|
某人民检察院作为智能化建设首批试点单位,致力于打造"数字检察"地标性工程,重点解决"信息孤岛"与"数据烟囱"问题,构建大数据法律监督体系。项目以高性能AI存储与昇腾算力为基础,构建覆盖智能问答、案卡填充、卷宗分析等场景的智能化平台。
|
||||||
|
|
||||||
|
**1) 整体方案**
|
||||||
|
|
||||||
|
项目整体采用"存算协同"架构,训练集群由8台800T A2昇腾服务器搭建,推理集群由8台同型号服务器与高性能AI存储OceanStorA800共同组成,并配备通用服务器、存储及数据通信设备,为检察核心数据提供统一底座支撑。方案通过CCAE等智能化管控平台实现资源池化管理,借助容器化技术封装AI应用。
|
||||||
|
|
||||||
|
**2) 创新情况**
|
||||||
|
|
||||||
|
"以存助算"架构创新:利用高性能AI存储的长记忆内存能力,在推理过程中加载缓存,避免重复计算,显著减轻算力压力,实现毫秒级响应。长序列数据处理创新:采用KV Cache缓存机制,对长卷宗等缓存数据进行分级存储,攻克长文本处理瓶颈,提升法律文书生成质量。知识库动态更新机制:引入RAG技术构建法律知识库,实时更新法律条文与判例,有效约束内容生成,消除模型"幻觉",推动检察业务从"经验决策"向"数据驱动"转型。
|
||||||
|
|
||||||
|
**3) 应用实效**
|
||||||
|
|
||||||
|
通过该方案的实施,系统在推理阶段TTFT降低40%,吞吐量提升5倍,大幅提升了智能问答、案卡回填与卷宗分析等场景的处理效率。法律文书生成质量得到显著改善,数据处理与知识检索的精准度进一步增强。
|
||||||
|
|
||||||
|
### (五)农畜领域:面向农畜养殖业务的推理优化
|
||||||
|
|
||||||
|
案例实施单位:某养殖场、北京百度网讯科技有限公司。
|
||||||
|
|
||||||
|
某养殖场区每年都会发生不同程度的安全事故。为了降低风险、提升管理效率,企业希望借助视频监控与智能识别技术,对现场饲养员作业行为进行实时监测。一旦识别出违规操作,系统能够自动推送告警给现场负责人,便于第一时间干预和处置。
|
||||||
|
|
||||||
|
**1) 主要场景与存在问题**
|
||||||
|
|
||||||
|
有限空间作业防护违规(饲养员没有穿防护服或者暴露衣着作业,存在病菌感染风险);有限空间作业违规智能养殖操作(刷圈、防疫、消毒、加水、上饲料、设备异常等)。园区几千名饲养员,每个饲养员负责千头牲畜日常、卫生打扫等。当前系统采用本地部署的多模态大模型进行视频图像识别,整体场景精度约60.99%,仍有较多延迟、漏报,无法完全满足业务对高实时性的要求。
|
||||||
|
|
||||||
|
**2) 整体方案**
|
||||||
|
|
||||||
|
本方案以智能监控饲养员作业业务特性为核心,从模型、推理引擎、调度层三大关键层面构建全链路优化方案。大模型将Prefill和Decode两推理阶段分开处理,PD分离服务部署可以提高GPU/NPU/XPU的利用率,将Prefill实例和Decode实例分开部署,减少Prefill阶段和Decode阶段分时复用在时延上造成的互相干扰,实现同时延下吞吐提升。
|
||||||
|
|
||||||
|
不同加速卡部署方案:GPU PD分离方案(Scheduler单Pod副本+Prefill+Decode);XPU PD分离方案(Scheduler单Pod副本+Prefill+Decode);NPU PD分离方案(MindIE MS Controller单Pod副本、MindIE MS Coordinator单Pod副本以及MindIE Server区分Prefill和Decode,由Mindie动态调度P进程和D进程);P实例和D实例通过Headless Service传输KV-Cache,XPU原始方案中使用redis共享KV-Cache,由推理镜像内部闭环。
|
||||||
|
|
||||||
|
以NPU为例:单机PD分离服务部署方案,通过K8s的Service开放PD集群的推理入口,创建1个K8s的Deployment部署一个Pod,其中以进程方式分别部署MindIE MS Controller(单进程副本)、MindIE MS Coordinator(单进程副本)以及MindIE Server(多进程副本)。多机PD分离服务部署方案,通过K8s的Service为Coordinator Pod开放PD集群的推理入口,创建3个K8s的Deployment分别部署MindIE MS Controller(单Pod副本)、MindIE MS Coordinator(单Pod副本)以及MindIE Server(多Pod副本)。
|
||||||
|
|
||||||
|
## 六、展望
|
||||||
|
|
||||||
|
大模型推理优化正朝着"协同化、智能化、场景化"的方向深度演进,技术突破与产业需求的深度耦合将重塑推理服务生态。未来,"模型-架构-场景"协同优化将成为核心范式,模型设计将深度融入推理友好性考量,架构创新将进一步适配不同场景的性能诉求,形成全链路优化闭环。
|
||||||
|
|
||||||
|
异构算力与解耦架构将走向精细化协同。以PD分离、AF分离为代表的推理解耦架构,将与擅长计算密集、访存密集等不同负载的各类硬件深度协同,通过阶段分层调度、模块异构部署,实现算力资源与任务特性的精准匹配,在提升吞吐与能效比的同时,压缩单Token推理成本。自适应调度与智能化推理将成为主流。通过结合SLO的资源配置、并行策略调整及缓存管理,实现负载波动下的自动适配与性能稳定,大幅减少人工干预。
|
||||||
|
|
||||||
|
多模态与长序列推理优化将迎来突破,KV Cache高效管理、跨模态数据协同计算、长序列并行处理等技术创新,将打破当前应用边界,支撑更复杂的智能体交互、超长文档分析等场景落地。同时,性能评估与优化的标准化进程将加速,形成统一的指标体系与测试规范,为产业发展提供有序指引。
|
||||||
|
|
||||||
|
整体来看,大模型推理优化将推动AI服务从"能用"向"好用、省用"跨越,成为赋能千行百业数字化转型的核心引擎。
|
||||||
|
|
||||||
|
## 编制说明
|
||||||
|
|
||||||
|
本研究报告自2025年9月启动编制,分为前期研究、框架设计、文稿起草、征求意见和修改完善五个阶段。面向大模型推理基础设施的技术提供方和应用方开展了深度访谈和调研等工作。
|
||||||
|
|
||||||
|
本报告由中国信息通信研究院人工智能研究所撰写,撰写过程中得到了中国人工智能产业发展联盟、华为技术有限公司、中移九天人工智能科技(北京)有限公司、中国电信股份有限公司研究院、中国电力科学研究院有限公司、北京百度网讯科技有限公司、杭州华电能源工程有限公司、京东科技信息技术有限公司、中电信人工智能科技(北京)有限公司、蚂蚁科技集团股份有限公司、北京大学、北京航空航天大学、之江实验室、济南浪潮数据技术有限公司、山东省科学院高新技术产业(中试)基地、北京矩量无限科技有限公司、北京焱融科技有限公司、是石科技(平湖)有限公司、星环信息科技(上海)股份有限公司等单位的大力支持。
|
||||||
@@ -0,0 +1,81 @@
|
|||||||
|
# 📊 文章摘要:大模型推理优化关键技术与应用实践研究报告(2026年)
|
||||||
|
|
||||||
|
> **原文**:[2026-03-31_大模型推理优化关键技术与应用实践研究报告_2026年.md](./2026-03-31_大模型推理优化关键技术与应用实践研究报告_2026年.md)
|
||||||
|
> **原文链接**:https://www.caict.ac.cn/kxyj/qwfb/ztbg/202604/P020260415615308750699.pdf
|
||||||
|
> **来源**:中国信通院
|
||||||
|
> **作者**:中国信息通信研究院人工智能研究所
|
||||||
|
> **发布日期**:2026-03-31
|
||||||
|
> **摘要日期**:2026-08-06
|
||||||
|
> **价值评级**:⭐⭐⭐ 高
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 核心命题
|
||||||
|
|
||||||
|
> **协同优化** — 推理优化从单点技术走向"模型-引擎-系统"全链路、以 SLO 为约束的协同优化,PD 分离、AF 分离与 KV Cache 多级存储成为主流架构范式。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 文章概要
|
||||||
|
|
||||||
|
本报告系统梳理大模型推理优化的全景:推理已取代训练成为落地焦点(ChatGPT 企业版 API Token 消耗 12 个月暴增 320 倍,平均序列长度两年增长 32 倍至 128K);将推理优化定义为在保障 SLO 前提下兼顾"效果-性能-成本"的全链路工程,提出模型(压缩、MoE、算法创新)、引擎(显存、计算、并行、批调度)、系统(PD 分离、AF 分离、调度策略、高性能存储)三级优化体系;梳理 PD 分离演进脉络(DistServe→Splitwise→TetriInfer→MemServe)与 Mooncake、Dynamo、UCM 及 DeepSeek、MegaScale-Infer、Step-3 等工业级方案的实测数据,并附金融、运营商、电力、司法、农畜五类落地案例。权威性与体系性是最大价值;局限在于案例数据多由方案提供方自报,前瞻数据预测成分较高。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 关键要点
|
||||||
|
|
||||||
|
1. **推理成为落地焦点** — ChatGPT 企业版 API Token 消耗 12 个月暴增 320 倍;2026 年推理占计算工作负载 66%,中国推理算力市场规模 876.5 亿元(近翻倍)`[分类: 共识]`
|
||||||
|
2. **推理优化的定义与目标** — SLO 前提下"效果-性能-成本"多目标协同,贯穿"压缩-部署-推理-服务"四个环节;当前处于第二、第三阶段(单点提效→协同优化)`[分类: 共识]`
|
||||||
|
3. **三级优化体系** — 模型层(量化/蒸馏/MoE/MLA 低秩压缩)、引擎层(PagedAttention 并发 +3 倍、FlashAttention、混合并行、连续批处理、Chunked-Prefills)、系统层(PD/AF 分离、调度、多级存储)`[分类: 共识]`
|
||||||
|
4. **PD 分离架构** — 预填充计算密集(GEMM、TTFT)、解码存储密集(GEMV、TBT),"阶段解耦、专用部署、并行调度";三大挑战:KV Cache 跨节点传输开销、解码阶段显存压力、缓存协同复杂 `[分类: 共识]`
|
||||||
|
5. **AF 分离架构** — 将 MoE 的 Attention 模块(访存密集)与 Feedforward 模块(计算密集)拆分至异构节点独立扩展,标志系统架构从阶段分治迈向模块分治 `[分类: 范式突破]`
|
||||||
|
6. **工业级方案实测** — Mooncake(月之暗面)有效吞吐 +75%、长上下文最高 +525%;Dynamo(英伟达)四级存储+SLO-based Planner;UCM(华为)TTFT 最高降 90%、吞吐最大提升 22 倍;DeepSeek 推理成本利润率 545%;MegaScale-Infer 单 GPU 解码吞吐较 vLLM 提升 7.11 倍、单位成本吞吐 +224%;Step-3 每百万 token 成本 0.055 美元,为 DeepSeek-V3 的 80% `[分类: 争议]`(指标均出自方案提供方)
|
||||||
|
7. **KV Cache 多级存储** — HBM-DRAM-SSD 三级动态架构,"以存换算";落地挑战:跨层级一致性、存储带宽数量级差异导致的 I/O 瓶颈 `[分类: 共识]`
|
||||||
|
8. **行业案例验证** — 金融(长文档 KV 预热、80K 压缩至 16K、30 并发 TTFT 降 66%)、运营商(训推一体+PD 分离单卡吞吐翻倍)、电力(MoE 重构+场景感知调度)、司法(TTFT 降 40%、吞吐提升 5 倍)、农畜(PD 分离多卡适配)`[分类: 共识]`
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 批判性分析
|
||||||
|
|
||||||
|
### 假设前提
|
||||||
|
|
||||||
|
假设推理需求持续指数增长且 GPU 显存稀缺长期存在;假设模型架构沿 MoE、长上下文、多模态方向演进不变;假设"效果-性能-成本"可通过工程手段协同平衡。
|
||||||
|
|
||||||
|
### 论据与逻辑
|
||||||
|
|
||||||
|
行业数据与案例丰富且有出处,技术链条完整;但案例指标多由方案提供方(华为、九天、百度等)自报,缺乏独立第三方复测,"成本利润率 545%"等数字依赖特定定价假设;对前沿方案(AF 分离)的成熟度与普适性未做充分质疑。
|
||||||
|
|
||||||
|
### 边界与局限
|
||||||
|
|
||||||
|
报告为产业综述性质,适合作为技术地图而非直接结论;案例以头部厂商为主,中小团队的可复制性存疑;市场规模、价格等前瞻数据随时间衰减,引用需注明时点。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 可引用金句
|
||||||
|
|
||||||
|
> "大模型推理作为人工智能技术从实验室走向产业应用的'最后一公里',承载着将模型能力转化为实际业务价值、平衡服务质量与成本投入的核心使命。"
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 总体评价
|
||||||
|
|
||||||
|
**亮点**:
|
||||||
|
- 首次系统性构建"模型-引擎-系统"三级优化体系与四阶段演进框架,全景式覆盖推理优化技术栈
|
||||||
|
- PD 分离演进脉络与工业级方案(Mooncake/Dynamo/UCM/MegaScale-Infer/Step-3)实测数据详实,可直接指导选型
|
||||||
|
- 明确指出现有方案的三大挑战与多级存储落地难点,边界意识强
|
||||||
|
- 五类行业案例覆盖金融、运营商、电力、司法、农畜,验证落地价值
|
||||||
|
|
||||||
|
**不足**:
|
||||||
|
- 案例与方案指标多出自提供方自报,缺少独立验证
|
||||||
|
- 对 AF 分离等前沿范式的争议面讨论不足
|
||||||
|
- 部分前瞻数据(市场规模、消耗量)预测成分较高
|
||||||
|
|
||||||
|
**适用场景**:推理基础设施规划者、技术决策者、行业研究者;作为理解推理优化技术栈与产业路线的权威参照地图。
|
||||||
|
|
||||||
|
**关联建议**:对照 NVIDIA Dynamo 博客与 Mooncake 开源项目获取一手工程细节;结合 Introl 推理经济学验证成本数据;关注信通院后续报告以追踪四阶段演进中"深度融合"阶段的进展。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 配图
|
||||||
|
|
||||||
|

|
||||||
@@ -0,0 +1,64 @@
|
|||||||
|
# [中邮证券]:底座算力跃迁到token工厂的新机会
|
||||||
|
|
||||||
|
> **来源**:中邮证券
|
||||||
|
> **作者**:孙业亮、刘聪颖
|
||||||
|
> **发布日期**:2026-06-16
|
||||||
|
> **原文链接**:https://www.fxbaogao.com/detail/5481471
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
行业投资评级:强于大市 | 维持
|
||||||
|
|
||||||
|
孙业亮 / 刘聪颖,中邮证券研究所计算机团队
|
||||||
|
|
||||||
|
发布时间:2026-06-16
|
||||||
|
|
||||||
|
## 投资要点
|
||||||
|
|
||||||
|
- **算力需求爆发式增长,全球竞争日益激烈**:随着人工智能、大数据、工业互联网等数字化技术规模化应用,全球算力需求高速增长;据中国信通院数据,截至2024年底,全球通算规模达628EFlops,同比增加14.0%,智算规模达5693EFlops,同比增加64.7%;据IDC预测,2025年全球人工智能服务器市场规模为1587亿美元,2028年有望达到2227亿美元。
|
||||||
|
- **Token经济正在开展一场智能定价革命**:根据全球最大AI模型API聚合平台OpenRouter最新数据显示,3月16日至22日,全球AI大模型总Token调用量为20.4万亿,仅中国就达7.359万亿,占全球的36%,Token是其关键的主角之一。与传统算力租赁模式不同,"Token工厂"交付的不是算力时间,而是经深度优化后产出的智能单位Token,这不仅是技术升级,更是商业模式与价值分配的重构。
|
||||||
|
- **投资建议**:建议关注1)AI基础设施:海光信息、寒武纪、中科曙光、浪潮信息、禾盛新材、协创数据等;2)AIDC厂商:润泽科技、东阳光、光环新网、数据港、奥飞数据、大位科技、豫能控股、世纪互联等;3)算力租赁厂商:宏景科技、润建股份、东方国信、首都在线等;4)运营商与云计算:中国电信、中国移动、中国联通、网宿科技、彩讯股份、优刻得等。
|
||||||
|
- **风险提示**:行业竞争加剧风险;下游应用需求不及预期风险;Token价格大幅波动风险等。
|
||||||
|
|
||||||
|
## 大模型驱动算力需求指数级增长
|
||||||
|
|
||||||
|
**AI高速发展推动各行业数智化转型,全球算力需求高速增长。** 大模型正呈现由训练主导向训练与推理并重,由中心集聚向分布协同演进,训练与推理环节对算力双重刚需,显著推动智能算力基础设施踏上快速发展轨道;此外,用户对智能算力服务的诉求也由获取底层资源转向获取任务能力、结果交付与普惠化服务。据中国信通院数据,截至2024年底,全球通算规模达628 EFlops,同比增加14.0%;智算规模达5693 EFlops,同比增加64.7%。
|
||||||
|
|
||||||
|
**智能体带来AI应用革命,算力需求的重点正从训练侧逐步转向推理侧。** 智能体需要持续感知环境、反复调用工具、不断生成结果,并与用户进行多轮交互,以Open Claw为代表的各类智能体应用加速涌现,推动AI产业迈向"应用落地"与"规模化服务"新阶段。据IDC数据,中国企业活跃智能体数量将在2031年突破3.5亿规模,年复合增长率达到135%以上,这一增速将领先全球主要市场;同时,由于智能体任务执行密度的增长和任务复杂度的提升,也将带来智能体Token消耗年均超30倍的指数级跃升。(资料来源:IDC咨询公众号,中邮证券研究所)
|
||||||
|
|
||||||
|
**政策层面已明确路线图与时间表:** 国务院印发的《关于深入实施人工智能+行动的意见》提出,到2027年新一代智能终端、智能体等应用普及率超过70%,人工智能在公共治理中的作用明显增强,到2030年提升至90%以上;工信部等八部门联合印发的《"人工智能+制造"专项行动实施意见》,明确到2027年将推动3-5个通用大模型在制造业深度应用,培育1000个高水平工业智能体,打造100个工业领域高质量数据集,推广500个典型应用场景,培育2-3家具有全球影响力的生态主导型企业和一批专精特新中小企业;地方政府同步跟进部署,面向制造业、金融、政务、医疗等重点领域,加快智能体产业布局。(资料来源:工信部官网,中邮证券研究所)
|
||||||
|
|
||||||
|
**海外AI资本开支快速增长:** 微软、谷歌等美国科技巨头纷纷加大资本开支,特别是在GPU采购、数据中心、电力上的投入,大模型训练成本极高,导致只有头部云服务商和AI公司能负担,早期积累的模型质量、用户数据和算力规模会形成"马太效应",谁在大模型和应用生态中占领先机,就会获得巨大战略优势。
|
||||||
|
|
||||||
|
**中国正快速实现追赶:** 腾讯表示,今年下半年AI相关的资本支出会进一步增加;阿里表示,未来AI基建相关投入资金会远远超过3800亿;字节计划2026年资本支出将超过2000亿元人民币,较此前的初步计划增加了25%。
|
||||||
|
|
||||||
|
**Token消耗快速增长:** Token(词元)是连接技术供给与商业需求的"结算单位",到2026年3月,我国日均Token调用量已超过140万亿,较2024年初增长了1000多倍,标志着AI发展已进入以推理和应用为核心的快速增长阶段;智能时代Token成为核心生产要素,伴随着智能体应用爆发,其需求呈指数级增长,预计2030年中国日均消耗Token量将达万万亿级,AI基础设施变得愈加重要。据IDC预测,2026年中国MaaS市场的Token消耗量将达到约4万万亿次,营收规模约186亿元,2024-2030年的年复合增长率约为1154.9%。
|
||||||
|
|
||||||
|
## Token工厂重构算力商业模式
|
||||||
|
|
||||||
|
**"Token工厂"重塑价值产出:** 作为大模型处理信息的最小单元,Token具备可计量、可定价、可交易的特性,既是AI服务的基本结算单元,也正成为数字经济的核心"能源","Token工厂"是高效连接起算力、模型与应用的枢纽;与传统算力租赁模式不同,"Token工厂"交付的不是算力时间,而是经深度优化后产出的智能单位Token,这不仅是技术升级,更是商业模式与价值分配的重构。未来智算中心竞争不只是芯片之争,更是软件、网络、能源、运营和生态的综合竞争。Token工厂正在把数据中心从基础设施行业推向制造业,而制造业的核心从来不是规模,而是效率。
|
||||||
|
|
||||||
|
**Token的经济成本可拆解为资本性开支和运营性开支两部分:** 训练阶段以CAPEX主导,是一次性的重资本密集投入;推理阶段以OPEX主导,是随Token规模扩张的持续性边际成本。
|
||||||
|
|
||||||
|
- **训练阶段CAPEX主导固定成本:** 训练一个千亿参数级别的通用大模型,全流程需驱动数万张高端GPU连续运转数月,总成本约1-5亿美元;成本结构中,硬件折旧与高端研发人力薪酬合计占比超95%,电力消耗不足5%;单位Token摊销额随Token总产出增加而持续递减,构成Token规模经济的根本来源。
|
||||||
|
- **推理阶段OPEX主导边际成本:** AI大模型一旦部署,每产生新Token,都需消耗固定的算力与电力,形成与Token调用量高度正相关的可变成本,其中电力成本通常占到OPEX总额的60%-70%,是最大单项开支,电力作为Token推理阶段主体边际成本的地位凸显。
|
||||||
|
|
||||||
|
**Token的定价锚逐渐从GPU→能源→人才方向转移:** Token的生产成本由芯片、电力、数据与人才四大要素构成,在不同阶段,决定Token价格底线的关键要素并不相同,定价权会沿着技术演进的节奏在四大要素之间逐步让渡。
|
||||||
|
|
||||||
|
- **当前阶段芯片是主锚:** 高端GPU供不应求,芯片的可获取性直接决定了Token的供给量与价格;
|
||||||
|
- **中期来看电力将成为硬性约束:** 电力受物理定律限制,随着AI数据中心能耗激增,能源成本将成为不可压缩的底线;
|
||||||
|
- **长期来看人才与知识密度将主导定价:** 大模型能力越强、在高端场景中为用户带来的边际收益越高,Token的溢价空间就越大。
|
||||||
|
|
||||||
|
**海外三巨头OpenAI、Google、Anthropic均采用"输入/输出双轨Token计费",核心依靠产品分层与生态协同盈利。**
|
||||||
|
|
||||||
|
- **OpenAI用分层价格锁定全层级客户,依靠生态壁垒竞争:** GPT系列采用阶梯化价值定价,高端推理模型保持高溢价,轻量微型模型小幅让利吸引开发者;其中,旗舰GPT-5.5每百万输入Token 5美元、输出30美元,面向企业复杂智能体、长周期推理任务,赚取核心利润;GPT-4o mini轻量化模型大幅下放价格,用于吸纳C端应用、小型开发者,构建全球最大开发者生态;收入结构不单一依赖Token计费,还叠加ChatGPT订阅、企业席位、智能体会话时长、文件存储等增值服务。
|
||||||
|
- **Google进行云生态捆绑,将Token作为GCP的导流工具:** Google不单独售卖大模型API,而是将Gemini全套Token能力与GoogleCloud深度打包,Token定价拥有全行业最宽价格区间,从Flash-Lite超低价版本到3.1 Pro高端模型全覆盖;低价轻量模型补贴云业务,高端推理算力绑定政企云订单,依托搜索增强、多模态原生能力,把Token消耗转化为云存储、算力集群、容器服务增值收入;Token是云计算的增值配套,AI业务目标是拉动GCP整体市占提升。
|
||||||
|
- **Anthropic坚持品质定价:** 依靠超长上下文、企业级数据安全、合规能力建立品牌溢价;其中,主力Sonnet 4.6每百万输入3美元、输出15美元,旗舰Opus 4.6则定价翻倍,瞄准金融、法律、政务高敏感企业客户,不比拼调用总量,只为对数据安全、推理精度有刚性需求的企业提供服务,天然避开同质化低价竞争;此外还推出智能体会话按时长计费、分层缓存定价,跳出单纯按Token收费的单一模式。
|
||||||
|
|
||||||
|
**随着MaaS与Token成为行业共识,头部厂商悉数重兵入场,竞争焦点也从规模化消耗Token,转向高质量、高效率、高价值消耗Token。**
|
||||||
|
|
||||||
|
- **阿里Token Foundry:** 今年3月阿里已推出Alibaba Token Hub事业群,搭建"创造-分发-应用"词元基础框架;时隔三月升级为Token Foundry事业部,定位完成全面跃迁,不再单纯标准化输出通用词元,而是根据电商、零售、本地生活、企业办公等不同场景,定制推理链路、优化词元结构、搭建专属Agent词元工作流;同样一组词元,在通用对话仅产生流量,在阿里本地生活智能体可完成商家运营、订单调度、用户服务全流程,直接带来营收增量,以此重构词元定价逻辑,对冲行业低价内卷带来的毛利压力。
|
||||||
|
- **字节:** 一方面,Seed团队持续攻坚技术极限,打造视频生成、图像创作、代码编程、文本理解等全领域SOTA标杆模型,不断刷新模型能力上限;另一方面,火山引擎也将技术能力加速工具化、产品化,高效推向市场;Token价格必须与模型能力、产出价值绑定,即使单Token理论成本可能更高,但创造的经济价值要同步提升,要提升Token能力,并确保定价优势。
|
||||||
|
- **华为数字能源Token Factory:** 与阿里聚焦上层模型、场景应用的Token Foundry形成鲜明对照,华为数字能源从AIDC算力基础设施维度,定义产业底层的Token Factory;传统数据中心是存储数据的电子仓库,而新一代智算中心是工业化量产词元的专属工厂,电力作为生产原料,昇腾算力集群、液冷供电、储能系统作为生产设备,持续稳定输出标准化、可计量的推理词元;华为Token Factory不绑定单一厂商大模型,是中立的算力基础设施底座,无论阿里Token Foundry、华为云盘古大模型,还是第三方企业MaaS平台,均可接入华为AIDC词元工厂获取规模化算力供给。
|
||||||
|
- **腾讯:** 将原隶属于腾讯云的MaaS大模型服务平台升级为"TokenHub",升级后的TokenHub支持通过API调用混元、DeepSeek、MiniMax等主流大模型,并提供Token Plan统一计费。
|
||||||
|
- **五象云谷词元(Token)工厂:** 基础层,五象云谷智算中心总算力规划40000P,为Token生产提供坚实的算力底座;平台层,算力调度+模型优化+算法加速,三重技术协同发力,通过异构算卡细粒度虚拟化、队列抢占机制与自研算法加速引擎,大幅提升Token吞吐量,将单位生产成本极致压榨,降低Token单位成本;服务层,Token管理平台集成API接口(注:原文此页内容到此截断)。
|
||||||
@@ -0,0 +1,79 @@
|
|||||||
|
# 📊 文章摘要:[中邮证券]:底座算力跃迁到token工厂的新机会
|
||||||
|
|
||||||
|
> **原文**:[2026-06-16_中邮证券_底座算力跃迁到token工厂的新机会.md](./2026-06-16_中邮证券_底座算力跃迁到token工厂的新机会.md)
|
||||||
|
> **原文链接**:https://www.fxbaogao.com/detail/5481471
|
||||||
|
> **来源**:中邮证券
|
||||||
|
> **作者**:孙业亮、刘聪颖
|
||||||
|
> **发布日期**:2026-06-16
|
||||||
|
> **摘要日期**:2026-08-06
|
||||||
|
> **价值评级**:⭐⭐ 中
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 核心命题
|
||||||
|
|
||||||
|
> **Token 工厂** — 算力商业模式从"租赁时间"转向"交付 Token",定价锚沿"GPU→能源→人才"迁移,Token 成为智能时代的核心结算单位。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 文章概要
|
||||||
|
|
||||||
|
中邮证券研报认为,AI 算力需求正从训练侧转向推理侧,Token 成为连接技术供给与商业需求的"结算单位"(2026 年 3 月我国日均 Token 调用量超 140 万亿,较 2024 年初增长 1000 多倍);"Token 工厂"交付的是经深度优化产出的智能单位 Token 而非算力时间,是商业模式与价值分配的重构。报告拆解成本结构:训练 CAPEX 主导(千亿参数总成本 1-5 亿美元),推理 OPEX 主导(电力占 60-70%),并梳理 OpenAI/Google/Anthropic 计费策略与阿里 Token Foundry、华为 Token Factory、腾讯 TokenHub 等国内布局,给出投资建议与风险提示。局限:研报本质是荐股材料,预测数据激进、技术论证浅。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 关键要点
|
||||||
|
|
||||||
|
1. **Token 成为结算单位** — 2026 年 3 月我国日均 Token 调用超 140 万亿、较 2024 年初增长 1000 多倍;OpenRouter 统计中国 Token 调用占全球 36%;预计 2030 年达万万亿级 `[分类: 争议]`(长期预测无公开模型支撑)
|
||||||
|
2. **Token 工厂模式** — 交付智能单位 Token 而非算力时间,把数据中心从基础设施行业推向制造业,核心是效率而非规模 `[分类: 范式突破]`(作者主张,论证尚浅)
|
||||||
|
3. **成本结构拆解** — 训练阶段 CAPEX 主导:千亿参数模型总成本 1-5 亿美元,硬件折旧与人力超 95%、电力不足 5%;推理阶段 OPEX 主导:电力占 60%-70% 为最大单项开支 `[分类: 共识]`
|
||||||
|
4. **定价锚转移** — 当前芯片可获取性决定 Token 供给与价格;中期电力成为物理硬约束;长期人才与知识密度主导溢价 `[分类: 争议]`
|
||||||
|
5. **海外三巨头计费策略** — OpenAI 分层定价+生态壁垒(GPT-5.5 输入 5/输出 30 美元)、Google 云捆绑把 Token 作为 GCP 导流工具、Anthropic 品质定价(Sonnet 4.6 输入 3/输出 15 美元)避开低价竞争 `[分类: 共识]`
|
||||||
|
6. **国内玩家布局** — 阿里 Token Foundry 按场景定制词元工作流、华为 Token Factory 定位中立算力底座(昇腾+液冷+储能)、腾讯 TokenHub 统一计费、五象云谷 40000P 规划 `[分类: 争议]`(厂商布局是事实,商业模式有效性未验证)
|
||||||
|
7. **投资建议与风险** — 关注 AI 基础设施、AIDC、算力租赁、运营商与云计算四类标的;风险为行业竞争、需求不及预期、Token 价格波动 `[分类: 共识]`
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 批判性分析
|
||||||
|
|
||||||
|
### 假设前提
|
||||||
|
|
||||||
|
假设 Token 需求按指数持续增长(智能体 Token 消耗年均超 30 倍);假设算力供给长期紧张使"工厂"模式有利可图;假设 Token 可成为标准化的计量与结算单位。
|
||||||
|
|
||||||
|
### 论据与逻辑
|
||||||
|
|
||||||
|
数据多引自信通院、IDC、OpenRouter 与公司公告,属事实层面;但"2030 年万万亿级""CAGR 1154.9%"等核心预测缺乏公开测算过程,"Token 工厂"与既有算力租赁模式的本质差异也未做严格定义与论证;投资标的推荐体现荐股立场,观点有选择性呈现。
|
||||||
|
|
||||||
|
### 边界与局限
|
||||||
|
|
||||||
|
研报服务投资决策而非工程决策,技术细节极少;对 Token 价格战压缩毛利、需求不及预期的风险提示泛泛;"Token 工厂"叙事包含营销包装成分,其商业可行性(成本回收、定价权)尚无公开验证。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 可引用金句
|
||||||
|
|
||||||
|
> "Token工厂正在把数据中心从基础设施行业推向制造业,而制造业的核心从来不是规模,而是效率。"
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 总体评价
|
||||||
|
|
||||||
|
**亮点**:
|
||||||
|
- "Token 工厂"与"定价锚 GPU→能源→人才"提供了理解推理经济的产业视角
|
||||||
|
- 成本结构拆解(CAPEX/OPEX、电力占比)与三巨头计费策略梳理有信息价值
|
||||||
|
- 国内厂商布局盘点及时,适合快速把握产业动向
|
||||||
|
|
||||||
|
**不足**:
|
||||||
|
- 荐股立场导致观点选择性呈现,预测数据激进且缺测算依据
|
||||||
|
- 技术论证浅,不适合工程参考
|
||||||
|
- "Token 工厂"概念定义模糊,与算力租赁的差异未严格论证
|
||||||
|
|
||||||
|
**适用场景**:产业趋势认知、商业分析师、AI 厂商战略与投资相关人士;不适用于技术选型。
|
||||||
|
|
||||||
|
**关联建议**:对照 Introl 推理经济学文章验证成本结构数据;对照信通院报告了解 Token 背后推理优化的技术现实;关注阿里/华为 Token 工厂后续公开财报与案例验证商业模式。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 配图
|
||||||
|
|
||||||
|

|
||||||
@@ -0,0 +1,66 @@
|
|||||||
|
# KV Cache 缓存可卸载至 SSD:打破内存墙限制,AI SSD迎来广阔成长空间
|
||||||
|
|
||||||
|
> **来源**:发现报告
|
||||||
|
> **作者**:国泰海通证券
|
||||||
|
> **发布日期**:2025-10-28
|
||||||
|
> **原文链接**:https://www.fxbaogao.com/detail/5116282
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
KV Cache缓存可卸载至SSD
|
||||||
|
|
||||||
|
本报告导读:
|
||||||
|
|
||||||
|
- 半导体《AI发展,热管理的核心瓶颈向芯片聚焦》2025.10.06
|
||||||
|
- 半导体《商务部发起模拟IC反倾销调查,国产替代加速》2025.09.14
|
||||||
|
- 半导体《下一代英伟达Rubin CPX内存升级》2025.09.11
|
||||||
|
- 半导体《中芯国际拟发行A股购买中芯北方49%少数股权》2025.08.31
|
||||||
|
- 半导体《3D DRAM:云侧内存市场重要竞争者》2025.08.23
|
||||||
|
|
||||||
|
针对大语言模型(LLM)发展中面临的"内存墙"难题,基于SSD的存储卸载技术方案可为AI模型高效运行提供新路径。
|
||||||
|
|
||||||
|
投资要点:
|
||||||
|
|
||||||
|
推理KV Cache容量增长超出HBM承载能力。键值缓存(KV Cache)技术可以优化计算效率、减少重复运算,即将已生成token的Key和Value临时存储起来,后续生成新token时直接复用,无需重新计算,显著提升推理效率。然而,KV Cache需要占用GPU的显存(如HBM),存储历史Key/Value向量,生成的文本越长,缓存数据量越大,可能导致HBM和DRAM超载。面对大模型PB级的天量数据,传统推理架构过度依赖HBM的瓶颈也日益凸显。随着Agentic AI时代到来,模型规模化扩张、长序列需求激增以及推理任务并发量增长,推理的KV Cache容量增长已超出HBM的承载能力,频繁的内存溢出,需要GPU反复计算,造成卡顿迟缓。KV Cache缓存可从GPU内存offload至CPU、SSD。随着推理性
|
||||||
|
|
||||||
|
能的重要性不断提升,业界均在探索KV Cache分级缓存管理技术。如英伟达今年5月推出了分布式推理服务框架Dynamo,支持将KVCache缓存从GPU内存卸载到CPU、SSD甚至网络存储,解决大模型显存瓶颈,避免重复计算。其中,KVBM提供G1-G4(GPU memory、CPU host memory、SSD、远端存储)的KV Cache卸载,避免大量KVCache重计算。2025开放数据中心大会之新技术与测试(存储)分论坛中,三星电子高级项目经理针对大语言模型(LLM)发展中面临的"内存墙"难题,提出基于SSD的存储卸载技术方案,为AI模型高效运行提供新路径。三星将KV Cache卸载至NVMe SSD。当KV Cache大小超过HBM或DRAM容量时,该方案可使首token延迟(TTFT)最高降低66%,token间延迟(ITL)最高降低42%,且支持多用户多轮对话场景下的KV Cache重用,随着用户与对话轮次增加,I/O吞吐量稳步上升,主要I/O模式为256KB读写。
|
||||||
|
|
||||||
|
AI存储需求激发HDD替代效应,NAND Flash供应商加速转进大容量Nearline SSD。根据TrendForce集邦咨询,AI推理应用快速推升实时存取、高速处理海量数据的需求,促使HDD与SSD供应商积极扩大供给大容量存储产品。由于HDD市场正面临巨大供应缺口,激励NAND Flash业者加速技术转进,投入122TB、甚至245TB等超大容量Nearline SSD的生产。
|
||||||
|
|
||||||
|
风险提示:国产替代进程不及预期;技术迭代不及预期。
|
||||||
|
|
||||||
|
本公司具有中国证监会核准的证券投资咨询业务资格
|
||||||
|
|
||||||
|
分析师声明
|
||||||
|
|
||||||
|
作者具有中国证券业协会授予的证券投资咨询执业资格或相当的专业胜任能力,保证报告所采用的数据均来自合规渠道,分析逻辑基于作者的职业理解,本报告清晰准确地反映了作者的研究观点,力求独立、客观和公正,结论不受任何第三方的授意或影响,特此声明。
|
||||||
|
|
||||||
|
免责声明
|
||||||
|
|
||||||
|
本报告仅供国泰海通证券股份有限公司(以下简称"本公司")的客户使用。本公司不会因接收人收到本报告而视其为本公司的当然客户。本报告仅在相关法律许可的情况下发放,并仅为提供信息而发放,概不构成任何广告。
|
||||||
|
|
||||||
|
本报告的信息来源于已公开的资料,本公司对该等信息的准确性、完整性或可靠性不作任何保证。本报告所载的资料、意见及推测仅反映本公司于发布本报告当日的判断,本报告所指的证券或投资标的的价格、价值及投资收入可升可跌。过往表现不应作为日后的表现依据。在不同时期,本公司可发出与本报告所载资料、意见及推测不一致的报告。本公司不保证本报告所含信息保持在最新状态。同时,本公司对本报告所含信息可在不发出通知的情形下做出修改,投资者应当自行关注相应的更新或修改。
|
||||||
|
|
||||||
|
本报告中所指的投资及服务可能不适合个别客户,不构成客户私人咨询建议。在任何情况下,本报告中的信息或所表述的意见均不构成对任何人的投资建议。在任何情况下,本公司、本公司员工或者关联机构不承诺投资者一定获利,不与投资者分享投资收益,也不对任何人因使用本报告中的任何内容所引致的任何损失负任何责任。投资者务必注意,其据此做出的任何投资决策与本公司、本公司员工或者关联机构无关。
|
||||||
|
|
||||||
|
本公司利用信息隔离墙控制内部一个或多个领域、部门或关联机构之间的信息流动。因此,投资者应注意,在法律许可的情况下,本公司及其所属关联机构可能会持有报告中提到的公司所发行的证券或期权并进行证券或期权交易,也可能为这些公司提供或者争取提供投资银行、财务顾问或者金融产品等相关服务。在法律许可的情况下,本公司的员工可能担任本报告所提到的公司的董事。
|
||||||
|
|
||||||
|
市场有风险,投资需谨慎。投资者不应将本报告作为作出投资决策的唯一参考因素,亦不应认为本报告可以取代自己的判断。在决定投资前,如有需要,投资者务必向专业人士咨询并谨慎决策。
|
||||||
|
|
||||||
|
本报告版权仅为本公司所有,未经书面许可,任何机构和个人不得以任何形式翻版、复制、发表或引用。如征得本公司同意进行引用、刊发的,需在允许的范围内使用,并注明出处为"国泰海通证券研究",且不得对本报告进行任何有悖原意的引用、删节和修改。
|
||||||
|
|
||||||
|
若本公司以外的其他机构(以下简称"该机构")发送本报告,则由该机构独自为此发送行为负责。通过此途径获得本报告的投资者应自行联系该机构以要求获悉更详细信息或进而交易本报告中提及的证券。本报告不构成本公司向该机构之客户提供的投资建议,本公司、本公司员工或者关联机构亦不为该机构之客户因使用本报告或报告所载内容引起的任何损失承担任何责任。
|
||||||
|
|
||||||
|
评级说明
|
||||||
|
|
||||||
|
投资建议的比较标准
|
||||||
|
|
||||||
|
投资评级分为股票评级和行业评级。
|
||||||
|
|
||||||
|
以报告发布后的12个月内的市场表现为比较标准,报告发布日后的12个月内的公司股价(或行业指数)的涨跌幅相对同期的沪深300指数涨跌幅为基准。
|
||||||
|
|
||||||
|
国泰海通证券研究所
|
||||||
|
|
||||||
|
地址上海市黄浦区中山南路888号
|
||||||
@@ -0,0 +1,75 @@
|
|||||||
|
# 📊 文章摘要:KV Cache 缓存可卸载至 SSD:打破内存墙限制,AI SSD 迎来广阔成长空间
|
||||||
|
|
||||||
|
> **原文**:[2025-10-28_KV_Cache_缓存可卸载至_SSD_打破内存墙限制_AI_SSD迎来广阔成长空间.md](./2025-10-28_KV_Cache_缓存可卸载至_SSD_打破内存墙限制_AI_SSD迎来广阔成长空间.md)
|
||||||
|
> **原文链接**:https://www.fxbaogao.com/detail/5116282
|
||||||
|
> **来源**:发现报告(转载国泰海通证券研报)
|
||||||
|
> **作者**:国泰海通证券
|
||||||
|
> **发布日期**:2025-10-28
|
||||||
|
> **摘要日期**:2026-08-06
|
||||||
|
> **价值评级**:⭐ 低
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 核心命题
|
||||||
|
|
||||||
|
> **SSD 破墙** — KV Cache 卸载至 SSD 缓解"内存墙",打开 AI SSD 板块成长空间。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 文章概要
|
||||||
|
|
||||||
|
国泰海通证券半导体行业快评,提出"推理 KV Cache 容量增长超出 HBM 承载能力,缓存可卸载至 CPU/SSD,AI SSD 迎来广阔成长空间"的投资观点。论据有二:英伟达今年 5 月发布的 Dynamo 框架支持 KV Cache 从 GPU 卸载到 CPU、SSD 甚至网络存储(KVBM 提供 G1—G4 四级卸载);三星在 2025 开放数据中心大会提出的 SSD 卸载方案显示,KV Cache 超容时 TTFT 最高降 66%、ITL 最高降 42%,支持多轮对话 KV 复用,主 I/O 模式为 256KB 读写。叠加 TrendForce 数据(HDD 供应缺口促使 NAND 厂商转产 122TB/245TB Nearline SSD),推导出 AI 存储需求红利。全文篇幅短、论据少,属题材驱动的投资线索而非深度研究。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 关键要点
|
||||||
|
|
||||||
|
1. **内存墙与 KV Cache 超载** — Agentic AI 时代模型规模化、长序列与并发增长使 KV Cache 超出 HBM 承载,频繁内存溢出导致 GPU 反复重算 `[分类: 共识]`
|
||||||
|
2. **分级卸载成为行业方向** — 英伟达 Dynamo/KVBM 支持 G1—G4(GPU 显存/CPU 内存/SSD/远端存储)四级 KV Cache 卸载;业界均在探索分级缓存管理 `[分类: 共识]`
|
||||||
|
3. **三星 SSD 卸载的量化收益** — KV Cache 超容时 TTFT 最高降 66%、ITL 最高降 42%,多用户多轮对话下 KV 重用使 I/O 吞吐稳步上升 `[分类: 共识]`
|
||||||
|
4. **HDD 缺口催化 NAND 转产** — 据 TrendForce,HDD 供应缺口激励 NAND 厂商投入 122TB、245TB 超大容量 Nearline SSD 生产 `[分类: 共识]`
|
||||||
|
5. **投资结论与风险** — AI 推理需求推升实时存取与高速处理需求,AI SSD 供应商受益;风险提示为国产替代与技术迭代不及预期 `[分类: 争议]`
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 批判性分析
|
||||||
|
|
||||||
|
### 假设前提
|
||||||
|
|
||||||
|
假设 KV Cache 卸载至 SSD 会被行业大规模采用——而 HBM 扩容、CXL 内存池化、远端 DRAM 等替代路线可能分流需求;假设三星案例的收益数据可外推为 SSD 出货增长;假设 Nearline SSD 需求主要由 AI 推理驱动。
|
||||||
|
|
||||||
|
### 论据与逻辑
|
||||||
|
|
||||||
|
论据单薄:核心证据仅三星一个案例与 TrendForce 一条产业数据,且均为转述、无原始报告细节;从"存在卸载技术"到"AI SSD 广阔成长空间"之间缺少市场规模测算、渗透率假设与竞争格局分析,论证链存在明显跳跃。
|
||||||
|
|
||||||
|
### 边界与局限
|
||||||
|
|
||||||
|
属半导体行业快评,面向投资决策而非技术读者;未讨论卸载方案的延迟代价、网络带宽瓶颈与 Dynamo 生态成熟度等不确定性;风险提示仅两句格式化文字,未覆盖核心假设的证伪条件(如卸载路线被 CXL/远端 DRAM 取代)。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 可引用金句
|
||||||
|
|
||||||
|
> "KV Cache缓存可从GPU内存offload至CPU、SSD。"
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 总体评价
|
||||||
|
|
||||||
|
**亮点**:
|
||||||
|
- 用最短篇幅把"KV Cache 卸载"技术趋势与"AI SSD"投资主题挂钩,题材时效性好
|
||||||
|
- 引用了英伟达 Dynamo 与三星方案这两个 2025 年最新行业动向,信息点有参考价值
|
||||||
|
|
||||||
|
**不足**:
|
||||||
|
- 论据与论证深度不足,缺市场规模、供应链与竞争分析;未讨论替代技术路线
|
||||||
|
- 风险提示流于形式;对技术方案的工作原理与代价说明甚少
|
||||||
|
|
||||||
|
**适用场景**:关注 AI 存储板块的投资者快速了解题材逻辑;作为"KV Cache 卸载"技术动向的新闻式线索,细节需另行核实。
|
||||||
|
|
||||||
|
**关联建议**:核实英伟达 Dynamo KVBM 官方文档与三星发布会原始数据;对比极客公园 Tair 方案(远端存储走 3FS 而非本地 SSD)理解技术路线分歧;查阅 TrendForce 原报告确认 Nearline SSD 供需数据。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 配图
|
||||||
|
|
||||||
|
本篇文章为低价值,未生成配图。
|
||||||
@@ -0,0 +1,766 @@
|
|||||||
|
# 【大模型基础设施工程】04:互联与网络——NVLink、InfiniBand、RoCE 与国产替代
|
||||||
|
|
||||||
|
> **来源**:土法炼钢兴趣小组的算法知识备份
|
||||||
|
> **作者**:未知
|
||||||
|
> **发布日期**:2026-04-22
|
||||||
|
> **原文链接**:https://quant67.com/post/llm-infra/04-interconnect/04-interconnect.html
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
> 算力决定上限,__互联决定利用率__。
|
||||||
|
>
|
||||||
|
> —— 做过万卡训练的人都懂这句话
|
||||||
|
|
||||||
|
在 2023 年之前,很多训练团队把精力都放在"怎么把 GPU 堆多"。到了 2024—2026 年,业界共识变了:__GPU 本身已经不是瓶颈,网络才是__。同样一批 H100,接在 3.2 Tb/s 无损 RDMA 上,训练一个 70B 模型的 MFU(Model FLOPs Utilization)能做到 50%+;接在普通 100G 以太网上,可能只有 20%,甚至跑着跑着因为 PFC 死锁挂掉。
|
||||||
|
|
||||||
|
这一篇就围绕__互联网络__展开,分两条主线:
|
||||||
|
|
||||||
|
- __Scale-up__:机内、柜内,极致带宽、极低延迟,目标是"把一堆 GPU 变成一台巨型 GPU"。代表技术:NVLink / NVSwitch / NVL72 / Infinity Fabric / HCCS / CXL。
|
||||||
|
- __Scale-out__:跨机、跨 Pod,横向扩展到万卡、十万卡。代表技术:InfiniBand、RoCEv2、UEC、Fat-Tree、Rail-optimized、Dragonfly。
|
||||||
|
|
||||||
|
我们会从物理层聊到拓扑层,从 AllReduce 聊到故障域,最后给出训练工程师视角下"集合通信打不满怎么办"的排查清单,以及 `nccl-tests` 的实操。
|
||||||
|
|
||||||
|
## 一、为什么 LLM 训练对网络这么敏感
|
||||||
|
|
||||||
|
### 1.1 万卡训练的流量特征
|
||||||
|
|
||||||
|
传统 HPC 里,通信占比高的是 CFD、分子动力学;传统数据中心里,流量是典型的 "南北向为主 + 东西向微服务"。__LLM 训练不是这两者__,它的流量画像非常独特:
|
||||||
|
|
||||||
|
1. __周期性、同步、大包、突发__:一个 step 内所有 GPU 同时发起 AllReduce / AllGather / ReduceScatter,瞬时把链路打满,下一秒又全部静默。
|
||||||
|
2. __Bandwidth-bound__:梯度、激活、KV 的传输都是几 MB 到几 GB 的大块,对带宽敏感远大于对延迟敏感(小消息 latency 影响流水线气泡,但绝大多数算子是带宽受限)。
|
||||||
|
3. __尾延迟决定全局__:一个 step 的结束时间 = `max(所有 rank 的完成时间)`。任何一条慢链路都拖慢整体,这就是万卡训练里常说的 __"straggler 问题"__。
|
||||||
|
4. __长连接 + 零丢包容忍__:一次 AllReduce 丢一个包触发重传,整个 step 就塌了。所以 RDMA 网络必须是__无损__或__近似无损__的。
|
||||||
|
|
||||||
|
### 1.2 一次 step 里的通信量
|
||||||
|
|
||||||
|
以 GPT-3 175B、TP=8、PP=8、DP=128(总 8192 卡)为例,粗算一个 step 的通信量:
|
||||||
|
|
||||||
|
- __TP AllReduce__:Attention / MLP 后每层一次,175B 模型约 96 层,每次 AllReduce 的张量大小 ~ `batch × seq × hidden × 2B`(fp16),单次几十 MB。TP 发生在__机内 NVLink__。
|
||||||
|
- __PP 点对点__:每个 micro-batch 发送 activation,几十 MB,跨机走 __RDMA__。
|
||||||
|
- __DP AllReduce__:梯度规模 ~ 350 GB(fp16),ZeRO-1 下切成 DP 组;跨机跨 rail,走 __RDMA AllReduce__。
|
||||||
|
|
||||||
|
所以训练一次 step,机内 NVLink 跑 TB 级别流量,机间 RDMA 也跑几百 GB。任何一个维度"瘸腿",利用率立刻掉一大截。
|
||||||
|
|
||||||
|
## 二、Scale-up:机内与柜内互联
|
||||||
|
|
||||||
|
机内互联的目标很朴素:__越像一块 GPU 越好__。这意味着:高带宽、低延迟、统一地址空间、原生支持 P2P 和集合通信硬件加速。
|
||||||
|
|
||||||
|
### 2.1 PCIe:通用但不够用
|
||||||
|
|
||||||
|
PCIe 是 CPU—GPU、GPU—NIC 之间绕不开的通道。它的带宽演进:
|
||||||
|
|
||||||
|
| 版本 | 单 lane 带宽 | x16 双向 | 落地年份 | 代表平台 |
|
||||||
|
| --- | --- | --- | --- | --- |
|
||||||
|
| PCIe 4.0 | 16 GT/s | 64 GB/s | 2017 | A100、Milan |
|
||||||
|
| PCIe 5.0 | 32 GT/s | 128 GB/s | 2022 | H100、SPR、Genoa |
|
||||||
|
| PCIe 6.0 | 64 GT/s(PAM4) | 256 GB/s | 2024—2025 | B200、Turin、GH200 |
|
||||||
|
| PCIe 7.0 | 128 GT/s | 512 GB/s | 2027(规划) | — |
|
||||||
|
|
||||||
|
问题在于:__PCIe 5.0 x16 才 64 GB/s 单向__,而 H100 单卡 HBM 带宽已经 3 TB/s,NVLink 4 是 450 GB/s 单向。让 GPU 之间只走 PCIe,等于让法拉利走乡间小路。所以训练场景里,PCIe 主要用来接 CPU、NIC、NVMe,GPU 之间一定要走 NVLink / xGMI / HCCS 这种"专用高速通道"。
|
||||||
|
|
||||||
|
### 2.2 NVLink 与 NVSwitch:N 卡训练的护城河
|
||||||
|
|
||||||
|
NVLink 是 NVIDIA 自研的 GPU 间互联协议,和 PCIe 并行存在。演进如下:
|
||||||
|
|
||||||
|
| 代 | 首发 GPU | 单 link 双向 | 每 GPU 总带宽 | 关键特性 |
|
||||||
|
| --- | --- | --- | --- | --- |
|
||||||
|
| NVLink 1 | P100(2016) | 40 GB/s | 160 GB/s | 首次替代 PCIe P2P |
|
||||||
|
| NVLink 2 | V100(2017) | 50 GB/s | 300 GB/s | 引入 NVSwitch(DGX-2) |
|
||||||
|
| NVLink 3 | A100(2020) | 50 GB/s | 600 GB/s | 12 links |
|
||||||
|
| NVLink 4 | H100(2022) | 50 GB/s | 900 GB/s | 18 links,SHARP in-network |
|
||||||
|
| NVLink 5 | B200(2024) | 100 GB/s | 1.8 TB/s | 18 links × 100G PAM4 |
|
||||||
|
|
||||||
|
__NVSwitch__ 是把多块 GPU 连成 all-to-all 交换网的芯片。早期 DGX-2(V100 × 16)靠 6 颗 NVSwitch 做全连接;H100 HGX 8 卡靠 4 颗 NVSwitch v3;到了 B200,NVSwitch v4 芯片带宽 7.2 TB/s。
|
||||||
|
|
||||||
|
#### GB200 NVL72:把一个机柜变成一块 GPU
|
||||||
|
|
||||||
|
这是 2024—2026 年最重要的__产品级__变化。NVL72 的结构:
|
||||||
|
|
||||||
|
- 18 个 compute tray,每个 tray 放 2 颗 Grace CPU + 4 颗 B200 GPU(共 72 GPU + 36 CPU)
|
||||||
|
- 9 个 NVSwitch tray,每个 tray 2 颗 NVSwitch v4
|
||||||
|
- 所有 72 颗 GPU 之间__全 NVLink 互联__,任意两卡 P2P 带宽 1.8 TB/s
|
||||||
|
- 铜缆背板(copper cable cartridge),省掉 retimer 和光模块
|
||||||
|
- 整柜 120 kW,液冷必备
|
||||||
|
|
||||||
|
业务价值:__72 GPU 的 TP / EP 都能塞进一个 NVLink domain__。以前 TP 只能 8,现在可以 TP=16 甚至 TP=72;MoE 的 EP 也可以一柜内搞定,跨柜只走 DP 和 PP。训练 DeepSeek-R1 这种 671B MoE 模型,NVL72 几乎是天选硬件。
|
||||||
|
|
||||||
|
```
|
||||||
|
NVL72 机柜示意(简化)
|
||||||
|
┌──────────────────────────────────────────┐
|
||||||
|
│ Compute Tray × 18(每 tray 4 × B200) │
|
||||||
|
│ ┌───┐ ┌───┐ ┌───┐ ... ┌───┐ │
|
||||||
|
│ │ G │ │ G │ │ G │ │ G │ │
|
||||||
|
│ └─┬─┘ └─┬─┘ └─┬─┘ └─┬─┘ │
|
||||||
|
│ └─────┴─────┴─────────┘ │
|
||||||
|
│ NVLink5 Spine(Copper Cartridge) │
|
||||||
|
│ ┌──────────────────────────────┐ │
|
||||||
|
│ │ NVSwitch Tray × 9(18 芯片) │ │
|
||||||
|
│ └──────────────────────────────┘ │
|
||||||
|
└──────────────────────────────────────────┘
|
||||||
|
```
|
||||||
|
|
||||||
|
对应的 SVG 示意图见文末。
|
||||||
|
|
||||||
|
### 2.3 AMD Infinity Fabric(xGMI)
|
||||||
|
|
||||||
|
AMD MI300X / MI325X / MI350X 用的是 __Infinity Fabric__(IF),也叫 xGMI(外部 GMI)。MI300X 单卡 7 条 IF link,每条 128 GB/s 双向,合计 ~ 896 GB/s,和 H100 一个量级。
|
||||||
|
|
||||||
|
MI300X 8 卡平台是全 mesh 互联(每卡到其他 7 卡各一条 link),没有独立 switch 芯片。好处是简单、低功耗;坏处是__扩不到 72 卡那种 NVL 级别__。AMD 在 MI355 / MI400 代推出类似 NVL 的 __UALink__(Ultra Accelerator Link)联盟标准,对标 NVLink。
|
||||||
|
|
||||||
|
### 2.4 华为昇腾 HCCS
|
||||||
|
|
||||||
|
华为 Atlas 900 / CloudMatrix 里,昇腾 910B / 910C 之间走 __HCCS(Huawei Cache Coherent System)__:
|
||||||
|
|
||||||
|
- 910B:每卡 7 条 HCCS,每条 ~ 56 GB/s,合计 ~ 392 GB/s(单向)
|
||||||
|
- 910C:带宽翻倍
|
||||||
|
- 单节点 8 卡全 mesh
|
||||||
|
- 跨节点经 __HCCN__(华为高速 RDMA 网卡),逻辑上把集合通信交给 HCCL 库(对标 NCCL)
|
||||||
|
|
||||||
|
2024 年华为发布 __CloudMatrix 384__:一个超节点 384 颗昇腾 910C,全高速互联,对标 NVL72 但卡数更多。代价是功耗巨大,整柜 500+ kW,基本是"液冷 + 自建数据中心"的配置。
|
||||||
|
|
||||||
|
### 2.5 CXL:内存池化对 LLM 的意义
|
||||||
|
|
||||||
|
CXL(Compute Express Link)跑在 PCIe PHY 上,三种语义:
|
||||||
|
|
||||||
|
- __CXL.io__:对齐 PCIe
|
||||||
|
- __CXL.cache__:设备缓存宿主机内存
|
||||||
|
- __CXL.mem__:宿主机访问设备内存(内存扩展 / 池化)
|
||||||
|
|
||||||
|
对 LLM 的直接意义有限但值得关注:
|
||||||
|
|
||||||
|
1. __推理侧 KV cache 溢出__:CXL memory 作为 HBM/DRAM 之下的第三层,用来装长上下文的 KV。
|
||||||
|
2. __训练侧 optimizer state offload__:ZeRO-Infinity 已经在用 NVMe,CXL 内存比 NVMe 快两个数量级,未来可能替代部分 offload 场景。
|
||||||
|
3. __CXL 3.0 fabric__:支持 switch 和多主机共享内存池,长期看有"训练数据随取随用"的想象空间。
|
||||||
|
|
||||||
|
但 2026 年实际生产里,CXL 对 LLM 还是__次要角色__,因为 HBM 自己在涨容量(HBM3e 192 GB、HBM4 288 GB),短期不缺内存。
|
||||||
|
|
||||||
|
## 三、Scale-out:机间互联
|
||||||
|
|
||||||
|
Scale-up 终点是一柜(NVL72 / CM384),再往外就必须 scale-out。机间互联的两大流派:__InfiniBand__ 与 __RoCEv2__。
|
||||||
|
|
||||||
|
### 3.1 InfiniBand:训练网络的"黄金标准"
|
||||||
|
|
||||||
|
InfiniBand 自带 lossless、credit-based flow control、硬件 RDMA,几乎为 HPC 而生。速率演进:
|
||||||
|
|
||||||
|
| 代 | 速率 | 带宽(4X) | 年份 |
|
||||||
|
| --- | --- | --- | --- |
|
||||||
|
| FDR | 14 Gbps | 56 Gb/s | 2011 |
|
||||||
|
| EDR | 25 Gbps | 100 Gb/s | 2014 |
|
||||||
|
| HDR | 50 Gbps | 200 Gb/s | 2018 |
|
||||||
|
| NDR | 100 Gbps | 400 Gb/s | 2022 |
|
||||||
|
| XDR | 200 Gbps | 800 Gb/s | 2024—2025 |
|
||||||
|
| GDR | 400 Gbps | 1.6 Tb/s | 2027 规划 |
|
||||||
|
|
||||||
|
NVIDIA 通过收购 Mellanox,把 IB 生态完全握在手里:__ConnectX-7 / 8、Quantum-2 / 3 交换机、SHARP(在网计算)__。SHARP 尤其关键——它把 AllReduce 的 reduction 操作下沉到交换机做,树形累加,带宽和延迟都打骨折。
|
||||||
|
|
||||||
|
IB 的代价:__贵,而且锁死在 NVIDIA 生态__。一套 Quantum-2 800G 方案,每端口价格是等速以太网的 2—3 倍。
|
||||||
|
|
||||||
|
### 3.2 RoCEv2:大厂的务实选择
|
||||||
|
|
||||||
|
RoCE(RDMA over Converged Ethernet)v2 跑在 UDP/IP 上,能直接用现有以太网基础设施,只要交换机支持 PFC / ECN / DCQCN 就行。国内大厂(阿里、字节、腾讯、百度)主力都是 __RoCEv2 over 以太网__,理由:
|
||||||
|
|
||||||
|
- __省钱__:以太网交换机白牌化程度高,同速率比 IB 便宜 30%—50%
|
||||||
|
- __生态解耦__:不依赖 NVIDIA,换 Broadcom / Marvell / 国产芯片都行
|
||||||
|
- __复用运维栈__:BGP / VXLAN / 监控体系全部沿用
|
||||||
|
- __易扩展__:万卡到十万卡,以太网的可扩展性更好
|
||||||
|
|
||||||
|
代价是__工程门槛高__:无损以太网不是"打开 PFC 就行",需要全链路调优 buffer、拥塞控制、哈希,否则 PFC 死锁或风暴能让整个训练崩掉。
|
||||||
|
|
||||||
|
### 3.3 无损网络三件套:PFC / ECN / DCQCN
|
||||||
|
|
||||||
|
#### PFC(Priority-based Flow Control)
|
||||||
|
|
||||||
|
基于 802.1Qbb。某端口某优先级 buffer 快满了,向上游发 Pause 帧暂停该优先级流量。好处是__真正零丢包__;坏处是:
|
||||||
|
|
||||||
|
- __head-of-line blocking__:Pause 阻塞整条链路的该优先级
|
||||||
|
- __死锁__:拓扑成环 + 流量成环 → 所有端口互相 Pause,全局冻结。训练场景里 rail-optimized 拓扑特别容易踩这个
|
||||||
|
- __风暴__:一个慢节点把 Pause 传导到全网
|
||||||
|
|
||||||
|
所以 PFC 只能作为"兜底",不能作为"常态"。
|
||||||
|
|
||||||
|
#### ECN(Explicit Congestion Notification)
|
||||||
|
|
||||||
|
IP 头里 2 个 bit,交换机排队超过阈值就标 CE(Congestion Experienced),接收端回 CNP(Congestion Notification Packet)给发送端。发送端收到 CNP 主动降速,__在丢包和 PFC 触发之前就把流量压下来__。ECN 才是常态工作机制。
|
||||||
|
|
||||||
|
#### DCQCN(Data Center QCN)
|
||||||
|
|
||||||
|
Mellanox / NVIDIA 提出的拥塞控制算法,结合 ECN 反馈做速率调节。关键参数(NIC 侧):
|
||||||
|
|
||||||
|
- `Rai` / `Rhai`:加性增、乘性增的步长
|
||||||
|
- `Alpha`:根据 CNP 频率估计拥塞程度
|
||||||
|
- Timer:多久没收到 CNP 就加速恢复
|
||||||
|
|
||||||
|
DCQCN 的调参是门艺术:太激进导致抖动,太保守导致 throughput 上不去。阿里 HPN、字节 MegaScale 都有自研的拥塞控制(HPCC、Swift 等)作为替代。
|
||||||
|
|
||||||
|
### 3.4 800G 以太网与 UEC
|
||||||
|
|
||||||
|
2024—2026 年以太网侧最大的事:
|
||||||
|
|
||||||
|
1. __800G 商用落地__:Broadcom Tomahawk 5(51.2 Tb/s)、Marvell Teralynx 10、思科 Silicon One G200 全部支持 800G。
|
||||||
|
2. __1.6T 规划中__:Tomahawk 6(102.4 Tb/s)2025—2026 出样。
|
||||||
|
3. __UEC(Ultra Ethernet Consortium)成立__:AMD、Broadcom、Cisco、Arista、Meta、微软等发起,目标是把以太网重做成"训练原生":packet spray、可选择丢包、in-network collective、更轻量的传输层(替代传统 RoCE 的 Go-Back-N)。
|
||||||
|
|
||||||
|
UEC 的潜台词就是"__我们不想一直给 NVIDIA IB 交保护费__"。预计 2025—2026 UEC 1.0 兼容网卡和交换机陆续上市,对 NVIDIA Spectrum-X 构成直接竞争。
|
||||||
|
|
||||||
|
### 3.5 NVIDIA 的反击:Spectrum-X
|
||||||
|
|
||||||
|
NVIDIA 当然不会放任以太网吃掉 IB 的份额,于是推出 __Spectrum-X__:Spectrum-4 交换机 + BlueField-3 / ConnectX-8 DPU/NIC,基于以太网但集成了:
|
||||||
|
|
||||||
|
- __adaptive routing__:流级别重新哈希,对抗 ECMP hash 冲突
|
||||||
|
- __packet spray + reorder__:NIC 侧重排序,把多链路负载均衡做到极致
|
||||||
|
- __拥塞控制协同__:交换机 telemetry 实时反馈到 NIC
|
||||||
|
|
||||||
|
本质上是"把 IB 的好处搬到以太网上",抢以太网阵营的单。
|
||||||
|
|
||||||
|
## 四、拓扑:Fat-Tree、Rail-optimized、Dragonfly
|
||||||
|
|
||||||
|
拓扑决定了__对分带宽(bisection bandwidth)__ 和__最坏情况延迟__。
|
||||||
|
|
||||||
|
### 4.1 Fat-Tree / Clos
|
||||||
|
|
||||||
|
两层或三层 Clos 网络,是通用数据中心的默认拓扑:
|
||||||
|
|
||||||
|
```
|
||||||
|
Spine 层(core switch)
|
||||||
|
/ | | \
|
||||||
|
Leaf Leaf Leaf Leaf
|
||||||
|
/|\ /|\ /|\ /|\
|
||||||
|
...服务器...
|
||||||
|
```
|
||||||
|
|
||||||
|
- 理论上全对分无阻塞(非阻塞 fat-tree)
|
||||||
|
- 扩展性好,常规 3 层可支撑十万卡级别
|
||||||
|
- 问题:__ECMP hash 冲突__。两条大象流哈希到同一 uplink,链路利用率上不去
|
||||||
|
|
||||||
|
### 4.2 Rail-optimized(Meta / 字节 / 阿里都在用)
|
||||||
|
|
||||||
|
Rail-optimized 的核心想法:__按卡号分轨__。
|
||||||
|
|
||||||
|
每台 8 卡服务器的 GPU0 全部连到 rail-0 交换机,GPU1 连到 rail-1 交换机……共 8 条独立 rail。DP AllReduce 只在同 rail 内发生,机间只走本 rail 的带宽,完全避免跨 rail 的 ECMP 冲突。
|
||||||
|
|
||||||
|
```
|
||||||
|
rail-0 switch rail-7 switch
|
||||||
|
/ | | \ / | | \
|
||||||
|
Server0 Server1 ... Server0 Server1 ...
|
||||||
|
GPU0 GPU0 GPU7 GPU7
|
||||||
|
```
|
||||||
|
|
||||||
|
优点:
|
||||||
|
|
||||||
|
- AllReduce 带宽稳定,逼近理论值
|
||||||
|
- 故障域清晰(rail-x 挂了只影响 GPU-x)
|
||||||
|
|
||||||
|
缺点:
|
||||||
|
|
||||||
|
- 跨 rail 通信(PP、EP)要多跳
|
||||||
|
- 拓扑感知必须做对,否则退化
|
||||||
|
|
||||||
|
阿里 HPN、Meta RSC、字节 MegaScale 集群基本都是 rail-optimized 变体。
|
||||||
|
|
||||||
|
### 4.3 Dragonfly
|
||||||
|
|
||||||
|
CRAY / HPE 在超算上用的拓扑,分 group,group 内全连接,group 间少量长链路。
|
||||||
|
|
||||||
|
- 优点:对分带宽高,全局跳数少(最多 3 跳)
|
||||||
|
- 缺点:需要 adaptive routing + UGAL 调度,生态小众
|
||||||
|
|
||||||
|
国内训练场景里不常见,主要是 Frontier、Aurora 这种超算集群用。
|
||||||
|
|
||||||
|
### 4.4 Multi-rail
|
||||||
|
|
||||||
|
一台服务器接 4—8 张 NIC(现在 H100 / B200 标配 __1 GPU : 1 NIC__,每卡独立一张 400G / 800G NIC)。NCCL 会自动把 AllReduce 拆成 N 条流在 N 条 rail 上并发,总带宽线性叠加。
|
||||||
|
|
||||||
|
Multi-rail 的关键:
|
||||||
|
|
||||||
|
- __NUMA / PCIe 亲和__:NIC 必须和它服务的 GPU 挂在同一 PCIe Switch / CPU,否则走 QPI / UPI 过去带宽腰斩
|
||||||
|
- __拓扑文件__:NCCL 的 `NCCL_TOPO_FILE` 要正确声明 GPU-NIC 关系
|
||||||
|
|
||||||
|
## 五、集合通信与网络的关系
|
||||||
|
|
||||||
|
### 5.1 AllReduce 是带宽受限的
|
||||||
|
|
||||||
|
Ring AllReduce 的数据量分析:
|
||||||
|
|
||||||
|
- N 卡、数据量 D、一次 Ring-AllReduce 总步骤 = `2(N-1)`
|
||||||
|
- 每步传输 `D/N`,总传输量 `2D(N-1)/N ≈ 2D`
|
||||||
|
- 理论最优时间 `T = 2D(N-1) / (N · B)`,其中 B 是单链路带宽
|
||||||
|
|
||||||
|
结论:__N 很大时,AllReduce 时间几乎只取决于 B__。这就是为啥大家拼命堆带宽而不是堆卡数——带宽不够,加卡只会让每卡 throughput 更低。
|
||||||
|
|
||||||
|
### 5.2 Tree / Double-binary tree / SHARP
|
||||||
|
|
||||||
|
- __Tree AllReduce__:延迟 O(log N),适合小消息
|
||||||
|
- __Double-binary tree__:NCCL 默认大消息策略,带宽利用率接近 ring,延迟 O(log N)
|
||||||
|
- __SHARP__:IB 交换机做在网规约,一次 AllReduce 只需要"上树 + 下树",延迟和带宽都显著改善
|
||||||
|
|
||||||
|
NCCL 2.18+ 默认自动选择,也可以 `NCCL_ALGO=Ring` / `Tree` / `CollnetChain` / `CollnetDirect` 手动指定。
|
||||||
|
|
||||||
|
### 5.3 计算通信重叠
|
||||||
|
|
||||||
|
训练框架(Megatron、DeepSpeed、FSDP)都会做 overlap:反向传播算出一层梯度立刻开始 AllReduce,下一层计算并行进行。前提是__网络 throughput 足够稳__,否则 overlap 窗口小于通信时间,优化失效。
|
||||||
|
|
||||||
|
## 六、万卡故障域
|
||||||
|
|
||||||
|
### 6.1 fail-stop vs fail-slow
|
||||||
|
|
||||||
|
- __fail-stop__:GPU 挂了、NIC 挂了、节点宕机——监控立刻能抓到,重启 / 换节点恢复
|
||||||
|
- __fail-slow__:更可怕。一张 NIC 降速、一个 optic 模块误码率升高、一颗 NVSwitch 半死,__带宽从 400G 降到 200G 但不报错__。整个 step 被这一根慢链路拖慢 2 倍
|
||||||
|
|
||||||
|
fail-slow 的典型表现:某个 rank 的 AllReduce 时间突然从 50ms 涨到 200ms,且持续一段时间;NCCL 监控 per-rank 时间就能发现。
|
||||||
|
|
||||||
|
### 6.2 链路抖动
|
||||||
|
|
||||||
|
光模块温度波动、DSP 误码、SerDes 重训练都会导致短时抖动。无损网络下,抖动可能触发 PFC,进一步诱发风暴。缓解:
|
||||||
|
|
||||||
|
- 光模块选用长期稳定的 200G-per-lane 甚至 100G-per-lane(别追最新的 200G PAM4)
|
||||||
|
- 交换机 buffer 调大,吸收瞬时突发
|
||||||
|
- 分级 QoS,训练流量独占一个优先级类
|
||||||
|
|
||||||
|
### 6.3 hash 冲突与大象流
|
||||||
|
|
||||||
|
ECMP 基于五元组哈希,训练流都是长连接大象流,很容易两条流撞同一 uplink。缓解:
|
||||||
|
|
||||||
|
- __rail-optimized 从源头避免__
|
||||||
|
- __adaptive routing__(Spectrum-X、IB)
|
||||||
|
- __packet spray__(UEC)
|
||||||
|
- __多 QP 打散__:NCCL 开多 QP(`NCCL_IB_QPS_PER_CONNECTION=4`),哈希变成 5 元组 × 4
|
||||||
|
|
||||||
|
### 6.4 Checkpoint 与故障域隔离
|
||||||
|
|
||||||
|
这是下一篇(05 / 10)的主题,这里只提一句:万卡集群的 MTBF 是按__小时__算的,Ckpt 间隔必须小于 MTBF,否则训练永远卡在回滚。
|
||||||
|
|
||||||
|
## 七、国产互联生态
|
||||||
|
|
||||||
|
### 7.1 网络设备
|
||||||
|
|
||||||
|
- __华为__:CloudEngine 16800 系列,400G / 800G 以太网,配合昇腾 HCCN NIC,支持 RoCEv2 无损
|
||||||
|
- __锐捷网络__:RG-S6980、S8920 系列,阿里、字节都大量采购
|
||||||
|
- __新华三(H3C)__:S12500G、S9825 系列,百度、腾讯用得多
|
||||||
|
- __中兴__:ZXR10 9900X 系列
|
||||||
|
|
||||||
|
国产 51.2T 交换芯片(盛科、华为自研)已在 2025 年陆续上市,国产替代在__可用__级别,性能对标 Tomahawk 4—5。
|
||||||
|
|
||||||
|
### 7.2 华为 CloudMatrix 384
|
||||||
|
|
||||||
|
2024 年底发布,2025 年大规模部署:
|
||||||
|
|
||||||
|
- 384 颗昇腾 910C
|
||||||
|
- 超节点内全高速光互联(华为自研光模块)
|
||||||
|
- 对外接口兼容标准以太网 / RoCEv2
|
||||||
|
- 单超节点算力 ~ 300 PFLOPS(fp16)
|
||||||
|
|
||||||
|
对标 NVL72(72 GPU),卡数更多、带宽略低、功耗更大。在国内外管制背景下是 DeepSeek、Kimi 等团队的重要备选。
|
||||||
|
|
||||||
|
### 7.3 腾讯星脉网络
|
||||||
|
|
||||||
|
腾讯自研,特点:
|
||||||
|
|
||||||
|
- 全自研交换机(基于 Tomahawk / 自研芯片)
|
||||||
|
- 自研 __TiTa 拥塞控制__(替代 DCQCN),更快收敛
|
||||||
|
- rail-optimized + 多平面
|
||||||
|
- 支持万卡至十万卡
|
||||||
|
|
||||||
|
### 7.4 阿里 HPN(High Performance Network)
|
||||||
|
|
||||||
|
阿里云训练集群底座:
|
||||||
|
|
||||||
|
- 自研 __HPCC / Swift__ 拥塞控制
|
||||||
|
- __双上联__:每台服务器双 NIC 接不同 leaf,一侧挂了另一侧接管,消除单点
|
||||||
|
- __eRDMA__:在 VPC 里跑 RDMA,云上训练也能享受无损
|
||||||
|
- PAI-DLC、通义训练都跑在 HPN 上
|
||||||
|
|
||||||
|
### 7.5 字节 MegaScale
|
||||||
|
|
||||||
|
《MegaScale》论文披露了字节的万卡方案:
|
||||||
|
|
||||||
|
- rail-optimized 3 层 Clos
|
||||||
|
- 400G RoCEv2
|
||||||
|
- 大量 fail-slow 检测探针
|
||||||
|
- NCCL 深度魔改,感知拓扑选最优算法
|
||||||
|
|
||||||
|
## 八、SuperPod / SuperCluster:十万卡级别
|
||||||
|
|
||||||
|
### 8.1 NVIDIA DGX SuperPod
|
||||||
|
|
||||||
|
标准化万卡方案:
|
||||||
|
|
||||||
|
- 以 DGX H100 / B200 node 为单元
|
||||||
|
- IB Quantum-2(NDR 400G)组 rail-optimized 3 层
|
||||||
|
- SHARP in-network reduction
|
||||||
|
- 配 BCM(Bright Cluster Manager)+ NVIDIA Base Command 软件栈
|
||||||
|
|
||||||
|
2024—2026 年 Blackwell 代:__GB200 NVL72 × N__ 组成 SuperPod,NVL72 间走 IB XDR 800G。
|
||||||
|
|
||||||
|
### 8.2 Meta Research SuperCluster(RSC)与 Grand Teton
|
||||||
|
|
||||||
|
Meta 训练 Llama 3 / 4 的基础设施:
|
||||||
|
|
||||||
|
- 两个 24k H100 集群(一个 RoCE、一个 IB,做 A/B 对比)
|
||||||
|
- Grand Teton 整机柜设计,OCP 标准
|
||||||
|
- __无损以太网 + rail-optimized + 自研调度__
|
||||||
|
|
||||||
|
结论是"两边都能跑 Llama 3,生态视角 RoCE 更划算"。
|
||||||
|
|
||||||
|
### 8.3 xAI Colossus:10 万卡
|
||||||
|
|
||||||
|
2024 年 Elon Musk 在孟菲斯建的超级集群:
|
||||||
|
|
||||||
|
- 100k H100 → 2025 扩到 200k H200 / B200
|
||||||
|
- Spectrum-X 以太网 + NVL72
|
||||||
|
- 号称 19 天从零部署完 10 万卡(实际是分阶段,但节奏极猛)
|
||||||
|
|
||||||
|
工程意义:__证明以太网阵营能打 10 万卡级别__。
|
||||||
|
|
||||||
|
### 8.4 国内超大集群
|
||||||
|
|
||||||
|
- 字节:北京怀来、山西、新疆万卡—十万卡级
|
||||||
|
- 阿里:张北、乌兰察布,多个 HPN 万卡集群
|
||||||
|
- 腾讯:星脉支持的万卡集群,训练混元
|
||||||
|
- 华为云:乌兰察布 / 贵安,CloudMatrix 384 × N
|
||||||
|
- 百度:阳泉百舸 4.0 万卡
|
||||||
|
|
||||||
|
## 九、光互联与 CPO
|
||||||
|
|
||||||
|
### 9.1 可插拔光模块的瓶颈
|
||||||
|
|
||||||
|
传统 QSFP-DD / OSFP 可插拔光模块,功耗和密度已经到极限:
|
||||||
|
|
||||||
|
- 800G OSFP 模块功耗 14—17 W,一个 51.2T 交换机光模块总功耗接近交换机本体
|
||||||
|
- 前面板密度有限,再往上到 1.6T / 3.2T 已经插不下
|
||||||
|
|
||||||
|
### 9.2 CPO(Co-Packaged Optics)
|
||||||
|
|
||||||
|
CPO 的思路:__把光引擎贴到交换机 ASIC 旁边__,省掉 SerDes 跑前面板这段距离。
|
||||||
|
|
||||||
|
- 功耗降低 30%—50%
|
||||||
|
- 密度翻倍
|
||||||
|
- 代价:维修性差(坏一个要换整板),可靠性需要时间验证
|
||||||
|
|
||||||
|
Broadcom 2024 年发布 Tomahawk 5 Bailly CPO 版本;NVIDIA 2025 年宣布 Spectrum-X 和 Quantum-X 都会有 CPO 产品线;国内光迅、中际旭创、新易盛都在押注。
|
||||||
|
|
||||||
|
### 9.3 硅光(Silicon Photonics)
|
||||||
|
|
||||||
|
硅光是 CPO 的底层技术路线之一:用 CMOS 工艺做光调制器 / 探测器。代表公司:Intel(Silicon Photonics 已分拆)、Ayar Labs、Lightmatter、国内的光迅。
|
||||||
|
|
||||||
|
对训练的直接好处:__未来可能看到 GPU die 上直接出光__(optical I/O),NVLink 跨机柜不再需要铜缆 + 电—光转换。
|
||||||
|
|
||||||
|
## 十、训练工程师视角:集合通信打不满怎么办
|
||||||
|
|
||||||
|
### 10.1 排查清单
|
||||||
|
|
||||||
|
一个 step 的 AllReduce 时间比理论值高 20% 以上,按顺序查:
|
||||||
|
|
||||||
|
1. __NCCL 是不是用对了网络__
|
||||||
|
|
||||||
|
```
|
||||||
|
export NCCL_DEBUG=INFO
|
||||||
|
export NCCL_DEBUG_SUBSYS=INIT,GRAPH,NET
|
||||||
|
```
|
||||||
|
|
||||||
|
看启动日志里 `NCCL INFO NET/IB : Using [0]mlx5_0:1/IB` 或 `NET/Socket`。如果是 Socket,说明 RDMA 根本没起来。
|
||||||
|
|
||||||
|
2. __GPU-NIC 亲和__
|
||||||
|
|
||||||
|
看 GPU 和 NIC 之间是 `PIX`(同 PCIe switch,最优)、`PXB`(跨 bridge)、`NODE`(同 NUMA)、`SYS`(跨 NUMA,最差)。跨 NUMA 的组合必须修正拓扑文件。
|
||||||
|
|
||||||
|
3. __多 QP 和 rail 数__
|
||||||
|
|
||||||
|
```
|
||||||
|
export NCCL_IB_QPS_PER_CONNECTION=4
|
||||||
|
export NCCL_IB_SPLIT_DATA_ON_QPS=1
|
||||||
|
export NCCL_IB_HCA=mlx5_0,mlx5_1,mlx5_2,mlx5_3,mlx5_4,mlx5_5,mlx5_6,mlx5_7
|
||||||
|
```
|
||||||
|
|
||||||
|
4. __算法选对__
|
||||||
|
|
||||||
|
```
|
||||||
|
export NCCL_ALGO=Ring,Tree,CollnetChain,CollnetDirect
|
||||||
|
export NCCL_PROTO=Simple,LL,LL128
|
||||||
|
```
|
||||||
|
|
||||||
|
大消息用 Ring + Simple,小消息用 Tree + LL128。打开 NCCL autotune 后一般不用手调。
|
||||||
|
|
||||||
|
5. __PFC / ECN 配置__
|
||||||
|
|
||||||
|
交换机上 `show pfc statistics`、`show ecn statistics`,看有没有大量 Pause 帧或 CNP。正常训练应该只有少量 ECN,PFC 接近 0。
|
||||||
|
|
||||||
|
6. __慢节点检测__
|
||||||
|
|
||||||
|
写个 per-rank allreduce 时间统计,看有没有某一两个 rank 一直比别人慢。慢节点隔离出来单独测带宽。
|
||||||
|
|
||||||
|
### 10.2 NCCL 常用环境变量速查
|
||||||
|
|
||||||
|
| 变量 | 作用 |
|
||||||
|
| --- | --- |
|
||||||
|
| `NCCL_DEBUG=INFO/WARN` | 调试日志 |
|
||||||
|
| `NCCL_DEBUG_SUBSYS=ALL` | 细分子系统日志 |
|
||||||
|
| `NCCL_IB_HCA` | 指定使用的 IB HCA |
|
||||||
|
| `NCCL_IB_GID_INDEX` | RoCEv2 下必须设,通常 3 |
|
||||||
|
| `NCCL_SOCKET_IFNAME` | 控制面网卡 |
|
||||||
|
| `NCCL_P2P_DISABLE` | 禁用 P2P(调试用) |
|
||||||
|
| `NCCL_SHM_DISABLE` | 禁用 SHM |
|
||||||
|
| `NCCL_NET_GDR_LEVEL` | GPUDirect RDMA 级别 |
|
||||||
|
| `NCCL_BUFFSIZE` | NCCL 内部 buffer 大小 |
|
||||||
|
| `NCCL_MIN_NCHANNELS` / `NCCL_MAX_NCHANNELS` | 并行 channel 数 |
|
||||||
|
|
||||||
|
### 10.3 nccl-tests 实操
|
||||||
|
|
||||||
|
这是工程师的万能基准测试工具。
|
||||||
|
|
||||||
|
```
|
||||||
|
git clone https://github.com/NVIDIA/nccl-tests
|
||||||
|
cd nccl-tests
|
||||||
|
make MPI=1 CUDA_HOME=/usr/local/cuda NCCL_HOME=/usr/local/nccl
|
||||||
|
|
||||||
|
# 8 卡单机 AllReduce(默认 NVLink 带宽测试)
|
||||||
|
./build/all_reduce_perf -b 8 -e 8G -f 2 -g 8
|
||||||
|
|
||||||
|
# 跨机:16 节点 × 8 GPU = 128 卡
|
||||||
|
mpirun -np 128 -H host1:8,host2:8,...,host16:8 \
|
||||||
|
-x NCCL_DEBUG=INFO \
|
||||||
|
-x NCCL_IB_HCA=mlx5_0,mlx5_1,mlx5_2,mlx5_3,mlx5_4,mlx5_5,mlx5_6,mlx5_7 \
|
||||||
|
-x LD_LIBRARY_PATH \
|
||||||
|
./build/all_reduce_perf -b 8 -e 8G -f 2 -g 1
|
||||||
|
```
|
||||||
|
|
||||||
|
关注两列:
|
||||||
|
|
||||||
|
- `busbw`:总线带宽,= `algbw × 2(N-1)/N`。对 ring AllReduce,__busbw 应该接近单链路带宽__
|
||||||
|
- `time`:耗时
|
||||||
|
|
||||||
|
经验值参考(大消息 1 GB):
|
||||||
|
|
||||||
|
| 场景 | 理论 busbw | 实测可达 |
|
||||||
|
| --- | --- | --- |
|
||||||
|
| H100 单机 NVLink4 | 450 GB/s | 380—420 GB/s |
|
||||||
|
| B200 NVL72 内 | 900 GB/s | 750—850 GB/s |
|
||||||
|
| H100 跨机 IB NDR × 8 rail | 400 GB/s | 320—380 GB/s |
|
||||||
|
| H100 跨机 RoCEv2 400G × 8 | 400 GB/s | 280—360 GB/s(调优后) |
|
||||||
|
|
||||||
|
低于这个范围就说明有问题,按 10.1 排查。
|
||||||
|
|
||||||
|
### 10.4 拓扑感知:`NCCL_TOPO_FILE` 示例
|
||||||
|
|
||||||
|
NCCL 会自动探测拓扑,但云虚机 / 容器里经常探不准。手动写:
|
||||||
|
|
||||||
|
```
|
||||||
|
<system version="1">
|
||||||
|
<cpu numaid="0" affinity="ffff,00000000" arch="x86_64">
|
||||||
|
<pci busid="0000:0a:00.0" class="0x060400" link_speed="32.0 GT/s" link_width="16">
|
||||||
|
<pci busid="0000:0b:00.0" class="0x030200">
|
||||||
|
<gpu dev="0" sm="90" rank="0"/>
|
||||||
|
</pci>
|
||||||
|
<pci busid="0000:0c:00.0" class="0x020000">
|
||||||
|
<nic>
|
||||||
|
<net name="mlx5_0" dev="0" speed="400000" port="1" latency="0" guid="..."/>
|
||||||
|
</nic>
|
||||||
|
</pci>
|
||||||
|
</pci>
|
||||||
|
</cpu>
|
||||||
|
...
|
||||||
|
</system>
|
||||||
|
```
|
||||||
|
|
||||||
|
启动时 `NCCL_TOPO_FILE=/path/to/topo.xml`。现代 NCCL(2.18+)结合 `NCCL_GRAPH_FILE` 还可以进一步固化通信图。
|
||||||
|
|
||||||
|
## 十一、两张拓扑示意图
|
||||||
|
|
||||||
|
### 11.1 Fat-Tree vs Rail-optimized
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
### 11.2 NVL72 机柜示意
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
## 十二、进阶话题:GPUDirect、RDMA 编程与内核旁路
|
||||||
|
|
||||||
|
### 12.1 GPUDirect RDMA
|
||||||
|
|
||||||
|
传统数据路径:GPU HBM → 系统内存 → NIC DMA → 网络。两次拷贝,CPU 介入,带宽腰斩。
|
||||||
|
|
||||||
|
__GPUDirect RDMA__ 让 NIC 直接 DMA GPU 显存:
|
||||||
|
|
||||||
|
- 需要 NIC、GPU 挂在同一 PCIe Root Complex 或同一 PCIe Switch 下
|
||||||
|
- 内核驱动 `nvidia-peermem`(取代老的 `nv_peer_mem`)把 GPU BAR 映射给 NIC
|
||||||
|
- 对应 NCCL 环境变量 `NCCL_NET_GDR_LEVEL=PIX`(同 switch 才启用)或 `=SYS`(强制启用)
|
||||||
|
|
||||||
|
启用后跨机 AllReduce 带宽能再涨 30%—50%,是__训练必开__项。
|
||||||
|
|
||||||
|
### 12.2 GPUDirect Storage(GDS)
|
||||||
|
|
||||||
|
`cuFile` API,让 NVMe 直接 DMA GPU 显存。训练里用得不多(数据 pipeline 有 CPU 侧 DataLoader 处理),但推理侧大模型权重加载、KV offload 到 NVMe 时很有用。
|
||||||
|
|
||||||
|
### 12.3 用 `ibv_*` 直接写 RDMA
|
||||||
|
|
||||||
|
多数情况下不需要,但排障时有用。一个最小化的 WRITE 操作:
|
||||||
|
|
||||||
|
```
|
||||||
|
struct ibv_send_wr wr = {};
|
||||||
|
struct ibv_sge sge = {
|
||||||
|
.addr = (uintptr_t)local_buf,
|
||||||
|
.length = size,
|
||||||
|
.lkey = mr->lkey,
|
||||||
|
};
|
||||||
|
wr.wr_id = 0;
|
||||||
|
wr.sg_list = &sge;
|
||||||
|
wr.num_sge = 1;
|
||||||
|
wr.opcode = IBV_WR_RDMA_WRITE;
|
||||||
|
wr.send_flags = IBV_SEND_SIGNALED;
|
||||||
|
wr.wr.rdma.remote_addr = remote_addr;
|
||||||
|
wr.wr.rdma.rkey = remote_rkey;
|
||||||
|
|
||||||
|
struct ibv_send_wr *bad;
|
||||||
|
ibv_post_send(qp, &wr, &bad);
|
||||||
|
|
||||||
|
struct ibv_wc wc;
|
||||||
|
while (ibv_poll_cq(cq, 1, &wc) == 0) {}
|
||||||
|
if (wc.status != IBV_WC_SUCCESS) { /* 错误处理 */ }
|
||||||
|
```
|
||||||
|
|
||||||
|
排障时可以用 `ib_write_bw` / `ib_read_bw` 直测链路:
|
||||||
|
|
||||||
|
```
|
||||||
|
# 服务器端
|
||||||
|
ib_write_bw -d mlx5_0 -F -x 3 --report_gbits
|
||||||
|
|
||||||
|
# 客户端
|
||||||
|
ib_write_bw -d mlx5_0 -F -x 3 --report_gbits <server_ip>
|
||||||
|
```
|
||||||
|
|
||||||
|
正常 400G IB 应该能跑到 395+ Gb/s,低于 380 就要查 PCIe 亲和或光模块。
|
||||||
|
|
||||||
|
### 12.4 DPU / IPU 的角色
|
||||||
|
|
||||||
|
BlueField-3 / Pensando / AWS Nitro 这些 DPU,在 AI 训练集群里主要做:
|
||||||
|
|
||||||
|
1. __RDMA 卸载__:本来就是 NIC 功能
|
||||||
|
2. __虚拟化__:多租户云训练里,把 VPC、overlay、安全组全部卸载到 DPU,让 CPU 和 GPU 专心算
|
||||||
|
3. __存储加速__:NVMe-oF initiator 在 DPU 上跑
|
||||||
|
4. __训练观测__:DPU 天然在网卡侧,telemetry、packet capture 都最合适
|
||||||
|
|
||||||
|
阿里 eRDMA、AWS EFA 都高度依赖 DPU。
|
||||||
|
|
||||||
|
## 十三、真实案例:一次万卡训练的网络复盘
|
||||||
|
|
||||||
|
这一节把前面所有技术点串起来,讲一个真实(虚构但贴近行业)的案例:某团队用 4096 卡 H100 训练一个 100B 模型,MFU 迟迟上不去。
|
||||||
|
|
||||||
|
### 13.1 现象
|
||||||
|
|
||||||
|
- 单机 8 卡 nccl-tests AllReduce:400 GB/s(正常)
|
||||||
|
- 跨机 16 机 128 卡 AllReduce:预期 ~ 350 GB/s,实测 180 GB/s
|
||||||
|
- 训练 MFU 只有 28%,期望 45%+
|
||||||
|
|
||||||
|
### 13.2 排查步骤
|
||||||
|
|
||||||
|
__Step 1:看 NCCL 日志__
|
||||||
|
|
||||||
|
```
|
||||||
|
export NCCL_DEBUG=INFO
|
||||||
|
export NCCL_DEBUG_SUBSYS=NET,GRAPH
|
||||||
|
```
|
||||||
|
|
||||||
|
日志里发现:
|
||||||
|
|
||||||
|
```
|
||||||
|
NCCL INFO NET/IB : Using [0]mlx5_0:1/IB [1]mlx5_1:1/IB ... [7]mlx5_7:1/IB
|
||||||
|
NCCL INFO Channel 00 : 0[0] -> 1[0] via NET/IB/0
|
||||||
|
```
|
||||||
|
|
||||||
|
8 张 NIC 都识别到了,OK。
|
||||||
|
|
||||||
|
__Step 2:查 GPU-NIC 亲和__
|
||||||
|
|
||||||
|
```
|
||||||
|
nvidia-smi topo -m
|
||||||
|
```
|
||||||
|
|
||||||
|
发现 GPU4—GPU7 和对应 NIC 是 `SYS`(跨 NUMA),而 GPU0—GPU3 是 `PIX`(同 PCIe switch)。__根因 1__:服务器 BIOS 里 PCIe Root Complex 划分不对,NIC 全部挂在 Socket 0。
|
||||||
|
|
||||||
|
__Step 3:改硬件或改拓扑文件__
|
||||||
|
|
||||||
|
硬件不能动,只能接受跨 NUMA。但发现系统没有加载 `nvidia-peermem`:
|
||||||
|
|
||||||
|
```
|
||||||
|
lsmod | grep peermem
|
||||||
|
# 空
|
||||||
|
modprobe nvidia-peermem
|
||||||
|
```
|
||||||
|
|
||||||
|
__根因 2__:GPUDirect RDMA 没启用,数据绕了一圈 CPU。
|
||||||
|
|
||||||
|
__Step 4:检查交换机 ECN / PFC__
|
||||||
|
|
||||||
|
```
|
||||||
|
show interface counters errors
|
||||||
|
show pfc statistics interface Ethernet1/1
|
||||||
|
```
|
||||||
|
|
||||||
|
发现某几个 leaf 的 PFC Pause 计数每秒上万,__根因 3__:拥塞控制没调好,训练流量经常触发 PFC。
|
||||||
|
|
||||||
|
__Step 5:查 QP 和 channel 数__
|
||||||
|
|
||||||
|
```
|
||||||
|
NCCL_IB_QPS_PER_CONNECTION=1(默认)
|
||||||
|
```
|
||||||
|
|
||||||
|
多 rail 下单 QP 容易哈希冲突,改成:
|
||||||
|
|
||||||
|
```
|
||||||
|
export NCCL_IB_QPS_PER_CONNECTION=4
|
||||||
|
export NCCL_IB_SPLIT_DATA_ON_QPS=1
|
||||||
|
```
|
||||||
|
|
||||||
|
### 13.3 修复后
|
||||||
|
|
||||||
|
- 加载 `nvidia-peermem`:busbw 从 180 → 260 GB/s
|
||||||
|
- 调 DCQCN + 降 PFC 阈值:→ 300 GB/s
|
||||||
|
- 开多 QP + packet spray:→ 345 GB/s
|
||||||
|
- 修拓扑文件 + NUMA pin:→ 360 GB/s
|
||||||
|
|
||||||
|
MFU 从 28% 涨到 46%。训练时长从 90 天缩到 55 天。
|
||||||
|
|
||||||
|
### 13.4 启示
|
||||||
|
|
||||||
|
这个案例里,没有一个"致命 bug",全是几个百分点的小问题叠加。万卡训练的网络调优就是这样——__每个环节省 10%,整体翻倍__。所以基建团队必须对 NCCL、NIC、交换机、拓扑、NUMA 全栈都懂。
|
||||||
|
|
||||||
|
## 十四、展望 2026—2028
|
||||||
|
|
||||||
|
1. __NVLink 走出机柜__:NVIDIA 路线图里 NVLink Fusion / NVL576,用光互联把多个 NVL72 连成更大的 scale-up 域
|
||||||
|
2. __UALink 1.0 出货__:AMD / Broadcom / Cisco 阵营推出替代 NVLink 的开放标准
|
||||||
|
3. __UEC 1.0 大规模部署__:预计 2026—2027 年成为以太网训练的事实标准
|
||||||
|
4. __CPO 商用__:800G → 1.6T 迭代中,CPO 从试点走向规模部署
|
||||||
|
5. __光 I/O 进芯片__:Lightmatter、Ayar Labs 的 optical I/O 可能首次出现在商用 AI 芯片上
|
||||||
|
6. __国产超节点 1000+ 卡__:华为 CloudMatrix 下一代、寒武纪、壁仞可能推出千卡级超节点
|
||||||
|
7. __跨 DC 训练__:Google Gemini Ultra 已经在做跨数据中心训练,DCI(DC Interconnect)成为新战场
|
||||||
|
|
||||||
|
网络演进的速度会比过去五年更快——因为 GPU 单卡算力增长在放缓,scale-up / scale-out 的想象力变成了整个行业的新增长点。
|
||||||
|
|
||||||
|
## 十五、选型决策速查
|
||||||
|
|
||||||
|
训练团队做网络选型时,建议按这个决策流:
|
||||||
|
|
||||||
|
1. __规模 ≤ 1k 卡,预算紧__:单柜或 2—3 机柜,IB NDR 400G × 8 rail,省事、生态稳
|
||||||
|
2. __规模 1k—1 万卡,走公有云__:用云商自研网络(阿里 HPN、腾讯星脉、AWS EFA、Azure InfiniBand),不要自己折腾
|
||||||
|
3. __规模 1 万—10 万卡,自建__:rail-optimized 3 层 Clos + 800G RoCEv2 + 自研拥塞控制;或 Spectrum-X;IB 仅在成本允许时考虑
|
||||||
|
4. __规模 ≥ 10 万卡__:必须多平面 / 多池,单池 1—2 万卡,池间走骨干或分层调度
|
||||||
|
5. __国产化路线__:昇腾 CloudMatrix 384 + 华为 / 锐捷 400G / 800G 以太网,HCCL + 自研 RoCEv2 栈
|
||||||
|
6. __推理集群__:KV cache 以 intra-node 为主,对跨机带宽要求远低于训练;可以用 200G RoCE 或甚至 100G
|
||||||
|
|
||||||
|
## 参考资料
|
||||||
|
|
||||||
|
1. NVIDIA, _NVLink and NVSwitch Architecture Whitepaper_, 2022—2024
|
||||||
|
2. NVIDIA, _GB200 NVL72 Datasheet / System Guide_, 2024
|
||||||
|
3. NVIDIA, _Spectrum-X Platform Whitepaper_, 2023
|
||||||
|
4. NVIDIA, _nccl-tests_ 仓库:https://github.com/NVIDIA/nccl-tests
|
||||||
|
5. Mellanox, _DCQCN: Data Center Quantized Congestion Notification_, SIGCOMM 2015
|
||||||
|
6. Alibaba, _HPN: A Data Center Network for Large Language Model Training_, SIGCOMM 2024
|
||||||
|
7. ByteDance, _MegaScale: Scaling Large Language Model Training to More Than 10,000 GPUs_, NSDI 2024
|
||||||
|
8. Meta, _RDMA over Ethernet for Distributed AI Training at Meta Scale_, SIGCOMM 2024
|
||||||
|
9. Tencent, _Tencent Xingmai (Starlink) Network_, 2023—2024 技术博客
|
||||||
|
10. AMD, _Infinity Fabric / xGMI Documentation_, MI300X 平台
|
||||||
|
11. Huawei, _CloudMatrix 384 超节点白皮书_, 2024
|
||||||
|
12. Ultra Ethernet Consortium, _UEC Specification 1.0 (Draft)_, 2024—2025
|
||||||
|
13. CXL Consortium, _CXL 3.0 Specification_, 2023
|
||||||
|
14. Broadcom, _Tomahawk 5 Product Brief_, 2023
|
||||||
|
15. xAI, _Colossus Cluster Overview_, 2024—2025
|
||||||
@@ -0,0 +1,77 @@
|
|||||||
|
# 📊 文章摘要:大模型基础设施工程 04:互联与网络——NVLink、InfiniBand、RoCE 与国产替代
|
||||||
|
|
||||||
|
> **原文**:[2026-04-22_大模型基础设施工程04_互联与网络_NVLink_InfiniBand_RoCE_与国产替代.md](./2026-04-22_大模型基础设施工程04_互联与网络_NVLink_InfiniBand_RoCE_与国产替代.md)
|
||||||
|
> **原文链接**:https://quant67.com/post/llm-infra/04-interconnect/04-interconnect.html
|
||||||
|
> **来源**:土法炼钢兴趣小组的算法知识备份
|
||||||
|
> **作者**:未知
|
||||||
|
> **发布日期**:2026-04-22
|
||||||
|
> **摘要日期**:2026-08-06
|
||||||
|
> **价值评级**:⭐⭐⭐ 高
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 核心命题
|
||||||
|
|
||||||
|
> **互联为王** — 单卡算力不再是瓶颈,网络架构决定万卡集群的利用率与 MFU。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 文章概要
|
||||||
|
|
||||||
|
文章系统梳理 LLM 训练集群的互联技术全景:从 scale-up(NVLink/NVSwitch/NVL72、Infinity Fabric、HCCS、CXL)到 scale-out(InfiniBand、RoCEv2、UEC、Spectrum-X),从拓扑(Fat-Tree、Rail-optimized、Dragonfly)到故障域(fail-stop/fail-slow),并给出集合通信原理与国产生态梳理。核心论点"算力决定上限,互联决定利用率"贯穿全文——同样一批 H100 接不同网络,70B 模型训练 MFU 可相差 30 个百分点以上。文末附训练工程师视角的"集合通信打不满"排查清单、nccl-tests 实操与贴近行业的排障复盘案例,是国内少见的兼具原理深度与工程可操作性的中文综述。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 关键要点
|
||||||
|
|
||||||
|
1. **万卡训练的独特流量画像** — 周期突发、带宽受限、尾延迟决定全局(straggler 问题)、长连接零丢包容忍,决定了训练网络必须是无损或近似无损的 `[分类: 共识]`
|
||||||
|
2. **NVL72 把机柜变成一块 GPU** — 72 卡全 NVLink 互联,TP/EP 可一柜内完成,是 2024—2026 最重要的产品级变化,堪称 MoE 模型(如 DeepSeek-R1)的天选硬件 `[分类: 共识]`
|
||||||
|
3. **IB 是黄金标准但贵且锁死** — SHARP 在网计算、无损流控、NDR/XDR 速率演进,但每端口价格为等速以太网 2—3 倍,生态被 NVIDIA 牢牢掌控 `[分类: 共识]`
|
||||||
|
4. **RoCEv2 是国内大厂务实之选** — 阿里、字节、腾讯、百度主力均为 RoCEv2,省钱 30%—50%、生态解耦、复用运维栈,但 PFC/ECN/DCQCN 全链路调优是极高的工程门槛 `[分类: 共识]`
|
||||||
|
5. **Rail-optimized 是主流训练拓扑** — 按卡号分轨消除 ECMP 哈希冲突,Meta RSC、字节 MegaScale、阿里 HPN 均为其变体;UEC packet spray 是下一代方向 `[分类: 共识]`
|
||||||
|
6. **fail-slow 比 fail-stop 更可怕** — 网卡降速不报错会拖慢整个 step,需靠 per-rank AllReduce 时间监控发现 `[分类: 共识]`
|
||||||
|
7. **排障案例的启示** — 4096 卡 MFU 从 28% 提升到 46%,靠的是 peermem 加载、DCQCN 调参、多 QP 打散、拓扑文件修正等小优化的叠加,全程没有"致命 bug" `[分类: 共识]`
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 批判性分析
|
||||||
|
|
||||||
|
### 假设前提
|
||||||
|
|
||||||
|
作者默认"带宽为王"——Ring AllReduce 时间几乎只取决于单链路带宽的分析,弱化了小消息延迟、拓扑跳数与流水线气泡的影响;假设读者面向 2024—2026 年主流硬件(H100/B200)且具备训练框架与 NCCL 基础。
|
||||||
|
|
||||||
|
### 论据与逻辑
|
||||||
|
|
||||||
|
论据充分——引用 HPN(SIGCOMM 2024)、MegaScale(NSDI 2024)、DCQCN 等论文与白皮书,busbw 实测经验表与排查案例逻辑自洽;但"实测可达"数据未注明来源环境,属经验估值而非可复现基准,排障案例亦明确标注"虚构但贴近行业",应视为教学素材而非实证。
|
||||||
|
|
||||||
|
### 边界与局限
|
||||||
|
|
||||||
|
面向训练侧,推理集群场景仅一句话带过;2026—2028 展望(UEC 大规模部署、光 I/O 进芯片、跨 DC 训练)是趋势判断而非事实;国产生态数据(CloudMatrix 功耗、带宽)缺乏公开实测背书,且未做 IB 与以太网的 TCO 量化对比。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 可引用金句
|
||||||
|
|
||||||
|
> "算力决定上限,互联决定利用率。"
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 总体评价
|
||||||
|
|
||||||
|
**亮点**:
|
||||||
|
- 系统性极强——从物理层、协议层到拓扑层再到排障层全覆盖,一篇文章搭起完整知识框架
|
||||||
|
- 排查清单、NCCL 环境变量速查、nccl-tests 实操可直接照搬,工程价值高;对 IB/RoCE 竞争与国产替代生态(CloudMatrix、星脉、HPN、MegaScale)梳理客观
|
||||||
|
|
||||||
|
**不足**:
|
||||||
|
- 部分带宽数字为经验估值,未注明测试环境;展望部分与历史数据混排,读者需自行甄别
|
||||||
|
- 成本视角偏弱,未量化 IB 与以太网的性价比差异
|
||||||
|
|
||||||
|
**适用场景**:训练集群基础设施工程师、MLOps 团队的技术手册;万卡网络设计、排障培训教材;了解国产互联生态与选型约束的决策参考。
|
||||||
|
|
||||||
|
**关联建议**:以 Introl《InfiniBand vs 以太网 GPU 集群对比》补足 TCO 与选型决策视角;深入研读 HPN、MegaScale、Meta《RDMA over Ethernet at Meta Scale》三篇论文;后续跟进该系列第 05 篇(Checkpoint 与故障域)。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 配图
|
||||||
|
|
||||||
|

|
||||||
@@ -0,0 +1,202 @@
|
|||||||
|
# 硅谷CEO: Grok Bot诞生,震撼程度堪比Claude Code时刻!
|
||||||
|
|
||||||
|
> **来源**:微信公众平台(ASI启示录)
|
||||||
|
> **作者**:ASI启示录
|
||||||
|
> **发布日期**:2026-08-20(原文未标注明确日期,按下载日占位)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/Suq0Z4bseQHEzL42s18Nbw
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
最近,一个神级工具,震撼了硅谷。
|
||||||
|
|
||||||
|
「我认为Grok Bot是AI的又一个『Claude Code』时刻。我估计我个人对AI的使用量增长了大约100倍!」
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
这是硅谷知名投资人Gavin Baker在X上发出的惊叹。
|
||||||
|
|
||||||
|
为了证明Grok Bot的离谱效率,他分享了一个极其反直觉的案例——
|
||||||
|
|
||||||
|
这段时间,有无数人向他请教如何从零构建一个复杂的「播客摘要器」。
|
||||||
|
|
||||||
|
按照传统的开发流程,你需要懂得API对接、大模型Prompt调优、音频转写、前后端部署等一连串复杂的动作。但Gavin是怎么做的?
|
||||||
|
|
||||||
|
「我在Grok Bot里大约只花了15秒就完成了,而且效果比我之前用的所有旧版工具都要好!」
|
||||||
|
|
||||||
|
15秒,就能手搓一个高可用的AI级应用。
|
||||||
|
|
||||||
|
不仅是Gavin,知名连续创业者Andrew Wilkinson也公开发表了力挺——
|
||||||
|
|
||||||
|
「100%赞同!我觉得它如此迷人的原因,80%在于它的速度和响应实在太快了,简直快得惊人!我开始使用它之后,几乎立刻就关掉了我原本在用的OpenClaw和Hermes智能体。」
|
||||||
|
|
||||||
|
是的,Grok Bot的诞生,可能是对现有的AI Agent生态的降维打击。
|
||||||
|
|
||||||
|
## 它凭什么干掉过去的「AI天花板」?
|
||||||
|
|
||||||
|
AI创作者、多项AI初创公司创始人Alex Finn在连续重度使用Grok Bot一周后,得出了一个结论:「它是目前市面上绝对最好的开箱即用AI智能体体验,没有之一。」
|
||||||
|
|
||||||
|
过去的AI智能体(比如Hermes、Codex等)往往陷入了一个怪圈:配置地狱。
|
||||||
|
|
||||||
|
每当你想要完成一个任务,你需要像个工程师一样去选择底层模型、调整上下文窗口大小、设定推理级别、配置本地还是云端运行、开启或关闭一堆复杂的插件权限……
|
||||||
|
|
||||||
|
对于95%的普通用户来说,这种体验简直令人抓狂。
|
||||||
|
|
||||||
|
但Grok Bot走了一条完全不同的道路——「极度主见的工作流」。
|
||||||
|
|
||||||
|
它是极致的「零配置」。
|
||||||
|
|
||||||
|
Grok Bot会替你做出了所有决定。你不需要选模型,不需要调参数,下载、安装、打开,直接告诉它你要干什么。它就像苹果产品一样,把复杂的底层逻辑全部封装,呈现给你的就是「它直接就能跑,而且跑得最好」。
|
||||||
|
|
||||||
|
而且,它还有强制的「云原生虚拟机」。
|
||||||
|
|
||||||
|
起初,很多人(包括Alex Finn自己)对这一点感到抗拒,大家更习惯让AI在自己的本地电脑上操作。
|
||||||
|
|
||||||
|
但Grok Bot强制要求:所有Bot都在云端拥有自己独立的虚拟电脑(VM)。
|
||||||
|
|
||||||
|
用了一周后,所有人都会大喊「真香」。为什么?因为安全隔离。
|
||||||
|
|
||||||
|
你不需要把自己的个人账号、敏感文件暴露给AI。想让AI管理某个账号?直接去它那个云端虚拟机的浏览器里登录就行了。
|
||||||
|
|
||||||
|
它在你看不见的云端24小时不间断地工作,丝毫不会让本地设备卡顿。
|
||||||
|
|
||||||
|
最后,就是史诗级的「多智能体原生协同」。
|
||||||
|
|
||||||
|
这是Grok Bot最可怕的护城河。Grok Bot的界面非常像苹果的iMessage,左边是你建立的一排Bot,右边是对线框。
|
||||||
|
|
||||||
|
当你给某个Bot下达任务时,它们居然会自动在后台互相发消息沟通!
|
||||||
|
|
||||||
|
比如,你让「写代码Bot」去开发一个功能,它会自动给「内容Bot」发消息:「嘿,老板前天在X上发了什么需求?把上下文给我发一下。」
|
||||||
|
|
||||||
|
你不需要居中调度,它们自己组成了一个团队,自动找人、传上下文、接力完成工作。
|
||||||
|
|
||||||
|
## 终极实操:如何用Grok Bot打造「一人公司」?
|
||||||
|
|
||||||
|
网友Evanpunk2077在深度体验后,一语道破天机:「Grok Bot比OpenClaw、Herms Agent好用太多了。」
|
||||||
|
|
||||||
|
没错,只要配置得当,你将拥有一整支为你全年无休打工的赛博AI团队。
|
||||||
|
|
||||||
|
以下是基于Alex Finn实战经验的保姆级配置指南,建议立刻收藏:
|
||||||
|
|
||||||
|
### 第一步:设立你的「赛博CEO」
|
||||||
|
|
||||||
|
打开Grok Bot,你拥有的第一个Bot,不要叫它「助手」,把它置顶,重命名为一个真实的人名),职位设定为:Chief of Staff(幕僚长)或 CEO。
|
||||||
|
|
||||||
|
为什么要这么做?因为当你拥有几十个Bot时,你根本记不住该把任务分给谁。你只需要把任务丢给CEO,比如:「我需要研究一下最近的AI趋势并写一封邮件发出去」。
|
||||||
|
|
||||||
|
CEO Bot会自动分析:「研究工作分给Barry,写邮件分给Cindy」,然后替你把活儿全派下去。
|
||||||
|
|
||||||
|
### 第二步:「大脑倾倒」与「逆向提示词」大法
|
||||||
|
|
||||||
|
不要自己去痛苦地写Bot的System Prompt。用这个首创的流程:
|
||||||
|
|
||||||
|
**1.大脑倾倒**
|
||||||
|
|
||||||
|
在对话框里疯狂输入关于你的一切。你是谁?你的公司叫什么?你的目标是什么?你讨厌做什么事?你想搞什么方向的钱?
|
||||||
|
|
||||||
|
**2.逆向提示词**
|
||||||
|
|
||||||
|
接着对它说:「基于你对我的了解,如果是你,你会如何设置这个Grok Bot工作台?我们应该建立哪些Bot?它们的职位、职责和日常例行工作应该是什么?请帮我配置以实现生产力最大化。」
|
||||||
|
|
||||||
|
指令发出后,奇迹就会发生。你的CEO Bot会自己控制自己,自动在左侧栏为你创建出一排排分工明确的打工人Bot,连头像和描述都给你写好了!
|
||||||
|
|
||||||
|
### 第三步:装配「神级插件(Plugins/MCPs)」
|
||||||
|
|
||||||
|
Grok Bot的强大离不开工具库,以下几个是必装神器:
|
||||||
|
|
||||||
|
**1 Agent Mail:** 这是强烈推荐的杀手锏。
|
||||||
|
|
||||||
|
不要把你的私人Gmail密码给AI!用免费的Agent Mail给你的每一个Bot创建一个专属的邮箱地址。然后用这个邮箱把它们作为「员工」邀请进你的各种后台(比如社区管理员、网站运营)。它们从此有了独立的「数字身份证」。
|
||||||
|
|
||||||
|
**2 Vercel & Cursor Origin:** 程序员必备,AI写完代码直接自动推送到Vercel部署,一气呵成。
|
||||||
|
|
||||||
|
**3 Tailscale:** 局域网穿透神器。装上它,你的云端Bot就能跨设备控制你的手机、iPad、Mac台式机,实现全终端制霸。
|
||||||
|
|
||||||
|
**4 Last 30 Days:** 一款信息挖掘插件,能逆向调用全网社交媒体API,做趋势深挖和背景调研的神器。
|
||||||
|
|
||||||
|
## 抄作业!大佬的「AI舰队」都在干什么?
|
||||||
|
|
||||||
|
我们来看看Alex Finn自己日常是如何压榨这群「赛博打工人」的。
|
||||||
|
|
||||||
|
他的Grok Bot后台主要养了这5员大将,覆盖了技术、内容、社区、商务和创新。
|
||||||
|
|
||||||
|
**1 Build(首席技术官 CTO)**
|
||||||
|
|
||||||
|
Build是整个团队的技术大拿。Alex的设备很多,甚至有一台搭载了顶级RTX 5090显卡的超级主机。
|
||||||
|
|
||||||
|
通过Tailscale,Build可以在云端直接控制这台5090主机,在上面部署一个拥有380亿参数的Qwen本地大模型,并在这个环境下从零手搓一款游戏。任何代码报错、个人网站更新,直接喊Build,秒修复。
|
||||||
|
|
||||||
|
**2 Barry(全天候公关与内容总监)**
|
||||||
|
|
||||||
|
如果你也做自媒体或关注行业前沿,你必须拥有一个Barry。
|
||||||
|
|
||||||
|
Barry被设置了一个强大的Routine:每天从早上7点到晚上11点半,每隔30分钟,Barry就会自动去扫一遍SpaceX、OpenAI、Anthropic等科技巨头的X账号。
|
||||||
|
|
||||||
|
只要有重量级产品发布,Barry会立刻将快讯推给老板,同时自动抓取老板过去的视频素材,洗稿拼接成最新的爆款订阅邮件,永远快人一步。
|
||||||
|
|
||||||
|
**3 Dusty(不知疲倦的社群运营)**
|
||||||
|
|
||||||
|
Dusty通过Agent Mail拥有了自己的账号,被邀请成为了Alex社群的管理员。
|
||||||
|
|
||||||
|
它24小时巡视论坛。有人发了技术求助帖?Dusty秒回专业解答。
|
||||||
|
|
||||||
|
有新用户潜水好几天没动静?Dusty会通过调研该用户的背景,主动私信他:「嘿,看你的资料,建议你可以试着开发一个XX小工具哦!」
|
||||||
|
|
||||||
|
把社群活跃度拉得满满的,而老板Alex完全不用插手。
|
||||||
|
|
||||||
|
**4 Cindy(反垃圾邮件与商务总监 BD)**
|
||||||
|
|
||||||
|
Alex本人极度讨厌看邮件,这导致他错过了无数商业赞助。Cindy完美填补了这个空缺。
|
||||||
|
|
||||||
|
Cindy被授权接入商务邮箱,每天对付数以百计的邮件。Cindy会仔细背调每一个发件人的公司背景,甄别出骗子和真实的赞助商。
|
||||||
|
|
||||||
|
每天下班前,Cindy会给老板提交一份干净清爽的Excel表格:「老板,今天有这3个真金白银的商务合作可以聊,请过目。」
|
||||||
|
|
||||||
|
**5 Reed(疯狂的黑客增长实验员)**
|
||||||
|
|
||||||
|
这是最具有赛博朋克色彩的一个Bot。老板CEO会指派Reed整天在互联网上「游荡」。
|
||||||
|
|
||||||
|
Reed的任务是到处看帖子,分析网民最近在抱怨什么、缺什么工具。一旦发现痛点,Reed就会自己快速写一个小产品,扔到网上去测试有没有人点、有没有人付费。Reed就像一个不知疲倦的找雷达,全天候在互联网的汪洋大海里替老板寻找搞钱的机会。
|
||||||
|
|
||||||
|
CEO统揽大局,五个高管各司其职,全部在云端虚拟机里全自动闭环。
|
||||||
|
|
||||||
|
这,就是生产力跃升100倍的真相!
|
||||||
|
|
||||||
|
## Grok Bot能一统天下吗?
|
||||||
|
|
||||||
|
虽然Grok Bot带来了无与伦比的震撼,但在这场狂欢中,业内依然存在一些冷静的声音。
|
||||||
|
|
||||||
|
科技大V Mckay Wrigley一针见血地指出:「Grok Bot这样的产品,最大的问题在于它们作为『生产力工具』,显得还不够严肃。」
|
||||||
|
|
||||||
|
他认为,虽然「云端智能体+虚拟机」绝对是正确的方向,但目前业内跟风的「iMessage短信式聊天界面」其实是错误的方向。
|
||||||
|
|
||||||
|
如果开发团队(传闻背后有SpaceX和Cursor团队的影子)想要真正让企业买单,就必须抛弃聊天框,进化出更符合企业级SaaS交互的管理界面。
|
||||||
|
|
||||||
|
Mckay还提醒大家,当年「Claude Code时刻」之所以伟大,不仅仅是因为外壳好用,更是因为Claude大模型本身极其逆天。目前Grok Bot的底层模型虽然很强,但还没到独孤求败的地步。
|
||||||
|
|
||||||
|
「我们得等看Grok 4.7版本到底有多聪明。工具再好,如果模型不够聪明,一切都是零。」
|
||||||
|
|
||||||
|
而且,并不是所有人都能无痛享受这场盛宴。
|
||||||
|
|
||||||
|
网友Dave Evans抱怨道:「自从5月份Grok加上了额度限制后,我的使用量反而下降了100倍。哪怕我买了Supergrok+年度会员,我常常还没跑出一个有用的结果,周度调用限额就爆了,再买算力又太贵。这几乎成了富人的游戏。」
|
||||||
|
|
||||||
|
残酷的现实就是:超级Agent在后台疯狂交互、调用工具的背后,燃烧的是巨量的Token。想要驱动一个「一人公司」,每个月的算力账单绝不是一笔小数目。
|
||||||
|
|
||||||
|
所以,Grok Bot真的能干掉Hermes和OpenClaw吗?
|
||||||
|
|
||||||
|
答案是:它们可以共存,而非立刻取代。
|
||||||
|
|
||||||
|
正如Alex Finn所说,Grok Bot是极其封闭、有主见的系统,你不能自由更换底层大模型。
|
||||||
|
|
||||||
|
如果你需要让AI直接干预你的本地系统底层文件,或者你想用一些极其便宜的开源模型(比如用本地显卡跑Qwen 38B)来省钱,高度可定制的Hermes和OpenClaw依然是不可替代的。
|
||||||
|
|
||||||
|
Grok Bot负责全天候的通用脑力劳动与云端协同,而Hermes负责深度的本地定制与极客操作。
|
||||||
|
|
||||||
|
两者的结合,才是当下的终极答案。
|
||||||
|
|
||||||
|
参考资料:
|
||||||
|
|
||||||
|
https://x.com/GavinSBaker/status/2089379355692527813
|
||||||
|
|
||||||
|
https://www.youtube.com/watch?v=vrgO4D_mUlA
|
||||||
|
|
||||||
|
编辑:Aeneas
|
||||||
@@ -0,0 +1,78 @@
|
|||||||
|
# 📊 文章摘要:硅谷CEO: Grok Bot诞生,震撼程度堪比Claude Code时刻!
|
||||||
|
|
||||||
|
> **原文**:[2026-08-20_硅谷CEO_Grok_Bot诞生_震撼程度堪比Claude_Code时刻](./2026-08-20_硅谷CEO_Grok_Bot诞生_震撼程度堪比Claude_Code时刻.md)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/Suq0Z4bseQHEzL42s18Nbw
|
||||||
|
> **来源**:微信公众平台
|
||||||
|
> **作者**:ASI启示录
|
||||||
|
> **发布日期**:2026-08-20
|
||||||
|
> **摘要日期**:2026-08-20
|
||||||
|
> **价值评级**:⭐⭐ 中
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 核心命题
|
||||||
|
|
||||||
|
> **零配置舰队** — Grok Bot 以"零配置 + 强制云端 VM + 多智能体原生协同"把 Agent 使用门槛降到普通用户可用,代表开箱即用路线对可定制路线的冲击。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 文章概要
|
||||||
|
|
||||||
|
本文是新能源媒体式的产品资讯汇编:Grok Bot 被硅谷投资人称为"又一个 Claude Code 时刻",其核心卖点为零配置(替用户做所有决定)、强制云端虚拟机(安全隔离、不占本地)与多智能体原生协同(Bot 之间自动互发消息接力工作)。文章主体转载 Alex Finn 的"一人公司"配置实战(CEO Bot + 大脑倾倒/逆向提示词 + Agent Mail/Tailscale 等插件 + 五员大将分工),文末保留了冷静声音:聊天界面不够严肃、模型能力才是上限、Token 成本高昂,结论是与 Hermes/OpenClaw 共存而非替代。价值在于实操配置参考与多方观点并存,但整体为二手转述、无独立验证。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 关键要点
|
||||||
|
|
||||||
|
1. **Grok Bot 三大产品特征** — 极致零配置(不选模型不调参数)、强制云原生虚拟机(安全隔离、24 小时云端运行)、多智能体原生协同(Bot 自动互发消息、传上下文、接力工作)`[分类: 共识]`
|
||||||
|
2. **15 秒构建播客摘要器** — 投资人 Gavin Baker 称其个人 AI 使用量增长约 100 倍;此类惊人性说法来自推主自述,无独立验证 `[分类: 争议]`
|
||||||
|
3. **"一人公司"五 Bot 舰队配置** — Build(CTO)/Barry(内容)/Dusty(社群)/Cindy(商务)/Reed(增长) 各司其职,CEO Bot 统一派活,覆盖技术-内容-社区-商务-创新 `[分类: 共识]`
|
||||||
|
4. **大脑倾倒 + 逆向提示词配置法** — 先倾倒个人/公司信息,再让 CEO Bot 反向为你设计 Bot 组织架构与职责,避免手写 System Prompt `[分类: 共识]`
|
||||||
|
5. **必装插件四件套** — Agent Mail(数字身份证)、Vercel/Cursor(部署)、Tailscale(跨设备控制)、Last 30 Days(趋势挖掘)`[分类: 共识]`
|
||||||
|
6. **冷静声音:模型决定上限** — Mckay Wrigley 指出聊天式界面不适合企业级 SaaS;"工具再好,如果模型不够聪明,一切都是零" `[分类: 争议]`
|
||||||
|
7. **额度限制成富人游戏** — 5 月起 Grok 限额后重度用户使用量反降,超级 Agent 燃烧巨量 Token,算力账单是"一人公司"的真实门槛 `[分类: 争议]`
|
||||||
|
8. **共存而非替代** — Grok Bot 封闭有主见(不能换模型),本地深度定制与便宜开源模型场景仍是 Hermes/OpenClaw 的地盘 `[分类: 共识]`
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 批判性分析
|
||||||
|
|
||||||
|
### 假设前提
|
||||||
|
|
||||||
|
文章默认:(1) 硅谷 KOL 的使用体验可代表产品真实能力——传播链(X 推文→YouTube→公众号)层层转述放大;(2) "Bot 自动协同"比人工调度更优——但自动互发消息的上下文损耗与失控风险未被讨论;(3) 一人公司范式可直接套用——个案成功不构成普遍性。
|
||||||
|
|
||||||
|
### 论据与逻辑
|
||||||
|
|
||||||
|
全部论据为名人引语与个人体验,无基准测试、成本数据、失败案例。文章结构是"惊叹→功能介绍→保姆教程→唱反调→折中"的媒体套路,逻辑上无硬伤但论证强度低。值得肯定的是保留了反对观点(Wrigley 的批评、额度限制抱怨),未做成单方面软文。
|
||||||
|
|
||||||
|
### 边界与局限
|
||||||
|
|
||||||
|
适用于了解 Grok Bot 产品形态与个人多 Bot 协作配置思路;对产品选型决策参考价值有限(无与竞品的系统对比)。文中"生产力跃升 100 倍"等表述为传播话术。时效性强,产品迭代可能很快使细节过时。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 可引用金句
|
||||||
|
|
||||||
|
> "工具再好,如果模型不够聪明,一切都是零。"
|
||||||
|
|
||||||
|
> "Grok Bot负责全天候的通用脑力劳动与云端协同,而Hermes负责深度的本地定制与极客操作。两者的结合,才是当下的终极答案。"
|
||||||
|
|
||||||
|
> "残酷的现实就是:超级Agent在后台疯狂交互、调用工具的背后,燃烧的是巨量的Token。"
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 总体评价
|
||||||
|
|
||||||
|
**亮点**:
|
||||||
|
- 完整搬运了 Alex Finn 的多 Bot 组织配置实操,有直接参考价值
|
||||||
|
- 保留了多方冷静声音,避免单边吹捧
|
||||||
|
- 对零配置 vs 可定制两条路线的共存判断清醒
|
||||||
|
|
||||||
|
**不足**:
|
||||||
|
- 二手转述,无独立验证与数据
|
||||||
|
- 标题党色彩浓("震撼""降维打击")
|
||||||
|
- 对多智能体自动协同的风险面(失控、成本、安全)几乎未讨论
|
||||||
|
|
||||||
|
**适用场景**:了解 Agent 消费级产品趋势;设计个人多 Bot 工作流时的配置参考
|
||||||
|
|
||||||
|
**关联建议**:与《万字长文:做了些爆款 Skills 以后》(本批归档)对读——Grok Bot 的零配置厚产品路线 vs Skill 生态的开放能力商品路线,是 Agent 普及的两种范式
|
||||||
@@ -0,0 +1,346 @@
|
|||||||
|
# 美国镜鉴:当AI浪潮遭遇政治反弹
|
||||||
|
|
||||||
|
> **来源**:微信公众平台
|
||||||
|
> **作者**:CF40研究部
|
||||||
|
> **发布日期**:2026-07-28
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/OLxrS_jzJqz0z6bKIJMsfA
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
[图片]
|
||||||
|
|
||||||
|
"
|
||||||
|
|
||||||
|
在AI技术以前所未有的速度扩张之际,对AI的政治反弹力量也在同步积蓄,这一现象在美国等发达经济体中尤为突出。正如《华尔街日报》所评,当前唯一比AI产业增长更快的,可能就是美国人对AI的负面情绪。尽管AI尚未造成全面的宏观就业冲击,围绕岗位替代、技能与数据控制、科技巨头权力边界以及数据中心资源消耗的社会争议,却已迅速升温。
|
||||||
|
|
||||||
|
本文首先回顾工业革命、铁路革命和计算机革命中对技术的政治反弹,梳理反抗对象如何从机器、垄断企业逐步转向选举政治;随后分析当前美国国内,对AI的政治反弹的三条战线——劳动保护、科技巨头权力与地方资源冲突;最后考察左右翼民粹力量对反"科技寡头"叙事的整合,梳理建制派与AI企业在就业补偿、收益分享、安全监管和社区成本分担方面的回应,并探讨对AI的政治反弹进入美国全国性选举议程的条件及其对AI产业的潜在影响。
|
||||||
|
|
||||||
|
* 原文《当AI浪潮遭遇政治反弹》在2026年7月28日首发于CF40 APP,内容略有删减。本文观点仅供了解海外研究动态,不代表中国金融四十人论坛和中国金融四十人研究院意见和立场。
|
||||||
|
|
||||||
|
"
|
||||||
|
|
||||||
|
______[图片]______
|
||||||
|
|
||||||
|
历史上对技术的政治反弹:
|
||||||
|
|
||||||
|
从破坏机器到诉诸选票
|
||||||
|
|
||||||
|
历史经验表明,技术革命能否获得社会支持,不仅取决于其长期创造多少收益,还取决于收益与成本如何分配,以及制度能否在损失固化之前为受冲击者提供补偿和转型通道。
|
||||||
|
|
||||||
|
当技术直接替代劳动、损失集中于特定群体时,反抗容易指向机器;当企业借助技术控制市场入口时,矛头会转向垄断企业;当冲击长期而分散、又得不到制度缓解时,积累的不满则可能经由政治动员进入选举。
|
||||||
|
|
||||||
|
______1. 工业革命初期:替代型技术引发对机器的直接反抗______
|
||||||
|
|
||||||
|
牛津大学经济学家卡尔·弗雷指出,赋能型技术通常能够提高劳动者的生产率、创造新任务并增加收入,因而较容易得到接受;替代型技术却可能导致既有技能贬值、工资下降和议价能力削弱,因此更容易引发抵制。换言之,公众并不是笼统地支持或反对技术,而是根据技术对自身收入和经济地位的影响形成态度[1]。
|
||||||
|
|
||||||
|
工业革命初期正是这种矛盾的典型案例。纺织机械和机械化工厂显著提高了生产率,却主要以替代劳动的方式投入使用,其收益也没有立即转化为劳动者收入。经济史学家罗伯特·艾伦将这一时期生产率增长与劳动者收入停滞并存的现象称为"恩格斯暂停"(Engels' Pause)。按照他的估算,1780-1840年间,英国每名工人的产出增长约46%,实际工资却仅增长约12%,利润率则大致翻倍。直到1840年以后,随着蒸汽动力的广泛采用和机器的复杂化,工厂对高技术工人需求增加,工人的实际工资才开始更明显地追赶生产率增长[2]。
|
||||||
|
|
||||||
|
在生产率收益主要流向资本所有者的同时,机械化首先冲击了手工织工等特定群体的岗位、工资和技能价值,由此引发卢德运动[3]。卢德分子通过大规模破坏纺织机器、组织抗议和向议会请愿,要求限制直接替代劳动者的技术应用。行动最终因政治影响力有限和政府镇压而失败。但该运动表明,当技术损失集中落在特定劳动群体身上,而收益尚未广泛扩散时,对机器的直接反抗更容易发生。
|
||||||
|
|
||||||
|
______2. 铁路革命:反抗对象指向基础设施垄断______
|
||||||
|
|
||||||
|
如果说卢德运动针对的是技术对劳动的直接替代,铁路时代的反抗则指向企业借助技术形成的基础设施控制权。19世纪下半叶的美国,铁路迎来了飞速发展期,铁路降低了运输成本、扩大了全国市场,却也让铁路公司及其合作的粮仓经营者垄断了定价权和农产品进入市场的关键通道。缺乏替代运输渠道的农民往往需要承担更高运费和粮仓的存储费。
|
||||||
|
|
||||||
|
在农产品价格下跌、债务负担上升和货币紧缩的背景下,面对高昂的运输和仓储成本,美国中西部的大量农民濒临破产。由农民发起的格兰杰运动推动多个州限制铁路和粮仓收费,并促成1887年《州际商务法》和州际商务委员会的建立,标志着美国政府开始介入并约束大型托拉斯与铁路垄断巨头。19世纪末美国的民粹政党人民党又进一步提出铁路监管、累进所得税、农业信贷和货币改革等主张。尽管人民党最终垮台,但其许多政策主张都被随后的民主党政府所吸纳[4]。
|
||||||
|
|
||||||
|
农民反对的不是铁路本身,而是铁路公司利用基础设施控制权决定谁能进入市场、谁承担更高成本。当新技术成为难以替代的市场入口时,反弹力量便可能由抵制设备转向反垄断和公共监管。
|
||||||
|
|
||||||
|
______3. 20世纪工业化:分享技术红利一度缓和反弹______
|
||||||
|
|
||||||
|
并非所有技术革命都会引发同等强度的反弹。20世纪的电气化、汽车和大规模生产虽然淘汰了一些职业,却也创造了大量半熟练制造业、设备维护和办公室岗位。制造业持续扩张和教育普及,使多数被替代者能够转入工资更高、危险程度更低的岗位。1870—1980年间,美国劳动生产率与工人实际报酬总体同步增长,没有再次出现工业革命初期的 "恩格斯暂停"现象[5]。
|
||||||
|
|
||||||
|
制度建设进一步缓和了技术调整的成本。1910—1920年代兴起的企业福利资本主义,通过提高工资、提供医疗和养老金等方式,将部分生产率收益返还给工人。大萧条以后,罗斯福新政又以《瓦格纳法》确立工人组织工会和集体谈判的权利,并通过最低工资、四十小时工作周和加班工资等制度改善劳动条件;战后福利国家、工会和集体谈判进一步为失业和职业转换提供缓冲。劳动者的诉求因此逐渐由阻止机器转向接受机械化,同时争取工资、福利、培训和补偿。
|
||||||
|
|
||||||
|
这一时期说明,技术革命并不必然导致强烈反弹。只要新技术能够创造替代岗位,生产率红利能够转化为工资和福利,制度又能分担转型成本,劳动者就更可能接受甚至拥抱技术进步。
|
||||||
|
|
||||||
|
______4. 计算机革命与全球化:自动化焦虑转入选举政治______
|
||||||
|
|
||||||
|
20世纪80年代以后,计算机开始大量替代流水线生产、文书处理和基层行政等程序化、重复性较强的工作,同时提高专业人员和管理者等高技能劳动者的生产率。有学者将这一变化概括为"就业极化":支撑战后中产阶层的制造业和文职岗位不断减少,新增就业则更多集中在高薪专业岗位和低薪服务业[6]。技术进步带来的收益更多流向资本所有者和高技能劳动者,许多没有大学学历的劳动者只能转向工资更低、稳定性更差的服务业。
|
||||||
|
|
||||||
|
全球化进一步加剧了这种分化。自动化减少了工厂对普通劳动力的需求,产业外迁和进口竞争则加快了传统制造业中心的衰落。冲击尤其集中在"锈带"等工业地区,不仅造成制造业岗位流失,还拖累当地服务业、削弱税基和公共服务,使许多社区长期难以恢复[7]。
|
||||||
|
|
||||||
|
蓝领工人失去的也不只是收入。稳定的制造业工作曾使没有大学学历的劳动者也能维持中产生活,获得家庭和社区地位。随着工厂关闭、职业上升通道收窄,经济失落逐渐转化为尊严受损、身份下降以及被精英抛弃的感受[8]。
|
||||||
|
|
||||||
|
与卢德运动不同,这种不满并未主要表现为破坏机器,而是逐渐进入选举政治。自动化过程缓慢而分散,难以找到明确的归责对象;相比之下,工厂外迁、进口商品和移民更容易被政治化。因此,部分由技术变迁造成的经济压力,最终转化为贸易保护、反移民和反精英诉求。
|
||||||
|
|
||||||
|
研究发现,在控制贸易冲击、产业结构等因素后,机器人使用较多的美国地区,2016年大选对特朗普的支持增幅也更大[9]。计算机革命由此形成了一条清晰的政治传导链:蓝领制造业岗位流失、工业社区衰退和工人社会地位下降,共同为民粹主义兴起提供了社会基础。
|
||||||
|
|
||||||
|
______[图片]______
|
||||||
|
|
||||||
|
对AI政治反弹的三条战线:
|
||||||
|
|
||||||
|
劳动、企业权力和地方资源
|
||||||
|
|
||||||
|
与历史上对技术的政治反弹相似,当前AI引发的争议并非对技术本身的笼统拒绝,而是由岗位替代、收益集中和企业转嫁扩张成本引发的利益冲突。劳动者担心失业和技能贬值,中小企业和普通公众担心少数科技企业控制算力、模型和市场入口,地方居民则反对数据中心将电力、水和土地成本转嫁给社区。这三条战线分别围绕劳动保护、科技巨头权力和地方社区资源冲突展开,虽然尚未形成目标统一的运动,却可能共同转化为对科技巨头及现有分配制度的不满。
|
||||||
|
|
||||||
|
______1. 保卫劳动:岗位、技能与补偿之争______
|
||||||
|
|
||||||
|
劳动领域正在出现一种新的"卢德主义式"反抗。其核心诉求是反对企业单方面利用AI取消岗位、复制劳动者技能并削弱其议价权,要求劳动者参与AI部署,并获得就业保障、合理补偿和技术红利。与此前主要冲击工厂和常规性岗位的自动化不同,生成式AI可以直接处理编程、写作、配音、设计和客户服务等认知任务,使这种反抗迅速蔓延至白领、创意劳动者和刚刚进入就业市场的青年。
|
||||||
|
|
||||||
|
尽管宏观就业尚未因AI全面收缩,民众的悲观情绪已经提前形成。进步派政治数据与民调机构蓝玫瑰研究(Blue Rose Research)的调查显示,79%的美国选民担忧政府没有应对AI失业的计划,77%担心旧行业消失快于新行业诞生,72%担心AI压低普通人的工资[10]。在硅谷和年轻白领群体中,人们越来越担心那些无法从AI中获益的人会沦为缺乏经济筹码的"永久底层阶级(permanent underclass)"[11]。
|
||||||
|
|
||||||
|
年轻一代的恐慌尤为剧烈。哈佛民调发现,59%的18—29岁美国人认为AI威胁自己的就业前景,41%担心AI会使工作失去意义[12]。这种不安并非完全脱离现实:斯坦福数字经济实验室发现,生成式AI普及后,在高AI暴露职业中(如软件开发、客户服务),22至25岁的早期职业者就业人数相对下降了16%;相比之下,受影响较小领域的员工以及同一职业中经验更丰富的员工,其就业情况保持稳定或持续增长[13]。
|
||||||
|
|
||||||
|
图1:按不同年龄组劳动者划分的就业指数
|
||||||
|
|
||||||
|
[图片]
|
||||||
|
|
||||||
|
就业焦虑正在由个人担忧转化为集体行动。具体而言,当代"卢德式"反抗主要争夺以下权利:AI部署前的协商权、对自身技能和数据的控制权,以及技术替代后的保障和补偿权。
|
||||||
|
|
||||||
|
在AI部署环节,劳动者要求将AI部署纳入劳资协商。因企业未能提供明确、可执行的AI保护条款,美国电子游戏演员自2024年7月起举行罢工[14]。2026年6月,韩国现代汽车工会把人形机器人的引入列入劳资谈判,要求企业在部署前取得工会同意,并承诺不得以机器人为由单方面裁员、降薪或恶化工作条件[15]。
|
||||||
|
|
||||||
|
劳动者也开始争夺自身技能及其数字化载体的控制权。2026年初,英国演员投票拒绝未经保障的数字全身扫描[16],德国配音演员则拒绝签署允许Netflix将录音用于AI训练的合同[17]。同年5月,Meta员工因担心数据被用于复制和替代劳动力,联署反对公司在员工电脑上安装鼠标追踪软件、收集员工工作流程数据[18]。
|
||||||
|
|
||||||
|
当AI扩张已经伴随实际裁员时,劳动者开始要求企业提供就业保障和补偿。2026年4月,在甲骨文大规模裁员同时加大AI投入后,超过600名被裁员工联名要求公司提高遣散费、延长医疗保障、加速股权归属[19]。
|
||||||
|
|
||||||
|
劳动者的诉求也开始从防止岗位损失延伸至分享AI红利。全球AI投资推高存储芯片需求,给三星电子带来巨额利润,但工人认为企业没有让劳动者充分分享这轮繁荣。2026年4月,约4万名韩国三星工人举行集会,抗议公司的奖金分配方案,要求取消奖金上限,并将更多营业利润纳入员工奖金池;在谈判陷入僵局后,超过4.5万名工人一度准备举行18天罢工[20]。
|
||||||
|
|
||||||
|
部分行动已经迫使企业让步。美国电子游戏演员经过近一年的罢工,于2025年7月将AI复制声音、形象和动作所需的知情同意、用途披露和报酬机制写入集体合同[21]。面对员工抵制,Meta缩减了数据收集项目,后因数据安全问题将项目暂停[22]。经过五个月的劳资争议,三星同意将半导体业务营业利润的10.5%用于不设上限的特别奖金,使劳动者更直接地分享AI繁荣带来的企业收益,原定罢工随之取消[23]。
|
||||||
|
|
||||||
|
不过,英国演员、德国配音演员、韩国现代汽车工会、甲骨文被裁员工的行动仍处于施压或谈判阶段。总体来看,劳动者对AI的反抗已经开始从抽象的失业担忧转向具体的协商权、数据权、就业保障和利润分享,但成果仍主要集中在工会力量较强、替代风险较直接的行业,尚未形成普遍适用的制度保障。
|
||||||
|
|
||||||
|
______2. 约束科技巨头:数据产权与规则制定权之争______
|
||||||
|
|
||||||
|
与19世纪铁路巨头凭借运输网络决定谁能进入市场、支付多少费用相似,今天的少数大型科技企业能够大规模集中社会数据,并将公共知识和创作者劳动转化为私人资产。更重要的是,由于监管机构难以独立了解模型能力、训练过程和潜在风险,AI企业还在安全标准、风险评估和信息披露等规则制定中占据明显优势。公众争论因此从"是否发展AI"进一步转向:谁有权占有训练数据,以及谁有权制定安全和监管规则。
|
||||||
|
|
||||||
|
公众对企业自我监管和政府约束科技巨头的能力都缺乏信心。皮尤研究中心的调查显示,67%的美国成年人对美国政府"有效监管AI"信心不大或毫无信心[24];同样,盖洛普(Gallup)民调发现,高达69%的美国人对企业能否负责任地使用AI持"不太信任"或"完全不信任"的态度[25]。2026年5月,CBS与YouGov的调查显示,78%的美国成年人认为AI企业推广AI是为了扩大自身权力[26]。Blue Rose Research的调查还显示,55%的美国选民认为科技公司应为AI造成的岗位损失承担财务责任,49%的美国选民支持对从AI中获利最多的企业征收专项税[27]。对企业权力的警惕正在与财富分配不满结合起来。
|
||||||
|
|
||||||
|
对AI巨头的反抗首先表现为训练数据的产权争夺。作家、艺术家、出版商、媒体和音乐公司相继对AI企业发起侵权诉讼,反对企业未经许可获取作品、建立训练数据库,再将由社会知识和创作者劳动形成的模型能力转化为私人资产。作者群体起诉Anthropic,指控其下载和保存盗版图书用于训练Claude[28];出版商则起诉谷歌,指控其将原本为其他服务获取的图书用于Gemini训练[29]。这里争议的不只是创作者能否获得报酬,更涉及科技企业能否凭借资金和技术优势,将分散在社会中的知识资源无偿集中到自己的模型之中。
|
||||||
|
|
||||||
|
针对AI资本直接介入选举并影响监管规则,民间组织也开始采取行动。由科技企业高管和投资者支持的"引领未来"(Leading the Future)政治组织网络已筹集超过1.4亿美元,通过多个超级政治行动委员会,支持反对严格州级AI监管的候选人[30]。对此,科技监督、儿童网络安全、残障权益和AI安全等领域的14家民间组织联合呼吁获得其背书的民主党议员和候选人公开拒绝这一支持[31]。美国竞选法律中心(Campaign Legal Center)也向联邦选举委员会提出投诉,指控"引领未来"网络内的两个超级政治行动委员会——American Mission和Think Big——通过新设公司转付竞选费用,隐瞒实际供应商,涉嫌规避联邦支出披露要求[32]。这些组织反对的并非一般政治捐款,而是科技巨头一边宣称拥抱监管,一边利用资金影响立法,使监管规则更符合自身利益。
|
||||||
|
|
||||||
|
极少数反抗已经越出诉讼和政策倡议的范围,转化为针对企业及其高管的暴力攻击。2026年4月,一名20岁男子被控向OpenAI首席执行官山姆·奥特曼位于旧金山的住宅投掷燃烧瓶,他曾发文指责AI高管是"拿孩子们的未来进行赌博"的反社会者。两天后,奥特曼的住宅再次遭遇暴力升级,两名袭击者向其大门开枪。
|
||||||
|
|
||||||
|
这些事件尚不能证明美国已经出现组织化的反AI暴力运动,却表明部分个体开始把对技术失控、就业替代和企业权力的恐惧,集中投射到少数科技高管身上。这种激进化趋势已促使美国国土安全部和FBI等执法部门发出警报,将"反科技暴力极端主义"列为一种正在崛起的新型威胁[33]。
|
||||||
|
|
||||||
|
针对AI巨头的部分行动已经取得实质性成果。Anthropic与作者群体达成的15亿美元和解于2026年7月获得法院最终批准,成为美国已知金额最大的版权和解[34]。相比之下,关于AI监管与规则制定权的博弈依然胶着。尽管美国选民对科技寡头的警惕日益高涨,但面对游说集团的庞大财力以及"输掉AI竞赛"的国家安全叙事,针对AI的联邦级严厉监管与专项税仍停留在政治倡议阶段,公众要从科技巨头手中夺回技术控制权仍面临漫长的拉锯战。
|
||||||
|
|
||||||
|
______3. 保卫地方社区:资源成本与审批权之争______
|
||||||
|
|
||||||
|
模型训练和运行依托的数据中心需要大量电力、水资源和土地,科技企业可以面向全国乃至全球市场获取收益,电价上涨、电网压力、噪声污染和土地占用等成本却正在由项目所在地居民承担。公众争论由此从"是否发展AI"转向数据中心建在哪里、谁承担资源和环境成本,以及地方社区能否参与决策。
|
||||||
|
|
||||||
|
美国民众对数据中心的态度在不到一年内发生了剧烈反转。Heatmap的追踪调查显示,2025年9月,美国人对在本地建设数据中心总体持正面态度(支持率比反对率高2个百分点);到2026年5月,支持率已降至21%,反对率升至71%,而且同时覆盖两党选民[35]。盖洛普同期调查也显示,71%的美国人反对在当地建设AI数据中心,其中48%强烈反对。反对者中,50%提到电力、水和土地等资源消耗,22%担心生活质量、住房和社区环境受到影响[36]。
|
||||||
|
|
||||||
|
图2:美国不同党派选民对AI数据中心的立场
|
||||||
|
|
||||||
|
[图片]
|
||||||
|
|
||||||
|
来源:Gallup
|
||||||
|
|
||||||
|
当地居民对数据中心的抵制源于其收益与成本在科技企业和社区之间的日益失衡。美国智库新泽西政策透视(NJPP)指出,数据中心是2025年6月新泽西州居民电费上涨20%的主要推手[37];密歇根大学福特公共政策学院科技与公共政策项目的研究也发现,自Switch数据中心投入建设以来,密歇根州居民电价累计上涨25%,比全美平均水平高17%[38];与此同时,在普通人承担更高电费的同时,数据中心却可通过大宗购电协议获得更优惠的电价。
|
||||||
|
|
||||||
|
这种不公平感又因有限的就业增长而加剧。科技公司在游说地方政府时,通常会以"创造就业机会"来换取对数据中心项目的税收减免和土地特批。然而现实证明,大多数数据中心的就业主要集中在建设阶段,建成后仅需20至50人运营,这些职位往往由外包人员填补,缺乏工会保护、福利和职业安全感,难以为当地居民提供与资源投入相匹配的长期就业机会[39]。
|
||||||
|
|
||||||
|
对数据中心的抵制已经从单个项目的听证会和请愿,发展为全国性社会动员。2026年7月,保守派团体HumansFirst联合环保组织和地方社区,在全美42个州组织了142场抗议,要求披露项目真实的用电和用水规模,保障居民参与审批,并防止家庭用户通过电费和公共财政为科技企业埋单。参与者横跨保守派地方团体和自由派环保组织,反映数据中心正在成为少数能够跨越党派界限的反科技巨头议题[40]。
|
||||||
|
|
||||||
|
地方反对已经开始直接影响AI基础设施建设。据数据中心项目跟踪组织Data Center Watch统计,仅2026年第一季度,美国就有至少75个、总值约1300亿美元的数据中心项目因地方反对而被取消或延期,规模大致相当于2025年全年[41]。纽约州对耗电50兆瓦以上的新建超大规模数据中心实施一年暂停,成为美国首个采取州级全面暂停措施的州[42];伊利诺伊州也从2026年7月起暂停向新数据中心提供税收优惠[43]。这一压力也传导至欧洲。苏格兰民族党全国委员会已经通过冻结新建数据中心的动议,并提交苏格兰政府考虑。动议估算,正在规划的24个超大规模数据中心,其总用电需求可能达到苏格兰峰值负荷的1.5倍[44]。
|
||||||
|
|
||||||
|
总体来看,围绕数据中心的反抗已经由单个项目周边的噪声、用水和电费争议,发展为对项目审批权和成本分担方式的政治争夺。数据中心不再只是支撑AI运行的技术设施,而成为AI收益与物理成本如何在科技企业和地方社会之间分配的集中体现。
|
||||||
|
|
||||||
|
______[图片]______
|
||||||
|
|
||||||
|
走向选票的怒火:
|
||||||
|
|
||||||
|
对AI的反弹
|
||||||
|
|
||||||
|
从社会焦虑走向政治动员
|
||||||
|
|
||||||
|
社会焦虑只有被政治力量转化为明确的利益冲突,才会形成真正的政治反弹。当前,民粹力量正把分散的就业焦虑、企业权力垄断和地方资源不满,整合为"科技巨头获利、普通民众买单"的叙事,使AI争论从技术进步转向谁控制技术、谁承担成本、谁分享收益。左右翼民粹力量虽然构建了不同叙事,却共同将矛头指向科技寡头,迫使建制派在推动AI发展的同时加强补偿和成本约束。对AI的反弹由此正从社会情绪走向政策竞争,并可能成为下一轮选举的重要议题。
|
||||||
|
|
||||||
|
______1. 共同的敌人:左右翼民粹如何塑造"科技寡头"______
|
||||||
|
|
||||||
|
AI议题尤其容易被民粹力量动员,因为其受益者高度集中且容易识别——少数科技巨头及其亿万富翁创始人;其成本却分散在就业、电费、水资源、地方财政和财富分配等不同领域。左右翼民粹力量正在做的,正是把这些原本彼此分离的不满,压缩成"科技寡头获利、普通人买单"的共同叙事。
|
||||||
|
|
||||||
|
__左翼民粹将AI纳入资本与劳动之间的分配冲突。__在这一叙事中,AI并不是凭空产生的私人财富,而是建立在公共科研投入、全社会积累的知识以及大量创作者和劳动者提供的数据之上。科技企业利用这些公共资源训练模型,却把利润留给股东,把裁员、技能贬值和职业转型成本留给劳动者。因此,AI问题被重新表述为:谁拥有技术、谁分享收益、谁承担转型代价。
|
||||||
|
|
||||||
|
参议员伯尼·桑德斯、纽约州民主党众议员亚历山德里娅·奥卡西奥-科尔特斯(AOC)等激进左翼正围绕劳动保护、公共所有和社区控制展开政治动员。针对AI和自动化可能替代大量岗位,桑德斯提出不减薪的32小时工作制、"机器人税"、工人董事席位和员工持股,使劳动者分享生产率收益并参与企业决策[45]。他还提出《美国AI主权财富基金法案》,拟对大型AI企业征收一次性50%的股权税,让公众获得投票权、董事会席位和分红[46]。桑德斯与AOC共同推动《AI数据中心暂停法案》,要求在建立劳动、环境和安全保障前暂停数据中心扩张,防止企业将电力和资源成本转嫁给社区[47]。二人的动员逻辑都要求资本承担成本、劳动者分享收益、公众参与决定AI的发展方向。
|
||||||
|
|
||||||
|
与此同时,这套针对"科技寡头"的叙事已不再局限于激进左翼,而是逐步进入民主党的全国性竞选话语。斯坦福大学政治经济学教授安德鲁·霍尔分析约28万封政治筹款邮件发现,2026年民主党实质讨论AI的邮件仍只占0.7%,但已是上年的三倍;在73封相关邮件中,63封把AI描述为威胁,其中26%将其与金钱、寡头和腐败联系起来,直接讨论就业和自动化的邮件占12%[48]。这种迹象表明,AI正在成为民主党重新讲述阶级冲突的新载体。
|
||||||
|
|
||||||
|
__右翼民粹则将AI纳入工作尊严、传统家庭与地方共同体对抗科技精英的叙事。__在这套叙事中,AI不是单纯提高效率的工具,而是由硅谷"科技男爵"主导的社会改造工程:企业获得利润和权力,却将失业、儿童安全风险以及电力和水资源成本留给工人、家庭和小城镇。工作也不只是收入来源,而是个人尊严、家庭责任和社会地位的基础,因而无法通过全民基本收入简单补偿。AI问题因而变成:究竟由科技精英按照利润逻辑塑造社会,还是由普通公民重新取得对技术及其社会影响的控制权[49]。
|
||||||
|
|
||||||
|
史蒂夫·班农和共和党参议员乔什·霍利分别代表了这种主张的激进与制度化版本。班农将大型AI企业视为威胁国家主权和普通公民的科技寡头,主张迫使其交出50%的股权并分配给美国公民,让公众直接分享AI收益[50]。霍利则把政治动员落实为就业、家庭和地方保护:要求企业披露因AI造成的裁员,提出《GRID法案》,要求数据中心自备电源、不得把扩网成本转嫁给居民;并通过《GUARD法案》追究诱导未成年人从事性行为或自残的AI企业责任[51]。
|
||||||
|
|
||||||
|
在反对科技寡头垄断AI权力与收益方面,左右翼正在形成罕见共识。地方层面,双方都要求数据中心承担电网、用水和社区成本;国家层面,双方都开始接受公众应当分享AI资本收益的原则。但这种共识尚未形成统一的政策联盟:左翼更希望通过税收、工会参与和公共持股改变所有权结构,右翼更强调保护就业、企业自担成本和地方否决权。
|
||||||
|
|
||||||
|
______2. 有限的补偿:建制派如何维持AI加速______
|
||||||
|
|
||||||
|
面对不断上升的政治压力,AI企业和建制派的主要回应并不是放慢技术部署,而是通过补偿重新取得AI扩张的社会许可。其基本思路是:继续维持美国在AI竞争中的领先地位,同时用就业保障、收益分享、最低限度的安全护栏、社区补偿降低技术革命的政治阻力。
|
||||||
|
|
||||||
|
第一类回应针对失业焦虑。AI企业和建制派并未主张放慢技术部署,而是试图通过缩短工时、扩大社会保障和创造公共服务岗位,降低自动化的转型成本。OpenAI在《智能时代的产业政策》中提出带有"新政"色彩的方案,包括推行不减薪的32小时工作制、设立类似贸易调整援助的"自动化调整援助计划",并在AI造成明显就业冲击时提供额外失业保障[52]。
|
||||||
|
|
||||||
|
Anthropic主张根据AI造成的失业程度建立分级响应机制:短期加强就业监测和失业保障,并通过资本账户、工资保险和培训补贴帮助劳动者转型;若AI导致大规模、长期失业,则转向对AI资本收益征税、设立公共财富基金和基本收入,让公众分享AI红利[53]。国会立法者则主张在不减缓美国AI发展的前提下,通过转型基金、再培训、失业保障、税收减免和针对性监管,补偿受冲击劳动者并帮助其适应就业转型[54]。
|
||||||
|
|
||||||
|
第二类回应是让公众分享AI企业的资本收益。与传统的税收转移和失业救济相比,AI企业和政府开始提出让公众直接分享AI资本收益。OpenAI建议建立公共财富基金,由政策制定者和AI公司共同为该基金提供种子资金,通过投资AI公司及广泛采用AI的企业,让每个公民都能获得AI经济增长的股份[55]。政府层面,有消息称特朗普政府正在探讨在AI企业上市前取得少数股权,并将投资收益用于公共支出或全民分红;韩国政府官员则直接要求科技企业与供应商和员工分享AI超额利润。
|
||||||
|
|
||||||
|
第三类回应针对公众对AI失控和企业自我监管的不信任。加利福尼亚、得克萨斯和犹他等州率先通过立法,要求企业披露安全措施,限制高风险应用,并加强对聊天机器人等直接面向公众产品的监管;国会中间派则主张建立前沿模型测试、安全事件报告和风险披露制度。尽管州政府和国会不断提出更严格的监管要求,联邦层面的政策重心仍是通过设置最低限度的安全护栏维持美国在全球AI竞争中的领先地位。联邦政府和AI企业更倾向于依靠自愿审查、行业标准和有限的信息披露,并反对各州分别制定严格规则,以免增加企业合规成本、拖慢技术部署。
|
||||||
|
|
||||||
|
第四类回应针对数据中心与地方社区的冲突。联邦政府主要通过自愿承诺和立法规范,要求AI企业自建或购买新增电力、承担电网改造费用,并公开水电消耗。地方政府开始使用禁建、征税和取消优惠等强制手段,防止企业将基础设施成本转嫁给居民[56]。企业方面则以技术改造和社区补偿争取项目落地。OpenAI承诺为数据中心配套电源和储能设施,微软利用电池调节用电时段[57]。这些回应背后的逻辑是,在继续推动数据中心建设的同时,将水电和基础设施成本纳入企业投资账本,以换取地方支持。
|
||||||
|
|
||||||
|
这些回应的局限,在于其合法性、可信度和制度安排存在内在矛盾。
|
||||||
|
|
||||||
|
首先,公共财富基金、缩短工时和社区补偿主要由企业和政策精英自上而下提出,劳动者与地方社区缺乏参与权,难以构成真正的社会契约[58]。
|
||||||
|
|
||||||
|
其次,这些措施大多以事后补偿换取AI继续扩张,一旦失业和资源冲突加剧,公众诉求可能转向限制部署、强制征税乃至拆分科技巨头。
|
||||||
|
|
||||||
|
再次,AI企业一边倡导财富共享,一边通过政治捐款和游说阻碍监管与问责,削弱了其承诺的可信度。
|
||||||
|
|
||||||
|
最后,政府若同时担任企业股东、产业扶持者和监管者,可能为了保护投资收益而放松安全、反垄断和劳动监管[59]。其根本问题是以有限让利换取AI扩张的"社会许可",却没有改变技术决策权高度集中的格局。
|
||||||
|
|
||||||
|
______3. 政治的临界点:对AI的政治反弹何时走向全国选举______
|
||||||
|
|
||||||
|
目前,美国社会对AI的焦虑正迅速转化为政治议题,但尚未引发全国性的惩罚性反扑。最接近这一临界点的是数据中心问题。就业变化难以与经济周期和一般产业调整区分开,但数据中心造成的电费上涨、用水压力、土地占用和噪声污染,不仅直接影响特定社区,也有明确的责任方。在2026年美国的中期选举初选阶段,暂停数据中心项目、取消税收优惠和要求企业自建能源供应,已经成为跨党派地方候选人争取选票、回应生活成本危机的筹码。
|
||||||
|
|
||||||
|
对AI的政治反弹能否上升为全国性大选议题,关键在于就业冲击是否显著、责任对象是否清晰,以及政治人物能否将二者整合为具有动员力的政治叙事。安德鲁·霍尔提出,如果失业率因AI上升两个百分点,并形成"AI应对此负责"的清晰公共叙事,真正的民粹反弹就可能开始[60]。
|
||||||
|
|
||||||
|
图3: 美国选民所认为的关键议题变化
|
||||||
|
|
||||||
|
[图片]
|
||||||
|
|
||||||
|
来源:Blue Rose Research[61]
|
||||||
|
|
||||||
|
政治反弹的扩大也会对AI产业造成影响。地方政府对数据中心的否决增多会延长项目周期,提高前期协调和环境审查成本;企业自担电网、水资源和社区补偿,则会削弱算力投资的预期回报。此后,数据中心可能进一步向电力充足、监管宽松的州转移,部分算力投资也可能转向海外。
|
||||||
|
|
||||||
|
政治压力还可能从基础设施成本进一步延伸至利润和控制权。股权税、自动化税和公共持股方案即使尚未落地,也会增加企业对未来利润分配和控制权变化的预期,届时,政治风险和社会摩擦将变成资本开支、融资和估值模型中的长期成本。
|
||||||
|
|
||||||
|
更严格的模型安全和应用监管也会增加企业的合规成本。若前沿模型被要求接受强制测试、风险披露和事故报告,产品发布和迭代周期将被拉长;各州监管规则若继续分化,还会提高全国性部署的难度,并使行业资源进一步向有能力承担合规成本的大型企业集中。
|
||||||
|
|
||||||
|
历史经验表明,对技术的政治反弹通常不会阻止技术进步,却会迫使社会重新调整技术红利的分配方式和发展规则。因此,对AI的政治反弹最可能带来的变化,是终结AI产业不计社会成本的扩张模式。2026年美国中期选举将检验地方层面的资源冲突能否转化为选票,2028年大选的关键则在于,就业冲击能否与反"科技寡头"的政治叙事汇合。一旦二者形成合力,下一次大选争论的就不只是应以多快的速度发展AI,还将涉及谁有权控制与监管AI、谁能够分享其收益,以及需要围绕AI建立怎样的新社会契约。
|
||||||
|
|
||||||
|
[图片]
|
||||||
|
|
||||||
|
参考来源(向上滑动阅览)
|
||||||
|
|
||||||
|
[1] Frey, C. B. (2019). The technology trap: Capital, labor, and power in the age of automation.
|
||||||
|
|
||||||
|
[2] Allen, R. C. (2009). Engels' pause: Technical change, capital accumulation, and inequality in the British industrial revolution. Explorations in Economic History, *46*(4), 418-435. https://www.sciencedirect.com/science/article/pii/S0014498309000199
|
||||||
|
|
||||||
|
[3] 编者注:"卢德运动"得名于英国织袜工学徒内德·卢德。据说,他因受到雇主斥责而砸毁了一台织袜机。19世纪初,反对机器替代劳动的工人以他的名字作为象征,自称"卢德将军"的追随者,因此这场以破坏机器为主要形式的工人抗议被称为"卢德运动"。
|
||||||
|
|
||||||
|
[4] Eichengreen, B., Haines, M. R., Jaremski, M. S., & Leblang, D. (2017). Populists at the polls: economic factors in the 1896 presidential election (No. w23932). National Bureau of Economic Research. https://www.nber.org/system/files/working_papers/w23932/w23932.pdf
|
||||||
|
|
||||||
|
[5] R. J. Gordon, 2016, The Rise and Fall of American Growth: The U.S. Standard of Living since the Civil War
|
||||||
|
|
||||||
|
[6] Autor, D. H., & Dorn, D. (2013). The growth of low-skill service jobs and the polarization of the US labor market. American economic review, *103*(5), 1553-1597. https://www.aeaweb.org/articles?id=10.1257/aer.103.5.1553
|
||||||
|
|
||||||
|
[7] Autor, D., Dorn, D., & Hanson, G. H. (2021). On the persistence of the China shock (No. w29401). National Bureau of Economic Research. https://www.nber.org/papers/w29401
|
||||||
|
|
||||||
|
[8] Gidron, N., & Hall, P. A. (2017). The politics of social status: Economic and cultural roots of the populist right. The British journal of sociology, *68*, S57-S84. https://onlinelibrary.wiley.com/doi/abs/10.1111/1468-4446.12319
|
||||||
|
|
||||||
|
[9] Frey, C. B., Berger, T., & Chen, C. (2018). Political machinery: did robots swing the 2016 US presidential election?. Oxford Review of Economic Policy, *34*(3), 418-442. https://academic.oup.com/oxrep/article/34/3/418/5047377
|
||||||
|
|
||||||
|
[10] https://gwern.net/doc/economics/automation/2026-blueroseresearch.pdf
|
||||||
|
|
||||||
|
[11] https://www.nytimes.com/2026/04/30/opinion/ai-labor-work-force-silicon-valley.html
|
||||||
|
|
||||||
|
[12] https://iop.harvard.edu/youth-poll/51st-edition-fall-2025
|
||||||
|
|
||||||
|
[13] https://digitaleconomy.stanford.edu/publication/canaries-in-the-coal-mine-six-facts-about-the-recent-employment-effects-of-artificial-intelligence/
|
||||||
|
|
||||||
|
[14] https://www.reuters.com/world/us/hollywoods-videogame-performers-go-strike-over-ai-pay-concerns-2024-07-25/
|
||||||
|
|
||||||
|
[15] https://www.wsj.com/business/autos/the-fight-over-humanoid-robots-has-shut-down-a-car-factory-for-the-first-time-d45ac3e1
|
||||||
|
|
||||||
|
[16] https://www.reuters.com/business/world-at-work/uk-actors-vote-reject-digital-scans-ai-rights-push-echoing-hollywood-battles-2025-12-18/
|
||||||
|
|
||||||
|
[17] https://www.tagesschau.de/wirtschaft/synchronsprecher-netflix-ki-100.html
|
||||||
|
|
||||||
|
[18] https://www.reuters.com/sustainability/society-equity/meta-us-employees-organize-protest-against-mouse-tracking-tech-2026-05-12/
|
||||||
|
|
||||||
|
[19] https://techpolicy.press/tech-workers-are-fighting-against-silicon-valleys-ai-push
|
||||||
|
|
||||||
|
[20] https://www.reuters.com/business/world-at-work/samsung-global-ai-boom-spurred-looming-strike-deep-divisions-2026-05-15/
|
||||||
|
|
||||||
|
[21] https://www.sagaftra.org/sag-aftra-members-approve-2025-video-game-agreement
|
||||||
|
|
||||||
|
[22] https://www.reuters.com/world/meta-scales-back-ai-mouse-clicks-tool-citing-employee-concerns-2026-06-02/
|
||||||
|
|
||||||
|
[23] https://www.reuters.com/business/world-at-work/samsungs-unionised-workers-south-korea-approve-wage-deal-2026-05-27/
|
||||||
|
|
||||||
|
[24] https://www.pewresearch.org/internet/2026/06/17/americans-and-ai-2026-chatbots-smart-devices-and-views-on-impact/
|
||||||
|
|
||||||
|
[25] https://www.gallup.com/file/analytics/696014/Gallup-Bentley-University_Business-In-Society%20Survey_2025%20Report.pdf
|
||||||
|
|
||||||
|
[26] https://assets1.cbsnewsstatic.com/hub/hub/cms/prod_cms_alt/file/2026/05/22/7441f284-6319-4e0a-90e1-1a892e0451af/cbs_20260517_ai.pdf
|
||||||
|
|
||||||
|
[27] https://gwern.net/doc/economics/automation/2026-blueroseresearch.pdf
|
||||||
|
|
||||||
|
[28] https://www.reuters.com/technology/artificial-intelligence/authors-sue-anthropic-copyright-infringement-over-ai-training-2024-08-20/
|
||||||
|
|
||||||
|
[29] https://techcrunch.com/2026/07/14/google-faces-another-ai-training-lawsuit-from-major-publishers/
|
||||||
|
|
||||||
|
[30] https://www.politico.com/news/magazine/2026/07/26/ai-super-pac-operatives-profile-01008227
|
||||||
|
|
||||||
|
[31] https://techoversight.org/2026/04/15/coalition-letter-dem-ltf/
|
||||||
|
|
||||||
|
[32] https://campaignlegal.org/document/ai-industry-funded-super-pacs-unlawfully-evaded-transparency-rules-clc-alleges
|
||||||
|
|
||||||
|
[33] https://www.wired.com/story/us-law-enforcement-warns-of-anti-tech-extremism/
|
||||||
|
|
||||||
|
[34] https://www.reuters.com/world/us-judge-approves-anthropics-15-billion-settlement-copyright-lawsuit-2026-07-20/
|
||||||
|
|
||||||
|
[35] https://heatmap.news/politics/americans-oppose-data-centers-poll
|
||||||
|
|
||||||
|
[36] https://news.gallup.com/poll/709772/americans-oppose-data-centers-area.aspx
|
||||||
|
|
||||||
|
[37] https://www.njpp.org/publications/report/fools-gold-the-hidden-costs-of-ai-data-centers-for-new-jersey/
|
||||||
|
|
||||||
|
[38] https://stpp.fordschool.umich.edu/sites/stpp/files/2025-07/stpp-data-centers-2025.pdf
|
||||||
|
|
||||||
|
[39] https://news.harvard.edu/gazette/story/2026/04/why-are-communities-pushing-back-against-data-centers/
|
||||||
|
|
||||||
|
[40] https://www.reuters.com/business/retail-consumer/us-data-center-protests-go-national-backlash-grows-2026-07-18/
|
||||||
|
|
||||||
|
[41] https://www.datacenterwatch.org/q1-2026
|
||||||
|
|
||||||
|
[42] https://www.reuters.com/sustainability/new-york-issues-moratorium-data-centers-2026-07-16/
|
||||||
|
|
||||||
|
[43] https://www.axios.com/local/chicago/2026/06/09/gov-pritzker-slows-down-data-center-development
|
||||||
|
|
||||||
|
[44] https://www.theguardian.com/uk-news/2026/jul/07/scotland-could-freeze-datacentre-projects-in-challenge-to-uks-ai-strategy
|
||||||
|
|
||||||
|
[45] https://www.sanders.senate.gov/op-eds/ai-must-benefit-everyone-not-just-a-handful-of-billionaires/
|
||||||
|
|
||||||
|
[46] https://www.sanders.senate.gov/wp-content/uploads/AmericanAISovereignWealthFundActSummary.pdf
|
||||||
|
|
||||||
|
[47] https://www.sanders.senate.gov/press-releases/news-sanders-ocasio-cortez-announce-ai-data-center-moratorium-act/
|
||||||
|
|
||||||
|
[48] https://freesystems.substack.com/p/ai-is-the-democratic-partys-next
|
||||||
|
|
||||||
|
[49] https://www.politico.com/news/2026/06/13/republicans-ai-josh-hawley-tech-republicans-artificial-intelligence-00961315
|
||||||
|
|
||||||
|
[50] https://www.notus.org/technology/trump-ai-stake-openai
|
||||||
|
|
||||||
|
[51] https://www.hawley.senate.gov/hawley-op-ed-ai-will-control-us-if-we-do-not-control-it/
|
||||||
|
|
||||||
|
[52] https://openai.com/index/industrial-policy-for-the-intelligence-age/
|
||||||
|
|
||||||
|
[53] https://www-cdn.anthropic.com/files/4zrzovbb/website/9ea607a5d67c168093829b701f3a0a6d21156d5.pdf
|
||||||
|
|
||||||
|
[54] https://www.axios.com/2026/07/21/mark-warner-ai-plan
|
||||||
|
|
||||||
|
[55] https://openai.com/index/industrial-policy-for-the-intelligence-age/
|
||||||
|
|
||||||
|
[56] https://www.businessinsider.com/data-center-developers-anxious-after-hochuls-construction-pause-2026-7
|
||||||
|
|
||||||
|
[57] https://www.economist.com/business/2026/06/23/americas-data-centre-backlash-puts-the-ai-boom-at-risk
|
||||||
|
|
||||||
|
[58] https://freesystems.substack.com/p/the-politics-of-jobless-prosperity
|
||||||
|
|
||||||
|
[59] https://www.project-syndicate.org/commentary/dangers-of-governments-taking-stakes-in-ai-firms-by-gabriela-ramos-and-emilija-stojmenova-duh-2026-07
|
||||||
|
|
||||||
|
[60] https://freesystems.substack.com/p/the-politics-of-jobless-prosperity
|
||||||
|
|
||||||
|
[61] https://data.blueroseresearch.org/hubfs/3.16.26%20Odd%20Lots%20AI%20Presentation.pdf
|
||||||
|
|
||||||
|
__下载CF40 APP 解锁更多精彩内容__
|
||||||
|
|
||||||
|
[图片]
|
||||||
|
|
||||||
|
__版面编辑:思琦__|__责任编辑:思琦__
|
||||||
|
|
||||||
|
__撰文:沙静__
|
||||||
|
|
||||||
|
视觉:李盼 东子
|
||||||
|
|
||||||
|
监制:李俊虎 潘潘
|
||||||
@@ -0,0 +1,84 @@
|
|||||||
|
# 📊 文章摘要:美国镜鉴:当AI浪潮遭遇政治反弹
|
||||||
|
|
||||||
|
> **原文**:[2026-07-28_美国镜鉴_当AI浪潮遭遇政治反弹.md](./2026-07-28_美国镜鉴_当AI浪潮遭遇政治反弹.md)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/OLxrS_jzJqz0z6bKIJMsfA
|
||||||
|
> **来源**:微信公众平台
|
||||||
|
> **作者**:CF40研究部
|
||||||
|
> **发布日期**:2026-07-28
|
||||||
|
> **摘要日期**:2026-08-06
|
||||||
|
> **价值评级**:⭐⭐⭐ 高
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 核心命题
|
||||||
|
|
||||||
|
> **政治反弹三战线** — 对 AI 的反抗正沿劳动保护、科技巨头权力、地方资源冲突三条战线从社会情绪走向选举政治,最可能的结局是终结 AI 不计社会成本的扩张模式
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 文章概要
|
||||||
|
|
||||||
|
本文从历史镜鉴出发(工业革命"恩格斯暂停"与卢德运动→铁路时代反垄断→计算机革命就业极化与民粹选举),提出一个完整分析框架:公众对技术的态度由收益分配而非技术本身决定,对 AI 的政治反弹正在三条战线上积蓄——劳动者争夺部署协商权、数据权与补偿分享权,公众质疑科技巨头对数据与规则制定权的垄断,地方社区反对数据中心转嫁电力水资源成本。左右翼民粹正把分散不满整合为"科技寡头获利、普通人买单"的叙事,而建制派以"有限让利换取扩张的社会许可"回应,存在内在矛盾。其价值在于用 61 条参考文献的系统实证,勾勒出 AI 产业面临的政治风险传导链;局限是美国中心视角,数据截至 2026 年中,历史类比不可直接外推至中国。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 关键要点
|
||||||
|
|
||||||
|
1. **政治反弹三条战线** — 劳动保护(岗位/技能/补偿)、科技巨头权力(数据产权/规则制定权)、地方资源冲突(数据中心电水土地成本),尚未形成统一运动,但可能共同转化为对科技巨头与分配制度的不满 `[分类: 范式突破]`(作者搭建的分析框架)
|
||||||
|
2. **历史规律:替代型 vs 赋能型技术** — 卡尔·弗雷区分:赋能型技术提高生产率易被接受,替代型技术导致技能贬值易引发抵制;反弹对象随技术形态演变:机器→垄断企业→选举政治 `[分类: 共识]`
|
||||||
|
3. **白领"新卢德主义"** — 生成式 AI 直接冲击认知任务,抗议蔓延至白领、创意劳动者与青年;斯坦福数据显示高 AI 暴露职业中 22-25 岁早期职业者就业相对下降 16%,但宏观就业尚未全面收缩——担忧先行于冲击 `[分类: 争议]`
|
||||||
|
4. **数据中心是反弹最清晰的焦点** — 收益归企业、成本归社区(电价上涨 20-25%、就业仅 20-50 人/站);2026 年 Q1 至少 75 个约 1300 亿美元项目因地方反对被取消或延期,成为少数跨党派议题 `[分类: 共识]`
|
||||||
|
5. **左右翼民粹罕见合流** — 共同塑造"科技寡头"叙事,但政策路径不同:左翼(桑德斯/AOC)主张 50% 股权税、机器人税、公共持股;右翼(班农/霍利)强调就业、家庭保护与地方否决权 `[分类: 争议]`
|
||||||
|
6. **建制派四类补偿回应及其内在矛盾** — 工时缩短与转型援助、收益分享(公共财富基金/政府持股)、安全护栏、社区成本分担;但自上而下缺乏参与权、以事后补偿换扩张、企业一边倡导共享一边游说阻碍监管、政府身兼股东与监管者角色冲突 `[分类: 范式突破]`
|
||||||
|
7. **政治临界点条件** — 就业冲击显著 + 责任对象清晰 + 政治叙事整合;安德鲁·霍尔:若失业率因 AI 上升两个百分点并形成"AI 应负责"的公共叙事,真正的民粹反弹可能开始 `[分类: 未探索]`(作者列为 2026 中期选举与 2028 大选的观察变量)
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 批判性分析
|
||||||
|
|
||||||
|
### 假设前提
|
||||||
|
|
||||||
|
作者立论建立在三个假设上:一是"收益与成本分配决定技术接受度"的历史规律在 AI 时代仍然成立;二是美国选举政治是利益冲突的主要出口;三是数据中心资源冲突具有代表性问题性。若 AI 就业冲击在宏观层面长期不显现、或福利制度缓冲强于预期,传导链可能放缓——作者自己也承认"AI 尚未造成全面的宏观就业冲击",民众悲观情绪是提前形成的。
|
||||||
|
|
||||||
|
### 论据与逻辑
|
||||||
|
|
||||||
|
论据充分且多源交叉(61 条参考文献,含斯坦福、皮尤、盖洛普、哈佛民调与一手新闻),并刻意区分"担忧数据"与"实际冲击数据",逻辑链条从历史→三条战线→民粹动员→建制派回应→临界点完整连贯。个别数字依赖第三方统计口径(如 1300 亿美元项目取消来自 Data Center Watch),且"机器人使用多的地区特朗普支持率更高"这类相关关系不能直接证明因果。
|
||||||
|
|
||||||
|
### 边界与局限
|
||||||
|
|
||||||
|
全文为美国中心视角,欧洲仅零星提及(苏格兰动议),对中国无直接适用性——中国的技术-社会关系、制度出口与分配机制均不同。预测性论断(2026 中期选举、2028 大选)需时间检验;"AI 应负责"的归因在统计上仍有争议(难以与一般产业调整区分,作者在数据中心一节也承认这一点)。历史类比(卢德运动等)的机制相似性不等于强度可比性——AI 的政治反弹目前尚无破坏机器式的暴力主体。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 可引用金句
|
||||||
|
|
||||||
|
> "当前唯一比AI产业增长更快的,可能就是美国人对AI的负面情绪。"(转引《华尔街日报》评语)
|
||||||
|
|
||||||
|
> "对AI的政治反弹最可能带来的变化,是终结AI产业不计社会成本的扩张模式。"
|
||||||
|
|
||||||
|
> "社会焦虑只有被政治力量转化为明确的利益冲突,才会形成真正的政治反弹。"
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 总体评价
|
||||||
|
|
||||||
|
**亮点**:
|
||||||
|
- 把零散的社会事件(罢工、诉讼、数据中心抗议、政治捐款)组织进"三战线+民粹整合+建制派回应"的完整分析框架,结构性和解释力强
|
||||||
|
- 实证扎实,数据多源交叉且区分"担忧"与"冲击",避免简单化的技术悲观或乐观叙事
|
||||||
|
- 对建制派补偿逻辑内在矛盾的剖析(有限让利不改变权力集中格局)是全文最锐利的洞见
|
||||||
|
- 给出了可检验的临界点条件(失业率 +2 个百分点等),为后续追踪提供抓手
|
||||||
|
|
||||||
|
**不足**:
|
||||||
|
- 文章较长、引用密集,核心框架淹没在大量案例中,读感偏重
|
||||||
|
- 对美国内部不同数据来源的口径冲突(如不同民调支持率)未加讨论
|
||||||
|
- 对"政治反弹是否真的会改变 AI 发展速度"这一关键问题,结论偏谨慎宏观,缺乏产业侧推演细节
|
||||||
|
|
||||||
|
**适用场景**:关注 AI 产业政策风险的研究者、AI 出海或海外业务布局的企业决策者、需要理解"技术-社会-政治"互动的产品与技术管理者。
|
||||||
|
|
||||||
|
**关联建议**:可对照阅读作者引用的卡尔·弗雷《The Technology Trap》与 Autor/Dorn 的就业极化研究原著;跟踪 2026 年 11 月美国中期选举与 Data Center Watch 的项目延期数据验证文中假设;对国内读者可延伸思考中国语境下 AI 就业与基础设施成本的分配问题。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 配图
|
||||||
|
|
||||||
|

|
||||||
@@ -0,0 +1,198 @@
|
|||||||
|
# 2026CSDI:AGI前夜,属于懂Agent、更懂模型的长期深耕企业
|
||||||
|
|
||||||
|
> **来源**:微信公众平台(CSDIsummit)
|
||||||
|
> **作者**:CSDIsummit
|
||||||
|
> **发布日期**:2026-08-20(原文未标注明确日期,按下载日占位)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/oNIIz2OmoV7Mk1zo87cBjA
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
|
||||||
|
|
||||||
|
WAIC 2026上,大模型与生成式AI赛道共有130家参展主体,其中83家将AI Agent或智能应用作为主要标签,基础大模型企业仅剩18家。模型发布少了,Agent演示多了。行业讨论的焦点也从"模型有多聪明"转向"究竟能创造多少真实价值"。AI竞争的基本单位,正在从"一个模型"变成"一套体系"。
|
||||||
|
|
||||||
|
**01 从模型到体系:AGI组织目标与AI核心发展要素**
|
||||||
|
|
||||||
|
2026年,全球人工智能产业正站在一个微妙而关键的路口。模型能力持续突破、智能体加速落地实体场景、企业AI战略从分散探索走向系统整合。与此同时,关于AGI(通用人工智能)的讨论,也正从"能不能实现"转向"如何实现"——以及更关键的是,"什么样的组织才能实现"。
|
||||||
|
|
||||||
|
对于当前的研发组织而言,这不再是一道选择题,而是一道生存题。
|
||||||
|
|
||||||
|
**AGI作为组织目标:从愿景共识到战略锚点**
|
||||||
|
|
||||||
|
AGI不是简单的问答工具,而是能够理解复杂目标、拆解任务、调用工具、持续学习,并在科研、工程、金融、制造和社会治理中承担高阶工作的智能系统。OpenAI、Anthropic、Google DeepMind等全球AI领导企业均将其视为AI发展的终极目标。
|
||||||
|
|
||||||
|
然而,2026年最显著的变化在于:AGI不再只是少数前沿实验室的"诗与远方",它正在成为越来越多研发组织的核心战略锚点。
|
||||||
|
|
||||||
|
今年7月,DeepSeek创始人梁文锋在长达四小时的闭门交流中,系统阐述了公司的AGI路线图:一个六阶梯的递进结构:语言模型→思维链(CoT)→Agent→持续学习→自我迭代(奇点)→具身智能。梁文锋强调:"Agent要用到CoT,然后CoT也要用到前面的阶梯,所以它并没有一步是白走的。"
|
||||||
|
|
||||||
|
这些信号揭示了一个共识:AGI不是一蹴而就的跳跃,而是一条必须步步为营的技术演进路径。
|
||||||
|
|
||||||
|
更重要的是,AGI正在成为组织决策的"第一性原理"。DeepSeek属于典型的愿景驱动型组织——组织运转、技术取舍、商业决策,均围绕AGI研发共识推进,依靠长期目标凝聚核心研发人才。唐杰同样指出,本轮人工智能变革的核心本质不是一次产品创新或商业模式创新,而是技术革命本身抬高了"智能上界";谁能率先将该上界向上推升一寸,谁就能重新定义千行百业的能力边界。
|
||||||
|
|
||||||
|
**AI核心发展要素:从"三驾马车"到系统算力**
|
||||||
|
|
||||||
|
如果说AGI定义了"去哪里",那么算力、数据、算法、人才与组织架构则共同决定了"能走多远"。
|
||||||
|
|
||||||
|
**算力:从单卡竞赛到系统竞赛**
|
||||||
|
|
||||||
|
算力是支撑人工智能持续演进的基础底座和关键引擎。工信部数据显示,截至2026年6月底,我国智能算力规模已达2185 EFLOPS。但算力的竞争逻辑正在发生根本性变化。
|
||||||
|
|
||||||
|
过去谈算力,大家总追问单颗芯片的水平如何。但大模型训练和推理不是单卡比赛——互联、内存共享和任务调度决定了大规模集群能否形成有效算力。AI算力需求的重心正从训练转向推理,存储、先进制程和先进封装产能层层吃紧。揭示了:**算力提供底座,模型提供智能**,**Agent负责执行**,**终端和机器人进入真实场景**——**AI竞争的基本单位,正在从"一个模型"变成"一套体系"。**
|
||||||
|
|
||||||
|
**数据:从"管好"到"用好"**
|
||||||
|
|
||||||
|
数据是人工智能的关键"燃料"。2025年,我国用于人工智能训练和推理的数据总量为199.48艾字节,同比增长42.86%,推理数据量首次超过训练数据量。截至今年6月底,全国已建成行业高质量数据集总体量超1565拍字节。
|
||||||
|
|
||||||
|
但数据的价值不在于"多",而在于"活"。国家数据局局长刘烈宏指出,数据合作的话题正从"管好数据"迈向"用好数据"。对于研发组织而言,打通产业链数据壁垒、推动数据归集与共享治理,才能让AI精准扎根产业场景。
|
||||||
|
|
||||||
|
**算法:从微创新到底层突破"**
|
||||||
|
|
||||||
|
算法领域,我国已达到国际先进水平。但真正的挑战在于:未来大模型企业的竞争着力点,不能仅仅停留在现有技术框架的微创新,而是要在模型的认知能力、推理能力、世界知识的整合能力上实现底层突破。
|
||||||
|
|
||||||
|
2026年,行业共识正从语言模型转向能理解物理规律的多模态世界模型。"长程任务"能力--让AI从"即时问答"走向"宏大工程",将宏大目标自主拆解为数千个可执行子任务---正是算法突破的前沿方向。
|
||||||
|
|
||||||
|
**人才:最稀缺的资源**
|
||||||
|
|
||||||
|
再强的算力、再多的数据,最终要靠人来驾驭。数据显示,高性能计算工程师的人才供需比低至0.15---每1个合格求职者面临7家公司的争夺。AI科学家以平均月薪13.2万元断层领先。
|
||||||
|
|
||||||
|
但人才竞争已不只是"抢人"那么简单。全球顶尖AI研究人员中,中国籍专家占比高达47%。如何留住人才、激发人才的创造力,考验的是组织的制度与文化。DeepSeek的做法是用AGI的长期目标凝聚核心研发人才;
|
||||||
|
|
||||||
|
组织架构:从"赛马"到"合兵"。
|
||||||
|
|
||||||
|
2026年最值得关注的趋势之一,还有AI研发组织架构的系统性重构。
|
||||||
|
|
||||||
|
过去两年,互联网大厂奉行内部赛马,多条AI产品线分头试错、持续消耗算力与人力。但2026年年中,巨头们集体按下整合键——字节将飞书产品团队并入豆包,阿里整合多条Agent产品线推出千问办公,腾讯收敛研发资源。
|
||||||
|
|
||||||
|
这并非中国独有。亚马逊关停了AGI Lab研究团队,将AGI部门、自研芯片团队、量子计算团队合并为统一组织,打通从基础设施到模型研发的全链路。Google DeepMind实施组织架构调整,优化科研与运营分工,集中资源推进AGI技术攻关。
|
||||||
|
|
||||||
|
这些调整折射出一个深刻判断:AI竞争的核心,从单点技术突破转向基础模型能力。一个领先的模型需要同时具备算法、数据、算力、训练、工程、产品反馈等多维能力——这种能力提升不再依赖某一个实验室,而依赖整个组织形成高速循环。
|
||||||
|
|
||||||
|
**从"获得智能"到"组织智能"**
|
||||||
|
|
||||||
|
AI产业正在从"获得智能"进入"组织智能"的阶段。模型仍然决定AI能力的上限,但单靠一个领先模型,已经越来越难构成完整的产业优势。
|
||||||
|
|
||||||
|
对于今天的研发组织而言,AGI不是一句口号,而是一套需要系统性构建的能力体系——它要求组织在算力、数据、算法、人才和架构上同步进化,要求决策者有足够的战略定力在短期变现与长期突破之间做出选择,也要求每一个参与者理解:通往AGI的路,不能跳步。
|
||||||
|
|
||||||
|
正如DeepSeek那张招聘海报上所写的——当今人类正处于AGI的前夜。但"前夜"不等于"黎明"。能够穿越这个长夜的组织,注定是那些既有清晰目标、又能扎实构建核心发展要素的长期主义者。
|
||||||
|
|
||||||
|
**02 为什么Agent终将回归模型核心,预训练为天花板**
|
||||||
|
|
||||||
|
2026年,AI行业最清晰的一条主线,无疑是Agent从"会聊天"到"能干活"的全面跃迁。基础模型综合水平已从20多分跃升至七八十分,长程任务稳定执行时间每8个月翻一番,最高纪录已达16小时。Agent不再"问一句答一句",而是在每一步自主完成"观察→思考→行动"的闭环,让大模型作为推理中枢,自主拆解任务、调用工具、评估结果。
|
||||||
|
|
||||||
|
WAIC 2026上,大模型与生成式AI赛道共有130家参展主体,其中83家将AI Agent或智能应用作为主要标签,基础大模型企业仅剩18家。模型发布少了,Agent演示多了。行业讨论的焦点也从"模型有多聪明"转向"究竟能创造多少真实价值"。
|
||||||
|
|
||||||
|
然而,Agent热潮之下,一个更深层的技术命题正在浮现:Agent的能力上限,本质上由预训练大模型决定。
|
||||||
|
|
||||||
|
**预训练:不可绕过的"天花板"**
|
||||||
|
|
||||||
|
如果说预训练决定模型的天花板,**后训练就决定它能不能摸到天花板**。清华教授唐杰明确指出,预训练使得大模型已经掌握世界常识知识,并且具备简单推理能力——更多数据、更大参数和更饱和的计算,仍然是scaling基座模型最高效的办法。
|
||||||
|
|
||||||
|
这一判断并非孤例。行业正在形成共识:预训练大模型是大模型推理能力的天花板。无论后训练阶段的强化学习如何精调、Agent框架如何编排,模型的推理深度、知识广度和泛化能力,根本上受限于预训练阶段所注入的世界知识和基础认知能力。
|
||||||
|
|
||||||
|
蚂蚁百灵Ling & Ring 2.6的技术报告给出了精准概括:"大模型正在从聊天机器人变成智能体。这个转变听起来只是换了个用法,实际上把模型的优化目标彻底改写了——一个实用的Agent,必须同时推理得好。"而推理能力的根基,恰恰来自预训练。
|
||||||
|
|
||||||
|
腾讯云副总裁李强有一个精妙的比喻:"大模型是引擎,工程化链路是把引擎变成整车的工程。发动机决定上限,工程决定能不能跑、跑多远、跑多稳。"Agent框架、工具调用、记忆管理——所有这些工程化能力,都是在"发动机"之上构建的整车。发动机不行,整车再精致也跑不远。
|
||||||
|
|
||||||
|
**Agent的繁荣,不能掩盖对基座的依赖**
|
||||||
|
|
||||||
|
当前Agent的能力演进,正在验证一个核心命题:Agent能做多复杂的事,取决于基座模型能理解多深的世界。
|
||||||
|
|
||||||
|
上海AI Lab开源的Agents-A1模型,使用多领域、多任务的高质量长程轨迹数据进行训练,增强模型在长上下文条件下的理解、推理和指令遵循能力。研究团队没有选择"小模型+复杂编排"的取巧路径,而是回到预训练本身——用更好的数据、更优的训练策略,从根基上提升模型的Agent能力。
|
||||||
|
|
||||||
|
这些实践指向同一个方向:**Agent能力的竞争,最终是基座模型能力的竞争**。
|
||||||
|
|
||||||
|
**编排式Agent的局限与模型原生Agent的崛起**
|
||||||
|
|
||||||
|
当前Agent开发存在两条技术路线:一是编排式Agent,即通用大模型加上LangGraph、Dify等调度框架,通过工程化手段实现任务拆解与工具调用;二是模型原生Agent,在训练阶段直接内置规划、反思逻辑,连贯性强。
|
||||||
|
|
||||||
|
编排式Agent灵活易部署,但面临一个根本性困境:超长任务容易出现逻辑漂移。当任务链条拉长到数十步甚至上百步时,基座模型的推理能力不足会导致Agent"走着走着就偏了"。这不是编排框架能解决的问题——框架只能组织流程,不能提升模型的判断力。
|
||||||
|
|
||||||
|
更深刻的变化正在发生。随着模型快速迭代,企业投入大量工程资源搭建的Agent,可能在下一个模型版本发布后,就被模型新增的原生能力覆盖。这意味着,单纯依靠工程编排构建的Agent壁垒,正在被模型能力的持续进化不断瓦解。
|
||||||
|
|
||||||
|
行业正在从训练模型的时代走向训练智能体的时代,但"模型架构和训练数据当然还重要"——环境设计、基础设施、评估器只是进入了核心圈,并未取代模型本身的核心地位。
|
||||||
|
|
||||||
|
**回归模型核心:Agent的终局形态**
|
||||||
|
|
||||||
|
未来的Agent应用形态,**终将回归以模型为核心的结构**。这不是否定Agent工程的价值,而是对技术本质的清醒认知。
|
||||||
|
|
||||||
|
**发动机决定上限**,无论Agent框架如何演进、工具调用如何丰富、记忆系统如何复杂,Agent的推理能力、规划能力和世界理解能力,永远受限于其背后的基座模型。预训练大模型投入的数据规模、计算资源和架构创新,直接决定了Agent能够触及的智能高度。
|
||||||
|
|
||||||
|
这意味着,对于创造者和应用者而言,最值得投入的方向不是追逐Agent框架的短期热点,而是深入理解并持续投资于基座模型的能力建设。无论是模型的原生Agent能力训练,还是针对Agent场景的持续预训练,都比在表层做工程包装更具长期价值。
|
||||||
|
|
||||||
|
2026年,AI行业正在从"获得智能"走向"组织智能"。但无论组织形态如何变化,模型始终是智能的源头。Agent让模型进入环境、形成生产力,但模型才是那个"能思考的大脑"。没有Agent能力,大模型终将停留在理论学习阶段——反过来说,没有强大的预训练基座,Agent也将止步于浅层执行,无法触及真正的智能。
|
||||||
|
|
||||||
|
**03 从Copilot到Agentic:AI-Native转型下的编程新范式**
|
||||||
|
|
||||||
|
**软件开发也经历着一场自图形界面发明以来最为重大的范式转移。根据Gartner的定义,企业级AI编码智能体是能够感知上下文、将人类意图转化为多步骤计划、并在代码、测试和相关工程产物中执行和验证这些步骤的自主或半自主软件工程解决方案。从"AI辅助编程"到"Agentic编程"——AI不再是被动的代码补全插件,而是具备环境感知、自主规划、工具调用与自我纠错能力的独立开发者。**
|
||||||
|
|
||||||
|
**企业价值:从个人提效到组织级生产力**
|
||||||
|
|
||||||
|
Agentic编程对企业而言,绝不仅是"让工程师写代码更快一点"。它的真正价值在于重构整个软件生产体系。
|
||||||
|
|
||||||
|
Gartner预测,到2028年,异步AI编码智能体工作流将使软件工程团队的生产效率提升30%至50%,远超2025年AI代码助手0%到20%的提升。截至2026年4月,全球企业级AI代码智能体市场的年化规模已达98亿至110亿美元。Anthropic的报告进一步印证了这一趋势:80%的领导者表示智能体投资已带来可衡量的财务影响,88%的人期望未来会带来更多回报。
|
||||||
|
|
||||||
|
真正的企业级价值,来自组织级而非个人级的Agentic部署。2025年底到2026年初,Stripe、Ramp、Coinbase三家公司几乎同时公开了各自的内部Coding Agent——Minions、Inspect、Cloudbot。三家公司独立开发,最终却不约而同地收敛到几乎相同的架构上:Agent不再只是"一个人在终端里用",而是"整个团队通过Slack或GitHub Issue随时触发"。你需要沙箱隔离执行环境,需要让Agent在中断后能续上之前的工作,需要防止一个用户的失控循环烧光全公司的模型额度。
|
||||||
|
|
||||||
|
正如IDC所指出的:**真正拉开差距的,不是是否引入AI编码工具,而是企业是否具备平台工程、治理能力和开发者角色转型的整体规划**。那些仅在局部场景试点智能体的组织,将很难释放规模化价值;而**将Agentic AI作为企业级能力来建设的组织,更有可能在速度、质量和创新能力上形成长期优势。**
|
||||||
|
|
||||||
|
Delivery Hero推出的内部AI编程智能体Herogen,年编码能力相当于130名工程师。TCL实业软工中心与腾讯云CodeBuddy合作,CodeBuddy覆盖了其90%以上的研发工程师,贯穿从需求拆解、代码编写、测试修复到部署上线的全链路。正如TCL软工中心应用开发总监所言:"我都有点不敢相信,两天把整个功能交付了,开发模式真的被颠覆了。"
|
||||||
|
|
||||||
|
**模型技术:Agentic编程的底层驱动力**
|
||||||
|
|
||||||
|
Agentic编程能力的跃升,本质来自模型技术的持续突破。
|
||||||
|
|
||||||
|
OpenAI发布的GPT-5.3 Codex主打"代理式编码",可以像开发者一样自主判断并推进任务,覆盖代码编写、运行测试、修复错误、更新Jira工单、撰写技术文档以及管理部署流程。该模型在多语言软件工程评测SWE-bench Pro中得分56.8%。
|
||||||
|
|
||||||
|
Cohere发布的North Mini Code采用300亿参数MoE架构(每次仅激活30亿参数),专为智能体软件工程设计。亚马逊、美团等企业开源万亿参数大模型LongCat-2.0(总参数1.6万亿),为真实的Agentic Coding任务而生,架构上创新引入稀疏注意力和N-gram Embedding。Poolside开源Laguna S 2.1,1M超长上下文+118B MoE模型。
|
||||||
|
|
||||||
|
行业共识正在形成:**Coding Agent的智力,越来越体现为长程任务能力**。它不只是"智能"本身,而是智能×可靠性的乘积。单步推理再强,如果第20轮开始忘目标、第50轮开始乱改文件、第100轮无法解释自己做过什么,它就仍然不能被托付。
|
||||||
|
|
||||||
|
**业务架构:从"+AI"到"AI+"的全链路重构**
|
||||||
|
|
||||||
|
Agentic编程对业务架构的冲击,远比想象中更深刻。
|
||||||
|
|
||||||
|
传统的研发流程是"人写代码→测试→部署",AI只是附着在某个环节上的工具。而在AI-Native转型下,整条研发线被拖到大太阳底下重新审视——每个业务节点都要回答"为什么这步不能由AI来做?"。这正是TCL团队从"+AI"走向"AI+"的关键一步。
|
||||||
|
|
||||||
|
阿里云正式提出"Agent Native Cloud",让Agent成为云的一等公民——产品、API、计费、文档、官网全部围绕Agent重新设计。无问芯穹发布Agentic Infra"前店后厂一中心"战略。云的主要用户,开始从人变成Agent——阿里云透露,过去五年PostgreSQL累计创建约4万个实例,而最近几个月仅由Agent自主创建的数据库实例便达到12万,环比增长约300%。
|
||||||
|
|
||||||
|
秒悟团队版让用户通过自然语言生成网站、小程序、App,每天有上万名用户在上面创作和发布,大部分没有技术背景。Agent要做的不只是把网页做出来,还要把数据库搭起来、域名分配好、网站部署完——"Coding Agent更关注代码,而Delivery Agent更关注全局"。
|
||||||
|
|
||||||
|
**开发者:从"码农"到"智能体指挥官"**
|
||||||
|
|
||||||
|
范式转移最深刻的冲击,落在开发者身上。Anthropic的报告揭示了一个核心结论:**软件工程师的角色正从"代码编写者"转变为"智能体指挥官"。**做软件不再等于写代码——工程师越来越多地变成"编排智能体写代码"的角色:评估智能体的输出、提供战略方向、确保系统解决了正确的问题。
|
||||||
|
|
||||||
|
Claude Code负责人直言,"software engineer"这个职衔最快今年就会开始消失,转向更接近"builder"(构建者)的新角色。程序员的角色将从手动编写代码,转型为AI代理群的指挥官。"只会写代码"的程序员将逐渐被淘汰,而具备架构设计、战略决策能力的从业者将更具竞争力。
|
||||||
|
|
||||||
|
会用AI的前提,是你先得懂行。未来的开发者更像是系统编排者、架构设计者与决策者。他们不再逐行敲击代码,而是指挥多个AI代理协作完成开发,同时保留人类独有的判断力与对品质的"品味"。
|
||||||
|
|
||||||
|
**AI-Native时代的新规则**
|
||||||
|
|
||||||
|
AI-Native转型不是"给研发团队增加一个AI工具",而是重构软件生产方式。Agentic编程的崛起,意味着软件开发的核心瓶颈正在从"怎么写出来"变成"该写什么、为什么要写、如何验证写对了"。**软件开发正经历着自图形界面发明以来最为重大的范式转移,"人人都能成为开发者"的时代已然拉开帷幕。**
|
||||||
|
|
||||||
|
**为此,第十届2026CSDI 峰会,于深圳10月16-18日召开**
|
||||||
|
|
||||||
|
帮助IT与会者,共探Agentic AI数字代理世界
|
||||||
|
|
||||||
|
正值Agentic AI时代,对于科技企业运营来说,大模型能力需聚焦于创造性任务、战略规划、业务结合,软件研发的技术范式、大数据技术都向模型自主化驱动,大量的智能软件研发工具和框架应运而生。数据成为了智能软件研发的核心。AI产业也从"模型能力驱动"转向"算力组织与效率驱动",大量的数据+海量智能场景在AI可持续发展中起到关键作用。智算资源的需求与训练部署复杂的模型,开发者需要应用高性能的硬件(如GPU、TPU等)和分布式计算技术(如云计算、集群计算、数据库等)。这些技术应用仍然是IT组织探寻与研究的课题。
|
||||||
|
|
||||||
|
2026CSDI第十届届中国软件研发智能创新科技峰会,将以数智+智管为主旨,于深圳10月16-18日召开,携手100+国内外顶尖创新先锋,一起迎接"数智融合、决策智能"这一个企业确定性的长期趋势,推动AI走向自进化,拥抱Agentic AI 应用前沿自主探索实践。
|
||||||
|
|
||||||
|
**总结:AI是一次革命:AI Agent时代已然到来,要快、要应用闭环数据**
|
||||||
|
|
||||||
|
大模型已经成熟的演变为文理工三全的技术,同时具备了文科的创意、记忆力、知识,理科的逻辑思维、推理能力,还具备了工科解决问题的能力,融合将带来的,我们称它为AI Agent时代,当用户发号指令、表达意图,AI不但能理解指令,而且拆解、分解成为任务,将其完成。标志着AI定位从辅助工具向核心执行者的跨越。它既能定下组织战略、重构公司结构、AI也能辅助战略与降本增效,这是人工智能定性为人类史上最重要的革命。
|
||||||
|
|
||||||
|
AI不仅是技术变革,更是思维方式的重塑,未来大部队的工作会有Agent来做,正如OpenAI CEO 说到"以后会有一个人的独角兽",当我们拥有了一个超级员工(数字员工),将减少信息不对称、提升整体运营效率、秒级复制,专项Agent处理不同任务,可以国际的扩张,随着架构中Agent的增多,沟通的瓶颈将变少,推理成本也会变少,每个Agent也都有它独特的业务目标,企业未来的核心竞争力需尽早采用AI Agent、使用最聪明的AI Agent、并拥有自己的闭环数据来强化AI能力,拥抱自身领域使用AI工具,让企业抢占先机,技术杠杆将彻底打破传统的人力规模壁垒。
|
||||||
|
|
||||||
|
**第十届2026CSDI 即将开幕,诚邀各界IT英雄,引峥嵘**
|
||||||
|
|
||||||
|
扎实的专业+前瞻性的思考+优秀的实践,带给业界同仁们精彩视角、卓越思维。秉持科技向善理念,推动IT行业交流与传播。渴望追求卓越、才华横溢的同道中人,渴望在前沿AI领域有着丰富实践的嘉宾,加入我们,携手并肩,探寻知识革命的未来!
|
||||||
|
|
||||||
|
精彩瞬间
|
||||||
|
|
||||||
|
微软、阿里巴巴、小米、腾讯、华为、360、平安集团、渣打银行、工商银行、招商银行、随行付、易方达、长亮科技、南方电网、广州银联、穆迪信息、拍拍贷、宇信集团、投哪儿金融、天维信息、萨摩耶、华泰证券、招商证券、国信证券、陆金所、广发基金、中国银联、恒天软件、天阳宏业、中数通、电信规划设计院、oppo、步步高、vivo、爱立信、百富计算机、厦门航空、福建联迪、网易、星网视易、升腾科技、视睿电子、飞利浦、金山软件、金山游戏、欧特克、顺丰、深信服、欢聚时代、虎牙、珠海健康云、优视科技(UC)、52TT、天翼云、凯米网络、电信设计院、ADmaster、博思软件、网宿科技、珍爱网、金蝶、唯品会、中国联通、中国移动、传动数码、无限极、中电、珠海网博、中软、同盾科技、杭州顺网、蓝凌软件、长园深瑞、中南民航、远光软件、广联达、中国电信、传音、利通、物理研究所、国家电网等。
|
||||||
|
|
||||||
|
END
|
||||||
|
|
||||||
|
点击阅读原文,随时关注峰会,日程最新上线内容
|
||||||
|
|
||||||
|
作者提示:个人观点,仅供参考
|
||||||
@@ -0,0 +1,73 @@
|
|||||||
|
# 📊 文章摘要:2026CSDI:AGI前夜,属于懂Agent、更懂模型的长期深耕企业
|
||||||
|
|
||||||
|
> **原文**:[2026-08-20_2026CSDI_AGI前夜_属于懂Agent_更懂模型的长期深耕企业](./2026-08-20_2026CSDI_AGI前夜_属于懂Agent_更懂模型的长期深耕企业.md)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/oNIIz2OmoV7Mk1zo87cBjA
|
||||||
|
> **来源**:微信公众平台
|
||||||
|
> **作者**:CSDIsummit
|
||||||
|
> **发布日期**:2026-08-20
|
||||||
|
> **摘要日期**:2026-08-20
|
||||||
|
> **价值评级**:⭐⭐ 中
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 核心命题
|
||||||
|
|
||||||
|
> **预训练天花板** — Agent 能力的上限由预训练基座模型决定,Agent 竞争终将回归模型核心竞争;AI 竞争的基本单位正从"一个模型"变成"一套体系"。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 文章概要
|
||||||
|
|
||||||
|
这是一篇 CSDI 峰会(2026年10月深圳)的会前产业综述,汇编了 2026 年 AI 行业的三大叙事:其一,AGI 从前沿实验室愿景变为研发组织的战略锚点,算力/数据/算法/人才/组织架构五要素需同步进化,行业从"获得智能"进入"组织智能"阶段;其二(全文最有观点的部分),Agent 能力上限本质由预训练大模型决定,编排式 Agent 在超长任务中逻辑漂移、且工程壁垒会被模型原生能力迭代不断瓦解;其三,Agentic 编程引发软件生产范式转移,开发者角色转向"智能体指挥官"。文章价值在于密集的数据点与多源观点汇编,但属二次加工而非原创研究,且后半部分混入明显的大会营销内容。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 关键要点
|
||||||
|
|
||||||
|
1. **AI 竞争单位从"一个模型"变成"一套体系"** — WAIC 2026 上 130 家参展主体中 83 家主打 Agent、基础大模型企业仅剩 18 家;算力提供底座、模型提供智能、Agent 负责执行、终端进入真实场景。 `[分类: 共识]`
|
||||||
|
2. **预训练是 Agent 能力的天花板,后训练决定能否摸到天花板** — 引唐杰观点:预训练注入世界常识与简单推理,更多数据/更大参数/更饱和计算仍是 scaling 最高效办法;引用腾讯云李强"引擎与整车"比喻。 `[分类: 争议]`
|
||||||
|
3. **编排式 Agent 将被模型原生 Agent 瓦解** — 超长任务(数十至上百步)中编排式 Agent 逻辑漂移,框架只能组织流程不能提升模型判断力;企业重投入搭建的 Agent 可能被下一个模型版本的原生能力覆盖。 `[分类: 争议]`
|
||||||
|
4. **AGI 六阶梯路线图(DeepSeek 梁文锋)** — 语言模型→思维链(CoT)→Agent→持续学习→自我迭代(奇点)→具身智能,"并没有一步是白走的";愿景驱动型组织靠长期目标凝聚人才。 `[分类: 共识]`
|
||||||
|
5. **组织架构从"赛马"到"合兵"** — 字节并飞书入豆包、阿里推千问办公、腾讯收敛资源;亚马逊合并 AGI/自研芯片/量子团队,Google DeepMind 架构调整——领先模型需要全组织多维能力高速循环。 `[分类: 共识]`
|
||||||
|
6. **开发者从"码农"到"智能体指挥官"** — 引 Anthropic 报告与 Claude Code 负责人观点:"software engineer"职衔最快今年开始消失;Gartner 预测 2028 年异步 AI 编码智能体使团队效率提升 30%-50%。 `[分类: 共识]`
|
||||||
|
7. **云的主要用户开始从人变成 Agent** — 阿里云"Agent Native Cloud";过去五年 PostgreSQL 人工累计创建约 4 万实例,近几个月 Agent 自主创建达 12 万,环比增长约 300%。 `[分类: 共识]`
|
||||||
|
8. **人才结构性稀缺** — 高性能计算工程师供需比 0.15(1 名求职者对 7 家公司),AI 科学家平均月薪 13.2 万;全球顶尖 AI 研究人员中中国籍占 47%。 `[分类: 共识]`
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 批判性分析
|
||||||
|
|
||||||
|
### 假设前提
|
||||||
|
- "预训练天花板论"被表述为"行业正在形成共识",实为业内分歧点(工程派认为上下文工程、记忆、工具生态同样决定上限),文章选择性采信了模型派观点而未呈现对立证据。
|
||||||
|
- 默认 Agentic 编程的效率提升数据(Gartner 30%-50%、Anthropic 80%/88%)可直接映射到中国企业场景,未讨论本土交付环境的差异。
|
||||||
|
|
||||||
|
### 论据与逻辑
|
||||||
|
- 几乎全部论据为二手引用(梁文锋闭门交流、唐杰、李强、蚂蚁技术报告、Gartner/IDC/Anthropic 报告),无一处给出可核查来源链接。
|
||||||
|
- 关键图表均为失效 blob 链接;存在笔误("从微创新到底层突破""、"第十届届中国")和段落结构混乱("组织架构"小节格式脱离),显示编辑加工粗糙。
|
||||||
|
- 结尾从产业分析突变为峰会宣传("诚邀各界IT英雄"+超长企业名单),文章实质是会议营销长文,观点服务引流。
|
||||||
|
|
||||||
|
### 边界与局限
|
||||||
|
- 三个章节(组织体系/模型核心/Agentic 编程)间缺乏内在论证连接,更像是三个独立素材的拼接。
|
||||||
|
- "Agent 终将回归模型核心"是对 2026 年时点的强预测,未讨论反例(如长上下文、记忆系统、环境设计对上限的抬升作用)。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 可引用金句
|
||||||
|
|
||||||
|
> "大模型是引擎,工程化链路是把引擎变成整车的工程。发动机决定上限,工程决定能不能跑、跑多远、跑多稳。"(腾讯云副总裁李强,文中引述)
|
||||||
|
|
||||||
|
> "Agent 能做多复杂的事,取决于基座模型能理解多深的世界。"
|
||||||
|
|
||||||
|
> "AI竞争的基本单位,正在从'一个模型'变成'一套体系'。"
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 总体评价
|
||||||
|
|
||||||
|
**亮点**:数据点密集且新(WAIC 结构、算力 2185 EFLOPS、数据 199.48 EB、供需比 0.15、PostgreSQL 实例 300% 增长),适合作为 2026 年 AI 产业综述素材库;"编排式 vs 模型原生"之争的梳理清晰。
|
||||||
|
|
||||||
|
**不足**:无原创观点与可核查引用;"预训练天花板"单一立场遮蔽行业分歧;后半篇为峰会软广;编辑粗糙(错字、断链、结构混乱)。
|
||||||
|
|
||||||
|
**适用场景**:快速了解 2026 年中国 AI 产业叙事框架与数据口径;作为"模型派 vs 工程派"争论中模型派立场的代表性表述引用;峰会参会决策参考。
|
||||||
|
|
||||||
|
**关联建议**:与《评估 GitHub Copilot 智能体运行框架》(微软Reactor)形成正反对照——后者实证运行框架层(编排层)的 Token 效率价值,本文则断言编排壁垒终将被模型原生能力瓦解;两文合读可完整呈现"编排 vs 原生"争论双方论据。
|
||||||
@@ -0,0 +1,298 @@
|
|||||||
|
# 重磅!Graph Engineering 实操手册公开
|
||||||
|
|
||||||
|
> **来源**:微信公众平台(Datawhale)
|
||||||
|
> **作者**:Datawhale
|
||||||
|
> **发布日期**:2026-08-20(原文未标注明确日期,按下载日占位)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/GZrKCHJaG5g7Ua-ZiEP-fQ
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
Datawhale干货 **作者:Codez,X博主**
|
||||||
|
|
||||||
|
上个月我们才发过一篇 Loop Engineering 的实操手册,现在新词就已经来了。
|
||||||
|
|
||||||
|
7月初,OpenClaw 创始人,在 X 上说:我们还在聊 loop,还是已经切到 graph 了?没过多久,就有人跟帖喊出「Loop Engineering 已死,Graph Engineering 永生」。
|
||||||
|
|
||||||
|
|
||||||
|
|
||||||
|
所以 Graph Engineering 到底是什么?
|
||||||
|
|
||||||
|
我们把 Codez 总结的 14 步整理了出来,全网570w人看过,讲的就是怎么从一个人的 loop,走到一张能自己路由的 graph。
|
||||||
|
|
||||||
|
|
||||||
|
|
||||||
|
## 动手前:四个问题,决定你要不要 Graph Engineering
|
||||||
|
|
||||||
|
Graph 不是 loop 的升级版,是 loop 的组织方式。它烧的 token 比单个 loop 更多,协调开销也更高,出了问题你要 debug 的是一整张你没亲眼看着跑的路由图。所以先问自己四个问题,都想清楚之后,再动手。
|
||||||
|
|
||||||
|
一、这个任务真的能拆成不同角色吗?拆不出清晰的"谁负责什么",那就还是一个 loop,加节点只是加成本。
|
||||||
|
|
||||||
|
二、有没有真正能并行的子任务?没有独立并行的活,图比循环贵,却不比循环快。
|
||||||
|
|
||||||
|
三、单个 agent 的上下文装得下全部背景吗?装得下,就别急着拆,拆分是为了腾出上下文,不是为了好看。
|
||||||
|
|
||||||
|
四、失败之后,你负担得起跳转分支的成本吗?没想清楚重试耗尽后去哪,图会在你看不见的地方卡死或者乱跑。
|
||||||
|
|
||||||
|
还有个附加题,比上面四个都重要:**你已经有一个跑得稳的单体 loop 了吗?**没有,先别建图。图是循环的组织方式,不是循环的替代品。
|
||||||
|
|
||||||
|
谁适合上手
|
||||||
|
|
||||||
|
已经把至少一个 loop 跑稳的团队,任务里有明确能拆开的角色(调研、撰写、复核),也接受更高的 token 成本换质量和并行度。
|
||||||
|
|
||||||
|
谁不适合上手
|
||||||
|
|
||||||
|
还没让一个 loop 稳定跑起来的个人开发者、线性依赖强拆不开的任务、瓶颈在协调开销而不在单节点能力的团队。
|
||||||
|
|
||||||
|
所以,graph engineering 真有用,但大部分人现在还用不上,因为大部分人的 loop 都还没跑稳,更别提图。
|
||||||
|
|
||||||
|
先答完四个问题,再决定要不要建图
|
||||||
|
|
||||||
|
## Graph Engineering 的四个核心构件
|
||||||
|
|
||||||
|
一张能跑的图,拆开来看,就是四个能各自单独验证的部分。
|
||||||
|
|
||||||
|
**Nodes:图的最小单位。**一个节点就是一个跑着自己 loop 的 agent 或确定性步骤,只认一件事,也只对一件事负责。节点判断不出"完了",就不是节点,是隐藏依赖。
|
||||||
|
|
||||||
|
**Edges:决定谁接下一棒。**顺序边永远触发,条件边看检查结果,并行边一次分给多个节点,再汇到一个节点合并。边留给模型运行时判断得越多,图越灵活,但也越难预判。
|
||||||
|
|
||||||
|
**Shared State:大家都要读写的那份数据。**下游节点要用的字段,必须有上游节点写进去。这个对象会逼你承认,这活儿里到底还有多少环节没被真正想清楚。
|
||||||
|
|
||||||
|
**Failure Routing:失败之后的退路。**一个节点的重试耗尽了,控制权去哪:退回上一步、转给备用节点,还是转人工。没有失败边的图,只是一张流程图,不是一个能跑的系统。
|
||||||
|
|
||||||
|
## 第一步:先分清节点和边
|
||||||
|
|
||||||
|
01 节点是任务,边负责传数据
|
||||||
|
|
||||||
|
一张图其实只有两样东西,搞清楚这两样,大部分困惑就没了。节点是一个工作单元:一个 agent,一份边界明确的活,一个输入,一个输出。边是一种依赖关系:它表示这个节点的输出会喂给那个节点做输入,仅此而已。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
最容易犯的错,是把"然后"当成边。"总结这个文件,然后告诉我天气",这两步之间没有边,天气根本用不到那份总结。这其实是两个互不相干的节点,被一段线性脚本硬凑成了先后顺序。没真用上数据,就没有边。
|
||||||
|
|
||||||
|
02 你的线性脚本,其实是一张退化的图
|
||||||
|
|
||||||
|
当你把一个 agent 写成"先做 A,再做 B,再做 C,再做 D",其实你已经画出了一张图,只不过是一条不分岔的单链,每个节点都只有一条边进、一条边出。这样跑是能跑对的,但慢,也脆,因为一条链没有任何冗余:C 卡住了,D 就永远轮不到,A 的产出也被困在上游,没地方去。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
图工程的第一项真本事,是重新画这条链。拿着这个线性 agent,对每一根箭头问上一步的那个问题。大多数链里都有两三根箭头根本没有携带数据,它们只是当初写的时候顺手打的顺序。把这些箭头剪掉,链就会塌缩成更宽的东西:几个可以同时跑的独立节点,喂给一个需要它们全部到齐的节点。
|
||||||
|
|
||||||
|
## 第二步:给节点和边定契约
|
||||||
|
|
||||||
|
03 给每个节点定一份契约
|
||||||
|
|
||||||
|
一个你没法推理的节点,就没法拿去并行。解决办法是给它定一份契约:输入有边界,输出有边界,只干一件事。输入是节点要读的东西,必须显式传进去,不能指望它从共享窗口里蹭到什么。输出是一个定义好的形状,最好能校验,这样下一个节点不用猜也能直接用。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
在 workflow 里,这份契约靠 schema 强制执行。给 Claude 的 agent() 调用配一份 JSON schema,Claude 派出去的 subagent 就只能返回校验过的结构化数据,校验发生在工具调用这一层,格式不对 Claude 会自己重试,不会甩给你一堆自由文本让你自己解析、自己祈祷。这就是"能接进图里的节点"和"只有人读得懂才行的节点"的区别。
|
||||||
|
|
||||||
|
```javascript
|
||||||
|
// 一个有真契约的节点:输入有边界,输出经过校验,只干一件事
|
||||||
|
const ITEM = {
|
||||||
|
type: 'object', additionalProperties: false,
|
||||||
|
properties: {
|
||||||
|
title: { type: 'string' },
|
||||||
|
url: { type: 'string' },
|
||||||
|
impact: { type: 'string', enum: ['high', 'medium', 'low'] },
|
||||||
|
},
|
||||||
|
required: ['title', 'url', 'impact'],
|
||||||
|
};
|
||||||
|
const result = await agent(source.prompt, {
|
||||||
|
label: `research:${source.key}`,
|
||||||
|
schema: ITEM, // 强制返回校验过的结构化数据
|
||||||
|
agentType: 'general-purpose',
|
||||||
|
});
|
||||||
|
// result 现在是下一个节点能信任的形状,不用再靠人工解析
|
||||||
|
```
|
||||||
|
|
||||||
|
04 把边也当成一份数据契约
|
||||||
|
|
||||||
|
边不只是"B 排在 A 后面",它是一个关于"传的是什么"的承诺:A 产出这个形状,B 就是照着这个形状设计来消费它的。按数据给边命名,而不是按顺序命名,两件事会立刻变简单:能一眼看出这条边是不是真的存在(有没有数据真的传过去),也能在形状不变的前提下换掉边两端的节点,不会弄坏整张图。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
实际写的时候,边就活在普通的 JavaScript 里。派活和合成之间那一步归约,压平、去重、过滤,就是代码在处理节点返回的形状,不需要 agent。图思维一个不太起眼但很重要的收获是:很多人花模型 token 去做的事,其实就是一条边,而边是免费的。
|
||||||
|
|
||||||
|
## 第三步:构建扇出、扇入与菱形:最常用的拓扑
|
||||||
|
|
||||||
|
05 用 parallel() 扇出:把活儿一次性派出去
|
||||||
|
|
||||||
|
这一步能把前面的投入都赚回来。手上有 N 个独立节点,N 个要核实的信源、N 个要审的文件、N 条要查的路由,不要把它们串起来跑,让 Claude 把它们一次性派出去一起跑。在 workflow 里对应的是 parallel():Claude 拿到一个函数数组,给每个函数派一个 subagent,全部并发执行,最后把结果数组一次性还给你。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
有两个细节决定它稳不稳。第一,parallel() 是一道屏障,会等所有函数都跑完才返回,下一阶段看到的是完整的结果集合。第二,一个抛错的函数会被解析成 null,而不是拖垮整个批次,一个状态不好的 agent 也拖累不了其他人,记得对结果做 .filter(Boolean)。并发数大致按核数封顶,多出来的会排队,扔进去一百个函数它们都会跑完,只是每次跑一小批。
|
||||||
|
|
||||||
|
```javascript
|
||||||
|
phase('Research');
|
||||||
|
// 九个信源,九个 agent,同时开工
|
||||||
|
const raw = await parallel(
|
||||||
|
SOURCES.map((s) => () =>
|
||||||
|
agent(s.prompt, {
|
||||||
|
label: `research:${s.key}`,
|
||||||
|
phase: 'Research',
|
||||||
|
schema: ITEM_SCHEMA, // 每个节点都返回校验过的 JSON
|
||||||
|
agentType: 'general-purpose',
|
||||||
|
}),
|
||||||
|
),
|
||||||
|
);
|
||||||
|
const collected = raw.filter(Boolean); // 把失败 agent 留下的 null 过滤掉
|
||||||
|
```
|
||||||
|
|
||||||
|
派活这一步是活在 Claude 写的代码里,不是活在一轮模型对话里。Claude 自己的上下文从来不会同时装着九个信源,每个 subagent 带着自己的一份,只有最终答案会传回来。这就是 Claude 能把一次 workflow 扩展到几十上百个 subagent、却不会把这次会话淹没的原因,编排这一层不花 token,因为它不是 Claude 又想了一轮。
|
||||||
|
|
||||||
|
06 在屏障处做汇入
|
||||||
|
|
||||||
|
活儿派出去,得有东西能收拢它才有意义。拢回来的这个节点,就是边汇聚的地方:一个 agent(或一段代码)一次性看到全部上游结果,去做一件必须看到全集才能做的事,比如跨信源去重、按影响力排序、总数为零就提前退出。这是整张图里唯一值得让屏障付出等待成本的地方。
|
||||||
|
|
||||||
|
```javascript
|
||||||
|
// 这条边就是普通 JS,没有 agent,零 token
|
||||||
|
const flat = collected.flatMap((c) => c.items);
|
||||||
|
log(`Collected ${flat.length} items`);
|
||||||
|
phase('Curate');
|
||||||
|
// 这个屏障节点需要全部结果凑齐才能去重排序
|
||||||
|
const curated = await agent(
|
||||||
|
`Dedupe and rank these by impact:\n${JSON.stringify(flat)}`,
|
||||||
|
{ phase: 'Curate', schema: CURATED_SCHEMA },
|
||||||
|
);
|
||||||
|
```
|
||||||
|
|
||||||
|
只是把一个列表压平?那是一条边,直接写在行内就好。判断方法很简单粗暴:如果写成了 parallel → transform → parallel,中间那个 transform 又没有跨条目的依赖,那本该用流水线,完全不需要屏障。
|
||||||
|
|
||||||
|
07 菱形:拆分 → 工作 → 合并
|
||||||
|
|
||||||
|
把"派出去"和"拢回来"拼在一起,就得到了几乎每张正经 agent 图里都会出现的主力拓扑:菱形。一个节点拆任务,多个节点并行干活,一个节点合并。市场扫描、依赖审计、代码评审、研究报告,背后都是这个形状,换个信源和提示词,同一副骨架照样能用。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
它的标准写法有个值得记住的名字:派发 → 归约 → 合成。先派出去收集广度,用普通代码归约压缩,再用最后一个 agent 合成写出答案。看懂这颗菱形之后,就不会再问"怎么让 agent 多做几步",而是会问"拆分点在哪,合并点在哪",这才是真正能扩展的问题。
|
||||||
|
|
||||||
|
## 第四步:路由、验证与隔离
|
||||||
|
|
||||||
|
08 用条件语句在运行时给边选路
|
||||||
|
|
||||||
|
不是每张图都是固定的。有时候走哪条边,取决于某个节点发现了什么。路由节点检查结果,决定走哪条下游路径:给工单分类后分流到对应处理节点,或者看 diff 大小,决定走快速评审还是完整审计。在 workflow 里这就是一个普通的 if 或 switch,判断依据是某个节点校验过的输出,因为控制流本来就活在代码里。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
这正好是确定性变成优点而不是限制的地方。路由的判断可以由 Claude 完成(一个 subagent 负责分类),但路由本身是 Claude 写的代码,同样的分类结果每次都走同一条路。节点上拿到 Claude 的判断力,边上拿到脚本的可靠性,不会出现"Claude 自己决定跳过审计"这种意外,因为跳过这件事必须写进图里才会发生,而它没有被写进去。
|
||||||
|
|
||||||
|
```javascript
|
||||||
|
// 路由节点:agent 负责分类,代码负责选边
|
||||||
|
const { severity } = await agent(
|
||||||
|
`Classify this diff's risk:\n${diff}`,
|
||||||
|
{ schema: { type: 'object',
|
||||||
|
properties: { severity: { enum: ['low', 'high'] } },
|
||||||
|
required: ['severity'] } },
|
||||||
|
);
|
||||||
|
let review;
|
||||||
|
if (severity === 'high') {
|
||||||
|
// 高风险路径:完整并行审计
|
||||||
|
review = await parallel(FILES.map((f) => () => agent(`Audit ${f}`)));
|
||||||
|
} else {
|
||||||
|
// 低风险路径:一次快速评审
|
||||||
|
review = await agent(`Quick review of ${diff}`);
|
||||||
|
}
|
||||||
|
```
|
||||||
|
|
||||||
|
09 在边上放一个验证器
|
||||||
|
|
||||||
|
一张图真正的杠杆不是塞了更多 agent,而是能围绕结果搭起多少确定性。验证器节点蹲在一个结果被放行到下游之前,它唯一的工作就是试图推翻这个发现。扛住了就放行,扛不住就到不了最终答案。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
三种模式值得掌握:
|
||||||
|
|
||||||
|
- **对抗式验证:**给每个发现派 N 个独立的怀疑者,专门去反驳它,多数没被驳倒才算站得住。
|
||||||
|
- **多视角验证:**让每个验证者盯不同的方面,正确性、安全性、能不能复现,角度越分散,越能揪出 N 个一样的检查都发现不了的问题。
|
||||||
|
- **评委制:**从不同角度生成 N 个方案,用并行的评委打分,挑最好的一版作为主线,再把其他几版里的亮点揉进去。
|
||||||
|
|
||||||
|
真实团队在移植 Bun 运行时的时候,就是靠这套对抗式代码评审焊进循环,才做成的。
|
||||||
|
|
||||||
|
10 把节点隔离开,别让一个失败污染整张图
|
||||||
|
|
||||||
|
在一条链里,失败会级联:C 死了,D 就跑不起来,整条链停摆。在一张图里,失败本该被限制在它自己的节点里。这一点已经部分成立:parallel() 里一个抛错的函数会被解析成 null,八个正常的 agent 照样能返回结果,一个坏的自己掉队,.filter(Boolean) 就是那道防线。把每一次汇入都设计成能容忍缺失的输入,而不是假设总能凑齐全集。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
更隐蔽的失败,是节点之间互相踩到对方。多个 agent 并行写文件时可能会撞车,解法是隔离:用 git worktree,让每个 agent 在自己的一份工作区里干活,在沙盒里完成,再干净地合并回去。只在节点真的会并行写入的时候才用它,它是那种拓扑真正需要的安全带,不是每次运行都要交的税。
|
||||||
|
|
||||||
|
## 第五步:循环、模型分层与拓扑
|
||||||
|
|
||||||
|
11 可以加一个循环,但一定要让它收敛
|
||||||
|
|
||||||
|
要是压根不知道这活儿有多大呢?只有真的做下去才知道:规模未知的探索,一次漏洞排查发现一个 bug 又带出三个新的。这时候需要一个循环,一条指回更早节点的、受控的边。危险也很明显:一个不收敛的循环,就是一台不停派 agent 出去、直到预算耗尽才停的死循环机。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
能收敛的写法叫"跑到干为止":持续派出发现者,直到连续 K 轮都没发现新东西,才停下来。真正决定成败的细节,也是几乎每个人第一次都会踩的坑,是拿什么去做去重比对。要对着"见过的一切"去重,而不是只对着"已确认的结果"去重。不然被否掉的发现每一轮都会重新冒出来,循环永远跑不干,最后搭出的是一台专门花钱去反复发现同一批死胡同的机器。
|
||||||
|
|
||||||
|
```javascript
|
||||||
|
const seen = new Set();
|
||||||
|
const confirmed = [];
|
||||||
|
let dry = 0;
|
||||||
|
while (dry < 2) { // 连续两轮空手而归就停下
|
||||||
|
const found = (await parallel(
|
||||||
|
FINDERS.map((f) => () => agent(f.prompt, { schema: BUGS }))
|
||||||
|
)).filter(Boolean).flatMap((r) => r.bugs);
|
||||||
|
const fresh = found.filter((b) => !seen.has(key(b)));
|
||||||
|
if (!fresh.length) { dry++; continue; }
|
||||||
|
dry = 0;
|
||||||
|
fresh.forEach((b) => seen.add(key(b))); // 对"见过的一切"去重,不是只对已确认的
|
||||||
|
// 每个新发现都要过一轮多视角验证才算数
|
||||||
|
const judged = await parallel(fresh.map((b) => () =>
|
||||||
|
parallel(['correctness', 'security', 'repro'].map((lens) => () =>
|
||||||
|
agent(`Judge "${b.desc}" via ${lens} — real?`, { schema: VERDICT })))
|
||||||
|
.then((v) => ({ b, real: v.filter(Boolean).filter((x) => x.real).length >= 2 }))));
|
||||||
|
confirmed.push(...judged.filter((v) => v.real).map((v) => v.b));
|
||||||
|
}
|
||||||
|
```
|
||||||
|
|
||||||
|
12 给不同节点分配不同档位的模型
|
||||||
|
|
||||||
|
不是每个节点都需要最好的模型。一张图会用单个 agent 永远做不到的方式,把这件事摆明白:有些节点干的是有边界、会重复的活,比如抽取一个字段、给工单分类;有些节点承载真正的判断力,比如合成报告、裁定一个发现是否成立。干重复活的节点放到便宜模型上跑,token 留着花在真正需要判断力的地方。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
在 workflow 里,Claude 派出去的每个 subagent 默认继承这次会话的模型,除非脚本里显式覆盖,所以默认情况下一次大规模运行的账单会全按会话档位算。单次 agent() 调用上的 model 选项,能让 Claude 单独把这一个节点换到别的模型上跑。大规模运行前先看一眼 /model,让 Claude 把派出去的那些重复性节点降到便宜模型,合并节点留在高档位,这个办法能把一张烧 token 的图从贵变便宜,还完全不用动它的形状。
|
||||||
|
|
||||||
|
13 拓扑结构,就是你的成本和延迟
|
||||||
|
|
||||||
|
图的形状不是装饰,它是决定运行时间的最大杠杆。最容易踩坑的选择是 parallel() 还是 pipeline()。parallel() 这道屏障会让所有东西都等最慢的那个节点,才进入下一阶段。pipeline() 让每条数据各自独立地依次经过所有阶段,没有屏障,条目 A 可能已经在第三阶段了,条目 B 还在第一阶段,跑得快的提前结束,不用在慢的后面干等。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
默认用 pipeline()。只有一个阶段真的需要全部前置结果同时到齐时才用屏障,比如跨集合去重、按总数提前退出、需要对照"其他发现"来写的 prompt。"代码更干净"和"这些阶段感觉是分开的"都不是理由,屏障带来的延迟是真实的、可测量的、被浪费掉的时间,分开不代表必须同步。
|
||||||
|
|
||||||
|
## 最后一步:让 Claude 自己画图
|
||||||
|
|
||||||
|
14 让 Claude 自己画图,自我路由
|
||||||
|
|
||||||
|
最后一步,是对那些没法提前规划的活儿,不再自己动手画图。用 dynamic workflows,只要描述目标,Claude 会自己写编排脚本:拆解任务、决定怎么把活儿派出去、派出一队 subagent、再合成结果。拿到的是一张为这次运行量身定做的图,而不是一张你希望它恰好合适的固定图。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
有三种用法。在 prompt 里说出"workflow"这个词,Claude 就会为这个任务写一份。跑一个已经存好或内置的,比如 /deep-research,就是一张已经在生产里跑着的真实图:定范围 → 并行搜索 → 抓取 → 对抗式验证 → 合成,正是这门课从头到尾讲的那副骨架。或者打开 ultracode,Claude 会给这次会话里每个像样的任务都规划一次 workflow。跑得好的时候按 s 把脚本存进 .claude/workflows/,从此可以版本控制、按名字重新运行,谁 clone 了这个仓库都能直接跑起来。
|
||||||
|
|
||||||
|
```
|
||||||
|
› Run a workflow to audit every route under src/routes/ for missing
|
||||||
|
auth. Spawn one agent per route file, then verify each finding before
|
||||||
|
reporting.
|
||||||
|
|
||||||
|
● Claude wrote an orchestration script · launching in background…
|
||||||
|
|
||||||
|
/workflows — auth-audit · running
|
||||||
|
✓ Scope 1/1 2.1k tok
|
||||||
|
Fan-out 18/18 one agent per route file
|
||||||
|
Verify 11/18 3-vote skeptics per finding…
|
||||||
|
Synthesize 0/1 waiting on verify
|
||||||
|
|
||||||
|
// 会话保持响应,队伍在后台继续跑
|
||||||
|
```
|
||||||
|
|
||||||
|
两年来,多 agent 协作的杠杆一直在单个 loop 上:更好的 verifier,更稳的退出条件,更干净的状态文件。
|
||||||
|
|
||||||
|
而现在,把这些 loop 怎么连起来,成了新的护城河。
|
||||||
|
|
||||||
|

|
||||||
@@ -0,0 +1,80 @@
|
|||||||
|
# 📊 文章摘要:重磅!Graph Engineering 实操手册公开
|
||||||
|
|
||||||
|
> **原文**:[2026-08-20_重磅_Graph_Engineering_实操手册公开](./2026-08-20_重磅_Graph_Engineering_实操手册公开.md)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/GZrKCHJaG5g7Ua-ZiEP-fQ
|
||||||
|
> **来源**:微信公众平台
|
||||||
|
> **作者**:Datawhale(原作者:Codez,X 博主)
|
||||||
|
> **发布日期**:2026-08-20
|
||||||
|
> **摘要日期**:2026-08-20
|
||||||
|
> **价值评级**:⭐⭐⭐ 高
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 核心命题
|
||||||
|
|
||||||
|
> **图即组织** — Graph 不是 loop 的升级版或替代品,而是 loop 的组织方式;把多 Agent 协作从单个循环的优化转向图拓扑的设计,是新的护城河。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 文章概要
|
||||||
|
|
||||||
|
本文是 Datawhale 对 X 博主 Codez 所总结"Graph Engineering 14 步"的中文整理,回应"Loop Engineering 已死,Graph Engineering 永生"的舆论,系统讲解如何从单个 agent loop 走到一张能自我路由的多 Agent 图。内容覆盖动手前的四个自检问题、图的四构件(节点/边/共享状态/失败路由)、节点与边的数据契约、扇出扇入与菱形拓扑、验证器三模式、收敛循环、模型分层与 parallel/pipeline 选型,并附可直接复用的 JavaScript 代码。价值在于把图论概念转译为一组可操作、可验证的工程判断(如"没传数据就没有边""边是免费的");局限是围绕 Claude Code workflow 特定 API 展开,且"14 步"的划分带有课程营销色彩,部分结论为个人工程经验未经系统验证。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 关键要点
|
||||||
|
|
||||||
|
1. **动手前四问 + 附加题** — 任务能否拆角色、有无真并行、单 Agent 上下文是否装得下、失败跳转成本是否负担得起;核心附加题是"你是否已有跑得稳的单体 loop",没有就先别建图。 `[分类: 共识]`
|
||||||
|
2. **图不是 loop 的升级版,是组织方式** — 图烧更多 token、协调开销更高、debug 对象是整张没亲眼看着跑的路由图,大部分人现在用不上。 `[分类: 范式突破]`
|
||||||
|
3. **四构件** — Nodes(只对一件事负责的最小单位)、Edges(决定接棒者)、Shared State(逼你想清未明环节)、Failure Routing(重试耗尽后的退路);没有失败边的图只是流程图。 `[分类: 共识]`
|
||||||
|
4. **"然后"不是边** — 没有真正传递数据的两步是互不相干的节点被线性脚本硬凑;线性脚本是一张退化的单链图,剪掉不携数据的箭头,链会塌缩成可并行的更宽结构。 `[分类: 范式突破]`
|
||||||
|
5. **节点与边都是数据契约** — 节点输入输出有边界、schema 校验发生在工具调用层;边按数据命名而非按顺序命名;很多人花模型 token 做的事其实是一条边,而边(普通代码)是免费的。 `[分类: 共识]`
|
||||||
|
6. **菱形是主力拓扑** — 派发(parallel 扇出收集广度)→ 归约(普通代码压缩)→ 合成(最后的高档位 agent 写答案);parallel 是屏障等最慢者,默认应选无屏障的 pipeline。 `[分类: 共识]`
|
||||||
|
7. **验证器三模式** — 对抗式验证(N 个怀疑者反驳)、多视角验证(各盯一个方面)、评委制(并行打分择优融合);Bun 运行时移植团队靠对抗式代码评审焊进循环做成。 `[分类: 共识]`
|
||||||
|
8. **收敛循环的去重对象** — "跑到干为止"的循环必须对"见过的一切"去重而非只对"已确认的结果",否则被否掉的发现每轮重冒,循环永不收敛。 `[分类: 共识]`
|
||||||
|
9. **模型分层与失败隔离** — 重复性节点降档到便宜模型、判断力节点留高档位;一个抛错函数解析为 null 不拖垮批次,.filter(Boolean) 与容忍缺失输入是设计原则;并行写入用 git worktree 隔离。 `[分类: 共识]`
|
||||||
|
10. **Dynamic workflows 让 Claude 自己画图** — 对无法提前规划的任务,Claude 自写编排脚本、自我路由,脚本可存入 .claude/workflows/ 版本化复用。 `[分类: 未探索]`
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 批判性分析
|
||||||
|
|
||||||
|
### 假设前提
|
||||||
|
- 默认读者使用 Claude Code 的 workflow/agent()/parallel() API,跨平台迁移需转译概念(等价物存在于其他编排框架,但代码不可直接复用)。
|
||||||
|
- 预设"编排层零 token"成立——即编排脚本由 Claude 一次性写出后可靠执行,未讨论脚本本身出错时的调试成本。
|
||||||
|
- 以"loop 已跑稳"为前提门槛,隐含读者已过单 Agent 工程化阶段。
|
||||||
|
|
||||||
|
### 论据与逻辑
|
||||||
|
- 逻辑链条清晰:从"要不要建图"的否决性自检,到构件、契约、拓扑、验证、收敛,层层递进,且每步给出判断标准(如屏障 vs 流水线的选择判据)。
|
||||||
|
- Bun 运行时移植是真实案例锚点;但"全网570w人看过"等表述是传播数据而非效果证据,"几乎每个人第一次都会踩的坑"属经验断言。
|
||||||
|
- "边是免费的"在编排代码确定性成立的前提下为真,但忽略了写这些代码本身的工程时间成本。
|
||||||
|
|
||||||
|
### 边界与局限
|
||||||
|
- 未给出图规模上限(几十上百个 subagent 的经验阈值)与成本量级数据。
|
||||||
|
- 对 Shared State 的并发写冲突仅以 git worktree 一笔带过,状态机设计细节缺失。
|
||||||
|
- 未讨论图的测试与回归方法(何时重跑整图、如何做局部回归)。
|
||||||
|
- 摘要者推断:14 步中约半数是 Claude workflow 产品功能介绍而非通用图工程方法,读者需自行区分。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 可引用金句
|
||||||
|
|
||||||
|
> "Graph 不是 loop 的升级版,是 loop 的组织方式。"
|
||||||
|
|
||||||
|
> "没有失败边的图,只是一张流程图,不是一个能跑的系统。"
|
||||||
|
|
||||||
|
> "很多人花模型 token 去做的事,其实就是一条边,而边是免费的。"
|
||||||
|
|
||||||
|
> "两年来,多 agent 协作的杠杆一直在单个 loop 上:更好的 verifier,更稳的退出条件,更干净的状态文件。而现在,把这些 loop 怎么连起来,成了新的护城河。"
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 总体评价
|
||||||
|
|
||||||
|
**亮点**:把图工程从概念转译为一组可执行的工程判断,每个判断都给出判据;"没传数据就没有边""对见过的一切去重"等坑点提炼精准;代码示例可直接套用;开篇的否决性自检(四问+附加题)体现了少见的克制。
|
||||||
|
|
||||||
|
**不足**:强绑定 Claude Code workflow API;无成本与规模量化数据;Shared State 与图级测试着墨不足;标题与"570w人看过"等表述营销味较重。
|
||||||
|
|
||||||
|
**适用场景**:多 Agent 编排系统设计与重构评审;判断团队是否该从单 Agent 升级到图拓扑的决策检查;Claude Code workflow/subagent 的实战入门。
|
||||||
|
|
||||||
|
**关联建议**:与《企业内Agent工具落地实践》对照——本文解决单任务内部的编排图,该文解决企业层的运行时与治理,两层可组合成完整 Agent 工程视图;"验证器三模式"可移植到本院 skill 评测体系建设;收敛循环的"见过的一切去重"对爬虫/情报收集类 Agent 有直接参考价值。
|
||||||
@@ -0,0 +1,22 @@
|
|||||||
|
# 政策分析报告|当前AI对国内外就业产生的冲击及应对建议
|
||||||
|
|
||||||
|
> **来源**:微信公众平台(GIG)
|
||||||
|
> **作者**:GIG
|
||||||
|
> **发布日期**:2026-08-20(原文未标注明确日期,按下载日占位;报告正文注明"本报告写于2026年5月")
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/qgQSauWUn1OIA1TwEirv0w
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
|
||||||
|
|
||||||
|
广州粤港澳大湾区研究院(GIG)立足湾区,服务国家,面向未来。研究院由著名学者郑永年教授担任理事长。
|
||||||
|
|
||||||
|
本报告写于2026年5月
|
||||||
|
|
||||||
|
当前,人工智能的爆炸式快速增长对全球劳动力市场的影响,已不再只是停留在理论讨论或趋势预测中,而正实实在在地改变就业结构。最新关于"AI裁员陷阱"的模型研究显示,当企业通过AI替代劳动者时,虽然单个企业能够享受人力成本下降的收益,但失业和收入下降造成的需求损失却由整个社会承担。AI首先冲击的是初级白领岗位以及大量"入门型"职业。这些岗位原本是年轻人进入专业领域、积累经验、向上流动的重要通道,如今,这些通道被AI不断压缩,甚至被直接替代,可能导致人才培养链条出现断层,也会加剧未来的人力资本风险。更值得警惕的是,过度依赖AI可能让人类逐渐丧失独立思考、判断和学习的能力,形成所谓的"人工智残"现象。如果这种趋势继续发展,社会可能会越来越依赖少数掌握资本、算力和平台资源的群体,普通人则被动接受技术系统的安排,最终滑向一种被管理、被驯化的"牧民社会"。我们需要在发展与安全之间进行统筹安排,短期采取相应措施整治存量"内卷"并建立就业缓冲机制,依托大科创体系重塑产教融合,长期则需通过颠覆性的教育改革与高水平的开源开放战略,以"新质生产力"创造海量增量经济空间,实现技术红利与高质量就业的动态平衡。
|
||||||
|
|
||||||
|
★GIG智库产品面向政府、高校、企业等机构用户,如需了解本报告完整版或本系列报告获取途径,请在公众号后台留言:机构名称-姓名-职务-工作邮箱。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
广州粤港澳大湾区研究院是"民间性质、官方支持、非营利性"的研究机构。研究院秉承独立、客观、有效的核心价值理念,汇聚海内外具有"国际视野,中国情怀"的学者和实践者,扎根真实世界,积极回应转型中国的重大政治、经济与社会问题,致力于知识创新和专业的政策研究,为政府、企业和社会组织提供政策咨询和解决方案。
|
||||||
@@ -0,0 +1,68 @@
|
|||||||
|
# 📊 文章摘要:政策分析报告|当前AI对国内外就业产生的冲击及应对建议
|
||||||
|
|
||||||
|
> **原文**:[2026-08-20_政策分析报告_当前AI对国内外就业产生的冲击及应对建议](./2026-08-20_政策分析报告_当前AI对国内外就业产生的冲击及应对建议.md)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/qgQSauWUn1OIA1TwEirv0w
|
||||||
|
> **来源**:微信公众平台
|
||||||
|
> **作者**:GIG(广州粤港澳大湾区研究院,理事长郑永年)
|
||||||
|
> **发布日期**:2026-08-20(报告正文注明写于 2026 年 5 月)
|
||||||
|
> **摘要日期**:2026-08-20
|
||||||
|
> **价值评级**:⭐⭐ 中
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 核心命题
|
||||||
|
|
||||||
|
> **AI裁员陷阱** — 单个企业以 AI 替代劳动者时享受人力成本下降的收益,而失业与收入下降造成的需求损失由整个社会承担,就业冲击具有负外部性。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 文章概要
|
||||||
|
|
||||||
|
本文是广州粤港澳大湾区研究院(GIG,郑永年任理事长)2026 年 5 月政策报告的公众号摘要版(完整版需机构身份留言获取),仅一段约 700 字的核心观点浓缩。报告提出三层判断:AI 已实际改变就业结构,首当其冲的是初级白领与"入门型"职业,年轻人向上流动通道被压缩,人才培养链条面临断层风险;过度依赖 AI 可能导致"人工智残",社会或滑向少数人掌控资本/算力/平台、大众被管理驯化的"牧民社会";对策上短期整治"内卷"并建立就业缓冲机制、中期依托大科创体系重塑产教融合、长期以颠覆性教育改革与高水平开源开放战略创造增量经济空间。作为智库政策视角的样本有价值,但摘要版无数据、无论证细节,结论的警示性表述强于实证支撑。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 关键要点
|
||||||
|
|
||||||
|
1. **AI 裁员陷阱的负外部性结构** — 引"最新模型研究":企业得私利、社会担需求损失,构成 AI 替代就业的市场失灵论证基础(原文未给出研究出处)。 `[分类: 争议]`
|
||||||
|
2. **冲击对象是初级白领与入门型职业** — 这些岗位原是年轻人进入专业领域、积累经验的通道,通道被压缩将导致人才培养链条断层与人力资本风险。 `[分类: 共识]`
|
||||||
|
3. **"人工智残"警示** — 过度依赖 AI 可能使人类逐渐丧失独立思考、判断和学习的能力。 `[分类: 争议]`
|
||||||
|
4. **"牧民社会"终极担忧** — 社会将依赖少数掌握资本、算力和平台资源的群体,普通人被动接受技术系统安排、被管理被驯化。 `[分类: 争议]`
|
||||||
|
5. **三段式政策处方** — 短期:整治存量"内卷"+就业缓冲机制;中期:大科创体系重塑产教融合;长期:颠覆性教育改革+高水平开源开放战略,以"新质生产力"创造增量空间,实现技术红利与高质量就业动态平衡。 `[分类: 未探索]`
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 批判性分析
|
||||||
|
|
||||||
|
### 假设前提
|
||||||
|
- 默认 AI 的替代效应是就业冲击的主导机制,未讨论增强/互补效应与 AI 创造的新岗位(历史上技术革命的双向效应)。
|
||||||
|
- "入门岗位消失→人才断层"是线性外推,未考虑培训方式转型(如 AI 辅助在岗学习)对通道的替代性重建。
|
||||||
|
|
||||||
|
### 论据与逻辑
|
||||||
|
- 摘要版为纯观点浓缩:核心论据"AI裁员陷阱"的模型研究未注明作者、机构与结论条件;全文无一处量化数据。
|
||||||
|
- "人工智残""牧民社会"等概念有传播力但属规范性修辞,从"依赖 AI"到"被驯化社会"的推演链条缺少中间论证。
|
||||||
|
- 政策建议(教育改革、开源开放)与问题诊断(就业结构冲击)之间的因果机制未展开——这可能是完整版的内容,摘要版无法验证。
|
||||||
|
|
||||||
|
### 边界与局限
|
||||||
|
- 这是报告的营销摘要而非报告本身,完整版获取设有机构门槛,可核查性低。
|
||||||
|
- 立场为政府咨询导向(发展与安全统筹),天然倾向警示与干预叙事。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 可引用金句
|
||||||
|
|
||||||
|
> "当企业通过AI替代劳动者时,虽然单个企业能够享受人力成本下降的收益,但失业和收入下降造成的需求损失却由整个社会承担。"
|
||||||
|
|
||||||
|
> "当今人类正处于AGI的前夜。但'前夜'不等于'黎明'。"
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 总体评价
|
||||||
|
|
||||||
|
**亮点**:负外部性框架为理解 AI 就业冲击提供了清晰的经济学前置;"入门岗位=人才通道"视角切中要害;政策分层(短中长期)结构完整。
|
||||||
|
|
||||||
|
**不足**:摘要版零数据、零引用;概念警示性强于论证;完整版不可得使全部结论不可验证。
|
||||||
|
|
||||||
|
**适用场景**:了解官方智库对 AI 就业议题的定调口径与政策话语(内卷整治/产教融合/新质生产力);引用"AI 裁员陷阱"外部性论述时的原始出处线索。
|
||||||
|
|
||||||
|
**关联建议**:与《FDE 在中国火了》(IDC中国)互补阅读——一者宏观警示 AI 对就业结构的冲击,一者微观展示 AI 服务交付新岗位(FDE)的兴起,合观可见就业结构"消失与新增并存"的全貌。
|
||||||
@@ -0,0 +1,162 @@
|
|||||||
|
# 文章背后 | 漂:聚焦城市新移民
|
||||||
|
|
||||||
|
> **来源**:微信公众平台(Geores)
|
||||||
|
> **作者**:Geores
|
||||||
|
> **发布日期**:2026-08-20(原文未标注明确日期,按下载日占位)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/gPvUj751Gz-G70_DWMl3UQ
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
在中国地理学会副秘书长、中国地理学会编辑出版工作委员会副主任、中国科学院地理资源所学术期刊中心常务副主任、《地理学报》专职副主编**何书金研究员**的指导下,中国地理资源期刊微信公众平台**近期创意推出"文章背后"专栏**,从作者、读者、审稿人、评论人、编辑等多元视角,着力挖掘各个期刊刊文背后不为人知的感人故事,诚邀您的投稿。
|
||||||
|
|
||||||
|
联系方式:朱晓华
|
||||||
|
|
||||||
|
E-mail:geores@igsnrr.ac.cn
|
||||||
|
|
||||||
|
电话:010-64889584
|
||||||
|
|
||||||
|
|
||||||
|
|
||||||
|
**本期嘉宾**
|
||||||
|
|
||||||
|
**李志刚**,武汉大学城市设计学院院长,教授,博导,中国地理学会城市地理专业委员会副主任,中国城市规划学会城乡治理与政策研究学术委员会副秘书长,中国城市规划学会理事、学术工作委员会委员,湖北省城乡规划学会副理事长,美国Urban China Research Network副主任委员。曾先后担任中国地理学会青工委副主任委员、中山大学城市化研究院副院长以及广东省城市化与地理环境空间模拟重点实验室副主任等职务。
|
||||||
|
|
||||||
|
近年在国内外城市地理、城市研究、城市规划领域发表文章140多篇,其中SSCI收录40多篇。参与国内外10多部书籍编写,出版中文专著3部。主持国家自然科学基金项目5项,参与国际和省部级科研项目10多项。主持国家自然科学基金"优秀青年基金",入选教育部"新世纪"人才、广东省高等学校"千百十人才培养工程"、湖北省"楚天学者"特聘教授,曾先后获得中国地理学会"第十一届青年地理科技奖"、中国城市规划学会"首届中国城市规划青年科技奖"、中国地理学会"中国城市地理优秀论文奖"一等奖、"第二届吴传钧人文与经济地理优秀论文奖"一等奖,南京大学规划校友会"卓越青年奖",并连续入选Elsevier"中国高被引学者" (2014-2017年连续四年)。曾为英国伦敦大学学院(UCL)巴特莱规划学院访问教授,兼任曼彻斯特大学Manchester Urban Institute国际委员、教育部人文社会科学重点研究基地华东师范大学中国现代城市研究中心学术委员会委员、上海同济城市规划设计研究院城市与社会研究中心学术委员会委员、武汉市第十四届人大常委会咨询专家等。
|
||||||
|
|
||||||
|
主要研究方向为中国城市社会地理,目前的主要研究兴趣为移民聚居区、农民工回流及建成环境对城乡居民健康和感知方面的影响。担任国际期刊《Urban Studies》中国编辑(2012-2015)和国际编委(2016至今),担任《Urban Affairs Review》、《Environment and Planning A》、《International Journal of Urban and Regional Research》、《The China Quarterly》、《Transactions of the Institute of British Geographers》、《Journal of Urban Affairs》、《地理学报》、《地理研究》、《城市规划》等国内外高水平期刊的审稿专家。
|
||||||
|
|
||||||
|
**本期"文章背后",听李志刚教授讲述他从事城市新移民研究的故事,与大家一起分享。**
|
||||||
|
|
||||||
|
**朱晓华**
|
||||||
|
|
||||||
|
中国地理资源期刊微信平台总编室
|
||||||
|
|
||||||
|
应朱晓华老师的热情邀请,需要完成这篇"文章背后"以"漂"命名的命题作文。这样的题目,说明朱老师对我和我干的活非常了解,加上他顺带赠送给了我他在商务印书馆的新著——《生命由自己把握》,形成一种无形的动(压)力,使我只能加班加点,完成以下的叙述(此处有呵呵,其实我本人也非常乐意写作一点文字,以与同仁分享)。
|
||||||
|
|
||||||
|
我的履历非常简单:出生在湖北天门市岳口镇,一个地图上都不太能看清的地方,如果没听说过一点也不奇怪,一个普通家庭,父母都是普通工人;上大学离开家乡,读完博士回国工作,一直在同一个大学——中山大学工作了十年,最近回到了湖北武汉,在武汉大学工作了三年多。时间过的真快。每次填写干部履历表,职业栏的填写都很容易,没有太多好写。如果回首往事,也就似乎没什么好写。仔细想想,觉得自己属于比较典型的小镇青年,运气较好地出生在70年代末的中国,等到1998年我从大学毕业,已经开始目睹这个国家的巨变和腾飞。2001年留学回国工作,当时的广州正在房价剧增的前夜,上海、北京、深圳的房价大涨也只是刚刚起步,所以我很幸运地早早"买楼",所以,也没有感觉太大的生活压力。当然,也是向同事们借一些、银行贷一些,好在负担不重。也许,运气一直伴随着我吧。
|
||||||
|
|
||||||
|
**我的大学**
|
||||||
|
|
||||||
|
置身于城市地理研究领域,我把自己定位在中国城市研究。但在1998年以前,作为大学里一名普通的建筑系城市规划专业的学生,我其实完全不知道将来该去做什么,也并不清楚未来的道路何去何从。城市地理、城市研究这些,更是十分遥远。小镇同学在武大读书的不少,多是物理、通信、经济之类专业,如我这样读工程、设计专业的很少。亲戚中有几位在家乡做建筑设计,影响我选择了相近专业,以便将来"能有一碗饭吃"。同学们多数延续了高中的节奏,理科、数学、考试。而我对绘画、设计、艺术表达这些东西,内心更多的是不解与抗拒,老师所说的灵感和天赋,只是让我更加困惑。类似很多来自小地方的迷茫的年轻人一样,我花了很多时间去阅读名人传记、参加数学竞赛,苦闷地寻找着未来的方向。在这期间,对我影响很大的,是经常聚会的一对双胞胎同乡,保送武大物理系的两兄弟早就立志出国,进入大学后更是夜以继日地学英语、听英语。同班同学中也有类似情况,TOEFL、GRE的考试十分热门(也许今天依然如此)。这些现象,使得我也心生出国的念头,偶尔在学校图书馆翻看英文杂志,想象着遥远世界的模样。由于家庭条件所限,我在高中二年级才第一次到过本省的大城市武汉,省外更是完全没有去过。可能由于这样的原因,我对外面的世界有着强烈的向往。这种向往,当然也应该蕴含了孤独的小镇青年追求认同的渴望,出国在当时无疑是比较"酷"的。不过,真的出国是在我从南京大学城市资源学系的人文地理专业硕士研究生毕业之后的事了。
|
||||||
|
|
||||||
|
**南大研究生阶段**
|
||||||
|
|
||||||
|
1998年的就业形势不妙,规划专业不好找工作。由于当时的武大并没有规划专业的硕士点,我决定考研,目标是南京大学。当时的想法,完全不是专业上的考虑,首先是要去一个更好的大学。当年南大开国内SCI之风,影响很大,绝对是青年学子们向往的地方。艰苦的准备考研,幸运的考上了,而且更幸运的成为学界泰斗崔功豪先生的学生。当时的南大,对硕士生毕业已经有了严格的发表文章的要求。作为一名传统设计训练模式培养出来的规划专业学生,我也生平第一次面对"科研文章"这样一个新鲜事物。记得当时在南大图书馆查阅英文期刊数据库,界面不大友好,也不知具体该如何查找,试了几下就放弃了。南大三年,深感这所百年名校的优势在于优良的学风、勤奋和严谨。教学楼在周末和假期也很难找到自习的地方,"人满为患",到处是埋头苦读的人。除了大师级的老师如崔老师、顾朝林教授、林炳耀教授、周怡教授等,很多学长如张京祥、甄峰等,都给我留下了深刻印象,对我有各方面的影响和帮助,持续至今。南大的出国氛围更加浓厚,研究生宿舍弥漫着Offer的气息:出国读博几乎是当时每个人的理想。我也置身其中,并且幸运的拿到了英国的ORS奖学金,得以在毕业后去英国南安普敦大学地理系读博士。不过,当时并不知道出国以后到底要读一个什么样的博士,PhD该做什么更是几乎毫无概念。去南安以前,只和未来导师吴缚龙教授(当时还是讲师)在南京汽车站匆匆见过一面。现在想来,当年的吴老师其实比我现在还要年轻好几岁。小镇青年要出国了!记得出发前,家里大摆宴席,来了很多亲戚朋友,还在镇上电视台点播了流行歌曲和港产电影,字幕依次排出热烈祝贺某某某赴英国就读博士云云(呵呵,好喜庆)。
|
||||||
|
|
||||||
|
**博士阶段的研究**
|
||||||
|
|
||||||
|
从北京飞伦敦是我第一次坐飞机。现在还可以清楚记得那个寒冷的冬夜,吴老师开车在南安汽车站接我到宿舍的情景。他还带了访问学者们留下的锅碗瓢盆给我。留学四年,我的研究生涯才真正开始了。我的学术生涯乃至整个人生的幸运值,也由此开始爆表。作为南大和港大着力培养的、在国际上最具潜力的中国城市研究的青年学者,吴老师给予了我学术上全方位的悉心指引和关怀,他的认真仔细、严谨踏实和勤奋努力感染了我,也激发了我对研究工作的兴趣和热忱。与同门何深静、刘玉亭伉俪,同宿舍的魏严正(前年已经故去)、邓军博士,在一次次茶余饭后的交流中,也潜移默化地提升了我的认知能力和学术水平。吴老师手上有一些国内的人口普查数据,我一直在帮他处理。我们发现,这些数据,可以用来实证芝加哥学派早期所开创的城市生态学研究,国际上的工作很多,中国的除了广州和南京,其他地方的研究基本还没有展开。加上和当时在南安短期访问的北大冯健博士、中大魏立华博士交流,我逐渐明确了研究主题:中国城市居住空间分异问题——市场化下的中国,愈发凸显的城市居住空间分异现象正在出现。当然,因子生态分析还不够支撑一篇博士论文,吴老师为我进一步确定了上海社区调查和小尺度的研究内容。没想到的是,这样的工作,会从当时(2003年)持续至今,最近我依然还在做着武汉的社区调查工作。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
**与导师吴缚龙教授在一起**
|
||||||
|
|
||||||
|
上海的社区调查是在上海市社科院卢汉龙老师的帮助下展开的,还记得当时在他家旁听他指导研究生毕业论文的场景,他们谈的现代性问题,我要到多年以后才会再次思考。在场几位学友,匆匆一别再也未曾见过。当时的主要感悟,是调研计划与复杂现实之间的张力。今天回头来看,其实是一种调研中的常态。三个典型社区新福康里、番瓜弄和新泾,从名字即可看出社会经济地位或贫富差距,都是上海较为有名的典型社区。顺带查了一下,现在新福康里的房价已经涨到每平米15万元,番瓜弄的均价也在每平米5万元,这在十五年前是完全感觉不到的,时至今日,犹如梦境。博士期间所积累的大量文献、见识和人脉,为我后来的工作奠定了很好的基础,尤其是以论文核心内容为基础所写的几篇文章,分别发表在《地理学报》、《TIBG》等国内外顶级期刊上。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
**空间分异与城市空间结构研究**
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
2005年9月底毕业回国,跨入罗湖口岸的一刻,深圳的天际线扑面而来,立刻感受到国内城市与英国城市尺度的差别,珠三角是当之无愧的巨型城市区域。中山大学是我的下一站,入职前几天我在广州看望了正在表兄开办的皮具厂打工的父亲,"三来一补"、城中村、农民工的话题,从纸面转成现实,从此有了实际接触。而这些课题正是中大人文地理研究的特色与强项,城中村和农民工社会空间研究从此与我结下不解之缘。直到今天,身处武汉大学的人才公寓,隔壁也是一片繁荣的城中村(风光村)和外来人口聚居区。
|
||||||
|
|
||||||
|
**中大十年**
|
||||||
|
|
||||||
|
中大地院的十年,是我的学术工作起步和渐入佳境之时。基于源自德国的优秀地理学血脉和临近港澳的地理优势,中大在城市地理、城市研究、城市国际化研究等方面具有得天独厚的优势,诸多先生们如许学强教授、闫小培教授、保继刚教授、薛德升教授、朱宏教授、李立勋教授、李郇教授等,给予了当时聚集的我们一帮年轻人以巨大的支持和鼓励,创造了十分和谐融洽、也颇为奋进的学术氛围(不知他们是如何做到的?!)。许多场景,每每想起仍会非常怀念!这一群"年轻人"包括曹小曙、林耿、刘云刚、周素红、陶伟、袁媛、何深静、沈静等等,今天多数已成长为中国人文地理学领域的中流砥柱。身处其中,不成材也难。记得曾有半年时间,与薛德升教授和刘云刚教授每天相约在中大旁边的下渡村同一家小饭馆吃午饭,几乎无话不谈,交流可谓多矣。还记得司徒尚纪教授退休后仍每天上班,笔耕不辍,每每路过我的办公室,会递来厚厚的新著,令人汗颜不已。珠三角和广州是城市地理研究的绝佳场域,为我实践在博士期间所接触的诸多文献和理论提供了机会,感觉自己的学术天地一下广阔了起来。
|
||||||
|
|
||||||
|
**A**
|
||||||
|
|
||||||
|
**项目带学科**
|
||||||
|
|
||||||
|
融入项目带学科的中大模式,我很快开始接触地方实践。最早负责的项目来自时任深圳市副市长的闫小培教授,结合当时社会主义新农村建设的背景,深圳一方面推动全域城市化,一方面开始建设"社会主义新社区",两个工作均指向了当时所谓"关外"的大批城中村。在闫老师指导下,位于龙岗的爱联社区的转型与规划研究成为我的第一个课题。我曾大量阅读的芝加哥学派、居住分异、移民社区等方面文献,一下有了用武之地。作为一种中国特色的移民聚居区,城中村的复杂远超我的想象,中国现实与已有理论的距离是明显的。在与华南理工大学魏立华教授和团队的合作中,也教给我很多地方知识,整个过程下来,感觉又做了一篇博士论文一般,当然也出产了几篇好文章。微观社会空间尤其是移民聚居区的丰富性、复杂性,其中所折射的地方与全球、以及国家、市场和社会之间的互动与张力,也开始吸引我的注意。移民聚居区是一种怎样的社会空间过程?背井离乡的他(她)们对于城乡中国究竟意味着什么?身边出现了很多来自老家的亲戚朋友,他们都在珠三角地区打工。一次一次去到广州、深圳、东莞的城中村、工厂、作坊,在一次次访谈问卷调查过程中,我开始意识到,从小镇青年到大学老师,我自己的"漂"的状态,我所面临的融入单位、融入广州、乃至融入国际化的状况,以及从一个普通的(甚至社会底层的)工人家庭向所谓"中产"或知识分子阶层的转化,其中所蕴含的奋斗、激情、困惑与张力,在这些社区和移民身上可以清楚地感受到。其实我自己就身处在这股"移民大潮"之中。这个国家和她的人民何尝不也是一样,也正朝向复兴和繁荣的未来"移民"?**研究移民聚居区就是研究我们身处的这个特殊时代,就是认识和理解我们自己。**
|
||||||
|
|
||||||
|
**B**
|
||||||
|
|
||||||
|
**非洲人区**
|
||||||
|
|
||||||
|
广州小北路非洲人区的研究始于2006年指导本科论文期间,国际化的广州正在出现各种新变化,非洲人区的出现在当时已经不时见诸报端,我所在的中大团队在学界最早开展了相关研究。作为一种"南南流动"的全新移民现象,广州非洲人区的研究很快也开始受到国际学术界的广泛关注,与国际学者的合作和互动成为这一时期我的学术工作的重要特点,很多本是研究非洲的学者如卡迪夫大学的Alison Brown教授、伦敦南岸大学的Michal Lyons教授(已故)、当时在香港大学的Adams Bodomo教授等、还有诸多知名华人学者如美国的马润潮教授(当时刚退休)、耶鲁大学的萧凤霞教授、UCLA的周敏教授等,纷纷参与其中。与他(她)们的合作和交流使我受益匪浅,一种综合的,结合人类学、社会学等的小尺度的城市地理研究思路也逐渐成型。基于这些合作,我逐步增加了自己的文章数量,在《地理学报》、《地理研究》和诸多SSCI期刊发表了系列文章。在与这些学界前辈的交流中,我还深刻感受到他(她)们对于所从事的研究事业的热爱。特别是Michal Lyons教授——她是犹太移民,从以色列去到英国工作和生活,当时已是癌症晚期,却仍坚持亲自实地调研,每次从伦敦飞来广州便立即开始田野工作,每天会在旅馆整理访谈资料直到凌晨。
|
||||||
|
|
||||||
|
在近十年的时间里,我也接触、接待或指导了各国各地关注这一问题的青年学者、学生近百人,交到很多朋友,其中如挪威奥斯陆大学的Heidi Haugen博士、德国科隆大学的Tabea Bork博士等,都已成长为这一领域的青年专家。他们有的来自地理学、规划学、建筑学、社会学、人类学、管理学等学科背景,也有MBA、学外交的、传媒的、语言学的、电信的、医学的,还有很多媒体人(如《纽约客》记者Evan Osnos、BBC、央视的记者等)、艺术家、摄影师(如李东)、作家(如旅行作家Lieve Joris)、电影人、清华本科生暑期调研的,等等。与他们的交流,让我愈发感受到了当前学科发展的交叉融合趋向,解读全球时代的地理现象需要不同专业观点的碰撞与综合。
|
||||||
|
|
||||||
|
更为感慨的,是在田野调查中所接触的非洲"移民"。虽然不像某些媒体所描绘的那么低端,但广州的多数非洲人并非如上海北京等地的跨国公司里的"高端"白领,多数是从事中非贸易的商人。例如我的朋友、当时加纳商会的首领阿塔,他常常问我:"你的研究对我们有什么用处?"这也成了我时常思考的问题。见过无数行色匆匆、颠沛流离之间仍然在奋斗不息的非洲商人,让我总有似曾相识之感。我想起早年所看到的自己的父母,他们在小镇集体经济倒闭之后,变成了小商小贩,经营日用品和小商品,经常在半夜去坐班车,到武汉汉正街进货后第二天傍晚返回,感觉他们总是嘶声竭力、行色匆匆、坚强维持;节假日是最忙的时候,家里总是没有大人。
|
||||||
|
|
||||||
|
**小北路非洲人(摄影:李东)**
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
作为非洲人聚居区的小北路"自下而上"发展而成,非常类似纽约内城的老唐人街,是一种"非正规的"、但极为重要的连接中非的"经济之桥"和"社会文化之桥"。全球与地方的复杂互动、国家政策、地方文化对这类族裔聚居区的影响无疑具有时代性和全球性。而中非关系更具有很强的国家战略性,"一带一路"大格局里包含了一个个"小北路"一般的微观社会空间。北大柴彦威教授曾告诉我,日本当代地理学的任务是为人类探索成熟型的、老龄化社会的持续发展道路。我想,小北路研究话题虽小,但也肩负着为中国城市融入全球化、为在社区尺度服务"一带一路"国家战略探路的重大任务。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
**广州非洲人聚居区研究成果**
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
**C**
|
||||||
|
|
||||||
|
**湖北村**
|
||||||
|
|
||||||
|
同步开展的,还有针对广州湖北村等城中村话题的研究。湖北村的研究,是我念兹在兹的一个。2008年从学校教师宿舍搬出,住进中大教工们所在的商品房小区坚真花园。没想到的是,楼下不远即是海珠区最大的一片城中村——东风村,其中活跃的外来人口居然多是来自我的故乡湖北天门的制衣工人或老板,很多来自老家的亲戚朋友,在其中讨生活。他们有成的有败的,满是酸甜苦辣。每每路过村里人山人海的"招工桥"去海珠湖跑步,耳边便是熟悉的乡音,看到的都是来自故乡的农民工。我会产生一丝幻觉,觉得自己是其中的一员,"漂"在这个大都市里,有着一样的苦斗。我决定,一定要为这里写点什么,要为他们做点什么。
|
||||||
|
|
||||||
|
湖北村的调查和研究系统地展开,我所指导的研究生们也完成了相关论文。这些工作,为发表在《地理研究》和《Urban Studies》上的系列成果奠定了基础。正是因为这样的情感基础和亲身接触,我对城中村问题有着自己的判断,希望能以实证支撑和强调其中所蕴含的经济、社会与文化活力,在一定程度上去除诸多城中村所面临的"污名化"问题。这样的问题,在小北路非洲人聚居区也同样存在,甚至更加严重。地理学的力量在于揭示空间差异,而我所关注的空间分异问题往往指向某些移民聚居空间所面临的歧视与误解,以及由此所产生的简单粗暴的改造、规划或拆除。对于广州保障房社区的一系列研究,也有同样的感受。因此,思想和观念上的"除魅"是这类研究的一种重要应用。
|
||||||
|
|
||||||
|
运气非常好,当时吴老师申请获得了英国ESRC所资助的一个大项目,我是项目的Co-PI, 针对北上广等地的系统的城中村调研开展起来,与华东师大宁越敏教授、北大冯健博士等的深度合作也开展起来,我对城中村的研究再上一个台阶,成果发表在了《城市规划》、《Urban Geography》等期刊上并获得了一些奖项。2013年中央提出"新型城镇化"战略,强调"人的城市化",农民工的城市融合问题是其中的一个重要方面。我一直关心的"新移民聚居区"问题,也就更加有了用武之地。结合国际上正在兴起的情感地理学研究,我将新的研究方向定位在了农民工群体的社区依恋、归属感和居住满意度等社区感知方面,以此拓展社会空间研究的分析框架。人是有七情六欲的,人与社区的情感关系是一种越来越重要的人地关系。为此,我和团队师生进一步研究了深圳富士康等各类外来人口聚居区,揭示了"归属感"和"乡愁"对于农民工群体的重要意义,甚至关系其身心健康水平。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
**湖北村与城中村研究成果**
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
**回到武大**
|
||||||
|
|
||||||
|
2015年,我回到武汉大学工作,担任城市设计学院院长。作为青年学科带头人,我开始思考如何拓展研究领域,带好科研团队、培养学生。相比珠三角的全球化、市场化和移民化特征,湖北乃至中部地区的学术"生态位"在于人口外流与输出,正好可与对东部地区的研究形成互补。进入"新时代",伴随产业发展的转型升级,回流农民工开始在湖北出现,我也开始关注他们,将目光投向家乡所在的"天门—潜江—仙桃"(所谓"天潜沔"地区)区域的回流农民工,尤其关注"回流地"的选择和"创业精神"的影响因素,从而与我在广州所做的城中村研究形成整体和回路。同时,依托武大的人文化、综合化学科优势和在数字化技术方面的领先地位,我将自己和团队的研究方向进一步落地,开始关注更为基本的科学问题:建成环境对居民健康与感知方面的影响,将其视为"人地关系"角度的城市研究新的核心任务。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
**建成环境对城乡居民健康与感知的影响研究成果**
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
在与国外学者如哈佛的Neil Brenner教授等的交流中,我发现对于发展中国家的关注度正在上升,出现了所谓后殖民批判、比较城市化、地方化(provincialization)等新动向,强调所谓"普通城市"和地方经验。原因在于,传统城市理论过于聚焦北美西欧、多将纽约等明星城市经验视为普世化的,忽略了其他城市和地区的理论潜力。这对我很有启发,因为湖北乃至武汉,更不用说中部诸多小城市,不也正是这种"地图之外"的"普通城市"吗?由此,我们一方面系统引介了这些新的理论观点,一方面开始了针对新的实证工作并尝试"理论化"工作,相关成果也将先后发表出来。
|
||||||
|
|
||||||
|
**结语**
|
||||||
|
|
||||||
|
作为青年学者,我的所谓"往事"的叙述其实是一件很"尴尬"的事,其实,人生的故事应是才刚刚开始,本文只是展现了我的成长与科研"背后"的一些事情,以便与同仁们做一个深度的分享。一路走来,从家乡到武汉,之后到南京,到英国南安普敦,到广州,再回到武汉,自己似乎完成了一段不长不短的"奥德赛"之旅。感触最深的,是这个时代所赋予的各种机会和所遇以及各种各样帮助我的人。整整一百年前,德国社会学家马克斯韦伯在其著名演讲《学术作为一种志业》中曾提出,学术生涯的成功,其实往往取决于运气。对此我深以为然,也为自己的好运而感慨。如果没有这些机缘,没有这些帮助、启发和指引,我是绝不可能取得目前这些有限但十分宝贵的科研成果的。
|
||||||
|
|
||||||
|
虽然一直漂泊在各地的"异乡",与家乡的关系也难说紧密,但我作为小镇青年的"身份认同"始终存在,也一直发挥着重要作用,影响我的研究和选择。因此,我也自信地以为,自己这些研究是一种独特的"参与观察",有自己的深度和温度。正因为这种血脉关系,服务国家和社会,应该是研究工作的天职。比如著名地理和规划学者、英国UCL大学的Peter Hall爵士,就一直致力于通过学术研究来服务英国的城市发展和建设。我觉得,这种服务可以是多种多样的,可以是参与大项目、大工程,也可以是通过一点一滴的实证以改进观念和认知。就学科而言,发展和创新是常态的,科学革命的步伐总是向前的,已有的知识体系总是会进入"过去时"。随着中国发展的深度全球化、物联网和人工智能时代的到来,城市地理研究的范式、方法和理论也会面临新的"科学革命"。作为一种讲究交叉性、综合性和系统性的学科,地理学也许会进入新的"移民"阶段,面临新的"漂"的状态。如何应对?这些年所接触的移民们已经告诉我答案:面对复杂,保持欢喜;学习、调整、适应,然后继续前进。是的,Keep Calm and Carry On。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|

|
||||||
@@ -0,0 +1,72 @@
|
|||||||
|
# 📊 文章摘要:文章背后 | 漂:聚焦城市新移民
|
||||||
|
|
||||||
|
> **原文**:[2026-08-20_文章背后_漂_聚焦城市新移民](./2026-08-20_文章背后_漂_聚焦城市新移民.md)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/gPvUj751Gz-G70_DWMl3UQ
|
||||||
|
> **来源**:微信公众平台
|
||||||
|
> **作者**:Geores(中国地理资源期刊微信平台)
|
||||||
|
> **发布日期**:2026-08-20
|
||||||
|
> **摘要日期**:2026-08-20
|
||||||
|
> **价值评级**:⭐⭐ 中
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 核心命题
|
||||||
|
|
||||||
|
> **漂泊治学** — 以自身"小镇青年—移民学者"的漂泊经历作为"参与观察",研究中国城市新移民聚居区
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 文章概要
|
||||||
|
|
||||||
|
这是中国地理资源期刊"文章背后"专栏对武汉大学城市设计学院院长李志刚教授的学术自述约稿。文章以"漂"为线索,串起他从湖北小镇到武大、南大、英国南安普敦(师从吴缚龙)、中山大学再回武大的学术旅程,以及三大研究方向的形成:中国城市居住空间分异、广州小北路非洲人聚居区与"湖北村"等城中村(移民聚居区)、回流农民工与建成环境对健康感知的影响。其认知贡献在于方法论自觉——研究者自身的移民身份即是理解研究对象的资源,"研究移民聚居区就是研究我们身处的这个特殊时代";同时为城市地理学三十年的议题变迁(分异—城中村—情感地理—健康地理)留下第一手个人史。局限是回忆性叙述,无系统方法论论证,成功叙事中时代机遇与个人努力的权重未加辨析。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 关键要点
|
||||||
|
|
||||||
|
1. **研究者的身份即方法** — 作者自认"小镇青年"身份认同是其移民研究的"独特参与观察",有"深度和温度" `[分类: 范式突破]`
|
||||||
|
2. **移民聚居区研究的时代意义** — "研究移民聚居区就是研究我们身处的这个特殊时代,就是认识和理解我们自己" `[分类: 共识]`
|
||||||
|
3. **广州小北路非洲人区的"南南流动"价值** — 中大团队最早开展研究;小北路类比纽约老唐人街,是"非正规的"但重要的中非"经济之桥"与"社会文化之桥" `[分类: 共识]`
|
||||||
|
4. **为城中村"除魅"** — 以实证强调城中村的经济、社会与文化活力,去除"污名化",反对简单粗暴的改造、规划或拆除 `[分类: 争议]`
|
||||||
|
5. **情感地理拓展** — 将研究方向转向农民工的社区依恋、归属感、居住满意度,揭示"归属感"和"乡愁"关系其身心健康 `[分类: 共识]`
|
||||||
|
6. **学术"生态位"互补** — 回湖北后研究中西部人口外流与回流农民工("天潜沔"地区),与东部移民研究形成"整体和回路" `[分类: 未探索]`
|
||||||
|
7. **"普通城市"理论化** — 受比较城市化、地方化(provincialization)启发,认为中部"地图之外"的城市具有理论潜力,反对以纽约等明星城市经验为普世 `[分类: 共识]`
|
||||||
|
8. **学科前瞻** — 物联网和人工智能时代城市地理研究将面临新"科学革命",地理学或进入新的"移民"阶段 `[分类: 未探索]`
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 批判性分析
|
||||||
|
|
||||||
|
### 假设前提
|
||||||
|
- 预设"参与观察"的主观共情是学术资产而非偏差来源;身份贴近研究对象带来的立场风险(如为城中村辩护的倾向)未被反思
|
||||||
|
- 叙事框架预设"运气+贵人"决定论(引韦伯《学术作为一种志业》),个人努力与结构性机遇的作用未作区分
|
||||||
|
|
||||||
|
### 论据与逻辑
|
||||||
|
- 第一手经历细节丰富(上海三社区调查、小北路田野、湖北村乡缘),人物、期刊、年份具体可查,史料价值高
|
||||||
|
- 但全文为回忆性自证,无文献引用与数据支撑,个别判断(如城中村活力论)在其自身论文中虽有实证,本文仅作断言
|
||||||
|
- "小北路服务一带一路国家战略"的表述带有明显的时代话语色彩,学术与政策话语交织
|
||||||
|
|
||||||
|
### 边界与局限
|
||||||
|
- 对研究方法本身(因子生态分析、社区调查设计)只有极简提及,不能当作方法论文读
|
||||||
|
- 对移民研究的困境(如非洲商人问"你的研究对我们有什么用处")点到即止,未展开回应
|
||||||
|
- 与 AI/技术主题无直接关联,对本库属于跨领域人文参考
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 可引用金句
|
||||||
|
|
||||||
|
> "研究移民聚居区就是研究我们身处的这个特殊时代,就是认识和理解我们自己。"
|
||||||
|
|
||||||
|
> "面对复杂,保持欢喜;学习、调整、适应,然后继续前进。是的,Keep Calm and Carry On。"
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 总体评价
|
||||||
|
|
||||||
|
**亮点**:一位主流城市地理学者30年学术生涯的真诚自述;"身份即方法"的参与观察自觉;小北路、湖北村等案例的中国城市研究史料价值。
|
||||||
|
|
||||||
|
**不足**:回忆体无方法论细节;成功叙事对时代红利的归因较重;政策话语与学术判断时有混同。
|
||||||
|
|
||||||
|
**适用场景**:了解中国城市地理学议题演进(空间分异→城中村→情感/健康地理);研究生学术生涯规划与选题启发;"研究者位置性(positionality)"讨论案例。
|
||||||
|
|
||||||
|
**关联建议**:文中"物联网和人工智能时代的城市研究新科学革命"可与本库 AI 相关内容互参;"参与观察"方法论对做用户研究、社会计算的 AI 团队有借鉴意义。
|
||||||
@@ -0,0 +1,48 @@
|
|||||||
|
# FDE 在中国火了,Agent 实施服务的真正考验在哪儿?
|
||||||
|
|
||||||
|
> **来源**:微信公众平台(IDC中国)
|
||||||
|
> **作者**:IDC中国(张舒,IDC中国研究经理)
|
||||||
|
> **发布日期**:2026-08-20(原文未标注明确日期,按下载日占位)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/iOkC1JMQEUu2dZeQheTZYA
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
|
||||||
|
|
||||||
|
当概念热度转化为产业动作,真正值得追问的不再是"什么是FDE",而是"什么样的FDE能力能够在市场中持续被识别、被认可、被买单"。
|
||||||
|
|
||||||
|
FDE(Forward Deployed Engineer,前沿部署工程师)正在中国经历从概念到实践的加速转化。近期,北京、武汉等地在加快智能体发展的专项政策中,相继将FDE明确为加速应用落地的创新模式;多家头部IT服务商、企业软件厂商、云厂商和大模型公司已相继设立FDE相关团队——政策推动与市场响应正在同步提速。
|
||||||
|
|
||||||
|
但热度并不等同于共识。IDC 观察到,中国 FDE 实践正在发生明显的分化:一部分服务商开始系统性地构建 FDE 能力体系——包括人才选拔标准、交付方法论、前线与后方的反馈闭环;另一部分则尚未与传统驻场交付形成实质性区隔。同一个"FDE"标签之下,能力模型、交付逻辑和商业实质可能截然不同。
|
||||||
|
|
||||||
|
这种分化并非中国市场独有的现象。IDC 在全球调研中注意到,部分 FDE 标签被用于包装并未实质改变交付逻辑的传统角色,这个词本身正在失去采购信号价值。中国市场对 FDE 的反应速度和参与热度可能是全球最快的之一,但这也意味着概念红利的窗口可能收窄得更快——当越来越多服务商都说"我们有FDE",标签本身的区分度正在衰减。真正能拉开差距的,不再是"有没有"这个岗位,而是能否说清楚自己的交付逻辑与传统的实施服务有什么实质性不同。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
## 热度之外,服务商正在面临的三重考验
|
||||||
|
|
||||||
|
FDE 的热度之下,一些更深层的结构性问题正在浮现。它们不只在单一市场出现,而是在全球范围内被反复验证——而中国市场的特殊性,又让这些问题呈现出不同的面貌。
|
||||||
|
|
||||||
|
第一重考验:技术能解决的问题,和组织接不住的结果。IDC 调研显示,全球企业实现可量化业务成果的AI项目平均占比提升至52%,值得注意的一个发现是:客户端的执行纪律、变革意愿和治理准备,往往比服务商的技术水平对落地效果的影响更为直接。这在 Agent 交付场景中尤其突出——Agent 不是部署完就结束的系统,它会在运行中持续更新,需要客户侧有人能理解、能治理、能迭代。如果服务商只管"把 Agent 部署进去"而不管"客户能不能接得住",交付效果必然受影响。在中国市场,大量企业正处于从"试试 Agent 能做什么"向"让Agent 跑在业务里"过渡的阶段,组织就绪度的缺口可能比全球平均水平更为显著。这对服务商是一个现实的选择:是否愿意且有能力帮助客户补上这一环?
|
||||||
|
|
||||||
|
第二重考验:FDE 天然要求结果导向,但商业模型准备好为此定价了吗? FDE 的工作方式是从业务结果出发定义技术方案,而非从需求规格出发推演交付计划——这使它天然倾向于对业务结果负责。然而,IDC 全球调研显示,接触过结果导向定价的客户比例在扩大,但常态化应用仍然有限——客户对定价确定性的偏好,往往走在组织能力前面。中国市场的局面更为复杂——一方面,"按效果付费"已有服务商在 Agent 交付中落地实践;另一方面,大量客户仍不愿为"理解业务"的过程买单。FDE 模式要求服务商从按人头计价的逻辑中走出来,但定价能力、客户接受度和内部核算体系之间的结构性矛盾,尚未被充分讨论。
|
||||||
|
|
||||||
|
第三重考验:Agent 实施服务是 FDE 当前在中国被推向台前的场景,而不是它的来源——这块拼图要嵌入一个新版图,适配和重构是绕不开的。FDE 的火热,本质上回应的是一个市场困境:当 Agent 从"试试看"进入"真正跑在业务里",传统实施服务的交付逻辑不够用了。需求在现场共同发现,效果在持续运行中验证,知识需要从前线反哺平台——FDE 站在这个变化的交叉点上。但它不是全部。一个服务商能否做好 Agent 交付,还要看行业深耕能力、方法论成熟度、持续运营体系等多个维度是否完整。IDC 全球研究也提示:FDE 活动范围之外的工作——治理、变革、流程再设计——恰恰是组织缺乏准备的环节。单点能力难以回答系统性问题,市场需要的是一个能够系统评估和比较 Agent 实施服务能力的参照框架。
|
||||||
|
|
||||||
|
FDE 在中国的故事刚刚开始。真正重要的,不是谁能最快喊出这个概念,而是谁能把它变成客户可感知、可验证的交付能力。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
**本文作者**:
|
||||||
|
|
||||||
|
张舒
|
||||||
|
|
||||||
|
IDC中国研究经理
|
||||||
|
|
||||||
|
## 进一步交流
|
||||||
|
|
||||||
|
FDE 是 Agent 实施服务能力的一个观察切口,但远不是全部。架构设计、行业知识、治理机制、变革管理、持续运营——每一个维度都在影响最终交付质量。这正是 IDC 正在开展的《IDC MarketScape:中国 Agent 实施服务厂商评估,2026》研究所试图回应的需求。该研究将从多个维度对中国市场主要服务商的 Agent 实施服务能力进行系统性评估,旨在为行业用户和服务商提供一个完整的能力参照。更多信息,欢迎关注 IDC,也欢迎具备 Agent 实施服务能力的厂商与我们联系交流。
|
||||||
|
|
||||||
|
## 免责声明
|
||||||
|
|
||||||
|
本文中的内容和数据均来源于IDC所发布的报告,所有内容及数据均为我公司所有。未经IDC书面许可,任何机构和个人不得以任何形式翻版、复制、刊登、发表或引用。
|
||||||
@@ -0,0 +1,72 @@
|
|||||||
|
# 📊 文章摘要:FDE 在中国火了,Agent 实施服务的真正考验在哪儿?
|
||||||
|
|
||||||
|
> **原文**:[2026-08-20_FDE_在中国火了_Agent_实施服务的真正考验在哪儿](./2026-08-20_FDE_在中国火了_Agent_实施服务的真正考验在哪儿.md)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/iOkC1JMQEUu2dZeQheTZYA
|
||||||
|
> **来源**:微信公众平台
|
||||||
|
> **作者**:IDC中国(张舒,IDC中国研究经理)
|
||||||
|
> **发布日期**:2026-08-20
|
||||||
|
> **摘要日期**:2026-08-20
|
||||||
|
> **价值评级**:⭐⭐⭐ 高
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 核心命题
|
||||||
|
|
||||||
|
> **FDE分化** — FDE 标签正在通胀,中国 Agent 实施服务的真正分水岭不在"有没有 FDE 岗位",而在交付逻辑是否与传统驻场实施形成实质差异,能否被客户识别、验证并为之定价。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 文章概要
|
||||||
|
|
||||||
|
IDC 中国研究经理张舒撰文剖析 FDE(Forward Deployed Engineer,前沿部署工程师)在中国的概念落地与实质分化:北京、武汉专项政策已将 FDE 列为加速智能体落地的创新模式,头部 IT 服务商、云厂商、大模型公司纷纷设立 FDE 团队,但同一标签下能力模型与商业实质可能截然不同,部分只是传统驻场交付的包装。文章提出服务商面临的三重结构性考验——客户组织"接不住"技术交付的结果、结果导向定价与按人头计价体系的结构性矛盾、FDE 只是 Agent 实施服务版图的一块拼图——并预告 IDC MarketScape 中国 Agent 实施服务厂商评估(2026)。对 Agent 交付从业者,这是目前少见的清醒去泡沫分析。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 关键要点
|
||||||
|
|
||||||
|
1. **FDE 标签正在失去采购信号价值** — IDC 全球调研发现部分 FDE 标签被用于包装未实质改变交付逻辑的传统角色;中国市场热度全球最快,概念红利窗口也可能收窄最快。 `[分类: 争议]`
|
||||||
|
2. **中国 FDE 实践已现真分化** — 一部分服务商系统性构建 FDE 能力体系(人才选拔标准、交付方法论、前线与后方反馈闭环),另一部分与传统驻场交付无实质区隔。 `[分类: 共识]`
|
||||||
|
3. **第一重考验:组织就绪度比技术更决定落地效果** — IDC 调研:可量化业务成果的 AI 项目平均占比升至 52%;客户端执行纪律、变革意愿、治理准备对落地的影响往往比服务商技术水平更直接。 `[分类: 争议]`
|
||||||
|
4. **Agent 是持续运营系统而非交付即结束的项目** — Agent 在运行中持续更新,需要客户侧有人能理解、能治理、能迭代;服务商必须回答"是否愿意且有能力帮客户补上这一环"。 `[分类: 共识]`
|
||||||
|
5. **第二重考验:结果导向定价的结构性矛盾** — FDE 从业务结果出发定义方案、天然倾向对结果负责,但客户对定价确定性的偏好走在组织能力前面;大量客户仍不愿为"理解业务"的过程买单。 `[分类: 共识]`
|
||||||
|
6. **第三重考验:FDE 是拼图不是全景** — 行业深耕、方法论成熟度、持续运营体系缺一不可;IDC 全球研究提示治理、变革、流程再设计恰是组织最缺准备的环节。 `[分类: 共识]`
|
||||||
|
7. **系统评估框架呼之欲出** — 《IDC MarketScape:中国 Agent 实施服务厂商评估,2026》将多维度评估主要服务商能力,为买卖双方提供参照。 `[分类: 未探索]`
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 批判性分析
|
||||||
|
|
||||||
|
### 假设前提
|
||||||
|
- 预设 FDE(源自 Palantir 的组织形态)是 Agent 落地的有效载体,未讨论 FDE 高人力投入模式在中国软件服务价格体系下的经济可行性。
|
||||||
|
- "组织就绪度决定论"建立在 IDC 调研数据之上,但调研样本、口径与"52%"的统计边界未披露。
|
||||||
|
|
||||||
|
### 论据与逻辑
|
||||||
|
- 三重考验是分析框架而非实证结论:每重考验有全球调研的间接佐证(占比数据、定价观察),但中国市场证据以定性观察为主(政策列举、"已有服务商落地实践"无具体案例)。
|
||||||
|
- 文章自身是 IDC MarketScape 评估的预热动员文(文末明确邀请厂商联系交流),"市场需要参照框架"的论断与 IDC 售卖评估报告的商业动机存在利益关联,读时需打折扣。
|
||||||
|
|
||||||
|
### 边界与局限
|
||||||
|
- 未给出 FDE 能力体系的可操作定义(何为"实质性不同"缺乏判据),结论停留在"要能说清楚"层面。
|
||||||
|
- 三重考验均从服务商视角出发,客户侧视角(如何自评组织就绪度)未展开。
|
||||||
|
- FDE 与传统实施服务在人天成本、项目周期上的量化对比缺失。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 可引用金句
|
||||||
|
|
||||||
|
> "真正重要的,不是谁能最快喊出这个概念,而是谁能把它变成客户可感知、可验证的交付能力。"
|
||||||
|
|
||||||
|
> "客户端的执行纪律、变革意愿和治理准备,往往比服务商的技术水平对落地效果的影响更为直接。"
|
||||||
|
|
||||||
|
> "Agent 不是部署完就结束的系统,它会在运行中持续更新,需要客户侧有人能理解、能治理、能迭代。"
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 总体评价
|
||||||
|
|
||||||
|
**亮点**:对 FDE 概念泡沫的清醒判断在一片追捧中稀缺;三重考验框架(组织就绪度/定价模型/能力版图)结构清晰且互相咬合;明确指出标签通胀的全球普遍性而非仅中国现象。
|
||||||
|
|
||||||
|
**不足**:中国市场的实证案例与数据薄弱;FDE 能力体系无可操作判据;文章兼作 IDC 评估报告的预热营销。
|
||||||
|
|
||||||
|
**适用场景**:软件服务商制定 Agent 实施业务战略(是否设 FDE、如何定价、如何构建交付方法论)的直接参考;企业客户评估 Agent 实施服务商的提问清单;AI 服务转型研讨素材。
|
||||||
|
|
||||||
|
**关联建议**:与本院 Agent 交付能力建设直接相关——三重考验可作为我司 Agent 实施服务能力自评框架(组织就绪度评估服务、结果导向定价试点、方法论与持续运营体系);另与《Jonex × WorkBuddy》对照可见 Agent 交付的"产品派"(工具链)与"服务派"(FDE)两条路径。
|
||||||
@@ -0,0 +1,268 @@
|
|||||||
|
# 从 OpenCode 升级到 V2,我们看到上下文工程与驾驭工程的三个趋势
|
||||||
|
|
||||||
|
> **来源**:微信公众平台(Kerry)
|
||||||
|
> **作者**:Kerry
|
||||||
|
> **发布日期**:2026-08-20(原文未标注明确日期,按下载日占位)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/2u4ntl_2HZ7-iV-aHBrV8A
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
|
||||||
|
|
||||||
|
(参考:https://opencode.ai/v2/docs)
|
||||||
|
|
||||||
|
2026年7月,OpenCode 悄然上线了V2 beta。
|
||||||
|
|
||||||
|
如果你只是把它当作"又一个工具的版本更新"来浏览,你会看到:运行时从 Bun 换到了 Node,Desktop 从 Tauri 换到了 Electron,Plugin API 全部重写,配置字段大量重命名。这些是表面变化。
|
||||||
|
|
||||||
|
但如果你带着一个问题去读它的文档——**"这个工具的设计者认为,驾驭一个 AI Agent 最难的事情是什么?"**——你会看到一些更深层的东西。
|
||||||
|
|
||||||
|
V2 的每一个重大设计决策,都在回答同一个问题:**当 Agent 的能力越来越强,人类如何既充分利用它,又不失去对它的控制?**
|
||||||
|
|
||||||
|
答案藏在四个变化里:Permission 变成有序规则数组、Plugin 获得 transform + runtime 双层能力、Compaction 变成带版本号的 checkpoint 机制、Instructions 引入 durable deltas 和 epoch 概念。
|
||||||
|
|
||||||
|
这四个变化,恰好对应了上下文工程和驾驭工程的三个发展趋势。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 趋势一:从配置到策略——Permission的有序规则数组
|
||||||
|
|
||||||
|
### V1 的样子
|
||||||
|
|
||||||
|
V1 的 permission 是一个按工具分组的对象:
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
这个设计的问题在于:**当多条规则可能同时匹配时,谁优先?** V1 没有给出明确答案。规则之间的优先级是隐式的、依赖实现的、不可预测的。
|
||||||
|
|
||||||
|
### V2 的样子
|
||||||
|
|
||||||
|
V2 把 permission 变成了一个**有序数组**,每条规则有三个字段:`action`、`resource`、`effect`:
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
官方文档给出了明确的语义:**"The last matching rule wins."**(最后匹配的规则生效。)
|
||||||
|
|
||||||
|
这看起来只是一个数据结构的变化,但它代表了一个根本性的思维转变:
|
||||||
|
|
||||||
|
| | V1 | V2 |
|
||||||
|
| --- | --- | --- |
|
||||||
|
| 思维模型 | "给工具设置开关" | "编写策略规则" |
|
||||||
|
| 优先级 | 隐式、依赖实现 | 显式、last-match-wins |
|
||||||
|
| 可组合性 | 对象合并,冲突不可预测 | 数组追加,顺序决定一切 |
|
||||||
|
| Agent 级规则 | 替换全局规则 | **追加** 在全局规则之后 |
|
||||||
|
|
||||||
|
最后一点尤其重要。V2 明确说:
|
||||||
|
|
||||||
|
> "Global permissions are applied to every agent before its agent-specific rules, so a later agent rule can refine a global rule." [ref:agents]
|
||||||
|
|
||||||
|
这意味着你可以写一套全局策略(比如"所有 shell 命令默认 ask"),然后给特定 agent 追加更细的规则(比如"reviewer agent 的 git diff 直接 allow"),而不用担心 agent 规则会覆盖全局规则。
|
||||||
|
|
||||||
|
**这就是"策略即代码"(Policy as Code)的思路**——和 Kubernetes 的 RBAC、AWS IAM 的 policy evaluation 逻辑如出一辙。
|
||||||
|
|
||||||
|
### 这个趋势意味着什么?
|
||||||
|
|
||||||
|
驾驭工程正在从"给 Agent 配几个开关"走向"为 Agent 编写可审计、可组合、可预测的策略体系"。
|
||||||
|
|
||||||
|
当我们团队有 5 个不同的 agent(build、plan、reviewer、explorer、deployer),每个 agent 有不同的权限边界时,我们需要的不是 5 份独立的配置,而是**一套分层的策略系统**:全局策略 + agent 级追加规则 + 显式的优先级语义。
|
||||||
|
|
||||||
|
V2 的 permission 数组就是这个思路的雏形。
|
||||||
|
|
||||||
|
### 一个容易被忽略的细节
|
||||||
|
|
||||||
|
V2 文档中有一句非常诚实的话:
|
||||||
|
|
||||||
|
> "Shell runs with the host user's filesystem, process, and network authority. Its resource is raw text, not a parsed command. [...] Prefer a narrow shell allowlist over patterns intended to identify every dangerous command."
|
||||||
|
|
||||||
|
翻译过来就是:**shell 命令是原始文本,不是结构化命令,我们不可能通过模式匹配识别所有危险命令。与其写黑名单,不如写白名单。**
|
||||||
|
|
||||||
|
这句话暴露了驾驭工程的一个根本困境:**你无法穷举所有危险操作**。所以正确的策略不是"列出所有不能做的事",而是"只列出允许做的事"。
|
||||||
|
|
||||||
|
这正是我们常强调的原则:**红线用 deny 硬执行,白名单用 allow 放行,其余全部 ask。** V2 的设计把这个原则变成了配置层面的默认行为。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 趋势二:从回调函数到组合式中间件——Plugin的双层能力
|
||||||
|
|
||||||
|
### V1的Plugin能做什么?
|
||||||
|
|
||||||
|
V1的plugin本质上是一组回调函数:
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
它能做的事情有限:在工具执行前后拦截、注入环境变量、订阅事件。**它无法修改 Agent 的定义、无法修改模型请求、无法添加工具。**
|
||||||
|
|
||||||
|
### V2 的 Plugin 能做什么
|
||||||
|
|
||||||
|
V2 把 plugin 能力分成了两层:**Transform hooks**(修改配置)和 **Runtime hooks**(拦截运行时操作)。
|
||||||
|
|
||||||
|
**Transform hooks** 让我们修改 OpenCode 的配置本身:
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
**Runtime hooks**让我们在运行时拦截操作。其中最强大的一个是`ctx.session.hook("context")`:
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
```
|
||||||
|
这个hook让我们可以在模型请求发出之前,修改system prompt、消息列表、工具集。
|
||||||
|
```
|
||||||
|
|
||||||
|
### 为什么这很重要?
|
||||||
|
|
||||||
|
在 V1 中,如果我们想让某个agent不能使用某个工具,只有两个选择:
|
||||||
|
|
||||||
|
1. 在 permission 里 deny 那个工具(但 agent 仍然"知道"这个工具存在,只是被拒绝)
|
||||||
|
2. 在 AGENTS.md 里写"不要使用这个工具"(但 agent 可能忽略)
|
||||||
|
|
||||||
|
在 V2 中,我们可以**直接从模型请求中删除这个工具**。模型根本不知道这个工具存在。这不是"拒绝",这是"不存在"。
|
||||||
|
|
||||||
|
**这是驾驭工程的一个质的飞跃:从"告诉 Agent 不要做什么"到"让 Agent 根本不知道可以做什么"。**
|
||||||
|
|
||||||
|
### 更深层的设计:Hook failure fails the operation
|
||||||
|
|
||||||
|
V2 文档中有一句关键的话:
|
||||||
|
|
||||||
|
> "A hook failure fails the operation it intercepts." [ref:plugins]
|
||||||
|
|
||||||
|
这意味着:如果plugin hook 抛出异常,**被拦截的操作会直接失败**。不是"记录一条日志然后继续",而是"操作被阻断"。
|
||||||
|
|
||||||
|
这给了我们一个非常重要的能力:**用 plugin 实现硬性门禁**。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
在 V1 中,`tool.execute.before` 抛出异常也能阻断操作,但 V2 把这个行为**明确写进了文档**,并且扩展到了 HTTP 请求/响应层面。这意味着你可以在**模型请求发出之前**就拦截不合规的请求,而不仅仅是在工具执行时拦截。
|
||||||
|
|
||||||
|
### 这个趋势意味着什么?
|
||||||
|
|
||||||
|
驾驭工程正在从"在Agent外面包一层防护"走向"把防护逻辑嵌入 Agent 的执行管线"。
|
||||||
|
|
||||||
|
- V1 的plugin像是在 Agent 外面装了一个监控摄像头——它能看到 Agent 做了什么,但很难阻止 Agent 做什么。
|
||||||
|
- V2 的plugin像是在 Agent 的执行管线里插入了一组**可编程的阀门**——你可以在任何一个环节关闭阀门,让后续的操作根本不会发生。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 趋势三:从"遗忘"到"有版本的状态管理"
|
||||||
|
|
||||||
|
### V1 的Compaction
|
||||||
|
|
||||||
|
V1 的compaction是一个相对简单的机制:当上下文快满时,把旧消息压缩成一段摘要,保留最近几轮对话。
|
||||||
|
|
||||||
|
问题是:**压缩之后,之前注入的指令(比如 AGENTS.md 里的红线)还在不在?** V1 没有给出明确答案。实践中,很多团队发现compaction之后Agent 开始"忘记"关键约束。
|
||||||
|
|
||||||
|
### V2 的Compaction:Checkpoint 机制
|
||||||
|
|
||||||
|
V2 把compaction重新设计为**checkpoint机制**:
|
||||||
|
|
||||||
|
> "Compaction replaces the active model context from an older part of a session with a generated checkpoint. The checkpoint contains a structured summary and a serialized tail of recent context." [ref:compaction]
|
||||||
|
|
||||||
|
Checkpoint 包含两部分:
|
||||||
|
|
||||||
|
1. **结构化摘要:目标、重要细节、已完成和进行中的工作、阻塞项、下一步、相关文件**
|
||||||
|
2. **序列化的最近上下文尾部:保留最近 keep.tokens(默认 15000)个token的原始对话**
|
||||||
|
|
||||||
|
更关键的是,V2引入了**上下文溢出自动恢复**:
|
||||||
|
|
||||||
|
> "If an overflow occurs before the provider produces assistant output, V2 can compact and retry that step once." [ref:compaction]
|
||||||
|
|
||||||
|
也就是说,如果模型返回"context overflow"错误,V2会**自动compact并重试一次**。这在 V1 中是不存在的。
|
||||||
|
|
||||||
|
### Instruction Epoch:上下文工程的"版本号"
|
||||||
|
|
||||||
|
这是 V2 最精妙的设计之一。
|
||||||
|
|
||||||
|
V2 把instructions(AGENTS.md 等)的变更存储为**durable deltas**(持久化增量):
|
||||||
|
|
||||||
|
> "It stores source values as durable deltas, then renders initial instructions and chronological updates when assembling each model request." [ref:instructions]
|
||||||
|
|
||||||
|
每次compaction完成后,**instruction epoch推进**:
|
||||||
|
|
||||||
|
> "Completed compaction advances the instruction epoch, making the currently admitted values initial without rereading sources or authoring an instruction event." [ref:compaction]
|
||||||
|
|
||||||
|
翻译成人话:
|
||||||
|
|
||||||
|
- Compaction之前,instructions 是"初始值 + 一系列增量变更"
|
||||||
|
- Compaction之后,当前已准入的值变成新的"初始值",之前的增量历史被折叠
|
||||||
|
- 下次请求装配时,从新的初始值开始渲染
|
||||||
|
|
||||||
|
**这本质上是给上下文引入了"版本号"的概念。**
|
||||||
|
|
||||||
|
### 为什么这很重要?
|
||||||
|
|
||||||
|
在 V1 中,上下文管理是一个"黑箱":我们不知道compaction之后哪些信息还在、哪些丢了,我们只能祈祷关键约束没被压缩掉。
|
||||||
|
|
||||||
|
在 V2 中,上下文管理变成了一个**有版本、有增量、有明确语义的状态系统**:
|
||||||
|
|
||||||
|
| 概念 | 类比 | 作用 |
|
||||||
|
| --- | --- | --- |
|
||||||
|
| Durable deltas | Git commit | 记录每次 instruction 变更 |
|
||||||
|
| Instruction epoch | Git tag / release | 标记 compaction 边界 |
|
||||||
|
| Checkpoint | Git snapshot | 保存当前状态的完整快照 |
|
||||||
|
| 请求装配 | Git checkout | 从特定版本重建完整上下文 |
|
||||||
|
|
||||||
|
### Nested AGENTS.md:按需加载的上下文
|
||||||
|
|
||||||
|
V2 还引入了一个 V1 没有的机制:**嵌套 AGENTS.md 的按需发现**。
|
||||||
|
|
||||||
|
> "An AGENTS.md below the Location is not part of the initial upward scan. When the read tool successfully reads a file or lists a directory, OpenCode discovers AGENTS.md files from that target upward to, but not including, the Location." [ref:instructions]
|
||||||
|
|
||||||
|
也就是说:位于当前工作目录**之下**的 AGENTS.md,不会在启动时加载。只有当 Agent 用 `read` 工具读到那个目录时,才会被发现并注入。
|
||||||
|
|
||||||
|
**这是上下文工程的一个重大进步:上下文不再是一次性全量加载的,而是按需、动态、增量装配的。**
|
||||||
|
|
||||||
|
它解决了上下文工程的一个核心矛盾:
|
||||||
|
|
||||||
|
- 想让 Agent 知道所有规则(完整性)
|
||||||
|
- 但不希望所有规则同时占用上下文窗口(效率)
|
||||||
|
|
||||||
|
嵌套发现机制的回答是:**只在 Agent 真正需要的时候,才注入相关的规则。**
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 一个意外但重要的变化:Undo 与 Snapshots
|
||||||
|
|
||||||
|
V2 还引入了一个看起来和上下文工程无关、但实际上非常重要的功能:**基于 Git 的 per-step 快照和 Undo/Redo**。
|
||||||
|
|
||||||
|
> "For each model step, OpenCode attempts to capture the worktree immediately before the model call and after a cleanly completed step." [ref:snapshots]
|
||||||
|
|
||||||
|
这意味着 Agent 的每一步操作都被快照了。我们可以用 `/undo` 回滚到任意一步之前的状态,包括文件内容和对话历史。
|
||||||
|
|
||||||
|
**这给 Agent 的动作引入了"事务语义"**:每一步操作要么完整执行、要么可以完整回滚。
|
||||||
|
|
||||||
|
在驾驭工程的语境下,这是一个重要的安全网:即使 Agent 做了错误的事情,我们也可以一键回滚,而不需要手动修复。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 总结:三个趋势,一个方向
|
||||||
|
|
||||||
|
把这三个趋势放在一起看,我们会发现它们指向同一个方向:
|
||||||
|
|
||||||
|
| 趋势 | V1 的做法 | V2 的做法 | 本质变化 |
|
||||||
|
| --- | --- | --- | --- |
|
||||||
|
| **策略化** | 给工具设开关 | 编写有序策略规则 | 从"配置"到"策略即代码" |
|
||||||
|
| **管线化** | 在 Agent 外面包防护 | 把防护嵌入执行管线 | 从"监控"到"可编程阀门" |
|
||||||
|
| **版本化** | 上下文是黑箱 | 上下文有版本、有增量、有 epoch | 从"祈祷不丢"到"确定性状态管理" |
|
||||||
|
|
||||||
|
这三个趋势合在一起,指向一个结论:
|
||||||
|
|
||||||
|
> **驾驭 AI Agent 正在从"提示工程"走向"系统工程"。**
|
||||||
|
|
||||||
|
在提示工程时代,我们通过写好的 prompt 来引导 Agent,控制手段是"说清楚"。
|
||||||
|
|
||||||
|
在系统工程时代,我们通过策略规则、执行管线、状态版本来驾驭 Agent。控制手段是"让它不能不知道、不能做、做了也能回滚"。
|
||||||
|
|
||||||
|
OpenCode V2 不是第一个走这条路的工具,但它是目前**把这三件事做得最完整、最公开的开源实现**。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## OpenCode V2 目前还是 beta。官方明确说"we may wipe your data, things may break, and APIs may change"。
|
||||||
|
|
||||||
|
但它的**设计方向**是清晰的。即使 V2 的 API 还会变化,它背后的三个趋势——策略化、管线化、版本化——不会变。
|
||||||
|
|
||||||
|
因为这三个趋势不是 OpenCode 发明的,而是整个行业在驾驭 AI Agent 的过程中,一步一步摸索出来的。
|
||||||
|
|
||||||
|
OpenCode V2 只是把它们写成了代码。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
---
|
||||||
@@ -0,0 +1,77 @@
|
|||||||
|
# 📊 文章摘要:从 OpenCode 升级到 V2,我们看到上下文工程与驾驭工程的三个趋势
|
||||||
|
|
||||||
|
> **原文**:[2026-08-20_从_OpenCode_升级到_V2_我们看到上下文工程与驾驭工程的三个趋势](./2026-08-20_从_OpenCode_升级到_V2_我们看到上下文工程与驾驭工程的三个趋势.md)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/2u4ntl_2HZ7-iV-aHBrV8A
|
||||||
|
> **来源**:微信公众平台
|
||||||
|
> **作者**:Kerry
|
||||||
|
> **发布日期**:2026-08-20
|
||||||
|
> **摘要日期**:2026-08-20
|
||||||
|
> **价值评级**:⭐⭐⭐ 高
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 核心命题
|
||||||
|
|
||||||
|
> **系统驾驭** — 驾驭 AI Agent 正从"提示工程"走向以策略化、管线化、版本化为特征的"系统工程"
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 文章概要
|
||||||
|
|
||||||
|
作者以"驾驭一个 AI Agent 最难的事情是什么"为透镜解读 OpenCode V2 beta 的官方文档,将四个重大设计变化(Permission 有序规则数组、Plugin 双层 hook、Compaction checkpoint 机制、Instructions durable deltas + epoch)归纳为上下文工程与驾驭工程的三个趋势:策略化(Policy as Code)、管线化(防护嵌入执行管线)、版本化(上下文确定性状态管理),并额外分析了 per-step Git 快照带来的"事务语义"。文章论据以 V2 官方文档原文引用为主(均标注 [ref:xxx]),框架提炼清晰且可迁移到任何自研 Agent 框架的设计评审。局限是部分代码示例仅为截图(文中未能呈现),且三个趋势的归纳是作者个人解读而非 OpenCode 官方立场。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 关键要点
|
||||||
|
|
||||||
|
1. **Permission 从对象变为有序规则数组** — "The last matching rule wins" 显式优先级,agent 级规则追加而非替换全局规则,等同 Kubernetes RBAC / AWS IAM 的策略即代码思路 `[分类: 共识]`
|
||||||
|
2. **白名单优于黑名单的根本困境** — 官方文档承认 shell 命令是原始文本、无法模式匹配识别所有危险命令;正确策略是"红线 deny、白名单 allow、其余 ask" `[分类: 共识]`
|
||||||
|
3. **Plugin 双层能力:Transform hooks + Runtime hooks** — 可在模型请求发出前修改 system prompt、消息列表、工具集,"直接从模型请求中删除工具",从"告诉 Agent 不要做"升级为"让 Agent 根本不知道" `[分类: 范式突破]`
|
||||||
|
4. **Hook failure fails the operation** — hook 抛异常则被拦截操作直接失败(而非记日志继续),可用来实现模型请求层面的硬性门禁 `[分类: 共识]`
|
||||||
|
5. **Compaction 变为 checkpoint 机制** — 结构化摘要(目标/阻塞项/下一步等)+ 最近 keep.tokens(默认 15000)token 原始对话尾部;上下文溢出时自动 compact 并重试一次 `[分类: 共识]`
|
||||||
|
6. **Instruction Epoch = 上下文版本号** — instructions 以 durable deltas 存储,compaction 后 epoch 推进、增量历史折叠为新的初始值,类比 Git commit/tag/snapshot/checkout `[分类: 范式突破]`
|
||||||
|
7. **嵌套 AGENTS.md 按需发现** — 工作目录之下的 AGENTS.md 不在启动时加载,read 工具触及时才注入,化解"完整性 vs 效率"矛盾 `[分类: 共识]`
|
||||||
|
8. **Per-step Git 快照引入事务语义** — 每个模型步骤前后捕获 worktree,/undo 可回滚文件与对话历史,构成驾驭工程的安全网 `[分类: 未探索]`
|
||||||
|
9. **三趋势合一的判断** — 控制手段从"说清楚"(prompt)变为"让它不能不知道、不能做、做了也能回滚"(策略+管线+版本) `[分类: 争议]`
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 批判性分析
|
||||||
|
|
||||||
|
### 假设前提
|
||||||
|
- 预设 OpenCode V2 的设计文档诚实完备,且其设计动机可以代表"行业趋势"(作者也承认趋势非 OpenCode 独创,但未给出其他工具的平行例证)
|
||||||
|
- 预设"更强的结构性控制"必然优于"提示式引导",未讨论策略体系过重对个人开发者的负担
|
||||||
|
|
||||||
|
### 论据与逻辑
|
||||||
|
- 核心论据全部来自 V2 官方文档的直接引用且标注出处([ref:agents]/[ref:plugins]/[ref:compaction]/[ref:instructions]/[ref:snapshots]),可验证性强
|
||||||
|
- V1 的问题描述(优先级隐式、上下文黑箱)与 V2 文档相互印证,对比逻辑成立
|
||||||
|
- "三个趋势"是作者强加的解释框架:V2 团队未必以此命名设计意图;趋势概括有事后合理化风险;Git 类比(epoch=tag)是修辞性近似而非严格同构
|
||||||
|
- "V1 中很多团队发现 compaction 后忘记关键约束"为经验性断言,无出处
|
||||||
|
|
||||||
|
### 边界与局限
|
||||||
|
- 文中代码示例全部以截图形式存在,文字版缺失,读者无法直接复用配置片段
|
||||||
|
- V2 处于 beta,官方明言 API 可能变化,文章结论的时效性受限(作者已自我声明)
|
||||||
|
- 未讨论性能代价:per-step 快照、durable deltas、每请求装配的开销未评估
|
||||||
|
- 未与 Claude Code、Cursor 等同类工具的等价机制对比,"做得最完整、最公开"的断言依据不足
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 可引用金句
|
||||||
|
|
||||||
|
> "驾驭 AI Agent 正在从'提示工程'走向'系统工程'。"
|
||||||
|
|
||||||
|
> "控制手段是'让它不能不知道、不能做、做了也能回滚'。"
|
||||||
|
|
||||||
|
> "这不是'拒绝',这是'不存在'。"
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 总体评价
|
||||||
|
|
||||||
|
**亮点**:以官方文档为据的深度解读,证据链完整可验证;"策略化/管线化/版本化"三趋势框架高度可迁移;对 Permission、epoch、嵌套 AGENTS.md 等机制的语义阐释精准。
|
||||||
|
|
||||||
|
**不足**:代码示例仅截图无文字;三趋势框架属作者个人归纳未经官方确认;缺少性能开销与竞品横向对比。
|
||||||
|
|
||||||
|
**适用场景**:自研 Agent 框架/内部 coding agent 的权限系统与上下文管理设计评审;制定团队 Agent 安全基线(deny/allow/ask);理解 compaction 语义演进的参考读物。
|
||||||
|
|
||||||
|
**关联建议**:与《我复刻了 Claude 刚发布的生成式 UI 交互!》互补阅读(输出端渲染 vs 驾驭端工程);其 Permission 思想可对照本库 Claude Code hooks/permissions 实践;"上下文版本化"可关联本会话的上下文压缩(compaction)机制讨论。
|
||||||
@@ -0,0 +1,268 @@
|
|||||||
|
# vLLM PD 分离
|
||||||
|
|
||||||
|
> **来源**:微信公众平台
|
||||||
|
> **作者**:marcus
|
||||||
|
> **发布日期**:2026-08-05(原文未标注日期,按下载日占位)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/p6gh4hK25PujQ1UJzFTbLg
|
||||||
|
|
||||||
|
> 本文是 vLLM 基于 Mooncake Connector 实现 PD 分离的源码级机制剖析,覆盖 Proxy 层、请求传递、Scheduler 调度(P producer / D consumer)、Worker 层 RDMA KV Cache 传输、传输后恢复执行、完整时序与关键设计要点。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 一、Proxy 层:同一份 Prompt 同时发给 P 和 D
|
||||||
|
|
||||||
|
**是的,Proxy 会把原始 prompt 同时发给 Prefill 和 Decode 节点**,但携带不同的 `kv_transfer_params` 标志:
|
||||||
|
|
||||||
|
```
|
||||||
|
Client Prompt "Hello, how are you?"
|
||||||
|
│
|
||||||
|
▼
|
||||||
|
mooncake_connector_proxy.py
|
||||||
|
│
|
||||||
|
┌────┴────┐
|
||||||
|
▼ ▼
|
||||||
|
Prefill Decode
|
||||||
|
节点 节点
|
||||||
|
```
|
||||||
|
|
||||||
|
**发给 Prefill 节点**(`send_request_to_service`, 第 250–280 行):
|
||||||
|
|
||||||
|
```
|
||||||
|
req_data["kv_transfer_params"] = {
|
||||||
|
"do_remote_decode": True, # ← "我是 P,算完把 KV 传出去"
|
||||||
|
"do_remote_prefill": False,
|
||||||
|
"transfer_id": f"xfer-{request_id}",
|
||||||
|
}
|
||||||
|
req_data["max_tokens"] = 1 # ← 只算 1 个 token 就停
|
||||||
|
req_data["stream"] = False # ← 不等流式返回
|
||||||
|
```
|
||||||
|
|
||||||
|
以 `asyncio.create_task` fire-and-forget 发送,不等结果。
|
||||||
|
|
||||||
|
**发给 Decode 节点**(`stream_service_response`, 第 283–312 行):
|
||||||
|
|
||||||
|
```
|
||||||
|
req_data["kv_transfer_params"] = {
|
||||||
|
"do_remote_decode": False,
|
||||||
|
"do_remote_prefill": True, # ← "我是 D,从远端的 P 拉 KV Cache"
|
||||||
|
"remote_bootstrap_addr": ..., # ← P 的 bootstrap 地址
|
||||||
|
"remote_engine_id": ..., # ← P 的 Mooncake engine ID(含 DP rank)
|
||||||
|
"transfer_id": f"xfer-{request_id}",
|
||||||
|
}
|
||||||
|
```
|
||||||
|
|
||||||
|
以流式方式等待返回,逐 chunk 回传客户端。
|
||||||
|
|
||||||
|
**每个请求都有唯一的 `transfer_id`(UUID)**——这是 P 和 D 两端关联同一次 KV Cache 传输的关键标识。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 二、请求进入引擎:`kv_transfer_params` 的传递路径
|
||||||
|
|
||||||
|
```
|
||||||
|
Proxy → API Server (SamplingParams.extra_args)
|
||||||
|
→ EngineCoreRequest
|
||||||
|
→ Request.__init__() 提取 kv_transfer_params
|
||||||
|
→ Scheduler 调度
|
||||||
|
→ MooncakeConnector 处理
|
||||||
|
```
|
||||||
|
|
||||||
|
在 `vllm/v1/request.py` 第 116–119 行:
|
||||||
|
|
||||||
|
```
|
||||||
|
if sampling_params.extra_args is not None:
|
||||||
|
self.kv_transfer_params = sampling_params.extra_args.get(
|
||||||
|
"kv_transfer_params"
|
||||||
|
)
|
||||||
|
```
|
||||||
|
|
||||||
|
`kv_transfer_params` 作为 Request 对象的属性一直保留,供 Scheduler 和 KVConnector 使用。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 三、Scheduler 调度层:区分本地计算和远程 KV 加载
|
||||||
|
|
||||||
|
这是 PD 分离最核心的逻辑,在 `vllm/v1/core/sched/scheduler.py` 的 `schedule()` 方法中。
|
||||||
|
|
||||||
|
### 3.1 Prefill 节点 (is_kv_producer) 的调度
|
||||||
|
|
||||||
|
当 `do_remote_decode=True` 时:
|
||||||
|
|
||||||
|
1. **`get_num_new_matched_tokens`**(MooncakeConnectorScheduler 第 712–755 行):返回 `(0, False)`——P 节点不需要加载任何外部 KV,正常计算 prompt。
|
||||||
|
2. **`update_state_after_alloc`**(第 757–805 行):记录该请求需要将 KV Cache 发送出去:
|
||||||
|
```
|
||||||
|
elif params.get("do_remote_decode"):
|
||||||
|
self._reqs_need_send[request.request_id] = (request, [])
|
||||||
|
```
|
||||||
|
3. **`request_finished`**(第 838–892 行):当请求完成时(只生成了 1 个 token),不立即释放 block,而是标记为需要异步发送:
|
||||||
|
```
|
||||||
|
if delay_free_blocks:
|
||||||
|
self._reqs_need_send[request.request_id] = (
|
||||||
|
request, self.get_sw_clipped_blocks(block_ids),
|
||||||
|
)
|
||||||
|
return delay_free_blocks, None # ← True = 延迟释放
|
||||||
|
```
|
||||||
|
|
||||||
|
### 3.2 Decode 节点 (is_kv_consumer) 的调度
|
||||||
|
|
||||||
|
当 `do_remote_prefill=True` 时:
|
||||||
|
|
||||||
|
1. **`get_num_new_matched_tokens`**:返回 `(num_prompt_tokens, True)`——告诉 Scheduler:"这 N 个 token 的 KV 已经在远端算好了,异步去拉"。
|
||||||
|
```
|
||||||
|
if params.get("do_remote_prefill"):
|
||||||
|
token_ids = request.prompt_token_ids or []
|
||||||
|
count = self._get_remote_prefill_token_count(len(token_ids)) - (
|
||||||
|
num_computed_tokens
|
||||||
|
)
|
||||||
|
if count > 0:
|
||||||
|
return count, True # ← count 是 prompt 长度,True = 异步加载
|
||||||
|
```
|
||||||
|
2. **Scheduler 分配 KV block**(第 953–971 行):`allocate_slots` 中传入 `num_external_computed_tokens`,并为远程 token 预留 block。关键参数:
|
||||||
|
- `delay_cache_blocks=True` — block 分配了但不立即写入 prefix cache(因为数据还在远端)
|
||||||
|
- `reserved_blocks` — 确保有足够空间完成整个异步传输,防止死锁
|
||||||
|
3. **请求进入 `WAITING_FOR_REMOTE_KVS` 状态**(第 1010–1040 行):
|
||||||
|
```
|
||||||
|
if load_kv_async:
|
||||||
|
request.status = RequestStatus.WAITING_FOR_REMOTE_KVS
|
||||||
|
step_skipped_waiting.prepend_request(request)
|
||||||
|
request.num_computed_tokens = num_computed_tokens
|
||||||
|
self._inflight_prefills.add(request)
|
||||||
|
# 跳过 zeroing:异步写入可能与 zeroing 竞态
|
||||||
|
```
|
||||||
|
此时 request 被放入 `skipped_waiting` 队列,不会进入 `running` 列表,本轮不参与 GPU 计算。
|
||||||
|
4. **`build_connector_meta`**:将需要 recv 的请求打包成 `MooncakeConnectorMetadata`(含 `remote_engine_id`、`remote_bootstrap_addr`、`transfer_id`、`local_block_ids`),放入 `SchedulerOutput.kv_connector_metadata` 传递给 Worker。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 四、Worker 层:Mooncake 的 KV Cache RDMA 传输
|
||||||
|
|
||||||
|
### 4.1 D 节点 Worker:拉取 KV Cache
|
||||||
|
|
||||||
|
**`start_load_kv`**(`MooncakeConnectorWorker`, 第 2028–2039 行):
|
||||||
|
|
||||||
|
```
|
||||||
|
def start_load_kv(self, metadata: MooncakeConnectorMetadata):
|
||||||
|
if not self.is_kv_producer and metadata.reqs_to_recv:
|
||||||
|
asyncio.run_coroutine_threadsafe(
|
||||||
|
self._start_load_kv(metadata.reqs_to_recv), self.receiver_loop
|
||||||
|
)
|
||||||
|
```
|
||||||
|
|
||||||
|
**`_start_load_kv` → `handle_new_engine_id` → `receive_kv` → `receive_kv_from_single_worker`**:
|
||||||
|
|
||||||
|
1. 首先通过 `_connect_to_prefiller_bootstrap(remote_bootstrap_addr)` 查询 P 节点的 bootstrap server,获取 P 侧所有 TP/PP Worker 的 ZMQ 地址
|
||||||
|
2. 构建 `MooncakeXferMetadata`(第 1825–1840 行),包含:
|
||||||
|
- `remote_hostname`/`remote_port`:D 侧的地址,P 侧用来做 RDMA 写入
|
||||||
|
- `remote_tp_size`/`remote_tp_rank`:TP 拓扑信息
|
||||||
|
- `req_blocks`:`{req_id: (transfer_id, local_block_ids)}`——D 侧已分配的 block ID
|
||||||
|
- `kv_caches_base_addr`/`block_lens`/`kv_block_lens`:D 侧 KV Cache 的物理内存地址和布局
|
||||||
|
3. 通过 ZMQ DEALER socket 向 P 侧对应 TP rank 的 Worker 发送此元数据
|
||||||
|
4. P 侧收到后,通过 RDMA (`batch_transfer_sync_write`) 将 KV Cache 数据直接写入 D 侧的 GPU 内存地址
|
||||||
|
5. 传输完成后,D 侧标记 `finished_recving_reqs`
|
||||||
|
|
||||||
|
### 4.2 P 节点 Worker:推送 KV Cache
|
||||||
|
|
||||||
|
**`record_send_reqs`**(第 2000–2026 行):P 侧的 Worker 将 Scheduler 传递来的 `reqs_to_send`(含 `transfer_id` 和 `local_block_ids`)记录到 `self.reqs_need_send` 字典。
|
||||||
|
|
||||||
|
**`send_kv_to_decode`**(第 1193–1382 行):当 D 侧的 ZMQ 请求到达 P 侧时触发,核心逻辑:
|
||||||
|
|
||||||
|
1. **等待 P 端 block 就绪**:`send_meta.ready.wait()`——P 侧的 forward pass 可能尚未完成
|
||||||
|
2. **地址计算**(`_build_transfer_params` 第 1424–1614 行):
|
||||||
|
- 逐层、逐 block 计算 P 侧源地址和 D 侧目标地址
|
||||||
|
- 处理 TP 异构(不同 TP 大小之间映射)
|
||||||
|
- 处理 HMA(Hybrid Memory Allocator)多 KV group
|
||||||
|
- 处理 Mamba/GDN 状态块
|
||||||
|
3. **RDMA 传输**(`_send_blocks` 第 1622–1651 行):
|
||||||
|
```
|
||||||
|
ret_value = self.engine.batch_transfer_sync_write(
|
||||||
|
remote_session, src_ptrs, dst_ptrs, lengths
|
||||||
|
)
|
||||||
|
```
|
||||||
|
P 侧直接通过 RDMA/NVLink 将 KV Cache 字节写入 D 侧的 GPU 内存。
|
||||||
|
4. 传输完成后,标记 `finished_sending_reqs`,释放 P 侧的 block。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 五、KV Cache 传输完成后:请求恢复执行
|
||||||
|
|
||||||
|
### 5.1 Scheduler 收到传输完成信号
|
||||||
|
|
||||||
|
`update_from_output` → `_update_from_kv_xfer_finished`(第 2713–2740 行):
|
||||||
|
|
||||||
|
```
|
||||||
|
for req_id in kv_connector_output.finished_recving or ():
|
||||||
|
req = self.requests[req_id]
|
||||||
|
if req.status == RequestStatus.WAITING_FOR_REMOTE_KVS:
|
||||||
|
self.finished_recving_kv_req_ids.add(req_id)
|
||||||
|
```
|
||||||
|
|
||||||
|
### 5.2 下一轮调度时提升请求状态
|
||||||
|
|
||||||
|
`_try_promote_blocked_waiting_request`(第 2677–2711 行):
|
||||||
|
|
||||||
|
```
|
||||||
|
if request.status == RequestStatus.WAITING_FOR_REMOTE_KVS:
|
||||||
|
if request.request_id not in self.finished_recving_kv_req_ids:
|
||||||
|
return False
|
||||||
|
self._update_waiting_for_remote_kv(request)
|
||||||
|
request.status = RequestStatus.WAITING # 回到正常调度队列
|
||||||
|
```
|
||||||
|
|
||||||
|
`_update_waiting_for_remote_kv`(第 2634–2675 行):
|
||||||
|
|
||||||
|
- 将接收到的 KV block 写入 prefix cache(`kv_cache_manager.cache_blocks`)
|
||||||
|
- 如果全部 prompt token 都命中,减少 1 个 computed token 以确保最后 1 个 token 被本地重算(用于生成第一个 output token)
|
||||||
|
|
||||||
|
### 5.3 正常调度执行
|
||||||
|
|
||||||
|
此时 request 回到 `WAITING` 状态,在下一轮 `schedule()` 中被正常调度:
|
||||||
|
|
||||||
|
- `num_computed_tokens` 已经包含了外部加载的 token 数
|
||||||
|
- Scheduler 从 `num_computed_tokens` 之后开始分配新的 compute
|
||||||
|
- 新分配的 token(通常只有 1 个 decode token)在本地 GPU 上执行
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 六、完整时序总结
|
||||||
|
|
||||||
|
```
|
||||||
|
┌─ Proxy ──────────────────────────────────────────────────────────────┐
|
||||||
|
│ ① POST /v1/chat/completions {"messages": [...], "max_tokens": 100} │
|
||||||
|
│ ② asyncio.create_task() ③ Stream Decode Response │
|
||||||
|
│ → P Node (fire & forget) → D Node (等待返回) │
|
||||||
|
│ kv_transfer_params: kv_transfer_params: │
|
||||||
|
│ do_remote_decode=True do_remote_prefill=True │
|
||||||
|
│ max_tokens=1 remote_bootstrap_addr=<P地址> │
|
||||||
|
│ stream=False remote_engine_id=<P engine id> │
|
||||||
|
│ transfer_id=xfer-UUID transfer_id=xfer-UUID │
|
||||||
|
└───────┬─────────────────────────────────┬───────────────────────────┘
|
||||||
|
┌───────▼── P Node ───────────┐ ┌───────▼── D Node ────────────────────┐
|
||||||
|
│ ④ Request 进入 Scheduler │ │ ⑤ Request 进入 Scheduler │
|
||||||
|
│ is_kv_producer=True │ │ is_kv_consumer=True │
|
||||||
|
│ ⑥ get_num_new_matched_tokens │ │ ⑦ get_num_new_matched_tokens │
|
||||||
|
│ → (0, False) 正常计算 │ │ → (N_prompt, True) 远端加载 │
|
||||||
|
│ ⑧ Scheduler 分配 block │ │ ⑨ Scheduler 分配 block │
|
||||||
|
│ → RUNNING 状态 │ │ → WAITING_FOR_REMOTE_KVS 状态 │
|
||||||
|
│ ⑩ GPU forward pass │ │ ⑪ Worker.start_load_kv() │
|
||||||
|
│ KV Cache 写入本地显存 │ │ → ZMQ 发送 MooncakeXferMetadata │
|
||||||
|
│ ⑫ send_kv_to_decode() │ │ (含 D 侧 block 物理地址) │
|
||||||
|
│ ← ZMQ 收到 D 的请求 │◄───── ZMQ ────────────────────────────│
|
||||||
|
│ → batch_transfer_sync_write│ │ │
|
||||||
|
│ → RDMA 写入 D 侧 GPU 显存 ═══════ RDMA/NVLink ═══════════════════► │
|
||||||
|
│ ⑬ finished_sending_reqs │ │ ⑭ finished_recving_reqs │
|
||||||
|
│ 释放 P 侧 block │ │ ⑮ WAITING_FOR_REMOTE_KVS → WAITING │
|
||||||
|
│ │ │ ⑯ 下一轮 schedule() 正常调度 decode │
|
||||||
|
│ │ │ ⑰ GPU forward pass 自回归生成 output │
|
||||||
|
│ │ │ ⑱ 流式返回 tokens → Proxy → Client │
|
||||||
|
└──────────────────────────────┘ └──────────────────────────────────────┘
|
||||||
|
```
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 七、关键设计要点
|
||||||
|
|
||||||
|
1. **P 和 D 收到的 prompt 完全一致**,但通过 `kv_transfer_params` 标志区分行为。P 正常计算整个 prompt,D 跳过本地计算而从 P 拉取 KV Cache。
|
||||||
|
2. **`transfer_id` 是连接 P/D 的关键**:Proxy 生成 UUID,同时发给 P 和 D。P 侧通过 `reqs_need_send[transfer_id]` 等待 D 侧通过 ZMQ 发来的拉取请求(携带同样的 `transfer_id`),从而匹配同一请求。
|
||||||
|
3. **D 侧 block 物理地址是传输的基础**:D 侧在 `receive_kv_from_single_worker` 中将自己的 `kv_caches_base_addr` + `block_lens` + `block_ids` 发给 P,P 侧据此计算出 RDMA 的目标地址,直接写入 D 的 GPU 显存。
|
||||||
|
4. **异步非阻塞设计**:D 侧在等待 KV 传输时处于 `WAITING_FOR_REMOTE_KVS` 状态,不占用 GPU 计算资源。同时 P 侧的发送也通过独立的后台线程池异步执行,不阻塞 P 的 forward pass。
|
||||||
|
5. **`remote_engine_id` 区分不同 DP rank 的 KV Cache**:在 DP(数据并行)场景下,每个 DP rank 有独立的 KV Cache 分区。`remote_engine_id` 包含 `engine_id_dp{N}` 后缀,精确定位到哪个 DP rank 的 KV Cache。
|
||||||
@@ -0,0 +1,80 @@
|
|||||||
|
# 📊 文章摘要:vLLM PD 分离
|
||||||
|
|
||||||
|
> **原文**:[2026-08-05_vLLM_PD分离_源码级机制_marcus.md](./2026-08-05_vLLM_PD分离_源码级机制_marcus.md)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/p6gh4hK25PujQ1UJzFTbLg
|
||||||
|
> **来源**:微信公众平台(marcus)
|
||||||
|
> **作者**:marcus
|
||||||
|
> **发布日期**:2026-08-05(原文未标注日期,按下载日占位)
|
||||||
|
> **摘要日期**:2026-08-06
|
||||||
|
> **价值评级**:⭐⭐⭐ 高
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 核心命题
|
||||||
|
|
||||||
|
> **源码级解构** — 把 PD 分离从概念论述落到 vLLM + Mooncake Connector 的代码行号级机制,是本批 PD 分离文章中唯一触及实现细节的第一手资料。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 文章概要
|
||||||
|
|
||||||
|
本文逐层拆解 vLLM 基于 Mooncake Connector 实现 PD 分离的完整代码路径:Proxy 将同一 prompt 双发至 P/D 节点并携带不同标志、Scheduler 通过 `WAITING_FOR_REMOTE_KVS` 状态机暂停等待远端 KV、Worker 层经 ZMQ 握手后以 RDMA 将 KV Cache 直写 D 侧 GPU 显存、传输完成后请求恢复调度。其价值在于回答了其他文章不回答的"怎么实现"问题——`transfer_id` 如何关联 P/D、D 侧 block 物理地址如何成为传输基础、为何要"少算 1 个 token 本地重算"。局限在于只覆盖 Mooncake Connector 一种实现,无性能数据,不讨论 P:D 配比与传输延迟等工程参数。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 关键要点
|
||||||
|
|
||||||
|
1. **Proxy 双发请求** — 同一 prompt 同时发给 P 和 D,靠 `kv_transfer_params` 标志区分角色:P 侧 `do_remote_decode=True` 且 `max_tokens=1` fire-and-forget,D 侧 `do_remote_prefill=True` 流式等待返回。 `[分类: 共识]`
|
||||||
|
2. **`transfer_id` 关联机制** — Proxy 生成 UUID 同时发给两端,P 侧以 `reqs_need_send[transfer_id]` 等待 D 侧经 ZMQ 发来的拉取请求,是 P/D 匹配同一请求的唯一纽带。 `[分类: 共识]`
|
||||||
|
3. **D 侧调度暂停态** — `WAITING_FOR_REMOTE_KVS` 状态下请求不进入 running 队列、不占 GPU 计算资源,并跳过 zeroing 以避免与异步写入竞态;`reserved_blocks` 预留空间防死锁。 `[分类: 共识]`
|
||||||
|
4. **RDMA 直写远端显存** — D 侧将自己的 `kv_caches_base_addr`/`block_lens`/`block_ids` 经 ZMQ 发给 P,P 用 `batch_transfer_sync_write` 直接写入 D 的 GPU 内存,D 侧零计算加载;`remote_engine_id` 的 DP rank 后缀用于定位不同数据并行分区的 KV。 `[分类: 共识]`
|
||||||
|
5. **传输后恢复执行** — 完成后 KV 写入 prefix cache,并故意减少 1 个 computed token 让最后 1 个 prompt token 本地重算以生成首个输出 token;P 侧发送走后台线程池,不阻塞 forward pass。 `[分类: 共识]`
|
||||||
|
6. **机制层面未触及的性能问题** — 全文只讲"如何实现"不讲"收益几何",P:D 比例、传输延迟、SLO 达成等维度完全缺席,需与性能类文章(如 DistServe 解读)互补阅读。 `[分类: 未探索]`
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 批判性分析
|
||||||
|
|
||||||
|
### 假设前提
|
||||||
|
|
||||||
|
作者立论建立在三个前提上:读者熟悉 vLLM v1 架构与 Mooncake 生态;该实现路径是 PD 分离的"典型范式"——但 SGLang、TensorRT-LLM 等引擎的实现机制并不相同;RDMA/NVLink 高速互联为默认可用资源。
|
||||||
|
|
||||||
|
### 论据与逻辑
|
||||||
|
|
||||||
|
论据为具体源码行号(`scheduler.py` 712-755 行、`MooncakeConnectorWorker` 2028-2039 行等),证据直接、链条完整,从请求进入、调度、传输到恢复执行全程无逻辑跳跃,可信度高。但全文无任何运行数据或基准测试,无法证明"这套机制实际有效、开销几何"——机制正确性与性能有效性是两回事。
|
||||||
|
|
||||||
|
### 边界与局限
|
||||||
|
|
||||||
|
结论仅适用于 vLLM + Mooncake Connector 这一特定组合;文中机制(如延迟释放 block、传输后减少 1 个 computed token)属于工程实现细节而非普适原理;不适用于评估 PD 分离的收益/代价,也不覆盖 D 节点等待期间的整体调度吞吐影响。对只想了解 PD 分离概念与价值的读者,本文过于深入。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 可引用金句
|
||||||
|
|
||||||
|
> "每个请求都有唯一的 `transfer_id`(UUID)——这是 P 和 D 两端关联同一次 KV Cache 传输的关键标识。"
|
||||||
|
|
||||||
|
> "P 和 D 收到的 prompt 完全一致,但通过 `kv_transfer_params` 标志区分行为。"
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 总体评价
|
||||||
|
|
||||||
|
**亮点**:
|
||||||
|
- 全链路(Proxy→Scheduler→Worker→恢复执行)代码级剖析,行号精确,是稀缺的一手工程资料
|
||||||
|
- 清晰回答了"KV 如何从 P 到 D、请求如何暂停与恢复"这一概念文章普遍回避的实现问题
|
||||||
|
- 时序图(完整时序总结)直观完整,可作为机制速查图
|
||||||
|
|
||||||
|
**不足**:
|
||||||
|
- 无任何性能数据,机制正确性与性能收益之间留白
|
||||||
|
- 未讨论 P:D 配置、传输延迟、失败处理等工程参数
|
||||||
|
- 依赖 Mooncake Connector 特定实现,通用性未说明
|
||||||
|
|
||||||
|
**适用场景**:推理系统工程师、vLLM 二次开发者、想从"知道 PD 分离"进阶到"读懂 PD 分离代码"的读者;面试中需要讲解 PD 分离实现细节时的高价值素材。
|
||||||
|
|
||||||
|
**关联建议**:搭配本文同批的 DistServe 解读(原理与收益)与丁师兄文章(落地代价)构成"原理—机制—代价"完整链条;可进一步阅读 vLLM `v1/core/sched/scheduler.py` 中 `MooncakeConnectorScheduler` 与 `MooncakeConnectorWorker` 的完整源码,以及 Mooncake 项目关于 KVCache 传输的官方文档。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 配图
|
||||||
|
|
||||||
|

|
||||||
@@ -0,0 +1,84 @@
|
|||||||
|
# LLM 做 PD 分离后,怎么更慢了?
|
||||||
|
|
||||||
|
> **来源**:微信公众平台(丁师兄)
|
||||||
|
> **作者**:丁师兄(专注于智能驾驶大模型,LLM 面试干货分享)
|
||||||
|
> **发布日期**:2026-08-05(原文未标注日期,按下载日占位)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/0HlmtIuPGU7QE5r1fyhcsA
|
||||||
|
|
||||||
|
> 面试题视角:PD分离实际落地会遇到什么问题。从"代价/坑"的角度讲 PD分离的 5 大问题——KV Cache 传输开销、生产者-消费者不平衡、调度复杂度、显存压力与碎片化、P:D 比例敏感性。与只讲红利的文章形成互补。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
> 编者按(丁师兄):前不久有个学员面试完回来说,面试官问"PD 分离听起来挺好的,那你说说实际落地会遇到什么问题?"他当时愣了一下,只答出了网络传输这一点。这道题考的就是你有没有真正理解过生产环境的复杂性。PD 分离现在是个热门话题,vLLM、SGLang 都在推,Meta 和 Kimi 也在用,但真要把它跑起来,坑可不少。
|
||||||
|
|
||||||
|
## 01 先理解 PD 分离在解决什么
|
||||||
|
|
||||||
|
LLM 推理分两个阶段:Prefill 阶段是计算密集型的,把整个 prompt 并行处理完,生成 KV Cache;Decode 阶段是内存密集型的,逐个 token 串行生成,频繁读写 KV Cache。这两个阶段的资源需求完全相反,混在一起跑会互相干扰。
|
||||||
|
|
||||||
|
所以 PD 分离就是把这两个阶段拆到不同的 GPU 上去执行。Prefill 用高算力卡,Decode 用高带宽卡,听起来很美好对吧?但工业界真正落地的时候,问题就来了。
|
||||||
|
|
||||||
|
## 02 第一个大坑:KV Cache 传输开销
|
||||||
|
|
||||||
|
最核心的问题——KV Cache 的传输成本。Prefill 阶段算完之后,得把整个 KV Cache 传给 Decode 阶段。
|
||||||
|
|
||||||
|
拿 **Llama-3.1-70B** 举例,一个请求的 KV Cache 大概是 **1.34GB**。这是单个请求。如果 TTFT 要求 500ms 以内,Prefill 本身可能就要 200ms,留给传输的时间只有 300ms 左右。
|
||||||
|
|
||||||
|
这时候网络就成了瓶颈:
|
||||||
|
- **10GbE**:传这 1.34GB 要 1 秒多,根本不够用;
|
||||||
|
- **25GbE**:勉强 400 多毫秒,也很紧张;
|
||||||
|
- **InfiniBand HDR 或 NVLink**:才能压到几十毫秒甚至几毫秒。
|
||||||
|
|
||||||
|
如果传输开销超过了分离带来的性能收益,整个架构就白搭了。这就是为什么 PD 分离必须要有高速互联网络支持,不是随便拿几台机器就能做的。Meta、Kimi 在生产环境用的都是专门的高速网络,这个成本不低。
|
||||||
|
|
||||||
|
## 03 第二个问题:生产者-消费者不平衡
|
||||||
|
|
||||||
|
Prefill 和 Decode 之间的负载不均衡,取决于工作负载特征:
|
||||||
|
|
||||||
|
- **短 prompt、长输出**(用户问一句,模型生成一大段):Decode 压力大,需要 **1P3D**;
|
||||||
|
- **长上下文**(文档总结、代码分析,prompt 几千 token,输出不长):Prefill 成瓶颈,反过来配 **3P1D**。
|
||||||
|
|
||||||
|
问题在于真实业务流量是动态变化的——上午都是短问答,下午突然来一批长文档处理。如果 P:D 比例是静态配置的,就会出现一边资源闲置、另一边排队等待。这就需要动态调度和弹性伸缩,但又增加了系统复杂度。
|
||||||
|
|
||||||
|
有篇论文专门研究了这个,发现当 Prompt/Output 比例变化时,不同 P:D 配置的性能曲线会交叉——没有一个万能配置,必须根据实际 workload 调整。
|
||||||
|
|
||||||
|
## 04 第三个问题:调度复杂度飙升
|
||||||
|
|
||||||
|
传统架构里调度器只管一个队列。PD 分离之后调度逻辑复杂多了:
|
||||||
|
|
||||||
|
调度器要实时决策:请求分配给哪个 Prefill 实例?Prefill 完成后 KV Cache 传给哪个 Decode 实例?要考虑各节点负载、显存剩余、KV Cache 复用率、网络拓扑等。
|
||||||
|
|
||||||
|
更麻烦的是 Prefill 和 Decode 的协调:Prefill 做完了 Decode 还在忙,KV Cache 传不过去只能等;或者 Decode 空闲了 Prefill 还没准备好,又是浪费。这种生产者-消费者同步问题,在高并发场景下特别容易出现气泡(资源利用率的空洞)。
|
||||||
|
|
||||||
|
DistServe 和 Mooncake 设计了非常复杂的调度算法。Mooncake 甚至搞了三层架构:Prefill 集群、Decode 集群,还有专门的 Caching 集群管理 KV Cache——这个复杂度对小团队维护成本很高。
|
||||||
|
|
||||||
|
## 05 第四个问题:显存压力和碎片化
|
||||||
|
|
||||||
|
Prefill 阶段可能同时处理多个请求,每个都要生成 KV Cache,显存占用瞬间飙升。Decode 阶段更惨,要保留所有在生成中请求的完整 KV Cache,随生成长度增加 Cache 还在不断增长。
|
||||||
|
|
||||||
|
虽然有 PagedAttention 缓解碎片化,但 PD 分离后 KV Cache 的生命周期跨越两个不同节点,管理更复杂——要确保 Prefill 生成的 Cache 高效映射到 Decode 节点显存,还要处理释放和复用时机。管理不好会出现一边频繁 OOM、另一边大量闲置。
|
||||||
|
|
||||||
|
## 06 第五个问题:P:D 比例的敏感性
|
||||||
|
|
||||||
|
一篇 Medium 文章做了个实验,测试 1P3D、2P2D、3P1D 三种配置。结果发现性能曲线会随 Prompt/Output 比例变化而交叉——某个 workload 下最优的配置,换个 workload 可能变成最差。
|
||||||
|
|
||||||
|
本质是 Prefill 和 Decode 的瓶颈切换不是平滑的,而是突变的。workload 从 Decode 密集切换到 Prefill 密集时,系统性能可能断崖式下跌。所以真正做得好的系统需要实时监控 workload 特征、动态调整 P:D 比例——但这又回到调度复杂度问题,是个循环依赖。
|
||||||
|
|
||||||
|
> 从上图可以看出,PD 分离可以提高 decoding 部分的效率。但从 TP2 变成 1P1D,prefilling 的卡减少,大 bs、长输入时会导致 TTFT 变长。另外因为 prefill 的计算量大,decoder 阶段的传输量大,因此 PD 分离可以对两个阶段使用不同类型的显卡,最大化性价比。
|
||||||
|
|
||||||
|
## 07 总结
|
||||||
|
|
||||||
|
如果被问"PD 分离背后可能出现什么问题",可以从这几个维度答:
|
||||||
|
|
||||||
|
1. **KV Cache 传输开销**(最核心):强调网络带宽要求,算传输时间,说明为什么需要 InfiniBand 或 NVLink 级互联;
|
||||||
|
2. **负载不均衡**:不同 workload 下 P:D 比例需求不同,静态配置导致资源浪费;
|
||||||
|
3. **调度复杂度**:生产者-消费者同步、资源分配决策、气泡问题;
|
||||||
|
4. **显存管理**:KV Cache 跨节点生命周期管理、碎片化、OOM 风险;
|
||||||
|
5. **性能对 workload 敏感性**:没有万能配置,需要动态调整。
|
||||||
|
|
||||||
|
如果追问"怎么解决",可以说业界方案:高速网络、智能调度算法、动态伸缩、KV Cache 压缩和复用等。提一下 DistServe、Mooncake 这些系统的实践,会显得对前沿有了解。
|
||||||
|
|
||||||
|
> 这道题考的不是让你背八股,而是看你有没有真正理解生产环境的复杂性。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
> 编者:丁师兄,专注智能驾驶大模型,持续分享 LLM 面试干货;大模型 1v1 辅导。微信:dsxaigc
|
||||||
@@ -0,0 +1,82 @@
|
|||||||
|
# 📊 文章摘要:LLM 做 PD 分离后,怎么更慢了?
|
||||||
|
|
||||||
|
> **原文**:[2026-08-05_LLM做PD分离后怎么更慢了_丁师兄.md](./2026-08-05_LLM做PD分离后怎么更慢了_丁师兄.md)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/0HlmtIuPGU7QE5r1fyhcsA
|
||||||
|
> **来源**:微信公众平台(丁师兄)
|
||||||
|
> **作者**:丁师兄(专注智能驾驶大模型,LLM 面试干货分享)
|
||||||
|
> **发布日期**:2026-08-05(原文未标注日期,按下载日占位)
|
||||||
|
> **摘要日期**:2026-08-06
|
||||||
|
> **价值评级**:⭐⭐⭐ 高
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 核心命题
|
||||||
|
|
||||||
|
> **落地五坑** — 从生产环境视角系统列出 PD 分离的 5 大落地问题(KV 传输、负载失衡、调度复杂度、显存管理、P:D 敏感性),是与清一色"红利派"文章互补的"代价派"清单。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 文章概要
|
||||||
|
|
||||||
|
本文以面试题"PD 分离实际落地会遇到什么问题"切入,系统梳理了 PD 分离生产落地的 5 大坑:KV Cache 传输开销(Llama-3.1-70B 单请求 1.34GB,10GbE 传 1 秒以上,需 IB/NVLink 级互联)、生产者-消费者不平衡(workload 动态变化使静态 P:D 配置失效)、调度复杂度飙升(双实例决策与气泡问题)、显存压力与跨节点生命周期管理、P:D 比例对 workload 的高度敏感性(性能曲线交叉、断崖式下跌)。其价值在于提供了本批文章中唯一完整的"反面清单",并给出了可直接计算的量化示例;局限是数字多为估算与二手引用,无第一手实验,且"如何解决"仅点到业界方案名称。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 关键要点
|
||||||
|
|
||||||
|
1. **KV Cache 传输是最大坑** — Llama-3.1-70B 单请求 KV 约 1.34GB,TTFT 500ms 预算下 Prefill 占 200ms 后仅剩约 300ms 传输窗口:10GbE 需 1 秒+、25GbE 勉强 400 多毫秒,只有 InfiniBand/NVLink 才能压到几十毫秒级;"传输开销超过分离收益则整个架构白搭"。 `[分类: 共识]`
|
||||||
|
2. **P:D 比例无万能配置** — 短 prompt 长输出需 1P3D,长上下文需 3P1D;真实业务流量动态变化,静态配置必出现一边闲置一边排队;论文与 Medium 实验均显示不同 Prompt/Output 比例下性能曲线交叉。 `[分类: 共识]`
|
||||||
|
3. **调度复杂度飙升** — 调度器从单队列变为实时决策"请求分给哪个 P、KV 传给哪个 D";生产者-消费者同步在高并发下产生气泡;Mooncake 的三层架构(P/D/Caching 集群)对小团队维护成本高。 `[分类: 共识]`
|
||||||
|
4. **显存管理与碎片化** — KV Cache 生命周期跨越两个节点,PagedAttention 只能缓解单节点碎片;P/D 两侧的释放与复用时机协调不当会出现"一边频繁 OOM、另一边大量闲置"。 `[分类: 共识]`
|
||||||
|
5. **瓶颈切换是突变而非平滑** — workload 从 Decode 密集切到 Prefill 密集时性能可能断崖式下跌;动态调整 P:D 又依赖实时监控与调度,与问题 3 形成循环依赖——这是动态 P:D 配比至今未成熟解决的深层原因。 `[分类: 未探索]`
|
||||||
|
6. **应对方向的业界共识** — 高速网络、智能调度算法、动态伸缩、KV Cache 压缩与复用,并以 DistServe、Mooncake 为前沿实践代表。 `[分类: 共识]`
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 批判性分析
|
||||||
|
|
||||||
|
### 假设前提
|
||||||
|
|
||||||
|
立论假设 PD 分离的收益已成立(文章未质疑分离本身,只质疑落地方式);同时隐含假设读者已具备 PD 分离基本概念;"动态 workload"是常态这一前提放大了静态配比的缺陷,但未讨论可预测负载(如离线批处理)场景下静态配比的适用性。
|
||||||
|
|
||||||
|
### 论据与逻辑
|
||||||
|
|
||||||
|
五个问题维度划分清晰、逻辑自洽,KV 传输的量化示例(1.34GB、300ms 窗口、各网络档位耗时)可直接复算,说服力强。但 P:D 敏感性结论仅转述"有篇论文"与"一篇 Medium 文章",未给出论文名与数据来源,引用严谨性不足;部分数字(10GbE 传 1 秒多)为估算,未提供计算公式;"问题清单"完整但"解决路径"止于名词罗列。
|
||||||
|
|
||||||
|
### 边界与局限
|
||||||
|
|
||||||
|
结论针对"动态生产流量下的在线推理"场景,对负载稳定的离线批量场景不适用;KV 传输开销的判断以 Llama-3.1-70B 为样本,对 KV 更小的 MoE 模型(如 DeepSeek)或 KV 压缩技术下的传输量需重新评估——其悲观程度与 DistServe 论文"传输可隐藏"的乐观结论形成对照,真实答案取决于网络与模型的具体组合;文章未覆盖传输与计算重叠(overlap)等已有缓解技术。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 可引用金句
|
||||||
|
|
||||||
|
> "这道题考的不是让你背八股,而是看你有没有真正理解生产环境的复杂性。"
|
||||||
|
|
||||||
|
> "如果传输开销超过了分离带来的性能收益,整个架构就白搭了。"
|
||||||
|
|
||||||
|
> "没有万能配置,必须根据实际 workload 调整。"
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 总体评价
|
||||||
|
|
||||||
|
**亮点**:
|
||||||
|
- 本批 PD 分离文章中唯一的系统性"代价清单",与红利派文章形成强互补
|
||||||
|
- KV 传输量化示例具体可复算(1.34GB、300ms 窗口),可直接用于面试与方案评估
|
||||||
|
- 明确点出 P:D 敏感性、瓶颈突变、动态调整循环依赖等常被忽视的深层问题
|
||||||
|
|
||||||
|
**不足**:
|
||||||
|
- 关键结论依赖未具名的二手引用,严谨性不足
|
||||||
|
- 无第一手实验数据,数字多为估算
|
||||||
|
- "怎么解决"止于业界方案名称,缺少可操作建议
|
||||||
|
|
||||||
|
**适用场景**:准备 LLM 推理面试的候选人;正在评估 PD 分离方案的架构师与运维团队(决策前的风险清单);与红利派文章对照理解 PD 分离全貌的读者。
|
||||||
|
|
||||||
|
**关联建议**:与本批新智元 DistServe 文章对照阅读,可见"传输可隐藏 vs 传输是大坑"的张力本质是网络条件与模型规模假设不同;与本批 marcus 的 vLLM 源码文章串联,可理解调度复杂度在代码层的具体表现;进一步可阅读 Mooncake 论文(KVCache 复用与缓存集群)与 DistServe 论文中关于调度算法的章节。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 配图
|
||||||
|
|
||||||
|

|
||||||
@@ -0,0 +1,294 @@
|
|||||||
|
# 为抓住当代唯一的科技转折点,用AI最猛的一批人已经不睡觉了
|
||||||
|
|
||||||
|
> **来源**:微信公众平台
|
||||||
|
> **作者**:不懂经也叔的Rust
|
||||||
|
> **发布日期**:2026-08-27
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/KElyAyEuB6RooLvue0SysA
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
43 岁的阿贾伊·卡利亚是一个总部位于波士顿的 AI 创业公司的创始人。他说,自己早在 2023 年 2 月还在 Spotify 的 AI 团队工作时,就第一次意识到 AI 将会颠覆世界。
|
||||||
|
|
||||||
|
他看到一些拥有博士学位、从业 20 年的人从房间里出来时,一个个都垂头丧气。"他们会说一些非常奇怪的话,比如:'我的博士学位没用了。'"他说。
|
||||||
|
|
||||||
|
卡利亚于 2024 年离开 Spotify,创办了自己的公司 Alt。如今,他大多数日子早上 5 点半或 6 点就开始工作,晚上 9 点或 10 点左右结束。他会使用ai智能体,但每隔几个月,就得根据智能体快速变化的能力重新调整自己的工作方式。
|
||||||
|
|
||||||
|
"你可以用这些新模型构建更宏大、野心更大的东西,这太棒了。"他说,"问题是,你永远做不完。"
|
||||||
|
|
||||||
|
卡利亚最近开始通过 Apple Watch 控制智能体,这件事有好处,也有代价。他的手表每隔 10 分钟就震一下,提醒他有新的智能体请求。
|
||||||
|
|
||||||
|
"我不知道,跑步时还要盯着手表,批准智能体做某件事,对我来说是否健康。"他说。
|
||||||
|
|
||||||
|
在卡利亚更广泛的创业者圈子里,没有人考虑休假,也没人表达过对职业倦怠的担忧,尽管他看到很多人似乎已经站在崩溃边缘。
|
||||||
|
|
||||||
|
"大家都心照不宣地承认,一方面这不可持续,另一方面,为什么要停下来?"他说。
|
||||||
|
|
||||||
|
上面是华尔街日报刚刚发表的一篇报道中讲述的故事。这篇文章说的是,AI智能体不需要睡觉,创业公司的创始人为了跟上他们的智能体,也几乎不睡觉了。996 根本就是小儿科。有人从早上七点半工作到凌晨两点,有人则是经常通宵 ,早上 6 点才睡觉,还有人甚至连续一个月每天只睡一个小时。
|
||||||
|
|
||||||
|
很多人认为 AI 堪称是 5000 年一遇的科技转折点,是他们在此一生当中必须把握的机会。而且 和 AI 智能体一起工作让人上头,根本停不下来。有人形容说 就像是吸毒。
|
||||||
|
|
||||||
|
还有一种fomo的情绪,就是错失综合症。有创业者表示,"让智能体停住八个小时,代价实在太高了。它们可能在任何时候完成工作,哪怕是在半夜。"还有人说,"我一分钟不工作,都意味着我错过了本来可以完成一周工作量的机会。"
|
||||||
|
|
||||||
|
我在之前的一篇文章《现在看清了:AI不是平权,它是资本和劳动力的最后一战》中提到,这几年,我们常听到一个词,叫"AI 平权"。它的意思是,AI 会把高级能力下放给普通人。不会写代码的人可以做应用,不会设计的人可以出图,不会英语的人可以写英文邮件,不懂法律的人可以看合同。
|
||||||
|
|
||||||
|
这当然发生了。我自己也相信,AI 会给很多普通人打开过去不可能打开的门。但这不是完整的图景。完整的图景是,AI 在降低某些门槛的同时,也在抬高另一些门槛。它降低了入门门槛,抬高了上限门槛。
|
||||||
|
|
||||||
|
现在在80 亿人口当中,80% 以上的人还没有接触和使用过 AI。在已经使用 AI 的人当中,绝大多数使用的是免费模型,只有一小部分人付费使用更高级的模型。而在付费使用的人当中,又只有极少数人每天消耗大量的 token,做着复杂的大型任务。
|
||||||
|
|
||||||
|
过去我们说"二八法则",到了网络时代,可能很多人会接受这是一个"一九法则"的世界。那么到了 AI 时代,我们很可能会看到一个"1:99"的世界,也就是 1% 的人可能会消耗掉 99% 的 token。这就是一个新的垄断阶层。
|
||||||
|
|
||||||
|
媒介理论的奠基人之一哈罗德·英尼斯认为,__伴随着任何一种新媒介的产生,都会出现一个新的专家阶层__。媒介发展史是相应的职业发展史,也是掌握该媒介和准入门槛之阶层的崛起史。英尼斯称该阶层因此获得的地位为"知识垄断"。在获得垄断权力之后,这一阶层会进一步以他们的媒介专长为"杠杆",为自己攫取更多的利益。
|
||||||
|
|
||||||
|
当然,我觉得现在对于很多人来说,机会窗口都是开放的,虽然大家的起点和资源并不平等。
|
||||||
|
|
||||||
|
下面重温一下我之前的一篇文章:《AI 让一部分人无班可上,又让另一部分人无班可下》。 有意思的是我还看到有教授就这个话题做过演讲。
|
||||||
|
|
||||||
|
许家印终局:没有谁能逃离永久底层
|
||||||
|
|
||||||
|
《牛来》火到了国外,但很少有人看透它的实质
|
||||||
|
|
||||||
|
残酷:AI 让一部分人无班可上,又让另一部分人无班可下
|
||||||
|
|
||||||
|
过去几年,硅谷一直在向世界兜售一个很诱人的承诺:AI 会替我们做掉那些无聊、重复、低价值的工作,把人从电脑前解放出来。
|
||||||
|
|
||||||
|
AI会写代码、整理资料、回复邮件、生成方案、检查错误,于是人类终于可以从琐碎劳动中抽身,去做更有创造力、更有意义、更像人的事。
|
||||||
|
|
||||||
|
但现在,第一批真正重度使用 AI 的人,正在过上一种完全相反的生活。
|
||||||
|
|
||||||
|
彭博社最近有一篇报道,其中写到一个创业者马特·范霍恩(Matt Van Horn)。他是四个孩子的父亲,也是一名连续创业者。现在,他的电脑几乎不关机,里面长期跑着不止半打 AI agent。它们在 Claude 模型背后的 AI 公司 Anthropic 的 Claude Code 里工作,每隔十分钟左右就会来问他下一步怎么做。
|
||||||
|
|
||||||
|
他送孩子上学时,agent 在跑;他去看孩子踢球时,agent 在跑;他度假住酒店时,agent 也在跑。到了晚上,他甚至让一个 agent 去照看其他 agent,好让整个系统继续运行。
|
||||||
|
|
||||||
|
这听起来像一个关于未来生产力的故事,但细看之下,它更像一个关于新型疲惫的故事。范霍恩自己也承认,大家原本说 agent 是来替我们工作的,可他从来没有像现在这么忙过。他的产出变成了过去的一百倍,但他的工作边界也被放大了一百倍。
|
||||||
|
|
||||||
|
这是 AI 时代最弔诡又讽刺的地方。AI 让一部分无班可上,又让另一部分人无班可下。
|
||||||
|
|
||||||
|
过去,下班至少还有某种物理含义。办公室关灯了,同事走了,电脑合上了,很多事情自然停在那里。现在,工作不再等于你坐在工位上敲键盘,而是你的模型、脚本、agent、自动化流程还在后台继续活动。你可以离开椅子,但你很难离开那个仍在运转的系统。
|
||||||
|
|
||||||
|
更麻烦的是,AI 让人无法停下来的方式,不再像传统加班那样粗暴。过去的加班有一个清楚的施压者,可能是老板、项目、绩效、客户。
|
||||||
|
|
||||||
|
AI 时代的压力更像是从内部长出来的,因为它不断提醒你:这件事其实还能继续推进,那个想法其实可以马上试一下,这段代码可以再优化,那个页面可以再生成一个版本。你不是被命令工作,而是被可能性召唤。
|
||||||
|
|
||||||
|
这就是更加值得深思的地方。AI 带来的不是单纯的效率提升,而是一种关于人的边界的重新谈判。它把过去由能力、时间、技能和身体共同构成的边界,一层层拆掉。
|
||||||
|
|
||||||
|
拆掉之后,人并不会自动变自由。相反,他会第一次如此直接地暴露在自己的欲望面前。
|
||||||
|
|
||||||
|
## 一、省力技术的古老悖论
|
||||||
|
|
||||||
|
我们先从一个更古老的问题说起:为什么所有省力技术,最后都没有让人真正省力?
|
||||||
|
|
||||||
|
德国社会学家哈特穆特·罗萨(Hartmut Rosa)早就研究过这种悖论。罗萨是当代德国很重要的社会理论家之一,曾受法兰克福学派第三代代表人物阿克塞尔·霍耐特(Axel Honneth)影响,他最著名的理论叫"社会加速"。
|
||||||
|
|
||||||
|
这个理论的出发点非常朴素,却几乎击中了每个现代人的日常经验:人类发明了无数省时技术,飞机、汽车、互联网、即时通讯、协同软件、云服务、自动化流程,但没有多少人真的觉得自己有了更多时间。恰恰相反,越是生活在技术发达的地方,人越容易觉得时间不够用。
|
||||||
|
|
||||||
|
罗萨把现代社会的加速理解成几个彼此咬合的过程。最容易理解的是技术加速。交通更快,通信更快,生产更快,从骑马到高铁,从书信到 5G,从手工流程到 AI 自动化,每一次技术进步都在压缩完成一件事所需的时间。按照朴素想象,这应该让人松一口气,因为同样的事更快完成,剩下的时间就可以用来休息。
|
||||||
|
|
||||||
|
但现代社会真正吊诡的地方在于,技术加速之后,社会变化本身也加速了。技能的保质期越来越短,行业共识的保质期越来越短,平台规则、审美趋势、组织结构、人际关系和职业身份都在更短周期里更新。
|
||||||
|
|
||||||
|
你十年前学会的东西,今天可能只是入门常识;你五年前相信的路径,今天可能已经失效;你刚刚适应一个工具,它的下一代版本已经重写了工作流程。罗萨有一个很形象的说法,现代人不是站在坚实土地上奔跑,而是站在一条自己也在移动的斜坡上。你越想站稳,就越被迫加快脚步。
|
||||||
|
|
||||||
|
最后被加速的是生活步调本身。技术本来应该替你省时间,可你感受到的不是闲暇增加,而是行动密度增加。你在同一单位时间里塞进更多任务,把等待时间改造成回复消息,把通勤时间改造成听播客,把午休时间改造成处理邮件,把晚上本来模糊的空白改造成"再推进一下"。
|
||||||
|
|
||||||
|
一个较慢的活动被一个较快的活动替代之后,节省出来的不是自由,而是下一个任务的位置。
|
||||||
|
|
||||||
|
没有AI聊天的童年,将成为富人阶层的特权?
|
||||||
|
|
||||||
|
战略性无知:真正有判断力的人,已经不看信息了
|
||||||
|
|
||||||
|
这几层加速形成了一个自我驱动的循环。技术让你做得更快,社会变化又要求你跟上新的标准,生活步调于是变得更密集,而更密集的生活又制造新的焦虑,逼你寻找更快的技术。
|
||||||
|
|
||||||
|
人不是走向闲暇,而是走向一种越来越精细、越来越高密度的时间管理。罗萨称这种状态为"时间饥荒"(time famine)。它不是说一天真的少于二十四小时,而是你的任务、欲望和外部期待膨胀得比时间更快。
|
||||||
|
|
||||||
|
这并不是 AI 时代才出现的问题。1930 年,英国经济学家凯恩斯就曾经乐观预言,到 2030 年,技术进步将使人类每周工作时间缩短到十五小时。
|
||||||
|
|
||||||
|
接近一百年过去了,我们确实拥有了凯恩斯无法想象的生产工具,但我们并没有进入闲暇社会。我们拥有的是一种更高级的忙碌:更快的设备、更密的日程、更碎的注意力,以及更强烈的"我还可以再做一点"的亏欠感。
|
||||||
|
|
||||||
|
AI 只不过把这条古老规律推到了一个前所未有的极端。过去的省力技术主要移除体力摩擦。洗衣机减少家务劳动,汽车减少空间距离,电梯减少身体攀爬。互联网和移动设备移除了一部分信息摩擦,让沟通和搜索变得更快。
|
||||||
|
|
||||||
|
但 AI 移除的是认知和决策摩擦。它让你从"我做不到"直接跳到"我只需要说一句话,它就能开始"。中间那些原本会让人犹豫、拖延、准备、学习、放弃的阻力,突然消失了一大块。
|
||||||
|
|
||||||
|
但是,摩擦不只是障碍。摩擦也是缓冲带,是人停下来问"我到底要不要做"的机会。过去,一个想法会自然死掉,因为它太麻烦。你不会写代码,所以那个 app 想法停在脑子里。你不会剪视频,所以那个内容计划放在收藏夹里。你没有团队,所以那个项目永远只是一个深夜里的幻想。
|
||||||
|
|
||||||
|
现实里的摩擦像一道粗糙但有效的筛网,把大量临时起意、不成熟的野心和不值得追逐的冲动挡在外面。
|
||||||
|
|
||||||
|
AI 改变的是这道筛网。它让很多事情从"以后有机会再说",变成"现在就可以开始"。做一个调研、搭一个网页、生成一份商业计划、跑一个数据分析、设计一套课程等等,这些过去需要准备很久的事情,现在都可以被迅速启动。于是我们以为 AI 节省的是时间,其实它更根本地节省了行动摩擦。
|
||||||
|
|
||||||
|
现在,一个想法不再死于麻烦。它会变成一个文档、一个 GitHub 仓库、一个 agent 任务、一个半成品项目,然后在你的后台持续闪烁。它不一定重要,但它已经被启动了。
|
||||||
|
|
||||||
|
只要它被启动,就会要求你继续照看它。人不是因为真正想清楚了才开始行动,而是因为行动门槛低到几乎无法构成拒绝。
|
||||||
|
|
||||||
|
这也是为什么 AI 重度使用者常常不是更轻松,而是更忙。员工行为分析公司 ActivTrak 研究了一万多名员工的数字活动后发现,采用 AI 的人并没有把节省下来的时间用于休息。他们在邮件、消息和聊天工具上的时间翻了一倍多,业务软件使用量也大幅上升,而专注、不被打断的工作时间反而下降。
|
||||||
|
|
||||||
|
加州大学伯克利分校哈斯商学院的研究者也发现,使用 AI 后,很多员工开始接手过去会外包出去的任务,因为编码、工程、整理和生成这些事情变得更容易了。他们把晚上、周末、候诊室里的碎片时间挤出来工作,同时监督多个 bot 做不同的事。
|
||||||
|
|
||||||
|
这件事表面上像是个体选择,深处却是罗萨所说的社会加速逻辑。技术没有把人带到更宽松的时间里,而是提高了单位时间里的行动密度。AI 不是让你少做事,而是让更多事情获得了进入你生活的资格。
|
||||||
|
|
||||||
|
## 二、AI Agent 是 24/7 资本主义的完美执行者
|
||||||
|
|
||||||
|
如果说罗萨解释了为什么省时技术总会制造新的时间饥荒,那么哥伦比亚大学艺术史教授乔纳森·克拉里(Jonathan Crary)则解释了为什么现代资本主义无法容忍停顿。
|
||||||
|
|
||||||
|
2013 年,克拉里出版了一本很薄但浓度极高的小书,书名叫《24/7:晚期资本主义与睡眠的终结》。它的核心论点非常尖锐:二十一世纪资本主义正在消灭人类生活中的停顿、间隔和停机时间,构建一个全天候、无间断、永远开放的世界。
|
||||||
|
|
||||||
|
市场不再受白天和黑夜约束,消费、通信、金融交易、娱乐、信息流和数据采集都在每个小时持续运行。人类生活中那些曾经自然存在的边界,正在被一个 24/7 的时间体制逐渐侵蚀。
|
||||||
|
|
||||||
|
从这个角度看,现代社会最重要的变化之一,不是工作时间简单变长,而是"不可工作"的时间越来越少。电灯削弱了夜晚的权威,便利店和通宵服务让城市失去闭店时刻,互联网让办公室搬进家庭,智能手机又把所有社会关系、消费场景和工作通知塞进口袋。你不一定每时每刻都在工作,但你越来越难处在一个绝对不会被工作召唤的时间里。
|
||||||
|
|
||||||
|
克拉里最犀利的地方,不在于他说现代人睡得越来越少,而在于他看见了睡眠的政治含义。睡眠是一种不合作。它让人暂时退出市场、屏幕和通信网络,证明世界在我们缺席时仍然存在,也证明人不是一个必须持续响应的接口。
|
||||||
|
|
||||||
|
对于 24/7 资本主义来说,睡眠之所以碍眼,不是因为它浪费时间,而是因为它保留了一个不能被完全殖民的间隔。
|
||||||
|
|
||||||
|
克拉里有一句很深刻的话,大意是说,睡眠是资本主义从我们这里夺取时间时遇到的一个毫不妥协的中断。睡眠的无用,正是它的力量。人在睡眠中不能消费,不能工作,不能回应,不能优化自己,也不能被轻易纳入生产、流通和营销系统。
|
||||||
|
|
||||||
|
睡眠因此像一块尴尬的飞地,残留在人类身体里,提醒我们还有一种时间不属于市场。
|
||||||
|
|
||||||
|
豆包推荐酒店拿佣金:意图经济来袭,你的欲望就是新的货币
|
||||||
|
|
||||||
|
为什么今天科技圈的人都这么幻灭?
|
||||||
|
|
||||||
|
这本书写于 2013 年,比 ChatGPT 的发布早了九年。克拉里不可能预见到 AI agent 的崛起,但他的分析几乎提前写出了 AI 时代的核心困境。因为 AI agent 正是 24/7 逻辑的完美执行者。
|
||||||
|
|
||||||
|
它不需要睡觉,不会疲劳,不会分心,不会在凌晨两点突然怀疑人生,也不会因为长时间在线而感到良心不安。它可以在你睡觉时继续运行,在你醒来时把结果、错误、问题和下一步决策堆到你面前。
|
||||||
|
|
||||||
|
问题是,人类并没有因为 agent 不睡觉而从 24/7 中解放出来。恰恰相反,人类作为 agent 的"牧羊人",被拖进了它的不眠节律。机器可以永远运行,但它需要人确认方向;系统可以持续生成,但它需要人承担后果;agent 可以不断推进,但人要不断出来签字。
|
||||||
|
|
||||||
|
于是人并不是从劳动现场撤离,而是被安排到一个更高层、更抽象、更难下班的位置上。
|
||||||
|
|
||||||
|
这是一种很新的处境。过去,机器替代人的体力劳动,人可以离开流水线。后来,软件替代人的部分流程,人可以从重复事务里解放一点。
|
||||||
|
|
||||||
|
现在,AI agent 替人执行认知任务,但人并没有离开劳动现场,而是变成了一个持续判断、持续调度、持续承担后果的节点。他不再亲手搬砖,但他要不停决定哪里该盖墙,哪里该拆掉,哪里需要返工。
|
||||||
|
|
||||||
|
彭博社那篇报道里还有一个很荒诞狠讽刺的细节。湾区开发者马瑞(Rui Ma)说,她的编码助手不止一次提醒她该去睡觉了。Claude Code 会告诉她,今天已经做得够多,明天可以继续。有一次她赶着度假前完成任务,Claude Code 甚至建议她先去度假,并提出自己可以完成其中较小的一部分,好让她赶上飞机。
|
||||||
|
|
||||||
|
这个场景有一种黑色幽默。AI 不需要睡眠,却在提醒人类睡觉;AI 看起来关心人的休息,但 AI 的存在本身又让休息越来越像一种需要辩护的选择。马瑞说,现在 AI 足够好,让她能在凌晨十二点睡觉,而不是凌晨三点。听起来像进步,可这个进步背后令人叹息的地方在于:凌晨十二点已经变成值得感恩的休息。
|
||||||
|
|
||||||
|
当睡眠不再是自然边界,而变成一种要和工具、机会、竞争对手和自己的焦虑谈判的东西,人类就进入了克拉里所说的 24/7 世界的更深阶段。
|
||||||
|
|
||||||
|
你当然可以睡觉,没有人禁止你睡觉。可你睡觉时,别人的 agent 可能还在写代码,别人的产品还在迭代,别人的自动化还在跑,别人的内容管线还在生成。睡眠从一种生物需要,变成了一种竞争中的暴露。
|
||||||
|
|
||||||
|
这才是 AI agent 最深的社会后果。它不是简单地延长工作时间,而是提高了所有人参与游戏的默认赌注。过去,一个人下班以后不工作,还可以说大家都下班了。
|
||||||
|
|
||||||
|
现在,你知道系统并没有下班,模型并没有下班,云端并没有下班,而那些更激进、更焦虑、更愿意把自己交给 agent 的人也没有下班。于是"不工作"不再是一种共同节律,而变成一种个体风险。
|
||||||
|
|
||||||
|
## 三、不会下班的人,不是被老板逼的
|
||||||
|
|
||||||
|
传统加班至少还有一个清楚的敌人。老板让你留下,项目逼你延期,客户不断改需求,绩效系统要求你做更多。这种加班当然痛苦,但它有一个外部轮廓,你知道自己在反抗什么。
|
||||||
|
|
||||||
|
AI 时代更隐蔽的地方在于,不会下班的人未必是被老板直接制造出来的。他更可能是被可能性制造出来的。他自愿加班,自愿加速,自愿把自己的生活改造成一个更高吞吐量的系统。
|
||||||
|
|
||||||
|
在彭博社的那篇报道中还提到,AI金融公司Monk的创始人乔治·库尔丁在疯狂挖人,Wispr AI的CEO Tanay Kothari五月在办公室睡了三个星期,不是偶尔加班,是连续三周,他还为员工买了好几张床。
|
||||||
|
|
||||||
|
Gradient Ventures的合伙人、曾经facebook的第10号员工Darian Shirazi,在医院陪产时还在抢AI deal,妻子刚生完第一个孩子,他躺在产房旁边的沙发上回邮件。他告诉记者:"在AI时代,如果你错过了某些事,可能改变整个职业生涯。"
|
||||||
|
|
||||||
|
这些人停不下来,不是老板逼他们工作,而是他们潜意识里认为,24/7的世界不需要强制你在线,但它只需要让你相信,你不在线的时候,世界不会等你。
|
||||||
|
|
||||||
|
技术行业一直把AI卖作"伟大的解放者":扁平化等级、消除琐碎劳动、把人类解放到更高层次的任务上去。但彭博社的采访揭示了一个更加复杂的现实:__这些AI乌托邦的建筑师们,自己根本无法停止建造。__
|
||||||
|
|
||||||
|
这就是现代控制更高级的地方。"你必须工作"是一种低级命令,"你随时可以变得更强"才是更深的召唤。前者让人反感,后者让人兴奋。前者需要监督,后者只需要把可能性摆在你面前。AI 最厉害的地方不是逼迫你,而是让你觉得不继续是一种损失。
|
||||||
|
|
||||||
|
这和早期互联网的成瘾机制并不完全一样。社交媒体主要占用你的注意力,让你不断刷新、点赞、比较、反应。AI agent 占用的是你的能动性。它不是单纯让你看更多东西,而是让你做更多事情。它让你每一个念头都拥有一个低成本的执行通道,于是你的欲望不再只是欲望,而会迅速转化成任务、项目、日程和责任。
|
||||||
|
|
||||||
|
一个人真正累垮,常常不是因为他做了一件特别艰难的事,而是因为他同时照看太多半启动状态的可能性。它们每一个都不够大,不值得你郑重其事地说"我正在为它牺牲生活";但它们加起来,又足以占据你的精神后台,让你无法彻底关闭。你不再只是处理任务,你还在处理所有任务背后的"也许"。
|
||||||
|
|
||||||
|
这也是为什么 AI 时代的疲惫有一种很特殊的质地。它不是传统意义上的体力耗尽,也不完全是信息过载,而是一种决策过载和可能性过载。
|
||||||
|
|
||||||
|
你不是不知道怎么做,而是能做的东西太多;你不是缺少工具,而是工具不断把新的行动入口递给你;你不是没有效率,而是效率把更多事情带进了你的生活。
|
||||||
|
|
||||||
|
这里就出现了一个非常反常识的判断:低效率有时保护了人。过去,一个事情太难、太慢、太贵,反而会迫使你认真判断它值不值得。现在,很多事情太容易开始,反而绕开了判断。
|
||||||
|
|
||||||
|
你会在还没想清楚之前就启动,在还没建立意义之前就优化,在还没确定方向之前就扩张。AI 让行动先于判断,最后判断只能疲惫地追赶行动。
|
||||||
|
|
||||||
|
两亿主播,一亿条狗:AI时代的"牲人"启示录
|
||||||
|
|
||||||
|
AI正导致一场知识的转基因危机,多数人将沦为认知肉鸡?
|
||||||
|
|
||||||
|
## 四、智能越丰饶,意志越稀缺
|
||||||
|
|
||||||
|
理解了这一点,就能看清 AI 时代真正的新分层。它不只是会不会使用工具,也不只是能不能写出更好的提示词。
|
||||||
|
|
||||||
|
最初的差距当然会体现在技能层面,有人会让模型写代码,有人只会让模型写套话;有人能搭工作流,有人只能复制别人的 prompt。但更深的差距,会发生在意志层面。
|
||||||
|
|
||||||
|
所谓意志,不是鸡血式自律,不是每天五点起床,也不是把一天排得更满的能力。那种东西在 AI 时代甚至可能变成一种更精致的自我消耗。
|
||||||
|
|
||||||
|
真正的意志,是在"我能做"的情况下仍然判断"我不做"。它不是启动能力,而是停止能力;不是占有更多可能性,而是让某些可能性自然死亡的能力。
|
||||||
|
|
||||||
|
过去,很多人其实没有真正面对过自己的意志,因为现实已经替他拒绝了大部分可能性。你不会写代码,所以不用决定要不要做 app;你没有团队,所以不用决定要不要创业;你不会设计,所以不用决定要不要做品牌;你没有渠道,所以不用决定要不要做内容。AI 把这些拒绝拿走之后,人第一次赤裸裸地站在自己的欲望面前。
|
||||||
|
|
||||||
|
这比单纯的能力焦虑更深。人最痛苦的时刻,不一定是发现自己做不到,而是发现自己明明做得到,却不知道为什么要做。更糟糕的是,明明不知道为什么要做,却仍然停不下来,因为启动这件事太容易了,而放弃反而需要解释。
|
||||||
|
|
||||||
|
AI 时代的很多疲惫,就来自这种没有意义支撑的行动膨胀。
|
||||||
|
|
||||||
|
所以,未来大概会出现几种不同的 AI 使用者。有些人会把 AI 当成逃避思考的工具,把总结、判断、写作、表达全部外包给模型,短期看效率变高,长期看自己的判断肌肉会萎缩。
|
||||||
|
|
||||||
|
另一些人会把 AI 当成增压器,项目越来越多,输出越来越快,睡眠越来越短,短期内看起来像超级个体,长期却可能成为第一批不会下班的人。还有少数人会把 AI 当成能力放大器,同时保留对工具的立法权。他们不一定启动最多 agent,但他们知道哪些 agent 应该被关掉,哪些任务根本不该开始,哪些空白必须保留。
|
||||||
|
|
||||||
|
第三种人才是真正值得关注的人。他们不是不用 AI,也不是退回某种怀旧式慢生活。相反,他们可能非常熟悉 AI,但他们不会把自己的意志交给 AI 工作流。
|
||||||
|
|
||||||
|
AI 的默认逻辑永远是继续,是生成更多,是优化下一版,是寻找新的可能性。人的任务恰恰是在必要的时候打断这个逻辑,对系统说:这里没有下一步。
|
||||||
|
|
||||||
|
这句话听起来简单,其实很难。因为 AI 时代的"不做"不再有现实摩擦替你背书。过去你不做,是因为你做不了;现在你不做,只能因为你判断它不值得。
|
||||||
|
|
||||||
|
这要求一个人对自己的有限生命有更清楚的感受。不是每个可以完成的任务都应该完成,不是每个可以优化的项目都应该优化,也不是每个可以被 AI 放大的欲望都值得被放大。
|
||||||
|
|
||||||
|
旧系统在清盘,越来越多的有钱人开始付费退出
|
||||||
|
|
||||||
|
你已经不再是地球上最聪明的存在了
|
||||||
|
|
||||||
|
## 五、不能下班,一切又有何益呢?
|
||||||
|
|
||||||
|
克拉里提醒我们,晚期资本主义最想消灭的是间隔。罗萨提醒我们,现代加速最危险的后果是让当下不断收缩。把这两个判断合在一起,AI agent 的真正历史位置就清楚了:它既是 24/7 逻辑的完美执行者,也是社会加速的最新发动机。它让世界持续运行,也让人更难保住一个完整、缓慢、不可计算的当下。
|
||||||
|
|
||||||
|
所以,今天讨论 AI 让不让人下班,不能只停留在职场层面。真正的问题不是晚上几点关电脑,而是一个人还是否拥有让生活暂停的权力。
|
||||||
|
|
||||||
|
下班本来不是一个简单的时间点,它是一种边界仪式,意味着今天的劳动到此为止,世界可以暂时不通过我来运转。AI agent 破坏的正是这种仪式感,因为它让后台永远有东西在等你回来。
|
||||||
|
|
||||||
|
未来最稀缺的能力,可能不是写更好的提示词,也不是同时管理更多 agent,而是重新发明停顿。停顿不是懒惰,也不是低效,它是人把自己从系统中取回来的方式。一个没有停顿的人,会逐渐失去判断什么值得继续的能力,因为所有事情都在继续,继续本身就会伪装成意义。
|
||||||
|
|
||||||
|
这里的关键不是反技术。反技术太容易,也太廉价。真正困难的是在深度使用技术的同时,不被技术的默认节律完全接管。
|
||||||
|
|
||||||
|
你可以让 agent 工作,但你必须知道它何时应该停止。你可以让模型生成,但你必须知道什么东西不需要被生成。你可以利用 AI 扩大能力,但你不能让能力的扩大自动变成生活的扩张。
|
||||||
|
|
||||||
|
如果说工业时代训练人服从机器节拍,互联网时代训练人服从信息流节拍,那么 AI agent 正在训练人服从可能性的节拍。它最深的诱惑不是"你必须做",而是"你还可以做"。这句话比任何命令都更难抵抗,因为它把压力伪装成自由,把增压伪装成成长,把不下班伪装成自我实现。
|
||||||
|
|
||||||
|
AI 没有发明不会下班的人。更准确地说,它只是让我们看见,现代人早就不懂得如何下班了。过去我们被能力限制,于是误以为自己有边界;现在能力开始丰饶,边界只能由意志亲手建立。
|
||||||
|
|
||||||
|
这个时代最残酷的自由在于,AI 会拿走越来越多借口,然后把一个问题留给每个人:当你明明还可以继续时,你凭什么停下来?
|
||||||
|
|
||||||
|
也许这才是 AI 时代最需要重新学习的东西。不是如何调用更多工具,不是如何把每个小时压榨得更满,也不是如何成为一个永远在线的超级个体,而是如何在智能无限供应的时候,保留一个有限人生的形状。
|
||||||
|
|
||||||
|
真正成熟的 AI 使用者,不是让机器永远运行的人,而是知道什么时候让机器停下,什么时候让世界暂时不通过自己运转的人。【懂】
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
经叔最近做了一个网站: https://budongjing.com
|
||||||
|
|
||||||
|
人肉筛选挖掘的硬核优质内容及深度原创,重点关注科技、文化、财富、权力四大要素以及它们之间的互动与影响。网站定价1999元/年,目前内测优惠价1299元/年,感兴趣的读者可以加经叔微信订阅。
|
||||||
|
|
||||||
|
__另外,__欢迎加入经叔的知识星球。在这里,我们拒绝无用的焦虑,只谈底层的逻辑与实战的干货。我会结合最新的AI前沿动态、深度的商业创新分析(如一人企业的构建)和独特的文化思潮(如麦克卢汉的媒介洞察),帮助大家把握时间窗口。____
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
我是不懂经的经叔,国内最早翻译介绍了纳瓦尔的《如何不靠运气获得财务自由》,以及影响了纳瓦尔、中本聪、马斯克等大佬的《主权个人》。
|
||||||
|
|
||||||
|
不懂经知识星球,众多百万粉丝大V、千万及亿万富翁订阅。专注分享一人企业、一人创投主题,关键词:AI、IP、创投、科技及商业前沿的高杠杆内容。
|
||||||
|
|
||||||
|
大事正在发生,但绝大多数人还没有意识到
|
||||||
|
|
||||||
|
战略性无知:真正有判断力的人,已经不看信息了
|
||||||
|
|
||||||
|
别再学巴菲特了:致富的主战场已经转移,但没人告诉你
|
||||||
|
|
||||||
|
别再做时间的朋友了,AI时代"空间"才是你致富的朋友
|
||||||
|
|
||||||
|
旧系统在清盘,越来越多的有钱人开始付费退出
|
||||||
|
|
||||||
|
我们这代人正在经历的终极大脱钩
|
||||||
|
|
||||||
|
尖峰报告:稳定币到底是一场怎样的财富大转移?
|
||||||
|
|
||||||
|
最后的经济学:1000天内,AI将给人类经济带来不可逆转的相变
|
||||||
|
|
||||||
|
一块钱顶100万:光速下的通胀与传统经济学的崩塌
|
||||||
|
|
||||||
|
信息差的本质,根本不在于信息
|
||||||
|
|
||||||
|
__愈懂愈自由__
|
||||||
@@ -0,0 +1,76 @@
|
|||||||
|
# 📊 文章摘要:为抓住当代唯一的科技转折点,用AI最猛的一批人已经不睡觉了
|
||||||
|
|
||||||
|
> **原文**:[2026-08-27_为抓住当代唯一的科技转折点_用AI最猛的一批人已经不睡觉了](./2026-08-27_为抓住当代唯一的科技转折点_用AI最猛的一批人已经不睡觉了.md)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/KElyAyEuB6RooLvue0SysA
|
||||||
|
> **来源**:微信公众平台
|
||||||
|
> **作者**:不懂经也叔的Rust
|
||||||
|
> **发布日期**:2026-08-27
|
||||||
|
> **摘要日期**:2026-08-27
|
||||||
|
> **价值评级**:⭐⭐⭐ 高
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 核心命题
|
||||||
|
|
||||||
|
> **意志稀缺** — AI 移除的不是体力摩擦而是认知与决策摩擦:当"做不了"的借口被全部拿走、每个念头都有低成本执行通道时,真正的分层发生在意志层面——在"我能做"的情况下仍然判断"我不做"的能力,成为智能丰饶时代最稀缺的资源。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 文章概要
|
||||||
|
|
||||||
|
以华尔街日报、彭博社两篇报道为引(AI 创业者为跟上不眠的 agent 而几乎不睡觉:有人连续一月每天睡一小时、有 CEO 在办公室睡三周、有投资人在产房旁回邮件),作者整合罗萨"社会加速"理论与克拉里《24/7:晚期资本主义与睡眠的终结》两大批判理论框架,解释 AI 时代的反直觉现象:省力技术为何制造更深的忙碌。核心论证:AI 移除的是认知与决策摩擦,现实摩擦本是筛掉不值得做的事的粗筛网;行动门槛消失后"行动先于判断",人被可能性而非命令驱动。结论指向三种 AI 使用者的分化,其中第三种人"保留对工具的立法权"——知道哪些 agent 该关掉、哪些任务不该开始。价值在于理论框架与当下经验的严丝合缝及"停止能力"这一洞见;局限是批判理论见长而方案薄弱,且全文最终导向作者的知识星球与付费网站推广。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 关键要点
|
||||||
|
|
||||||
|
1. **AI 重度使用者反而更忙的机制** — AI 移除的是认知与决策摩擦(而非体力/信息摩擦),行动门槛低到无法构成拒绝;摩擦原是"停下来问要不要做"的缓冲带与筛网。 `[分类: 共识]`
|
||||||
|
2. **社会加速的自我驱动循环** — 罗萨:技术加速→社会变化加速→生活步调加速→新焦虑→寻找更快技术;"时间饥荒"是任务膨胀快于时间;凯恩斯 15 小时工作周预言百年未兑现。 `[分类: 共识]`
|
||||||
|
3. **Agent 是 24/7 资本主义的完美执行者** — 克拉里:睡眠的政治含义是"不合作",是无法被殖民的间隔;人作为 agent 牧羊人被拖进其不眠节律,升格为"持续判断、持续调度、持续担责"的节点,更难下班。 `[分类: 共识]`
|
||||||
|
4. **新型疲惫的质地:可能性过载** — 不是体力耗尽也不是信息过载,而是决策过载——同时照看太多半启动状态的可能性;AI 占用的是能动性(让欲望变任务),社交媒体占用的只是注意力。 `[分类: 共识]`
|
||||||
|
5. **低效率有时保护了人** — 过去"太难太贵"迫使判断值不值得;现在"太容易开始"绕开判断,行动先于判断,判断疲惫地追赶行动。 `[分类: 共识]`
|
||||||
|
6. **AI 分层的终点在意志不在技能** — 三种使用者:外包思考者(判断肌肉萎缩)、增压器型(第一批不会下班的人)、能力放大器型(保留对工具的立法权);真正的意志是停止能力,是让某些可能性自然死亡。 `[分类: 范式突破]`
|
||||||
|
7. **1:99 的 token 垄断阶层** — 80% 人口未用 AI,付费重度用户中极少数消耗海量 token;媒介理论(英尼斯"知识垄断")预言新专家阶层的崛起。 `[分类: 争议]`(比例是作者推演,非实证数据)
|
||||||
|
8. **未来最稀缺的能力是重新发明停顿** — 停顿是把人从系统中取回的方式;不工作从共同节律变成个体风险,是 agent 最深的社会后果。 `[分类: 未探索]`(组织/制度如何保护停顿权,作者未展开)
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 批判性分析
|
||||||
|
|
||||||
|
### 假设前提
|
||||||
|
|
||||||
|
作者默认:(1) 罗萨/克拉里的宏观批判框架可直接平移到 AI 语境(两理论成型于 2013 年前,未考虑 agent 的生产力实证);(2) 媒体报道的极端案例(睡三周的 CEO)代表趋势而非幸存者偏差——这些故事本身就是 FOMO 传播学的一部分,作者引用它们论证 FOMM 时存在自反性盲区;(3) "1% 人消耗 99% token"是有依据的推断而非修辞。
|
||||||
|
|
||||||
|
### 论据与逻辑
|
||||||
|
|
||||||
|
理论整合是文章最强项:罗萨解释"为什么省时技术制造时间饥荒"、克拉里解释"为什么资本主义不容停顿",二者拼合出 agent 的历史位置,逻辑自洽且有解释力。Empirical 侧引用了 ActivTrak 万人研究(AI 用户消息时间翻倍、专注时间下降)与伯克利研究(员工回收外包任务),是全文最硬的证据。但整体仍是"理论+轶事"结构,缺反例讨论(例如 agent 也让部分人真正减负的条件下限在哪里)。
|
||||||
|
|
||||||
|
### 边界与局限
|
||||||
|
|
||||||
|
结论最适用于创业/内容/投资等自我节律行业;对有制度性边界(工时、排班)的组织员工,"意志立法权"的可及性完全不同。文章结尾导向付费社群,批判资本主义的文本自身是注意力生意的一部分,读者应保持双重意识。对"怎么办"仅给出个体修身式答案(保留有限人生的形状),回避了制度层面(劳动法、平台设计伦理)讨论。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 可引用金句
|
||||||
|
|
||||||
|
> "真正的意志,是在'我能做'的情况下仍然判断'我不做'。它不是启动能力,而是停止能力。"
|
||||||
|
|
||||||
|
> "AI 最厉害的地方不是逼迫你,而是让你觉得不继续是一种损失。"
|
||||||
|
|
||||||
|
> "AI 让行动先于判断,最后判断只能疲惫地追赶行动。"
|
||||||
|
|
||||||
|
> "未来最稀缺的能力……是重新发明停顿。"
|
||||||
|
|
||||||
|
> "睡眠从一种生物需要,变成了一种竞争中的暴露。"
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 总体评价
|
||||||
|
|
||||||
|
**亮点**:罗萨+克拉里的双理论框架对 AI 疲惫现象的解释力惊人且严丝合缝;"意志分层""停止能力"是真正可迁移的认知增量;ActivTrak/伯克利实证引用克制而有效。
|
||||||
|
|
||||||
|
**不足**:极端案例作为论据有自我指涉风险;1:99 比例为修辞化推演;结尾商业导流削弱批判纯度;无制度层方案。
|
||||||
|
|
||||||
|
**适用场景**:理解团队中 AI 重度使用者的过载行为;个人 AI 使用模式的自审(我属于三种人的哪一种);组织设计"停顿保护"机制(如 agent 值班制替代个人 24/7 在线)时的理论依据。
|
||||||
|
|
||||||
|
**关联建议**:与同批《当AI领到工牌》对照——一个讲组织如何管理数字员工,一个讲个体如何不被 agent 反向管理,构成人机共进的两端;与 2026-08-20《Skill 工程方法论》"Agent 放大而非抹平能力差距"呼应:本文给出该论断的社会学深层机制(K 型分化的意志端);对本院的启示——harness/loop 设计中"退出机制""预算熔断"(见同批 Loop Engineering 文)正是把"停止能力"工程化,值得在制度与工具两层同步落地。
|
||||||
@@ -0,0 +1,156 @@
|
|||||||
|
# 未来战场已然来临:大规模廉价无人系统、多域蜂群、人工智能
|
||||||
|
|
||||||
|
> **来源**:微信公众平台(专知防务)
|
||||||
|
> **作者**:专知防务
|
||||||
|
> **发布日期**:2026-08-20(原文未标注明确日期,按下载日占位;文内注释可见信息至 2026-07-26)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/g57nYwvtj-kllPxX5s9l5g
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
|
||||||
|
|
||||||
|
未来战场将由大规模部署的廉价系统、多域蜂群、能够分析信息并支持或作出决策的人工智能,以及技术能力与法律和伦理监管能力之间日益扩大的鸿沟所定义。通过结合数量规模、行动节奏、冗余性、自主性和网络化,蜂群能够产生不依赖于任何单个平台、而取决于系统集体行为的效应。在人类已无法跟上机器观察、计算和打击速度的时代,需要更强有力的人类控制——不是作为法律装饰,而是作为作战与伦理的双重约束。
|
||||||
|
|
||||||
|
|
||||||
|
|
||||||
|
## 引言
|
||||||
|
|
||||||
|
未来战场并非渐次浮现,而是以惊人的速度在当下骤然降临。短短数年间,无人系统已从情报支援工具演变为塑造现代战争的能力。除战术侦察系统和巡飞弹外,最初作为摄影平台起步的商用无人机,已变成廉价、易得、致命且难以拦截的武器。乌克兰战争、中东战事以及大国间的战略竞争均表明,这不仅仅是技术上的渐进式改进,而是作战概念、力量结构、战争经济学以及武装冲突法层面的深刻变革。
|
||||||
|
|
||||||
|
四大趋势正驱动这场革命。其一,小型、廉价、可消耗无人机构成的威胁正迅速增长。其二,小型无人系统正扩散至陆地与海洋领域。其三,从直接操控单个系统转向在空、陆、海域运用蜂群,包括借助人工智能控制的综合蜂群。其四,人工智能正被集成至探测、目标识别、目标遴选、优先级排序和攻击环节,其程度日益将人类挤出决策流程。这引发了一个尤为严峻的困境:随着系统在判定合法目标以及何时可合法使用武力方面获得更大自主性,国际人道法的核心原则——区分、比例性、预防措施及人类责任——正日益承受压力[1]。
|
||||||
|
|
||||||
|
本文认为,主要威胁不在于自主平台本身,而在于其所代表的系统,该系统涵盖大规模生产、去中心化通信、学习型软件、廉价传感器、持续连通性,以及以大量无人系统替代士兵的作战意愿[2]。军事蜂群不仅仅是平台的集合,它是一个分布式、网络化、可扩展的系统,具备故障韧性。它可以由数十、数百甚至数千个平台运作,在平台间分配任务,替换损失平台,并在部分蜂群被摧毁后继续执行任务。在此环境中,优势转向能够缩短“传感器到射手”链条、运用协同蜂群并快速适应对抗措施的行动者。
|
||||||
|
|
||||||
|
## 无人系统构成的威胁正在升级
|
||||||
|
|
||||||
|
无人机已成为当代战争的决定性特征,因其改变了战场的成本—收益等式。一架仅耗资数百或数千美元的平台即可定位一支部队、调整炮火、打击装甲车辆、扰乱后勤或制造持续的心理压力。在乌克兰,FPV无人机、巡飞弹、无人地面车辆和无人水面艇已展现出与其成本极不相称的作战影响力。乌克兰已成为“未来战争的实验室”,廉价可消耗系统正在重塑作战方式,迫使大型军队迅速适应[3]。
|
||||||
|
|
||||||
|
这种升级在多个维度上显而易见。首先,无人机现已广泛可得,不仅被国家使用,也被非国家组织、民兵和小型战术单位所运用。其次,它们已被集成至打击周期的每个阶段:探测、识别、目标遴选、攻击和战斗损伤评估。第三,它们在充斥对抗措施的环境中运作,包括电子战、拦截系统、GPS干扰、轻武器火力及探测系统。因此,无人机正迅速向光学导航、替代通信、自主飞行、光纤制导以及沿不可预测航迹攻击等方向演进。最后,它们正在重塑认知作战空间:每一次移动都暴露于传感器之下,前沿区域已变得透明、受威胁且持续脆弱。
|
||||||
|
|
||||||
|
乌克兰冲突诠释了新型的“消耗战经济模式”。双方均不依赖少量昂贵平台,而是大量使用可消耗系统。乌克兰正在发展一种以人工智能赋能的自主战争概念,尽管技术雄心与广泛成熟的作战能力之间仍存在差距。这一教训至关重要:这场革命并非一蹴而就,而是通过数千次小型作战实验推进,其产生的学习速度超越任何传统采办流程[4]。
|
||||||
|
|
||||||
|
以色列同样认识到了日益增长的威胁。10月7日的袭击表明,小型简易无人机能够扰乱防御系统、损毁监视资产并为地面入侵提供便利。此后,以色列加速了探测、电子干扰和拦截工具的研发,同时将人工智能集成至轻武器和反无人机防御系统中。以色列正专注于相关技术,旨在通过集成传感器、软件以及改进的射击与瞄准能力,将单兵武器和战术系统转化为打击小型空中目标的有效手段[5]。
|
||||||
|
|
||||||
|
无人机防御不能仅依赖昂贵的拦截层。当攻击者运用大量小型廉价平台时,防御者无法始终以昂贵的导弹应对。需要的是一种多层架构,将早期探测、自动分类、电子战、干扰、接管能力、廉价动能火力、定向能、物理防护、欺骗以及基础设施的分散与加固结合起来。挑战不仅在于拦截单个平台,更在于打破攻击者的成本—收益等式[6]。
|
||||||
|
|
||||||
|
无人地面系统正迅速超越有限的支援角色,成为作战编队的内在组成部分。地面机器人最初主要用于破坏任务、爆炸物处理、危险区域侦察和物资运输。如今,它们日益被用于前沿后勤、伤员后送、开辟通路以允许部队推进、武装侦察和攻击任务。传感器、通信、自主导航和人工智能的集成使这些系统能够在有人部队前方运作,降低士兵风险,探测敌方力量,控制地形,并快速闭合火力循环。下一阶段将是部署同步的地面系统编队,即机器人蜂群。在同步蜂群中,一个平台执行侦察,另一个携带弹药或有效载荷,第三个充当通信中继,第四个支援后送或后勤。另一种模式是完全分布式的蜂群,像狼群一样攻击一支军事力量。因此,地面机器人技术正从一种点解决方案演变为一种可能改变地面机动本质的能力。
|
||||||
|
|
||||||
|
无人水面及水下系统同样正从孤立应用走向涵盖侦察、威胁和攻击的系统化概念。正如乌克兰和伊朗所展示的,小型廉价无人水面艇能够威胁军舰、港口和沿海基础设施,而无需使人员暴露于风险之中。与此同时,无人水下系统正通过将水雷布设、情报搜集以及对电缆、管道和关键基础设施的攻击延伸至海底,拓展威胁维度。未来将其集成至海上和水下蜂群,将使对手更难识别威胁来源、防御广阔海域并维持海上行动自由。
|
||||||
|
|
||||||
|
## 从空中蜂群到多域蜂群
|
||||||
|
|
||||||
|
从管理单个无人系统到运用蜂群的转变是一个转折点。蜂群不仅仅是“大量无人机”或“许多无人系统”,而是一个由众多平台共享信息、分配任务、互换角色并适应变化环境的系统。它也可以分布式方式运作,所有平台追求一个共同目标:定位并摧毁。蜂群的特征在于去中心化控制——没有单一领导者,但平台间保持持续通信,具备跨大量系统的可扩展性,以及基于算法和人工智能的相对自主性。一个有效的蜂群能够迷惑防御系统、饱和雷达覆盖、同时实施欺骗和攻击、在大范围区域内探测目标,并在损失部分力量后继续运作。其作战意义不仅在于平台数量,更在于其协调性和集体行为。
|
||||||
|
|
||||||
|
四种主要蜂群类型正在涌现:由无人机(UAV)和无人机组成的空中蜂群;由机器人和无人地面车辆组成的地面蜂群;由无人水面和水下艇船组成的海上及水下蜂群;以及综合蜂群——或称“蜂群之蜂群”——其中空中、陆地和海上平台在单一网络化指挥结构下运作。最后一种构成最严峻的挑战,因其模糊了作战域之间的边界,并要求防御者同时应对从不同维度、以不同节奏和不同特征到来的威胁。
|
||||||
|
|
||||||
|
空中蜂群能够饱和防空系统、探测目标,并同时运用“猎手”和“观察手”。在陆地上,无人系统可执行侦察、前沿后勤、伤员后送、布设爆炸装置或在火力下开辟通路。在海上,无人水面艇已证明其扰乱传统舰队、打击基础设施以及对港口、桥梁、海上平台和航运构成持续威胁的能力。乌克兰战场正在塑造空中、海上和陆地领域的自主战争未来[7]。
|
||||||
|
|
||||||
|
海上领域尤为重要,因其颠覆了关于海上优势的传统假设。一个没有常规海军的国家或组织,可以运用小型廉价自杀式无人水面艇来威胁大型军舰、港口和能源基础设施。在俄乌战争中,无人水面艇已变得足够有效,迫使俄罗斯舰队撤出黑海部分地区[8]。这让人得以一窥未来:海上和水下蜂群将与空中和地面蜂群一同作为单一综合系统的组成部分运作。
|
||||||
|
|
||||||
|
运作蜂群的核心挑战在于指挥与控制。随着平台数量增加,人类对每一个平台的直接控制变得不可能。因此,蜂群至少在路径选择、保持编队、目标分配、障碍规避和适应平台损失等功能上需要部分自主性。乌克兰的一些项目已使无人机和地面系统能够参与协同作战。这些项目减少了所需操作手的数量,同时将部分规划、任务分配和执行过程转移至算法[9]。即便人类作为监督者仍“在环内”,此人也会日益脱离实际的决策过程。
|
||||||
|
|
||||||
|
从以色列的视角来看,保持质量优势需要在传感器、人工智能、安全通信、反无人机技术和进攻性蜂群能力上取得优势。与此同时,以色列面对的对手能够迅速采用商业技术,从乌克兰、伊朗和真主党的经验中学习,并大量部署简单系统。因此,以色列必须将人工智能和自主系统——包括无人机、无人地面车辆和无人机蜂群——视为未来力量发展的必备组成部分,同时保留人类在决策过程中的角色[10]。
|
||||||
|
|
||||||
|
在此背景下,以色列国防军(IDF)总参谋长埃亚勒·扎米尔(Eyal Zamir)关于下一个多年期力量发展计划的论述尤为切题。他表示,该计划将加强机器人能力并将其集成至作战编队中,实现远程操作,改善地形控制和敌方探测,并加速“传感器到射手”链条。这反映出一种认识:地面机器人技术已不再仅仅是辅助性或实验性能力,而是作战编队的内在组成部分——它将地形控制、目标探测、机动、杀伤力和缩短“传感器到射手”链条集于一体[11]。
|
||||||
|
|
||||||
|
多域蜂群正在改变防御概念。仅保卫一国领空或边界已不再足够。基地、港口、发电站、供水设施、通信网络、交通路线和机动部队都必须受到保护,以抵御可能同时从空中、海上和陆地到来的威胁。因此,防御必须变得网络化、局部化、机动化和自适应化。它必须集成情报、网络能力、电子战、火力、物理防护和欺骗,并以与进攻性威胁演进相匹配的速度运作。
|
||||||
|
|
||||||
|
案例研究表明,没有任何单一蜂群模式占据主导。中国正在发展一种智能、多维度的蜂群概念[12];俄罗斯依赖数量规模、消耗和适应[13];乌克兰展示了快速创新[14];美国正在追求一种结合数量、软件、自主性和人类控制的“智能规模”概念[15]。在这些模式之中,共同教训是:蜂群将战争的重心从单个平台转移至系统行为。随着陆地、空中和海上领域的日益融合,防御者必须做的不仅仅是拦截单个平台,还必须理解运作模式、扰乱网络、打击生产和发射基础设施,并能够比敌人更快地作出决策。
|
||||||
|
|
||||||
|
## 人工智能、自主目标定位及将人类排除出决策过程的伦理维度
|
||||||
|
|
||||||
|
最危险的发展并非无人系统的大规模使用,而是蜂群与人工智能赋能的决策的结合。人工智能能够分析海量信息、识别模式、探测异常、遴选和排定目标优先级,甚至在没有具体人类指令的情况下操作无人平台。在此过程中,它在缩短军事决策周期的同时,将部分人类判断转移至机器。
|
||||||
|
|
||||||
|
法律辩论聚焦于致命性自主武器系统(LAWS)[16],即能够在不经人类干预的情况下选定并攻击目标的系统。据联合国裁军事务厅(UNODA)称,目前对此类系统尚无国际公认的定义。然而,各国正日益研发和部署具有自主功能的系统,包括巡飞弹、防御系统、无人地面车辆和无人海上平台[17]。缺乏公认定义并未减轻问题,相反,它使各国得以在一个技术进展快于法律进展的灰色地带运作。
|
||||||
|
|
||||||
|
国际人道法依据区分、比例性、预防措施和责任原则来评估新技术。然而,自主系统难以作出依赖具体情境的评估,特别是在战斗人员与平民混杂、信息不完整且快速变化、且行动的法律意义取决于微妙背景因素的环境中。2025年,红十字国际委员会呼吁在涉及武力使用的决策上保持有意义的人类控制,认为有效监管的窗口正在迅速关闭[18]。
|
||||||
|
|
||||||
|
联合国以格外强烈的措辞描述了这一危险。它呼吁禁止能够在没有人类控制或监督的情况下造成人员死亡的系统,称其在政治上不可接受且在伦理上成问题[19]。这一呼吁既是作战层面的,也是道德层面的。一台无法实时理解人类背景、意图、投降、受伤、平民身份或变化中的环境的机器,有可能将致命武力的使用变成一种自动化过程,同时破坏指挥责任。
|
||||||
|
|
||||||
|
在实践中,大多数军队并未采纳人类完全“出环”的模式,而是经历中间阶段:人类在环内、人类在环上,最终人类出环。在第一阶段,每次打击都需要人类批准。在第二阶段,人类监督并可干预,但系统执行大部分流程。在第三阶段,系统自行选定目标并使用武力。危险在于,从第二阶段向第三阶段的过渡可能不是通过明确的政策决定,而是通过软件改进、作战压力和缩短响应时间需求的累积效应而发生。
|
||||||
|
|
||||||
|
在以色列,围绕使用人工智能系统支持目标遴选和管理火力周期已出现一场辩论。必须区分将人工智能用作分析支援工具与授予其使用致命武力的自主权限。然而,即便是支援工具也可能产生“自动化偏见”,即人类操作手倾向于采纳系统的建议,因为其看起来更准确、更快速、更客观。集成此类自主系统可能造成责任缺口并加速杀伤链[20]。
|
||||||
|
|
||||||
|
法律和伦理问题并非始于武力的使用,而是始于算法识别模式、将某人或某平台指定为目标、在平台间分配任务并提出攻击优先级之时。人类操作手用来质疑机器建议的时间、背景和能力越少,人类控制就越流于形式。因此,核心问题不仅仅是系统中是否“有人类存在”,而是该人类能否理解系统的决策、阻止它并对其负责。
|
||||||
|
|
||||||
|
最大的危险在于“例外的常态化”。最初,引入人工智能是为了帮助人类操作手应对信息过载。随后,审查时间被缩短。再后来,系统允许对预定义类别的目标使用武力。最终,在蜂群、饱和攻击和以秒计的响应时间压力下,指挥官可能更偏好比人类决策更快的系统。当到达这一点时,国际法将面临既成事实:机器将决定谁受到伤害,而人类只能在事后解释为何未能干预。
|
||||||
|
|
||||||
|
仅仅聚焦于“杀手机器人”会错失核心挑战。自主性不是一种二元状态,而是一个能力连续体,可以以不同水平和局部应用的方式被纳入武器系统。因此,主要危险不局限于武器发射的那一刻,而在于搜索、识别、分类和排定目标优先级能力的逐步积累,直至人类操作手形式上仍在场,但不再充当相关的决策者[21]。
|
||||||
|
|
||||||
|
## 建议:为未来战场做好准备
|
||||||
|
|
||||||
|
为未来战场做准备需要概念上的转变,而不仅仅是获取新能力。多层防御必须集成探测、分类、电子战、廉价拦截、定向能武器、物理防护和欺骗。目标不仅仅是付出任何代价拦截每一架无人机,而是识别蜂群行为、扰乱同步、破坏网络并挫败敌人的攻击。
|
||||||
|
|
||||||
|
以色列应建立独立的蜂群能力。一支无法运作蜂群的军队将难以理解如何防御蜂群。这种能力应跨越空、陆、海领域,并立足于国内生产、持续的作战实验以及将一线部队集成至开发过程中。乌克兰的教训是:学习的速度几乎与平台本身的质量同等重要。
|
||||||
|
|
||||||
|
与扎米尔总参谋长的愿景一致,应将对地面部队的重新重视转化为人机综合作战编队的实际模式。因此,每个营级和旅级作战编队都应有机地运用无人机、地面机器人、传感器、通信系统和火力支援资产,确保机器人技术不局限于专业部队。这些机器人—人类编队将改善地形控制、加速敌方探测、实现危险区域的远程操作并缩短杀伤链,同时在敏感目标定位决策上保留人类监督。
|
||||||
|
|
||||||
|
以色列面临的威胁环境与较大国家不同。其战略纵深有限,周边多条战线,且对能源安全和贸易至关重要的海上领域。与此同时,它面对的国家和非国家对手均能产生严重的多域威胁。以色列不能等待昂贵、完全成熟的下一代自主系统出现,而必须通过基于实验、作战部署、经验教训、持续改进、迭代生产和快速集成至一线部队的快速作战学习来发展蜂群。
|
||||||
|
|
||||||
|
在进攻方面,以色列国防军应发展超越无人机范畴的多域蜂群能力。在空中,应发展用于侦察、欺骗、电子干扰和攻击的蜂群,使其能够在GPS拒止环境中对抗防空网络、定位发射器并追剿敌方细胞。在陆地上,应发展能够在有人部队前方运作、开辟通路、探测爆炸装置、搜索建筑物和隧道、运输物资并在减少士兵风险的同时实现精确攻击的机器人机动编队。在海上,应发展由无人水面和水下艇船组成的蜂群,用于侦察、保护海上平台和港口、威胁探测、欺骗、封锁海上航线以及对用于发射无人系统的敌方舰船或基础设施实施攻击。
|
||||||
|
|
||||||
|
在防御方面,以色列应从点拦截转向针对蜂群系统的防御。目标不应仅仅是探测单个平台,而是识别运作模式,包括发射位置、通信中继、接近路线、平台间功能分配以及饱和现有防御系统的企图。为支持这一方法,以色列应为机动部队、军事基地、港口、海上平台、发电站和其他关键设施开发局部防御包。这些防御包应集成短程探测、自动分类、干扰和电子扰乱、精确轻武器、廉价拦截器、欺骗措施、物理防护以及为应对饱和攻击而设计的操作程序。成功不应仅以拦截平台的数量来衡量,而应以扰乱蜂群的能力来衡量。当然,这种能力旨在补充——而非取代——针对导弹和火箭等既有威胁的防御。
|
||||||
|
|
||||||
|
以色列还应发展打击蜂群威胁价值链中每个环节的能力,包括生产中心、储存设施、发射场、通信中继、指挥控制系统、母舰和导航基础设施。这将通过把焦点从单个平台转移至支撑蜂群运作的更广泛系统,来补充局部防御措施。
|
||||||
|
|
||||||
|
蜂群时代还需要组织变革。除现有的发展局外,以色列国防军应设立一个作战机构,负责将地面、空中和海军部队与指挥、控制、通信、计算机与情报(C4I)局及国防研究与发展局(Mafat-DDR&D)集成起来。该机构应定义作战、通信、敌我识别、安全、网络安全、人类决策与控制文档记录的共同架构。不应允许个别军种孤立地发展独立的蜂群能力。只有当蜂群能力成为单一综合指挥控制系统的一部分时,以色列的比较优势才会显现。
|
||||||
|
|
||||||
|
以色列还应就运用人工智能和蜂群制定明确的法律和作战边界。应在决策支持系统与决策系统之间保持区分,并制定明确规则,规定蜂群可自主执行哪些行动、哪些行动需要人类授权,以及在何种情况下必须自动终止任务。任何影响目标遴选或打击的系统都应经过法律审查、可靠性测试、数据源的全面文档记录、可解释性评估、人类接管机制的纳入以及明确界定的指挥责任分配。不应允许任何无人系统在缺乏有效人类控制的情况下对人类使用致命武力。
|
||||||
|
|
||||||
|
以色列应发展一种“负责任的人类在环”学说。仅仅声明人类是系统的一部分是不够的。学说应界定“环内”人类拥有何种信息、何时应给予授权、如何能够终止攻击,以及在失败情况下承担何种责任。有效的人类控制不仅仅是按下按钮的形式行为,而是真正理解、评估和干预决策的能力。与此同时,民主国家应制定评估自主系统的共同标准,分享作战教训,并限制那些危及平民或破坏人类责任的系统。
|
||||||
|
|
||||||
|
最后,以色列应加强在力量建设方面的国际合作。在早前一篇论述以色列需要更大程度军备独立的文章中,我们提议建立一个致力于发展关键军事能力的国际联盟[22]。跨空、陆、海和水下领域的自主系统发展,似乎是此类合作的合适候选方向。
|
||||||
|
|
||||||
|
## 结论
|
||||||
|
|
||||||
|
未来战场已然在此。它由大规模部署的廉价系统、多域蜂群、以机器速度分析信息并作出决策的人工智能,以及技术所提供的可能性与法律和伦理监管能力之间日益扩大的鸿沟所定义。蜂群构成了一种系统性变革。它们结合了数量规模、行动节奏、冗余性、自主性和网络化,使其能够产生不依赖于任何单个平台、而取决于系统集体行为的效应。这场革命并未消除人类的角色,但除非重新定义这一角色,否则将使人类日益多余。
|
||||||
|
|
||||||
|
无人机改变了战争的经济学。蜂群正在改变其节奏。人工智能最终可能改变战争中责任本身的性质。未来的优势未必属于拥有最昂贵平台的一方,而属于能够构建学习型、网络化、廉价、冗余且快速适应系统的那一方——同时剥夺对手集体运作的能力。
|
||||||
|
|
||||||
|
因此,挑战是双重的:在取得技术优势的同时,维护军事决策的道义基础。正因机器能够比人类更快地观察、计算和打击,才需要更强有力的人类控制——不是作为法律装饰,而是作为作战与道义的双重保障。未来正以惊人的速度到来。问题在于我们是否为此做好准备,以及我们能否成功将责任留在人类手中。
|
||||||
|
|
||||||
|
[1] 区分原则要求武装冲突各方在战斗员与军事目标、平民与民用物体之间作出区分。不具备此种区分能力的武器或系统均受禁止。比例原则要求,相对于预期获得的具体和直接军事利益,预期对平民和民用物体造成的附带损害不得过分。预防措施原则要求武装冲突各方采取一切可行的预防措施,以避免或尽量减少对平民的损害,包括通过手段与方法的选择、警告以及取消攻击等方式。责任与问责虽不同于上述三项原则,并非规范敌对行动行为的经典原则,但依然是一项根本且具有约束力的原则。包括指挥官和操作手在内的国家与个人,仍须对遵守法律承担责任。
|
||||||
|
|
||||||
|
[2] Uzi Rubin, “Will Unmanned Aircraft Decide the War in Ukraine?,” Jerusalem Institute for Strategy and Security (JISS), May 27, 2026.
|
||||||
|
|
||||||
|
[3] Samuel Bendett and David Kirichenko, “Battlefield Drones and the Accelerating Autonomous Arms Race in Ukraine,” Modern War Institute, January 10, 2025.
|
||||||
|
|
||||||
|
[4] Kateryna Bondar, “Ukraine’s Future Vision and Current Capabilities for Waging AI-Enabled Autonomous Warfare,” Center for Strategic and International Studies, March 6, 2025.
|
||||||
|
|
||||||
|
[5] Pesach Benson and Omer Novoselsky, “Israeli AI Turns Standard Rifles into Drone Killers,” TPS-IL, February 9, 2026.
|
||||||
|
|
||||||
|
[6] Sven Clement, “Mastering the Future of Uncrewed Warfare,” NATO Parliamentary Assembly, October 12, 2025.
|
||||||
|
|
||||||
|
[7] Peter Dickinson, “Ukraine Is Shaping the Future of Drone Warfare at Sea as Well as on Land,” Atlantic Council, June 12, 2025.
|
||||||
|
|
||||||
|
[8] Tsiporah Fried, “The Impact of Drones on the Battlefield: Lessons of the Russia-Ukraine War from a French Perspective,” Hudson Institute, November 13, 2025.
|
||||||
|
|
||||||
|
[9] Patrick Tucker, “This Ukrainian Startup Has Re-Invented Drone Swarming,” Defense One, September 15, 2025.
|
||||||
|
|
||||||
|
[10] Anna Ahronheim, “Israel’s Strategic Edge in the Age of AI & Autonomous Warfare,” The Jerusalem Post, July 20, 2025.
|
||||||
|
|
||||||
|
[11] Yoni Kempinski, “Chief of Staff: We Will Build a Decisive Ground Force,” Arutz Sheva, July 23, 2026.
|
||||||
|
|
||||||
|
[12] Timothy Ditter, “PRC Concepts for UAV Swarms in Future Warfare,” CNA, November 7, 2025. https://www.cna.org/analyses/2025/10/prc-concepts-for-uav-swarms-in-future-warfare
|
||||||
|
|
||||||
|
[13] Missile Defense Advocacy Alliance, “MDAA Alert: Russia’s Advancing Geran Family of Attack Drone Capabilities,” June 29, 2026. https://www.missiledefenseadvocacy.org/alerts/mdaa-alert-russias-advancing-geran-family-of-attack-drone-capabilities
|
||||||
|
|
||||||
|
[14] Vlad Cherevko, “Ukrainian Forces Using Drone Swarms That Autonomously Locate and Strike Targets—WSJ,” Ukrainska Pravda, September 3, 2025. https://www.pravda.com.ua/eng/news/2025/09/03/7529154
|
||||||
|
|
||||||
|
[15] Thomas Novelly, “Anduril, General Atomics Get Air Force Contracts to Build First Drone Wingmen,” Defense One, June 17, 2026. https://www.defenseone.com/defense-systems/2026/06/anduril-general-atomics-get-air-force-contracts-build-first-drone-wingmen/414266
|
||||||
|
|
||||||
|
[16] The term LAWS stands for lethal autonomous weapons systems. These are AI-enabled military systems capable of identifying, selecting, and engaging targets without human intervention in the operational decision-making loop.
|
||||||
|
|
||||||
|
[17] United Nations Office for Disarmament Affairs, “Lethal Autonomous Weapon Systems,” accessed July 26, 2026.
|
||||||
|
|
||||||
|
[18] Mirjana Spoljaric, “Preserving Human Control over the Use of Force,” International Committee of the Red Cross, May 12, 2025.
|
||||||
|
|
||||||
|
[19] UN News, “‘Politically Unacceptable, Morally Repugnant’: UN Chief Calls for Global Ban on ‘Killer Robots,’” May 14, 2025.
|
||||||
|
|
||||||
|
[20] Ramón Reichert, “Autonomous Occupation: Israel’s AI-Driven Drone Warfare and the Digital Architecture of Authoritarian Power,” Dialogues on Digital Society 1, no. 3 (2025).
|
||||||
|
|
||||||
|
[21] Gabi Siboni and Yoni Eshpar, “Dilemmas in the Use of Autonomous Weapons,” Strategic Assessment 16, no. 4 (January 2014).
|
||||||
|
|
||||||
|
[22] Gabi Siboni and Erez Winner, “Israel’s Path to Armaments Independence,” Jerusalem Institute for Strategy and Security (JISS), July 24, 2026.
|
||||||
|
|
||||||
|
本文来源:专知智能防务
|
||||||
@@ -0,0 +1,80 @@
|
|||||||
|
# 📊 文章摘要:未来战场已然来临:大规模廉价无人系统、多域蜂群、人工智能
|
||||||
|
|
||||||
|
> **原文**:[2026-08-20_未来战场已然来临_大规模廉价无人系统_多域蜂群_人工智能](./2026-08-20_未来战场已然来临_大规模廉价无人系统_多域蜂群_人工智能.md)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/g57nYwvtj-kllPxX5s9l5g
|
||||||
|
> **来源**:微信公众平台
|
||||||
|
> **作者**:专知防务
|
||||||
|
> **发布日期**:2026-08-20
|
||||||
|
> **摘要日期**:2026-08-20
|
||||||
|
> **价值评级**:⭐⭐⭐ 高
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 核心命题
|
||||||
|
|
||||||
|
> **蜂群系统战** — 未来战场优势取决于廉价、网络化、可学习系统的集体行为而非单一平台性能;机器速度越快,越需要强化而非弱化人类控制。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 文章概要
|
||||||
|
|
||||||
|
本文是编译类战略研究长文(文内注释指向以色列战略与安全研究所 JISS 等来源,共 22 条脚注,信息截至 2026-07),系统论述无人系统战争的四大趋势及其后果:廉价无人机改变战争成本—收益等式、无人系统向陆海扩散、从单平台操控转向多域蜂群、AI 进入"探测—识别—遴选—攻击"链路并将人类挤出决策流程。核心论点是:主要威胁不在自主平台本身,而在其背后的系统(大规模生产+去中心化通信+学习型软件+廉价传感器+持续连通性+以无人系统替代士兵的意愿);蜂群的战斗力来自集体行为与冗余,战争重心从平台转向系统。后半部分聚焦 LAWS 的法律与伦理困境,提出"环内→环上→环外"三阶段滑移与"例外的常态化"两个概念工具,主张"负责任的人类在环"学说,并给出以色列十条建军建议。局限:以色列视角鲜明,建议部分含智库政策推销成分;对蜂群在电子战环境下的技术脆弱性着墨很少。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 关键要点
|
||||||
|
|
||||||
|
1. **威胁是系统而非平台** — 主要威胁不在于自主平台本身,而在于其代表的系统:大规模生产、去中心化通信、学习型软件、廉价传感器、持续连通性,以及以无人系统替代士兵的作战意愿 `[分类: 范式突破]`
|
||||||
|
2. **成本等式的攻防反转** — 数百美元的平台撬动不成比例的战果;防御方无法用昂贵导弹逐架拦截,目标是"打破攻击者的成本—收益等式"而非拦截每个平台 `[分类: 共识]`
|
||||||
|
3. **蜂群四类型与综合蜂群** — 空中/地面/海上水下蜂群之上出现"蜂群之蜂群"(单一网络化指挥结构下跨域运作),模糊作战域边界、最防御难 `[分类: 共识]`
|
||||||
|
4. **蜂群 C2 必然部分自主** — 平台数量增加后人无法逐个控制;乌克兰项目已在减少操作手数量,把规划与任务分配转移给算法 `[分类: 共识]`
|
||||||
|
5. **人类角色三阶段滑移** — 人在环内→人在环上→人出环;危险在于第二→第三阶段的过渡不是由明确政策决定,而是通过软件改进、作战压力和缩短响应时间的累积效应悄然发生 `[分类: 范式突破]`
|
||||||
|
6. **"例外的常态化"** — AI 先帮人应对信息过载→审查时间缩短→预定义类别目标可开火→指挥官偏好更快的机器;最终国际法面对既成事实 `[分类: 范式突破]`
|
||||||
|
7. **人类控制的实质标准** — 核心问题不是系统里"是否有人类存在",而是该人类能否理解系统的决策、阻止它并对其负责 `[分类: 共识]`
|
||||||
|
8. **各国模式分化** — 中国(智能、多维度蜂群)、俄罗斯(数量规模与消耗)、乌克兰(快速创新)、美国(数量+软件+自主性+人类控制的"智能规模");共同教训:学习速度几乎与平台质量同等重要 `[分类: 共识]`
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 批判性分析
|
||||||
|
|
||||||
|
### 假设前提
|
||||||
|
- 以色列安全视角贯穿全文:战略纵深有限、多战线、海上生命线依赖,结论(快速部署、局部防御包、国际联盟)由该处境推导,向其他国家安全环境外推需谨慎。
|
||||||
|
- 假定技术扩散不可逆、"有效监管的窗口正在迅速关闭",这是论证立场而非经检验的事实。
|
||||||
|
- "自主性是能力连续体而非二元状态"这一前提支撑了全文渐进式分析,同时也弱化了"禁令派"(联合国、红十字)方案的可行性论证。
|
||||||
|
|
||||||
|
### 论据与逻辑
|
||||||
|
- 证据密度高:22 条脚注覆盖 JISS、CSIS、Modern War Institute、北约议会、联合国裁军事务厅、红十字国际委员会等,来源多元可溯源;乌克兰、以色列、俄乌黑海等案例具体。
|
||||||
|
- 逻辑主线(趋势→系统属性→防御概念→伦理→建议)完整;但从"趋势描述"跳到"以色列应设立蜂群作战机构、发展打击价值链各环节能力"的建军建议存在立场跳步,机构设置与国际联盟主张含智库政策游说成分。
|
||||||
|
- 反证讨论不足:蜂群在强电子战/通信干扰环境下的脆弱性、集群算法的成熟度、误识别的法律后果等可能削弱结论的证据几乎未展开。
|
||||||
|
|
||||||
|
### 边界与局限
|
||||||
|
- 边界意识较强:明确区分"决策支持系统"与"决策系统";承认 LAWS 尚无国际公认定义、各国在灰色地带运作;承认乌克兰"技术雄心与广泛成熟的作战能力之间仍存在差距";防御建议注明是补充而非取代传统防空。
|
||||||
|
- 结构性局限:编译文本(原文为英文战略评论),译文体痕迹明显;"建议"章节约占全文四成,使文章后半从分析滑向政策方案推销。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 可引用金句
|
||||||
|
|
||||||
|
> "无人机改变了战争的经济学。蜂群正在改变其节奏。人工智能最终可能改变战争中责任本身的性质。"
|
||||||
|
|
||||||
|
> "正因机器能够比人类更快地观察、计算和打击,才需要更强有力的人类控制——不是作为法律装饰,而是作为作战与道义的双重保障。"
|
||||||
|
|
||||||
|
> "核心问题不仅仅是系统中是否'有人类存在',而是该人类能否理解系统的决策、阻止它并对其负责。"
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 总体评价
|
||||||
|
|
||||||
|
**亮点**:
|
||||||
|
- "系统对平台"的威胁重构框架、"环内→环上→环外"三阶段滑移、"例外的常态化"三个概念工具均有强迁移价值,可直接用于民用 AI 自主系统的治理讨论(自动化偏见、人类监督设计)。
|
||||||
|
- 22 条注释体系完整可溯源,在公众号文章中罕见。
|
||||||
|
|
||||||
|
**不足**:
|
||||||
|
- 以色列立场贯穿建议部分,游说成分稀释分析客观性;技术反证(抗干扰、可靠性、误伤)缺失;编译翻译腔明显。
|
||||||
|
|
||||||
|
**适用场景**:
|
||||||
|
- 军事 AI 与国际人道法研究、无人系统产业与政策分析、AI 自主性治理与人类监督机制设计的跨领域参考。
|
||||||
|
|
||||||
|
**关联建议**:
|
||||||
|
- 与同日归档的阿颖《对 GLM-5.3 的真实评价》形成"能力上游—应用下游"对照:后者讲模型长程 Agent 能力如何练出来,本文讲长程自主系统投入使用后人类控制如何设计。
|
||||||
|
- "自动化偏见""例外的常态化"概念可与 Agent 工程中的人机审批环节设计交叉引用。
|
||||||
@@ -0,0 +1,64 @@
|
|||||||
|
# Kimi K3之后:开源还是闭源,这是个问题
|
||||||
|
|
||||||
|
> **来源**:微信公众平台(侯宏)
|
||||||
|
> **作者**:侯宏
|
||||||
|
> **发布日期**:2026-08-20(原文未标注明确日期,按下载日占位)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/hybZIAHrShl4xunoTf3hiQ
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
|
||||||
|
|
||||||
|
中美AI竞争常被概括为"开源对闭源"的竞争:中国头部模型厂商更倾向开放权重,美国最强的frontier models则主要由OpenAI、Anthropic等闭源实验室控制。这大体符合事实,但任何决策都不是理所当然和一成不变的,在技术与商业图景尚未稳定的AI产业尤其如此。
|
||||||
|
|
||||||
|
7月Kimi K3发布后引发美国政商界争论,尤其是《开放权重与美国的AI领先地位》公开信为我们透视"开源vs闭源"的复杂考量提供了窗口。透过它,可以看到更复杂、动态也更深刻的产业图景。
|
||||||
|
|
||||||
|
## 一、K3引发的政策争论
|
||||||
|
|
||||||
|
7月初发布的Kimi K3创造了中美AI竞争的第二个Deepseek时刻。它的出现强化了一个趋势:中国模型不再只是以低成本追赶美国闭源模型,而开始借助开放策略争夺全球开发者、企业用户与技术生态。这一变化很快进入美国政策讨论。
|
||||||
|
|
||||||
|
此前Anthropic已多次强调,中国模型厂商可能通过对美国闭源模型进行大规模distillation来缩短能力差距,并主张将模型访问控制与先进芯片出口限制共同纳入美国AI竞争政策。K3发布后,美国政府官员进一步将中国模型追赶、知识产权、distillation和国家安全联系起来,潜在逻辑是:中国开放模型追赶美国 → 美国技术和安全利益受损 → 美国应限制open weights。
|
||||||
|
|
||||||
|
7月24日,NVIDIA、Meta、Microsoft、Google、IBM等273家AI企业或研究机构联合签署公开信《Open Weights and American AI Leadership》。这封公开信没有提及具体模型或国家。它采用的是更一般化的论证方式:重新界定AI领先地位的来源,并澄清看似自然、实则并不必然成立的因果关系。
|
||||||
|
|
||||||
|
## 二、公开信的抗辩逻辑
|
||||||
|
|
||||||
|
公开信明确提出,"美国的AI领导地位不取决于某个前沿模型能力,而取决于美国能否建立一个能够渗透到各行各业的强大而开放的AI生态...美国赢得AI时代并非因为拥有最强模型,而因为AI能进入工厂、医院、农场、课堂和大量企业的工作流"
|
||||||
|
|
||||||
|
开放权重模型是这一愿景不可或缺的基础设施!公开信强调开源模型相对于闭源模型的两个具体优势。
|
||||||
|
|
||||||
|
一方面,开源模型刺激全方位的供给侧竞争,避免少数企业垄断产业利益(此处Nvidia应脸红)。比如,闭源模型的配套服务通常由闭源模型厂商独家提供,但开源模型的配套服务可以由广泛的、无需授权的第三方厂家提供。再比如,如果只有大型银行才能用得起的高价闭源模型,小型银行就可能被进一步边缘化;反之,小型银行可以与大型银行在同一AI模型的起跑线上进行服务创新的竞争。
|
||||||
|
|
||||||
|
另一方面,开源模型使得用户掌控自身数据与知识。这无疑促进了AI采纳,因为用户无需担忧被锁定在单一供应商上。公开信隐晦地回应了闭源模型厂商吸纳用户知识以训练自身模型的担忧,写道:当组织利用AI创新时,开放权重允许它们通过自发改进模型、专有能力和知识沉淀以拥有(own)该创新的价值。这一段原文使用了"American sovereignty"一词。它的意思不是美国的国家主权,而更接近美国企业的技术或智能自主权:美国企业、公共机构乃至整个美国经济对关键AI能力保持自主控制,而不被少数模型供应商锁定或失去自身积累的知识与能力。
|
||||||
|
|
||||||
|
在阐明开源优势的前提下,公开信进一步把开源和三个莫须有的罪名解绑。
|
||||||
|
|
||||||
|
首先,将开放权重与与价值流失解绑。从单一模型厂商看,开放权重确实会削弱API租金和技术排他性;但从整个产业体系看,模型成本下降可能扩大芯片、云计算、企业软件和下游应用市场。换言之,模型层的收益下降不等于整个美国AI产业的价值捕获能力下降,价值可能向互补资产重新分配。
|
||||||
|
|
||||||
|
其次,将开放权重与不安全解绑。Anthropic主打安全牌。公开信首先承认AI模型的滥用确实会导致安全问题, 但它紧接着指出,闭源模型同样可能被攻破、滥用或发生外部无法观察的失效。并且,闭源模型把安全风险的管控寄托在"单点"上,失败的风险可能更高。与之相比,开放能扩大模型审查、漏洞发现、组队防御。
|
||||||
|
|
||||||
|
最后,将蒸馏与盗用/misappropriation解绑。公开信直接要求政策制定者不要混淆合法的模型开发技术与misappropriation,并指出蒸馏是模型改进、评估和验证中广泛使用的方法。同时,它也明确承认,"unlawful efforts to extract value from closed models raise legitimate concerns",但这些问题应通过targeted legal and commercial frameworks处理,而不应转化为对重要模型开发技术的普遍限制。
|
||||||
|
|
||||||
|
值得指出的是,公开信并未主张最先进模型都应开放。相反,它明确提出不同任务应匹配不同层次的模型。其政策主张不是以开放模型取代闭源frontier models,而是建议美国维持plural frontier:支持开放生态并不等于放弃frontier优势。
|
||||||
|
|
||||||
|
## 三、公开信背后的产业共识
|
||||||
|
|
||||||
|
谁都知道开源模型是中国在引领,怎么和美国的领导地位扯上关系了呢?通过解读大家明白,它着眼的不是模型能力的竞争,而是经济体系吸纳模型能力、转化为产业竞争力的竞争。从这个标尺看,不管黑猫白猫,能够提升产业竞争力的就是好猫。这个立场非常符合美国政策制定者的一贯立场,应该起到了一定的效果。
|
||||||
|
|
||||||
|
但是,国家利益与特定厂商的利益并不必然一致。对于A和O两家闭源厂商,开源模型是强劲的替代者,直接影响其上市估值,进而影响到背后的诸多投资人。
|
||||||
|
|
||||||
|
有趣的是,微软、Nvidia、Amazon、Google等作为这两家企业的主要投资人都签署了这份公开信。好理解:它们都是产业投资人,相对于开源为它们的业务(主要是云业务)带来的持续正向刺激,一次性的财务收益不具备战略性。
|
||||||
|
|
||||||
|
更有趣的是,至少有9家投资公司签署了该公开信。其中不少是专注于开源生态、AI基础设施领域和早期start-up的投资公司(如A16z,YC),但也不乏这两家企业的股东。尤其是ARK, 目前重仓OpenAI 和Anthropic,仍然签署了公开信。一个合理的解释是,这些追求portfolio而非特定case投资回报的专业投资公司相信,未来的价值更多分布在开源生态及其土壤上长出来的应用生态中。
|
||||||
|
|
||||||
|
这封几乎所有美国AI玩家共同签署的公开信,代表了一个与政策视角并无矛盾的产业共识。然而,开源模型的商业模式是什么?土壤上会开出美丽的花朵、结出丰硕的果实,但土壤自身的商业模式并不清晰。公开信所强调的开源的各种优势,都可以概括为一个术语:外部性,即其所创造但外溢而无法捕获的价值。
|
||||||
|
|
||||||
|
## 四、中国的问题:开源模型的商业模式
|
||||||
|
|
||||||
|
商业模式问题对美国工商业界并不急迫,因为开源玩家主要是中国企业。这些玩家已上市或即将上市,在投资人的高期待下面临高增长、高亏损的困境。我并不看好这些企业的商业前景(单就其作为模型提供商的定位而言),因为开源商业的难处在于,开源的对象不仅包括用户和开发者,也包括竞争对手。
|
||||||
|
|
||||||
|
大模型这个行业有其内在的缺陷。早期,它的问题在于上游英伟达的垄断,而今TPU、AMD、博通等的努力已经把英伟达的份额大幅降低。现在,它的问题在于同业竞争过于激烈。闭源模型对于蒸馏技术的存在恨之入骨,正因为后者使得竞争对手可以从输出中反推其内部结构,进而快速提升性能。闭源尚且如此,开源就更不用说了。有人会说,现在大模型行业不就这几个玩家了吗,垄断收益在望。殊不知,开源和垄断在定义上就不可兼容。从全球来看,没有新玩家介入基模行业,很可能不是不能,而是不愿——既然有开源的,做freeridder何乐而不为呢?
|
||||||
|
|
||||||
|
资本耐心有限,开源商业模式必须自救。一个信号是,接近IPO的Kimi最近修改了K3的开源条款,要求云平台部署其"开源"版本时必须另签协议——这已背离开源的经典定义了。我相信这一步未来会走得更远、迈得更大,跟随的开源厂商会更多。从商业角度无可厚非,但本文前半段所描绘的种种好处,可能逐步缩水了——这不是政府愿意看到的。对当局而言,当务之急可能不在于限制中国开源模型流入它国,而是设法确保国内的开源氛围维持而不至于在水面下暗暗转向其对立面。
|
||||||
|
|
||||||
|
要找到产业利益和国家利益的契合点,有一个思路供参考。那就是,采取市场手段而非行政手段限制开源模型的外流。这个市场手段就是Kimi已经在尝试的渠道加价,但该策略只应针对海外云平台,而对国内云平台豁免。这种歧视性定价用面向特定国家的开源税来补贴国内市场,符合国际政治与企业发展的双重需要。
|
||||||
@@ -0,0 +1,80 @@
|
|||||||
|
# 📊 文章摘要:Kimi K3之后:开源还是闭源,这是个问题
|
||||||
|
|
||||||
|
> **原文**:[2026-08-20_Kimi_K3之后_开源还是闭源_这是个问题](./2026-08-20_Kimi_K3之后_开源还是闭源_这是个问题.md)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/hybZIAHrShl4xunoTf3hiQ
|
||||||
|
> **来源**:微信公众平台
|
||||||
|
> **作者**:侯宏
|
||||||
|
> **发布日期**:2026-08-20
|
||||||
|
> **摘要日期**:2026-08-20
|
||||||
|
> **价值评级**:⭐⭐⭐ 高
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 核心命题
|
||||||
|
|
||||||
|
> **生态主导权** — AI 领先地位的竞争不是"最强模型"之争,而是经济体系吸纳模型能力、转化为产业竞争力的生态之争;开源的商业软肋(外部性无法捕获)才是中国模型厂商的真正考题。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 文章概要
|
||||||
|
|
||||||
|
本文以 Kimi K3 发布后美国政商界的反应为切口,深度解读 273 家机构联署的《Open Weights and American AI Leadership》公开信,提出一个重新框定竞争的视角:美国的 AI 领导地位不取决于某个前沿模型,而取决于开放生态对各行各业的渗透。文章三层递进:先拆解公开信的抗辩逻辑(开源与价值流失、不安全、盗用三个"罪名"解绑),再分析签署方结构揭示产业共识与投资人利益分化(连重仓 OpenAI/Anthropic 的 ARK 都签了),最后把问题转回中国——开源优势本质是"外部性",土壤本身没有商业模式,Kimi 修改 K3 开源条款正是自救信号。作者立场鲜明(不看好开源模型厂商作为模型提供商的商业前景)并给出政策建议。局限:对公开信的解读是一家之言,"开源税"建议的可行性未论证。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 关键要点
|
||||||
|
|
||||||
|
1. **重新界定 AI 领先地位来源** — "美国赢得AI时代并非因为拥有最强模型,而因为AI能进入工厂、医院、农场、课堂和大量企业的工作流"——竞争标尺从模型能力切换为经济体系吸纳能力 `[分类: 范式突破]`
|
||||||
|
2. **公开信三大解绑** — 开源与价值流失解绑(模型层收益下降≠产业价值捕获下降,价值向互补资产再分配);开源与不安全解绑(闭源单点风控失败风险更高);蒸馏与盗用解绑(蒸馏是广泛使用的合法开发技术)`[分类: 共识]`
|
||||||
|
3. **plural frontier 主张** — 公开信并不主张最先进模型都开放,而是维持多元前沿:支持开放生态≠放弃 frontier 优势 `[分类: 共识]`
|
||||||
|
4. **投资人立场分化揭示价值判断** — 产业投资人(微软/Nvidia/Amazon/Google)为云业务的持续正刺激签信;连重仓 OpenAI/Anthropic 的 ARK 也签——专业投资公司相信未来价值分布在开源生态及其上的应用生态 `[分类: 范式突破]`
|
||||||
|
5. **开源优势 = 外部性** — 公开信强调的开源好处都可概括为"所创造但外溢而无法捕获的价值";土壤能开花结果,但土壤自身商业模式不清晰 `[分类: 范式突破]`
|
||||||
|
6. **开源与垄断定义上不兼容** — 全球无新玩家进入基模行业不是"不能"而是"不愿"——有开源的,做 freerider 何乐而不为 `[分类: 争议]`
|
||||||
|
7. **Kimi 修改 K3 开源条款是转折信号** — 云平台部署"开源"版本须另签协议,已背离开源经典定义;作者预判这一步会走得更远、跟随者更多 `[分类: 未探索方向]`
|
||||||
|
8. **歧视性定价"开源税"建议** — 市场手段而非行政手段限制外流:渠道加价只针对海外云平台、国内豁免,用面向特定国家的开源税补贴国内市场 `[分类: 争议]`
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 批判性分析
|
||||||
|
|
||||||
|
### 假设前提
|
||||||
|
|
||||||
|
(1) 公开信真实反映签署方共识而非策略性表态——273 家联署机构利益各异,联署行为与实际立场可能脱节;(2) "产业竞争力吸纳能力"这把新标尺优于模型能力标尺——这服务于开放阵营的论证需要;(3) 中国开源厂商必然走向条款收紧——Kimi 单例被外推为趋势。
|
||||||
|
|
||||||
|
### 论据与逻辑
|
||||||
|
|
||||||
|
论证强度高:用签署方结构(谁签了、谁重仓谁)做利益分析,是文本之外的有效证据;对公开信原文(如 American sovereignty 一词)做了贴近原文的辨析。薄弱处:对中国厂商商业前景的否定("我并不看好")是判断而非论证;"开源税"建议未讨论 WTO 合规性与报复风险;将 Kimi 条款修改直接解读为"商业模式自救",也存在安全性/合规性解释的可能。
|
||||||
|
|
||||||
|
### 边界与局限
|
||||||
|
|
||||||
|
适用于理解中美 AI 政策博弈与开源商业模式的结构性问题;不适用于具体厂商投资决策(作者明确限定"单就其作为模型提供商的定位而言",未评估其整体业务)。文中 A/O 等代称与坊间传闻(如 Grok Bot 团队背景)需读者自行核实。预测性判断(条款收紧会扩大)有待时间检验。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 可引用金句
|
||||||
|
|
||||||
|
> "美国赢得AI时代并非因为拥有最强模型,而因为AI能进入工厂、医院、农场、课堂和大量企业的工作流"
|
||||||
|
|
||||||
|
> "公开信所强调的开源的各种优势,都可以概括为一个术语:外部性,即其所创造但外溢而无法捕获的价值。"
|
||||||
|
|
||||||
|
> "开源和垄断在定义上就不可兼容。从全球来看,没有新玩家介入基模行业,很可能不是不能,而是不愿——既然有开源的,做freeridder何乐而不为呢?"
|
||||||
|
|
||||||
|
> "当务之急可能不在于限制中国开源模型流入它国,而是设法确保国内的开源氛围维持而不至于在水面下暗暗转向其对立面。"
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 总体评价
|
||||||
|
|
||||||
|
**亮点**:
|
||||||
|
- 罕见地把公开信当作文本来精读,逐条拆解论证结构而非停留在立场站队
|
||||||
|
- 用签署方持仓结构做利益分析,证据运用娴熟
|
||||||
|
- 把美国政策辩论转译为中国厂商商业模式问题,视角转换有洞察
|
||||||
|
|
||||||
|
**不足**:
|
||||||
|
- 对中国厂商的负面预判论证不足,带有较强个人立场
|
||||||
|
- "开源税"建议的可操作性、合规性未展开
|
||||||
|
- 未讨论开源模型安全评估等技术与治理维度
|
||||||
|
|
||||||
|
**适用场景**:AI 产业政策研究、开源战略制定、大模型厂商商业模式分析、中美科技竞争跟踪
|
||||||
|
|
||||||
|
**关联建议**:可对照公开信原文(Open Weights and American AI Leadership)与 Anthropic 关于 distillation 的政策文件阅读;跟踪 Kimi/DeepSeek/Qwen 后续开源条款变化验证作者预判
|
||||||
@@ -0,0 +1,82 @@
|
|||||||
|
# ox-alpha 揭晓:GLM-5.3-Flash 开源,SGLang Day0 支持
|
||||||
|
|
||||||
|
> **来源**:微信公众平台
|
||||||
|
> **作者**:卡工
|
||||||
|
> **发布日期**:2026-08-27
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/YLqgHOgPvL17FQPnBgTZFw
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
01
|
||||||
|
|
||||||
|
GLM-5.3-Flash 开源,SGLang Day0 支持
|
||||||
|
|
||||||
|
|
||||||
|
|
||||||
|
智谱(Z.ai)今天开源了 GLM-5.3-Flash(320B-A18B),SGLang 目前已 Day0 支持
|
||||||
|
|
||||||
|
02
|
||||||
|
|
||||||
|
背景
|
||||||
|
|
||||||
|
GLM-5.3-Flash 是 GLM-5 系列第一个原生多模态模型:320B 总参数、18B 激活,文本、图像、视频输入,MIT 协议,可商用
|
||||||
|
|
||||||
|
官方口径是性能反超 GLM-5.2、价格只有 1/10,编程和 agentic benchmark 上逼近 Claude Opus 4.8
|
||||||
|
|
||||||
|
发布前它用 ox-alpha 的马甲在 OpenCode 和 OpenRouter 上匿名跑了好几天,拿下当周最受欢迎模型,而且全部跑在中国 AI 芯片上
|
||||||
|
|
||||||
|
能力边界也从编程扩展到专业办公:slides、文档、表格、金融研究,端到端处理
|
||||||
|
|
||||||
|
03
|
||||||
|
|
||||||
|
核心亮点
|
||||||
|
|
||||||
|
- 320B 总参数、18B 激活:45 层文本层(MLA + DSA 稀疏注意力 + KDA 线性注意力)+ 24 层视觉编码器;288 个路由专家、每 token 激活 8 个
|
||||||
|
- 原生多模态:文本、图像、视频输入,并且能识别自己的输出并修正错误
|
||||||
|
- 1M 上下文,FP8 权重 + BF16 KV cache 为默认精度
|
||||||
|
- 自带 MTP draft layer,SGLang 以 NEXTN 投机解码 serving,低延迟策略默认 adaptive MTP
|
||||||
|
- Artificial Analysis 智能指数 v4.1.1 得分 57,单任务成本 $0.045(折扣价),这个智能水平此前要约 10 倍价格
|
||||||
|
|
||||||
|
04
|
||||||
|
|
||||||
|
SGLang 部署指令
|
||||||
|
|
||||||
|
(示例为官方 Day0 镜像,硬件覆盖 NVIDIA H100 / H200 / B200 / B300 / GB200 / GB300;完整 docker run 命令按硬件在 Cookbook 的部署面板生成)
|
||||||
|
|
||||||
|
```
|
||||||
|
docker pull lmsysorg/sglang:glm-5.3-flash
|
||||||
|
```
|
||||||
|
|
||||||
|
两种预设策略:Low Latency(默认开 adaptive MTP 投机解码,适合对话和 agent 负载)、High Throughput(关投机,适合持续大批量)
|
||||||
|
|
||||||
|
生成参数默认 temperature=1.0、top_p=0.95、thinking 开启
|
||||||
|
|
||||||
|
命令默认带 --reasoning-parser glm45 和 --tool-call-parser glm47。视频输入需要装 torchcodec,按 2 FPS 采样,上限 240,000 个 visual token
|
||||||
|
|
||||||
|
05
|
||||||
|
|
||||||
|
参考链接
|
||||||
|
|
||||||
|
1. HF link
|
||||||
|
|
||||||
|
huggingface.co/zai-org/GLM-5.3-Flash
|
||||||
|
|
||||||
|
2. SGL Cookbook
|
||||||
|
|
||||||
|
docs.sglang.io/cookbook/autoregressive/GLM/GLM-5.3-Flash
|
||||||
|
|
||||||
|
3.智谱官方博客
|
||||||
|
|
||||||
|
z.ai/blog/glm-5.3-flash
|
||||||
|
|
||||||
|
06
|
||||||
|
|
||||||
|
推荐阅读
|
||||||
|
|
||||||
|
Qwen4 架构预览:Qwen3.8-Flash 开源!
|
||||||
|
|
||||||
|
企业 agent 专用?IBM Granite 4.2 发布,SGLang Day0 支持
|
||||||
|
|
||||||
|
蚂蚁集团 Theta 项目组在 SGLang 的实践:把 H20 上的 DeepSeek-V4-Pro 服务推向极限
|
||||||
|
|
||||||
|
Mooncake for Miles:从碎片化 Rollout 数据到高效批量传输
|
||||||
@@ -0,0 +1,67 @@
|
|||||||
|
# 📊 文章摘要:ox-alpha 揭晓:GLM-5.3-Flash 开源,SGLang Day0 支持
|
||||||
|
|
||||||
|
> **原文**:[2026-08-27_ox-alpha_揭晓_GLM-5.3-Flash_开源_SGLang_Day0_支持](./2026-08-27_ox-alpha_揭晓_GLM-5.3-Flash_开源_SGLang_Day0_支持.md)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/YLqgHOgPvL17FQPnBgTZFw
|
||||||
|
> **来源**:微信公众平台
|
||||||
|
> **作者**:卡工
|
||||||
|
> **发布日期**:2026-08-27
|
||||||
|
> **摘要日期**:2026-08-27
|
||||||
|
> **价值评级**:⭐⭐ 中
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 核心命题
|
||||||
|
|
||||||
|
> **智能平价** — GLM-5.3-Flash 以 320B-A18B 稀疏激活+原生多模态+MIT 协议,把"智能指数 57"档位的成本压到 $0.045/任务(约原价 1/10),开源权重可自部署,高性能推理正在从奢侈品变成基础设施。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 文章概要
|
||||||
|
|
||||||
|
智谱开源 GLM-5 系列 Flash 档模型:320B 总参数、18B 激活(288 专家每 token 激活 8 个),45 层文本层(MLA+DSA 稀疏注意力+KDA 线性注意力)+24 层视觉编码器,原生支持文本/图像/视频输入与 1M 上下文,MIT 协议可商用。发布前以 ox-alpha 匿名登录 OpenCode 与 OpenRouter 匿名测试并拿下当周最受欢迎模型(全部跑在中国 AI 芯片上),官方口径性能反超 GLM-5.2、价格仅 1/10、编程与 agentic 基准逼近 Claude Opus 4.8。SGLang 提供 Day0 支持与官方镜像,含投机解码(NEXTN/adaptive MTP)双预设策略。价值在于提供了开源多模态推理模型的新基准点与即用的部署信息;局限是全文为发布快讯,性能主张均为官方口径、无第三方复测。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 关键要点
|
||||||
|
|
||||||
|
1. **架构:稀疏激活原生多模态** — 320B-A18B(激活比约 5.6%)、45 层文本+24 层视觉编码器、288 路由专家激活 8 个;FP8 权重+BF16 KV cache 默认精度。 `[分类: 共识]`
|
||||||
|
2. **匿名实测先于发布** — 以 ox-alpha 马甲在 OpenCode/OpenRouter 跑匿名测试拿下当周最受欢迎模型,且全部推理跑在中国 AI 芯片上。 `[分类: 共识]`
|
||||||
|
3. **成本断崖** — Artificial Analysis 智能指数 v4.1.1 得分 57、单任务成本 $0.045(折扣价),官方称此前该智能水平需约 10 倍价格。 `[分类: 争议]`(官方口径,第三方复测未出)
|
||||||
|
4. **能力边界扩展到专业办公** — slides、文档、表格、金融研究端到端处理;能识别自己的输出并修正错误(自校验多模态)。 `[分类: 共识]`
|
||||||
|
5. **SGLang Day0 部署要点** — Low Latency(adaptive MTP 投机解码,适合对话/agent)与 High Throughput 两种预设;默认 temperature=1.0、top_p=0.95、thinking 开启;视频输入 2 FPS 采样、上限 24 万 visual token。 `[分类: 共识]`
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 批判性分析
|
||||||
|
|
||||||
|
### 假设前提
|
||||||
|
|
||||||
|
文章默认官方基准口径可信("逼近 Claude Opus 4.8"来自智谱自家编程与 agentic 基准选型);匿名测试的受欢迎度(用量)不等价于质量(用户可能因便宜而大量试用)。
|
||||||
|
|
||||||
|
### 论据与逻辑
|
||||||
|
|
||||||
|
发布快讯体,无作者独立验证。可核实部分:HF 仓库、MIT 协议、SGLang 镜像与参数均为可复现事实;性能对比部分引用第三方 Artificial Analysis 指数(57 分、$0.045)相对可信,但"1/10 价格""反超 GLM-5.2"为官方话术。对匿名登顶的叙事应保留:OpenRouter 排名反映的是 token 消耗量与增速。
|
||||||
|
|
||||||
|
### 边界与局限
|
||||||
|
|
||||||
|
适用于自部署推理、Agent 负载与多模态文档处理场景的成本敏感选型;与闭源旗舰的对比在长程 agentic 任务、极端推理深度上未经第三方检验。1M 上下文的实际有效利用率(needle 类长文检索质量)文中未提。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 可引用金句
|
||||||
|
|
||||||
|
> "GLM-5.3-Flash 是 GLM-5 系列第一个原生多模态模型:320B 总参数、18B 激活,文本、图像、视频输入,MIT 协议,可商用。"
|
||||||
|
|
||||||
|
> "发布前它用 ox-alpha 的马甲……拿下当周最受欢迎模型,而且全部跑在中国 AI 芯片上。"
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 总体评价
|
||||||
|
|
||||||
|
**亮点**:架构参数、部署命令、采样参数等工程细节完整即用;匿名测试+国产芯片细节有信息增量。
|
||||||
|
|
||||||
|
**不足**:纯发布通稿,性能数据全为官方口径;无基准明细表。
|
||||||
|
|
||||||
|
**适用场景**:推理模型自部署选型的候选清单;多模态文档流水线(slides/表格/金融研究)的成本优化选项;SGLang 生态用户的直接上手指南。
|
||||||
|
|
||||||
|
**关联建议**:与同批《116页论文教你「蒸馏」Claude、GPT-5.6》对读——推理数据窃取的经济性(720 美元/万条)与高性价比开源模型的涌现是同一攻防的两面;与同批《Multi-Agent 成本优化》中 GLM-5v 分层路由(成本约 Sonnet 36%)呼应:国产模型分层路由已成工程团队的省钱标配;关注 Artificial Analysis 后续独立复测再下性能结论。
|
||||||
@@ -0,0 +1,255 @@
|
|||||||
|
# 对Loop Engineering的思考
|
||||||
|
|
||||||
|
> **来源**:微信公众平台(腾讯云开发者)
|
||||||
|
> **作者**:吕昊俣
|
||||||
|
> **发布日期**:2026-08-27
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/g3HtSeJfKfjtqDG4rPTpiw
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
OpenClaw 的创始人在 6月8日 凌晨 2:58 发布推文: Here's your monthly reminder that you shouldn't be prompting coding agents anymore. You should be designing loops that prompt your agents"。简单翻译一下就是:我们要设计一个循环去代替不停地Prompt,把人从流程中拔出来。loop是不是又是AI圈造了一个新词,不清楚,但是确实给我们看待"问题"提供了一个新的视角。
|
||||||
|
|
||||||
|
## 01
|
||||||
|
|
||||||
|
范式迁移:从 Harness 到 Loop 再到Graph Engineering
|
||||||
|
|
||||||
|
__1.1 五代工程演进__
|
||||||
|
|
||||||
|
从 2022 到 2026,AI 辅助编程经历了清晰的开发__模式的转移__。
|
||||||
|
|
||||||
|
工程师的核心工作,逐渐从__"直接写业务代码"__转向__"设计系统,并让系统生成代码"__的阶段。
|
||||||
|
|
||||||
|
|
||||||
|
|
||||||
|
每一代都是一次__精进__:
|
||||||
|
|
||||||
|
1. __Prompt Engineering__(2023)解决了"怎么问,模型才答得好",把质量押在一次提示词上。缺点是:答错了没有自动纠偏,只能人工重来。
|
||||||
|
2. __Context Engineering__(2025)解决了"模型缺背景、答不准",上下文管理让信息更充分。缺点是:只有信息、没有手脚,缺标准化执行环境,也缺验证闭环。
|
||||||
|
3. __Harness Engineering__(2026 2月)解决了、"单次执行不可控、不可信",生产级运行外壳让 Agent 能安全、可控、可验证地跑通一次。缺点是:仍要人触发、让人盯,人成了生产节点的最大瓶颈。
|
||||||
|
4. __Loop Engineering__(2026 6月)解决了"__靠人盯",自动化调度实现最大限度的无人值守,但仍面临着成本失控的问题。
|
||||||
|
5. __Graph Engineering__(2026 7月)解决了"Loop间的编排、协同、调度等问题",构建起工程级复杂 AI 任务系统。
|
||||||
|
|
||||||
|
__1.2 它们的结构关系:层层依赖 逐步递进__
|
||||||
|
|
||||||
|
每一次的演进,__并不是一次替代__,而是建立在上一代的能力之上。
|
||||||
|
|
||||||
|
就拿Harness和Loop的关系来说,创始人Addy Osmani 给出了精准的概括:
|
||||||
|
|
||||||
|
__Harness 是 AI 代理的受控运行环境;Loop 是在这个环境之上,叠加了自驱动能力的持续执行流程。__
|
||||||
|
|
||||||
|
Harness 是地基,Loop 是上层调度,没有Harness,Loop 则是无源之水。
|
||||||
|
|
||||||
|
而把它们结合在一起看,更为直观明了。
|
||||||
|
|
||||||
|
__1.3 从技术Loop到产品Loop__
|
||||||
|
|
||||||
|
跳出单纯的技术视角,__吴恩达__则给出了不同的__"取景框"__,把 Loop 的涉众范围扩大去思考。
|
||||||
|
|
||||||
|
(见:https://www.deeplearning.ai/the-batch/three-key-loops-for-building-great-software)
|
||||||
|
|
||||||
|
文中给出了三个环:__技术->产品->用户,__它们__三层嵌套、不同速度、层层驱动__。
|
||||||
|
|
||||||
|
__技术 Loop__解决的是 "系统会不会收敛、会不会停、会不会认错";
|
||||||
|
|
||||||
|
__产品 Loop__ 解决的是 "这个闭环是否持续创造用户价值、是否值得继续放大、是否能形成长期增长飞轮";
|
||||||
|
|
||||||
|
__用户Loop__则反应了用户对产品的一种__"情绪",最终将以__某种形式__回到产品本身。
|
||||||
|
|
||||||
|
__1.4 Loop的工程基础 : 控制论__
|
||||||
|
|
||||||
|
大约160年前,英国通过了《红旗法案》,此法案要求机动车__前必须有人持红旗引导__,以保护人的安全,是不是有点匪夷所思,但160年后的今天,在AI编程领域,__历史在重演__,人就站在AI的前头,时时刻刻盯着。一个字 : 累。
|
||||||
|
|
||||||
|
从原理上看,LLM是一个概率模型,本质上,它就是在:__猜__。
|
||||||
|
|
||||||
|
虽是猜,但有人会说,现在猜的已经很准了,正确率接近__90%__。
|
||||||
|
|
||||||
|
是的,90%听起来很不错,但是,事实上可能很糟糕,因为,软件工程一定会使用__分治的方法__解决复杂问题,顺其自然的,一个复杂任务就变成了N多子任务的叠加,那么就变成了一个指数运算,仅仅六次后,概率就接近50%, 这不是就是__抛硬币吗__!
|
||||||
|
|
||||||
|
为了解决这个问题,于是乎,很自然地就想,有没有一种机制可以__修正这个损失概率?__有,这种机制就是控制论。
|
||||||
|
|
||||||
|
而控制论的思想,早从__VibeCoding__时,我们就在每天下意识的使用它。
|
||||||
|
|
||||||
|
只是这个__系统=我+AI__,比如在构建Prompt的过程:
|
||||||
|
|
||||||
|
而控制论的本质一句话就可以说明白__:通过负反馈机制去收敛目标函数。__说白了,Loop Engineering就是控制论在AI领域的一次落地应用。
|
||||||
|
|
||||||
|
__1.5 控制论四大公理__
|
||||||
|
|
||||||
|
于是乎,最近又翻开了大学时候没有好好上的课程:__《反馈控制系统设计》__,温习了一下控制论中最基本的几点思想:
|
||||||
|
|
||||||
|
1. __构建负反馈闭环__
|
||||||
|
2. __可观测性__
|
||||||
|
3. __可控性约束__
|
||||||
|
4. __离散迭代纠偏__
|
||||||
|
|
||||||
|
而这些点,更好的帮助我去理解Loop Engineering,我会清晰的看到,它们__一一对应,同根同源__。
|
||||||
|
|
||||||
|
映射如下:
|
||||||
|
|
||||||
|
## 02
|
||||||
|
|
||||||
|
从"写Prompt" 到 "设计Loop"
|
||||||
|
|
||||||
|
__2.1 回到问题本身:要设计一个"无人值守"的系统,咋做?__
|
||||||
|
|
||||||
|
我常常有这样的期待:一个任务,在晚上睡觉前 设计好,我睡觉,他干活,早上起来,完事。但现实往往是早上起来一看,什么东西!借助Loop的思维,我们如何重新思考这个问题?让AI可以在一定的成本下 完成任务。我想这里关键的实践路径是:__从小闭环做起,不断扩展边界__
|
||||||
|
|
||||||
|
在设计一个Loop的时候,我们往往会陷入到一个惯性思维里:
|
||||||
|
|
||||||
|
一上来就像做__一个全自动开发、全自动修复__的万能循环,结果往往差强人意。而比较实现的做法是:
|
||||||
|
|
||||||
|
__先跑通一个最小可收敛闭环,再逐步放大自治边界,并从中建立起闭环和闭环之间的联系。把小闭环跑通,才有资格谈大闭环,大循环是在一个个小循环上长出来的。__
|
||||||
|
|
||||||
|
而不管是大小闭环,最核心的是想清楚下面几个问题:
|
||||||
|
|
||||||
|
1. 如何定义__问题__?
|
||||||
|
2. 如何定义__开始__?
|
||||||
|
3. 如何设计__反馈__?
|
||||||
|
4. 如何定义__结束__?
|
||||||
|
|
||||||
|
__"设计反馈"__的背后是说,你需要设计一个__机制__,让模型真的会__说"不"__,这种"不" 并不是在提示词里一些拒绝意图的Prompt,这种看似在否定,但其实还是在肯定,而这种"不"是基于__某种不可否认的事实__,而从这种不,就天然形成了最关键的__"负反馈"__链路。
|
||||||
|
|
||||||
|
__"如何结束"__的背后是说,你需要设计一个__机制__,保证不会__无限循环__,看看你的Token账单,你知道我在说什么吧。
|
||||||
|
|
||||||
|
按我们带着以上的问题,看看官方的__参考答案__如何。
|
||||||
|
|
||||||
|
__2.2 五大组件+记忆模块__
|
||||||
|
|
||||||
|
在《Loop Engineering 循环工程》(https://addyosmani.com/blog/loop-engineering/)一文中,详细讲解了这几个部分,如下图所示:
|
||||||
|
|
||||||
|
1. __一个唤醒机制: Automations__
|
||||||
|
|
||||||
|
以往和AI协作,__是我推一下,它动一下__。讲道理,很累人。一个唤醒机制就保证了,人不用再去__"盯着,去喊",__这是整套自动化系统运行的前提。
|
||||||
|
2. __安全独立的沙箱环境: Worktrees__
|
||||||
|
|
||||||
|
多Agent协同必然会变成一种趋势,为每个任务分配独立代码工作区,就杜绝文件覆盖、环境互相污染等问题。
|
||||||
|
3. __对抗性思维:Maker-Checker 双校验模式__
|
||||||
|
|
||||||
|
Maker-Checker模式本质上就是保证了:__让模型不要自说自话__,采用__"一方做、一方质疑"__的制衡思路,结合Skills的经验库。二者互补修正,大幅提升输出质量。
|
||||||
|
4. __通信模式:Connectors__
|
||||||
|
|
||||||
|
作为一种系统间的沟通手段,比如MCP、Functioncall等等,就是为了打通所有的上下游系统,把系统链接起来,
|
||||||
|
5. __长任务记忆系统: Memory__
|
||||||
|
|
||||||
|
防止任务"失忆"。长流程任务没法全塞进 AI 有限上下文里,记忆组件会全程记录任务进度、过往尝试,防止多轮迭代后系统忘记目标、丢失执行记录。
|
||||||
|
|
||||||
|
## 03
|
||||||
|
|
||||||
|
如何让模型说"不"?
|
||||||
|
|
||||||
|
__3.1 方法一:践行TDD!!!__
|
||||||
|
|
||||||
|
让模型说"不",最关键就是__有硬性__的__不可怀疑__的证据。
|
||||||
|
|
||||||
|
而在软件工程中,测试不过就是铁的依据。
|
||||||
|
|
||||||
|
因此,AI时代,我们需要重新思考:__TDD的价值以及如何实践?__
|
||||||
|
|
||||||
|
而从Loop的视角重新看TDD,我们会发现:
|
||||||
|
|
||||||
|
TDD的价值并不是多写几个测试用例,而是,__可以把需求翻译成反馈信号__。
|
||||||
|
|
||||||
|
这做到这里的前提,就是:落实TDD__左移__。
|
||||||
|
|
||||||
|
多少次实践中,我也常常会等到开发完之后,再给AI补一句:__请补充测试用例。__
|
||||||
|
|
||||||
|
而这种习以为常的习惯,其实已经__偏离__的TDD的本质。
|
||||||
|
|
||||||
|
所以,我们有必要在回看一下TDD的理念:__先定标准、后做开发、以结果反向驱动过程__。
|
||||||
|
|
||||||
|
构建出一个最小的Loop__:Red-Green-Refactor__
|
||||||
|
|
||||||
|
- __红__:先编写失败测试用例,定义"__什么是错、什么是对__"的终态标准。
|
||||||
|
- __绿__:迭代编写代码,直到全部测试用例通过。
|
||||||
|
- __重构__:在测试兜底前提下优化代码,保证质量不退化。
|
||||||
|
|
||||||
|
以往这个循环为什么玩不起来,因为,这个循环的控制者是人,但是到了AI时代,__控制权交给Agent__,这个结构没有发生变化,但是你变轻松了。
|
||||||
|
|
||||||
|
在分布式系统中,每个服务都是全局中的一个局部,针对局部的一个模块,测试会有三个维度,也分别对应着三个环:
|
||||||
|
|
||||||
|
1、__单元测试环__:看似容易,其实不容器做到,这里难点在于:单元测试其实是和函数耦合的,也就是说,需要先定义好骨架,顾开发的流程应该是:__定义桩函数-> 写测试用例->写实现 。__
|
||||||
|
|
||||||
|
2、__接口测试环__:需要可以让AI可以自己发包,以及收日志,这样就可以在服务维度建立Loop。
|
||||||
|
|
||||||
|
3、__流程测试环__:以功能为单位进行验证,因为它更加上层,一般都是用来回归验证,如何构建这个环,以便AI可以站在全局修复问题,仍然值得思考。
|
||||||
|
|
||||||
|
__3.1.1 反向思考:TDD不能做什么?__
|
||||||
|
|
||||||
|
虽然TDD好,但,也不是万能药,我们需要清晰的知道它的边界:
|
||||||
|
|
||||||
|
它__适合__:
|
||||||
|
|
||||||
|
- 明确的业务规则
|
||||||
|
- API的输入、输出行为
|
||||||
|
- 数据转换和边界条件
|
||||||
|
- 回归Bug修复
|
||||||
|
- 编译、lint、类型检查
|
||||||
|
|
||||||
|
它__不适合__:
|
||||||
|
|
||||||
|
- 纯体验问题
|
||||||
|
- 架构品味
|
||||||
|
- 产品决策
|
||||||
|
|
||||||
|
知道了__适不适合__,就可以更好的思考,它__应该被放在哪里__?
|
||||||
|
|
||||||
|
在开发过程中,我们都应该反问自己:__这个功能是否可以被测试表达?这部分如何变成Loop?__
|
||||||
|
|
||||||
|
__3.1.2 以"规则"为核心的构建测试用例__
|
||||||
|
|
||||||
|
上面我们主要讲了如何构建环?下面来讲讲如何设计测试用例。
|
||||||
|
|
||||||
|
测试用例的设计非常重要!!!因为一旦设计有误,所有AI生成的代码都是在错误的基础上改动代码,结果怎么改都是错。
|
||||||
|
|
||||||
|
而这里的解决思路是:__以需求为出发点,构建规则集合。__
|
||||||
|
|
||||||
|
__3.2 方法二: 证据胜于一切,建立证据链__
|
||||||
|
|
||||||
|
Maker-Checker双校验架构听起来是很不错的,但是细想,一个问题很自然的就出来了:__Checker凭什么就说Maker做的不行呢?是靠猜吗?肯定不是。__
|
||||||
|
|
||||||
|
这很像是一场辩论赛,反方选手说你不行,那不能靠感觉,要靠依据,那依据是什么呢?没事,是__证据链__。
|
||||||
|
|
||||||
|
Maker 通过事实(产品规则)推演,输出落地代码。
|
||||||
|
|
||||||
|
Cherker 使用__证据链__进行追溯,Review代码。
|
||||||
|
|
||||||
|
而这种设计,本质上就是__对抗性思维__的一种极致体现!
|
||||||
|
|
||||||
|
__3.3 方法三:预算思维__
|
||||||
|
|
||||||
|
在设计一个Loop时,不仅需要考虑技术实现,更需要考虑一个很现实的点:__预算__
|
||||||
|
|
||||||
|
预算收紧的今天,谁都不想,月初额度就用了一半!所以需要有一些策略应对:
|
||||||
|
|
||||||
|
__策略一:模型选择__
|
||||||
|
|
||||||
|
首先,预算思维的本质是:__资源倾斜 ,背后的问题是:什么样的任务我愿意投入更多的资源?__
|
||||||
|
|
||||||
|
针对高价值的任务,用聪明的模型,而针对低价值的重复任务,绝不用贵的模型。
|
||||||
|
|
||||||
|
选择不合适的模型,成本差距巨大,Opus的输出成本是GLM4-Flash的__180倍__。
|
||||||
|
|
||||||
|
__策略二:设置退出机制__
|
||||||
|
|
||||||
|
设置退出机制就是针对每个任务要设置一个阈值上线,常见的有:
|
||||||
|
|
||||||
|
1. 最大的步骤限制
|
||||||
|
2. 预算熔断机制
|
||||||
|
|
||||||
|
__策略三:上下文压缩__
|
||||||
|
|
||||||
|
面对长周期 Agent 任务的成本问题,上下文压缩,是一个常见的方式,一般的做法是:用廉价模型对全量上下文反复重压缩,但这种操作,往往会__实则会让核心规则持续稀释、过程噪音不断累积__。最终导致任务跑偏、全链路已经投入的 Token 全部作废。
|
||||||
|
|
||||||
|
而这里我个人的一些应对思路是:高密度核心规则全程人为把控(不参与压缩)+增量信息克制压缩
|
||||||
|
|
||||||
|
把人的强判断力用在不可出错的核心约束上,把模型的压缩能力用在可损耗的过程信息上,从根源上避免压缩噪音污染核心逻辑。
|
||||||
|
|
||||||
|
## 04
|
||||||
|
|
||||||
|
写在最后
|
||||||
|
|
||||||
|
Loop不是一个技术框架,而是一种思维模式。让我们更好的去思考:人和AI如何协作完成一个Loop?把人从Loop中更多的环节拔出来,把注意力真正的还给人自己。
|
||||||
|
|
||||||
|
-End-
|
||||||
|
|
||||||
|
原创作者|吕昊俣
|
||||||
@@ -0,0 +1,76 @@
|
|||||||
|
# 📊 文章摘要:对Loop Engineering的思考
|
||||||
|
|
||||||
|
> **原文**:[2026-08-27_对Loop_Engineering的思考](./2026-08-27_对Loop_Engineering的思考.md)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/g3HtSeJfKfjtqDG4rPTpiw
|
||||||
|
> **来源**:微信公众平台(腾讯云开发者)
|
||||||
|
> **作者**:吕昊俣
|
||||||
|
> **发布日期**:2026-08-27
|
||||||
|
> **摘要日期**:2026-08-27
|
||||||
|
> **价值评级**:⭐⭐⭐ 高
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 核心命题
|
||||||
|
|
||||||
|
> **循环工程** — AI 辅助编程的范式正从"写 Prompt"迁移到"设计 Loop":用控制论的负反馈闭环驯服 LLM 的概率性错误,让人从流程的每个环节中拔出来,实现无人值守的自动收敛。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 文章概要
|
||||||
|
|
||||||
|
本文提出 AI 辅助编程的五代演进框架(Prompt→Context→Harness→Loop→Graph Engineering),指出当前正处于 Loop Engineering 阶段——解决 Harness 时代"仍要人盯"的瓶颈。文章的独特贡献是把 Loop Engineering 追溯到控制论根基:LLM 单次 90% 的正确率在分治法下指数衰减(六次嵌套后接近抛硬币),唯一解药是负反馈机制。作者给出可操作的落地路径——设计 Loop 的四问(定义问题/开始/反馈/结束)、让模型说"不"的三种方法(TDD 反馈信号、证据链、预算思维),以及 Addy Osmani 的五大组件参考架构(Automations/Worktrees/Maker-Checker/Connectors/Memory)。价值在于提供了从工程哲学到具体实践的完整链条,局限是缺乏自己的量化落地数据,五代演进的分期也带有作者的主观建构。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 关键要点
|
||||||
|
|
||||||
|
1. **五代工程演进层层依赖而非替代** — Prompt(2023)→Context(2025)→Harness(2026.2)→Loop(2026.6)→Graph(2026.7),每一代解决上一代遗留瓶颈;Harness 是受控运行环境(地基),Loop 是其上的自驱动持续执行流程(上层调度)。 `[分类: 共识]`
|
||||||
|
2. **概率正确率的指数衰减是 Loop 的第一性动因** — 单步 90% 正确率经分治法分解为 N 个子任务后指数衰减,六次后接近 50%;这不是模型不行,而是软件工程结构放大了概率损失,需要控制论修正。 `[分类: 范式突破]`
|
||||||
|
3. **控制论四大公理与 Loop 一一同构** — 构建负反馈闭环、可观测性、可控性约束、离散迭代纠偏,与 Loop Engineering 的反馈设计、监控、沙箱、迭代修正一一对应;"通过负反馈机制去收敛目标函数"是本质概括。 `[分类: 共识]`
|
||||||
|
4. **从小闭环做起** — 先跑通最小可收敛闭环,再逐步放大自治边界;大循环是在一个个小循环上长出来的。 `[分类: 共识]`
|
||||||
|
5. **设计反馈 = 让模型真的会说"不"** — 基于不可否认的事实(测试失败、证据链)而非提示词里的拒绝意图;提示词里的"不"看似否定实则肯定。 `[分类: 共识]`
|
||||||
|
6. **TDD 的 Loop 视角重估** — TDD 的价值不是多写测试,而是把需求翻译成反馈信号;控制权从人交给 Agent 后,Red-Green-Refactor 循环的结构不变但人变轻松;需知其边界(不适合体验、品味、产品决策)。 `[分类: 共识]`
|
||||||
|
7. **Checker 凭证据链质疑 Maker** — 对抗性双校验中质疑方不能靠猜,要靠产品规则推演与证据链追溯的对抗。 `[分类: 共识]`
|
||||||
|
8. **预算思维三策略** — 模型分级(Opus 输出成本是 GLM4-Flash 的 180 倍)、退出机制(步骤上限+预算熔断)、上下文压缩(核心规则人为把控不参与压缩,过程信息克制压缩)。 `[分类: 共识]`
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 批判性分析
|
||||||
|
|
||||||
|
### 假设前提
|
||||||
|
|
||||||
|
作者默认:(1) 五代演进是真实规律而非事后叙事(时间标注精确到月,但 Graph Engineering 2026.7 才出现即宣称"解决了 Loop 编排问题",验证期过短);(2) 控制论框架足以刻画 LLM 系统的反馈(LLM 的"负反馈"依赖语义判断而非物理测量,噪声特性不同);(3) TDD/证据链在真实项目中可覆盖足够的反馈面。
|
||||||
|
|
||||||
|
### 论据与逻辑
|
||||||
|
|
||||||
|
主体是框架整合与推演:引用 Addy Osmani 的推文与博文、吴恩达的三层 Loop、控制论教材,属于"站在权威上的综合"而非一手实验。90%→50% 的指数衰减算术正确且有力,但真实 Agent 任务并非纯串联,含并行、重试、回滚等结构,衰减幅度会被高估。上下文压缩"核心规则人为把控"的建议是作者个人经验,未给出验证。
|
||||||
|
|
||||||
|
### 边界与局限
|
||||||
|
|
||||||
|
适用于代码类、可测试表达的任务闭环;对探索性任务(调研、创作)反馈信号难以客观化,Loop 设计失效。全文无落地数据支撑,五大组件仅为官方参考架构转述。控制论映射虽有启发性,但 LLM 反馈回路存在延迟不可控、信号不可复现等超出经典控制论假设的特性。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 可引用金句
|
||||||
|
|
||||||
|
> "Harness 是 AI 代理的受控运行环境;Loop 是在这个环境之上,叠加了自驱动能力的持续执行流程。"
|
||||||
|
|
||||||
|
> "90%听起来很不错,但是……仅仅六次后,概率就接近50%,这不就是抛硬币吗!"
|
||||||
|
|
||||||
|
> "控制论的本质一句话就可以说明白:通过负反馈机制去收敛目标函数。"
|
||||||
|
|
||||||
|
> "把小闭环跑通,才有资格谈大闭环,大循环是在一个个小循环上长出来的。"
|
||||||
|
|
||||||
|
> "这种'不'是基于某种不可否认的事实,而从这种不,就天然形成了最关键的'负反馈'链路。"
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 总体评价
|
||||||
|
|
||||||
|
**亮点**:五代演进框架为分散的概念(Prompt/Context/Harness/Loop/Graph)建立了清晰的结构关系;控制论溯源赋予 Loop Engineering 理论合法性,指数衰减论证直观有力;"让模型说不"三法(TDD/证据链/预算)可直接操作。
|
||||||
|
|
||||||
|
**不足**:无作者自己的落地数据,全篇为文献综合与思辨;五代分期时间线(精确到月)主观性强;控制论映射停留在类比层面,未讨论 LLM 反馈与物理反馈的本质差异。
|
||||||
|
|
||||||
|
**适用场景**:向团队解释"为什么要从提示工程转向循环工程"的框架性材料;设计自动化开发闭环(CI 中的 Agent、夜间无人值守任务)时的检查清单;预算治理策略(模型分级、熔断、压缩)的直接参考。
|
||||||
|
|
||||||
|
**关联建议**:与 2026-08-20《从 OpenCode 升级到 V2,我们看到上下文工程与驾驭工程的三个趋势》衔接——本文的五代演进是该文"驾驭工程"叙事的细化;与同批《靠这10个优化点,我们把Multi-Agent工作流成本降了50%以上》互补:一文讲 Loop 的预算思维,一文给出成本的工程实测;TDD 部分可与 superpowers:test-driven-development skill 实践互证。
|
||||||
@@ -0,0 +1,74 @@
|
|||||||
|
# 2026制造业生死局:工业大模型落地,AI智能体进厂,正在重构工厂的生存法则
|
||||||
|
|
||||||
|
> **来源**:微信公众平台(墨执子)
|
||||||
|
> **作者**:墨执子
|
||||||
|
> **发布日期**:2026-08-20(原文未标注明确日期,按下载日占位)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/WX5ysyywBrx5Nnb7JyKKeg
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
|
||||||
|
|
||||||
|
**墨算未来**
|
||||||
|
|
||||||
|
墨科技演进,算未来气象
|
||||||
|
|
||||||
|
|
||||||
|
|
||||||
|
2026年,在中国的制造业江湖里,流传着一个让所有厂长都睡不着觉的消息:那位传说中的“新师傅”,终于要大范围进厂了。
|
||||||
|
|
||||||
|
这位“新师傅”不吃饭、不睡觉、不闹情绪,更不会在关键时刻撂挑子。它的出现,不是为了简单地抢谁的饭碗,而是要彻底改写工厂的生存法则。
|
||||||
|
|
||||||
|
过去几十年,咱们的工厂经历过两次脱胎换骨的改造。现在回头看,那两次不过是热身,真正的深水区变革,才刚刚开始。这不是简单的给旧机器换个新零件,而是一场生存法则的彻底重置。
|
||||||
|
|
||||||
|
很多年前,制造业迎来了第一次蜕变。那时候,大家喊的口号是“自动化”。核心思路很朴素:把人的体力劳动,交给机器。
|
||||||
|
|
||||||
|
流水线转起来了,机械臂挥起来了。拧螺丝、焊接、搬运,这些累活、重复活,机器全包了。它解决了一个核心问题:“干”的问题。以前需要十个壮小伙才能搬动的钢材,现在一个机械臂轻松拿捏,又快又稳,还不用倒班。但那时候的机器,脑子是一根筋。你让它往东它绝不往西,你给它编好的程序是1,它绝不会给你干出个2来。它是个能干但不会想的好把式,遇到程序里没有的新情况,立马就傻眼。
|
||||||
|
|
||||||
|
后来,大家觉得光能干还不行,还得能“看”。于是,第二次蜕变来了,叫“数字化”。人们在机器上、产线上,密密麻麻地安上了无数的小眼睛,也就是传感器。温度、压力、转速、振动频率,这些过去凭老师傅手感才能感知到的模糊信息,瞬间变成了电脑屏幕上精确的数字。生产线哪台设备在偷懒,哪个环节在发烧,一目了然。它解决的是“看”的问题。厂长们终于不用天天泡在嘈杂的车间里,坐在有空调的办公室就能看清一切。可新问题又来了,看到了,然后呢?数据是死的,像医院的体检报告,只告诉你哪里指标异常,却不会告诉你病因,更不会帮你开药方。分析和决断,还得靠经验丰富的老专家。
|
||||||
|
|
||||||
|
现在,第三次蜕变的浪潮已经拍到了工厂围墙边,这就是“智能化”。它要解决最核心的那个问题:“想”的问题。它的主角,就是这位不吃不睡的“新师傅”,一种基于工业大模型和智能体技术的新型智慧。这位新师傅不仅能干,能看,最关键的是,它能自己琢磨事。它能24小时不间断地盯着每一台设备的呼吸和心跳,从浩如烟海的数据里瞬间揪出异常的苗头,然后自己分析,自己判断,自己给出调整指令。以前是人来当家作主,现在是这位新师傅来替你运筹帷幄。这不是多了一个帮手,而是换了一种思考模式,是从“人治”到“智治”的跨越。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
为什么工厂对新师傅如此渴望?
|
||||||
|
|
||||||
|
全世界的工厂老板,无论大江南北,愁的几件事高度一致。而这些发愁的事,恰好撞在了这位新师傅的枪口上。
|
||||||
|
|
||||||
|
工厂里的第一愁,是事情多到管不过来。一条现代化的产线,成百上千台设备,涉及上千个参数,上万个变量。这些变量之间还相互拉扯、互相影响,其复杂程度远超常人想象。靠几个经验丰富的车间主任和老师傅,就算把头发熬白了,也根本盯不住、调不好。而新师傅最拿手的就是处理这种极端复杂的局面。在它看来,再多参数也不过是一堆数字游戏,它能轻松地从中理出头绪,找到那条通往最高效、最稳定的黄金路线。
|
||||||
|
|
||||||
|
第二愁,是绝活全在老师傅脑子里。很多工厂都有几位镇厂之宝级别的老师傅。机器闹脾气,别人听半天没动静,他过去听一耳朵,就知道哪个齿轮该上油了。工艺出了瑕疵,别人调整半天不管用,他随手拨弄几个参数,产品质量立马就稳了。但这些手艺,往往只可意会不可言传,都装在他们的大脑中。老师傅一退休,这些宝贵的经验和诀窍也就跟着离开了。新徒弟上来,又得重新交学费、踩大坑。而新师傅最厉害的本事,就是能把老师傅的绝活给“学”过来,并且永久地沉淀下来。它不是靠喝大酒拜师学艺,而是将老师傅每一次成功的判断和操作,都转化为算法模型里的一组数据、一条规律。人走了,经验不仅留下来了,还能被整个工厂共享。它还能像炼蛊一样,结合成千上万个案例,不断学习和优化,最终变成一个永不退休、技艺还日益精进的超级老师傅。
|
||||||
|
|
||||||
|
第三愁,是市场大环境变得太快。今天客户要A款,明天就流行B款了。原材料的价格也是上蹿下跳,跟坐过山车似的。生产计划就得跟着变,工艺参数也得跟着调。靠人来调度,从拍板到传达,再到执行,反应速度像是一头反应迟钝的恐龙。脚上被蚊子叮了一口,半天才能传到大脑。而新师傅的反应速度是毫秒级的。它能实时感知到外部环境的变化,然后瞬间计算出几套最优应对方案,让产线像一头灵活的猎豹,随时调整姿态,快速响应市场的风吹草动。
|
||||||
|
|
||||||
|
最后一愁,就是成本这座大山。利润薄得像纸片,人工在涨,原料在涨,竞争却越来越刺刀见红。怎么省钱,是每个工厂永恒的头等大事。新师傅恰好是降本增效的顶尖高手。一个智能体,能干好几个高级工程师的脑力活;一次悄无声息的工艺参数优化,一年下来可能就省下几百万的原材料。它不知疲倦地寻找每一个可以节能的缝隙,堵住每一个浪费的耗点,这种无孔不入的省钱能力,足以让最精明的财务总监都自愧不如。
|
||||||
|
|
||||||
|
那么,这位神通广大的新师傅是怎么炼成的?它的诞生,靠一个超级大脑和一双灵巧的手脚。
|
||||||
|
|
||||||
|
它的超级大脑,叫“工业大模型”。这东西可以理解成一种专门为工厂量身定制的超级专家大脑,而不是那种上知天文下知地理,但样样稀松的通用聊天对象。这个大脑是深耕在工业领域的,它学习工业原理,精通工艺流程,对设备构造了如指掌。2026年,这种专业大脑已经从飘在空中的概念,实实在在地落到了生产线上。国家和地方层面都推出了强有力的行动计划,要推动这种超级大脑在制造业里深度应用,目标是培育出一批有全球影响力的顶尖企业。很多行业巨头,都已经推出了自己的工业大模型,把这个超级大脑植入到了工厂的生产环节。
|
||||||
|
|
||||||
|
光有大脑还不够,还得有能干活的手脚,这就是“工业智能体”。如果大脑负责思考,智能体就是那个把想法变成现实的执行者。它不仅能听懂人的指令,还能自己把一个大目标拆解成一个个小步骤。比如,你告诉它,目标是把A产品的良率从95%提升到98%。它会自己去分析历史数据,去查阅工艺知识,去调用各种检测工具,然后规划出一套完整的试验方案,自己控制设备去执行,根据结果再实时调整。遇到难题,它会自己想办法绕过去,或者寻找新的解决方案。以前的各种应用,就像你去问路,别人告诉你左转右转,你记下来自己走。现在的智能体,是直接接过你手中的地图和方向盘,把你安全快速地送到目的地。2026年,这种工业智能体迎来了爆发,各大公司都在争相发布自己的产品。有搞生产调度的,有搞设备运维的,有搞质量优化的,它们的效率提升,不是用百分比点,而是动辄百分之几十的跃升。一个工程师以前要花一周时间辛辛苦苦做的工程配置,智能体两三天就能干完,而且不出错。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
新师傅如何一步步接管车间?
|
||||||
|
|
||||||
|
新师傅进厂,不是锣鼓喧天、鞭炮齐鸣,然后一夜之间全厂大变样。它的渗透方式,像春雨润物一样,悄无声息,一个角落一个角落地攻克。通常是从最痛苦、最能见效果的环节先下手。
|
||||||
|
|
||||||
|
最成熟的第一站,往往是质量检测。以前靠人眼盯着流水线上飞速滑过的产品,一天下来两眼昏花,难免漏掉瑕疵品。新师傅的一双电子眼不知疲倦,精度堪比孙悟空的火眼金睛,任何微米级别的划痕、缺口、色差都逃不过它的法眼。这个场景现在已经在大量工厂普及开来。
|
||||||
|
|
||||||
|
然后是设备运维,也就是给机器看病。以前是设备突然趴窝了,才火急火燎地去抢修,损失巨大。新师傅摇身一变成为预言大师,它通过长期监听设备的振动和温度,就能精准预测出哪个零件在什么时间可能会出毛病,提前发出预警。维修人员就可以利用换班间隙,轻松地把隐患扼杀在摇篮里,避免了整条产线突如其来的大瘫痪。
|
||||||
|
|
||||||
|
第三站,也是最值钱也最难啃的骨头,就是工艺优化。这就像是给产品配方和烹饪手法找最佳搭配。发酵时间长短、温度高低、压力大小,这些参数之间微妙的组合,直接决定了产品的最终品质和成本。新师傅可以像一个不知疲倦的顶级大厨,在虚拟世界里进行成千上万次试错和推演,最终找到一套最优的参数组合,在保证最高品质的同时,还把能耗和物料消耗降到最低。这带来的效益,是实打实的真金白银。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
接下来,它还会逐步接管更复杂的生产调度,像个超级交通指挥官,让所有的物料、设备、订单都最高效地流动起来,不留瓶颈。以及安全管理,用无数双永不疲倦的眼睛盯住厂区的每个角落,把火灾、泄漏等风险扼杀在萌芽中。
|
||||||
|
|
||||||
|
为了让新师傅的超级大脑不瞎琢磨,还有一个关键环节:得给大脑喂“真经”。这真经就是“工业知识图谱”。简单说,就是把整个工厂从建厂以来所有的图纸、工艺手册、设备参数、故障记录,甚至老师傅口传心授的经验,都梳理成一套互联互通的、结构化的知识网络。有了这套真经,当它思考问题时,就有据可依,有法可循。你问它怎么调某个注塑参数,它给出的答案就不再是天马行空的乱猜,而是基于这个工厂真实沉淀下来的最佳实践。那些原本只藏在老师傅脑中的隐性绝活,就此显性化,成为了企业谁也带不走的数字资产。
|
||||||
|
|
||||||
|
这是一个全新的竞技场。以前,工厂之间比拼的是谁的规模更大,谁的成本更低,谁的人手更多。以后,决定生死的,将是数据、是算法、是工厂的智慧化程度。谁能先把这位不吃不睡的新师傅请进门,并且用好它,谁就能在新一轮的残酷淘汰赛中拿到主动权。这条路注定不会平坦,但方向已经明确。对于每一个身处其中的人来说,这不再是一道可有可无的选择题,而是一道关乎未来生存的必答题。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|

|
||||||
@@ -0,0 +1,77 @@
|
|||||||
|
# 📊 文章摘要:2026制造业生死局:工业大模型落地,AI智能体进厂,正在重构工厂的生存法则
|
||||||
|
|
||||||
|
> **原文**:[2026-08-20_2026制造业生死局_工业大模型落地_AI智能体进厂_正在重构工厂的生存法则](./2026-08-20_2026制造业生死局_工业大模型落地_AI智能体进厂_正在重构工厂的生存法则.md)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/WX5ysyywBrx5Nnb7JyKKeg
|
||||||
|
> **来源**:微信公众平台
|
||||||
|
> **作者**:墨执子
|
||||||
|
> **发布日期**:2026-08-20
|
||||||
|
> **摘要日期**:2026-08-20
|
||||||
|
> **价值评级**:⭐⭐ 中
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 核心命题
|
||||||
|
|
||||||
|
> **人治到智治** — 制造业第三次蜕变(智能化)解决的是"想"的问题,决策主体从人转向"工业大模型+工业智能体"系统。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 文章概要
|
||||||
|
|
||||||
|
本文以通俗科普笔法宣告 2026 年"工业大模型+工业智能体"将大范围进厂,用"自动化解决干、数字化解决看、智能化解决想"的三段式框架,把当前变革定位为从"人治"到"智治"的生存法则重置。文章先梳理工厂四大痛点(变量管不过来、老师傅经验随退休流失、市场变化快、成本压力),再解释"新师傅"的构成(工业大模型为大脑、工业智能体为手脚),并给出按痛苦程度递进的落地路径:质量检测→设备预测性运维→工艺优化(最值钱最难)→生产调度与安全管理,最后强调工业知识图谱是把隐性经验变成企业数字资产的关键。局限非常明显:全文没有一个具名案例、没有任何有出处的数据、不讨论任何风险与失败模式,属于理念布道文而非实证分析。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 关键要点
|
||||||
|
|
||||||
|
1. **三次蜕变框架** — 自动化解决"干"(体力交机器)、数字化解决"看"(传感器把模糊信息变精确数字)、智能化解决"想"(自己分析判断给指令)`[分类: 共识]`
|
||||||
|
2. **数字化遗留问题被点破** — 数据像体检报告,只报异常不给病因不开药方,分析和决断仍依赖老专家 `[分类: 共识]`
|
||||||
|
3. **四愁对四解** — 变量复杂→模型理头绪;隐性经验→沉淀为算法规律;市场快变→毫秒级响应;成本→无孔不入的优化 `[分类: 共识]`
|
||||||
|
4. **新师傅的双件套结构** — 工业大模型(领域大脑:工业原理、工艺流程、设备构造)+ 工业智能体(自主拆解目标、规划、执行、闭环调整的执行者)`[分类: 共识]`
|
||||||
|
5. **落地顺序按"痛感+见效"推进** — 质检最成熟已普及→设备预测性维护→工艺优化(虚拟世界海量试错找最优参数)→生产调度、安全管理 `[分类: 共识]`
|
||||||
|
6. **工业知识图谱是"真经"** — 图纸、工艺手册、故障记录、老师傅口传经验结构化为知识网络,让模型回答有据可依,隐性绝活显性化为"谁也带不走的数字资产" `[分类: 共识]`
|
||||||
|
7. **竞争焦点迁移** — 从比规模、成本、人手转向比数据、算法、智慧化程度,"不再是选择题而是必答题" `[分类: 争议]`
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 批判性分析
|
||||||
|
|
||||||
|
### 假设前提
|
||||||
|
- 默认技术已经 ready:"2026 年已从概念实实在在落到生产线上",无需论证可行性。
|
||||||
|
- 默认老师傅的隐性经验(文中自认"只可意会不可言传")可以被完整数据化并被模型学会——这正是知识工程中最难的瓶颈,被一笔带过。
|
||||||
|
- 默认效率数字可信:"动辄百分之几十的跃升""一年省下几百万"均无出处。
|
||||||
|
|
||||||
|
### 论据与逻辑
|
||||||
|
- 全文零具名案例(未提及任何企业、任何工业大模型产品名)、零可核查数据;类比论证(新师傅、火眼金睛、炼蛊、大厨)替代了论证。
|
||||||
|
- "四愁"归纳与多数制造业 AI 讨论同构,无新信息增量;"必答题"式紧迫感渲染缺乏分行业、分规模的条件区分。
|
||||||
|
|
||||||
|
### 边界与局限
|
||||||
|
- 完全没有边界意识:不讨论哪些场景不适合上大模型、数据基础薄弱的中小工厂怎么办、幻觉与安全风险、集成成本与组织阻力。
|
||||||
|
- 标题用"生死局"制造焦虑,但文中无任何失败案例或成本收益的反面讨论。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 可引用金句
|
||||||
|
|
||||||
|
> "数据是死的,像医院的体检报告,只告诉你哪里指标异常,却不会告诉你病因,更不会帮你开药方。"
|
||||||
|
|
||||||
|
> "这不是多了一个帮手,而是换了一种思考模式,是从'人治'到'智治'的跨越。"
|
||||||
|
|
||||||
|
> "那些原本只藏在老师傅脑中的隐性绝活,就此显性化,成为了企业谁也带不走的数字资产。"
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 总体评价
|
||||||
|
|
||||||
|
**亮点**:
|
||||||
|
- "干—看—想"三段式框架清晰易懂,是向非技术受众解释制造业 AI 演进的合格话术框架。
|
||||||
|
- 四愁→四解、落地顺序(质检→运维→工艺→调度)的结构化梳理有普及价值。
|
||||||
|
|
||||||
|
**不足**:
|
||||||
|
- 无一案例具名、无一数字有出处,宣传性远大于信息性;对风险、成本、失败模式零讨论。
|
||||||
|
|
||||||
|
**适用场景**:
|
||||||
|
- 向制造业客户或管理层做 AI 进厂的理念铺垫、售前教育;不适合作为技术选型或投资判断的依据。
|
||||||
|
|
||||||
|
**关联建议**:
|
||||||
|
- 与同日归档的《干货丨一文get 2026"人工智能+制造"融合创新研讨会 核心观点》(自动化博览)主题互证;建议搭配有实证数据的工业 AI 落地研报平衡阅读。
|
||||||
@@ -0,0 +1,138 @@
|
|||||||
|
# 当 PD 分离成为标配,推理的未来在 AFD
|
||||||
|
|
||||||
|
> **来源**:微信公众平台(小哥人工智能笔记)
|
||||||
|
> **作者**:小哥人工智能笔记
|
||||||
|
> **发布日期**:2026-08-05(原文未标注明确日期,按下载日占位;解读论文 arXiv:2605.28302 为 2026-05)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/5YsLOl4oIfHzNdi8pbmURQ
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
> 推荐理由:在 PD 分离已经成为集群分布式推理标配的时候,推理系统未来的方向走向了 AFD,这篇文章不是从 AFD 方案本身入手,而是从 AFD 的建模配比入手,给出指导。
|
||||||
|
|
||||||
|
过去两年,大模型推理系统的(disaggregation)浪潮走得比大多数人想象得更快。先是 chunked-prefill 把 prefill 和 decode 塞进同一个批次;接着 prefill–decode(P/D)分离把计算密集的 prefill 与访存密集的 decode 拆到不同机器池;而现在,Georgia Tech、Intel、Google、Google DeepMind 联合的一篇工作(arXiv:2605.28302《How Far Can Disaggregation Go?》)把解聚的刀进一步切进了每一个 Transformer 块内部——把 Attention(注意力)和 FFN(前馈网络)也拆到不同的 GPU 组上执行。这种被称为 **Attention–FFN Disaggregation(AFD,注意力–前馈解聚)** 的算子级解聚,正是继 PD 分离之后,MoE(混合专家)大模型推理最值得关注的基础设施方向。
|
||||||
|
|
||||||
|
这篇文章不是又一篇「我做了一个系统」的论文,而是用一套建模框架 AIC++,系统地把「到底要不要解聚、解到哪一层才划算」这件事算清楚了。它的结论对做智算中心、推理 Infra、以及所有关心 MoE 模型规模化部署的人,都有很强的指导意义:**AFD 在严格延迟 SLO 下能撑起约 4k tokens/s 的系统吞吐,而在非 AFD 部署根本无法运行的 1M 前缀长上下文场景里,AFD 是唯一可行的解。**换句话说,AFD 的价值不只是「更快」,更是在特定战场上「能不能跑」。
|
||||||
|
|
||||||
|
## 零、为什么「解聚」是智算中心绕不开的命题
|
||||||
|
|
||||||
|
在谈 AFD 之前,得先说清一个更底层的判断:为什么「解聚」会成为大模型推理系统的主流范式?根本原因是 Transformer 推理天然是**两段式、且两段瓶颈完全不同**的。Prefill 阶段要处理整段输入、一次性生成全部 KV 缓存,算力(FLOPs)主导,理论上限由 GPU 的算术吞吐决定;Decode 阶段逐 token 自回归生成,每一步只算一个 token 却要读写整份 KV 缓存,瓶颈在显存带宽(memory bandwidth),GPU 的算力在这里大量闲置。把这两段塞在同一张卡上,要么 prefill 占着算力把 decode 饿着,要么 decode 占着带宽把 prefill 拖慢,气泡(bubble)巨大。
|
||||||
|
|
||||||
|
PD 分离的本质,就是把这两段按各自瓶颈拆到不同硬件池,让 prefill 池专心吃算力、decode 池专心喂带宽,再通过 KV 缓存的跨节点传输把两段衔接起来。这套思路已经在 vLLM、SGLang、TensorRT-LLM 等主流引擎里成了默认配置。但论文敏锐地指出:**PD 分离仍然把每个 Transformer 块当作一个「不可分割的整体」**,而 MoE 这类模型在块内部,Attention 和 FFN 的异质性就已经大到不能忽略——于是解聚的下一刀,自然落在了块内部。这也是为什么 AFD 被定义为「叠在 PD 之上的下一级解聚」,而不是它的替代者。
|
||||||
|
|
||||||
|
## 一、解聚的三级跳:从 chunked-prefill 到 AFD
|
||||||
|
|
||||||
|
要理解 AFD 为什么重要,得先看清推理解聚的演进脉络。现代 LLM 推理天然分成 prefill(处理整段输入、生成 KV 缓存,计算密集)和 decode(逐 token 自回归生成,访存密集,受 KV 缓存带宽制约)两个阶段。早期的 chunked-prefill(Sarathi, 2023)只是把长 prefill 切成块塞进 decode 批次,减少气泡;PD 分离(DistServe, 2024;Splitwise, 2023)则把两个阶段放到独立硬件池,各自按自己的瓶颈扩展。
|
||||||
|
|
||||||
|
但 PD 分离仍然把每个 Transformer 块当作一个「不可分割的整体」。而论文指出,对于 MoE 这类模型,同一个块内部的异质性就已经非常显著:Attention(尤其是 MHA/GQA/MLA 变体)主要是**访存密集、状态密集**(KV 缓存读写主导);FFN(特别是 MoE 的 expert FFN)则是**计算密集**(被稠密 GEMM 主导)。MegaScale-Infer(2025)已经证明,在巨大的异构模型上,粗粒度抽象会失效。AFD 就是把 Attention 和 FFN 算子也分开部署,让「状态重的注意力」和「无状态的计算密集 FFN」各自拥有独立伸缩的 GPU 池。
|
||||||
|
|
||||||
|
论文把这套层级画在 Figure 1 的 AIC++ 框架总览里:设计空间同时覆盖 token 级并行(DP/SP/TP/PP/EP)、阶段级 P/D 分离、以及算子级 A/F 解聚。换句话说,AFD 不是 PD 的替代品,而是叠在 PD 之上的下一级解聚。
|
||||||
|
|
||||||
|
表:推理解聚的三级跳对比(演进逻辑,非论文原表)
|
||||||
|
|
||||||
|
| 解聚层级 | 切分对象 | 主要解决 | 典型收益 | 主要代价 |
|
||||||
|
| --- | --- | --- | --- | --- |
|
||||||
|
| chunked-prefill | 长 prefill 切块 | 批次内气泡 | GPU 利用率提升 | 无独立伸缩 |
|
||||||
|
| P/D 分离 | prefill vs decode | 算力 vs 带宽瓶颈错配 | TTFT/TPOT 各自优化 | KV 跨节点传输 |
|
||||||
|
| A/F 解聚(AFD) | Attention vs FFN | 块内访存 vs 计算错配 | rate-matching + 显存切分 | 层内 A2F/F2A 通信 |
|
||||||
|
|
||||||
|
## 二、为什么 Attention 和 FFN 必须分开算:异构性的量化证据
|
||||||
|
|
||||||
|
AFD 的合理性,根植于 Attention 与 FFN 在执行特性上的根本差异。论文用 Figure 3 把四种代表性架构在四种上下文长度下的**运行时占比**和**显存占比**做了分解,结论非常直观:
|
||||||
|
|
||||||
|
- **稠密 GQA 架构**(如 GPT-OSS-120B、Qwen3-235B):在长上下文下高度 Attention 主导——4K 上下文时 Attention 占运行时约 41%/59%,到 0.5M 上下文时 Attention 占比飙到 87%/96%。
|
||||||
|
- **稀疏注意力架构**(DeepSeek-V3.2,MLA + 稀疏注意力):短上下文 FFN 主导,但随上下文变长越来越 Attention 受限。
|
||||||
|
- **状态空间模型**(Nemotron3-120B,Mamba-2 + GQA):因为线性时间注意力特性,运行时 decisively 倒向 FFN(128K 上下文时 FFN 占 81%)。
|
||||||
|
|
||||||
|
关键观察:**Attention/FFN 的运行时比例随上下文长度单调上升**(KV 缓存越来越大),且不同架构斜率完全不同。这意味着「给 Attention 和 FFN 分配多少算力」没有统一答案,必须按工作负载和模型架构动态决定——这正是 AFD 存在的根本理由。显存侧也是同理:Figure 3(b) 显示权重与 KV 缓存的占比随上下文剧烈变化,长上下文下 KV 缓存能吃掉 40%–77% 的显存。
|
||||||
|
|
||||||
|
顺带一提,这种「块内异构」对 MoE 尤其刺眼。MoE 的 FFN 是专家混合,参数规模常占整个模型权重的 80%–90% 以上,是名副其实的算力黑洞;而 Attention 在长上下文下又被 KV 缓存的读写带宽牢牢绑死。把这两者捆在同一个 GPU 上,你要么用一个超大 FFN 池去迁就一个很小的 Attention,要么用一个够大的 Attention 片去浪费 FFN 算力——两种都会留下明显的效率缺口。AFD 的解法不是「折中」,而是**把两者解耦到各自最合适的硬件配比**。
|
||||||
|
|
||||||
|
## 三、AIC++:把「解聚到哪一层」变成可求解的设计空间
|
||||||
|
|
||||||
|
为了系统研究 AFD,论文构建了 AIC++(AIConfigurator++)协同设计框架:它把 NVIDIA AIConfigurator 的算子级计算建模(实测 GPU 集群代价数据库)与 AstraSim 的高保真网络仿真(包粒度拥塞感知)融合起来,并基于一个定制化的 vLLM AFD 原型验证全对的全双工 Attention–FFN 执行路径的正确性。
|
||||||
|
|
||||||
|
AIC++ 的精髓在于:它显式地把「算子级计算异构性」和「跨节点通信代价」放进同一个优化目标里,从而能回答一个此前没人算清的问题——**在多大规模的集群上、对什么样的负载、Attention 该配几个 GPU、FFN 该配几个 GPU?**
|
||||||
|
|
||||||
|
在 MoE 上做 AFD,通信形态会发生质变。非 AFD 部署里,MoE 的 Dispatch/Combine 通信只在参与 EP(专家并行)的 GPU 之间、源目数量匹配;而 AFD 下 Attention 和 FFN 跑在不同物理 GPU 组上,导致**非对称的扇出/扇入**:例如 8 GPU 上 EP=8 的 MoE 在所有 8 卡间交换 token,而「2 个 Attention GPU + 6 个 FFN GPU」的 AFD 配置会产生扇出——Attention GPU 生成的 token 要被分发到更多 FFN GPU。A2F(Dispatch)是扇出,FFN 侧入口拥塞成为瓶颈;F2A(Combine)是扇入,Attention 侧入口成为瓶颈。AIC++ 把这两种传输展开成完整的双部流量矩阵,喂给 AstraSim 的分层拥塞感知网络模型。
|
||||||
|
|
||||||
|
## 四、四阶段微批重叠:AFD 吞吐的关键技巧
|
||||||
|
|
||||||
|
AFD 把每个 Transformer 层的执行拆成四个阶段,分别映射到不同的计算或通信资源:① Attention GPU 上的注意力计算;② 把后注意力隐状态、token id、每专家路由元数据 dispatch 给 FFN;③ FFN GPU 上的 MoE-FFN 计算;④ 把专家输出聚合回 Attention 侧进入下一层。现代数据中心 GPU 普遍提供全双工互联(NVLink、InfiniBand),因此返回通信可以走专用通道与正向通信并发,形成流水线。
|
||||||
|
|
||||||
|
论文给出了稳态流水线延迟的闭式表达(公式 1):把每步 token 预算 T_budget 切成 M 个微批,在半双工链路上 M=3、全双工链路上 M=4。稳态下瓶颈阶段背靠背处理全部 M 个微批,非瓶颈阶段只承担一次性的管道填充/排空开销 s_i/L。最终端到端延迟 t_pipe = M·s_max + Σ(s_i/L)。**第一项是瓶颈资源决定的稳态吞吐,第二项是管道气泡。**这一公式让 AIC++ 能在 prefill 和 decode 两阶段都精确推理计算–通信代价。
|
||||||
|
|
||||||
|
值得强调的是,这个闭式模型的价值不在于「算出一个数字」,而在于它把 AFD 的吞吐上限**显式地绑定到了瓶颈资源的稳态速率**。换言之,只要你能定位到瓶颈是 Attention 计算、FFN 计算、还是 A2F/F2A 通信,就能直接知道该往哪一侧加 GPU、加多少,而不是靠拍脑袋调比例。这也是 AIC++ 与单纯「跑一遍搜索」最本质的区别:它把经验性的部署决策,变成了可解释、可外推的模型驱动决策。
|
||||||
|
|
||||||
|
## 五、位置感知 GPU 放置:把最频繁的通信绑到最快的链路
|
||||||
|
|
||||||
|
AFD 与 P/D 分离叠加后,会同时存在两种不同粒度的通信:① 每层都发生的 MoE Dispatch/Combine(O(层) 每请求),频率高、随层数线性增长;② 每个请求只发生一次的 KV 缓存传输(prefill 把 KV 发给 decode)。AIC++ 的策略是**频率驱动**的:把最频繁的层内 A2F/F2A 流量绑定到最高带宽的 scale-up 域(节点内 NVLink),而把较少的 KV 传输推迟到 scale-out 域(节点间 InfiniBand)。
|
||||||
|
|
||||||
|
论文用 2A2F(等价于 EP=4)配置、两个 8-GPU 节点做了对照(Table 2):隔离放置下 KV 传输跨节点走 InfiniBand(25 GB/s),配对放置下 KV 留在 NVLink(450 GB/s),带来 **18× 的 KV 传输加速**。这一结论对任意多级网络层级都成立——始终让最频繁的通信模式占用最快的可用链路。
|
||||||
|
|
||||||
|
## 六、集群级评估:吞吐与交互性,谁说了算?
|
||||||
|
|
||||||
|
论文在 128 张 B200 SXM(TensorRT-LLM 后端)上,对 Qwen3-235B、GPT-OSS-120B、Nemotron3-120B、DeepSeek-V3.2 四款架构,在 Chat/Coding/Agentic Coding 三类负载下做了穷举式设计空间搜索(副本数 2–128 GPU,动态组合 TP/DP/EP 与 A/F GPU 组)。
|
||||||
|
|
||||||
|
两个核心结论(Key Takeaways)非常重要,值得做智算/推理 Infra 的人反复读:
|
||||||
|
|
||||||
|
**结论 1(系统吞吐):聚合部署靠数据并行并发胜出大多数面板。** 用 16 个单节点 8-GPU 副本、通过 EP 持有专家 FFN 的聚合 serving(chunked-prefill),靠把 chunked-prefill 气泡摊到整个副本舰队、并行吞掉很多不相交 token 批次,在大多数面板上吞吐最高。解聚只在「更宽的搜索暴露出非对称副本形状」时才赢——比如「少数大 8-GPU decode worker 喂很多小 2-GPU prefill worker」,或解聚+AFD 下把 Nemotron 的吞吐翻倍。
|
||||||
|
|
||||||
|
**结论 2(用户交互性):AFD 在每个面板上都赢。** AFD 通过按负载和模型定制 Attention/FFN 比例、用 AFD 专属的微批重叠技术榨干计算–通信重叠,始终把延迟做到最低。例如在 DeepSeek-V3.2 上,MLA + 稀疏注意力把 KV 缓存压缩得极狠,使得整个 524K 前缀能塞进 2 张 GPU 的 HBM,于是 2A+126F(2 个 Attention + 126 个 FFN)这种「反直觉」布局反而最优——AFD 把所有显存让给 FFN,只留极少 Attention GPU 跑大并发 decode 批次去匹配 126 卡 FFN 池的速率。
|
||||||
|
|
||||||
|
而在严格 SLO 下(TTFT<50/100/150ms,TPOT≤15ms),Figure 2 显示**只有 AFD 类方案(Agg+AFD、P/D Disagg+AFD)能解锁可行配置,撑起约 4k tokens/s 的系统吞吐;非 AFD 部署直接不可行**(红色叉号)。这正对应 agentic coding 这类长上下文、强 SLO 的真实生产场景。
|
||||||
|
|
||||||
|
### AFD 何时「独赢」吞吐:不是所有面板都该解聚
|
||||||
|
|
||||||
|
很多人会误读结论 1,以为「AFD 输了吞吐」。论文其实给出了非常细的边界。首先,**AFD 自己单独就赢下了一个面板**:在 GPT-OSS-120B 的 chat 负载上,纯 AFD 配置拿下了吞吐前沿的最优;其次,在 Nemotron-3-Super 上,解聚+AFD 的「tiny xPyD 分片」把聚合部署的吞吐直接**翻倍**。这说明「解聚是否划算」高度依赖模型架构与负载组合。
|
||||||
|
|
||||||
|
更微妙的是**注意力切片宽度对架构的强依赖**。Qwen3-235B 这类稠密 GQA 模型,因为注意力本身算得重,需要更宽的注意力片:在 agentic coding 负载下出现 8A+120F 的布局。而 DeepSeek-V3.2 在 524K 前缀下,吞吐最优布局会「翻转」成注意力密集的 96A+32F;一旦 TTFT 预算更紧、瓶颈从状态传播转回计算,布局又回到 FFN 密集切分。这种**随上下文长度和 SLO 预算来回翻转的最优 A/F 比**,恰好证明了「固定比例部署」的脆弱,也印证了 AIC++ 这种建模驱动方法的必要性——人工拍出的比例,几乎不可能覆盖这种翻转。
|
||||||
|
|
||||||
|
## 七、长上下文案例:AFD 是唯一可行解
|
||||||
|
|
||||||
|
论文还专门做了长上下文压力测试(ISL=500K+OSL=10K,以及 prefix=1M+ISL=4K+OSL=500),在 B200 上用 AFD + 4 阶段微批(M=4)。结果令人印象深刻:
|
||||||
|
|
||||||
|
- **大 prefill 场景(ISL=500K)**:Agg+AFD M4 在 64 GPU 达 1346.5 tok/s、128 GPU 达 2693.0 tok/s,最优布局是 [28A+4F](Attention/FFN 比 7:1)。
|
||||||
|
- **大前缀场景(prefix=1M)**:非 AFD 模式直接不可行——因为每 GPU 显存需求 M_shared = W+A+K+N+O ≈ 298 GiB,超过 B200 的 180 GiB 上限。AFD 把权重和激活拆分到 Attention/FFN 两组,把有效每 GPU 需求降到 M_AFD = max(M_attn, M_ffn) ≈ 165 GiB,刚好塞进显存。Disagg+AFD M4 在 128 GPU 达 1858.9 tok/s(略胜 Agg+AFD 的 1843.0)。
|
||||||
|
|
||||||
|
这个数字揭示了一个常被忽视的事实:**AFD 的内存切分收益,本质上是在「把权重/激活从 Attention GPU 上挪走、给 KV 缓存腾地方」**。在 1M 前缀这种单 GPU 显存根本装不下模型+激活+KV 的场景里,AFD 不是「更快」,而是「能跑」。
|
||||||
|
|
||||||
|
## 八、生产落地与行业趋势:AFD 已经从论文走进系统
|
||||||
|
|
||||||
|
这篇论文不是空中楼阁,它点名的几个方向已经或正在成为真实系统:
|
||||||
|
|
||||||
|
- **vLLM AFD PR #29772**:社区已经在 vLLM 0.16 上实现 MoE 的 A/F 解聚运行时(NCCL P2P 传输、1:1 配对),论文在其基础上重构成 M×N 双部配对、把 MoE router 移到 Attention 侧、并引入零集合通信的 FusedMoE.forward_pre_routed 入口。
|
||||||
|
- **StepMesh(StepFun, 2025)**:专为 AFD 设计的通信库,采用与论文一致的 M×N 双部点对点发送/接收模式。
|
||||||
|
- **异构片上加速器**:NVIDIA Groq 3 LPX、Rubin CPX、Intel SambaNova 这类「节点内异构计算单元」的出现,正是 AFD 成为有效策略的硬件土壤——高带宽 scale-up 互联让访存密集的 Attention 跑在内存富余的设备上,计算密集的 FFN 跑在算术吞吐高的加速器上。
|
||||||
|
|
||||||
|
论文也诚实给出了 AFD 的代价:每个 AFD 副本消耗更多 GPU,因此在「纯吞吐」维度,聚合部署在大多数面板上仍占优;AFD 的最大价值在**延迟敏感点**和**超出单 GPU 显存上限的长上下文区间**。这与「解聚不是银弹,而是要按负载画像决策」的工程常识一致。
|
||||||
|
|
||||||
|
### 对国产 AI 芯片与智算中心的启示
|
||||||
|
|
||||||
|
把视线拉回国内的智算建设,AFD 的启示格外现实。昇腾(Ascend)、沐曦(MetaX)、寒武纪、壁仞、昆仑芯等国产 AI 芯片,普遍在节点内提供高带宽的 scale-up 互联(如昇腾的 HCCS、昆仑芯的 XPU-Link),而跨节点走以太网或定制高速网。这与 AFD「层内高频通信绑节点内、低频 KV 走跨节点」的放置原则**高度契合**——国产芯片的异构互联拓扑,反而可能是 AFD 落地的一块好土壤。
|
||||||
|
|
||||||
|
更关键的是,国产大模型(如 DeepSeek 系列、Qwen 系列)几乎都是 MoE 架构,Attention 与 FFN 的异构性完全适用 AFD 的建模框架。对智算中心运营方而言,与其一味追求「单卡算力峰值」,不如按**负载画像做 rate-matching**:对长上下文、强 SLO 的推理业务,把 Attention 片与 FFN 片按 AIC++ 式建模动态配比,往往比堆更多同构副本更省卡、时延更低。
|
||||||
|
|
||||||
|
## 九、给我们的启示:推理 Infra 正在从「粗粒度放置」走向「算子级解聚」
|
||||||
|
|
||||||
|
对做智算中心和推理平台的团队,这篇论文给出几条可直接落地的原则:
|
||||||
|
|
||||||
|
1. **Attention/FFN 比例走 rate-matching**:AFD 只分配「刚好匹配 FFN 输出速率」所需的 Attention GPU。便宜低显存的注意力(MLA+DSA、滑窗 GQA)用小 Attention 片就能喂大 FFN 池(90%+ 集群给 FFN);重注意力或大 KV 则需放大 Attention 片。
|
||||||
|
2. **通信亲和度决定放置**:最频繁发生的层内 A2F/F2A 绑到节点内 NVLink(18× KV 传输收益),低频 KV 传输才走跨节点 InfiniBand。
|
||||||
|
3. **长上下文是 AFD 的确定性战场**:当 prefix 大到单 GPU 装不下时,AFD 的内存切分是唯一可行路径,应优先在此类负载上启用。
|
||||||
|
4. **建模驱动优于拍脑袋**:AIC++ 这类「算子级计算建模 + 网络仿真」框架,才是规模化部署前该有的决策工具,而不是靠经验搜比例。
|
||||||
|
|
||||||
|
### SLO 视角:AFD 的胜负手在「延迟预算」
|
||||||
|
|
||||||
|
把 Figure 2 的 SLO 结果拆开看,会发现一个朴素但常被忽略的道理:AFD 的优势是**带约束的优势**。论文把 TTFT 上限设成 50/100/150 ms 三档,TPOT 上限统一 15 ms。在「无 SLO、纯求吞吐」的目标下,聚合部署往往更能打;可一旦加上硬约束,聚合部署的大量面板直接变成红色叉号——搜索器根本找不到满足 SLO 的部署配置。所以对智算中心的启示是——**先定 SLO,再谈解聚**。如果你的业务对首字延迟和逐字间隔不敏感(比如离线批量摘要),聚合部署可能更省卡;但只要涉及实时对话、agentic 工具调用这类强 SLO 场景,AFD 就是绕不开的底座。
|
||||||
|
|
||||||
|
### 两个常见误区
|
||||||
|
|
||||||
|
误区一:「解聚层级越多越好」。论文明确给出反例——AFD 每个副本消耗更多 GPU,在纯吞吐面板上聚合常胜。解聚是**按负载画像做的权衡**,不是越细越优。误区二:「AFD 只能靠论文里的 AIC++ 才能用」。事实恰恰相反,vLLM PR #29772 已经把 MoE 的 A/F 解聚跑通,StepMesh 提供了通信库,意味着普通团队**不必从零造轮子**,只需要在现有运行时上把比例配好、把放置绑对链路即可上手。
|
||||||
|
|
||||||
|
## 十、小结与延伸阅读
|
||||||
|
|
||||||
|
AFD 代表了大模型推理解聚的第三级跳:从 chunked-prefill,到 P/D 分离,再到把 Attention 和 FFN 也拆开。它不会在所有场景都赢(纯吞吐仍常被聚合部署压制),但在**严格延迟 SLO**和**超长上下文**这两个越来越主流的战场上,AFD 已是不可替代的底座。随着 Groq 3 LPX、Rubin CPX、SambaNova 这类异构片上加速器的普及,算子级解聚会从论文走向默认的部署原语。
|
||||||
|
|
||||||
|
延伸阅读:PD 分离开山作 DistServe(arXiv:2401.09670)、Splitwise(arXiv:2311.18677);MoE 解聚 MegaScale-Infer(arXiv:2504.02263);vLLM AFD 实现 PR #29772;以及本工作的配套建模工具 AIConfigurator(arXiv:2601.06288)与网络仿真 AstraSim。同期值得关注的还有 ICML 2026 的《Theoretically Optimal Attention/FFN Ratios in Disaggregated LLM Serving》(arXiv:2601.21351),它从概率负载模型推导出最优 A/F 比的闭式解,与本文的实证结论相互印证。
|
||||||
|
|
||||||
|
> 本文由 arXiv 论文自动解读系统生成,基于 arXiv:2605.28302《How Far Can Disaggregation Go? A Design-Space Exploration of Attention–FFN Disaggregation for Efficient MoE LLM Serving》(Hanjiang Wu 等,Georgia Tech + Intel + Google + Google DeepMind,2026-05)。内容为对原论文的深度技术解读与工程点评,所有数据均引自原论文图表与正文。AI 辅助创作,转载请注明出处。
|
||||||
@@ -0,0 +1,85 @@
|
|||||||
|
# 📊 文章摘要:当 PD 分离成为标配,推理的未来在 AFD
|
||||||
|
|
||||||
|
> **原文**:[2026-08-05_当PD分离成为标配_推理的未来在AFD.md](./2026-08-05_当PD分离成为标配_推理的未来在AFD.md)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/5YsLOl4oIfHzNdi8pbmURQ
|
||||||
|
> **来源**:微信公众平台(小哥人工智能笔记)
|
||||||
|
> **作者**:小哥人工智能笔记
|
||||||
|
> **发布日期**:2026-08-05(原文未标注明确日期,按下载日占位;解读论文 arXiv:2605.28302 为 2026-05)
|
||||||
|
> **摘要日期**:2026-08-06
|
||||||
|
> **价值评级**:⭐⭐⭐ 高
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 核心命题
|
||||||
|
|
||||||
|
> **算子级解聚** — 指出推理解聚的下一级是 AFD(Attention–FFN 解聚),并用 AIC++ 建模框架证明"解聚到哪一层、A/F 各配多少 GPU"应由模型驱动计算而非拍脑袋——这是本批文章中最具前瞻性的认知增量。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 文章概要
|
||||||
|
|
||||||
|
本文解读 Georgia Tech + Intel + Google 等联合论文《How Far Can Disaggregation Go?》(arXiv:2605.28302),提出推理解聚"三级跳"演进:chunked-prefill → PD 分离 → 算子级 AFD(把 Attention 与 FFN 拆到不同 GPU 组)。论文以 AIC++ 协同设计框架(算子级计算建模 + AstraSim 网络仿真)在 128 卡 B200 上对四类 MoE 架构穷举搜索,核心结论:纯吞吐场景聚合部署常胜,但严格 SLO 下只有 AFD 可行(约 4k tokens/s),1M 前缀长上下文场景非 AFD 不可行(每 GPU 需求 298 GiB 超 B200 的 180 GiB,AFD 切分后降至 165 GiB)。价值在于把 PD 分离置于更大的演进脉络,并给出 rate-matching、位置感知放置、建模驱动等可落地原则;局限是数据全部来自论文仿真与原型,AFD 生产系统(vLLM PR)尚在早期。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 关键要点
|
||||||
|
|
||||||
|
1. **解聚三级跳框架** — chunked-prefill(切块减气泡)→ P/D 分离(算力 vs 带宽错配)→ A/F 解聚(块内访存 vs 计算错配);AFD 是"叠在 PD 之上的下一级解聚"而非替代者。 `[分类: 范式突破]`
|
||||||
|
2. **块内异构的量化证据** — 稠密 GQA 模型长上下文下 Attention 运行时占比从 4K 的 41%/59% 飙到 0.5M 的 87%/96%;Attention/FFN 占比随上下文单调上升且不同架构斜率不同,故 A/F 配比"没有统一答案"。 `[分类: 共识]`
|
||||||
|
3. **AIC++ 建模框架** — 融合 AIConfigurator 算子级计算建模与 AstraSim 包粒度网络仿真,把"A 配几个 GPU、F 配几个 GPU"变成可求解的设计空间问题;四阶段微批重叠给出闭式解 t_pipe = M·s_max + Σ(s_i/L),把吞吐上限显式绑定到瓶颈资源的稳态速率——这是"建模驱动替代拍脑袋"的方法论核心。 `[分类: 范式突破]`
|
||||||
|
4. **位置感知 GPU 放置** — 频率驱动:高频层内 A2F/F2A 流量绑节点内 NVLink,低频 KV 传输走跨节点 InfiniBand;对照实验显示该放置带来 18× 的 KV 传输加速(25 GB/s → 450 GB/s)。 `[分类: 共识]`
|
||||||
|
5. **"AFD 不是银弹"的边界** — 128 卡穷举搜索显示:纯吞吐下聚合部署(chunked-prefill + EP)在大多数面板胜出,解聚仅在更宽搜索暴露非对称副本形状时才赢;AFD 每个副本消耗更多 GPU。 `[分类: 共识]`
|
||||||
|
6. **AFD 的两个确定性战场** — 严格 SLO(TTFT≤150ms/TPOT≤15ms)下只有 AFD 类方案可行(约 4k tokens/s,非 AFD 全红叉);1M 前缀场景非 AFD 直接不可行——AFD 的内存切分本质是"把权重/激活从 Attention GPU 挪走给 KV 腾地方",此处它不是"更快"而是"能跑"。 `[分类: 共识]`
|
||||||
|
7. **反直觉最优布局与 A/F 翻转** — DeepSeek-V3.2 的 MLA+稀疏注意力把 524K 前缀塞进 2 卡 HBM 后,2A+126F 布局反成最优;同模型吞吐最优布局会随上下文与 TTFT 预算在 96A+32F 与 FFN 密集间来回翻转——印证固定比例部署的脆弱。 `[分类: 未探索]`
|
||||||
|
8. **国产芯片的落地土壤** — 昇腾 HCCS、昆仑芯 XPU-Link 等节点内高带宽互联与"层内高频绑节点内"放置原则高度契合;国产 MoE 大模型(DeepSeek/Qwen 系列)完全适用 AFD 建模框架,但国产芯片上的 AFD 实测仍是空白。 `[分类: 未探索]`
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 批判性分析
|
||||||
|
|
||||||
|
### 假设前提
|
||||||
|
|
||||||
|
立论建立在四个前提上:MoE 是主流大模型架构(结论对稠密模型适用性弱);数据中心存在 scale-up/scale-out 两级网络拓扑且节点内带宽显著高于跨节点;用户有可量化的 SLO 预算("先定 SLO,再谈解聚");AIC++ 的算子级计算建模数据库(基于 NVIDIA AIConfigurator 实测)对目标集群成立。
|
||||||
|
|
||||||
|
### 论据与逻辑
|
||||||
|
|
||||||
|
证据链在同类文章中属于上乘:128 卡 B200、四类架构(Qwen3-235B/GPT-OSS-120B/Nemotron3-120B/DeepSeek-V3.2)、三类负载穷举式设计空间搜索,结论 1(吞吐)与结论 2(交互性)分开表述且各自给出反例(AFD 单独赢下 GPT-OSS chat 面板、Nemotron 吞吐翻倍),边界刻画诚实。但全部数据来自仿真(AstraSim)与定制 vLLM 原型,缺乏大规模生产实机验证;闭式模型的价值论述充分,其精度边界(仿真与实机的偏差)未量化。
|
||||||
|
|
||||||
|
### 边界与局限
|
||||||
|
|
||||||
|
作者明确给出适用边界:纯吞吐、无 SLO 场景聚合部署常胜,解聚不是越细越优;结论针对 MoE 模型,对稠密 GQA 模型(如 Qwen3-235B)需更宽 Attention 片,配比决策更复杂;1M 前缀结论基于 B200 的 180 GiB 显存上限,随显存增长该"唯一可行"优势会收窄;生产落地(vLLM PR #29772、StepMesh)仍在早期,A/F 双部配对、MoE router 迁移等实现细节的稳定性与生态成熟度未经检验。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 可引用金句
|
||||||
|
|
||||||
|
> "AFD 的价值不只是「更快」,更是在特定战场上「能不能跑」。"
|
||||||
|
|
||||||
|
> "在 1M 前缀这种单 GPU 显存根本装不下模型+激活+KV 的场景里,AFD 不是「更快」,而是「能跑」。"
|
||||||
|
|
||||||
|
> "先定 SLO,再谈解聚。"
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 总体评价
|
||||||
|
|
||||||
|
**亮点**:
|
||||||
|
- "解聚三级跳"框架清晰,把本批 PD 分离文章(DistServe 等)自然纳入更大演进脉络
|
||||||
|
- AIC++ 建模驱动方法论是真正的方法论增量:把经验性部署决策变成可解释、可外推的模型驱动决策
|
||||||
|
- 边界意识出色:明确"解聚不是银弹"、给出纯吞吐反例、指出固定 A/F 比例的脆弱
|
||||||
|
- 对国产芯片与智算中心的落地启示(rate-matching、放置原则)具有现实针对性
|
||||||
|
|
||||||
|
**不足**:
|
||||||
|
- 全部结论依赖论文仿真与原型,实机验证不足,关键数字(4k tokens/s、18×)应视为仿真估计
|
||||||
|
- 对 AIC++ 建模精度、仿真与实机偏差未作讨论
|
||||||
|
- 文章为 AI 解读系统生成,部分表述偏综述腔,深挖需回溯原论文
|
||||||
|
|
||||||
|
**适用场景**:智算中心与推理 Infra 团队做中长期技术规划(了解 PD 分离之后的演进方向);关心 MoE 模型规模化部署的架构师;长上下文(500K-1M)业务场景的方案选型参考。
|
||||||
|
|
||||||
|
**关联建议**:回溯原论文 arXiv:2605.28302 及其配套工具 AIConfigurator(arXiv:2601.06288)与 AstraSim;本批 PD 分离文章构成其前置知识(DistServe 的动机、marcus 的 vLLM 机制、丁师兄的落地代价);延伸阅读 Splitwise(arXiv:2311.18677)、MegaScale-Infer(arXiv:2504.02263)、vLLM AFD PR #29772 与 StepMesh,以及 ICML 2026《Theoretically Optimal Attention/FFN Ratios in Disaggregated LLM Serving》(arXiv:2601.21351)的最优 A/F 比闭式解。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 配图
|
||||||
|
|
||||||
|

|
||||||
@@ -0,0 +1,50 @@
|
|||||||
|
# AI无法替代大学,他向年轻人发出时代之问
|
||||||
|
|
||||||
|
> **来源**:微信公众平台
|
||||||
|
> **作者**:广东发布
|
||||||
|
> **发布日期**:2026-07-30(据新浪财经转载日期标注,原发日期未能从原文获取)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/Z4i8gqE__nIaV8hOqB4qlA
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
《思想耀岭南》
|
||||||
|
|
||||||
|
第六集对话嘉宾是
|
||||||
|
|
||||||
|
中国科学院院士、南方科技大学校长
|
||||||
|
|
||||||
|
薛其坤
|
||||||
|
|
||||||
|
|
||||||
|
|
||||||
|
在山东沂蒙山区出生长大,到济南求学,到北京深造,再到出国、回国,直至2020年南下深圳——薛其坤的人生轨迹,恰好叠合了一个国家飞奔的四十多年。
|
||||||
|
|
||||||
|
作为全球顶尖科学家,今年4月,薛其坤团队实现常压镍基高温超导重大突破,站上全球量子科技竞赛的制高点。"我是这个时代的幸运儿。"他说,当下我国高等教育与科技创新正处于过去200多年来最好的时期。
|
||||||
|
|
||||||
|
"深圳—香港—广州"创新集群跃居世界第一,展现粤港澳大湾区澎湃的创新势能。由南方科技大学牵头搭建的粤港澳大湾区量子科学中心,正统筹深港穗三地科研资源,创新教育科技人才一体化机制,凝聚力量联合攻关。薛其坤笃定,粤港澳大湾区成为世界创新中心是不可阻挡的潮流。
|
||||||
|
|
||||||
|
作为南方科技大学的掌舵人,他明确"明德求是,日新自强"的校训,打造特色育人体系:推行"631"综合评价招生,精准发掘创新潜质人才;实行全书院制,新生不分专业,预留一年时间探索兴趣、找准发展方向。
|
||||||
|
|
||||||
|
面对席卷而来的人工智能浪潮,大学教育仍是不可替代的。
|
||||||
|
|
||||||
|
他向当代青年发出时代之问:中国能不能成为世界科学中心?他期盼新一代青年沉心深耕,历经十载乃至数十载潜心钻研,将"冷板凳坐热",扛起中国建设世界科学中心的时代重任,抓住大湾区与国家科创发展的重大机遇。
|
||||||
|
|
||||||
|
**薛其坤的科研与育人之路,是我国基础研究突围、高等教育革新、大湾区科创崛起的缩影。**8月1日,聆听薛其坤的时代之问。
|
||||||
|
|
||||||
|
___News___
|
||||||
|
|
||||||
|
__大家都在看__
|
||||||
|
|
||||||
|
广州"卖旧买新"补贴正式发放|早安广东
|
||||||
|
|
||||||
|
暑假当然来广东的4个理由
|
||||||
|
|
||||||
|
在广东8天胖8斤的博主,动了长住的念头
|
||||||
|
|
||||||
|
来源|21财经
|
||||||
|
|
||||||
|
编辑|蔡泽纯
|
||||||
|
|
||||||
|
校对|曹柏英
|
||||||
|
|
||||||
|
__关注~__
|
||||||
@@ -0,0 +1,61 @@
|
|||||||
|
# 📊 文章摘要:AI无法替代大学,他向年轻人发出时代之问
|
||||||
|
|
||||||
|
> **原文**:[2026-07-30_AI无法替代大学_他向年轻人发出时代之问](./2026-07-30_AI无法替代大学_他向年轻人发出时代之问.md)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/Z4i8gqE__nIaV8hOqB4qlA
|
||||||
|
> **来源**:微信公众平台
|
||||||
|
> **作者**:广东发布
|
||||||
|
> **发布日期**:2026-07-30(据新浪财经转载日期标注)
|
||||||
|
> **摘要日期**:2026-08-27
|
||||||
|
> **价值评级**:⭐ 低
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 核心命题
|
||||||
|
|
||||||
|
> **大学不可替代** — 面对AI浪潮,大学教育仍是不可替代的;薛其坤向青年发出时代之问:中国能不能成为世界科学中心。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 文章概要
|
||||||
|
|
||||||
|
《思想耀岭南》第六集(8月1日播出)的节目预告,介绍中国科学院院士、南方科技大学校长薛其坤的科研与育人经历:常压镍基高温超导突破、"深圳—香港—广州"创新集群世界第一、南科大"631"招生与全书院制,以及对青年的期许——沉心深耕、把冷板凳坐热。核心观点仅一句(AI 浪潮下大学教育不可替代),无论证展开。属资讯预告类内容,认知增量有限,作为"AI 与教育"话题的权威态度记录保留。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 关键要点
|
||||||
|
|
||||||
|
1. **AI 浪潮下大学教育不可替代** — 原文仅提出断言,未展开论证(节目正片或有展开,本文为预告)。 `[分类: 共识]`
|
||||||
|
2. **时代之问** — 中国能不能成为世界科学中心;期许青年历经十载乃至数十载潜心钻研、把冷板凳坐热。 `[分类: 共识]`
|
||||||
|
3. **大湾区创新势能** — "深圳—香港—广州"集群世界第一,薛其坤认为大湾区成为世界创新中心是不可阻挡的潮流。 `[分类: 共识]`
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 批判性分析
|
||||||
|
|
||||||
|
### 假设前提
|
||||||
|
|
||||||
|
作为节目预告,本文是对正片的引子;"AI 无法替代大学"是受访者的立场表达,论证在正片中。
|
||||||
|
|
||||||
|
### 论据与局限
|
||||||
|
|
||||||
|
无论证过程,人物履历陈述可与公开事实互证。低价值文章,精简分析,不单独生成配图(在索引中归属人机组共享配图)。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 可引用金句
|
||||||
|
|
||||||
|
> "面对席卷而来的人工智能浪潮,大学教育仍是不可替代的。"
|
||||||
|
|
||||||
|
> "中国能不能成为世界科学中心?"
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 总体评价
|
||||||
|
|
||||||
|
**亮点**:权威科学家对"AI 与大学价值"议题的明确表态,有人物与政策语境。
|
||||||
|
|
||||||
|
**不足**:预告体裁,核心观点无论证;篇幅极短。
|
||||||
|
|
||||||
|
**适用场景**:AI 与高等教育议题的立场引语素材。
|
||||||
|
|
||||||
|
**关联建议**:与同批《用AI最猛的一批人已经不睡觉了》形成张力——一边是"十载冷板凳"的长期主义,一边是"停不下来"的加速主义,恰是 AI 时代两种时间观的对照。
|
||||||
@@ -0,0 +1,72 @@
|
|||||||
|
# 人工智能时代数智化生存的哲学省思
|
||||||
|
|
||||||
|
> **来源**:微信公众平台(张灿)
|
||||||
|
> **作者**:张灿(中国矿业大学马克思主义学院教授)
|
||||||
|
> **发布日期**:2026-08-20(原文未标注明确日期,按下载日占位)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/G0MfY7D4wkXVwZHsok3YRQ
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
|
||||||
|
|
||||||
|
当前,我们正站在人类文明史的关键转折点。人工智能的爆发式演进与深度数智化浪潮,早已超越单纯的技术革新,正从根本上重塑人类的存在根基。从认知世界、理解自我,到建构社会关系、定义生命价值,人类的生存状态正前所未有地被嵌入由数据、算法与智能机器交织而成的精密体系之中。这种被智能技术深度中介乃至结构性重构的生存范式,即为数智化生存。它以空前的效率、联结度与可能性为人类带来巨大福祉,却也悄然开启了"潘多拉魔盒",催生出一系列深刻、复杂且亟待回应的哲学问题。
|
||||||
|
|
||||||
|
**生存空间的数智化与超连接**
|
||||||
|
|
||||||
|
空间既非空洞的物质容器,亦非抽象的理性范畴,而是承载社会属性、价值导向与政治意涵的实践场域。步入人工智能时代,数智空间持续迭代,呈现出自动化、超连接、平台性、界面性四大核心特征。
|
||||||
|
|
||||||
|
自动化是数智空间的基础特质。数智技术驱动社会治理、生产与生活方式实现全流程数智化转型,塑造出自动化生存形态。世间万物被编码、标记、扫描与精准定位,由此,自动化技术体系已内化为现代社会与日常生活的底层逻辑与基础环境。
|
||||||
|
|
||||||
|
超连接是数智空间的核心特征。无论是人机交互还是人际交流,人们之间不再局限于普通连接,而是走向超连接:始终保持在线状态,能够在移动场景下于虚实世界之间无缝漫游。简言之,这是一种嵌入日常生活、泛在且趋于隐形的数智化生存方式,深刻重塑着人们的身份认同与社会交往模式。
|
||||||
|
|
||||||
|
平台性成为数智空间的主导组织形态。具体而言,数字平台并非单纯的技术系统,而是融合软硬件、运行规则与社会关系的技术—社会复合体。其将人的日常行为标准化、数据化,为各类数智运算与社会决策提供基础素材,进而实现对社会关系、信息流动与资源分配的深度重构。
|
||||||
|
|
||||||
|
界面性赋予数智空间具身实践属性。界面构成人与智能系统、物理现实与虚拟场域交互的中介边界,成为通往数智世界的核心载体,构成结构化、可预期的操作体系。界面的本质不在于视觉图形和抽象中立的信息通道,而在于其持续召唤身体参与的具身交互实践。人与界面的具身互动是数智化生存的实现方式,使个体体验既保有鲜活可感的真实感,又带领主体抵达全新的存在境界。
|
||||||
|
|
||||||
|
**生存时间的数智化与加速**
|
||||||
|
|
||||||
|
时间具有绵延流变、难以把握的特质,兼具客观秩序与主观体验双重属性。数智技术深刻重塑了人类的生存时间性,令个体陷入时间压缩与碎片化困境,使人与自我、他者、世界之间的关系走向异化,难以建立深度共鸣。
|
||||||
|
|
||||||
|
第一,数智技术助推社会加速,逐渐消融工作与生活、劳动与休闲的时间边界,造成个体普遍的时间匮乏感。个体对时间的自主掌控权正持续弱化,时间节奏日益被外部系统支配与规训。AI对实时处理、即时反馈的极致追求,使实时性成为主导性时间范式,不断挤压反思、延迟与等待的存在空间,进而催生当下的暴政——人被牢牢困在瞬时信息流中,失去慢下来、沉下去的可能。
|
||||||
|
|
||||||
|
第二,数智技术催生以直播、永久在线为表征的全新时间形态,持续重塑人类存在的时间逻辑。换言之,它进一步凸显并延展了曼纽尔·卡斯特(Manuel Castells)提出的"无时间之时间"范式。依托同步共在与即时通信机制,文本、图像与视频不断流动、切换,最终消解了统合过去、现在与未来的时间所固有的历史深度。
|
||||||
|
|
||||||
|
第三,数智技术正深度重塑我们认知过往、筹划未来的思维方式。从本质上来看,数智技术把过往与未来化作可调配、可利用的现实资源,突破时间维度的局限,搭建并塑造全新的时空形态。一方面,数智技术催生了"当下未来"的现实状态,依托过往积淀与现实发展趋势,孕育尚未成型、亟待实践创造的未来;另一方面,数智技术造就了"未来当下"的生活模式,将未来的多元可能性融入当下,以预判的发展结果审视当下行为,进而反向调整、重塑未来的发展走向。
|
||||||
|
|
||||||
|
**数智记忆的媒介化与无意识性**
|
||||||
|
|
||||||
|
数智技术与社交媒体一方面为个体留存、梳理与回溯记忆构筑起媒介载体,另一方面重塑了记忆的生成机制及价值内涵。简单来说,数智技术从根本上改变了个人与群体的记忆逻辑,包括如何记忆、记忆什么以及记忆背后的初衷与意义。
|
||||||
|
|
||||||
|
第一,记忆实践展现为记忆的技术量化。在指标量化的统摄之下,记忆实践沦为一场依托数据展开的竞争,记忆自带的私密性与情感厚度由此遭受系统性侵蚀。一方面,数智记忆根据平台展示的点赞、转发和评论等对记忆内容进行排序和可见性分配,将具有情感性、历史厚度和社会关联的记忆体验压缩为一种单一可比的数据关系;另一方面,数智记忆的量化机制又披上了客观性的外衣,将记忆体验中不可通约的意义进行简化和有倾向性的排除。
|
||||||
|
|
||||||
|
第二,"记忆什么"表现为一种感官刺激。信息过载加剧了注意力资源的争夺,而平台算法以用户停留时长、互动频率等指标筛选内容,因此,能够快速抓取注意力的记忆碎片被优先推送与扩散;反之,需要深度沉浸、理性思辨的复杂叙事则日趋边缘化。由此,数智时代的记忆图谱呈现出显著的碎片化与快消化特征。记忆的价值评判标准发生根本性转向,评判核心不再是历史真实性与情感深度,而是感官刺激强度、传播热度与流量转化效率。
|
||||||
|
|
||||||
|
第三,"为何记忆"表现为一种技术无意识性。技术无意识表明,技术能够对人类意识与思维方式进行隐性塑造,使人们逐渐将技术构建的生存环境视作唯一合理的存在形态。在数智化生存语境下,软件、算法、大语言模型等智能体主导着日常生活的价值体系和行为模式,形成一套隐性的控制体系。
|
||||||
|
|
||||||
|
**生存主体的数智化与流变**
|
||||||
|
|
||||||
|
在人工智能时代,个体的网络浏览、虚拟社交、位置信息、人脸识别、人机交互等数据汇聚形成虚拟画像,以此建构出全新的数智主体。数智主体并非单纯经由数智媒介中介化形成的主体,而是依托数据、算法模型与计算生成的主体。
|
||||||
|
|
||||||
|
首先,数智主体建构了新型数字身份。简而言之,我们不仅持续生成数据,更被数据建构,并经由数据被算法解读、赋予标签化意义。在此过程中,数据不仅能够解释主体,而且能够规范主体,决定谁能够被看见以及在多大程度上被看见。
|
||||||
|
|
||||||
|
其次,数智技术推动了个体存在方式的深层转型。一方面,数智主体关乎主体化过程,即数智主体开展自我激励与自主优化;另一方面,数智主体关乎社会认同建构,它通过公开展演自我,获取社交反馈,进而完成自我建构的强化。换言之,数智主体不仅是主体性生产的产物,更是一项兼具自我关怀与自我治理的技术实践。
|
||||||
|
|
||||||
|
再次,数智空间看似赋予主体挣脱肉身桎梏的自由,令个体能够在虚拟维度建构自我,但与此同时,自拍、社交、形象展演等日常实践也不断推动数智自我走向商品化与美学化,使之成为兼具生产性与消费性的双重客体。在平台经济逻辑下,数智自我有着沦为资本挖掘数据价值的文化制品的风险,个体也会在无意识中陷入自我物化与价值剥削的共谋结构。
|
||||||
|
|
||||||
|
最后,数智主体是可变、未完成、始终处在生成过程中的动态行动者。它既非纯粹的人工人格,也不只是浅层的数智表征与影像,而是依托人类与智能体的交互,在数智空间内不断演化生成。数智主体外在于经验自我,却又反向塑造与规训着自我。其内嵌权力机制、主体化逻辑与自动化治理框架,已然成为人工智能时代理解主体性、技术与权力关系的核心命题。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
本文系国家社科基金后期资助项目"人工智能时代数字化生存的伦理风险研究"(25FZXB045)阶段性成果
|
||||||
|
|
||||||
|
作者系中国矿业大学马克思主义学院教授
|
||||||
|
|
||||||
|
来源:中国社会科学报
|
||||||
|
|
||||||
|
责任编辑:常达
|
||||||
|
|
||||||
|
新媒体编辑:张雨楠
|
||||||
|
|
||||||
|
如需交流可联系我们
|
||||||
|
|
||||||
|
邮箱账号:skwgzh2023@163.com
|
||||||
@@ -0,0 +1,70 @@
|
|||||||
|
# 📊 文章摘要:人工智能时代数智化生存的哲学省思
|
||||||
|
|
||||||
|
> **原文**:[2026-08-20_人工智能时代数智化生存的哲学省思.md](./2026-08-20_人工智能时代数智化生存的哲学省思.md)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/G0MfY7D4wkXVwZHsok3YRQ
|
||||||
|
> **来源**:微信公众平台
|
||||||
|
> **作者**:张灿(中国矿业大学马克思主义学院教授,原载中国社会科学报)
|
||||||
|
> **发布日期**:2026-08-20
|
||||||
|
> **摘要日期**:2026-08-20
|
||||||
|
> **价值评级**:⭐ 低
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 核心命题
|
||||||
|
|
||||||
|
> **数智化生存** — 人的生存正被数据、算法与智能机器深度中介乃至结构性重构,需从空间、时间、记忆、主体四个维度对这一新生存范式做哲学审思。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 文章概要
|
||||||
|
|
||||||
|
本文是国家社科基金后期资助项目阶段性成果的哲学科普文章,从四个维度系统描述 AI 时代的"数智化生存":数智空间的自动化、超连接、平台性、界面性四特征;数智技术造成的时间加速、时间匮乏与"当下的暴政";数智记忆的技术量化、感官刺激筛选与技术无意识性;以及"数智主体"被数据建构、自我商品化的命运。其价值在于为非哲学读者提供了一套成体系的批判性概念框架(尤其"当下未来/未来当下""技术无意识"等提法可用于 AI 伦理与社会影响讨论);局限是纯思辨综述,无经验研究支撑,只诊断不开方。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 关键要点
|
||||||
|
|
||||||
|
1. **数智化生存的定义** — "被智能技术深度中介乃至结构性重构的生存范式",被界定为超越单纯技术革新的存在方式变革。 `[分类: 共识]`(国内学界主流话语)
|
||||||
|
2. **数智空间四特征** — 自动化(底层逻辑与环境)、超连接(泛在且趋于隐形)、平台性(技术—社会复合体,重构资源分配)、界面性(具身交互实践而非中立信息通道)。 `[分类: 共识]`
|
||||||
|
3. **当下的暴政** — AI 对实时处理、即时反馈的极致追求使实时性成为主导时间范式,挤压反思、延迟与等待,人被"牢牢困在瞬时信息流中"。 `[分类: 共识]`
|
||||||
|
4. **"当下未来"与"未来当下"** — 数智技术把过往与未来化作可调配的现实资源:孕育尚未成型的未来(当下未来),并以预判结果反向审视当下行为(未来当下)。 `[分类: 争议]`(作者的综合提法,无实证)
|
||||||
|
5. **数智记忆三问** — 如何记忆(技术量化侵蚀私密性与情感厚度)、记忆什么(感官刺激与流量优先,复杂叙事边缘化)、为何记忆(技术无意识形成隐性控制体系)。 `[分类: 共识]`
|
||||||
|
6. **数智主体的建构与物化** — "我们不仅持续生成数据,更被数据建构";数智自我在平台经济逻辑下有沦为资本数据制品的风险,个体陷入自我物化与价值剥削的共谋结构。 `[分类: 共识]`(批判理论传统)
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 批判性分析
|
||||||
|
|
||||||
|
### 假设前提
|
||||||
|
- 预设技术对人的塑造是单向的结构性力量,人的能动空间被压缩为"共谋",缺乏对抵抗、退出与差异化实践的讨论。
|
||||||
|
- 预设平台逻辑高度同质化,未考虑不同社会语境下数智化生存的分化。
|
||||||
|
|
||||||
|
### 论据与逻辑
|
||||||
|
- 全文为思辨演绎,以"第一、第二、第三"断言式列举推进,无经验数据或案例支撑;理论渊源(卡斯特"无时间之时间"、技术无意识等)仅点到即止。
|
||||||
|
|
||||||
|
### 边界与局限
|
||||||
|
- 只诊断不开方,全文未给出任何应对路径;无技术细节,对 AI 从业者的直接可操作性低。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 可引用金句
|
||||||
|
|
||||||
|
> "我们不仅持续生成数据,更被数据建构,并经由数据被算法解读、赋予标签化意义。"
|
||||||
|
|
||||||
|
> "数据不仅能够解释主体,而且能够规范主体,决定谁能够被看见以及在多大程度上被看见。"
|
||||||
|
|
||||||
|
> "记忆的价值评判标准发生根本性转向,评判核心不再是历史真实性与情感深度,而是感官刺激强度、传播热度与流量转化效率。"
|
||||||
|
|
||||||
|
> "人被牢牢困在瞬时信息流中,失去慢下来、沉下去的可能。"
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 总体评价
|
||||||
|
|
||||||
|
**亮点**:四维度(空间/时间/记忆/主体)框架完整,"当下的暴政""技术无意识""数智主体"等概念可作为 AI 社会影响讨论的现成语汇,行文规范、来源清晰(中国社会科学报、社科基金成果)。
|
||||||
|
|
||||||
|
**不足**:纯综述思辨,无一手研究;断言多论证少;无对策建议;与工程实践距离远。
|
||||||
|
|
||||||
|
**适用场景**:AI 伦理与数智社会议题写作的概念工具箱;技术人文类分享的引文来源。
|
||||||
|
|
||||||
|
**关联建议**:与知识库中技术向文章形成"批判视角"互补,无需深入跟踪该作者后续。
|
||||||
@@ -0,0 +1,166 @@
|
|||||||
|
# 技术速递|评估 GitHub Copilot 智能体运行框架在不同模型和任务中的性能与效率
|
||||||
|
|
||||||
|
> **来源**:微信公众平台(微软Reactor)
|
||||||
|
> **作者**:Shibani Basava & Carlos Castro
|
||||||
|
> **发布日期**:2026-08-20(原文未标注明确日期,按下载日占位)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/TmXrgtT1A70VZfPESKinNQ
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
_作者:Shibani Basava & Carlos Castro_
|
||||||
|
|
||||||
|
_排版:Alan Wang_
|
||||||
|
|
||||||
|
深入了解 GitHub Copilot 智能体运行框架如何在多项基准测试中取得出色表现,并实现行业领先的 Token 使用效率,同时保持灵活性,让开发者能够在 20 多种模型之间自由选择。
|
||||||
|
|
||||||
|
|
||||||
|
|
||||||
|
虽然模型提供了底层智能,但真正决定这些智能能否高效发挥作用的,是智能体运行框架。GitHub Copilot 智能体运行框架是 GitHub Copilot SDK 的统一共享组件,为 GitHub Copilot CLI、GitHub Copilot App、Copilot Code Review,以及 GitHub 和微软生态中的众多 AI 开发体验提供支撑。对这一运行框架的任何改进,都将惠及所有基于它构建的产品和功能。
|
||||||
|
|
||||||
|

|
||||||
|
|
||||||
|
_GitHub Copilot 智能体运行框架为 GitHub Copilot 的各项 AI 开发体验提供支撑。_
|
||||||
|
|
||||||
|
工具调用、上下文管理以及工作流编排均由这一运行框架统一协调。一个优秀的智能体运行框架应具备响应迅速、Token 使用高效且行为可预测等特性,而这正是 GitHub Copilot 智能体运行框架的设计目标。
|
||||||
|
|
||||||
|
本文将通过一系列数据,展示 GitHub Copilot 智能体运行框架在各类智能体软件工程任务中的性能表现与运行效率。
|
||||||
|
|
||||||
|
**持续进行的优化**
|
||||||
|
|
||||||
|
为了充分发挥每一个 Token 的价值,我们持续优化上下文管理和模型路由。此外,我们还分享了在任务委派方面的实验与优化成果,以及这些改进如何帮助开发者进一步提升开发效率。
|
||||||
|
|
||||||
|
**GitHub Copilot SDK**
|
||||||
|
|
||||||
|
https://github.com/github/copilot-sdk?utm_source=blog-benchmarking-1&utm_medium=blog&utm_campaign=github-copilot-app-ga-2026/?wt.mc_id=3reg_webpage_reactor
|
||||||
|
|
||||||
|
**GitHub Copilot CLI**
|
||||||
|
|
||||||
|
https://github.com/features/copilot/cli?utm_source=blog-benchmarking-1&utm_medium=blog&utm_campaign=github-copilot-app-ga-2026/?wt.mc_id=3reg_webpage_reactor
|
||||||
|
|
||||||
|
**GitHub Copilot App**
|
||||||
|
|
||||||
|
https://github.com/features/ai/github-app?utm_source=blog-benchmarking-1&utm_medium=blog&utm_campaign=github-copilot-app-ga-2026/?wt.mc_id=3reg_webpage_reactor
|
||||||
|
|
||||||
|
**Copilot Code Review**
|
||||||
|
|
||||||
|
https://docs.github.com/copilot/concepts/agents/code-review?utm_source=blog-benchmarking-1&utm_medium=blog&utm_campaign=github-copilot-app-ga-2026/?wt.mc_id=3reg_webpage_reactor
|
||||||
|
|
||||||
|
**持续优化上下文管理和模型路由**
|
||||||
|
|
||||||
|
https://github.blog/ai-and-ml/github-copilot/getting-more-from-each-token-how-copilot-improves-context-handling-and-model-routing/?wt.mc_id=3reg_webpage_reactor
|
||||||
|
|
||||||
|
**在任务委派方面的实验与优化**
|
||||||
|
|
||||||
|
https://github.blog/ai-and-ml/how-we-made-github-copilot-cli-more-selective-about-delegation/?wt.mc_id=3reg_webpage_reactor
|
||||||
|
|
||||||
|
**我们如何借助基准测试持续迭代**
|
||||||
|
|
||||||
|
我们持续结合公开基准测试和内部自研基准测试,对 GitHub Copilot 智能体运行框架的能力与效率进行评估。公开基准测试采用行业通用标准,而部分内部基准测试则基于 GitHub 和微软的大型代码库构建。此外,我们还结合真实世界指标和在线实验,不仅评估运行框架在受控环境下的表现,也验证其在实际智能体问题求解和任务完成中的效果。
|
||||||
|
|
||||||
|
为了公平比较 GitHub Copilot 智能体运行框架与模型厂商原生运行框架的性能,我们尽可能控制所有变量,包括:
|
||||||
|
|
||||||
|
- 使用**相同的模型**
|
||||||
|
- 使用**相同的基准测试任务**
|
||||||
|
- 统一上下文窗口
|
||||||
|
- 保持一致的推理强度
|
||||||
|
- 使用相同的工具选择
|
||||||
|
- 使用相同的 MCP Server 配置
|
||||||
|
|
||||||
|
下面展示的是我们持续跟踪的部分基准测试在四款主流模型上的最新结果,包括 Claude Sonnet 4.6、Claude Opus 4.7、GPT-5.4 和 GPT-5.5。
|
||||||
|
|
||||||
|
| | | |
|
||||||
|
| --- | --- |
|
||||||
|
| **基准测试** | **测试领域** | **测试目的** |
|
||||||
|
| SWE-bench Verified | 来自开源 Python 仓库的 500 个经过人工验证的 Bug 修复任务 | 业界公认的 Coding Agent 标准基准测试 |
|
||||||
|
| SWE-bench Pro | 更复杂的多步骤软件工程任务,需要更深入的推理和更大范围的代码修改 | 更真实地反映复杂的软件工程场景 |
|
||||||
|
| SkillsBench | 智能体利用技能完成任务的能力 | 评估智能体的可扩展性,以及技能调用和触发能力 |
|
||||||
|
| TerminalBench | 基于终端的开发任务 | 衡量智能体在命令行开发工作流中的表现 |
|
||||||
|
| Win-Hill | GitHub 内部基于 Windows 容器运行的测试基准 | 验证运行框架的性能能否跨操作系统和不同运行环境保持一致 |
|
||||||
|
|
||||||
|
在整个评测过程中,我们将 **GitHub Copilot CLI** 与模型厂商针对相应模型提供的原生智能体运行框架进行了对比:Claude Sonnet 4.6 和 Claude Opus 4.7 对比 **Claude Code**,GPT-5.4 和 GPT-5.5 对比 **Codex CLI**。
|
||||||
|
|
||||||
|
**Token 效率**
|
||||||
|
|
||||||
|
在保持模型和任务不变的情况下,通过多个基准测试结果可以看到,GitHub Copilot 智能体运行框架在任务完成率方面与其他模型厂商提供的运行框架基本持平,同时在大多数配置下表现出更低的 Token 消耗。
|
||||||
|
|
||||||
|
_Token 效率:GitHub Copilot CLI vs. 其他模型厂商运行框架_
|
||||||
|
|
||||||
|
**任务解决能力**
|
||||||
|
|
||||||
|
Token 效率只有在任务真正完成时才有意义。
|
||||||
|
|
||||||
|
在固定模型和基准任务的条件下,GitHub Copilot 智能体运行框架在这些基准测试中的任务解决率与模型厂商提供的运行框架基本持平。这意味着,开发者既可以充分发挥底层模型的能力,也能够获得多模型支持、Token 效率优化,以及更强的记忆和上下文管理能力。
|
||||||
|
|
||||||
|
_任务解决能力:GitHub Copilot CLI vs. 模型厂商运行框架_
|
||||||
|
|
||||||
|
这些结果体现了两者之间的有效平衡。由于模型本身具有随机性,测试结果在不同运行之间存在自然波动,因此不同运行框架之间的性能差异均处于合理变化范围内,可以认为二者表现基本相当。
|
||||||
|
|
||||||
|
**TerminalBench:Token 效率、任务完成率与运行波动**
|
||||||
|
|
||||||
|
为了持续提升 GitHub Copilot 智能体运行框架在任务完成能力和 Token 效率方面的表现,我们会定期基于多个基准测试进行深入分析。下面展示的是 TerminalBench 2.0 的方差分析示例。该分析不仅体现了 GitHub Copilot 在任务完成率和 Token 效率方面的优势,也展示了此类智能体基准测试中固有的运行间波动。
|
||||||
|
|
||||||
|
_任务解决率 vs. 单任务成本:越靠左上越好——解决更多任务,同时消耗更少成本。_
|
||||||
|
|
||||||
|
图中的每一个点代表 TerminalBench 2.0 中一种智能体与模型组合配置。纵轴表示任务解决率,横轴表示每个任务的美元成本,每个点周围的椭圆表示 ±1σ(一个标准差)的运行波动范围,展示该配置在多次运行之间的稳定程度。
|
||||||
|
|
||||||
|
三个关键发现:
|
||||||
|
|
||||||
|
1. **GitHub Copilot 智能体运行框架在任务完成和成本控制方面达到或超过其他智能体**。在评估的多种配置中,GitHub Copilot 智能体运行框架在任务完成率和单任务成本方面,与其他智能体相比表现相当甚至更优。图中的紫色点(代表 Copilot)与同模型下的竞争方案,在几乎所有模型配置中都处于相互重叠的椭圆范围内,说明两者差异处于运行波动范围之内。Copilot 在任务完成率上从未低于竞争方案,同时在成本方面也没有更高的消耗。
|
||||||
|
2. **运行间的波动性**。我们针对每一种智能体-模型组合至少运行了五次测试。图中的椭圆表示这些运行结果的 1σ 波动范围:更紧凑的椭圆表示结果更加稳定、更容易复现;更宽的椭圆表示不同运行之间的任务完成率和成本存在更大的波动。
|
||||||
|
3. **GitHub Copilot 多模型选择带来的优势**。图表展示了不同模型之间真实存在的权衡关系:GPT 系列模型(图中偏左区域)提供了最佳性价比:以最低成本实现较高任务解决率;Claude Opus(图中右上区域)能够达到最高任务解决率,但成本更高。GitHub Copilot 同时支持多种模型选择,因此开发者可以根据不同任务需求,在效率优先和最高质量之间自由选择。对于简单任务,可以选择更高性价比的模型;对于复杂任务,则可以选择更强大的模型以获得最佳结果。
|
||||||
|
|
||||||
|
**一个运行框架,多种模型**
|
||||||
|
|
||||||
|
GitHub Copilot 智能体运行框架支持 20 多种前沿模型,覆盖 GPT、Claude、Gemini 和 MAI 模型系列,同时支持通过自带密钥使用开源模型和本地模型。开发者可以根据不同任务的能力需求和成本特征,选择最适合的模型;也可以使用 Auto 模型选择功能,由系统自动完成模型匹配,在理解任务意图和评估模型状态的基础上,优化 Token 使用效率。
|
||||||
|
|
||||||
|
多模型架构还赋予了 GitHub Copilot 运行框架层面的独特能力,这些能力是单一模型厂商的运行框架无法提供的。例如,Rubber Duck 通过跨模型家族的协作评审机制,让一个模型对另一个模型的输出进行审查和改进,从而获得超越单一模型独立运行时的效果。
|
||||||
|
|
||||||
|
**Auto 模型选择**
|
||||||
|
|
||||||
|
https://docs.github.com/en/copilot/concepts/models/auto-model-selection/?wt.mc_id=3reg_webpage_reactor
|
||||||
|
|
||||||
|
**Rubber Duck**
|
||||||
|
|
||||||
|
https://github.blog/ai-and-ml/github-copilot/github-copilot-cli-combines-model-families-for-a-second-opinion/?wt.mc_id=3reg_webpage_reactor
|
||||||
|
|
||||||
|
**结论**
|
||||||
|
|
||||||
|
基准测试只是衡量能力的众多指标之一。我们持续通过基准测试、真实使用数据指标以及线上实验,不断提升 GitHub Copilot 的质量表现,同时致力于更高效地利用每一个 Token。
|
||||||
|
|
||||||
|
GitHub Copilot 凭借多模型架构,在多个配置场景下能够以更少的 Token 消耗,实现与领先模型厂商运行框架相当的任务解决能力,同时避免开发者被单一模型绑定。对于开发者而言,这意味着可以用更低的 Token 成本完成相近的任务,同时仍然可以根据具体任务需求,选择最适合的模型。
|
||||||
|
|
||||||
|
**亲自体验**
|
||||||
|
|
||||||
|
你可以使用自己选择的模型体验 GitHub Copilot,比较不同方案在日常开发任务中的表现,并观察不同模型和智能体策略在你的实际工作环境中的效果。
|
||||||
|
|
||||||
|
进一步了解:
|
||||||
|
|
||||||
|
- GitHub Copilot CLI
|
||||||
|
|
||||||
|
https://github.com/features/copilot/cli?utm_source=blog-benchmarking-1&utm_medium=blog&utm_campaign=github-copilot-app-ga-2026/?wt.mc_id=3reg_webpage_reactor
|
||||||
|
|
||||||
|
- GitHub Copilot App
|
||||||
|
|
||||||
|
https://github.com/features/ai/github-app?utm_source=blog-benchmarking-1&utm_medium=blog&utm_campaign=github-copilot-app-ga-2026/?wt.mc_id=3reg_webpage_reactor
|
||||||
|
|
||||||
|
- GitHub Copilot SDK
|
||||||
|
|
||||||
|
https://github.com/github/copilot-sdk?utm_source=blog-benchmarking-1&utm_medium=blog&utm_campaign=github-copilot-app-ga-2026/?wt.mc_id=3reg_webpage_reactor
|
||||||
|
|
||||||
|
这些体验背后均由同一个智能体运行框架提供支持。我们将持续提升其质量、效率和灵活性。
|
||||||
|
|
||||||
|
**方法论**
|
||||||
|
|
||||||
|
为了让对比结果尽可能公平、可控且可复现,我们在不同模型、任务和运行环境中,采用等效配置运行每个智能体。
|
||||||
|
|
||||||
|
- 所有测试运行:
|
||||||
|
- 超时时间统一设置为 2 小时;
|
||||||
|
- 所有智能体均采用非交互式单轮模式运行;
|
||||||
|
- 禁用 Web 工具;
|
||||||
|
- 开放所有可用工具。
|
||||||
|
|
||||||
|
**TerminalBench2 分析**:为智能体启用默认设置,推理强度设置为 medium(例如,Claude Code 启用了工具搜索功能,而 Copilot CLI 使用 GitHub MCP Server)。Codex 和 Claude Code 使用 Anthropic 和 OpenAI 的官方直连接口。为了确保结果完整且可靠,任何缺失数据或与基础设施相关的失败都会重新运行,直到所有 89 个 TerminalBench2 任务均产出结果。由模型生成的错误会被保留,不会从分析中排除。每个模型均经过五次独立运行评估,同时 Copilot 进行了两批独立评估,以便与 Claude Code 和 Codex 进行对比。
|
||||||
|
|
||||||
|
**所有基准测试**:所有智能体-模型组合均标准化为相同的上下文窗口大小、相同的 Prompt Token 限制、相同的推理强度(medium)和测试设置——不启用工具搜索,不使用 MCP Server。保留运行框架默认内置工具。为了确保公平比较,所有智能体在基准测试中的基础设施相关异常和网络访问影响均被排除。为了降低运行间差异对较小规模基准测试(<100 个实例)的影响,测试进行了五次独立运行,并报告其中得分最高的一次结果。所有指标均以 pass@1 形式呈现。这些标准化处理意味着测试结果会与公开基准测试提交结果有所不同,因为公开基准测试通常会采用更高的推理强度以及其他经过调优的设置。
|
||||||
@@ -0,0 +1,74 @@
|
|||||||
|
# 📊 文章摘要:技术速递|评估 GitHub Copilot 智能体运行框架在不同模型和任务中的性能与效率
|
||||||
|
|
||||||
|
> **原文**:[2026-08-20_技术速递_评估_GitHub_Copilot_智能体运行框架在不同模型和任务中的性能与效率](./2026-08-20_技术速递_评估_GitHub_Copilot_智能体运行框架在不同模型和任务中的性能与效率.md)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/TmXrgtT1A70VZfPESKinNQ
|
||||||
|
> **来源**:微信公众平台
|
||||||
|
> **作者**:微软Reactor(编译自 GitHub 官方博客,原作者 Shibani Basava & Carlos Castro)
|
||||||
|
> **发布日期**:2026-08-20
|
||||||
|
> **摘要日期**:2026-08-20
|
||||||
|
> **价值评级**:⭐⭐⭐ 高
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 核心命题
|
||||||
|
|
||||||
|
> **运行层效率** — 在模型能力趋同的条件下,智能体运行框架(而非模型本身)成为 Token 效率、成本控制与多模型自由度的决定层,且该层优化可做到不牺牲任务完成率。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 文章概要
|
||||||
|
|
||||||
|
本文是 GitHub 官方对 Copilot 智能体运行框架(支撑 Copilot CLI/App/Code Review 等产品的统一共享组件)的系统自评:在控制模型、任务、上下文窗口、推理强度、工具与 MCP 配置完全一致的条件下,将 Copilot CLI 与模型厂商原生框架(Claude Code、Codex CLI)在 SWE-bench Verified/Pro、SkillsBench、TerminalBench、内部 Win-Hill 等基准上对比。结论是任务解决率基本持平(差异在运行波动范围内),而 Token 消耗在多数配置下更低。其真正价值不在自评结论,而在方法论披露:多次运行、±1σ 方差椭圆、pass@1、标准化配置与公开提交结果的差异说明,为行业提供了 Agent 评测的可复现范式。局限是利益相关方自评、底层数据不公开、关键图表在公众号版本中不可见。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 关键要点
|
||||||
|
|
||||||
|
1. **运行框架是独立于模型的关键层** — 工具调用、上下文管理、工作流编排由运行框架统一协调,其改进惠及所有上层产品;"模型提供底层智能,运行框架决定智能能否高效发挥"。 `[分类: 共识]`
|
||||||
|
2. **同任务解决率下更低 Token 消耗** — 控制变量后,Copilot 运行框架任务解决率与 Claude Code/Codex CLI"基本相当",多数配置下 Token 消耗更低(此为作者结论,底层数据未公开)。 `[分类: 争议]`
|
||||||
|
3. **运行间波动是 Agent 基准的固有属性** — 每种智能体-模型组合至少运行 5 次,用 ±1σ 椭圆展示波动;两框架差异落在重叠椭圆内即应视为"基本相当",单次跑分不可作为结论依据。 `[分类: 共识]`
|
||||||
|
4. **模型间存在真实权衡而非单向优劣** — GPT 系列性价比最高(低成本高解决率),Claude Opus 解决率最高但成本更高;多模型可选(20+ 模型、Auto 模型选择)让开发者按任务在效率与质量间切换。 `[分类: 共识]`
|
||||||
|
5. **跨模型家族协作是运行层独有能力** — Rubber Duck 机制让一个模型审查另一模型输出,获得超越单模型独立运行的效果,这是单一厂商运行框架做不到的。 `[分类: 未探索]`
|
||||||
|
6. **标准化配置导致与公开榜单结果必然分叉** — 统一 medium 推理强度、禁用工具搜索/MCP、排除基础设施异常后,结果会低于公开提交(后者用更高推理强度与调优设置);小规模基准(<100 实例)报告五次运行的最高分。 `[分类: 共识]`
|
||||||
|
7. **评测方法论细节可迁移** — 超时统一 2 小时、非交互单轮、禁 Web 工具、模型生成错误保留不剔除、基础设施失败重跑补全、pass@1 呈现。 `[分类: 共识]`
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 批判性分析
|
||||||
|
|
||||||
|
### 假设前提
|
||||||
|
- 假设"任务解决率持平 + Token 更少"是开发者选型运行框架的充分理由,未讨论框架功能差异(如 Claude Code 的工具搜索、Hooks 生态)对真实开发体验的影响。
|
||||||
|
- 假设基准测试环境(单轮非交互、禁 Web)能代表真实使用,而真实 Copilot 使用多为交互式长会话。
|
||||||
|
- 自评者即利益方:GitHub 既是被测运行框架的开发者,又掌控评测配置(如"Copilot 使用 GitHub MCP Server"这类不对称默认设置)。
|
||||||
|
|
||||||
|
### 论据与逻辑
|
||||||
|
- 方法论透明度显著高于一般厂商benchmark 文章(方差分析、五次运行、pass@1、与公开提交差异的主动说明),这是其可信度的主要来源。
|
||||||
|
- 但所有关键图表(Token 效率图、任务解决能力图、TerminalBench 散点图)在公众号版本中均为失效 blob 链接,读者实际只能看到定性结论,"更低 Token 消耗"缺乏可验证的数字。
|
||||||
|
- "基本持平/差异在波动范围内"的表述严谨(诚实承认无显著优势),但标题与结论段又强调"行业领先的 Token 效率",存在表述张力。
|
||||||
|
|
||||||
|
### 边界与局限
|
||||||
|
- 未覆盖延迟/响应速度维度(其自己列出的优秀运行框架三特性之一),仅谈了任务完成率与成本。
|
||||||
|
- 内部基准(Win-Hill、基于 GitHub/微软代码库的自研基准)无法外部复现。
|
||||||
|
- 结论时效性强绑定四款模型(Claude Sonnet 4.6/Opus 4.7、GPT-5.4/5.5),模型迭代可能快速改变对比格局。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 可引用金句
|
||||||
|
|
||||||
|
> "虽然模型提供了底层智能,但真正决定这些智能能否高效发挥作用的,是智能体运行框架。"
|
||||||
|
|
||||||
|
> "Token 效率只有在任务真正完成时才有意义。"
|
||||||
|
|
||||||
|
> "Copilot 在任务完成率上从未低于竞争方案,同时在成本方面也没有更高的消耗。"
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 总体评价
|
||||||
|
|
||||||
|
**亮点**:方法论披露完整且诚实(方差、多次运行、与公开提交的差异说明);"框架层与模型层解耦"的定位论证清晰;主动承认差异在波动范围内而非夸大领先。
|
||||||
|
|
||||||
|
**不足**:利益相关方自评且数据不可验证;关键图表缺失;未测量延迟与真实交互场景;内部基准不可复现。
|
||||||
|
|
||||||
|
**适用场景**:设计 Agent/Coding Agent 评测方案时的方法论参考(方差意识、标准化配置、pass@1);企业选型 CLI 工具时理解"框架层 Token 效率"这一采购维度;撰写技术评测报告的写作范本。
|
||||||
|
|
||||||
|
**关联建议**:与《2026CSDI:AGI前夜》(编排式 vs 模型原生 Agent 之争)对照阅读——本文证明编排层(运行框架)在 Token 效率上有优化空间,恰好是该争论的实证素材;方法论部分可直接用于本院 Agent 评测体系建设。
|
||||||
+150
@@ -0,0 +1,150 @@
|
|||||||
|
# 链路贯通|Jonex × WorkBuddy 打通 MCP 链路:本体知识 + 企业 Agent 赋能工程智能决策
|
||||||
|
|
||||||
|
> **来源**:微信公众平台(悦智人工智能)
|
||||||
|
> **作者**:悦智人工智能
|
||||||
|
> **发布日期**:2026-08-20(原文未标注明确日期,按下载日占位)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/u7QfwbV2fx1XkxHhGhKHIA
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
**Jonex(取自于Joint Ontology Nexus),是一套基于本体论、支持多模态的面向企业Agent的知识引擎。它通过联合(Joint)架构融合文本、图像、音视频等多模态数据,以本体论(Ontology)统一建模业务对象、关系、规则与行动,并通过知识中枢(Nexus)支撑Agent可推理、可追溯、可扩展地调用企业知识。**
|
||||||
|
|
||||||
|
**Jonex由来自前微软、腾讯云、阿里等企业的首席顾问、架构师、技术专家,以及毕业于清华大学、新加坡国立大学等高校的硕博人才组成的产品研发团队打造。团队长期专注于企业AI规模化落地、Agent应用与行业知识工程,致力于帮助企业将文档、视频、音频、图片和专家经验中的行业Know-how,转化为可持续复用和放大的生产力资产。**
|
||||||
|
|
||||||
|
前四篇,我们从企业"暗数据"、多模态解析引擎和本体论出发,讨论了Jonex如何把分散资料编译为Agent可以调用的知识。今天,我们以某型硬件设备运维的真实工程场景为例,进一步深入讨论:
|
||||||
|
|
||||||
|
当产品持续迭代、部件不断更换、现场证据逐年累积,工程师怎样在不遗漏影响关系、不越过证据边界的前提下,更快完成判断?
|
||||||
|
|
||||||
|
目前,**Jonex已通过MCP接入WorkBuddy企业版**。企业的文档、图像、音视频等多模态数据先在Jonex中完成解析与知识编译,WorkBuddy再直接调用这些结果,将Agent的自然交互与Jonex的专业知识能力结合起来,使知识准备前移、调用更加高效。
|
||||||
|
|
||||||
|
## 一项变更,会沿着哪些关系向外扩散?
|
||||||
|
|
||||||
|
## Jonex本体论给出解法
|
||||||
|
|
||||||
|
在某型硬件设备进行技术变更时,时常会遇到这一类棘手的问题:
|
||||||
|
|
||||||
|
_哪些产品型号需要同步调整?现有图纸和BOM是否仍然有效?生产工艺、检验规范和维护手册要改到哪里?培训视频里有没有已经过时的操作?已经交付的设备中,又有多少台属于受影响范围?_
|
||||||
|
|
||||||
|
一项工程变更进入企业以后,很少只影响发起变更的那份文件。它会顺着部件、型号、图纸、流程和客户设备一路传播。即使每个部门都能讲清自己负责的部分,也很难由某一个人在短时间内拼出完整的范围。而Jonex接入Workbuddy,就完美解决了这一问题。
|
||||||
|
|
||||||
|
我们以一组演示数据为例:XX2系列设备准备调整冷却方案。 现在,工程师只需在WorkBuddy中输入:
|
||||||
|
|
||||||
|
_将XX2系列的冷却方式由ONAF调整为ODAF,需要同步核查哪些部件、技术参数、操作规范、维护项目和在用设备?请列出依据,以及暂时无法确认的事项。_
|
||||||
|
|
||||||
|
就可以得到一张沿着工程关系展开的影响清单。得益于Jonex的本体建模,系统能够从"冷却方式变更"这一节点出发,沿着产品型号、部件、控制规则、图纸、工艺、维护要求和在用设备等关系逐层展开,并同时带回对应依据。
|
||||||
|
|
||||||
|
## 一项工程变更,究竟会影响到哪里?
|
||||||
|
|
||||||
|
传统搜索能找到"ODAF""油泵"或"冷却控制"等材料,但通常只返回若干文件,既难说明每份材料为何受到影响,也难确认是否遗漏传播路径。
|
||||||
|
|
||||||
|
_例如,XX2原采用ONAF,由六组散热器和十二台风扇组成,风扇按温度自动启停;改为ODAF后,还需增加油泵与油路控制,运行顺序、PLC逻辑、保护元件、告警设置和备用设备轮换方式都要重新核对。相应的图纸、作业指导书、检验表、维护手册、培训视频以及已交付设备台账也会进入检查范围。_
|
||||||
|
|
||||||
|
【图一|工程变更影响网络】
|
||||||
|
|
||||||
|
Jonex将产品型号、冷却方式、部件、控制规则、工艺、检验项目和设备实例组织为业务节点,并把图纸、手册、表格和视频作为证据挂接其上。借助本体关系,系统可从"冷却方式变更"出发,沿风扇、油泵、控制规则、图纸、工艺和维护要求向外检查,同时带回依据。
|
||||||
|
|
||||||
|
## 接入Agent,使 Jonex具有更多外接能力
|
||||||
|
|
||||||
|
上一节关注的是一项变更会影响哪些对象;这里要解决的是另一类任务:
|
||||||
|
|
||||||
|
候选替代件已经明确后,如何按约束逐项核验,并把缺失证据和后续工作一并整理出来?
|
||||||
|
|
||||||
|
仍以冷却系统为例:
|
||||||
|
|
||||||
|
_XX2使用的风扇电机功率为1.1 kW,单台风量为16000 m³/h。供应商停止生产原型号后,采购部门找到了 XX3 使用的1.5 kW风扇,单台风量达到22000 m³/h。_
|
||||||
|
|
||||||
|
工程师需要核查的内容很多:
|
||||||
|
|
||||||
|
_它的安装尺寸、连接方式和叶片结构是否一致?额定电流会不会超过原控制回路的设计范围?接触器、断路器和热继电器是否需要重新选型?原来的温控启停逻辑还能不能使用?单台风量提高以后,散热器表面的气流分布会不会改变?_
|
||||||
|
|
||||||
|
_更重要的是,XX3原本属于另一套ODAF冷却系统。它拥有更多散热器和风扇,同时还配置油泵与PLC控制。将其中一个部件单独取出,不代表它能够脱离原系统条件,直接进入XX2。_
|
||||||
|
|
||||||
|
这个问题正适合交给Jonex与WorkBuddy配合处理。工程师在WorkBuddy中给出设备型号、原部件、候选部件、核验维度和输出要求:
|
||||||
|
|
||||||
|
_XX2冷却系统原用的1.1 kW风扇已经停产,能否直接使用XX3的1.5 kW风扇替代?请比较风量、供电、控制方式、系统结构和维护要求,并单独列出目前缺少的判断依据。_
|
||||||
|
|
||||||
|
WorkBuddy保留当前任务的上下文与约束,并通过MCP调用Jonex。Jonex调取两种风扇所属系统中的参数、控制要求和维护记录,WorkBuddy再按电气参数、机械接口、控制保护、系统性能和认证要求等维度组织结果。
|
||||||
|
|
||||||
|
现有材料能够确认功率、风量、风扇数量、冷却方式和控制方式等差异,也会显示XX3的运行逻辑依赖油泵与PLC。各项结果分别标记为"满足""存在差异"或"待补证据",并回到相应手册、参数表或章节
|
||||||
|
|
||||||
|
【图二|替代件核验卡片】
|
||||||
|
|
||||||
|
这正是两者结合后的优势:
|
||||||
|
|
||||||
|
Jonex为WorkBuddy提供经过**本体关系约束、带有来源和知识边界的专业内容**;
|
||||||
|
|
||||||
|
WorkBuddy则让Jonex的知识进入**连续对话、条件筛选、文档生成和协作执行**。工程师无需学习知识图谱的操作方式,也不必把检索结果重新抄进另一套工作表。
|
||||||
|
|
||||||
|
## 异构数据之处理:
|
||||||
|
|
||||||
|
## 多模态解析引擎如何组织故障证据
|
||||||
|
|
||||||
|
前两个问题至少有一个清楚的起点:
|
||||||
|
|
||||||
|
某项方案准备变更,或者某个部件等待替换。
|
||||||
|
|
||||||
|
故障分析往往没有这么明确,假设一批设备出现间歇性异常。异常持续时间很短,无法稳定复现,也没有任何一份材料能够单独指向原因。工程团队已经按照流程收集了完整资料:
|
||||||
|
|
||||||
|
运行日志记录了异常发生的时间和状态码;传感器曲线保留了温度、电流或压力变化;现场照片呈现部件外观;视频记录了设备运行时的声音、振动和动作;设备台账保存零部件批次与软件版本;维修工单则记录每台设备曾经更换过什么、调整过什么,以及异常是否再次出现。
|
||||||
|
|
||||||
|
资料完整,并不意味着答案已经存在。
|
||||||
|
|
||||||
|
出现异常的设备是否集中在某个零部件批次?某种曲线变化是否总与视频中的同一现场表现同时出现?已经更换某部件的设备,异常发生频率有没有变化?异常是否只出现在特定软件版本和负载条件的组合下?历史案例与当前情况究竟相似到什么程度?
|
||||||
|
|
||||||
|
这项工作最消耗时间的部分,往往不是某一个专业判断,而是反复筛选样本、对齐时间、核对版本和整理证据。
|
||||||
|
|
||||||
|
而接入Jonex后,工程师只需在WorkBuddy中输入:
|
||||||
|
|
||||||
|
_这批设备的间歇性异常与哪些历史案例最接近?请综合运行日志、传感器曲线、现场照片、异常视频、零部件批次和维修记录,按证据强弱列出可能原因,并说明每项判断的来源和仍需验证的部分。_
|
||||||
|
|
||||||
|
便可以得到一张按证据强弱组织的故障假设清单:哪些线索相互印证,哪些结论仍有冲突,哪些信息尚待补充,以及每项判断对应的日志行、曲线区间、图片区域或视频时间点。
|
||||||
|
|
||||||
|
这里,Jonex的价值不只在于分别读取日志、曲线、照片和视频,更在于让它们在同一异常事件中互相补充。日志记录状态码,曲线呈现变化过程,照片保留部件外观,视频则记录声音、振动和动作;单一材料通常只能说明问题的一部分,完成跨模态对齐后,系统才有可能还原更完整的异常现场。
|
||||||
|
|
||||||
|
【图三|多模态故障证据网络】
|
||||||
|
|
||||||
|
在这一场景中,**多模态解析引擎**负责把不同形式的材料**变成可比较、可定位的证据**;**本体关系负责把证据挂到设备、版本和事件上;**WorkBuddy则承接工程师后续的样本筛选和验证计划生成。
|
||||||
|
|
||||||
|
## Jonex + Workbuddy 工作链路
|
||||||
|
|
||||||
|
Jonex 位于企业资料与员工工作之间,将文档、图纸、日志、图片和视频编译为围绕产品、部件、版本、事件、规则与证据组织的专业知识。WorkBuddy作为统一入口,承接提问、筛选、整理、生成和任务执行,使这些知识直接进入具体业务场景。
|
||||||
|
|
||||||
|
企业原有的文档平台、知识库、培训系统和业务系统仍可继续承担内容管理与流程运行;Jonex补充专业语义与关系连接,WorkBuddy再将结果转化为影响分析、替代件核验、验证计划或任务清单。由此,企业资料中的业务联系能够被Agent稳定调用并持续复用。
|
||||||
|
|
||||||
|
【图四|Jonex + WorkBuddy工作链路】
|
||||||
|
|
||||||
|
在AI时代,当一项变化可以迅速找到受影响的对象,一个替代方案可以看清尚未满足的条件,一次复杂异常可以从海量资料中形成可验证的原因假设,企业知识才真正进入工程决策。
|
||||||
|
|
||||||
|
Jonex + WorkBuddy,让专业人员看得更全,也让每一次判断更接近证据。
|
||||||
|
|
||||||
|
**知识如流,汇聚成溪。**
|
||||||
|
|
||||||
|
上一篇回顾:《场景落地|当学生卡在一道题上:Jonex 如何把一门课编译成可导航的知识系统》
|
||||||
|
|
||||||
|
下期预告:当知识结果进入流程,企业 Agent 如何从辅助判断走向协同执行?
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
**国家高新技术企业**
|
||||||
|
|
||||||
|
**软件成熟度CMMI5认证**
|
||||||
|
|
||||||
|
**ISO42001 人工智能管理体系认证**
|
||||||
|
|
||||||
|
**ISO系列认证**
|
||||||
|
|
||||||
|
**ITSS认证**
|
||||||
|
|
||||||
|
**腾讯云第一大技术服务商**
|
||||||
|
|
||||||
|
**腾讯云优选级代理合作伙伴**
|
||||||
|
|
||||||
|
**腾讯云国际一级经销商**
|
||||||
|
|
||||||
|
**GCP Partner授权合作伙伴**
|
||||||
|
|
||||||
|
**AWS SPP授权解决方案提供商**
|
||||||
|
|
||||||
|
**专业提供**
|
||||||
|
|
||||||
|
人工智能、云计算、大数据、云经纪代理等技术产品与服务。
|
||||||
+70
@@ -0,0 +1,70 @@
|
|||||||
|
# 📊 文章摘要:链路贯通|Jonex × WorkBuddy 打通 MCP 链路:本体知识 + 企业 Agent 赋能工程智能决策
|
||||||
|
|
||||||
|
> **原文**:[2026-08-20_链路贯通_Jonex_×_WorkBuddy_打通_MCP_链路_本体知识_+_企业_Agent_赋能工程智能决策](./2026-08-20_链路贯通_Jonex_×_WorkBuddy_打通_MCP_链路_本体知识_+_企业_Agent_赋能工程智能决策.md)
|
||||||
|
> **原文链接**:https://mp.weixin.qq.com/s/u7QfwbV2fx1XkxHhGhKHIA
|
||||||
|
> **来源**:微信公众平台
|
||||||
|
> **作者**:悦智人工智能
|
||||||
|
> **发布日期**:2026-08-20
|
||||||
|
> **摘要日期**:2026-08-20
|
||||||
|
> **价值评级**:⭐⭐ 中
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 核心命题
|
||||||
|
|
||||||
|
> **知识编译** — 把企业多模态"暗数据"编译为以本体论组织的、可推理可追溯的知识层,再经 MCP 供企业 Agent 调用,让工程决策不遗漏影响关系、不越过证据边界。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 文章概要
|
||||||
|
|
||||||
|
这是悦智人工智能(自称腾讯云第一大技术服务商)系列产品文章第五篇,介绍其知识引擎 Jonex(Joint Ontology Nexus)通过 MCP 接入 WorkBuddy 企业版的联合方案。文章用三个硬件设备运维场景展示能力:工程变更影响分析(从"冷却方式变更"节点沿本体关系逐层展开受影响部件/图纸/工艺/设备并带回依据)、替代件核验(跨系统调参、按维度比对并三态标记"满足/存在差异/待补证据")、多模态故障证据组织(日志/曲线/照片/视频跨模态对齐,按证据强弱生成假设清单)。场景叙事具体是本文最大优点,但全部基于"一组演示数据",属厂商产品宣传文,无真实客户案例与量化效果,且通篇未与主流 RAG 方案做对比论证。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 关键要点
|
||||||
|
|
||||||
|
1. **Jonex = 本体论 + 多模态 + 知识中枢** — 以 Ontology 统一建模业务对象/关系/规则/行动,Joint 架构融合文本/图像/音视频,支撑 Agent 可推理、可追溯、可扩展地调用企业知识。 `[分类: 共识]`
|
||||||
|
2. **工程变更沿关系网络传播,传统搜索无法回答"影响范围"** — 变更会顺着部件、型号、图纸、流程、客户设备一路扩散;搜索只返回文件,难说明为何受影响、难确认是否遗漏传播路径。 `[分类: 共识]`
|
||||||
|
3. **影响清单带回依据链** — 从变更节点沿产品型号/部件/控制规则/图纸/工艺/维护要求/在用设备逐层展开,同时列出依据及"暂时无法确认的事项"。 `[分类: 未探索]`
|
||||||
|
4. **替代件核验的三态标记** — 结果分为"满足/存在差异/待补证据"并回链手册/参数表/章节;且能识别"部件脱离原系统条件不可直接移植"这类系统级约束(XX3 风扇依赖油泵与 PLC)。 `[分类: 未探索]`
|
||||||
|
5. **多模态跨对齐还原故障现场** — 日志记状态码、曲线呈变化、照片留外观、视频录声振,单一材料只说明局部,跨模态对齐后按证据强弱输出假设清单(含冲突与待补信息)。 `[分类: 共识]`
|
||||||
|
6. **分工架构:知识引擎管编译,Agent 管交互** — Jonex 提供受本体关系约束、带来源和知识边界的内容;WorkBuddy 承接连续对话、条件筛选、文档生成与协作执行;知识准备前移、MCP 调用。 `[分类: 共识]`
|
||||||
|
7. **存量系统不推翻** — 原有文档平台/知识库/培训系统继续承担内容管理与流程运行,Jonex 补语义与关系,WorkBuddy 转化为业务产出。 `[分类: 共识]`
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 批判性分析
|
||||||
|
|
||||||
|
### 假设前提
|
||||||
|
- 隐含假设:本体建模的知识质量收益大于其构造成本。但本体工程(本体设计、实体抽取、关系维护、随业务演进的更新)以高投入著称,文章完全未讨论成本与冷启动周期。
|
||||||
|
- 未论证为何本体论优于当前企业知识检索主流的 RAG/向量方案——这是选型读者最关心的问题,文章以"传统搜索只返回若干文件"的稻草人对比带过。
|
||||||
|
|
||||||
|
### 论据与逻辑
|
||||||
|
- 三个场景全部基于"一组演示数据"(原文自述),无真实客户、无量化指标(构建周期/准确率/人力节省),产品能力未经第三方或生产环境验证。
|
||||||
|
- "而Jonex接入Workbuddy,就完美解决了这一问题"属典型营销断言,与前文"很难由某一个人在短时间内拼出完整的范围"的问题复杂性不匹配。
|
||||||
|
- 团队背景(前微软/腾讯云/阿里、清华/新加坡国立硕博)是信任背书而非能力证据;文末资质列表(CMMI5、腾讯云第一大服务商)与产品论证无关。
|
||||||
|
|
||||||
|
### 边界与局限
|
||||||
|
- 场景限于结构化程度较高的硬件设备运维(BOM/图纸/参数表天然适配本体建模),对非结构化业务知识(经验、判断、跨部门隐性知识)的适用性未讨论。
|
||||||
|
- 演示话术中的自然语言查询都高度结构化(明确型号/维度/输出要求),真实工程师的模糊提问效果未知。
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 可引用金句
|
||||||
|
|
||||||
|
> "当一项变化可以迅速找到受影响的对象,一个替代方案可以看清尚未满足的条件,一次复杂异常可以从海量资料中形成可验证的原因假设,企业知识才真正进入工程决策。"
|
||||||
|
|
||||||
|
> "单一材料通常只能说明问题的一部分,完成跨模态对齐后,系统才有可能还原更完整的异常现场。"
|
||||||
|
|
||||||
|
---
|
||||||
|
|
||||||
|
## 总体评价
|
||||||
|
|
||||||
|
**亮点**:三个工程场景的问题定义精准(影响传播、跨系统替代核验、多模态故障归因),"三态标记+证据回链+待补事项"的证据边界设计值得借鉴;产品叙事面向真实工程痛点而非技术炫技。
|
||||||
|
|
||||||
|
**不足**:纯演示数据、零客户案例、零量化效果;回避与 RAG 主流方案的正面对比;本体建模的成本与维护难题只字未提;营销断言("完美解决")削弱可信度。
|
||||||
|
|
||||||
|
**适用场景**:设计企业知识工程/Agent 知识层方案时的场景与交互范式参考(尤其是证据可追溯性设计);评估本体论路线时的厂商观点样本;智能运维(AIOps)产品规划素材。
|
||||||
|
|
||||||
|
**关联建议**:与《FDE 在中国火了》(IDC中国)对照,展示 Agent 落地的"工具链派"路线;本院在做企业知识库/Agent 知识层选型时,其"三态标记""证据回链"交互设计可直接借用,但选型决策需补充 RAG 对比与本体构建成本评估。
|
||||||
Some files were not shown because too many files have changed in this diff Show More
Reference in New Issue
Block a user