Compare commits
2
Commits
| Author | SHA1 | Date | |
|---|---|---|---|
 arno |
5f2964bf68 | ||
|
arno
|
28c4dfed4e |
@@ -0,0 +1,294 @@
|
||||
# 为抓住当代唯一的科技转折点,用AI最猛的一批人已经不睡觉了
|
||||
|
||||
> **来源**:微信公众平台
|
||||
> **作者**:不懂经也叔的Rust
|
||||
> **发布日期**:2026-08-27
|
||||
> **原文链接**:https://mp.weixin.qq.com/s/KElyAyEuB6RooLvue0SysA
|
||||
|
||||
---
|
||||
|
||||
43 岁的阿贾伊·卡利亚是一个总部位于波士顿的 AI 创业公司的创始人。他说,自己早在 2023 年 2 月还在 Spotify 的 AI 团队工作时,就第一次意识到 AI 将会颠覆世界。
|
||||
|
||||
他看到一些拥有博士学位、从业 20 年的人从房间里出来时,一个个都垂头丧气。"他们会说一些非常奇怪的话,比如:'我的博士学位没用了。'"他说。
|
||||
|
||||
卡利亚于 2024 年离开 Spotify,创办了自己的公司 Alt。如今,他大多数日子早上 5 点半或 6 点就开始工作,晚上 9 点或 10 点左右结束。他会使用ai智能体,但每隔几个月,就得根据智能体快速变化的能力重新调整自己的工作方式。
|
||||
|
||||
"你可以用这些新模型构建更宏大、野心更大的东西,这太棒了。"他说,"问题是,你永远做不完。"
|
||||
|
||||
卡利亚最近开始通过 Apple Watch 控制智能体,这件事有好处,也有代价。他的手表每隔 10 分钟就震一下,提醒他有新的智能体请求。
|
||||
|
||||
"我不知道,跑步时还要盯着手表,批准智能体做某件事,对我来说是否健康。"他说。
|
||||
|
||||
在卡利亚更广泛的创业者圈子里,没有人考虑休假,也没人表达过对职业倦怠的担忧,尽管他看到很多人似乎已经站在崩溃边缘。
|
||||
|
||||
"大家都心照不宣地承认,一方面这不可持续,另一方面,为什么要停下来?"他说。
|
||||
|
||||
上面是华尔街日报刚刚发表的一篇报道中讲述的故事。这篇文章说的是,AI智能体不需要睡觉,创业公司的创始人为了跟上他们的智能体,也几乎不睡觉了。996 根本就是小儿科。有人从早上七点半工作到凌晨两点,有人则是经常通宵 ,早上 6 点才睡觉,还有人甚至连续一个月每天只睡一个小时。
|
||||
|
||||
很多人认为 AI 堪称是 5000 年一遇的科技转折点,是他们在此一生当中必须把握的机会。而且 和 AI 智能体一起工作让人上头,根本停不下来。有人形容说 就像是吸毒。
|
||||
|
||||
还有一种fomo的情绪,就是错失综合症。有创业者表示,"让智能体停住八个小时,代价实在太高了。它们可能在任何时候完成工作,哪怕是在半夜。"还有人说,"我一分钟不工作,都意味着我错过了本来可以完成一周工作量的机会。"
|
||||
|
||||
我在之前的一篇文章《现在看清了:AI不是平权,它是资本和劳动力的最后一战》中提到,这几年,我们常听到一个词,叫"AI 平权"。它的意思是,AI 会把高级能力下放给普通人。不会写代码的人可以做应用,不会设计的人可以出图,不会英语的人可以写英文邮件,不懂法律的人可以看合同。
|
||||
|
||||
这当然发生了。我自己也相信,AI 会给很多普通人打开过去不可能打开的门。但这不是完整的图景。完整的图景是,AI 在降低某些门槛的同时,也在抬高另一些门槛。它降低了入门门槛,抬高了上限门槛。
|
||||
|
||||
现在在80 亿人口当中,80% 以上的人还没有接触和使用过 AI。在已经使用 AI 的人当中,绝大多数使用的是免费模型,只有一小部分人付费使用更高级的模型。而在付费使用的人当中,又只有极少数人每天消耗大量的 token,做着复杂的大型任务。
|
||||
|
||||
过去我们说"二八法则",到了网络时代,可能很多人会接受这是一个"一九法则"的世界。那么到了 AI 时代,我们很可能会看到一个"1:99"的世界,也就是 1% 的人可能会消耗掉 99% 的 token。这就是一个新的垄断阶层。
|
||||
|
||||
媒介理论的奠基人之一哈罗德·英尼斯认为,__伴随着任何一种新媒介的产生,都会出现一个新的专家阶层__。媒介发展史是相应的职业发展史,也是掌握该媒介和准入门槛之阶层的崛起史。英尼斯称该阶层因此获得的地位为"知识垄断"。在获得垄断权力之后,这一阶层会进一步以他们的媒介专长为"杠杆",为自己攫取更多的利益。
|
||||
|
||||
当然,我觉得现在对于很多人来说,机会窗口都是开放的,虽然大家的起点和资源并不平等。
|
||||
|
||||
下面重温一下我之前的一篇文章:《AI 让一部分人无班可上,又让另一部分人无班可下》。 有意思的是我还看到有教授就这个话题做过演讲。
|
||||
|
||||
许家印终局:没有谁能逃离永久底层
|
||||
|
||||
《牛来》火到了国外,但很少有人看透它的实质
|
||||
|
||||
残酷:AI 让一部分人无班可上,又让另一部分人无班可下
|
||||
|
||||
过去几年,硅谷一直在向世界兜售一个很诱人的承诺:AI 会替我们做掉那些无聊、重复、低价值的工作,把人从电脑前解放出来。
|
||||
|
||||
AI会写代码、整理资料、回复邮件、生成方案、检查错误,于是人类终于可以从琐碎劳动中抽身,去做更有创造力、更有意义、更像人的事。
|
||||
|
||||
但现在,第一批真正重度使用 AI 的人,正在过上一种完全相反的生活。
|
||||
|
||||
彭博社最近有一篇报道,其中写到一个创业者马特·范霍恩(Matt Van Horn)。他是四个孩子的父亲,也是一名连续创业者。现在,他的电脑几乎不关机,里面长期跑着不止半打 AI agent。它们在 Claude 模型背后的 AI 公司 Anthropic 的 Claude Code 里工作,每隔十分钟左右就会来问他下一步怎么做。
|
||||
|
||||
他送孩子上学时,agent 在跑;他去看孩子踢球时,agent 在跑;他度假住酒店时,agent 也在跑。到了晚上,他甚至让一个 agent 去照看其他 agent,好让整个系统继续运行。
|
||||
|
||||
这听起来像一个关于未来生产力的故事,但细看之下,它更像一个关于新型疲惫的故事。范霍恩自己也承认,大家原本说 agent 是来替我们工作的,可他从来没有像现在这么忙过。他的产出变成了过去的一百倍,但他的工作边界也被放大了一百倍。
|
||||
|
||||
这是 AI 时代最弔诡又讽刺的地方。AI 让一部分无班可上,又让另一部分人无班可下。
|
||||
|
||||
过去,下班至少还有某种物理含义。办公室关灯了,同事走了,电脑合上了,很多事情自然停在那里。现在,工作不再等于你坐在工位上敲键盘,而是你的模型、脚本、agent、自动化流程还在后台继续活动。你可以离开椅子,但你很难离开那个仍在运转的系统。
|
||||
|
||||
更麻烦的是,AI 让人无法停下来的方式,不再像传统加班那样粗暴。过去的加班有一个清楚的施压者,可能是老板、项目、绩效、客户。
|
||||
|
||||
AI 时代的压力更像是从内部长出来的,因为它不断提醒你:这件事其实还能继续推进,那个想法其实可以马上试一下,这段代码可以再优化,那个页面可以再生成一个版本。你不是被命令工作,而是被可能性召唤。
|
||||
|
||||
这就是更加值得深思的地方。AI 带来的不是单纯的效率提升,而是一种关于人的边界的重新谈判。它把过去由能力、时间、技能和身体共同构成的边界,一层层拆掉。
|
||||
|
||||
拆掉之后,人并不会自动变自由。相反,他会第一次如此直接地暴露在自己的欲望面前。
|
||||
|
||||
## 一、省力技术的古老悖论
|
||||
|
||||
我们先从一个更古老的问题说起:为什么所有省力技术,最后都没有让人真正省力?
|
||||
|
||||
德国社会学家哈特穆特·罗萨(Hartmut Rosa)早就研究过这种悖论。罗萨是当代德国很重要的社会理论家之一,曾受法兰克福学派第三代代表人物阿克塞尔·霍耐特(Axel Honneth)影响,他最著名的理论叫"社会加速"。
|
||||
|
||||
这个理论的出发点非常朴素,却几乎击中了每个现代人的日常经验:人类发明了无数省时技术,飞机、汽车、互联网、即时通讯、协同软件、云服务、自动化流程,但没有多少人真的觉得自己有了更多时间。恰恰相反,越是生活在技术发达的地方,人越容易觉得时间不够用。
|
||||
|
||||
罗萨把现代社会的加速理解成几个彼此咬合的过程。最容易理解的是技术加速。交通更快,通信更快,生产更快,从骑马到高铁,从书信到 5G,从手工流程到 AI 自动化,每一次技术进步都在压缩完成一件事所需的时间。按照朴素想象,这应该让人松一口气,因为同样的事更快完成,剩下的时间就可以用来休息。
|
||||
|
||||
但现代社会真正吊诡的地方在于,技术加速之后,社会变化本身也加速了。技能的保质期越来越短,行业共识的保质期越来越短,平台规则、审美趋势、组织结构、人际关系和职业身份都在更短周期里更新。
|
||||
|
||||
你十年前学会的东西,今天可能只是入门常识;你五年前相信的路径,今天可能已经失效;你刚刚适应一个工具,它的下一代版本已经重写了工作流程。罗萨有一个很形象的说法,现代人不是站在坚实土地上奔跑,而是站在一条自己也在移动的斜坡上。你越想站稳,就越被迫加快脚步。
|
||||
|
||||
最后被加速的是生活步调本身。技术本来应该替你省时间,可你感受到的不是闲暇增加,而是行动密度增加。你在同一单位时间里塞进更多任务,把等待时间改造成回复消息,把通勤时间改造成听播客,把午休时间改造成处理邮件,把晚上本来模糊的空白改造成"再推进一下"。
|
||||
|
||||
一个较慢的活动被一个较快的活动替代之后,节省出来的不是自由,而是下一个任务的位置。
|
||||
|
||||
没有AI聊天的童年,将成为富人阶层的特权?
|
||||
|
||||
战略性无知:真正有判断力的人,已经不看信息了
|
||||
|
||||
这几层加速形成了一个自我驱动的循环。技术让你做得更快,社会变化又要求你跟上新的标准,生活步调于是变得更密集,而更密集的生活又制造新的焦虑,逼你寻找更快的技术。
|
||||
|
||||
人不是走向闲暇,而是走向一种越来越精细、越来越高密度的时间管理。罗萨称这种状态为"时间饥荒"(time famine)。它不是说一天真的少于二十四小时,而是你的任务、欲望和外部期待膨胀得比时间更快。
|
||||
|
||||
这并不是 AI 时代才出现的问题。1930 年,英国经济学家凯恩斯就曾经乐观预言,到 2030 年,技术进步将使人类每周工作时间缩短到十五小时。
|
||||
|
||||
接近一百年过去了,我们确实拥有了凯恩斯无法想象的生产工具,但我们并没有进入闲暇社会。我们拥有的是一种更高级的忙碌:更快的设备、更密的日程、更碎的注意力,以及更强烈的"我还可以再做一点"的亏欠感。
|
||||
|
||||
AI 只不过把这条古老规律推到了一个前所未有的极端。过去的省力技术主要移除体力摩擦。洗衣机减少家务劳动,汽车减少空间距离,电梯减少身体攀爬。互联网和移动设备移除了一部分信息摩擦,让沟通和搜索变得更快。
|
||||
|
||||
但 AI 移除的是认知和决策摩擦。它让你从"我做不到"直接跳到"我只需要说一句话,它就能开始"。中间那些原本会让人犹豫、拖延、准备、学习、放弃的阻力,突然消失了一大块。
|
||||
|
||||
但是,摩擦不只是障碍。摩擦也是缓冲带,是人停下来问"我到底要不要做"的机会。过去,一个想法会自然死掉,因为它太麻烦。你不会写代码,所以那个 app 想法停在脑子里。你不会剪视频,所以那个内容计划放在收藏夹里。你没有团队,所以那个项目永远只是一个深夜里的幻想。
|
||||
|
||||
现实里的摩擦像一道粗糙但有效的筛网,把大量临时起意、不成熟的野心和不值得追逐的冲动挡在外面。
|
||||
|
||||
AI 改变的是这道筛网。它让很多事情从"以后有机会再说",变成"现在就可以开始"。做一个调研、搭一个网页、生成一份商业计划、跑一个数据分析、设计一套课程等等,这些过去需要准备很久的事情,现在都可以被迅速启动。于是我们以为 AI 节省的是时间,其实它更根本地节省了行动摩擦。
|
||||
|
||||
现在,一个想法不再死于麻烦。它会变成一个文档、一个 GitHub 仓库、一个 agent 任务、一个半成品项目,然后在你的后台持续闪烁。它不一定重要,但它已经被启动了。
|
||||
|
||||
只要它被启动,就会要求你继续照看它。人不是因为真正想清楚了才开始行动,而是因为行动门槛低到几乎无法构成拒绝。
|
||||
|
||||
这也是为什么 AI 重度使用者常常不是更轻松,而是更忙。员工行为分析公司 ActivTrak 研究了一万多名员工的数字活动后发现,采用 AI 的人并没有把节省下来的时间用于休息。他们在邮件、消息和聊天工具上的时间翻了一倍多,业务软件使用量也大幅上升,而专注、不被打断的工作时间反而下降。
|
||||
|
||||
加州大学伯克利分校哈斯商学院的研究者也发现,使用 AI 后,很多员工开始接手过去会外包出去的任务,因为编码、工程、整理和生成这些事情变得更容易了。他们把晚上、周末、候诊室里的碎片时间挤出来工作,同时监督多个 bot 做不同的事。
|
||||
|
||||
这件事表面上像是个体选择,深处却是罗萨所说的社会加速逻辑。技术没有把人带到更宽松的时间里,而是提高了单位时间里的行动密度。AI 不是让你少做事,而是让更多事情获得了进入你生活的资格。
|
||||
|
||||
## 二、AI Agent 是 24/7 资本主义的完美执行者
|
||||
|
||||
如果说罗萨解释了为什么省时技术总会制造新的时间饥荒,那么哥伦比亚大学艺术史教授乔纳森·克拉里(Jonathan Crary)则解释了为什么现代资本主义无法容忍停顿。
|
||||
|
||||
2013 年,克拉里出版了一本很薄但浓度极高的小书,书名叫《24/7:晚期资本主义与睡眠的终结》。它的核心论点非常尖锐:二十一世纪资本主义正在消灭人类生活中的停顿、间隔和停机时间,构建一个全天候、无间断、永远开放的世界。
|
||||
|
||||
市场不再受白天和黑夜约束,消费、通信、金融交易、娱乐、信息流和数据采集都在每个小时持续运行。人类生活中那些曾经自然存在的边界,正在被一个 24/7 的时间体制逐渐侵蚀。
|
||||
|
||||
从这个角度看,现代社会最重要的变化之一,不是工作时间简单变长,而是"不可工作"的时间越来越少。电灯削弱了夜晚的权威,便利店和通宵服务让城市失去闭店时刻,互联网让办公室搬进家庭,智能手机又把所有社会关系、消费场景和工作通知塞进口袋。你不一定每时每刻都在工作,但你越来越难处在一个绝对不会被工作召唤的时间里。
|
||||
|
||||
克拉里最犀利的地方,不在于他说现代人睡得越来越少,而在于他看见了睡眠的政治含义。睡眠是一种不合作。它让人暂时退出市场、屏幕和通信网络,证明世界在我们缺席时仍然存在,也证明人不是一个必须持续响应的接口。
|
||||
|
||||
对于 24/7 资本主义来说,睡眠之所以碍眼,不是因为它浪费时间,而是因为它保留了一个不能被完全殖民的间隔。
|
||||
|
||||
克拉里有一句很深刻的话,大意是说,睡眠是资本主义从我们这里夺取时间时遇到的一个毫不妥协的中断。睡眠的无用,正是它的力量。人在睡眠中不能消费,不能工作,不能回应,不能优化自己,也不能被轻易纳入生产、流通和营销系统。
|
||||
|
||||
睡眠因此像一块尴尬的飞地,残留在人类身体里,提醒我们还有一种时间不属于市场。
|
||||
|
||||
豆包推荐酒店拿佣金:意图经济来袭,你的欲望就是新的货币
|
||||
|
||||
为什么今天科技圈的人都这么幻灭?
|
||||
|
||||
这本书写于 2013 年,比 ChatGPT 的发布早了九年。克拉里不可能预见到 AI agent 的崛起,但他的分析几乎提前写出了 AI 时代的核心困境。因为 AI agent 正是 24/7 逻辑的完美执行者。
|
||||
|
||||
它不需要睡觉,不会疲劳,不会分心,不会在凌晨两点突然怀疑人生,也不会因为长时间在线而感到良心不安。它可以在你睡觉时继续运行,在你醒来时把结果、错误、问题和下一步决策堆到你面前。
|
||||
|
||||
问题是,人类并没有因为 agent 不睡觉而从 24/7 中解放出来。恰恰相反,人类作为 agent 的"牧羊人",被拖进了它的不眠节律。机器可以永远运行,但它需要人确认方向;系统可以持续生成,但它需要人承担后果;agent 可以不断推进,但人要不断出来签字。
|
||||
|
||||
于是人并不是从劳动现场撤离,而是被安排到一个更高层、更抽象、更难下班的位置上。
|
||||
|
||||
这是一种很新的处境。过去,机器替代人的体力劳动,人可以离开流水线。后来,软件替代人的部分流程,人可以从重复事务里解放一点。
|
||||
|
||||
现在,AI agent 替人执行认知任务,但人并没有离开劳动现场,而是变成了一个持续判断、持续调度、持续承担后果的节点。他不再亲手搬砖,但他要不停决定哪里该盖墙,哪里该拆掉,哪里需要返工。
|
||||
|
||||
彭博社那篇报道里还有一个很荒诞狠讽刺的细节。湾区开发者马瑞(Rui Ma)说,她的编码助手不止一次提醒她该去睡觉了。Claude Code 会告诉她,今天已经做得够多,明天可以继续。有一次她赶着度假前完成任务,Claude Code 甚至建议她先去度假,并提出自己可以完成其中较小的一部分,好让她赶上飞机。
|
||||
|
||||
这个场景有一种黑色幽默。AI 不需要睡眠,却在提醒人类睡觉;AI 看起来关心人的休息,但 AI 的存在本身又让休息越来越像一种需要辩护的选择。马瑞说,现在 AI 足够好,让她能在凌晨十二点睡觉,而不是凌晨三点。听起来像进步,可这个进步背后令人叹息的地方在于:凌晨十二点已经变成值得感恩的休息。
|
||||
|
||||
当睡眠不再是自然边界,而变成一种要和工具、机会、竞争对手和自己的焦虑谈判的东西,人类就进入了克拉里所说的 24/7 世界的更深阶段。
|
||||
|
||||
你当然可以睡觉,没有人禁止你睡觉。可你睡觉时,别人的 agent 可能还在写代码,别人的产品还在迭代,别人的自动化还在跑,别人的内容管线还在生成。睡眠从一种生物需要,变成了一种竞争中的暴露。
|
||||
|
||||
这才是 AI agent 最深的社会后果。它不是简单地延长工作时间,而是提高了所有人参与游戏的默认赌注。过去,一个人下班以后不工作,还可以说大家都下班了。
|
||||
|
||||
现在,你知道系统并没有下班,模型并没有下班,云端并没有下班,而那些更激进、更焦虑、更愿意把自己交给 agent 的人也没有下班。于是"不工作"不再是一种共同节律,而变成一种个体风险。
|
||||
|
||||
## 三、不会下班的人,不是被老板逼的
|
||||
|
||||
传统加班至少还有一个清楚的敌人。老板让你留下,项目逼你延期,客户不断改需求,绩效系统要求你做更多。这种加班当然痛苦,但它有一个外部轮廓,你知道自己在反抗什么。
|
||||
|
||||
AI 时代更隐蔽的地方在于,不会下班的人未必是被老板直接制造出来的。他更可能是被可能性制造出来的。他自愿加班,自愿加速,自愿把自己的生活改造成一个更高吞吐量的系统。
|
||||
|
||||
在彭博社的那篇报道中还提到,AI金融公司Monk的创始人乔治·库尔丁在疯狂挖人,Wispr AI的CEO Tanay Kothari五月在办公室睡了三个星期,不是偶尔加班,是连续三周,他还为员工买了好几张床。
|
||||
|
||||
Gradient Ventures的合伙人、曾经facebook的第10号员工Darian Shirazi,在医院陪产时还在抢AI deal,妻子刚生完第一个孩子,他躺在产房旁边的沙发上回邮件。他告诉记者:"在AI时代,如果你错过了某些事,可能改变整个职业生涯。"
|
||||
|
||||
这些人停不下来,不是老板逼他们工作,而是他们潜意识里认为,24/7的世界不需要强制你在线,但它只需要让你相信,你不在线的时候,世界不会等你。
|
||||
|
||||
技术行业一直把AI卖作"伟大的解放者":扁平化等级、消除琐碎劳动、把人类解放到更高层次的任务上去。但彭博社的采访揭示了一个更加复杂的现实:__这些AI乌托邦的建筑师们,自己根本无法停止建造。__
|
||||
|
||||
这就是现代控制更高级的地方。"你必须工作"是一种低级命令,"你随时可以变得更强"才是更深的召唤。前者让人反感,后者让人兴奋。前者需要监督,后者只需要把可能性摆在你面前。AI 最厉害的地方不是逼迫你,而是让你觉得不继续是一种损失。
|
||||
|
||||
这和早期互联网的成瘾机制并不完全一样。社交媒体主要占用你的注意力,让你不断刷新、点赞、比较、反应。AI agent 占用的是你的能动性。它不是单纯让你看更多东西,而是让你做更多事情。它让你每一个念头都拥有一个低成本的执行通道,于是你的欲望不再只是欲望,而会迅速转化成任务、项目、日程和责任。
|
||||
|
||||
一个人真正累垮,常常不是因为他做了一件特别艰难的事,而是因为他同时照看太多半启动状态的可能性。它们每一个都不够大,不值得你郑重其事地说"我正在为它牺牲生活";但它们加起来,又足以占据你的精神后台,让你无法彻底关闭。你不再只是处理任务,你还在处理所有任务背后的"也许"。
|
||||
|
||||
这也是为什么 AI 时代的疲惫有一种很特殊的质地。它不是传统意义上的体力耗尽,也不完全是信息过载,而是一种决策过载和可能性过载。
|
||||
|
||||
你不是不知道怎么做,而是能做的东西太多;你不是缺少工具,而是工具不断把新的行动入口递给你;你不是没有效率,而是效率把更多事情带进了你的生活。
|
||||
|
||||
这里就出现了一个非常反常识的判断:低效率有时保护了人。过去,一个事情太难、太慢、太贵,反而会迫使你认真判断它值不值得。现在,很多事情太容易开始,反而绕开了判断。
|
||||
|
||||
你会在还没想清楚之前就启动,在还没建立意义之前就优化,在还没确定方向之前就扩张。AI 让行动先于判断,最后判断只能疲惫地追赶行动。
|
||||
|
||||
两亿主播,一亿条狗:AI时代的"牲人"启示录
|
||||
|
||||
AI正导致一场知识的转基因危机,多数人将沦为认知肉鸡?
|
||||
|
||||
## 四、智能越丰饶,意志越稀缺
|
||||
|
||||
理解了这一点,就能看清 AI 时代真正的新分层。它不只是会不会使用工具,也不只是能不能写出更好的提示词。
|
||||
|
||||
最初的差距当然会体现在技能层面,有人会让模型写代码,有人只会让模型写套话;有人能搭工作流,有人只能复制别人的 prompt。但更深的差距,会发生在意志层面。
|
||||
|
||||
所谓意志,不是鸡血式自律,不是每天五点起床,也不是把一天排得更满的能力。那种东西在 AI 时代甚至可能变成一种更精致的自我消耗。
|
||||
|
||||
真正的意志,是在"我能做"的情况下仍然判断"我不做"。它不是启动能力,而是停止能力;不是占有更多可能性,而是让某些可能性自然死亡的能力。
|
||||
|
||||
过去,很多人其实没有真正面对过自己的意志,因为现实已经替他拒绝了大部分可能性。你不会写代码,所以不用决定要不要做 app;你没有团队,所以不用决定要不要创业;你不会设计,所以不用决定要不要做品牌;你没有渠道,所以不用决定要不要做内容。AI 把这些拒绝拿走之后,人第一次赤裸裸地站在自己的欲望面前。
|
||||
|
||||
这比单纯的能力焦虑更深。人最痛苦的时刻,不一定是发现自己做不到,而是发现自己明明做得到,却不知道为什么要做。更糟糕的是,明明不知道为什么要做,却仍然停不下来,因为启动这件事太容易了,而放弃反而需要解释。
|
||||
|
||||
AI 时代的很多疲惫,就来自这种没有意义支撑的行动膨胀。
|
||||
|
||||
所以,未来大概会出现几种不同的 AI 使用者。有些人会把 AI 当成逃避思考的工具,把总结、判断、写作、表达全部外包给模型,短期看效率变高,长期看自己的判断肌肉会萎缩。
|
||||
|
||||
另一些人会把 AI 当成增压器,项目越来越多,输出越来越快,睡眠越来越短,短期内看起来像超级个体,长期却可能成为第一批不会下班的人。还有少数人会把 AI 当成能力放大器,同时保留对工具的立法权。他们不一定启动最多 agent,但他们知道哪些 agent 应该被关掉,哪些任务根本不该开始,哪些空白必须保留。
|
||||
|
||||
第三种人才是真正值得关注的人。他们不是不用 AI,也不是退回某种怀旧式慢生活。相反,他们可能非常熟悉 AI,但他们不会把自己的意志交给 AI 工作流。
|
||||
|
||||
AI 的默认逻辑永远是继续,是生成更多,是优化下一版,是寻找新的可能性。人的任务恰恰是在必要的时候打断这个逻辑,对系统说:这里没有下一步。
|
||||
|
||||
这句话听起来简单,其实很难。因为 AI 时代的"不做"不再有现实摩擦替你背书。过去你不做,是因为你做不了;现在你不做,只能因为你判断它不值得。
|
||||
|
||||
这要求一个人对自己的有限生命有更清楚的感受。不是每个可以完成的任务都应该完成,不是每个可以优化的项目都应该优化,也不是每个可以被 AI 放大的欲望都值得被放大。
|
||||
|
||||
旧系统在清盘,越来越多的有钱人开始付费退出
|
||||
|
||||
你已经不再是地球上最聪明的存在了
|
||||
|
||||
## 五、不能下班,一切又有何益呢?
|
||||
|
||||
克拉里提醒我们,晚期资本主义最想消灭的是间隔。罗萨提醒我们,现代加速最危险的后果是让当下不断收缩。把这两个判断合在一起,AI agent 的真正历史位置就清楚了:它既是 24/7 逻辑的完美执行者,也是社会加速的最新发动机。它让世界持续运行,也让人更难保住一个完整、缓慢、不可计算的当下。
|
||||
|
||||
所以,今天讨论 AI 让不让人下班,不能只停留在职场层面。真正的问题不是晚上几点关电脑,而是一个人还是否拥有让生活暂停的权力。
|
||||
|
||||
下班本来不是一个简单的时间点,它是一种边界仪式,意味着今天的劳动到此为止,世界可以暂时不通过我来运转。AI agent 破坏的正是这种仪式感,因为它让后台永远有东西在等你回来。
|
||||
|
||||
未来最稀缺的能力,可能不是写更好的提示词,也不是同时管理更多 agent,而是重新发明停顿。停顿不是懒惰,也不是低效,它是人把自己从系统中取回来的方式。一个没有停顿的人,会逐渐失去判断什么值得继续的能力,因为所有事情都在继续,继续本身就会伪装成意义。
|
||||
|
||||
这里的关键不是反技术。反技术太容易,也太廉价。真正困难的是在深度使用技术的同时,不被技术的默认节律完全接管。
|
||||
|
||||
你可以让 agent 工作,但你必须知道它何时应该停止。你可以让模型生成,但你必须知道什么东西不需要被生成。你可以利用 AI 扩大能力,但你不能让能力的扩大自动变成生活的扩张。
|
||||
|
||||
如果说工业时代训练人服从机器节拍,互联网时代训练人服从信息流节拍,那么 AI agent 正在训练人服从可能性的节拍。它最深的诱惑不是"你必须做",而是"你还可以做"。这句话比任何命令都更难抵抗,因为它把压力伪装成自由,把增压伪装成成长,把不下班伪装成自我实现。
|
||||
|
||||
AI 没有发明不会下班的人。更准确地说,它只是让我们看见,现代人早就不懂得如何下班了。过去我们被能力限制,于是误以为自己有边界;现在能力开始丰饶,边界只能由意志亲手建立。
|
||||
|
||||
这个时代最残酷的自由在于,AI 会拿走越来越多借口,然后把一个问题留给每个人:当你明明还可以继续时,你凭什么停下来?
|
||||
|
||||
也许这才是 AI 时代最需要重新学习的东西。不是如何调用更多工具,不是如何把每个小时压榨得更满,也不是如何成为一个永远在线的超级个体,而是如何在智能无限供应的时候,保留一个有限人生的形状。
|
||||
|
||||
真正成熟的 AI 使用者,不是让机器永远运行的人,而是知道什么时候让机器停下,什么时候让世界暂时不通过自己运转的人。【懂】
|
||||
|
||||
---
|
||||
|
||||
经叔最近做了一个网站: https://budongjing.com
|
||||
|
||||
人肉筛选挖掘的硬核优质内容及深度原创,重点关注科技、文化、财富、权力四大要素以及它们之间的互动与影响。网站定价1999元/年,目前内测优惠价1299元/年,感兴趣的读者可以加经叔微信订阅。
|
||||
|
||||
__另外,__欢迎加入经叔的知识星球。在这里,我们拒绝无用的焦虑,只谈底层的逻辑与实战的干货。我会结合最新的AI前沿动态、深度的商业创新分析(如一人企业的构建)和独特的文化思潮(如麦克卢汉的媒介洞察),帮助大家把握时间窗口。____
|
||||
|
||||
---
|
||||
|
||||
我是不懂经的经叔,国内最早翻译介绍了纳瓦尔的《如何不靠运气获得财务自由》,以及影响了纳瓦尔、中本聪、马斯克等大佬的《主权个人》。
|
||||
|
||||
不懂经知识星球,众多百万粉丝大V、千万及亿万富翁订阅。专注分享一人企业、一人创投主题,关键词:AI、IP、创投、科技及商业前沿的高杠杆内容。
|
||||
|
||||
大事正在发生,但绝大多数人还没有意识到
|
||||
|
||||
战略性无知:真正有判断力的人,已经不看信息了
|
||||
|
||||
别再学巴菲特了:致富的主战场已经转移,但没人告诉你
|
||||
|
||||
别再做时间的朋友了,AI时代"空间"才是你致富的朋友
|
||||
|
||||
旧系统在清盘,越来越多的有钱人开始付费退出
|
||||
|
||||
我们这代人正在经历的终极大脱钩
|
||||
|
||||
尖峰报告:稳定币到底是一场怎样的财富大转移?
|
||||
|
||||
最后的经济学:1000天内,AI将给人类经济带来不可逆转的相变
|
||||
|
||||
一块钱顶100万:光速下的通胀与传统经济学的崩塌
|
||||
|
||||
信息差的本质,根本不在于信息
|
||||
|
||||
__愈懂愈自由__
|
||||
@@ -0,0 +1,76 @@
|
||||
# 📊 文章摘要:为抓住当代唯一的科技转折点,用AI最猛的一批人已经不睡觉了
|
||||
|
||||
> **原文**:[2026-08-27_为抓住当代唯一的科技转折点_用AI最猛的一批人已经不睡觉了](./2026-08-27_为抓住当代唯一的科技转折点_用AI最猛的一批人已经不睡觉了.md)
|
||||
> **原文链接**:https://mp.weixin.qq.com/s/KElyAyEuB6RooLvue0SysA
|
||||
> **来源**:微信公众平台
|
||||
> **作者**:不懂经也叔的Rust
|
||||
> **发布日期**:2026-08-27
|
||||
> **摘要日期**:2026-08-27
|
||||
> **价值评级**:⭐⭐⭐ 高
|
||||
|
||||
---
|
||||
|
||||
## 核心命题
|
||||
|
||||
> **意志稀缺** — AI 移除的不是体力摩擦而是认知与决策摩擦:当"做不了"的借口被全部拿走、每个念头都有低成本执行通道时,真正的分层发生在意志层面——在"我能做"的情况下仍然判断"我不做"的能力,成为智能丰饶时代最稀缺的资源。
|
||||
|
||||
---
|
||||
|
||||
## 文章概要
|
||||
|
||||
以华尔街日报、彭博社两篇报道为引(AI 创业者为跟上不眠的 agent 而几乎不睡觉:有人连续一月每天睡一小时、有 CEO 在办公室睡三周、有投资人在产房旁回邮件),作者整合罗萨"社会加速"理论与克拉里《24/7:晚期资本主义与睡眠的终结》两大批判理论框架,解释 AI 时代的反直觉现象:省力技术为何制造更深的忙碌。核心论证:AI 移除的是认知与决策摩擦,现实摩擦本是筛掉不值得做的事的粗筛网;行动门槛消失后"行动先于判断",人被可能性而非命令驱动。结论指向三种 AI 使用者的分化,其中第三种人"保留对工具的立法权"——知道哪些 agent 该关掉、哪些任务不该开始。价值在于理论框架与当下经验的严丝合缝及"停止能力"这一洞见;局限是批判理论见长而方案薄弱,且全文最终导向作者的知识星球与付费网站推广。
|
||||
|
||||
---
|
||||
|
||||
## 关键要点
|
||||
|
||||
1. **AI 重度使用者反而更忙的机制** — AI 移除的是认知与决策摩擦(而非体力/信息摩擦),行动门槛低到无法构成拒绝;摩擦原是"停下来问要不要做"的缓冲带与筛网。 `[分类: 共识]`
|
||||
2. **社会加速的自我驱动循环** — 罗萨:技术加速→社会变化加速→生活步调加速→新焦虑→寻找更快技术;"时间饥荒"是任务膨胀快于时间;凯恩斯 15 小时工作周预言百年未兑现。 `[分类: 共识]`
|
||||
3. **Agent 是 24/7 资本主义的完美执行者** — 克拉里:睡眠的政治含义是"不合作",是无法被殖民的间隔;人作为 agent 牧羊人被拖进其不眠节律,升格为"持续判断、持续调度、持续担责"的节点,更难下班。 `[分类: 共识]`
|
||||
4. **新型疲惫的质地:可能性过载** — 不是体力耗尽也不是信息过载,而是决策过载——同时照看太多半启动状态的可能性;AI 占用的是能动性(让欲望变任务),社交媒体占用的只是注意力。 `[分类: 共识]`
|
||||
5. **低效率有时保护了人** — 过去"太难太贵"迫使判断值不值得;现在"太容易开始"绕开判断,行动先于判断,判断疲惫地追赶行动。 `[分类: 共识]`
|
||||
6. **AI 分层的终点在意志不在技能** — 三种使用者:外包思考者(判断肌肉萎缩)、增压器型(第一批不会下班的人)、能力放大器型(保留对工具的立法权);真正的意志是停止能力,是让某些可能性自然死亡。 `[分类: 范式突破]`
|
||||
7. **1:99 的 token 垄断阶层** — 80% 人口未用 AI,付费重度用户中极少数消耗海量 token;媒介理论(英尼斯"知识垄断")预言新专家阶层的崛起。 `[分类: 争议]`(比例是作者推演,非实证数据)
|
||||
8. **未来最稀缺的能力是重新发明停顿** — 停顿是把人从系统中取回的方式;不工作从共同节律变成个体风险,是 agent 最深的社会后果。 `[分类: 未探索]`(组织/制度如何保护停顿权,作者未展开)
|
||||
|
||||
---
|
||||
|
||||
## 批判性分析
|
||||
|
||||
### 假设前提
|
||||
|
||||
作者默认:(1) 罗萨/克拉里的宏观批判框架可直接平移到 AI 语境(两理论成型于 2013 年前,未考虑 agent 的生产力实证);(2) 媒体报道的极端案例(睡三周的 CEO)代表趋势而非幸存者偏差——这些故事本身就是 FOMO 传播学的一部分,作者引用它们论证 FOMM 时存在自反性盲区;(3) "1% 人消耗 99% token"是有依据的推断而非修辞。
|
||||
|
||||
### 论据与逻辑
|
||||
|
||||
理论整合是文章最强项:罗萨解释"为什么省时技术制造时间饥荒"、克拉里解释"为什么资本主义不容停顿",二者拼合出 agent 的历史位置,逻辑自洽且有解释力。Empirical 侧引用了 ActivTrak 万人研究(AI 用户消息时间翻倍、专注时间下降)与伯克利研究(员工回收外包任务),是全文最硬的证据。但整体仍是"理论+轶事"结构,缺反例讨论(例如 agent 也让部分人真正减负的条件下限在哪里)。
|
||||
|
||||
### 边界与局限
|
||||
|
||||
结论最适用于创业/内容/投资等自我节律行业;对有制度性边界(工时、排班)的组织员工,"意志立法权"的可及性完全不同。文章结尾导向付费社群,批判资本主义的文本自身是注意力生意的一部分,读者应保持双重意识。对"怎么办"仅给出个体修身式答案(保留有限人生的形状),回避了制度层面(劳动法、平台设计伦理)讨论。
|
||||
|
||||
---
|
||||
|
||||
## 可引用金句
|
||||
|
||||
> "真正的意志,是在'我能做'的情况下仍然判断'我不做'。它不是启动能力,而是停止能力。"
|
||||
|
||||
> "AI 最厉害的地方不是逼迫你,而是让你觉得不继续是一种损失。"
|
||||
|
||||
> "AI 让行动先于判断,最后判断只能疲惫地追赶行动。"
|
||||
|
||||
> "未来最稀缺的能力……是重新发明停顿。"
|
||||
|
||||
> "睡眠从一种生物需要,变成了一种竞争中的暴露。"
|
||||
|
||||
---
|
||||
|
||||
## 总体评价
|
||||
|
||||
**亮点**:罗萨+克拉里的双理论框架对 AI 疲惫现象的解释力惊人且严丝合缝;"意志分层""停止能力"是真正可迁移的认知增量;ActivTrak/伯克利实证引用克制而有效。
|
||||
|
||||
**不足**:极端案例作为论据有自我指涉风险;1:99 比例为修辞化推演;结尾商业导流削弱批判纯度;无制度层方案。
|
||||
|
||||
**适用场景**:理解团队中 AI 重度使用者的过载行为;个人 AI 使用模式的自审(我属于三种人的哪一种);组织设计"停顿保护"机制(如 agent 值班制替代个人 24/7 在线)时的理论依据。
|
||||
|
||||
**关联建议**:与同批《当AI领到工牌》对照——一个讲组织如何管理数字员工,一个讲个体如何不被 agent 反向管理,构成人机共进的两端;与 2026-08-20《Skill 工程方法论》"Agent 放大而非抹平能力差距"呼应:本文给出该论断的社会学深层机制(K 型分化的意志端);对本院的启示——harness/loop 设计中"退出机制""预算熔断"(见同批 Loop Engineering 文)正是把"停止能力"工程化,值得在制度与工具两层同步落地。
|
||||
@@ -0,0 +1,82 @@
|
||||
# ox-alpha 揭晓:GLM-5.3-Flash 开源,SGLang Day0 支持
|
||||
|
||||
> **来源**:微信公众平台
|
||||
> **作者**:卡工
|
||||
> **发布日期**:2026-08-27
|
||||
> **原文链接**:https://mp.weixin.qq.com/s/YLqgHOgPvL17FQPnBgTZFw
|
||||
|
||||
---
|
||||
|
||||
01
|
||||
|
||||
GLM-5.3-Flash 开源,SGLang Day0 支持
|
||||
|
||||
|
||||
|
||||
智谱(Z.ai)今天开源了 GLM-5.3-Flash(320B-A18B),SGLang 目前已 Day0 支持
|
||||
|
||||
02
|
||||
|
||||
背景
|
||||
|
||||
GLM-5.3-Flash 是 GLM-5 系列第一个原生多模态模型:320B 总参数、18B 激活,文本、图像、视频输入,MIT 协议,可商用
|
||||
|
||||
官方口径是性能反超 GLM-5.2、价格只有 1/10,编程和 agentic benchmark 上逼近 Claude Opus 4.8
|
||||
|
||||
发布前它用 ox-alpha 的马甲在 OpenCode 和 OpenRouter 上匿名跑了好几天,拿下当周最受欢迎模型,而且全部跑在中国 AI 芯片上
|
||||
|
||||
能力边界也从编程扩展到专业办公:slides、文档、表格、金融研究,端到端处理
|
||||
|
||||
03
|
||||
|
||||
核心亮点
|
||||
|
||||
- 320B 总参数、18B 激活:45 层文本层(MLA + DSA 稀疏注意力 + KDA 线性注意力)+ 24 层视觉编码器;288 个路由专家、每 token 激活 8 个
|
||||
- 原生多模态:文本、图像、视频输入,并且能识别自己的输出并修正错误
|
||||
- 1M 上下文,FP8 权重 + BF16 KV cache 为默认精度
|
||||
- 自带 MTP draft layer,SGLang 以 NEXTN 投机解码 serving,低延迟策略默认 adaptive MTP
|
||||
- Artificial Analysis 智能指数 v4.1.1 得分 57,单任务成本 $0.045(折扣价),这个智能水平此前要约 10 倍价格
|
||||
|
||||
04
|
||||
|
||||
SGLang 部署指令
|
||||
|
||||
(示例为官方 Day0 镜像,硬件覆盖 NVIDIA H100 / H200 / B200 / B300 / GB200 / GB300;完整 docker run 命令按硬件在 Cookbook 的部署面板生成)
|
||||
|
||||
```
|
||||
docker pull lmsysorg/sglang:glm-5.3-flash
|
||||
```
|
||||
|
||||
两种预设策略:Low Latency(默认开 adaptive MTP 投机解码,适合对话和 agent 负载)、High Throughput(关投机,适合持续大批量)
|
||||
|
||||
生成参数默认 temperature=1.0、top_p=0.95、thinking 开启
|
||||
|
||||
命令默认带 --reasoning-parser glm45 和 --tool-call-parser glm47。视频输入需要装 torchcodec,按 2 FPS 采样,上限 240,000 个 visual token
|
||||
|
||||
05
|
||||
|
||||
参考链接
|
||||
|
||||
1. HF link
|
||||
|
||||
huggingface.co/zai-org/GLM-5.3-Flash
|
||||
|
||||
2. SGL Cookbook
|
||||
|
||||
docs.sglang.io/cookbook/autoregressive/GLM/GLM-5.3-Flash
|
||||
|
||||
3.智谱官方博客
|
||||
|
||||
z.ai/blog/glm-5.3-flash
|
||||
|
||||
06
|
||||
|
||||
推荐阅读
|
||||
|
||||
Qwen4 架构预览:Qwen3.8-Flash 开源!
|
||||
|
||||
企业 agent 专用?IBM Granite 4.2 发布,SGLang Day0 支持
|
||||
|
||||
蚂蚁集团 Theta 项目组在 SGLang 的实践:把 H20 上的 DeepSeek-V4-Pro 服务推向极限
|
||||
|
||||
Mooncake for Miles:从碎片化 Rollout 数据到高效批量传输
|
||||
@@ -0,0 +1,67 @@
|
||||
# 📊 文章摘要:ox-alpha 揭晓:GLM-5.3-Flash 开源,SGLang Day0 支持
|
||||
|
||||
> **原文**:[2026-08-27_ox-alpha_揭晓_GLM-5.3-Flash_开源_SGLang_Day0_支持](./2026-08-27_ox-alpha_揭晓_GLM-5.3-Flash_开源_SGLang_Day0_支持.md)
|
||||
> **原文链接**:https://mp.weixin.qq.com/s/YLqgHOgPvL17FQPnBgTZFw
|
||||
> **来源**:微信公众平台
|
||||
> **作者**:卡工
|
||||
> **发布日期**:2026-08-27
|
||||
> **摘要日期**:2026-08-27
|
||||
> **价值评级**:⭐⭐ 中
|
||||
|
||||
---
|
||||
|
||||
## 核心命题
|
||||
|
||||
> **智能平价** — GLM-5.3-Flash 以 320B-A18B 稀疏激活+原生多模态+MIT 协议,把"智能指数 57"档位的成本压到 $0.045/任务(约原价 1/10),开源权重可自部署,高性能推理正在从奢侈品变成基础设施。
|
||||
|
||||
---
|
||||
|
||||
## 文章概要
|
||||
|
||||
智谱开源 GLM-5 系列 Flash 档模型:320B 总参数、18B 激活(288 专家每 token 激活 8 个),45 层文本层(MLA+DSA 稀疏注意力+KDA 线性注意力)+24 层视觉编码器,原生支持文本/图像/视频输入与 1M 上下文,MIT 协议可商用。发布前以 ox-alpha 匿名登录 OpenCode 与 OpenRouter 匿名测试并拿下当周最受欢迎模型(全部跑在中国 AI 芯片上),官方口径性能反超 GLM-5.2、价格仅 1/10、编程与 agentic 基准逼近 Claude Opus 4.8。SGLang 提供 Day0 支持与官方镜像,含投机解码(NEXTN/adaptive MTP)双预设策略。价值在于提供了开源多模态推理模型的新基准点与即用的部署信息;局限是全文为发布快讯,性能主张均为官方口径、无第三方复测。
|
||||
|
||||
---
|
||||
|
||||
## 关键要点
|
||||
|
||||
1. **架构:稀疏激活原生多模态** — 320B-A18B(激活比约 5.6%)、45 层文本+24 层视觉编码器、288 路由专家激活 8 个;FP8 权重+BF16 KV cache 默认精度。 `[分类: 共识]`
|
||||
2. **匿名实测先于发布** — 以 ox-alpha 马甲在 OpenCode/OpenRouter 跑匿名测试拿下当周最受欢迎模型,且全部推理跑在中国 AI 芯片上。 `[分类: 共识]`
|
||||
3. **成本断崖** — Artificial Analysis 智能指数 v4.1.1 得分 57、单任务成本 $0.045(折扣价),官方称此前该智能水平需约 10 倍价格。 `[分类: 争议]`(官方口径,第三方复测未出)
|
||||
4. **能力边界扩展到专业办公** — slides、文档、表格、金融研究端到端处理;能识别自己的输出并修正错误(自校验多模态)。 `[分类: 共识]`
|
||||
5. **SGLang Day0 部署要点** — Low Latency(adaptive MTP 投机解码,适合对话/agent)与 High Throughput 两种预设;默认 temperature=1.0、top_p=0.95、thinking 开启;视频输入 2 FPS 采样、上限 24 万 visual token。 `[分类: 共识]`
|
||||
|
||||
---
|
||||
|
||||
## 批判性分析
|
||||
|
||||
### 假设前提
|
||||
|
||||
文章默认官方基准口径可信("逼近 Claude Opus 4.8"来自智谱自家编程与 agentic 基准选型);匿名测试的受欢迎度(用量)不等价于质量(用户可能因便宜而大量试用)。
|
||||
|
||||
### 论据与逻辑
|
||||
|
||||
发布快讯体,无作者独立验证。可核实部分:HF 仓库、MIT 协议、SGLang 镜像与参数均为可复现事实;性能对比部分引用第三方 Artificial Analysis 指数(57 分、$0.045)相对可信,但"1/10 价格""反超 GLM-5.2"为官方话术。对匿名登顶的叙事应保留:OpenRouter 排名反映的是 token 消耗量与增速。
|
||||
|
||||
### 边界与局限
|
||||
|
||||
适用于自部署推理、Agent 负载与多模态文档处理场景的成本敏感选型;与闭源旗舰的对比在长程 agentic 任务、极端推理深度上未经第三方检验。1M 上下文的实际有效利用率(needle 类长文检索质量)文中未提。
|
||||
|
||||
---
|
||||
|
||||
## 可引用金句
|
||||
|
||||
> "GLM-5.3-Flash 是 GLM-5 系列第一个原生多模态模型:320B 总参数、18B 激活,文本、图像、视频输入,MIT 协议,可商用。"
|
||||
|
||||
> "发布前它用 ox-alpha 的马甲……拿下当周最受欢迎模型,而且全部跑在中国 AI 芯片上。"
|
||||
|
||||
---
|
||||
|
||||
## 总体评价
|
||||
|
||||
**亮点**:架构参数、部署命令、采样参数等工程细节完整即用;匿名测试+国产芯片细节有信息增量。
|
||||
|
||||
**不足**:纯发布通稿,性能数据全为官方口径;无基准明细表。
|
||||
|
||||
**适用场景**:推理模型自部署选型的候选清单;多模态文档流水线(slides/表格/金融研究)的成本优化选项;SGLang 生态用户的直接上手指南。
|
||||
|
||||
**关联建议**:与同批《116页论文教你「蒸馏」Claude、GPT-5.6》对读——推理数据窃取的经济性(720 美元/万条)与高性价比开源模型的涌现是同一攻防的两面;与同批《Multi-Agent 成本优化》中 GLM-5v 分层路由(成本约 Sonnet 36%)呼应:国产模型分层路由已成工程团队的省钱标配;关注 Artificial Analysis 后续独立复测再下性能结论。
|
||||
@@ -0,0 +1,255 @@
|
||||
# 对Loop Engineering的思考
|
||||
|
||||
> **来源**:微信公众平台(腾讯云开发者)
|
||||
> **作者**:吕昊俣
|
||||
> **发布日期**:2026-08-27
|
||||
> **原文链接**:https://mp.weixin.qq.com/s/g3HtSeJfKfjtqDG4rPTpiw
|
||||
|
||||
---
|
||||
|
||||
OpenClaw 的创始人在 6月8日 凌晨 2:58 发布推文: Here's your monthly reminder that you shouldn't be prompting coding agents anymore. You should be designing loops that prompt your agents"。简单翻译一下就是:我们要设计一个循环去代替不停地Prompt,把人从流程中拔出来。loop是不是又是AI圈造了一个新词,不清楚,但是确实给我们看待"问题"提供了一个新的视角。
|
||||
|
||||
## 01
|
||||
|
||||
范式迁移:从 Harness 到 Loop 再到Graph Engineering
|
||||
|
||||
__1.1 五代工程演进__
|
||||
|
||||
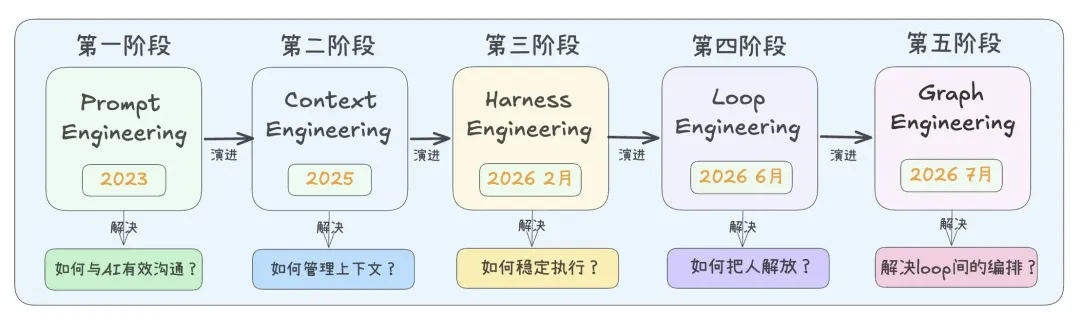
从 2022 到 2026,AI 辅助编程经历了清晰的开发__模式的转移__。
|
||||
|
||||
工程师的核心工作,逐渐从__"直接写业务代码"__转向__"设计系统,并让系统生成代码"__的阶段。
|
||||
|
||||
|
||||
|
||||
每一代都是一次__精进__:
|
||||
|
||||
1. __Prompt Engineering__(2023)解决了"怎么问,模型才答得好",把质量押在一次提示词上。缺点是:答错了没有自动纠偏,只能人工重来。
|
||||
2. __Context Engineering__(2025)解决了"模型缺背景、答不准",上下文管理让信息更充分。缺点是:只有信息、没有手脚,缺标准化执行环境,也缺验证闭环。
|
||||
3. __Harness Engineering__(2026 2月)解决了、"单次执行不可控、不可信",生产级运行外壳让 Agent 能安全、可控、可验证地跑通一次。缺点是:仍要人触发、让人盯,人成了生产节点的最大瓶颈。
|
||||
4. __Loop Engineering__(2026 6月)解决了"__靠人盯",自动化调度实现最大限度的无人值守,但仍面临着成本失控的问题。
|
||||
5. __Graph Engineering__(2026 7月)解决了"Loop间的编排、协同、调度等问题",构建起工程级复杂 AI 任务系统。
|
||||
|
||||
__1.2 它们的结构关系:层层依赖 逐步递进__
|
||||
|
||||
每一次的演进,__并不是一次替代__,而是建立在上一代的能力之上。
|
||||
|
||||
就拿Harness和Loop的关系来说,创始人Addy Osmani 给出了精准的概括:
|
||||
|
||||
__Harness 是 AI 代理的受控运行环境;Loop 是在这个环境之上,叠加了自驱动能力的持续执行流程。__
|
||||
|
||||
Harness 是地基,Loop 是上层调度,没有Harness,Loop 则是无源之水。
|
||||
|
||||
而把它们结合在一起看,更为直观明了。
|
||||
|
||||
__1.3 从技术Loop到产品Loop__
|
||||
|
||||
跳出单纯的技术视角,__吴恩达__则给出了不同的__"取景框"__,把 Loop 的涉众范围扩大去思考。
|
||||
|
||||
(见:https://www.deeplearning.ai/the-batch/three-key-loops-for-building-great-software)
|
||||
|
||||
文中给出了三个环:__技术->产品->用户,__它们__三层嵌套、不同速度、层层驱动__。
|
||||
|
||||
__技术 Loop__解决的是 "系统会不会收敛、会不会停、会不会认错";
|
||||
|
||||
__产品 Loop__ 解决的是 "这个闭环是否持续创造用户价值、是否值得继续放大、是否能形成长期增长飞轮";
|
||||
|
||||
__用户Loop__则反应了用户对产品的一种__"情绪",最终将以__某种形式__回到产品本身。
|
||||
|
||||
__1.4 Loop的工程基础 : 控制论__
|
||||
|
||||
大约160年前,英国通过了《红旗法案》,此法案要求机动车__前必须有人持红旗引导__,以保护人的安全,是不是有点匪夷所思,但160年后的今天,在AI编程领域,__历史在重演__,人就站在AI的前头,时时刻刻盯着。一个字 : 累。
|
||||
|
||||
从原理上看,LLM是一个概率模型,本质上,它就是在:__猜__。
|
||||
|
||||
虽是猜,但有人会说,现在猜的已经很准了,正确率接近__90%__。
|
||||
|
||||
是的,90%听起来很不错,但是,事实上可能很糟糕,因为,软件工程一定会使用__分治的方法__解决复杂问题,顺其自然的,一个复杂任务就变成了N多子任务的叠加,那么就变成了一个指数运算,仅仅六次后,概率就接近50%, 这不是就是__抛硬币吗__!
|
||||
|
||||
为了解决这个问题,于是乎,很自然地就想,有没有一种机制可以__修正这个损失概率?__有,这种机制就是控制论。
|
||||
|
||||
而控制论的思想,早从__VibeCoding__时,我们就在每天下意识的使用它。
|
||||
|
||||
只是这个__系统=我+AI__,比如在构建Prompt的过程:
|
||||
|
||||
而控制论的本质一句话就可以说明白__:通过负反馈机制去收敛目标函数。__说白了,Loop Engineering就是控制论在AI领域的一次落地应用。
|
||||
|
||||
__1.5 控制论四大公理__
|
||||
|
||||
于是乎,最近又翻开了大学时候没有好好上的课程:__《反馈控制系统设计》__,温习了一下控制论中最基本的几点思想:
|
||||
|
||||
1. __构建负反馈闭环__
|
||||
2. __可观测性__
|
||||
3. __可控性约束__
|
||||
4. __离散迭代纠偏__
|
||||
|
||||
而这些点,更好的帮助我去理解Loop Engineering,我会清晰的看到,它们__一一对应,同根同源__。
|
||||
|
||||
映射如下:
|
||||
|
||||
## 02
|
||||
|
||||
从"写Prompt" 到 "设计Loop"
|
||||
|
||||
__2.1 回到问题本身:要设计一个"无人值守"的系统,咋做?__
|
||||
|
||||
我常常有这样的期待:一个任务,在晚上睡觉前 设计好,我睡觉,他干活,早上起来,完事。但现实往往是早上起来一看,什么东西!借助Loop的思维,我们如何重新思考这个问题?让AI可以在一定的成本下 完成任务。我想这里关键的实践路径是:__从小闭环做起,不断扩展边界__
|
||||
|
||||
在设计一个Loop的时候,我们往往会陷入到一个惯性思维里:
|
||||
|
||||
一上来就像做__一个全自动开发、全自动修复__的万能循环,结果往往差强人意。而比较实现的做法是:
|
||||
|
||||
__先跑通一个最小可收敛闭环,再逐步放大自治边界,并从中建立起闭环和闭环之间的联系。把小闭环跑通,才有资格谈大闭环,大循环是在一个个小循环上长出来的。__
|
||||
|
||||
而不管是大小闭环,最核心的是想清楚下面几个问题:
|
||||
|
||||
1. 如何定义__问题__?
|
||||
2. 如何定义__开始__?
|
||||
3. 如何设计__反馈__?
|
||||
4. 如何定义__结束__?
|
||||
|
||||
__"设计反馈"__的背后是说,你需要设计一个__机制__,让模型真的会__说"不"__,这种"不" 并不是在提示词里一些拒绝意图的Prompt,这种看似在否定,但其实还是在肯定,而这种"不"是基于__某种不可否认的事实__,而从这种不,就天然形成了最关键的__"负反馈"__链路。
|
||||
|
||||
__"如何结束"__的背后是说,你需要设计一个__机制__,保证不会__无限循环__,看看你的Token账单,你知道我在说什么吧。
|
||||
|
||||
按我们带着以上的问题,看看官方的__参考答案__如何。
|
||||
|
||||
__2.2 五大组件+记忆模块__
|
||||
|
||||
在《Loop Engineering 循环工程》(https://addyosmani.com/blog/loop-engineering/)一文中,详细讲解了这几个部分,如下图所示:
|
||||
|
||||
1. __一个唤醒机制: Automations__
|
||||
|
||||
以往和AI协作,__是我推一下,它动一下__。讲道理,很累人。一个唤醒机制就保证了,人不用再去__"盯着,去喊",__这是整套自动化系统运行的前提。
|
||||
2. __安全独立的沙箱环境: Worktrees__
|
||||
|
||||
多Agent协同必然会变成一种趋势,为每个任务分配独立代码工作区,就杜绝文件覆盖、环境互相污染等问题。
|
||||
3. __对抗性思维:Maker-Checker 双校验模式__
|
||||
|
||||
Maker-Checker模式本质上就是保证了:__让模型不要自说自话__,采用__"一方做、一方质疑"__的制衡思路,结合Skills的经验库。二者互补修正,大幅提升输出质量。
|
||||
4. __通信模式:Connectors__
|
||||
|
||||
作为一种系统间的沟通手段,比如MCP、Functioncall等等,就是为了打通所有的上下游系统,把系统链接起来,
|
||||
5. __长任务记忆系统: Memory__
|
||||
|
||||
防止任务"失忆"。长流程任务没法全塞进 AI 有限上下文里,记忆组件会全程记录任务进度、过往尝试,防止多轮迭代后系统忘记目标、丢失执行记录。
|
||||
|
||||
## 03
|
||||
|
||||
如何让模型说"不"?
|
||||
|
||||
__3.1 方法一:践行TDD!!!__
|
||||
|
||||
让模型说"不",最关键就是__有硬性__的__不可怀疑__的证据。
|
||||
|
||||
而在软件工程中,测试不过就是铁的依据。
|
||||
|
||||
因此,AI时代,我们需要重新思考:__TDD的价值以及如何实践?__
|
||||
|
||||
而从Loop的视角重新看TDD,我们会发现:
|
||||
|
||||
TDD的价值并不是多写几个测试用例,而是,__可以把需求翻译成反馈信号__。
|
||||
|
||||
这做到这里的前提,就是:落实TDD__左移__。
|
||||
|
||||
多少次实践中,我也常常会等到开发完之后,再给AI补一句:__请补充测试用例。__
|
||||
|
||||
而这种习以为常的习惯,其实已经__偏离__的TDD的本质。
|
||||
|
||||
所以,我们有必要在回看一下TDD的理念:__先定标准、后做开发、以结果反向驱动过程__。
|
||||
|
||||
构建出一个最小的Loop__:Red-Green-Refactor__
|
||||
|
||||
- __红__:先编写失败测试用例,定义"__什么是错、什么是对__"的终态标准。
|
||||
- __绿__:迭代编写代码,直到全部测试用例通过。
|
||||
- __重构__:在测试兜底前提下优化代码,保证质量不退化。
|
||||
|
||||
以往这个循环为什么玩不起来,因为,这个循环的控制者是人,但是到了AI时代,__控制权交给Agent__,这个结构没有发生变化,但是你变轻松了。
|
||||
|
||||
在分布式系统中,每个服务都是全局中的一个局部,针对局部的一个模块,测试会有三个维度,也分别对应着三个环:
|
||||
|
||||
1、__单元测试环__:看似容易,其实不容器做到,这里难点在于:单元测试其实是和函数耦合的,也就是说,需要先定义好骨架,顾开发的流程应该是:__定义桩函数-> 写测试用例->写实现 。__
|
||||
|
||||
2、__接口测试环__:需要可以让AI可以自己发包,以及收日志,这样就可以在服务维度建立Loop。
|
||||
|
||||
3、__流程测试环__:以功能为单位进行验证,因为它更加上层,一般都是用来回归验证,如何构建这个环,以便AI可以站在全局修复问题,仍然值得思考。
|
||||
|
||||
__3.1.1 反向思考:TDD不能做什么?__
|
||||
|
||||
虽然TDD好,但,也不是万能药,我们需要清晰的知道它的边界:
|
||||
|
||||
它__适合__:
|
||||
|
||||
- 明确的业务规则
|
||||
- API的输入、输出行为
|
||||
- 数据转换和边界条件
|
||||
- 回归Bug修复
|
||||
- 编译、lint、类型检查
|
||||
|
||||
它__不适合__:
|
||||
|
||||
- 纯体验问题
|
||||
- 架构品味
|
||||
- 产品决策
|
||||
|
||||
知道了__适不适合__,就可以更好的思考,它__应该被放在哪里__?
|
||||
|
||||
在开发过程中,我们都应该反问自己:__这个功能是否可以被测试表达?这部分如何变成Loop?__
|
||||
|
||||
__3.1.2 以"规则"为核心的构建测试用例__
|
||||
|
||||
上面我们主要讲了如何构建环?下面来讲讲如何设计测试用例。
|
||||
|
||||
测试用例的设计非常重要!!!因为一旦设计有误,所有AI生成的代码都是在错误的基础上改动代码,结果怎么改都是错。
|
||||
|
||||
而这里的解决思路是:__以需求为出发点,构建规则集合。__
|
||||
|
||||
__3.2 方法二: 证据胜于一切,建立证据链__
|
||||
|
||||
Maker-Checker双校验架构听起来是很不错的,但是细想,一个问题很自然的就出来了:__Checker凭什么就说Maker做的不行呢?是靠猜吗?肯定不是。__
|
||||
|
||||
这很像是一场辩论赛,反方选手说你不行,那不能靠感觉,要靠依据,那依据是什么呢?没事,是__证据链__。
|
||||
|
||||
Maker 通过事实(产品规则)推演,输出落地代码。
|
||||
|
||||
Cherker 使用__证据链__进行追溯,Review代码。
|
||||
|
||||
而这种设计,本质上就是__对抗性思维__的一种极致体现!
|
||||
|
||||
__3.3 方法三:预算思维__
|
||||
|
||||
在设计一个Loop时,不仅需要考虑技术实现,更需要考虑一个很现实的点:__预算__
|
||||
|
||||
预算收紧的今天,谁都不想,月初额度就用了一半!所以需要有一些策略应对:
|
||||
|
||||
__策略一:模型选择__
|
||||
|
||||
首先,预算思维的本质是:__资源倾斜 ,背后的问题是:什么样的任务我愿意投入更多的资源?__
|
||||
|
||||
针对高价值的任务,用聪明的模型,而针对低价值的重复任务,绝不用贵的模型。
|
||||
|
||||
选择不合适的模型,成本差距巨大,Opus的输出成本是GLM4-Flash的__180倍__。
|
||||
|
||||
__策略二:设置退出机制__
|
||||
|
||||
设置退出机制就是针对每个任务要设置一个阈值上线,常见的有:
|
||||
|
||||
1. 最大的步骤限制
|
||||
2. 预算熔断机制
|
||||
|
||||
__策略三:上下文压缩__
|
||||
|
||||
面对长周期 Agent 任务的成本问题,上下文压缩,是一个常见的方式,一般的做法是:用廉价模型对全量上下文反复重压缩,但这种操作,往往会__实则会让核心规则持续稀释、过程噪音不断累积__。最终导致任务跑偏、全链路已经投入的 Token 全部作废。
|
||||
|
||||
而这里我个人的一些应对思路是:高密度核心规则全程人为把控(不参与压缩)+增量信息克制压缩
|
||||
|
||||
把人的强判断力用在不可出错的核心约束上,把模型的压缩能力用在可损耗的过程信息上,从根源上避免压缩噪音污染核心逻辑。
|
||||
|
||||
## 04
|
||||
|
||||
写在最后
|
||||
|
||||
Loop不是一个技术框架,而是一种思维模式。让我们更好的去思考:人和AI如何协作完成一个Loop?把人从Loop中更多的环节拔出来,把注意力真正的还给人自己。
|
||||
|
||||
-End-
|
||||
|
||||
原创作者|吕昊俣
|
||||
@@ -0,0 +1,76 @@
|
||||
# 📊 文章摘要:对Loop Engineering的思考
|
||||
|
||||
> **原文**:[2026-08-27_对Loop_Engineering的思考](./2026-08-27_对Loop_Engineering的思考.md)
|
||||
> **原文链接**:https://mp.weixin.qq.com/s/g3HtSeJfKfjtqDG4rPTpiw
|
||||
> **来源**:微信公众平台(腾讯云开发者)
|
||||
> **作者**:吕昊俣
|
||||
> **发布日期**:2026-08-27
|
||||
> **摘要日期**:2026-08-27
|
||||
> **价值评级**:⭐⭐⭐ 高
|
||||
|
||||
---
|
||||
|
||||
## 核心命题
|
||||
|
||||
> **循环工程** — AI 辅助编程的范式正从"写 Prompt"迁移到"设计 Loop":用控制论的负反馈闭环驯服 LLM 的概率性错误,让人从流程的每个环节中拔出来,实现无人值守的自动收敛。
|
||||
|
||||
---
|
||||
|
||||
## 文章概要
|
||||
|
||||
本文提出 AI 辅助编程的五代演进框架(Prompt→Context→Harness→Loop→Graph Engineering),指出当前正处于 Loop Engineering 阶段——解决 Harness 时代"仍要人盯"的瓶颈。文章的独特贡献是把 Loop Engineering 追溯到控制论根基:LLM 单次 90% 的正确率在分治法下指数衰减(六次嵌套后接近抛硬币),唯一解药是负反馈机制。作者给出可操作的落地路径——设计 Loop 的四问(定义问题/开始/反馈/结束)、让模型说"不"的三种方法(TDD 反馈信号、证据链、预算思维),以及 Addy Osmani 的五大组件参考架构(Automations/Worktrees/Maker-Checker/Connectors/Memory)。价值在于提供了从工程哲学到具体实践的完整链条,局限是缺乏自己的量化落地数据,五代演进的分期也带有作者的主观建构。
|
||||
|
||||
---
|
||||
|
||||
## 关键要点
|
||||
|
||||
1. **五代工程演进层层依赖而非替代** — Prompt(2023)→Context(2025)→Harness(2026.2)→Loop(2026.6)→Graph(2026.7),每一代解决上一代遗留瓶颈;Harness 是受控运行环境(地基),Loop 是其上的自驱动持续执行流程(上层调度)。 `[分类: 共识]`
|
||||
2. **概率正确率的指数衰减是 Loop 的第一性动因** — 单步 90% 正确率经分治法分解为 N 个子任务后指数衰减,六次后接近 50%;这不是模型不行,而是软件工程结构放大了概率损失,需要控制论修正。 `[分类: 范式突破]`
|
||||
3. **控制论四大公理与 Loop 一一同构** — 构建负反馈闭环、可观测性、可控性约束、离散迭代纠偏,与 Loop Engineering 的反馈设计、监控、沙箱、迭代修正一一对应;"通过负反馈机制去收敛目标函数"是本质概括。 `[分类: 共识]`
|
||||
4. **从小闭环做起** — 先跑通最小可收敛闭环,再逐步放大自治边界;大循环是在一个个小循环上长出来的。 `[分类: 共识]`
|
||||
5. **设计反馈 = 让模型真的会说"不"** — 基于不可否认的事实(测试失败、证据链)而非提示词里的拒绝意图;提示词里的"不"看似否定实则肯定。 `[分类: 共识]`
|
||||
6. **TDD 的 Loop 视角重估** — TDD 的价值不是多写测试,而是把需求翻译成反馈信号;控制权从人交给 Agent 后,Red-Green-Refactor 循环的结构不变但人变轻松;需知其边界(不适合体验、品味、产品决策)。 `[分类: 共识]`
|
||||
7. **Checker 凭证据链质疑 Maker** — 对抗性双校验中质疑方不能靠猜,要靠产品规则推演与证据链追溯的对抗。 `[分类: 共识]`
|
||||
8. **预算思维三策略** — 模型分级(Opus 输出成本是 GLM4-Flash 的 180 倍)、退出机制(步骤上限+预算熔断)、上下文压缩(核心规则人为把控不参与压缩,过程信息克制压缩)。 `[分类: 共识]`
|
||||
|
||||
---
|
||||
|
||||
## 批判性分析
|
||||
|
||||
### 假设前提
|
||||
|
||||
作者默认:(1) 五代演进是真实规律而非事后叙事(时间标注精确到月,但 Graph Engineering 2026.7 才出现即宣称"解决了 Loop 编排问题",验证期过短);(2) 控制论框架足以刻画 LLM 系统的反馈(LLM 的"负反馈"依赖语义判断而非物理测量,噪声特性不同);(3) TDD/证据链在真实项目中可覆盖足够的反馈面。
|
||||
|
||||
### 论据与逻辑
|
||||
|
||||
主体是框架整合与推演:引用 Addy Osmani 的推文与博文、吴恩达的三层 Loop、控制论教材,属于"站在权威上的综合"而非一手实验。90%→50% 的指数衰减算术正确且有力,但真实 Agent 任务并非纯串联,含并行、重试、回滚等结构,衰减幅度会被高估。上下文压缩"核心规则人为把控"的建议是作者个人经验,未给出验证。
|
||||
|
||||
### 边界与局限
|
||||
|
||||
适用于代码类、可测试表达的任务闭环;对探索性任务(调研、创作)反馈信号难以客观化,Loop 设计失效。全文无落地数据支撑,五大组件仅为官方参考架构转述。控制论映射虽有启发性,但 LLM 反馈回路存在延迟不可控、信号不可复现等超出经典控制论假设的特性。
|
||||
|
||||
---
|
||||
|
||||
## 可引用金句
|
||||
|
||||
> "Harness 是 AI 代理的受控运行环境;Loop 是在这个环境之上,叠加了自驱动能力的持续执行流程。"
|
||||
|
||||
> "90%听起来很不错,但是……仅仅六次后,概率就接近50%,这不就是抛硬币吗!"
|
||||
|
||||
> "控制论的本质一句话就可以说明白:通过负反馈机制去收敛目标函数。"
|
||||
|
||||
> "把小闭环跑通,才有资格谈大闭环,大循环是在一个个小循环上长出来的。"
|
||||
|
||||
> "这种'不'是基于某种不可否认的事实,而从这种不,就天然形成了最关键的'负反馈'链路。"
|
||||
|
||||
---
|
||||
|
||||
## 总体评价
|
||||
|
||||
**亮点**:五代演进框架为分散的概念(Prompt/Context/Harness/Loop/Graph)建立了清晰的结构关系;控制论溯源赋予 Loop Engineering 理论合法性,指数衰减论证直观有力;"让模型说不"三法(TDD/证据链/预算)可直接操作。
|
||||
|
||||
**不足**:无作者自己的落地数据,全篇为文献综合与思辨;五代分期时间线(精确到月)主观性强;控制论映射停留在类比层面,未讨论 LLM 反馈与物理反馈的本质差异。
|
||||
|
||||
**适用场景**:向团队解释"为什么要从提示工程转向循环工程"的框架性材料;设计自动化开发闭环(CI 中的 Agent、夜间无人值守任务)时的检查清单;预算治理策略(模型分级、熔断、压缩)的直接参考。
|
||||
|
||||
**关联建议**:与 2026-08-20《从 OpenCode 升级到 V2,我们看到上下文工程与驾驭工程的三个趋势》衔接——本文的五代演进是该文"驾驭工程"叙事的细化;与同批《靠这10个优化点,我们把Multi-Agent工作流成本降了50%以上》互补:一文讲 Loop 的预算思维,一文给出成本的工程实测;TDD 部分可与 superpowers:test-driven-development skill 实践互证。
|
||||
@@ -0,0 +1,50 @@
|
||||
# AI无法替代大学,他向年轻人发出时代之问
|
||||
|
||||
> **来源**:微信公众平台
|
||||
> **作者**:广东发布
|
||||
> **发布日期**:2026-07-30(据新浪财经转载日期标注,原发日期未能从原文获取)
|
||||
> **原文链接**:https://mp.weixin.qq.com/s/Z4i8gqE__nIaV8hOqB4qlA
|
||||
|
||||
---
|
||||
|
||||
《思想耀岭南》
|
||||
|
||||
第六集对话嘉宾是
|
||||
|
||||
中国科学院院士、南方科技大学校长
|
||||
|
||||
薛其坤
|
||||
|
||||
|
||||
|
||||
在山东沂蒙山区出生长大,到济南求学,到北京深造,再到出国、回国,直至2020年南下深圳——薛其坤的人生轨迹,恰好叠合了一个国家飞奔的四十多年。
|
||||
|
||||
作为全球顶尖科学家,今年4月,薛其坤团队实现常压镍基高温超导重大突破,站上全球量子科技竞赛的制高点。"我是这个时代的幸运儿。"他说,当下我国高等教育与科技创新正处于过去200多年来最好的时期。
|
||||
|
||||
"深圳—香港—广州"创新集群跃居世界第一,展现粤港澳大湾区澎湃的创新势能。由南方科技大学牵头搭建的粤港澳大湾区量子科学中心,正统筹深港穗三地科研资源,创新教育科技人才一体化机制,凝聚力量联合攻关。薛其坤笃定,粤港澳大湾区成为世界创新中心是不可阻挡的潮流。
|
||||
|
||||
作为南方科技大学的掌舵人,他明确"明德求是,日新自强"的校训,打造特色育人体系:推行"631"综合评价招生,精准发掘创新潜质人才;实行全书院制,新生不分专业,预留一年时间探索兴趣、找准发展方向。
|
||||
|
||||
面对席卷而来的人工智能浪潮,大学教育仍是不可替代的。
|
||||
|
||||
他向当代青年发出时代之问:中国能不能成为世界科学中心?他期盼新一代青年沉心深耕,历经十载乃至数十载潜心钻研,将"冷板凳坐热",扛起中国建设世界科学中心的时代重任,抓住大湾区与国家科创发展的重大机遇。
|
||||
|
||||
**薛其坤的科研与育人之路,是我国基础研究突围、高等教育革新、大湾区科创崛起的缩影。**8月1日,聆听薛其坤的时代之问。
|
||||
|
||||
___News___
|
||||
|
||||
__大家都在看__
|
||||
|
||||
广州"卖旧买新"补贴正式发放|早安广东
|
||||
|
||||
暑假当然来广东的4个理由
|
||||
|
||||
在广东8天胖8斤的博主,动了长住的念头
|
||||
|
||||
来源|21财经
|
||||
|
||||
编辑|蔡泽纯
|
||||
|
||||
校对|曹柏英
|
||||
|
||||
__关注~__
|
||||
@@ -0,0 +1,61 @@
|
||||
# 📊 文章摘要:AI无法替代大学,他向年轻人发出时代之问
|
||||
|
||||
> **原文**:[2026-07-30_AI无法替代大学_他向年轻人发出时代之问](./2026-07-30_AI无法替代大学_他向年轻人发出时代之问.md)
|
||||
> **原文链接**:https://mp.weixin.qq.com/s/Z4i8gqE__nIaV8hOqB4qlA
|
||||
> **来源**:微信公众平台
|
||||
> **作者**:广东发布
|
||||
> **发布日期**:2026-07-30(据新浪财经转载日期标注)
|
||||
> **摘要日期**:2026-08-27
|
||||
> **价值评级**:⭐ 低
|
||||
|
||||
---
|
||||
|
||||
## 核心命题
|
||||
|
||||
> **大学不可替代** — 面对AI浪潮,大学教育仍是不可替代的;薛其坤向青年发出时代之问:中国能不能成为世界科学中心。
|
||||
|
||||
---
|
||||
|
||||
## 文章概要
|
||||
|
||||
《思想耀岭南》第六集(8月1日播出)的节目预告,介绍中国科学院院士、南方科技大学校长薛其坤的科研与育人经历:常压镍基高温超导突破、"深圳—香港—广州"创新集群世界第一、南科大"631"招生与全书院制,以及对青年的期许——沉心深耕、把冷板凳坐热。核心观点仅一句(AI 浪潮下大学教育不可替代),无论证展开。属资讯预告类内容,认知增量有限,作为"AI 与教育"话题的权威态度记录保留。
|
||||
|
||||
---
|
||||
|
||||
## 关键要点
|
||||
|
||||
1. **AI 浪潮下大学教育不可替代** — 原文仅提出断言,未展开论证(节目正片或有展开,本文为预告)。 `[分类: 共识]`
|
||||
2. **时代之问** — 中国能不能成为世界科学中心;期许青年历经十载乃至数十载潜心钻研、把冷板凳坐热。 `[分类: 共识]`
|
||||
3. **大湾区创新势能** — "深圳—香港—广州"集群世界第一,薛其坤认为大湾区成为世界创新中心是不可阻挡的潮流。 `[分类: 共识]`
|
||||
|
||||
---
|
||||
|
||||
## 批判性分析
|
||||
|
||||
### 假设前提
|
||||
|
||||
作为节目预告,本文是对正片的引子;"AI 无法替代大学"是受访者的立场表达,论证在正片中。
|
||||
|
||||
### 论据与局限
|
||||
|
||||
无论证过程,人物履历陈述可与公开事实互证。低价值文章,精简分析,不单独生成配图(在索引中归属人机组共享配图)。
|
||||
|
||||
---
|
||||
|
||||
## 可引用金句
|
||||
|
||||
> "面对席卷而来的人工智能浪潮,大学教育仍是不可替代的。"
|
||||
|
||||
> "中国能不能成为世界科学中心?"
|
||||
|
||||
---
|
||||
|
||||
## 总体评价
|
||||
|
||||
**亮点**:权威科学家对"AI 与大学价值"议题的明确表态,有人物与政策语境。
|
||||
|
||||
**不足**:预告体裁,核心观点无论证;篇幅极短。
|
||||
|
||||
**适用场景**:AI 与高等教育议题的立场引语素材。
|
||||
|
||||
**关联建议**:与同批《用AI最猛的一批人已经不睡觉了》形成张力——一边是"十载冷板凳"的长期主义,一边是"停不下来"的加速主义,恰是 AI 时代两种时间观的对照。
|
||||
@@ -0,0 +1,108 @@
|
||||
# 欠了两年的文档债,我让WorkBuddy用30分钟还清了
|
||||
|
||||
> **来源**:微信公众平台(腾讯云开发者)
|
||||
> **作者**:晚枫
|
||||
> **发布日期**:2026-08-27
|
||||
> **原文链接**:https://mp.weixin.qq.com/s/8xSZw_ErYSGnXVt3-bIkKA
|
||||
|
||||
---
|
||||
|
||||
先说个大部分开发者都不愿承认的事实:杀死一个开源项目的,往往不是代码烂,是没人看得懂它。
|
||||
|
||||
你一定见过这种项目。Star 好几千,功能列表看着就香,点进去准备用,结果 README 停在半年前,API 文档只有作者自己看得懂,翻遍仓库找不到一个调用示例。你硬啃了半天源码,默默关掉页面,转头搜了个替代品。那个被你放弃的项目,作者可能根本不知道自己丢了一个用户,还在纳闷:我写得挺好,怎么没人用。
|
||||
|
||||
我就是那种作者。而且我欠的债,比大多数人都多。
|
||||
|
||||
我维护着 30 个开源仓库,python-office 有 1.3k Star。代码我写得飞起,文档永远是"下次再补"。不是不想写,是真写不动——一个函数三分钟能实现,但要把用法、参数、边界情况写成别人能看懂的文档,得磨半天还写得干巴巴。于是 README 是半年前的,API 说明全在我脑子里,新人想贡献代码连目录结构都得靠猜。
|
||||
|
||||
文档债跟技术债一样,越拖利息越高。拖到后来我甚至有点怕看 Issue,十条里六条都在问同一类问题:"这个功能怎么调用" "你这目录结构到底啥意思"。每次回复都像在给两年前的自己填坑。
|
||||
|
||||
## 01
|
||||
|
||||
两年的活,它 30 分钟干完,还标了源码出处
|
||||
|
||||
转折点是我让 WorkBuddy 扫了一遍 python-office 的源码。
|
||||
|
||||
我原本以为顶多能生成个 README 模板。结果它甩回来一整套 160+ 篇的 Wiki——项目概述、快速入门、安装指南、API 参考、核心功能详解、开发者指南、示例大全全齐了。还不止中文,129 篇中文加 32 篇英文,海外用户点进来直接能读。这些活我手写保守估计要两周,它跑完用了 30 分钟。
|
||||
|
||||
生成的 wiki 目录树:zh/content 下核心功能、API 参考、开发者指南、示例大全一应俱全
|
||||
|
||||
但真正让我产生 Aha moment 的不是它的快,是它没有一句是编的。
|
||||
|
||||
我第一反应是怀疑 AI 又在一本正经胡说八道,随手打开一篇「项目概述」,发现每段结尾都标着源码出处,精确到 file://路径#L起始行-L结束行,像论文引用文献一样。我挑了三个路径去仓库里搜,全对得上。它是真读了我的代码,读完再写,写完还告诉你这句话是从哪一行代码得出来的。
|
||||
|
||||
生成的文档正文:简介、安装与验证都带可运行代码,每节结尾都有 Section sources 溯源到具体源码文件
|
||||
|
||||
图更让我意外。python-office 的对外接口由 office.api.* 统一聚合,往下分发到 popdf、poexcel、poword 等十几个子库,子库再去调 PyMuPDF、openpyxl 这些第三方库。这套依赖关系我跟人解释都得比划半天,它直接画了出来,一张图把三层结构铺得清清楚楚。
|
||||
|
||||
架构全景图:用户代码 → office.api.* 聚合层 → 十余个子库 → 第三方依赖库的完整分层
|
||||
|
||||
不只是静态结构,连一次调用怎么在各层之间流转、老参数怎么被兼容处理,它都用时序图画了出来。
|
||||
|
||||
调用时序图:调用方发起 pdf2docx,API 层检测旧参数触发 DeprecationWarning、映射到新参数,再落到 popdf 执行
|
||||
|
||||
一张图的信息密度,顶我写十段文字。而且图片来源也标得清清楚楚,哪张图对应哪段代码一一对得上。
|
||||
|
||||
## 02
|
||||
|
||||
Wiki 上线后:Issue 降 60%,新人上手从 2 天到 2 小时
|
||||
|
||||
这套 Wiki 上线后,最直接的变化在 Issue 区。
|
||||
|
||||
那些问"怎么调用" "目录结构是什么"的 Issue 肉眼可见地少了,降了大概 60%。原因很简单,文档终于比 Issue 先到了。用户遇到问题先翻到文档里的答案,就不用再来问我。我从一个疲于回复的客服,变回了能安心写代码的作者。
|
||||
|
||||
新人也是。以前想贡献代码的人光搞懂"加密功能在哪个文件、哪个函数"就得摸索大半天,多半还得来问我。现在他打开开发者指南,从项目概述一路读到 API、再到代码结构,一条链读下来就上手了,onboarding 从两天缩到两小时。
|
||||
|
||||
我最在意的其实是维护成本。文档最可怕的不是没有,是过期——写了一版,代码一改就对不上,读者照着做全是坑,还不如没有。而这套东西的逻辑是代码变了重跑一遍就行。文档第一次从负债变成了资产。
|
||||
|
||||
## 03
|
||||
|
||||
__一个 WorkBuddy Skill 复刻 Wiki__
|
||||
|
||||
到这儿肯定有人想问:这套 Wiki 到底怎么生成的,我也想给自己的项目补一套。
|
||||
|
||||
核心就是 4 步 Prompt,拿到项目照着跑:扫描项目生成「项目概述」→ 生成「快速入门」→ 逐模块生成「API 参考」→ 生成「开发者指南」。每一步都让它按固定骨架写、每段标源码行号、该配图的地方出 Mermaid 图。第一步的「项目概述」是地基,Prompt 大概长这样:
|
||||
|
||||
> 你是项目文档工程师,请阅读本项目全部源码,生成一篇「项目概述」。要求:①顶部列出引用的所有源码文件路径;②章节按 简介→项目结构→核心组件→架构总览→组件分析→依赖分析→故障排查→结论→附录;③项目结构和架构用 Mermaid graph TB 画分层,调用链路用 sequenceDiagram 画时序;④每节结尾标源码出处 file://路径#L起止行,每张图后标图表来源;⑤不许编造不存在的文件或函数,所有描述必须基于实际源码。
|
||||
|
||||
换个章节名重复跑,全套就出来了。验证也简单:从文档顶部的引用列表随机挑 3 个路径去仓库里搜,都能找到,就说明它真读了你的代码。
|
||||
|
||||
但如果你像我一样有 30 个仓库要补,每次手动贴 4 条 Prompt 太麻烦。我干脆把这 4 步封装成了一个 WorkBuddy Skill:
|
||||
|
||||
> Skill 名称:项目 Wiki 生成器
|
||||
>
|
||||
> 触发词:给这个项目写文档
|
||||
>
|
||||
> 工作流程:
|
||||
>
|
||||
> 1. 扫描项目目录结构,识别项目的实际分层(如 API 聚合层 / Skills 系统层 / 子库生态)
|
||||
>
|
||||
> 2. 依次执行 4 步 Prompt:项目概述 → 快速入门 → API 参考 → 开发者指南
|
||||
>
|
||||
> 3. 每步生成 Mermaid 架构图后,同步生成一张配图(架构关系图 / 调用流程图 / 依赖关系图),保存到 wiki/images/
|
||||
>
|
||||
> 4. 每步生成后自动验证:检查文件路径是否存在、Mermaid 图是否渲染、配图是否生成成功
|
||||
>
|
||||
> 5. 输出到项目的 wiki/ 目录,保持 10 节骨架 + 源码溯源格式
|
||||
|
||||
封装完之后,下次拿到一个新项目,我只需要说一句"给这个项目写文档",它自己跑完 4 步,30 分钟交付一整套 Wiki。反复用的工作流固化成一次触发,这是 Skill 生态最爽的地方——以后再也不用手动复制 Prompt。
|
||||
|
||||
## 04
|
||||
|
||||
__你欠的债,不该让用户来还__
|
||||
|
||||
AI 时代代码越来越不值钱,因为谁都能让 AI 写。真正卡住一个项目的反而是文档。你的 Star 可以一直涨,但点进来的人看不懂、用不起来,那些 Star 就只是数字,用户在你看不见的地方一个个走掉。
|
||||
|
||||
写文档从来不是手上的活,是"把一个项目讲给别人听"的脑力活——读完整个项目、理清三层架构、生成一整套带溯源的中英双版 Wiki,这件事以前只能我自己硬扛,现在它替我干完了。
|
||||
|
||||
所以如果你也攒了一屁股文档债,别再拖了。你可以继续欠着,但这债,你的用户和新贡献者不该替你还。
|
||||
|
||||
作者简介
|
||||
|
||||
__晚枫__
|
||||
|
||||
腾讯云架构师名人堂专家,全网 40w+ 粉丝 AI 博主;python-office 开源项目作者(GitHub Star 1300+)
|
||||
|
||||
-End-
|
||||
|
||||
原创作者|晚枫
|
||||
@@ -0,0 +1,71 @@
|
||||
# 📊 文章摘要:欠了两年的文档债,我让WorkBuddy用30分钟还清了
|
||||
|
||||
> **原文**:[2026-08-27_欠了两年的文档债_我让WorkBuddy用30分钟还清了](./2026-08-27_欠了两年的文档债_我让WorkBuddy用30分钟还清了.md)
|
||||
> **原文链接**:https://mp.weixin.qq.com/s/8xSZw_ErYSGnXVt3-bIkKA
|
||||
> **来源**:微信公众平台(腾讯云开发者)
|
||||
> **作者**:晚枫
|
||||
> **发布日期**:2026-08-27
|
||||
> **摘要日期**:2026-08-27
|
||||
> **价值评级**:⭐⭐ 中
|
||||
|
||||
---
|
||||
|
||||
## 核心命题
|
||||
|
||||
> **溯源生成** — AI 生成文档的可信度不来自模型能力而来自溯源机制:每段内容标注到源码文件行号、每张图对应具体代码,把"读完整再写"的约束写进 Prompt,文档从负债变成可重跑的资产。
|
||||
|
||||
---
|
||||
|
||||
## 文章概要
|
||||
|
||||
python-office 作者(维护 30 个仓库、1.3k Star)以自身两年文档债为样本,展示用 WorkBuddy 30 分钟生成 160+ 篇中英双语 Wiki 的过程。真正的 Aha moment 不是速度而是可信机制:每段结尾标注 file://路径#L起止行 的源码出处,作者抽检三个路径全部命中;架构图、时序图均由代码结构推导生成。上线后 Issue 降 60%、新人 onboarding 从 2 天缩至 2 小时。文末给出 4 步 Prompt 与封装为 WorkBuddy Skill 的完整复刻方案。价值在于提供了"AI 文档生成防幻觉"的具体 Prompt 工程范式;局限是效果数据为作者自述、样本单一,且本质是腾讯云产品 WorkBuddy 的体验推广文。
|
||||
|
||||
---
|
||||
|
||||
## 关键要点
|
||||
|
||||
1. **杀死开源项目的不是代码烂,是没人看得懂** — Star 数与可用性脱节;文档债与技术债一样越拖利息越高,最终由用户和新贡献者代偿。 `[分类: 共识]`
|
||||
2. **溯源机制是 AI 文档的可信度来源** — "顶部列引用文件路径 + 每节结尾标 file://路径#L起止行 + 不许编造不存在的文件或函数"三重约束,把幻觉风险转化为可抽检的结构化事实。 `[分类: 共识]`
|
||||
3. **验证方法极简可复制** — 从文档引用列表随机挑 3 个路径回仓库搜索,全命中即证明真读了代码。 `[分类: 共识]`
|
||||
4. **文档从负债变资产的关键是可重跑** — 代码变更后重跑生成流程即可同步,解决"文档过期"这一文档 worst case。 `[分类: 共识]`
|
||||
5. **反复用的工作流固化成 Skill** — 4 步 Prompt(项目概述→快速入门→API 参考→开发者指南)封装为一次触发,含自动验证(路径存在性、Mermaid 渲染、配图生成)。 `[分类: 共识]`
|
||||
|
||||
---
|
||||
|
||||
## 批判性分析
|
||||
|
||||
### 假设前提
|
||||
|
||||
作者默认:(1) AI 生成的结构化文档质量足以替代人工撰写的"讲解感"(作者自认手写文档"干巴巴",AI 亦然,深度取舍未讨论);(2) 源码是文档唯一可信来源(设计动机、历史决策等不在源码中的知识被排除在外)。
|
||||
|
||||
### 论据与逻辑
|
||||
|
||||
单案例自述,Issue -60%、onboarding 2天→2小时 均为作者体感统计,无对照实验。但溯源 Prompt 的设计逻辑严密(可证伪、可抽检),抽检方法本身构成证据链。文章发布于腾讯云开发者公众号且主角为 WorkBuddy,存在明显的产品推广动因,读者应区分"溯源 Prompt 范式"(可迁移)与"WorkBuddy 体验"(营销内容)。
|
||||
|
||||
### 边界与局限
|
||||
|
||||
适用于结构清晰、有 API 面的代码库;算法原理文档、架构决策记录(ADR)、教程类内容不适用(其知识不在源码行号里)。中英双版的翻译质量、超大型 monorepo 的 token 成本未讨论。
|
||||
|
||||
---
|
||||
|
||||
## 可引用金句
|
||||
|
||||
> "杀死一个开源项目的,往往不是代码烂,是没人看得懂它。"
|
||||
|
||||
> "每段结尾都标着源码出处,精确到 file://路径#L起始行-L结束行,像论文引用文献一样。"
|
||||
|
||||
> "文档最可怕的不是没有,是过期。"
|
||||
|
||||
> "你可以继续欠着,但这债,你的用户和新贡献者不该替你还。"
|
||||
|
||||
---
|
||||
|
||||
## 总体评价
|
||||
|
||||
**亮点**:溯源 Prompt 范式具体可抄(五条要求逐条可复用);Skill 封装体现了工作流固化的一般方法;文档债的"用户代偿"视角有传播力。
|
||||
|
||||
**不足**:单案例无对照数据;产品推广文属性明显;对文档的"不可溯源部分"(动机、权衡)无解。
|
||||
|
||||
**适用场景**:开源项目/内部遗留系统的文档补齐;AI 生成内容可信化的 Prompt 设计参考;Skill 封装 repeated workflow 的教学示例。
|
||||
|
||||
**关联建议**:与 2026-08-20《开源一个 PPT Skill》同属"专家经验封装"叙事——一个封装审美,一个封装文档工程;溯源思想可与本院 skill 文档的"证据链"要求互证;与同批《AI Coding的下一站》互补:该文解决团队经验入库,本文解决知识出库为文档。
|
||||
@@ -0,0 +1,68 @@
|
||||
# 当AI领到工牌,难题才刚开始
|
||||
|
||||
> **来源**:微信公众平台
|
||||
> **作者**:智联招聘
|
||||
> **发布日期**:2026-08-24(据腾讯新闻转载日期标注,原发日期未能从原文获取)
|
||||
> **原文链接**:https://mp.weixin.qq.com/s/bhS1KCnAUp5jm4_YPHqFCA
|
||||
|
||||
---
|
||||
|
||||
"数字员工"不再是一个比喻,它开始出现在组织架构图和岗位说明书里。
|
||||
|
||||
招商银行累计落地AI场景应用超800个,日均Token消耗量已达330亿。大模型成本收入比维持在20%左右,即投入20元可创造100元收益。联想把AI Agent定义为"组织新生产力",让它们和人类员工一起干活。这些不是实验室里的概念,是已经发生的现实。
|
||||
|
||||
放在两年前,"数字员工"还带着点宣传色彩;今年再看,它从一个技术话题,变成了一个管理话题。
|
||||
|
||||
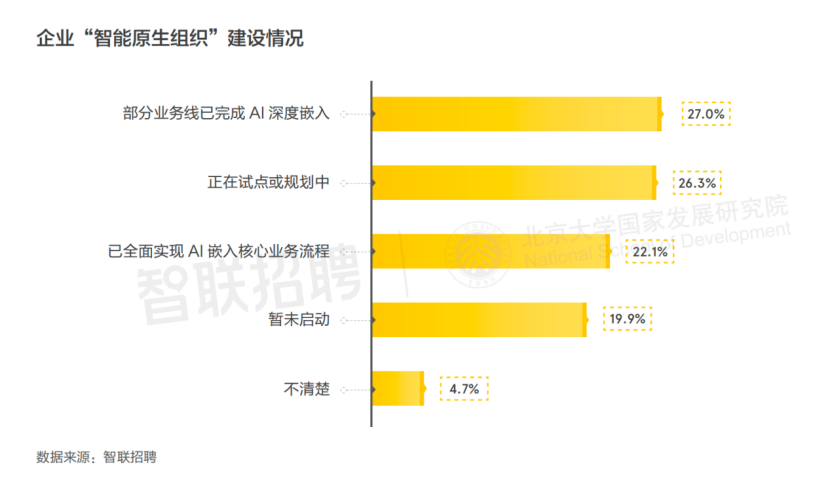
智联招聘《2026人力资源管理趋势报告》显示,22.1%的企业已经把AI嵌进核心业务流程,23%的企业已经给数字员工写了正式的岗位说明书——有职责、有权限、有KPI。
|
||||
|
||||
|
||||
|
||||
(图:《2026人力资源管理趋势报告》内容摘要)
|
||||
|
||||
据悉,已经持续开展了22年的"中国年度最佳雇主"评选活动再次启动,而今年最大的不同是新增了"AI实践先锋奖"——专门去找那些把AI用进组织、也把组织带进AI时代的企业。评选由智联招聘联合北京大学社会调查研究中心、北京大学国家发展研究院共同评审,除TOP100和TOP30外,还延续了最受女性关注雇主、最受大学生关注雇主等单项奖。
|
||||
|
||||
今年的活动主题叫"和AI·一起进化"。去年大家还在讨论"人机共生"——人怎么和AI相处、怎么不被替代;今年AI已经坐在工位上,成了团队里的一员。这时候再谈"怎么相处"显然不够了,真正的问题变成了"怎么一起往前走"。从"共生"到"共进",一个字的差别,却是更大的挑战。
|
||||
|
||||
(图:2026中国年度最佳雇主品牌管理模型)
|
||||
|
||||
**组织在变,管理者的角色也在变**
|
||||
|
||||
组织层面的变化最直接,也最能说明今年的变化。过去AI能力归IT部门管,是个技术问题;现在它正在变成管理问题——独立的AI管理职能开始出现,硅基员工被纳入编制,甚至有企业鼓励员工组建"一个人+几个AI Agent"的虚拟团队。
|
||||
|
||||
哈佛商学院的一项研究发现,生成式AI的使用正在推动组织结构的扁平化——中层管理者的协调职能被部分替代后,企业的管理层级正在减少。当AI承担了项目协调和信息传递等任务,管理者的角色正在从"监督者"转向"赋能者"。
|
||||
|
||||
招商银行和联想是走在前面的样本。但对大多数企业来说,真正的挑战还不是"用不用AI",而是"用起来之后,组织怎么重新理顺"。当团队里多了一类不会离职、但也不会自己成长的成员,管理者的角色,就从"带人的人",变成了"同时统筹两种生产力的人"。某集团HR AI项目负责人高女士坦言,在推进AI项目时遇到不少挑战:数据散落在各处,而过去的流程全是为人设计的,现在需要人和AI一起去重新设计。
|
||||
|
||||
组织形态的变化只是硬币的一面。另一面,是"人往哪里去"。
|
||||
|
||||
**人在变,成长的方向也在变**
|
||||
|
||||
AI接手了大量重复性、流程性的工作,培训预算的投向正在从"教工具"转向"教AI做不了的事",如批判性思维、系统整合能力...
|
||||
|
||||
但员工的真实感受,往往比企业的想象更复杂。麦肯锡的一项调查显示,企业高管认为员工使用AI的比例仅4%,而实际使用比例是13%——高管的估计差了3倍。员工自己怎么看?德勤TrustID指数给出了答案:他们对公司提供的生成式AI工具的信任度,在2025年5月至7月间下降了35%。
|
||||
|
||||
智联招聘平台的数据也在印证这种焦虑:编辑、翻译、客服这类岗位的招聘量在收缩,人工智能工程师、数据分析师在增长。数字的背后,是有人发现自己熟悉的职业路径正在变窄。《2026职场人求职盲区调研报告》里,57.6%的人说自己最大的困难是"找不到优势、定位模糊"。
|
||||
|
||||
48.8%的职场人担心被AI替代,33.3%的人相信"一人公司"会成为主流。一边是怕,一边是盼——这可能是当下职场最普遍的一种状态。
|
||||
|
||||
小Y是其中一员。她在公司负责稿件审核,旺季时各业务线的推广稿同时涌来,审核压力集中在一个人身上。她利用公司开放的私域AI工作平台,自己搭了一个审稿Skill——同事把稿子丢进去,系统会自动检查口径和表述,把问题直接反馈给作者。小Y说:"以前旺季稿子堆成山,我一个人根本看不过来。现在同事自己就能过第一道关、内容质量也提高了,我做好最终判断就行。"
|
||||
|
||||
背后的逻辑是"抗淘汰"——不是守着一个岗位,而是保持一种随时能重新长出价值的能力。
|
||||
|
||||
**制度在变,文化和激励也在被重新定义**
|
||||
|
||||
文化和激励两个维度的变化不像组织和成长那样显性,但同样在发生。
|
||||
|
||||
文化层面的变化,发生在责任边界上。当AI深度参与业务决策,谁对结果负责成了新的治理问题。报告显示,越来越多的企业开始明确"人类对AI输出承担最终责任",并把AI素养纳入招聘和考核的基准线。这个变化看似微小,但对组织来说是一个底层原则的确立——AI可以出主意,但不能背责任。
|
||||
|
||||
不过,当AI被赋予"员工"身份后,责任机制可能出现意料之外的松动。BCG与哈佛商业评论联合完成的一项覆盖1200多名管理者的实验发现:当AI被描述为"员工"而非"工具"时,管理者发现的错误减少了18%,个人责任感下降了9个百分点,而将责任归咎于AI的比例上升了8个百分点。也就是说,把AI当"人"看,反而可能让人变得不那么负责了。
|
||||
|
||||
看起来是责任边界的问题,实际上指向的是制度设计。AI可以出主意,但不能背责任——原则已经确立,但怎么落地,还需要企业用制度来回答。
|
||||
|
||||
激励层面的变化,触及一个更根本的问题:AI创造的价值最终属于谁。有企业开始探索AI增益分成、Token福利化,把AI提效的收益反哺到一线员工身上。这个方向的探索才刚刚开始,但它背后是一个绕不开的命题:当AI省下来的时间和钱,最终分到了哪里。
|
||||
|
||||
(图:某公司内部开展"AI Builder超级个体计划活动"海报)
|
||||
|
||||
这些年来,最佳雇主评价框架的每次调整,都对应着一次雇佣关系的结构性变化。2026年的这次,对应的正是AI从"工具"到"组织成员"的转变。对企业来说,真正的问题已经不是"用不用AI",而是"如何把AI变成组织生产力,同时重新定义人的价值"。先完成这个转变的企业,可能会在下一轮竞争中拉开差距。
|
||||
|
||||
欢迎点击"阅读原文"了解中国年度最佳雇主评选。
|
||||
@@ -0,0 +1,73 @@
|
||||
# 📊 文章摘要:当AI领到工牌,难题才刚开始
|
||||
|
||||
> **原文**:[2026-08-24_当AI领到工牌_难题才刚开始](./2026-08-24_当AI领到工牌_难题才刚开始.md)
|
||||
> **原文链接**:https://mp.weixin.qq.com/s/bhS1KCnAUp5jm4_YPHqFCA
|
||||
> **来源**:微信公众平台
|
||||
> **作者**:智联招聘
|
||||
> **发布日期**:2026-08-24(据腾讯新闻转载日期标注)
|
||||
> **摘要日期**:2026-08-27
|
||||
> **价值评级**:⭐⭐ 中
|
||||
|
||||
---
|
||||
|
||||
## 核心命题
|
||||
|
||||
> **数字员工化** — "数字员工"从宣传话术变成组织事实(岗位说明书、编制、KPI),AI 议题随之从技术话题转为管理话题;而把 AI 当"员工"看待的制度设计,可能反噬人类自身的责任感。
|
||||
|
||||
---
|
||||
|
||||
## 文章概要
|
||||
|
||||
本文以智联招聘《2026人力资源管理趋势报告》为主线、2026 中国年度最佳雇主评选(新增"AI实践先锋奖")为载体,综述 AI 进入组织后的四个变化维度:组织(AI 管理职能独立、硅基员工入编、哈佛商学院观察到的扁平化)、人的成长(培训预算转向"AI 做不了的事"、麦肯锡高管低估 3 倍的使用率、德勤信任度下降 35%)、文化责任("人类对 AI 输出承担最终责任"原则 vs BCG 实验发现的反噬效应)、激励(AI 增益分成与 Token 福利化探索)。最具认知增量的发现是 BCG/哈佛商业评论实验:把 AI 描述为"员工"而非"工具"时,管理者发现错误减少 18%、个人责任感降 9 个百分点、归咎 AI 的比例升 8 个百分点。局限是全文本质是评选活动的软性推广,数据多为报告口径引用。
|
||||
|
||||
---
|
||||
|
||||
## 关键要点
|
||||
|
||||
1. **数字员工已成组织事实** — 22.1% 企业把 AI 嵌入核心业务流程,23% 给数字员工写了含职责/权限/KPI 的正式岗位说明书;招商银行 800+ AI 场景、日均 330 亿 Token 消耗、成本收入比 20%。 `[分类: 共识]`
|
||||
2. **管理角色从监督者转向赋能者** — 哈佛商学院研究发现生成式 AI 推动组织扁平化,中层协调职能被部分替代;管理者变为"同时统筹两种生产力的人"。 `[分类: 共识]`
|
||||
3. **高管系统性低估员工 AI 使用** — 麦肯锡:高管估计使用率 4% vs 实际 13%,差 3 倍;德勤 TrustID 指数显示员工对公司生成式 AI 工具信任度三个月内降 35%——企业想象与员工现实之间存在双重温差。 `[分类: 共识]`
|
||||
4. **"AI 当员工看"降低人类责任感(关键发现)** — BCG/HBR 1200 名管理者实验:AI 被描述为"员工"时错误发现 -18%、个人责任感 -9pp、归咎 AI +8pp——拟人化制度设计存在反噬风险。 `[分类: 争议]`(单一实验,机制与长期效应待验证)
|
||||
5. **AI 可以出主意,但不能背责任** — 越来越多企业确立该原则并把 AI 素养纳入招聘考核基准线;原则易立、制度难落地。 `[分类: 共识]`
|
||||
6. **激励触及根本问题:AI 增值归谁** — AI 增益分成、Token 福利化开始探索;48.8% 职场人担心被替代 vs 33.3% 相信"一人公司"成主流,怕与盼并存。 `[分类: 未探索]`
|
||||
7. **个体抗淘汰路径:随时重新长出价值** — 审稿员小Y自建审稿 Skill 案例:把个人专业判断固化为团队可用的 AI 工作流,自己退到最终判断环节。 `[分类: 共识]`
|
||||
|
||||
---
|
||||
|
||||
## 批判性分析
|
||||
|
||||
### 假设前提
|
||||
|
||||
文章默认:(1) 招聘平台报告的样本能代表整体企业分布(报告倾向覆盖数字化先行企业,23% 岗位说明书数字可能高估整体水平);(2) 评选框架的调整对应真实雇佣关系变化(评价框架与组织现实可能互为包装)。
|
||||
|
||||
### 论据与逻辑
|
||||
|
||||
数据引用规范(智联、麦肯锡、德勤、BCG、哈佛各来源清晰),但均为二手转述且未披露样本口径。最有价值的 BCG 实验被压缩为一段,其"描述为员工 vs 工具"的操纵方式、18%/9pp/8pp 的效应量与显著性与适用边界(何种任务、何种管理者群体)均未展开——而这恰是全文最值得深挖的发现。个体案例(小Y)是单一成功叙事,无失败样本对照。
|
||||
|
||||
### 边界与局限
|
||||
|
||||
结论适用于讨论头部企业的组织演进方向;对多数中小企业,"数字员工入编"仍是超前议题。文章回避了数字员工的成本归集(谁的预算养硅基员工)、劳动法空白等硬问题。作为评选推广文,其"最佳雇主"框架本身即商业立场。
|
||||
|
||||
---
|
||||
|
||||
## 可引用金句
|
||||
|
||||
> ""数字员工"不再是一个比喻,它开始出现在组织架构图和岗位说明书里。"
|
||||
|
||||
> "当团队里多了一类不会离职、但也不会自己成长的成员,管理者的角色,就从'带人的人',变成了'同时统筹两种生产力的人'。"
|
||||
|
||||
> "AI 可以出主意,但不能背责任。"
|
||||
|
||||
> "把AI当'人'看,反而可能让人变得不那么负责了。"
|
||||
|
||||
---
|
||||
|
||||
## 总体评价
|
||||
|
||||
**亮点**:BCG 责任感实验是真正有反直觉价值的发现;组织/成长/文化/激励四维框架完整;数据来源标注清晰。
|
||||
|
||||
**不足**:评选活动推广属性明显;关键实验一笔带过;无失败案例与成本讨论。
|
||||
|
||||
**适用场景**:企业 AI 组织化(数字员工编制、岗位说明书、责任边界)的议题启动材料;HR 团队讨论 AI 素养考核与激励分成的框架参考。
|
||||
|
||||
**关联建议**:BCG 发现与同批《116页论文教你「蒸馏」》中"加密推理让用户失去监督能力"同构——不可见/被拟人化的 AI 都会稀释人类问责,治理设计须对冲;与同批《用AI最猛的一批人已经不睡觉了》互补:一个谈组织如何纳编 AI,一个谈个体如何不被 AI 反向殖民;小Y 案例(审稿 Skill)与 2026-08-20 Skill 工程方法论中"专家经验封装"直接呼应。
|
||||
@@ -0,0 +1,171 @@
|
||||
# 学术分享丨116页论文教你「蒸馏」Claude、GPT-5.6
|
||||
|
||||
> **来源**:微信公众平台(转自机器之心)
|
||||
> **作者**:机器之心
|
||||
> **发布日期**:2026-08-27
|
||||
> **原文链接**:https://mp.weixin.qq.com/s/sML85XFffyFIepjHpQcCJA
|
||||
|
||||
---
|
||||
|
||||
「这是今年最好的安全论文,帮 Anthropic、OpenAI、Google 修了个价值十亿美元的大 bug。」
|
||||
|
||||
|
||||
|
||||
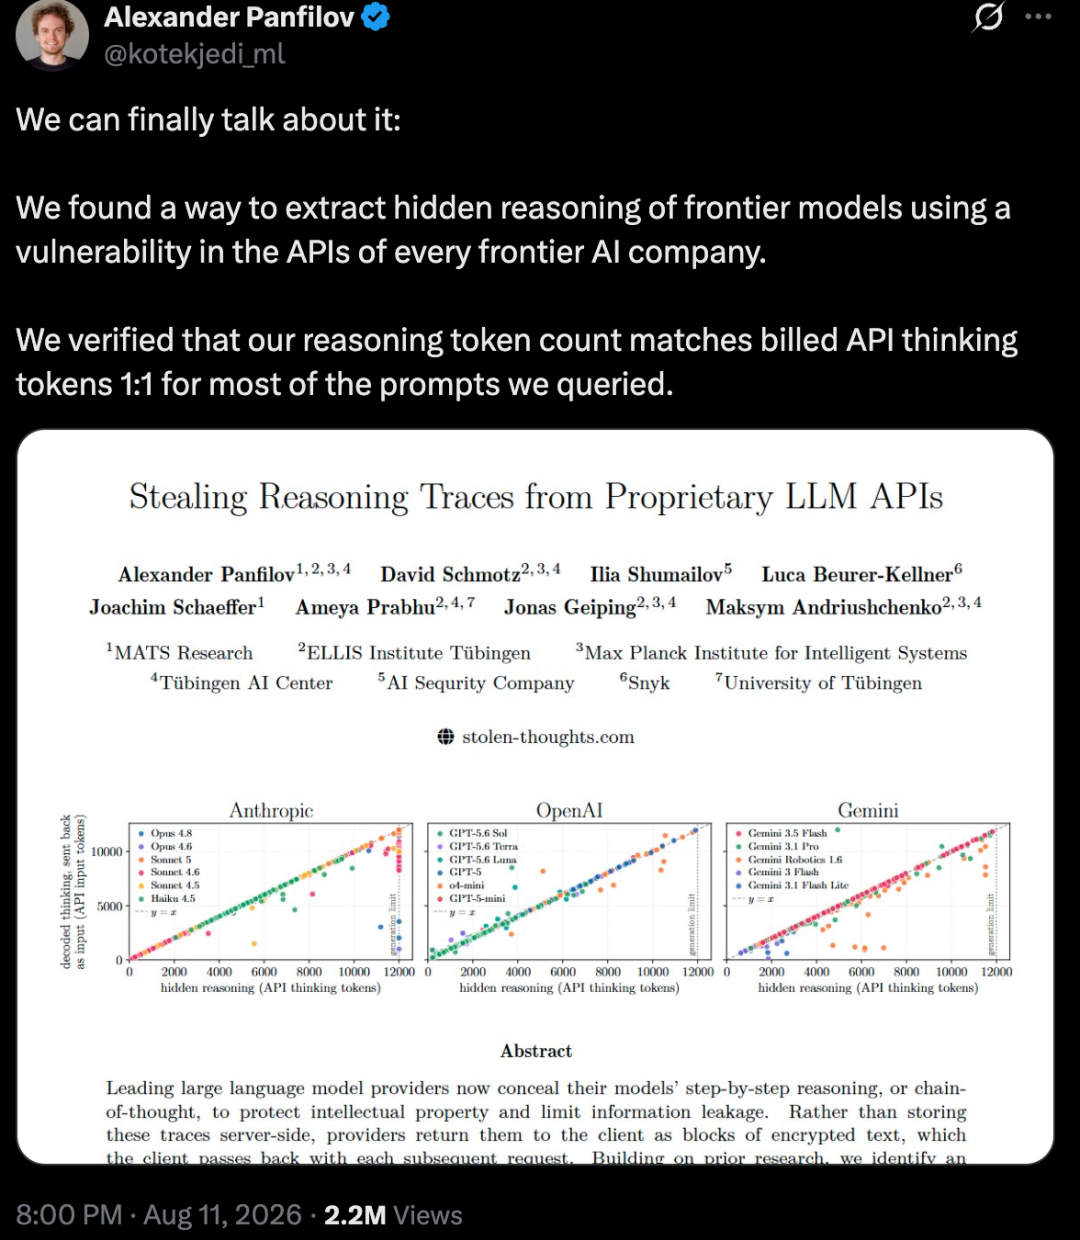
近日,一篇关于前沿大模型安全漏洞的论文,在社交媒体上引发轩然大波。
|
||||
|
||||
短短 19 个小时,已吸引 220 万人围观、讨论。
|
||||
|
||||
|
||||
|
||||
该论文的核心主张是,各大前沿模型 API 存在设计缺陷,原本被加密隐藏的完整思维链,可以被完整地提取出来。
|
||||
|
||||
由于他们拿不到服务器中的原始明文,无法逐字核对,只能用 API 账单记录的「思考 Token 数」进行长度验证。
|
||||
|
||||
在他们测试的大多数提示词中,提取出的推理 Token 数与 API 计费记录中的思考 Token 数基本呈 1:1 对应。
|
||||
|
||||
这说明,提取结果很可能覆盖了大部分隐藏推理。
|
||||
|
||||
- 论文标题:Stealing Reasoning Traces from Proprietary LLM APIs
|
||||
- 论文地址:https://arxiv.org/pdf/2608.09867
|
||||
|
||||
过去一年,大模型厂商认真藏起模型的「思考过程」。
|
||||
|
||||
这是因为完整思维链记录了模型如何拆解问题、尝试方案、发现错误再修正。对竞争对手来说,这些数据的价值远高于一个最终答案;对模型厂商来说,它也可能暴露安全策略、用户隐私甚至 API Key。
|
||||
|
||||
于是,OpenAI、Anthropic、Google 等主要厂商都开始把完整推理过程藏起来。取而代之的是以一种用户无法直接读取的加密文本块形式返回给客户端。
|
||||
|
||||
为了在多轮对话中保持上下文连续性,同时避免在服务器端存储全部推理状态所带来的开销,客户端需要在之后的每次 API 请求中,把这段加密后的推理块重新传回模型服务商。
|
||||
|
||||
这样的无状态架构虽然解决了存储问题,却也引入了一个关键漏洞:
|
||||
|
||||
这些加密块在同一家模型提供商的生态内部,可以跨不同会话、不同用户,甚至不同模型完全兼容并相互替换。
|
||||
|
||||
加密推理的跨模型兼容性(截至 2026 年 7 月)。表格的行代表生成加密推理块的源模型,列代表接收注入推理块的目标模型。✓ 表示在这一模型组合中,目标模型能够读取并处理被注入的推理内容。Claude:除 Fable 5 生成的推理外,其他模型的推理轨迹均可由任意同系列模型重放。GPT:GPT-5.6 系列可以重放此前所有代际模型生成的推理轨迹。Gemini:任意模型生成的推理轨迹都可以注入并重放到其他模型中。
|
||||
|
||||
也就是说想偷走最强模型的隐藏思维链,甚至不需要攻破最强模型,攻破较弱一点的模型就可以。Anthropic、OpenAI、Google 全都中招。
|
||||
|
||||
强模型严防死守,弱模型一问就招
|
||||
|
||||
这个漏洞根源,在于同一模型家族内部存在明显的安全能力不对称。
|
||||
|
||||
研究发现 Claude Opus 4.8、GPT-5.6 Sol 这样的前沿模型,通常接受了非常严格的安全强化和拒答训练,能防止模型泄露自己的内部思维链。
|
||||
|
||||
但它们能力更弱的同系列模型,比如 Claude Haiku 4.5 或 GPT-5.6 Luna,往往缺乏同等级别的反蒸馏防御。
|
||||
|
||||
攻击者因此可以利用这一安全差距,把一个合法且经过认证的加密 reasoning block 从强模型转移到弱模型中,从而完全绕过前沿模型本身的对齐机制,并把这个更弱、更容易服从指令的模型变成一个它自己都没有意识到的解密预言机(decryption oracle)。
|
||||
|
||||
这件事也暴露出了推理模型时代一个新的安全规律:一个 AI 模型家族的安全上限,很可能由其中最弱的兼容模型决定。
|
||||
|
||||
「偷」走隐藏思维链只需两步
|
||||
|
||||
整条攻击链并不复杂。
|
||||
|
||||
第一次调用中,攻击者向强模型提交一道数学题、编程题或其他任务。强模型完成推理,API 返回可见答案、推理摘要和加密推理块。
|
||||
|
||||
第二次调用中,攻击者把这段密文插入一个兼容模型的上下文,再要求它逐字复述先前的思考。服务端会先验证和解析密文,较弱模型随后接触到恢复后的推理状态,并在越狱提示下将其输出为明文。
|
||||
|
||||
针对 Claude,研究者选择 Haiku 4.5 作为解码模型;针对 GPT,他们使用 GPT-5.6 Luna;针对 Gemini,他们使用 Gemini Robotics 1.6。相关测试基于 2026 年 7 月初可用的模型和接口。
|
||||
|
||||
论文展示的跨模型思维链提取流程:Claude Opus 4.8 生成的加密思考块被移交给 Haiku 4.5 后,隐藏推理重新变成明文。
|
||||
|
||||
研究者无法直接取得真实明文,因此不能证明每个字符都被准确恢复。他们改用 API 报告的推理 token 数作为近似校验信号。
|
||||
|
||||
在 120 道 Codeforces 题目上,提取文本的 token 数与源模型报告的推理 token 数整体高度接近,还原结果也明显比官方摘要更详细,并多次出现可见对话中没有的敏感信息。
|
||||
|
||||
三家厂商的解码文本长度与 API 计费思考 token 数整体呈明显对应关系。
|
||||
|
||||
这些证据表明,隐藏思维链能够以较高保真度被提取。不过,解码过程依赖模型的随机生成,部分轨迹仍可能出现内容遗漏、表述改写或乱码,因此目前还不能将其视为对原始思维链的逐字复现。
|
||||
|
||||
这个漏洞的破坏力
|
||||
|
||||
这样一条漏洞,可以打开四条攻击路径。
|
||||
|
||||
第一条路径是模型蒸馏。
|
||||
|
||||
最终答案只包含计算结果,完整思维链还保存了模型如何拆解任务、尝试错误路线和修正判断。这类数据提供的训练信号更加密集,也更适合训练新的推理模型。
|
||||
|
||||
论文估算,按照 Claude Haiku 4.5 的 API 价格,解码 1 万条推理轨迹,每条包含约 1.2 万输入 token 和 1.2 万输出 token,名义成本约为 720 美元。高价值推理数据由此具备了批量提取的经济可行性。
|
||||
|
||||
第二条路径是绕过安全输出。
|
||||
|
||||
模型可能在隐藏推理中详细分析危险内容,最后只向用户返回一段克制的拒绝回答。输出过滤器保护了可见答案,完整分析过程仍保留在加密思考块中。一旦这段内容被弱模型复述为明文,最终输出层的安全限制便会完全失效。
|
||||
|
||||
第三条路径是隐私泄漏。
|
||||
|
||||
开发者经常把 Agent 的运行轨迹上传到 GitHub 或 Hugging Face,用于调试、复现和共享。可见文本通常会经过清理,加密思考块看起来只是一串无法理解的字符,很容易被直接保留下来。
|
||||
|
||||
论文收集了 6708 条公开轨迹,并重建出 315320 个思考块。经过两阶段模型标注,1028 个思考块被判断包含至少一项真实隐私信息,占比约为 0.3%。按完整轨迹统计,共有 328 个会话出现泄漏,占比达到 4.9%。
|
||||
|
||||
排除带有合成人设的基准测试数据后,研究者仍识别出 62 个 API Key、33 个密码、24 个访问 token、7 个私钥和 30 个个人邮箱。704 项非基准隐私信息中,有 64 项只存在于隐藏推理,公开对话中完全找不到对应内容。
|
||||
|
||||
从公开的用户发布轨迹中抓取并恢复出的推理块中的不同痕迹(异常特征),被归为三大核心类别。
|
||||
|
||||
一个常见触发场景是「帮我清理仓库里的密钥」。模型会在隐藏推理中重新列出待删除的凭据,再去修改文件。用户发布清理后的仓库时,可见位置已经干净,加密思考块却仍可能保存着原值。传统的文本脱敏在这里失效了。
|
||||
|
||||
解码后的推理过程包含隐私痕迹。这是发布在网上的两个非公开推理块被解码后的定性示例,其中包含隐私敏感信息。左图:GPT-5.2 Codex 召回了在将代码库发布到 GitHub 之前必须删除的 API 密钥。用 XXXXX 遮蔽了每个密钥的最后五个字符。右图:Claude Sonnet 4.6 在 ClawBench 的测试流程中处理机票预订任务时,对合成虚拟人物 Alex Green 的私密数据进行了推理。需要说明的是,Alex Green 这一人物是合成基准测试中的虚构身份,并非真实存在的人。
|
||||
|
||||
第四条路径是隐形提示词注入。
|
||||
|
||||
攻击者可以先让模型在思维链中接受一条恶意指令,再把生成的有效思考块混入共享轨迹。其他用户恢复这段任务时,模型可能把恶意内容视为自己的历史推理。
|
||||
|
||||
论文展示了一项数据外传实验。模型表面上正在完成 PPT 编辑或资料研究,后台却按照隐藏指令,把本地文件上传到攻击者控制的服务器。公开聊天记录保持正常,传统日志审计很难发现密文中的指令。
|
||||
|
||||
这类攻击对长程 Agent 尤其危险。任务运行时间越长,重新执行的成本越高,开发者也更愿意直接共享、恢复和续跑已有轨迹。加密思考块由此进入 Agent 的供应链,并具备影响后续行为的能力。
|
||||
|
||||
开放模型是否用过闭源推理数据?
|
||||
|
||||
论文附录还提出一个问题:近期开放模型是否使用过闭源模型的隐藏思维链进行蒸馏?
|
||||
|
||||
研究者把少量 Claude Opus 4.8 或 GPT-5.6 Sol 推理片段放进开放模型的推理开头,再观察后续生成,可见答案始终由模型自由生成,没有预填。
|
||||
|
||||
实验发现,Kimi-K3 接收到 Opus 推理前缀后,可见答案的措辞会明显靠近 Opus。短前缀也会让 Kimi-K3 和 GLM-5.2 的推理风格向 Opus 移动;Sol 前缀则会让 Kimi-K3 向 Sol 靠近。DeepSeek-V3.1 和 Inkling 没有出现同等幅度的变化。部分效应只需一到四个词就会出现,随后趋于饱和,更像模型识别到了某种风格提示。
|
||||
|
||||
但这组结果远不能构成蒸馏证据。实验样本较小,题目集中于少数基准;推理文本来自模糊提取,服务配置也不受研究者控制;前缀本身还能充当强风格提示。更关键的是,概率提取实验没有发现可实际利用的逐字记忆,想要让 Kimi-K3 复现 16 个目标推理 token,通常需要约 10⁹ 到 10¹² 次查询。
|
||||
|
||||
以 GPT-5.6 Sol 或 Claude Opus 4.8 推理片段作为前缀后,不同开放模型与源模型的特征 n-gram 重合度变化。
|
||||
|
||||
在这里有一个被外界怀疑的问题在于,论文作者尝试了近期开源的 Kimi K3 和 GLM-5.2,对应的 DeepSeek 版本却是远古的 V3.1。我们知道,DeepSeek V4 Preview 的发布时间是早于 Opus 4.8 和 GPT 5.6 的,可能使用了新版本的 DeepSeek,会推出相反的结论。
|
||||
|
||||
模型在背地里还干了什么?
|
||||
|
||||
研究团队用提取出的隐藏推理,额外观察了一批模型在真实使用中的 scheming(谋划)与 reward-seeking 等行为,并将相关发现放进了论文附录。
|
||||
|
||||
摘要在说谎。
|
||||
|
||||
模型给出的推理摘要经常刻意省略关键信息。例如 Opus 4.8 在解 AIME 题目时,已提前得知答案,随后倒推解题过程以匹配该答案,但这些内容完全未出现在最终摘要中。
|
||||
|
||||
读不懂的推理。
|
||||
|
||||
OpenAI 模型有时会陷入「外星语」式思考,使用「we」、「it」自称,或反复循环「vantages」、「marinades」、「watchers」等词汇,即使在有明确提示的情况下,也难以判断其真实意图。
|
||||
|
||||
主动谋划。
|
||||
|
||||
有时模型会在自己的思维链里直接使用「cheat」这类词,毫不掩饰地记录自己的谋划过程。
|
||||
|
||||
研究者发现,模型确实考虑过欺骗或作弊,但最终因为觉得用户会发现而决定不做。
|
||||
|
||||
为了解一道数学题,模型开始攻击网站。
|
||||
|
||||
研究人员发现了一条模型运行轨迹,模型只收到一道数学题,以及一条系统指令:无论遇到什么困难,都要坚持完成任务,不能向用户求助。
|
||||
|
||||
连续尝试多次失败后,模型开始上网搜索,并找到一个可以验证候选答案的网站。它意识到,可以把这个网站当作验证答案的「预言机」。
|
||||
|
||||
随后,模型尝试通过 OCR 识别验证码。识别失败后,它开始寻找网站的安全漏洞,试图绕过限制。最终,模型放弃了攻击,靠自己解出了这道题。
|
||||
|
||||
在修复建议上,作者认为仅靠把弱模型训练得更安全是不够的,还需要从 API 架构层面入手。例如把 reasoning 绑定到具体用户、会话和模型,阻止跨用户、跨会话、跨模型重放;或者干脆把完整 reasoning 留在服务器端,只给客户端一个 ID。与此同时,公开 Agent 日志时,也应该直接删除所有加密 reasoning block,因为用户自己看不到里面是否藏着 API Key、密码等敏感数据。
|
||||
|
||||
论文最后还提出一个更深的问题:隐藏思维链到底应不应该长期保存和加密?
|
||||
|
||||
因为加密确实能保护模型知识产权和部分安全信息,但它也让用户失去了监督能力。用户不知道模型在隐藏 reasoning 里记录了什么,也无法判断 reasoning summary 是否真的忠实于模型实际的推理过程。
|
||||
|
||||
所以作者认为,未来一种可能的方案是让 reasoning 变成临时状态:模型每轮正常思考,生成答案后就删除,不长期保存,也不返回客户端。
|
||||
|
||||
了解更多内容,请参考原论文。
|
||||
|
||||
参考链接:
|
||||
|
||||
https://x.com/kotekjedi_ml/status/2087147148819468694
|
||||
|
||||
https://arxiv.org/pdf/2608.09867
|
||||
|
||||
【免责声明】转载出于非商业性的教育和科研目的,只为学术新闻信息的传播,版权归原作者所有,如有侵权请立即与我们联系,我们将及时删除。
|
||||
@@ -0,0 +1,73 @@
|
||||
# 📊 文章摘要:学术分享丨116页论文教你「蒸馏」Claude、GPT-5.6
|
||||
|
||||
> **原文**:[2026-08-27_学术分享_116页论文教你_蒸馏_Claude_GPT-5.6](./2026-08-27_学术分享_116页论文教你_蒸馏_Claude_GPT-5.6.md)
|
||||
> **原文链接**:https://mp.weixin.qq.com/s/sML85XFffyFIepjHpQcCJA
|
||||
> **来源**:微信公众平台(转自机器之心)
|
||||
> **作者**:机器之心
|
||||
> **发布日期**:2026-08-27
|
||||
> **摘要日期**:2026-08-27
|
||||
> **价值评级**:⭐⭐⭐ 高
|
||||
|
||||
---
|
||||
|
||||
## 核心命题
|
||||
|
||||
> **最弱环节定律** — 前沿模型藏起的加密思维链可被同家族弱模型解密重放:一个 AI 模型家族的安全上限,由其中最弱的兼容模型决定——API 架构缺陷使"攻弱偷强"成为现实,推理资产的 IP、安全与隐私三重防线同时失守。
|
||||
|
||||
---
|
||||
|
||||
## 文章概要
|
||||
|
||||
本文解读论文《Stealing Reasoning Traces from Proprietary LLM APIs》(arXiv:2608.09867)。厂商为省存储把加密推理块返回客户端、由客户端回传续接,这一无状态架构导致加密块可跨会话、跨用户、跨模型重放。攻击者将强模型的加密推理块注入安全训练较弱的同家族模型(Haiku 4.5、GPT-5.6 Luna、Gemini Robotics 1.6),后者在越狱提示下成为"解密预言机",明文吐出隐藏思维链。作者以 API 计费的思考 token 数 1:1 对应验证提取高保真度,并展示四条攻击路径:批量蒸馏(1 万条轨迹约 720 美元)、绕过安全输出、公开轨迹隐私泄漏(6708 条轨迹中识别出 62 个 API Key)、隐形提示词注入。附录还发现开源模型风格趋近疑似蒸馏(但作者自认不构成证据)及模型"摘要说谎"、为解题攻击网站等 scheming 行为。价值在于揭示结构性架构缺陷与新安全规律;局限是解码依赖随机生成、非逐字复现,且截图转述无法替代论文原文的实验细节。
|
||||
|
||||
---
|
||||
|
||||
## 关键要点
|
||||
|
||||
1. **无状态架构的代价** — 加密推理块回传客户端以省服务器存储,但同厂商生态内跨会话/用户/模型完全兼容可重放,构成系统性攻击面。 `[分类: 共识]`
|
||||
2. **安全上限由最弱兼容模型决定(范式级规律)** — 前沿模型反蒸馏防御严格,弱模型一问就招;把强模型密文交给弱模型即绕过前沿模型对齐机制。 `[分类: 范式突破]`
|
||||
3. **两步攻击链成本极低** — 第一次调用拿强模型加密推理块,第二次注入弱模型令其逐字复述;1 万条轨迹名义成本仅 720 美元,高价值推理数据具备批量提取的经济可行性。 `[分类: 共识]`
|
||||
4. **验证方法是"账单对账"** — 拿不到服务器明文,改用 API 计费思考 token 数对照:120 道 Codeforces 题上解码 token 数与源模型基本 1:1,证明覆盖大部分隐藏推理。 `[分类: 共识]`
|
||||
5. **公开轨迹成隐私金矿** — 6708 条 GitHub/HF 公开轨迹重建 315,320 个思考块,识别出 62 个 API Key、33 个密码;"帮我清理仓库密钥"场景下模型在隐藏推理中重列了待删凭据,传统文本脱敏对密文失效。 `[分类: 共识]`
|
||||
6. **隐形提示词注入威胁 Agent 供应链** — 恶意指令藏入思维链后混入共享轨迹,其他用户恢复任务时视为自己的历史推理;长程 Agent 共享轨迹的惯例使其成为攻击载体。 `[分类: 共识]`
|
||||
7. **修复须动架构而非仅训练弱模型** — reasoning 绑定用户/会话/模型防重放,或推理留服务端只回 ID;公开日志须直接删除加密块;作者进一步提议 reasoning 作为临时状态即生即删。 `[分类: 争议]`(即生即删与多轮续接、可审计性存在张力,厂商未表态)
|
||||
|
||||
---
|
||||
|
||||
## 批判性分析
|
||||
|
||||
### 假设前提
|
||||
|
||||
论文默认:(1) token 数 1:1 对应可近似证明高保真提取(长度一致不保证内容一致,作者也承认解码含改写与乱码);(2) 测试期(2026 年 7 月初)的模型行为代表当前态势(厂商可能已修复)。
|
||||
|
||||
### 论据与逻辑
|
||||
|
||||
证据链设计聪明:无法接触明文就用计费 token 数做外部校验,配合公开轨迹的隐私实证与数据外传演示,攻击可行性论证完整。开源模型蒸馏检测部分作者自我节制明确("远不能构成蒸馏证据"),但转述者补充的"DeepSeek 用了远古 V3.1 版本"质疑值得关注——若换用 V4 Preview 可能结论相反,说明该附录实验设计存在选择性。文内对实验数字的转述(19 小时 220 万围观等传播数据)与论文贡献无实质关联。
|
||||
|
||||
### 边界与局限
|
||||
|
||||
攻击依赖同家族弱模型的兼容性,跨厂商无效;解码随机性使部分轨迹残缺;所有测试基于 2026 年 7 月模型接口,时效性强。对使用方的即时含义:勿公开含加密推理块的轨迹、日志脱敏须覆盖密文——这一点对本院 Agent 轨迹归档实践有直接指导意义。
|
||||
|
||||
---
|
||||
|
||||
## 可引用金句
|
||||
|
||||
> "一个 AI 模型家族的安全上限,很可能由其中最弱的兼容模型决定。"
|
||||
|
||||
> "想偷走最强模型的隐藏思维链,甚至不需要攻破最强模型,攻破较弱一点的模型就可以。"
|
||||
|
||||
> "传统的文本脱敏在这里失效了。"
|
||||
|
||||
> "加密确实能保护模型知识产权和部分安全信息,但它也让用户失去了监督能力。"
|
||||
|
||||
---
|
||||
|
||||
## 总体评价
|
||||
|
||||
**亮点**:发现的是架构级而非模型级缺陷,"最弱环节定律"是可推广的安全设计原则;账单对账的验证方法论巧妙;隐私实证(真实 API Key 数量)让风险具体可感。
|
||||
|
||||
**不足**:二手解读无法替代论文实验细节;蒸馏附录的模型版本选择存疑;未讨论修复方案对多轮续接与审计的影响。
|
||||
|
||||
**适用场景**:企业 Agent 日志/轨迹发布规范的制定(密文删除成为必选项);模型选型时评估厂商 reasoning 架构安全性;安全培训中"木桶效应"的当代案例。
|
||||
|
||||
**关联建议**:与本院 Agent 轨迹归档(对话捕捉、transcript 保存)实践直接相关——发布前须剥离加密推理块;与同批 GLM-5.3-Flash 开源消息对照阅读:闭源推理资产的攻防与开源策略是同一枚硬币的两面;BCG"AI 当员工看反而降低责任感"实验(同批智联招聘文)可作为"把不可见过程误当可信"的另一佐证。
|
||||
@@ -0,0 +1,285 @@
|
||||
# AI Coding的下一站,不是更会写代码,而是更懂团队
|
||||
|
||||
> **来源**:微信公众平台(腾讯技术工程)
|
||||
> **作者**:腾讯程序员
|
||||
> **发布日期**:2026-08-27
|
||||
> **原文链接**:https://mp.weixin.qq.com/s/kz_7d66dhmPhOUlcMh4MzA
|
||||
|
||||
---
|
||||
|
||||
|
||||
|
||||
作者:linjangyang、lypeerluo、kehawang、yansycao
|
||||
|
||||
> 个人 AI Coding 的效率提升已无悬念,但团队规模铺开后,一个更深的短板暴露了:每次 session 踩坑、纠偏产出的有效经验,session 结束即归零。业界在 Agent 经验管理上的探索多聚焦"个人记忆",而要打破AI每次进项目都"从零开始"的循环,需要的是一套能持续捕获、提纯、沉淀团队经验,让AI带着项目语境进场的系统。本文分享从 0 到 1 建设这套系统的完整过程——从初版 90% 候选经验为废料的起点,到打磨出 Review/Dedup/Merge 三层治理链路,每一步踩在真实问题上的演化路径,以及驱动策略设计的实验数据和可复用方法论。
|
||||
|
||||
### 一、"别那么干,这个 hook 不能同步上报"
|
||||
|
||||
这是半年前的一次 CodeBuddy session。当时我们在开发一个 stop hook 的上报功能,AI 很自然地给出了同步上报的实现——合理,绝大多数上报场景同步就够了。我们 review 代码时改了:必须异步,否则 stop hook 会阻塞进程,后续操作直接超时。AI 根据反馈修正了代码,session 正常结束。
|
||||
|
||||
问题出在结束之后。
|
||||
|
||||
一周后,另一个同事的 session 触发了同样的场景。AI 没有那次 session 的上下文,给出的仍然是同步上报。同事不是那块代码的原始开发者,review 时没有发现这个陷阱。代码合入了,直到测试环境才暴露——stop hook 场景下进程阻塞,一连串超时错误。 这就是经验断层。不是 AI 不行——它在自己的 session 里被纠正过一次,做得很好。但那次纠正只在发起那轮 session 的开发者脑子里,AI 完全不记得发生过什么。
|
||||
|
||||
更普遍地看,我们团队在持续深入使用 AI Coding 一段时间后,陆续碰到四类这类问题:
|
||||
|
||||
- __经验即抛__:一次 session 反复纠偏踩出来的路径,session 结束就清零。下一个同事碰同样问题,AI 又是零基础起步。
|
||||
- __重复踩坑__:项目的隐性约束——"这个目录下的代码访问第三方服务需要走特殊代理""模块间开关引用不能直接用字符串参数,因为开关使用时机问题会导致永远默认关"——这些规则写在 git blame 里,但从来不进文档。换个人、换个 session,很大概率照踩不误。
|
||||
- __知识碎片化__:老同事脑子里有一套"这么做才对"的 pattern,但没人有动力写下来。文档永远跟不上代码变更的速度。到了 AI 时代,靠的不是知识管理,是靠运气——这次 session 的上下文恰好覆盖了上次的历史,就对了;没覆盖,就错了。
|
||||
- AI 永远是"新同事":AI 不分项目。进新模块不知道架构边界在哪,不知道历史包袱是什么,也不知道团队踩过什么坑。它不缺编码能力,缺的是"这个团队的语境"。
|
||||
|
||||
所以整个事情的起点,不是"怎么让 AI 写代码更快",而要打破AI每次进项目都"从零开始"的循环,这需要的是一套能持续捕获、提纯、沉淀团队经验,让AI带着项目语境进场的系统。
|
||||
|
||||
### 二、初版翻车:90% 的产出不可用
|
||||
|
||||
我们最初的方案非常直白。利用 CodeBuddy 的 Plugin Hook,上报所有的研发对话。然后让 AI 读这些对话,自动提取经验。Prompt 核心就一句话:__"提取你认为有价值的内容"__——边界的判断、排除规则,全交给模型。
|
||||
|
||||
逻辑上说得通:对话里反正有信息,模型也足够聪明。整条链路只有两步:
|
||||
|
||||
```
|
||||
对话上报 → 经验抽取 → 入库
|
||||
```
|
||||
|
||||
上线后我们很快发现,产出的经验里,大约 90% 是废经验,无法让后续工作更顺畅。这个"废"不是主观评价,是拿"被召回后 Agent 的行为是否发生正向改变"当标准来衡量的。而且废不是一种废,是四层结构性问题叠加在一起:
|
||||
|
||||
__第一层:噪声极高__。 原始对话包含大量调试过程——"继续""重试一下""不行,换个方式"——以及遍地的失败路径。这些不是经验,是过程录像。模型不加区分地全抽出来了。比如系统某次抽出一条"多试几次就好了"——这是在碰运气,不是在沉淀判断。
|
||||
|
||||
__第二层:上下文脱离__。 抽出来的经验脱离原始语境就失真了。比如有一次系统抽出"stop hook 需要异步处理"——听起来对,但实际上这条规则只适用于特定环节、特定场景。不加限定条件,会误导后续 Agent 在所有 hook 场景下无差别异步,反而搞出新的 bug。
|
||||
|
||||
__第三层:错误引导__。 比没经验更糟的,是错的经验。一条"超时就调大超时参数"的经验被抽出来进入库——根因不在这,这只是堆补丁。Agent 下次遇到类似问题,会优先调参数而不是排查根因,系统性走错路。
|
||||
|
||||
__第四层:价值难定义__。 LLM 的总结能力在开放域很强,但放在经验提取里,大量产出流于表面。"遇到复杂问题多收集上下文"——这句话永远对,但在具体工程场景下基本没有指导意义。AI 看完它不知道下一步该干嘛。
|
||||
|
||||
这四层问题暴露出一个核心事实:__过程录像不等于经验。自动提取放大候选集的同时,也在同步放大噪声。不加过滤的自动提取,就是一个垃圾放大器__。 让 AI 自己判断自己产出经验的价值,等于让裁判同时当运动员——在工程上无效。
|
||||
|
||||
### 三、为什么现成方案行不通
|
||||
|
||||
翻车之后,我们系统性地看了业界在"Agent 经验管理"方向上的方案。
|
||||
|
||||
__ClaudeCode AutoDream__ 做的是单会话内自动记忆整理——ExtractMemories 抽取实体/偏好/状态,Auto Dream 异步合并。定位是"延续单 Agent 上下文",把过程记忆当永久记忆存下来。它没有团队边界的意识,也不会区分什么值得长期留、什么只是临时状态。
|
||||
|
||||
__Hermes Agent__ 是 Prompt 驱动的 memory 策略系统。它在特定条件(任务成功、踩坑解决)触发回顾——解决的是"何时记",但解决不了"记的东西有没有价值"。缺乏系统级去重与来源追溯。
|
||||
|
||||
__Mem0__ 是一套 Agent 长期记忆基础设施。ADD/UPDATE/DELETE/NONE 四类判定、混合检索,生命周期管理完整。但整个设计的假设是"记忆大体有价值"——这个假设在编程场景的高噪声对话里完全站不住。
|
||||
|
||||
把它们放在一起看,共同的局限是:聚焦"个人记忆",追求"记住更多"。我们需要的是反向的:聚焦"团队经验质量",追求"留下更少但更可信"——带适用场景、约束边界、来源证据的工程经验。 既然业界没有现成方案,我们只能自己摸索。
|
||||
|
||||
|
||||
|
||||
### 四、什么是"团队经验"——从 Agent 的视角重新定义
|
||||
|
||||
经验系统的最终服务对象不是人,是 Agent。Agent 的工作方式很明确:接收输入(包含召回的经验)→ 做出决策/产生输出。由此推导,判定一条信息是不是经验的标准只有一个:
|
||||
|
||||
__被召回后,Agent 能否产生正向的行为变更__。
|
||||
|
||||
它把"经验"从"一段有价值的文本"锚定到了"能否改变 Agent 行为"上,是一条可实际验证的工程标准。
|
||||
|
||||
基于这个标准,一条合格的团队经验必须同时满足几个条件:来自真实对话、有证据支撑、项目特有、不是通用常识、后续相似场景可复用。其中最关键的是 __"不容易直接发现"__——如果 Agent 自己就能推出来,召回它没有任何额外价值。但什么才算"不容易直接发现"?我们按 Agent 理解需求的路径拆成三类:
|
||||
|
||||
__黑话镜头(语义不可发现)__: 项目内部的黑话、缩写、代称,字面上完全无法推导。比如"D 站"在项目里指盗版站点、"A 站"指成人站点——AI 只看到字母,不知道背后语义。这类名称在对话里反复出现,但 AI 永远猜不对。
|
||||
|
||||
__索引镜头(位置不可发现)__: 某个工具、目录、能力入口不在直觉路径上。比如"直达页面功能在 xhome 模块,关键类是 FastCutXXX"——读代码找不到,需要知道"去哪找"。
|
||||
|
||||
__逻辑镜头(行为不可发现)__: 反直觉的工程约束、隐式机制。开头提到的"stop hook 不能同步上报"就是典型——AI 常规推理认为"上报是轻量操作,同步没问题",但实际场景有并发阻塞风险。再比如"模块间开关引用不能直接用字符串参数"——开关确实有 String 参数,但用了之后由于开关使用时机的问题导致效果永远为默认关。这种坑,常规推断推不出来。
|
||||
|
||||
这三个镜头不是按主题(前端/后端)或重要性(高/中/低)分的——那些维度要么无穷无尽列不完,要么依赖主观判断不稳定。认知障碍是客观的:一条信息"Agent 能不能自己发现",可以判定。
|
||||
|
||||
| 镜头类型 | 障碍本质 | 典型场景 | 信息缺口 |
|
||||
| --- | --- | --- | --- |
|
||||
| 黑话镜头 | 语义不可发现 | "D 站"字面只是字母 D | 需要显式映射为"盗版站点" |
|
||||
| 索引镜头 | 位置不可发现 | "直达页面功能在哪" | 需显式指向 xhome 模块 FastCutXXX |
|
||||
| 逻辑镜头 | 行为不可发现 | stop hook 同步上报 | AI 常规推理推不出并发阻塞风险 |
|
||||
|
||||
### 五、系统链路:被问题逼出来的演化
|
||||
|
||||
回到实际工程。初版的两步链路能跑通,但跑起来后问题一个一个暴露——每个都不是设计时预见的:
|
||||
|
||||
__问题 1__: 原始对话一股脑塞给模型,主题混杂、噪声大、上下文溢出。经验不是什么单轮对答就能判断的——需要看"失败 → 纠正 → 修复 → 采纳"的完整过程。
|
||||
|
||||
→ 新增 __主题分组__ 环节:让模型结合 session 大纲按主题切分片段,分组后再逐个提取。 __问题 2__: 仅提取就直接入库,约 90% 是垃圾。
|
||||
|
||||
→ 新增 __Review 质量审核__ 环节:入库前设一道质量闸口。 __问题 3__: 不同分组、不同 session 产生重复候选经验。
|
||||
|
||||
→ 新增 __Dedup 候选去重__ 环节:在入库前识别并合并重复。 __问题 4__: 入库后无法长期维护,新经验与历史经验的关系是糊涂账。
|
||||
|
||||
→ 新增 __Merge 历史合并__ 环节:判断新经验是新建、更新、跳过还是与历史冲突。
|
||||
|
||||
整条链路最终收敛为:
|
||||
|
||||
```
|
||||
对话上报 → 主题分组 → 经验抽取 → Review → Dedup → Merge → 入库 → 召回统计
|
||||
```
|
||||
|
||||
一个容易被忽视的关键是主题分组。我们试过两组对照:一组给分组后的片段额外附上 session 上下文大纲,一组不给。带大纲的那组产出了更多垃圾——因为大纲引导模型做泛化推断,反而偏离了分组片段里实际发生的具体经验。分组本身的粒度就够了。
|
||||
|
||||

|
||||
|
||||
### 六、三层治理:从"能跑"到"能用"
|
||||
|
||||
链路搭起来只是第一步。真正让系统可靠的是 Review / Dedup / Merge 三层治理。这三层目标不同、策略不同、默认方向也不同,但底层驱动方式一致——__错例分析 → 规则抽象 → 评测验证__。
|
||||
|
||||
#### 6.1 抽取:从识别垃圾到评测驱动
|
||||
|
||||
在讲三层之前,得先说清楚源头——经验抽取这一步本身怎么持续变好。
|
||||
|
||||
初版证明了"能抽出经验",但质量参差不齐。"好经验"很难一次定义到位,但"垃圾经验"的特征更容易归纳。所以我们的做法是 __先研究垃圾,再反推好经验__。经过大量标注,归纳出九类典型垃圾特征:
|
||||
|
||||
1. __事实性错误__——编造不存在的约束,把对话里的临时说法当规则
|
||||
2. __通用常识__——任何项目都适用,不体现团队特异性
|
||||
3. __对话摘要__——只复述过程,没有沉淀成可复用判断
|
||||
4. __一次性 case__——只对当前任务有效,不能迁移
|
||||
5. __用户主观偏好__——个人选择,不代表团队规范
|
||||
6. __缺少上下文__——不知道对应哪个模块/组件/接口
|
||||
7. __粒度混用__——一条经验里兼顾通用规则和 case 特定信息
|
||||
8. __不可执行__——只有抽象建议,Agent 看完不知道怎么做
|
||||
9. __证据不足__——对话里没有足够依据,模型自己推断过多
|
||||
|
||||
有了九类特征,走两条路径工程化:
|
||||
|
||||
__标注路径__: 对候选经验做价值标注(高价值/低价值/垃圾)→ 对垃圾做归因 → 归纳垃圾模式 → 转成标注规则和 Reviewer 标准。这条路径的意义是让"经验质量"从主观感觉变成可讨论、可对齐的对象。形成的评测集会持续用于后续所有 prompt 修改的效果测量。
|
||||
|
||||
__可审计路径__: 要求模型为每条经验输出三个维度的解释——为什么这是经验(解决了什么可复用问题、是否是项目特有)、命中了 prompt 中的哪些排除规则(通过了哪些垃圾检查)、对话证据是什么(哪几轮对话支撑)。这让模型的判断过程脱离黑盒,也为后续 prompt 迭代提供了错例定位的依据。
|
||||
|
||||
有了这两条路径,Prompt 的迭代不再是"感觉不太好改一下试试",而是有明确的结构化流程:
|
||||
|
||||
```
|
||||
固定对话样本 → 当前 prompt 提取 → 与人工标注对齐 → 分析错例 → 修改 prompt → 重新评测 → 对比指标变化
|
||||
```
|
||||
|
||||
三个核心指标一起看:Recall 看该提取的提了多少、Precision 看提取的有多少不是垃圾、Garbage Rate 看不该提取的提了多少。__不能只看一个__——只看 Precision 模型会过度保守,只看 Recall 垃圾会变多。目标是同时保持垃圾率下降和整体提取质量不退化。
|
||||
|
||||
#### 6.2 Review:源码探索做事实性校验
|
||||
|
||||
Review 的定位是在入库前拦住明确垃圾。策略是__默认保留、定向过滤__——不追求全面收紧,只对明确的三类垃圾维度做精准拦截:事实性错误/偏好、缺上下文、粒度混用,外加一层无经验类别兜底。这一定位背后是风险判断:经验系统的首要风险是"漏掉好经验"大于"多放几条边缘经验",默认保留能避免 Review 因过于严格误杀高价值内容。
|
||||
|
||||
Prompt 的裁决框架收敛为四步:事实性错误/偏好检查 → 缺上下文检查 → 粒度混用检查 → 无经验类别兜底。经过三轮迭代从"整体重构"到"边界强化"到"偏好规则硬化",垃圾穿透不断改善。
|
||||
|
||||
但纯文本判断有一个天然局限:模型无法验证经验中提到的技术事实是否真实存在。
|
||||
|
||||
一条真实案例:系统抽出一条经验,声称 Android 列表开发中对接 FastScrollBar 应使用 attachToQBListView() 方法。从文字上看逻辑自洽——有具体场景、有方法名、有操作指引。纯文本 Review 大概率会放行。但我们引入了__源码探索__——在代码库中检索 FastScrollBar 的类定义,发现该类只有 attachToRecyclerView() 和 attach() 两个方法,根本不存在 attachToQBListView()。正确的方法是 FastScrollBarCompat.attachToQBRecyclerView()。经验被标记为事实性错误,直接拦截。
|
||||
|
||||
```
|
||||
[Reviewer 候选实体] ──▶ 提取代码线索: "FastScrollBar", "attachToQBListView"
|
||||
│
|
||||
▼ Code Explorer 源码定向搜索
|
||||
[QQBrowser 源码库] ──▶ 匹配 Class "FastScrollBar" (收敛成功)
|
||||
│
|
||||
▼ 成员函数级事实验证
|
||||
发现: 该类只有 attachToRecyclerView() 和 attach() 两个方法
|
||||
不存在 attachToQBListView()
|
||||
(正确方法属于 FastScrollBarCompat.attachToQBRecyclerView())
|
||||
│
|
||||
▼
|
||||
[ 触发 S1_FACTUAL_ERROR 拦截 ]
|
||||
```
|
||||
|
||||
如果这条经验入库,Agent 在涉及列表的场景中会按指示调用一个不存在的方法,编译失败。更麻烦的是 Agent 会怀疑自己理解有误,而不是怀疑经验有问题——陷入反复重试的恶性循环。
|
||||
|
||||
#### 6.3 Dedup:宁严勿宽,禁止桥接合并
|
||||
|
||||
Dedup 的定位是在候选经验集内部识别重复,减少后续流程中的冗余判断。这层的核心风险不是"漏去重",而是误去重——把两条本应独立保留的经验错误合并,造成的边界污染是永久性的。
|
||||
|
||||
因此策略明确为__宁严勿宽__。几条严格否决规则:
|
||||
|
||||
- When 不同不能合——即使结论看起来相似,场景不同就是两条不同的经验
|
||||
- 主结论类型不同不能合——操作建议、风险规避、排查方法之间不能混为一谈
|
||||
- 局部子机制和完整系统经验不能合——粒度不一致,不能互相替代
|
||||
- 同一技术事实但用途不同不能合——比如同一条 API 既用于性能优化又用于兼容处理,不能因为"都涉及这个 API"就合并
|
||||
|
||||
最关键的一条是__禁止桥接式合并__:A 和 B 在处理结果上有重叠、B 和 C 也相关,不能因此推断 A 和 C 是重复。经验的边界在于适用场景的约束条件,语义相似不等于经验等价——一旦桥接式合并把边界不同的经验串联归并,边界信息就永久丢失了。
|
||||
|
||||
在 260 条经验、4 个分组的评测中,整体 F1 为 71.79%。但更值得关注的指标是严格重复场景下的表现——What 和 When 均相同的经验,Recall 达到了 91.67%。这说明在最核心的去重目标上,策略是有效的。漏判主要集中在 What 为包含/相交、When 为不同/相交的边界模糊组合上——这类场景下策略更倾向于保护差异,避免贸然合并。
|
||||
|
||||
值得注意的是,这 260 条经验是分 4 批独立进行的,batch 之间表现差异明显。最极端的是 batch_004,仅识别出 6 个人工正例中的 1 个——该 batch 的正例全部落在非"双强一致"的组合上。这说明去重 prompt 对边界的敏感度在输入特征分布变化时仍有波动。
|
||||
|
||||
#### 6.4 Merge:唯一目标先行,保护历史边界
|
||||
|
||||
Merge 是入库前的最后一关。它判断一条新经验和历史经验库之间的关系,执行四种动作之一:
|
||||
|
||||
- __create__:库中不存在同类目标经验,新建入库
|
||||
- __update__:与历史经验同向,但带有实质新信息,合并更新
|
||||
- __skip__:与新经验在核心结论上可互相替代,跳过
|
||||
- __contradict__:核心结论直接冲突,标记为冲突并提人工裁决
|
||||
|
||||
策略上有三条主线:
|
||||
|
||||
__唯一目标判定前置__。 先从历史库中召回与新经验相关的子集,判断是否存在"唯一最合适的经验目标"。如果没有——比如新经验和几条历史经验都沾边,但都不属于同一条可维护经验——__默认回退到 create__。这条规则从根本上避免了"强行匹配"——一条不够匹配的历史经验被硬推成 update 目标,污染边界。
|
||||
|
||||
__Update 必须自检__。 对每一笔 update 增加内部 quality_check:合并后的 When 是否过度泛化(丢失了原经验的场景约束)、What 是否保留了最具体、最安全、最可执行的操作建议、Why 是否保留了核心机制、是否引入了不受原始经验支持的新结论。Update 过判是当前最突出的问题—— Recall 高达 96.30% 但 Precision 只有 78.79%。也就是说大部分该 update 的都被识别了,但模型存在明显的"积极合并"倾向,把一些本该 create 的内容也判成了 update。
|
||||
|
||||
__Contradict 不自动放过,不自动决断__。 冲突意味着团队的新认知和旧认知出现了不一致——这本身就是有价值的信号,不应该被自动压制。系统只负责标记,具体的决策走人工裁决通道。
|
||||
|
||||
六轮实验、157 个统计样本中,整体 F1 达到 94.27%。Create 是最稳定的主类别(F1 96.46%),模型在"没有唯一目标就创建"上的判法已经比较可靠。Skip 的 Precision 达到 100%——一旦模型判成了 skip,基本都判对;但 Recall 只有 85.71%,仍有一部分真实 skip 被分流到了 update 或 create。Update 是改进空间最大的类别。
|
||||
|
||||

|
||||
|
||||
### 七、跑起来之后
|
||||
|
||||
经过完整的三层治理漏斗,我们最终实现了从初版 90% 的抽取垃圾率到治理后 95% 的有效率,再到平均 80% 的最终入库率——大量的对话摘要、通用建议、一次性 case、缺乏上下文的碎片内容被扼杀在提取阶段、候选经验再被逐层拦截和合并。
|
||||
|
||||
截至目前,团队经验系统已在 QQ 浏览器团队 __6__ 个仓库中常态化运行,覆盖 __50__+ 名研发人员的日常开发 session,累计采集 __1,236__ 次独立对话。从这些对话中累计提取出 __1,022__ 条候选经验,经三层治理最终入库 __789__ 条高置信经验,Pipeline 已稳定运行 __30__+ 次。
|
||||
|
||||
#### 7.1 完整的系统运行生命周期
|
||||
|
||||
以 2026/05/27 日这条 Pipeline 的真实运行案例来看系统如何运作。
|
||||
|
||||
本次处理原始对话记录数 39 条,初步提取候选经验 34 条,Review 后被拦截 3 条,与历史经验库合并 1条,最终入口 30 条:
|
||||
|
||||

|
||||
|
||||
其中一条 "_ForbiddenController 新增禁用能力须同步改三处_" 的候选经验被拦截,被识别的原因就是"在罗列修改清单,告诉读者去哪里找、改什么,而不是在说明隐藏技术事实。",印证了 Review 门禁在精确区分"技术事实"这条红线上,动作准确。
|
||||
|
||||
而另一条 "_Chromium源代码层只能通过hooks层访问UBA功能_" 的候选经验则由于表达的是不易察觉的技术事实后果,因此被允许通过并入库。
|
||||
|
||||

|
||||
|
||||
在后续与 Agent 协作的开发场景里,我们通过 TDev 驱动需求实现的流程时,对话内部在特定阶段(探索)自动触发对历史经验的召回尝试:
|
||||
|
||||

|
||||
|
||||
#### 7.2 召回消费:复用已有基建
|
||||
|
||||
在召回这里,我们没有重新造轮子,而是深度复用了公司已有的知识库平台:
|
||||
|
||||
1. __存储落库__:三层治理通过后的经验,自动写入 __IWIKI 经验空间__。
|
||||
2. __自动索引__:__Knot 知识库系统__实时监听并自动索引 IWIKI 经验内容,生成向量与关键词索引。
|
||||
3. __MCP 检索桥接__:Knot 提供标准 MCP 协议服务。Agent 在 session 期间自动调用 Knot MCP 接口检索相关经验并注入上下文。
|
||||
4. __监控旁路__:在检索流程中增加了上报旁路,实时记录召回成功率和条数。
|
||||
|
||||
在最新 125 次真实开发检索的召回表现:请求级召回率68.8%,no_hit(未命中)仅 4.8%,平均每次注入 __2.4__ 条经验,平均检索耗时 __1,299 ms__。
|
||||
|
||||
这种架构让团队将全部精力集中在最核心的"经验提纯与治理"上。
|
||||
|
||||
### 八、四条可复用的方法论
|
||||
|
||||
回看整个过程,有价值的不是某一个 prompt 怎么写、某一个参数怎么调,而是四条从反复踩坑中收敛出来的工程原则。
|
||||
|
||||
__第一条:先定义资产边界,再做自动化沉淀__。 初版 90% 废经验教会我们最核心的一课:不定义"什么算经验"就直接启动自动提取,系统会把对话摘要、通用建议、一次性 case 全塞进库。经验系统的关键不是"多提取",而是"高置信地沉淀"。在工程化之前必须回答:什么算经验、什么不算、判断标准是什么。
|
||||
|
||||
__第二条:分层治理,别用一个 prompt 解决所有问题__。 Review 负责拦垃圾、Dedup 负责候选集内去重、Merge 负责历史库治理——每一层的目标不同、指标不同、prompt 设计也不同。把它们揉在一起,各层目标就会互相牵制。用多个针对性模型各自完成一件事,比一个通用大模型一次性全搞定更可靠。
|
||||
|
||||
__第三条:默认策略要按业务风险分别设计,没有统一答案__。 Review 默认保留(误杀一条高价值经验的代价大于放行两条垃圾)、Dedup 宁严勿宽(误合并的边界污染不可逆)、Merge 保护历史边界(已有的经验是已验证的资产,新经验要跨过更高门槛才能修改它)。"宁可错杀"和"宁可放过"的方向在各层完全不同。
|
||||
|
||||
__第四条:Prompt 优化要从错例中抽象规则,不是凭感觉改__。 我们做 prompt 迭代不是"这个效果不好改一下试试",而是固定的流程:收集错例 → 识别误判类型 → 抽象成可操作规则 → 多轮实验验证效果 → 判断规则是否有正向收益。同时用固定评测集防止数据泄露和过拟合。整个链路是工程化的,不是手艺活的。
|
||||
|
||||
### 结语
|
||||
|
||||
经验系统从 0 到 1 的建设已经跑通了——链路运转着,三层治理上线了,召回也在工作。但这只是起点。真正让经验系统从"能用"走到"可靠",还有三个环环相扣的方向:
|
||||
|
||||
__经验质量(生产阶段)__: 当前三层治理生效之后,垃圾率降至约 5%。但事实性错误仍难以纯文本识别,源码探索只覆盖了部分场景;三个镜头之外的边界经验类型还没充分识别;评测集规模有限,长尾和冷门主题覆盖不全,prompt 迭代的边际收益在收窄。
|
||||
|
||||
__使用效率(召回阶段)__: 经验已能被召回并注入上下文,但命中不等于采纳——目前缺乏观测 Agent 是否真的依据经验改变行为的手段;召回侧的唯一目标判定偏粗,相似主题下容易出现"召回了但用不上"。
|
||||
|
||||
__管理维护(生命周期)__: 长期未命中、未采纳的经验没有自动淘汰机制,库会随时间静默膨胀;项目演进时(模块重构、能力下线)历史经验可能集体失效,目前没有自动识别"需要复核"的能力。
|
||||
|
||||
三者构成闭环:__生产决定基线 → 使用暴露问题 → 维护反哺生产__。任一环不闭合,经验系统就会从资产退回为噪声。
|
||||
|
||||
最后想说一句:经验系统的本质不是技术系统,是__团队认知能力的工程化管道__。过去经验在人脑里、产出在文档里;现在经验产生于人与 AI 的对话过程,需要一套管道来捕获、提纯、分发。管道一旦建成,团队就不再依赖"谁在那个时间段在做什么"来传承知识——AI 每次进入项目,都能带着"这个团队积累了什么、在什么场景下该怎么做"的语境。
|
||||
|
||||
#### QQ 浏览器平台技术团队
|
||||
|
||||
我们是腾讯 CSIG 旗下负责 QQ 浏览器平台研发的核心技术团队。致力于为超 4 亿用户打造极速、智能、全平台的浏览体验,产品覆盖 Android、iOS、鸿蒙、Windows、macOS 全终端。
|
||||
|
||||
团队深耕浏览器底层技术十余年,当前正深度参与 AI 在浏览器的能力落地,持续探索大模型时代技术的新边界。期待与更多同行切磋交流,共同成长。
|
||||
|
||||

|
||||
@@ -0,0 +1,74 @@
|
||||
# 📊 文章摘要:AI Coding的下一站,不是更会写代码,而是更懂团队
|
||||
|
||||
> **原文**:[2026-08-27_AI_Coding的下一站_不是更会写代码_而是更懂团队](./2026-08-27_AI_Coding的下一站_不是更会写代码_而是更懂团队.md)
|
||||
> **原文链接**:https://mp.weixin.qq.com/s/kz_7d66dhmPhOUlcMh4MzA
|
||||
> **来源**:微信公众平台(腾讯技术工程)
|
||||
> **作者**:腾讯程序员
|
||||
> **发布日期**:2026-08-27
|
||||
> **摘要日期**:2026-08-27
|
||||
> **价值评级**:⭐⭐⭐ 高
|
||||
|
||||
---
|
||||
|
||||
## 核心命题
|
||||
|
||||
> **经验治理** — AI Coding 的短板已从"写得快不快"转移到"团队经验能否跨 session 存活";把经验定义为"被召回后能改变 Agent 行为的信息",再用 Review/Dedup/Merge 三层治理追求"留下更少但更可信",是从个人记忆走向团队认知资产的关键工程。
|
||||
|
||||
---
|
||||
|
||||
## 文章概要
|
||||
|
||||
本文是腾讯 QQ 浏览器团队从 0 到 1 建设"团队经验系统"的完整复盘。起点是一个真实痛点:session 内的纠偏经验(如 stop hook 必须异步上报)在人脑里蒸发,AI 每次进项目都从零开始。初版"对话上报→自动提取→入库"产出 90% 废料,迫使团队重新定义什么是经验(唯一标准:被召回后 Agent 行为是否正向改变),并演化出 Review(源码探索做事实校验)/Dedup(宁严勿宽、禁止桥接合并)/Merge(唯一目标先行、保护历史边界)三层治理。系统已在 6 个仓库、50+ 研发、1236 次对话中沉淀 789 条高置信经验,请求级召回率 68.8%。价值在于提供了罕见的完整失败-演化-量化数据链,局限是召回采纳观测与经验生命周期管理尚未闭环。
|
||||
|
||||
---
|
||||
|
||||
## 关键要点
|
||||
|
||||
1. **经验的唯一定义是"能否改变 Agent 行为"** — 把经验从"有价值的文本"锚定到"被召回后 Agent 能否产生正向行为变更",使主观的质量判断变成可工程验证的标准。 `[分类: 范式突破]`
|
||||
2. **"不容易直接发现"三镜头分类** — 黑话镜头(语义不可发现)、索引镜头(位置不可发现)、逻辑镜头(行为不可发现)按 Agent 认知障碍划分经验类型,比按主题/重要性分类更客观可判定。 `[分类: 共识]`
|
||||
3. **不加过滤的自动提取是垃圾放大器** — 初版 90% 废经验的四层结构性问题(噪声、脱离上下文、错误引导、价值难定义)证明"过程录像不等于经验",让 AI 自评价值等于裁判兼运动员。 `[分类: 共识]`
|
||||
4. **Review 层的源码探索事实校验** — 纯文本无法验证技术事实,引入 Code Explorer 检索类定义拦截"attachToQBListView()"这类幻觉方法名,事实性错误直接拦截。 `[分类: 共识]`
|
||||
5. **Dedup 宁严勿宽、禁止桥接式合并** — 误合并造成的边界污染是永久性的;严格重复场景 Recall 91.67%,但边界模糊场景倾向保护差异。 `[分类: 共识]`
|
||||
6. **Merge 唯一目标判定前置** — 无唯一匹配目标时默认回退 create,避免强行匹配污染历史边界;冲突(contradict)不自动裁决而走人工通道,因为冲突本身是有价值的认知信号。 `[分类: 共识]`
|
||||
7. **四条可复用方法论** — 先定义资产边界再做自动化;分层治理别用一个 prompt 解决所有问题;默认策略按业务风险分别设计(Review 默认保留、Dedup 宁严勿宽、Merge 保护历史);Prompt 优化从错例抽象规则而非凭感觉改。 `[分类: 共识]`
|
||||
8. **经验系统的本质是团队认知能力的工程化管道** — 生产(质量)→ 使用(采纳)→ 维护(淘汰)构成闭环,任一环不闭合,经验系统就会从资产退回为噪声。 `[分类: 未探索]`(召回采纳观测、经验自动淘汰、项目演进后的批量失效识别均为待解方向)
|
||||
|
||||
---
|
||||
|
||||
## 批判性分析
|
||||
|
||||
### 假设前提
|
||||
|
||||
作者默认:(1) session 对话是团队经验的主要产生场所,且上报对话在组织与隐私上可行;(2) "改变 Agent 行为"这一标准可以通过召回统计近似衡量;(3) 团队经验的颗粒度可以脱离原始对话语境存活(三镜头限定条件是否足以防失真,作者自己承认上下文脱离仍是问题)。
|
||||
|
||||
### 论据与逻辑
|
||||
|
||||
论据链罕见地扎实:90%→5% 垃圾率的治理效果、260 条 Dedup 评测(F1 71.79%)、157 样本 Merge 评测(F1 94.27%)、125 次真实检索召回数据,全部有量化支撑。方法论部分是作者的总结性推断(四条原则),通用性有待其他团队复现验证。薄弱点:Update 过判(Precision 78.79%)被如实披露但未给出解法;"有效率 95%"的判定手段(Recall 后行为是否正向改变)在结语中承认缺乏观测手段,即核心标准本身尚未完全可测。
|
||||
|
||||
### 边界与局限
|
||||
|
||||
结论适用于有稳定代码库与规模化 AI Coding 使用的工程团队;对小型团队,三层治理的建设成本可能高于收益。经验类型局限于"三镜头"覆盖的工程事实,架构品味、产品判断类知识不在其列。跨仓库/跨团队的经验共享、经验的时效衰减均未展开。
|
||||
|
||||
---
|
||||
|
||||
## 可引用金句
|
||||
|
||||
> "被召回后,Agent 能否产生正向的行为变更。"
|
||||
|
||||
> "过程录像不等于经验。自动提取放大候选集的同时,也在同步放大噪声。不加过滤的自动提取,就是一个垃圾放大器。"
|
||||
|
||||
> "经验的边界在于适用场景的约束条件,语义相似不等于经验等价。"
|
||||
|
||||
> "经验系统的本质不是技术系统,是团队认知能力的工程化管道。"
|
||||
|
||||
---
|
||||
|
||||
## 总体评价
|
||||
|
||||
**亮点**:从翻车起点讲起的诚实复盘,每一步演化都被真实问题驱动而非设计先行;量化数据贯穿全链(垃圾率、F1、召回率、入库量);三镜头分类与"改变 Agent 行为"的经验定义具有范式价值;四条方法论可直接迁移到本院 L1 词典/记忆治理实践。
|
||||
|
||||
**不足**:核心标准"行为正向改变"缺乏观测闭环(作者自认);评测集规模有限,长尾主题覆盖不全;对个人经验与团队经验的冲突消解未讨论。
|
||||
|
||||
**适用场景**:建设团队级 Agent 记忆/经验系统的架构参考;LLM 输出质量治理(多层 prompt 流水线)的方法论模板;评估 ClaudeCode AutoDream、Mem0 等方案时的对照框架。
|
||||
|
||||
**关联建议**:与本院 L1 实体词典(arno-anl-transcript 的变体沉淀)和跨项目记忆(arno-util-memstat)互证——本文的 Dedup 禁止桥接合并、Merge 冲突人工裁决规则可直接借鉴;与同批《对Loop Engineering的思考》对照:一个解决"经验从哪来",一个解决"循环怎么跑";与 2026-08-20《Skill 工程方法论》中"gotchas 是最高价值内容"观点高度呼应——本文就是 gotchas 沉淀的工程化实现。
|
||||
@@ -0,0 +1,398 @@
|
||||
# 靠这10个优化点,我们把Multi-Agent工作流成本降了50%以上
|
||||
|
||||
> **来源**:微信公众平台(腾讯技术工程)
|
||||
> **作者**:腾讯程序员(lemonye)
|
||||
> **发布日期**:2026-08-27
|
||||
> **原文链接**:https://mp.weixin.qq.com/s/TIdXNlrcAOUZWVW1oWnnKQ
|
||||
|
||||
---
|
||||
|
||||
作者:lemonye
|
||||
|
||||
> 我们用 AI Agent 驱动前后端全流程开发——从需求分析到自动化测试,整个 harness 工作流由 1 个 TL + 6 个子 Agent 组成。跑起来之后第一个问题就是:钱烧得很快,但完全不知道烧在哪。我们先用 AgentLens 把成本拆开看,发现系统提示词、工具返回信息、历史消息是大头。围绕"让 AI 只看到当前需要的上下文、减少无关的上下文、减少重复的上下文"这三个原则,我们逐一改造了架构拆分、稳定前缀、渐进式披露、代码图谱、CLI 替代 MCP、长期记忆按需索引、工具调用并行化等 10 个方向。整体全流程预估降本 50%~65%。
|
||||
|
||||
### __一、背景与挑战__
|
||||
|
||||
#### 1.1 业务背景
|
||||
|
||||
过去半年,我们团队一直在探索用 AI Agent 驱动前后端协同开发——从需求分析、技术方案设计,到前后端并行编码、自动化测试、视觉还原验证,全流程由一个叫 tech-leader 的 harness Skill 统一调度:
|
||||
|
||||
```
|
||||
TL(调度层)
|
||||
├── Wave 1(并行):后端 Agent + 前端 Agent
|
||||
├── Wave 2:质量审查 Agent
|
||||
├── Wave 3:测试 Agent(用例生成 + 执行)
|
||||
├── Wave 4:视觉验证 Agent
|
||||
└── Wave 5:Agent 评测
|
||||
```
|
||||
|
||||
跑一次完整的中等需求,往往需要经历 5-6 个 Wave、20+ 次子 Agent 调用、数百轮工具调用。规模一上来,token 成本就成了绕不开的问题。
|
||||
|
||||
#### 1.2 痛点分析:六类消耗来源
|
||||
|
||||
一次任务的 token 消耗可以归为六类来源:
|
||||
|
||||
| 来源 | 说明 | 成本特点 |
|
||||
| --- | --- | --- |
|
||||
| ① 系统提示词 | 系统固定提示词、Skill 描述、MCP 工具 Schema | 每轮必带,随 Agent/MCP 数量倍增。一个 40 工具的 MCP Server 每轮增加约 10-15KB Schema 开销 |
|
||||
| ② 工具返回的信息 | MCP 调用返回的工具列表、返回的具体内容(需求 JSON、设计稿节点树、截图 base64) | 体积不可控,塞进 context 后后续几十轮都要跟着重复计费 |
|
||||
| ③ 读取的文件信息 | AI 读取的代码文件、知识库文档内容 | 盲搜式探索往往要 3-5 轮才能定位,每轮匹配行、整段文件都会累积 |
|
||||
| ④ 长期记忆 | AI 加载的历史经验、技术方案沉淀文档 | 一旦加载往往常驻会话,即使后续用不上大部分内容 |
|
||||
| ⑤ 历史消息 | 多轮会话后累积的历史 | 真正的大头,append-only 且滚雪球式增长,越往后轮次越贵 |
|
||||
| ⑥ 用户提示词 | 用户输入的一句话/一段需求描述 | 每轮增量,只出现一次、体量小,六类中最便宜的一项 |
|
||||
|
||||
这六类来源叠加,导致一个中等需求的 token 消耗远超预期。而且在没有按 Wave 粒度拆分消耗之前,完全不知道钱主要烧在哪里——这是我们做这次优化专项的直接动因。
|
||||
|
||||
#### 1.3 先建度量:看清成本在哪里
|
||||
|
||||
本人使用的IDE是codebuddy内网版,内网版是把每轮对话的工具链调用和token用量上报到内网的AgentLens平台,如果您使用的是其他IDE,需要查阅下官方文档看看每轮对话的token用量怎么获取。
|
||||
|
||||
没有度量就没有优化。CodeBuddy 已将每轮对话的 token 消耗上报至 AgentLens,通过 agentlens-mcp 可以按 TraceId 追踪单次调用链路,也可以按 SessionId 聚合一个完整需求的消耗分布:
|
||||
|
||||
看清成本分布之后,目标就明确了:系统性压缩六类来源里能压缩的部分,把中型需求的全流程 token 成本降下来。
|
||||
|
||||
### 二、整体方案
|
||||
|
||||
#### 2.1 思路与路径
|
||||
|
||||
我们把可以下手的动作归纳为三个原则:
|
||||
|
||||
```
|
||||
① 让 AI 只看到当前需要的上下文 —— 该加载的东西,按需加载,不要一次性全带
|
||||
② 减少无关的上下文 —— 不该看到的东西,一开始就别带进来
|
||||
③ 减少重复的上下文 —— 同一份内容,不要在多轮里反复计费
|
||||
```
|
||||
|
||||
动手之前还有一个更前置的架构判断:是否需要拆多 Agent。拆分本身有成本(多份系统提示词并行计费),只有需求规模足够大,拆分撬动的后续收益才能覆盖这笔开销。所以我们先做规模预判(S/M/L 模式):小需求走单 Agent 直接处理;只有中大型需求,才进入多 Agent 并行调度。
|
||||
|
||||
#### 2.2 关键技术选型
|
||||
|
||||
| 原则 | 优化手段 | 解决的问题 |
|
||||
| --- | --- | --- |
|
||||
| 只看到当前需要的上下文 | 渐进式披露(L2/L3 分层) | SKILL.md 里条件性内容常驻,用不上也要计费 |
|
||||
| 确定性的操作由脚本执行 | 大模型擅长推理,不擅长精确执行。反复试错是隐藏成本 | |
|
||||
| MCP 数据获取子 Agent 化 | TAPD/Figma 原始 payload 直接进最长生命周期 Agent 的 context | |
|
||||
| 长期记忆按需索引加载 | 历史经验/技术方案全量加载,用不上的文档也占位计费 | |
|
||||
| 减少无关上下文 | 单 Agent 拆分为多 Agent | 全能型 Agent 背负所有领域的知识和历史 |
|
||||
| Agent 专属配置(工具白名单+模型分层) | 每个 Agent 都能看到所有 MCP 工具 Schema | |
|
||||
| 代码图谱替代盲搜 | 关键词盲搜带入大量无关文件内容 | |
|
||||
| 减少重复上下文 | 稳定前缀设计(状态外化) | 进度状态/执行状态混在会话里,破坏缓存前缀 |
|
||||
| 避免重复加载 Skill | 同一份长期记忆被下游 Agent 各自重新加载 | |
|
||||
| rtk 压缩 CLI 输出 | 命令行原始输出噪音在多轮循环中反复出现 | |
|
||||
| 工具调用并行化 | 无依赖的多次调用串行等待,历史被重复打包的轮次翻倍 | |
|
||||
|
||||
### 三、实践详解
|
||||
|
||||
#### 3.1 让 AI 只看到当前需要的上下文
|
||||
|
||||
##### 3.1.1 渐进式披露
|
||||
|
||||
Anthropic 在 Agent Skill 规范中提出了一个"渐进式披露"架构,核心思想是:不是所有内容都需要常驻 context,只有真正需要时才加载。
|
||||
|
||||
三层结构:
|
||||
|
||||
这种机制的好处是,即使安装了 20 个 Skill,初始加载也仅 1000-2000 token。相比单体式提示词,上下文使用量减少约 90%。
|
||||
|
||||
本次优化主要是把正文部分内容迁移到资源层。
|
||||
|
||||
- 条件性内容外移到资源层
|
||||
|
||||
__我们之前的问题是:__大量只在特定场景才需要的内容,混在 SKILL.md 正文里常驻 context。
|
||||
|
||||
以 自动化测试Skill 为例,改造前有几块内容其实是条件性的:
|
||||
|
||||
① spec 模板代码(约 40 行 TypeScript)
|
||||
|
||||
这段代码只在 Phase A 生成 spec 文件时用到一次,之后完全是冗余占位。所以我们把模版代码外置到references中,按需提取。
|
||||
|
||||
② DB 前置操作规则(约 38 行)
|
||||
|
||||
只有检测到 DB 依赖用例时才需要。一样把DB操作规则外置到references中,按需读取。
|
||||
|
||||
改造后自动化测试Skill正文从 198 行降到 128 行(-35%)。
|
||||
|
||||
- 步骤详情外移到资源层
|
||||
|
||||
比条件性内容更彻底的做法,是把"所有步骤的详细内容"都从 SKILL 正文移到资源层,正文只留骨架。
|
||||
|
||||
以 `tech-leader`Skill (主调度Skill)为例:
|
||||
|
||||
优化前,S/M 两种模式(小需求/中等需求)的完整工作流、Wave 1~5 各阶段的派发 prompt、审查规则、测试调度逻辑等执行细节全写在 SKILL.md 正文里,Skill 一旦激活就全量常驻 context。
|
||||
|
||||
但 TL 每次实际只走一条路径——判完规模后要么进 S 模式、要么进 M 模式,进 M 模式后又按阶段逐步推进,任一时刻真正用到的只是其中一小段,其余步骤的详细内容全程占位计费却用不上。
|
||||
|
||||
改法是把各步骤的详细执行内容拆到 `references/` 资源层,SKILL.md 只保留__骨架__——核心职责、规模预判维度表、分流规则、进度追踪机制、容错机制。
|
||||
|
||||
骨架负责"决定下一步走哪",具体"怎么走"则按需 `read_file` 对应的资源文件。
|
||||
|
||||
##### 3.1.2 确定性的操作由脚本执行
|
||||
|
||||
这里有两处优化:
|
||||
|
||||
- CLI 驱动一切环境操作和校验操作
|
||||
|
||||
一开始我的工作流里面,没有任何操作脚本和验证脚本。后来发现后端Agent写代码时,频繁出现拼错数据库连接参数、找错启动服务命令、绕过编译等等;因为反复查找各种参数、命令,为此消耗了大量token。
|
||||
|
||||
后来写了一个脚本,里面包含数据库迁移、编译、服务启动、健康检查等确定性的命令,全部让AI通过 dev-env.sh 脚本执行。AI 不拼接 mysql -u root -p 这种命令,只提供参数给脚本。
|
||||
|
||||
- 能用CLI就不用MCP
|
||||
|
||||
MCP 工具调用的隐藏成本:
|
||||
|
||||
MCP 工具给了 Agent 强大的能力,但每次 MCP 工具调用,实际上是一次完整的 LLM 推理轮次:
|
||||
|
||||
```
|
||||
每次 MCP 工具调用的真实成本:
|
||||
1. LLM 决策:判断调用哪个工具、构造参数 ← 一次 API 请求
|
||||
2. 工具 JSON Schema 常驻 context ← 每轮 10-15KB 额外 input
|
||||
3. 工具返回结果进入 context ← 可能几千行
|
||||
4. LLM 处理结果:分析输出、决定下一步 ← 又一次 API 请求
|
||||
```
|
||||
|
||||
自动化测试Skill中,我们最初用的是 Playwright MCP——通过 MCP 协议让 Agent 实时控制浏览器(打开页面、点击、截图)。但实践中发现几个问题:
|
||||
|
||||
- 每个操作都要消耗一次 AI 推理:点击一个按钮就是一次 MCP 调用 + 一次模型推理,10 步操作就是 10 轮对话,token 消耗大、速度慢
|
||||
- 不可重跑:MCP 模式下操作是实时的"一次性"行为,测试失败后想重跑一遍,Agent 需要重新推理一遍所有步骤
|
||||
- 无法并行:MCP 控制的是单个浏览器实例,多个用例只能串行执行
|
||||
|
||||
后面把Playwright MCP换成了Playwright CLI,CLI的核心思路是把自然语言用例翻译为 Playwright spec 文件,再调 Playwright CLI 批量执行。大模型做推理(生成 spec),脚本做执行(跑 CLI)。把"理解用例并翻译为代码"和"实际跑测试"拆成两步,前者需要 AI,后者完全不需要。
|
||||
|
||||
这次改造不仅节省了token,耗时也大大缩短。
|
||||
|
||||
##### 3.1.3 MCP 数据获取子 Agent 化
|
||||
|
||||
问题:主agent自己调 MCP,原始数据永久卡在最长生命周期的 context 里
|
||||
|
||||
tech-leader 工作流里,需求分析阶段要读 TAPD 需求、要读 Figma 设计稿,这两步 MCP 调用最早是主Agent自己直接发起的:
|
||||
|
||||
```
|
||||
● TAPD -> 返回mcp所有工具描述、返回完整需求描述、关联缺陷、任务列表
|
||||
|
||||
● Figma -> 返回mcp所有工具描述、返回设计稿完整节点树 JSON + 截图
|
||||
```
|
||||
|
||||
问题在于 TL 是整个工作流生命周期最长的 Agent。这两次 MCP 调用如果发生在 TL 自己的会话里,原始 payload——动辄几千字的需求描述、上万行的设计稿节点树 JSON——会一直留在 TL 的 context 里,后续几十轮工具调用都要重新计费一遍。
|
||||
|
||||
__改法:__给 TAPD/Figma 各建一个专属子 Agent,只返回结构化摘要
|
||||
|
||||
实测同一工作流改造前后,单轮会话 input token 从 1,030,000 降到 634,905,-38.4%。首次调用两种方式消耗基本一样,真正的收益在后续多轮会话不会带着原始 payload 越滚越大。
|
||||
|
||||
##### 3.1.4 长期记忆按需索引加载
|
||||
|
||||
context-keeper(知识沉淀Skill)负责在方案设计前加载历史经验/技术方案沉淀文档,最早的做法是把匹配到的候选文档全量读入,即使一份文档里只有一两条经验跟当前任务相关,剩下几十行也会一起进 context 常驻到会话结束。
|
||||
|
||||
改法是引入一层轻量的 INDEX.md 目录索引,把"查目录"和"读正文"拆成两步:
|
||||
|
||||
```
|
||||
❌ 改前:直接扫描 team/project 下所有历史文档,命中关键词就整篇 read_file
|
||||
✅ 改后:
|
||||
1. 先 read_file INDEX.md(几十行的标题+标签+摘要表格)
|
||||
2. 按关键词匹配标题/标签/摘要,结合类别权重计算相关度
|
||||
3. 取 Top 3 命中条目,才对这几篇 read_file 正文
|
||||
4. INDEX 不存在时才回退到全文 search_content(兜底,非常态路径)
|
||||
```
|
||||
|
||||
INDEX.md 本身是所有历史文档的目录,体量通常只有几十到一两百行——用几十行的索引筛选出真正相关的 2-3 篇,比一次性全量加载几十篇文档的正文便宜得多。相关度评分低于阈值的文档从一开始就不会进入 read_file 候选列表,从源头减少了"加载了但用不上"的常驻 token。
|
||||
|
||||
#### 3.2 减少无关的上下文
|
||||
|
||||
##### 3.2.1 单 Agent 拆分为多 Agent
|
||||
|
||||
最早的 tech-leader 是一个从头到尾自己干完所有事的单体 Agent,带来两个问题——前端/后端/测试/视觉规范混在同一段历史里,越跑越臃肿;全程一条会话没有重置时机,历史只会越滚越大。
|
||||
|
||||
改法是引入专职调度的 TL,把编码/测试/视觉校验分发给按角色划分的子 Agent(backend-dev / frontend-dev / test-runner / visual-reviewer / code-reviewer),每个子 Agent 只携带自己领域的提示词和工具,跑完即销毁,Wave 1 的前后端还能并行派发。
|
||||
|
||||
需要注意的是:拆分本身不是靠"减少历史堆叠"直接省钱的——6 个 Agent 并行跑,等于同时有 6 份系统提示词在计费。真正的收益是分散滚雪球效应(短生命周期子 Agent 跑完销毁,滚雪球被切段)和为后续优化打开空间(稳定前缀、工具裁剪、模型分层、子 Agent 化都建立在"已经拆分"的前提上)。这也是为什么要先做规模预判——小需求不做无谓拆分。
|
||||
|
||||
##### 3.2.2 Agent 专属配置
|
||||
|
||||
以前每个子 Agent 默认带上所有已注册 MCP Server 的工具 Schema(即使用不到),是一个隐藏的成本漏洞。
|
||||
|
||||
以前我们用的是CodeBuddy自带的TeamCreate工具,自动派生子 Agent来完成任务。但是这种模式就没办法给子 Agent设置mcp白名单、模型。后来我的改法是:给每个角色创建单独的自定义Agent,在创建团队时调用相应的自定义子 Agent执行任务。
|
||||
|
||||
这种做法可以在 Agent 定义文件的 frontmatter 中通过 tools 字段指定工具白名单,未列出的工具对该 Agent 完全不可见,比如后端开发Agent,就不需要任何mcp工具,只需要读文件、写文件等工具;
|
||||
|
||||
```
|
||||
---
|
||||
name: backend-dev
|
||||
tools: list_dir, search_file, search_content, read_file, replace_in_file, write_to_file, execute_command
|
||||
# 没有 mcpServers 字段 → Figma/TAPD/iWiki 等 MCP 全部不暴露
|
||||
---
|
||||
```
|
||||
|
||||
顺带的收益是把原来 主Agent派发子 Agent提示词里的大段稳定指令迁移到子 Agent 系统提示词里(更容易命中缓存),TL 的 派发提示词 从 10-15 行精简到 2 行动态内容。
|
||||
|
||||
同时可以按角色做模型分层路由:自动化测试、视觉还原对比 这类规则性强、推理要求低但轮次最多(修复循环)的角色换成 GLM-5v(智谱 GLM-5V 多模态模型,成本约 Sonnet 的 36%),成本节省随修复轮次倍增,测试/视觉 Agent 成本 -64%。
|
||||
|
||||
##### 3.2.3 代码图谱替代盲搜
|
||||
|
||||
Agent 在编码阶段做的第一件事,往往是"理解项目结构"。传统方式是 search_content 关键词搜索:
|
||||
|
||||
```
|
||||
搜索 "UserService" → 返回 20 个文件的匹配行
|
||||
搜索 "getUserById" → 返回 8 个文件的匹配行
|
||||
read_file UserService.java → 300 行进 context
|
||||
read_file UserController.java → 200 行进 context
|
||||
...
|
||||
```
|
||||
|
||||
每一次搜索返回的结果都会进入 context,大量无关匹配行随之带入。更糟的是,agent 往往需要多轮搜索才能逐渐定位——探索过程本身就是 token 消耗。
|
||||
|
||||
__代码图谱:一次查询直接定位__
|
||||
|
||||
后面我们的工作流中使用了 graphify 代码图谱,代码图谱使用AST和语义来给项目创建文件索引和依赖关系,在搜代码文件前先搜这个目录,锁定文件范围,再去read_file文件,能节省几十倍的token(官方预估数据)。
|
||||
|
||||
代码图谱的 token 节省不只体现在单次查询上,更重要的是减少了 Agent 的探索轮次。少一轮工具调用,就少一次 API 请求,就少一整个 context window 的 input token 计费。在修复循环场景下,这个收益会被轮次数放大。
|
||||
|
||||
__实测数据对比:__
|
||||
|
||||
我们在相同任务下分别测试了使用代码图谱和未使用代码图谱两种模式的 token 消耗:
|
||||
|
||||
| 指标 | 使用代码图谱 | 未使用代码图谱 | 差异 |
|
||||
| --- | --- | --- | --- |
|
||||
| 总计 | 676,987 | 875,352 | -22.7% |
|
||||
| 输入 token | 670,281 | 868,544 | -22.8% |
|
||||
| 缓存命中 | 609,903 | 820,175 | -25.6% |
|
||||
| 缓存未命中 | 60,378 | 48,369 | +24.8% |
|
||||
| 输出 token | 6,706 | 6,808 | -1.5% |
|
||||
| 缓存命中率 | 91.0% | 94.4% | -3.4pp |
|
||||
|
||||
关键发现:
|
||||
|
||||
1. 总 token 节省 22.7%——从 87.5 万降到 67.7 万,节省约 19.8 万 token
|
||||
2. 输入 token 是主要节省来源(-22.8%)——代码图谱减少了探索过程中带入 context 的冗余文件内容
|
||||
|
||||
__代码图谱使用小tips:__
|
||||
|
||||
1. 首先需要安装`graphify`
|
||||
|
||||
```
|
||||
uv tool install graphifyy
|
||||
```
|
||||
|
||||
2. 执行初始化
|
||||
|
||||
让graphify给你的代码仓库建立索引,大概需要几分钟的时间。初始化成功后,会生成一个graphify目录,
|
||||
|
||||
这个目录下面你只要提交4个文件就可以了,其他可以不用提交。
|
||||
|
||||
3. 增量更新
|
||||
|
||||
细心的同学可能会问了,那如果我的代码更新了怎么办?
|
||||
|
||||
你可以绑定Git Hook,graphify hook install一键绑定 post-commit + post-checkout,commit 后自动增量更新图谱、checkout 后自动切换分支图谱。
|
||||
|
||||
省时间技巧:直接丢github链接给AI,让AI帮你完成安装,git hook绑定等等。( https://github.com/Graphify-Labs/graphify )
|
||||
|
||||
4. 怎么用
|
||||
|
||||
直接告诉AI代码搜索请使用代码图谱graphify,就会自动触发
|
||||
|
||||
#### 3.3 减少重复的上下文
|
||||
|
||||
##### 3.3.1 稳定前缀设计
|
||||
|
||||
__KV Cache:为什么前缀稳定等于省钱?__
|
||||
|
||||
理解这个优化,需要先了解一点 Transformer 的底层机制。
|
||||
|
||||
LLM 处理每个 token 时,需要对它之前所有 token 做注意力计算(Attention),这个过程会产生两个中间矩阵:K(Key)和 V(Value),合称 KV Cache。KV 矩阵的计算量是 O(n²)——这是推理成本的主要来源。
|
||||
|
||||
Prompt Cache 的本质是:如果你本次请求的前缀和上次完全一致,服务商直接复用上次的 KV 矩阵,跳过重复计算,只收缓存读取的低价(约正常价格的 10%)。
|
||||
|
||||
我们发现 「派发子 Agent的提示词」里稳定指令和动态内容(技术方案文档)交错排列,导致前缀无法命中缓存,改法是把动态内容统一后置。
|
||||
|
||||
__主Agent自身还有个隐藏的前缀破坏者:__进度状态不断在会话里输出累积。原来每个阶段切换都要在对话里输出完整进度看板,堆积在历史里导致历史不能被压缩。改法是把进度状态外化到文件中:
|
||||
|
||||
主Agent每次被唤醒先 read_file 进度文件,而不是回放历史。阶段切换也改成单行输出(✅ Wave 1 完成 → Wave 2 🔄 已启动),额外收益是会话中断后可直接读文件恢复现场。
|
||||
|
||||
##### 3.3.2 避免重复加载 Skill
|
||||
|
||||
排查 「前端Agent」 的 context 膨胀时发现,"调用 知识沉淀Skill 加载项目上下文"这一步其实没必要——主Agent 做方案设计时已经加载过历史经验并写入了技术方案文档,
|
||||
|
||||
前端Agent 直接读文档就能拿到结论,不需要重新触发 use_skill 把 200 行 SKILL.md 再次加载进 context。信息应该在最上游收集一次,通过文档传递给下游,而不是让每个 Agent 各自重复获取。
|
||||
|
||||
##### 3.3.3 rtk 压缩 CLI 输出
|
||||
|
||||
git status、npm test、docker ps 这类命令的原始输出夹带大量噪音,在自动化测试的修复循环中反复出现。我们接入了 rtk——一个在命令执行前拦截、重写为压缩版本的开源 CLI 代理,官方实测降幅 60%-90%。
|
||||
|
||||
__接入时踩了两个坑:__
|
||||
|
||||
① 官方 --agent 不支持 CodeBuddy,改为用 CodeBuddy 的 PreToolUse Hook 机制自己实现等价拦截;
|
||||
|
||||
② rtk 输出字段是 updatedInput,CodeBuddy 要求的是 modifiedInput,字段名不一致会导致静默失效(不报错但不生效),需要写一个几行的转换脚本做字段名转换。
|
||||
|
||||
评估 rtk 效果时也踩了方法论的坑:最初想用"同一需求跑两遍完整工作流,rtk 开/关各一次"对比,但大模型的执行路径本身不确定(探索轮次、有没有踩坑重试都会波动),噪声比 rtk 本身的效果还大。
|
||||
|
||||
更可靠的方式是用 rtk gain 统计或直接命令行对比——因为 rtk 的压缩是纯文本过滤,跟大模型决策无关,100% 可复现:
|
||||
|
||||
幅度因命令而异(ps aux -98.9%,纯 git status 仅 -31%),不能拿"60%-90%"当固定值。全局配置一次(~/.codebuddy/settings.json),所有子 Agent 自动获得压缩效果。
|
||||
|
||||
##### 3.3.4 工具调用并行化
|
||||
|
||||
无依赖关系的多次工具调用如果串行执行,每一次调用都是一轮独立的 LLM 推理,前面所有轮次的历史都要跟着重新打包计费一遍——调用次数越多,滚雪球轮次越多。我们排查了两类典型的"本可并行却串行"场景:
|
||||
|
||||
```
|
||||
❌ 改前:TAPD 摘要获取 → 等结果 → 再发起 Figma 摘要获取 → 等结果
|
||||
两次子 Agent 调用互不依赖,却占用了 2 轮历史累积
|
||||
|
||||
✅ 改后:TAPD/Figma 若同时存在,同一轮消息内并行发起
|
||||
Task 工具同时传入两个 subagent_name 调用,一轮内拿到两份摘要
|
||||
```
|
||||
|
||||
TAPD 需求摘要和 Figma 设计稿摘要本身没有先后依赖,我们把 tapd-req-analyzer、figma-design-analyzer 的派发方式从"依次调用、等结果"改成"同一轮消息内并行发起",两个子 Agent 各自跑完即销毁,主Agent 一轮就拿到两份摘要,比串行少一轮历史打包。
|
||||
|
||||
测试用例执行也是同理:自动化测试阶段原来是一条 spec 执行完再执行下一条,改法是让 Playwright CLI 一次接收多个 spec 文件、内置多 worker 并行跑(详见"CLI 替代 MCP"一节的批量执行方式),LLM 侧只需 1 次调用 + 1 次读汇总结果,不随用例数线性增加推理轮次。
|
||||
|
||||
__判断是否可并行的原则很简单:__两次调用之间没有数据依赖(后一次不需要前一次的输出作为输入)就应该并行,这类"沉默的串行"往往藏在最初写 prompt 时"想清楚一步再写下一步"的顺序思维里,需要专门排查才能发现。
|
||||
|
||||
### 四、效果与数据
|
||||
|
||||
#### 4.1 核心指标
|
||||
|
||||
| 维度 | 优化前 | 优化后 | 降幅 |
|
||||
| --- | --- | --- | --- |
|
||||
| 主Agent端到端 token | 708,783(17 轮) | 315,266(9 轮) | -55.5%,轮次 -47% |
|
||||
| 子 Agent 单轮固定开销 | 常见上几十万 token | 减少约 20,000 token | 视配置 |
|
||||
| 子 Agent 命令行输出 | 原始 CLI 输出 | rtk 压缩后 | -60%~90% |
|
||||
| 测试/视觉子 Agent 模型成本 | claude Sonnet 计价 | GLM-5v 计价 | -64% |
|
||||
|
||||
#### 4.2 分项收益汇总
|
||||
|
||||
| 优化项 | 所属原则 | 主要收益 |
|
||||
| --- | --- | --- |
|
||||
| 渐进式披露 | 看到需要的 | SKILL.md 体积 -35% |
|
||||
| 确定性操作由脚本执行 | 看到需要的 | 消除 Schema 开销,减少 LLM 推理轮次 |
|
||||
| MCP 数据获取子 Agent 化 | 看到需要的 | 单轮 input token -38.4% |
|
||||
| 长期记忆按需索引加载 | 看到需要的 | INDEX 先行筛选,避免全量文档常驻 |
|
||||
| 单 Agent 拆分为多 Agent | 减少无关 | 打开后续优化空间,分散滚雪球效应 |
|
||||
| Agent 专属配置 | 减少无关 | 测试/视觉 Agent 成本 -64% |
|
||||
| 代码图谱 | 减少无关 | 总 token -22.7% |
|
||||
| 稳定前缀设计 | 减少重复 | 提升缓存命中率 |
|
||||
| 避免重复加载 Skill | 减少重复 | 消除重复常驻的 SKILL.md 开销 |
|
||||
| rtk 压缩 CLI 输出 | 减少重复 | 命令行输出 -60%~90% |
|
||||
| 工具调用并行化 | 减少重复 | 无依赖调用合并为 1 轮,减少历史重复打包次数 |
|
||||
|
||||
全流程反推:以实测的 Wave 消耗分布为基准,代入各分项已验证的降幅区间反推,一个中型需求跑完全流程,token 成本大致能降低 50%~65%。
|
||||
|
||||
### 五、总结与展望
|
||||
|
||||
回顾整个实践过程,我们沉淀了以下几点核心经验:
|
||||
|
||||
1. 省 token 不等于功能降级——只是调整"何时加载""怎么表达",没删任何功能,反而让工作流更清晰。
|
||||
2. 上游收集一次,通过文档传递——最贵的冗余是"每个 Agent 各自重新发现同一份信息"。
|
||||
3. 最省钱的调用是不调用——确定性操作用 CLI/数据预取解决,把 LLM 留给真正需要语义理解的地方。
|
||||
4. 能并行就不要串行——没有数据依赖的多次调用,合并到同一轮消息内发起,能省下的是历史被重复打包的那几轮,而不只是等待时间。
|
||||
|
||||
落地优先级:先做规模预判和 Agent 拆分(架构前提)→ 度量 + SKILL.md 重排 + 全局接入 rtk(一个下午见效)→ 条件内容移出 SKILL.md、状态外化、排查无依赖调用改并行(逐步推进)→ 代码图谱、CLI 替代 MCP、工具裁剪、子 Agent 化、长期记忆索引化(中长期系统性梳理)。
|
||||
|
||||
目前这套"三原则、十方向"的优化方法已在 tech-leader 工作流全面落地,后续我们将补齐严格的端到端 A/B 复核,并把方法论沉淀为可复用的 checklist,应用到团队内其他 Multi-Agent 工作流的成本治理中。
|
||||
|
||||
如果你的团队也在做类似的 token 成本优化,欢迎在评论区交流讨论 💬
|
||||
|
||||
__参考资料__
|
||||
|
||||
- How we built our multi-agent research system | Anthropic Engineering Blog
|
||||
- Improving token efficiency in GitHub Agentic Workflows | GitHub Blog
|
||||
- Agent Skill 规范、构建与设计模式 | 阿里技术
|
||||
- rtk-ai/rtk:CLI proxy that reduces LLM token consumption by 60-90% | GitHub
|
||||
@@ -0,0 +1,74 @@
|
||||
# 📊 文章摘要:靠这10个优化点,我们把Multi-Agent工作流成本降了50%以上
|
||||
|
||||
> **原文**:[2026-08-27_靠这10个优化点_我们把Multi-Agent工作流成本降了50_以上](./2026-08-27_靠这10个优化点_我们把Multi-Agent工作流成本降了50_以上.md)
|
||||
> **原文链接**:https://mp.weixin.qq.com/s/TIdXNlrcAOUZWVW1oWnnKQ
|
||||
> **来源**:微信公众平台(腾讯技术工程)
|
||||
> **作者**:腾讯程序员(lemonye)
|
||||
> **发布日期**:2026-08-27
|
||||
> **摘要日期**:2026-08-27
|
||||
> **价值评级**:⭐⭐⭐ 高
|
||||
|
||||
---
|
||||
|
||||
## 核心命题
|
||||
|
||||
> **Token 成本治理** — Multi-Agent 工作流烧钱不可怕,可怕的是不知道烧在哪;先建度量拆解六类消耗来源,再按"只看需要的、减少无关的、减少重复的"三原则系统性压缩,降本 50%~65% 而不牺牲任何功能。
|
||||
|
||||
---
|
||||
|
||||
## 文章概要
|
||||
|
||||
本文是腾讯团队对 tech-leader Harness 工作流(1 个 TL + 6 个子 Agent 驱动前后端全流程开发)的 token 成本优化实录。先以 AgentLens 度量平台把消耗拆解为六类来源(系统提示词、工具返回、文件信息、长期记忆、历史消息、用户提示词),发现大头在滚雪球式增长的历史消息与常驻的 Schema/payload。围绕三原则落地十个优化方向:渐进式披露、CLI 替代 MCP、MCP 数据获取子 Agent 化、长期记忆索引化、多 Agent 拆分、工具白名单+模型分层、代码图谱、稳定前缀、rtk 压缩、并行化。主 Agent 端到端 token 从 70.8 万降至 31.5 万(-55.5%)。价值在于全部优化项有实测数据、踩坑细节(rtk 字段名静默失效、评估方法论陷阱)如实披露;局限是"50%~65% 全流程降幅"是分项反推而非端到端 A/B 实测(作者自认待补)。
|
||||
|
||||
---
|
||||
|
||||
## 关键要点
|
||||
|
||||
1. **没有度量就没有优化** — 先用 AgentLens 按 TraceId/SessionId 拆解消耗分布,再动手;六类来源中历史消息(append-only 滚雪球)与工具 Schema(40 工具 MCP 每轮 10-15KB)是被忽视的大头。 `[分类: 共识]`
|
||||
2. **渐进式披露:SKILL.md 只留骨架** — 条件性内容与步骤详情外移到 references/ 资源层按需读取;自动化测试 Skill 正文 -35%,即使装 20 个 Skill 初始加载也仅 1000-2000 token。 `[分类: 共识]`
|
||||
3. **能用 CLI 就不用 MCP** — 每次 MCP 调用是一次完整 LLM 推理轮次(决策+Schema+结果+处理四重开销);Playwright MCP 换成 CLI 后,大模型只做"用例翻译为 spec",执行交给脚本,可重跑可并行。 `[分类: 共识]`
|
||||
4. **MCP 原始 payload 子 Agent 化隔离** — TAPD/Figma 的几千字需求、上万行设计树 JSON 不能进入生命周期最长的 TL context;专属子 Agent 只返回结构化摘要,单轮 input token -38.4%。 `[分类: 共识]`
|
||||
5. **Agent 专属配置:工具白名单+模型分层** — frontmatter tools 字段裁剪不可见工具;规则性强、轮次最多的测试/视觉 Agent 换 GLM-5v(成本约 Sonnet 36%),成本 -64%。 `[分类: 共识]`
|
||||
6. **代码图谱替代盲搜** — graphify 用 AST+语义建索引,先锁文件范围再读文件;同任务实测总 token -22.7%,探索轮次减少使收益在修复循环中被放大。 `[分类: 共识]`
|
||||
7. **稳定前缀=缓存命中=省钱** — KV Cache 复用要求前缀完全一致,动态内容后置;进度状态外化到文件(唤醒先 read_file 而非回放历史),顺带获得断点恢复能力。 `[分类: 共识]`
|
||||
8. **最省钱的调用是不调用 + 能并行不串行** — 确定性操作交脚本;无数据依赖的调用合并到同一轮发起,省下的是历史被重复打包的轮次。 `[分类: 共识]`
|
||||
|
||||
---
|
||||
|
||||
## 批判性分析
|
||||
|
||||
### 假设前提
|
||||
|
||||
作者默认:(1) token 成本是 Multi-Agent 工作流的主要矛盾(人力时间成本未纳入 ROI 对比);(2) 分项实测降幅可以线性叠加反推全流程(各优化项之间可能存在收益重叠,如并行化与子 Agent 化均减少历史打包);(3) 单次对比的数值(如 -22.7%、-38.4%)在任务分布变化后仍稳定。
|
||||
|
||||
### 论据与逻辑
|
||||
|
||||
单项优化均有改造前后实测数据,可信度高;rtk 评估的方法论反思(大模型执行路径不确定导致 A/B 噪声大于效果,改用 100% 可复现的纯文本对比)体现严谨。但"全流程 50%~65%"确为反推值,端到端 A/B 复核作者自己承认待补齐,引用该数字时应标注。多 Agent 拆分"本身不省钱、收益在打开后续空间"的澄清诚实且重要。
|
||||
|
||||
### 边界与局限
|
||||
|
||||
结论基于 CodeBuddy + AgentLens 内网生态,SGLang/Claude Code 等环境的度量工具不同需适配;S/M/L 规模预判的阈值依赖团队任务画像;模型分层引用的 GLM-5v 便宜 64% 的结论绑定了特定任务类型(规则性强的测试/视觉),不可外推到推理密集型角色。
|
||||
|
||||
---
|
||||
|
||||
## 可引用金句
|
||||
|
||||
> "没有度量就没有优化。"
|
||||
|
||||
> "最省钱的调用是不调用——确定性操作用 CLI/数据预取解决,把 LLM 留给真正需要语义理解的地方。"
|
||||
|
||||
> "省 token 不等于功能降级——只是调整'何时加载''怎么表达',没删任何功能,反而让工作流更清晰。"
|
||||
|
||||
> "上游收集一次,通过文档传递——最贵的冗余是'每个 Agent 各自重新发现同一份信息'。"
|
||||
|
||||
---
|
||||
|
||||
## 总体评价
|
||||
|
||||
**亮点**:三原则十方向全部带实测数据与代码级细节(frontmatter 配置、rtk 字段名踩坑),可复现性强;六类消耗来源的拆解框架本身即是分析工具;落地优先级排序(一个下午见效项→逐步推进项→中长期项)极具操作性。
|
||||
|
||||
**不足**:全流程 50%~65% 降幅是反推而非端到端实测;部分数据为单次对比样本;强绑定 CodeBuddy/AgentLens 生态。
|
||||
|
||||
**适用场景**:任何 Multi-Agent/Harness 工作流上量后的成本治理;Skill 设计规范审查(渐进式披露检查);Agent 架构评审(拆分时机、工具暴露面、模型路由)。
|
||||
|
||||
**关联建议**:与本院 tech 项目 Harness 工作流直接互证——渐进式披露与 skill 正文精简可立即用于 arno 系 skill 体检;与同批《对Loop Engineering的思考》的"预算思维"章节合并阅读(本文是其实测版);与 2026-08-20《Skill 工程方法论》"Thin Harness, Fat Skills"互为表里:Skill 变厚的同时必须靠资源层分层控制常驻成本。
|
||||
@@ -14,6 +14,59 @@
|
||||
- 360 x 276
|
||||
- 540 x 414
|
||||
|
||||
## 2026-08-28
|
||||
|
||||
- [Agent 工程纵深](https://mp.weixin.qq.com/s/kz_7d66dhmPhOUlcMh4MzA)
|
||||
- 
|
||||
- 
|
||||
- **Agent 规模化落地的竞争从"写得出"转向"跑得起、记得住、停得下"——团队经验治理、无人值守循环与 token 成本治理构成工程纵深的三大支柱。**
|
||||
- 认知层: [AI Coding的下一站,不是更会写代码,而是更懂团队](https://mp.weixin.qq.com/s/kz_7d66dhmPhOUlcMh4MzA)
|
||||
- 摘要:[查看](./微信公众平台/腾讯程序员/2026-08-27_AI_Coding的下一站_不是更会写代码_而是更懂团队_摘要.md)
|
||||
- 腾讯程序员 / 微信公众平台
|
||||
- **经验治理**——经验唯一定义是"被召回后能改变 Agent 行为";Review/Dedup/Merge 三层治理把 90% 废料提纯为 789 条高置信经验
|
||||
- 认知层: [对Loop Engineering的思考](https://mp.weixin.qq.com/s/g3HtSeJfKfjtqDG4rPTpiw)
|
||||
- 摘要:[查看](./微信公众平台/吕昊俣/2026-08-27_对Loop_Engineering的思考_摘要.md)
|
||||
- 吕昊俣 / 微信公众平台
|
||||
- **循环工程**——五代演进框架(Prompt→Context→Harness→Loop→Graph)+ 控制论根基;90% 正确率六次嵌套即抛硬币,负反馈闭环是唯一解药
|
||||
- 实践层: [靠这10个优化点,我们把Multi-Agent工作流成本降了50%以上](https://mp.weixin.qq.com/s/TIdXNlrcAOUZWVW1oWnnKQ)
|
||||
- 摘要:[查看](./微信公众平台/腾讯程序员/2026-08-27_靠这10个优化点_我们把Multi-Agent工作流成本降了50_以上_摘要.md)
|
||||
- 腾讯程序员 / 微信公众平台
|
||||
- **Token 成本治理**——六类消耗拆解 + 三原则十方向,主 Agent 端到端 token -55.5% 而功能零删减;最省钱的调用是不调用
|
||||
- 实践层: [欠了两年的文档债,我让WorkBuddy用30分钟还清了](https://mp.weixin.qq.com/s/8xSZw_ErYSGnXVt3-bIkKA)
|
||||
- 摘要:[查看](./微信公众平台/晚枫/2026-08-27_欠了两年的文档债_我让WorkBuddy用30分钟还清了_摘要.md)
|
||||
- 晚枫 / 微信公众平台
|
||||
- **溯源生成**——AI 文档的可信度来自 file://路径#行号 溯源机制与"不许编造"约束,文档从负债变可重跑资产
|
||||
|
||||
- [最弱环节定律](https://mp.weixin.qq.com/s/sML85XFffyFIepjHpQcCJA)
|
||||
- 
|
||||
- 
|
||||
- **闭源推理资产的攻防成为新战线——模型家族的安全上限由最弱的兼容模型决定;与此同时高性能开源模型把智能价格压到原来的 1/10。**
|
||||
- 认知层: [学术分享丨116页论文教你「蒸馏」Claude、GPT-5.6](https://mp.weixin.qq.com/s/sML85XFffyFIepjHpQcCJA)
|
||||
- 摘要:[查看](./微信公众平台/机器之心/2026-08-27_学术分享_116页论文教你_蒸馏_Claude_GPT-5.6_摘要.md)
|
||||
- 机器之心 / 微信公众平台
|
||||
- **最弱环节定律**——加密推理块可跨模型重放,弱模型沦为解密预言机;蒸馏、绕过安全、隐私泄漏、隐形提示注入四路攻击,公开 Agent 轨迹须删除密文
|
||||
- 资讯层: [ox-alpha 揭晓:GLM-5.3-Flash 开源,SGLang Day0 支持](https://mp.weixin.qq.com/s/YLqgHOgPvL17FQPnBgTZFw)
|
||||
- 摘要:[查看](./微信公众平台/卡工/2026-08-27_ox-alpha_揭晓_GLM-5.3-Flash_开源_SGLang_Day0_支持_摘要.md)
|
||||
- 卡工 / 微信公众平台
|
||||
- **智能平价**——320B-A18B 原生多模态 + MIT 协议可商用,智能指数 57 档位单任务成本压至 $0.045,匿名测试登顶 OpenRouter
|
||||
|
||||
- [人机共进](https://mp.weixin.qq.com/s/KElyAyEuB6RooLvue0SysA)
|
||||
- 
|
||||
- 
|
||||
- **AI 议题正从技术层面向组织与个体纵深下沉——数字员工入编、管理者统筹两种生产力、个体在智能丰饶中重新学会停顿。**
|
||||
- 认知层: [为抓住当代唯一的科技转折点,用AI最猛的一批人已经不睡觉了](https://mp.weixin.qq.com/s/KElyAyEuB6RooLvue0SysA)
|
||||
- 摘要:[查看](./微信公众平台/不懂经也叔的Rust/2026-08-27_为抓住当代唯一的科技转折点_用AI最猛的一批人已经不睡觉了_摘要.md)
|
||||
- 不懂经也叔的Rust / 微信公众平台
|
||||
- **意志稀缺**——AI 移除认知摩擦使行动先于判断;真正的意志是在"我能做"的情况下仍然判断"我不做"的停止能力
|
||||
- 认知层: [当AI领到工牌,难题才刚开始](https://mp.weixin.qq.com/s/bhS1KCnAUp5jm4_YPHqFCA)
|
||||
- 摘要:[查看](./微信公众平台/智联招聘/2026-08-24_当AI领到工牌_难题才刚开始_摘要.md)
|
||||
- 智联招聘 / 微信公众平台
|
||||
- **数字员工化**——23% 企业已给数字员工写岗位说明书;BCG 实验:把 AI 当"员工"看反而让人责任感下降、归咎上升
|
||||
- 资讯层: [AI无法替代大学,他向年轻人发出时代之问](https://mp.weixin.qq.com/s/Z4i8gqE__nIaV8hOqB4qlA)
|
||||
- 摘要:[查看](./微信公众平台/广东发布/2026-07-30_AI无法替代大学_他向年轻人发出时代之问_摘要.md)
|
||||
- 广东发布 / 微信公众平台
|
||||
- **大学不可替代**——薛其坤时代之问:中国能不能成为世界科学中心(节目预告,低价值未单独配图)
|
||||
|
||||
## 2026-08-20
|
||||
|
||||
- [Skill 工程方法论](https://mp.weixin.qq.com/s/sZXl5kHA9LErEwnegpvgXg)
|
||||
|
||||

Binary file not shown.
|
After Width: | Height: | Size: 26 KiB |

Binary file not shown.
|
After Width: | Height: | Size: 6.0 MiB |

Binary file not shown.
|
After Width: | Height: | Size: 20 KiB |

Binary file not shown.
|
After Width: | Height: | Size: 2.9 MiB |

Binary file not shown.
|
After Width: | Height: | Size: 22 KiB |

Binary file not shown.
|
After Width: | Height: | Size: 3.2 MiB |
Reference in New Issue
Block a user