 arno
5f2964bf68
按主题分三组归档:Agent 工程纵深(经验治理/循环工程/
Token 成本治理/溯源生成)、最弱环节定律(推理链窃取/
GLM-5.3-Flash 开源)、人机共进(意志稀缺/数字员工化/
大学之问);每组配 4K 题图与 160x90 缩略图共 3 组,
昇腾 WAIC 纯图片一文无法文本化按先例未收录
256 lines
13 KiB
Markdown
256 lines
13 KiB
Markdown
# 对Loop Engineering的思考
|
||
|
||
> **来源**:微信公众平台(腾讯云开发者)
|
||
> **作者**:吕昊俣
|
||
> **发布日期**:2026-08-27
|
||
> **原文链接**:https://mp.weixin.qq.com/s/g3HtSeJfKfjtqDG4rPTpiw
|
||
|
||
---
|
||
|
||
OpenClaw 的创始人在 6月8日 凌晨 2:58 发布推文: Here's your monthly reminder that you shouldn't be prompting coding agents anymore. You should be designing loops that prompt your agents"。简单翻译一下就是:我们要设计一个循环去代替不停地Prompt,把人从流程中拔出来。loop是不是又是AI圈造了一个新词,不清楚,但是确实给我们看待"问题"提供了一个新的视角。
|
||
|
||
## 01
|
||
|
||
范式迁移:从 Harness 到 Loop 再到Graph Engineering
|
||
|
||
__1.1 五代工程演进__
|
||
|
||
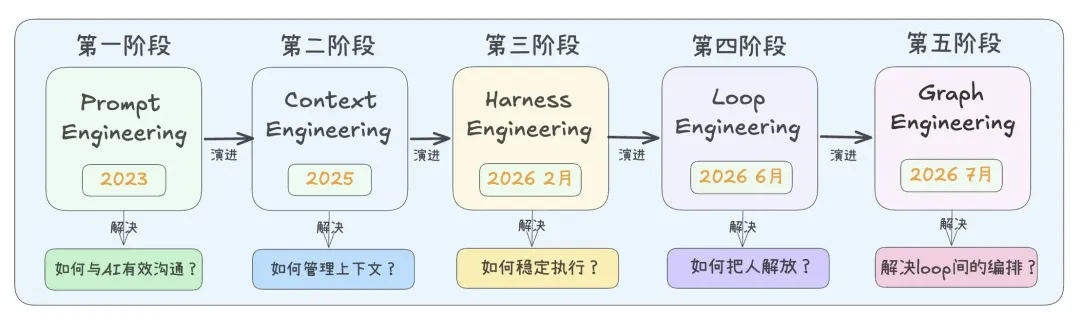
从 2022 到 2026,AI 辅助编程经历了清晰的开发__模式的转移__。
|
||
|
||
工程师的核心工作,逐渐从__"直接写业务代码"__转向__"设计系统,并让系统生成代码"__的阶段。
|
||
|
||
|
||
|
||
每一代都是一次__精进__:
|
||
|
||
1. __Prompt Engineering__(2023)解决了"怎么问,模型才答得好",把质量押在一次提示词上。缺点是:答错了没有自动纠偏,只能人工重来。
|
||
2. __Context Engineering__(2025)解决了"模型缺背景、答不准",上下文管理让信息更充分。缺点是:只有信息、没有手脚,缺标准化执行环境,也缺验证闭环。
|
||
3. __Harness Engineering__(2026 2月)解决了、"单次执行不可控、不可信",生产级运行外壳让 Agent 能安全、可控、可验证地跑通一次。缺点是:仍要人触发、让人盯,人成了生产节点的最大瓶颈。
|
||
4. __Loop Engineering__(2026 6月)解决了"__靠人盯",自动化调度实现最大限度的无人值守,但仍面临着成本失控的问题。
|
||
5. __Graph Engineering__(2026 7月)解决了"Loop间的编排、协同、调度等问题",构建起工程级复杂 AI 任务系统。
|
||
|
||
__1.2 它们的结构关系:层层依赖 逐步递进__
|
||
|
||
每一次的演进,__并不是一次替代__,而是建立在上一代的能力之上。
|
||
|
||
就拿Harness和Loop的关系来说,创始人Addy Osmani 给出了精准的概括:
|
||
|
||
__Harness 是 AI 代理的受控运行环境;Loop 是在这个环境之上,叠加了自驱动能力的持续执行流程。__
|
||
|
||
Harness 是地基,Loop 是上层调度,没有Harness,Loop 则是无源之水。
|
||
|
||
而把它们结合在一起看,更为直观明了。
|
||
|
||
__1.3 从技术Loop到产品Loop__
|
||
|
||
跳出单纯的技术视角,__吴恩达__则给出了不同的__"取景框"__,把 Loop 的涉众范围扩大去思考。
|
||
|
||
(见:https://www.deeplearning.ai/the-batch/three-key-loops-for-building-great-software)
|
||
|
||
文中给出了三个环:__技术->产品->用户,__它们__三层嵌套、不同速度、层层驱动__。
|
||
|
||
__技术 Loop__解决的是 "系统会不会收敛、会不会停、会不会认错";
|
||
|
||
__产品 Loop__ 解决的是 "这个闭环是否持续创造用户价值、是否值得继续放大、是否能形成长期增长飞轮";
|
||
|
||
__用户Loop__则反应了用户对产品的一种__"情绪",最终将以__某种形式__回到产品本身。
|
||
|
||
__1.4 Loop的工程基础 : 控制论__
|
||
|
||
大约160年前,英国通过了《红旗法案》,此法案要求机动车__前必须有人持红旗引导__,以保护人的安全,是不是有点匪夷所思,但160年后的今天,在AI编程领域,__历史在重演__,人就站在AI的前头,时时刻刻盯着。一个字 : 累。
|
||
|
||
从原理上看,LLM是一个概率模型,本质上,它就是在:__猜__。
|
||
|
||
虽是猜,但有人会说,现在猜的已经很准了,正确率接近__90%__。
|
||
|
||
是的,90%听起来很不错,但是,事实上可能很糟糕,因为,软件工程一定会使用__分治的方法__解决复杂问题,顺其自然的,一个复杂任务就变成了N多子任务的叠加,那么就变成了一个指数运算,仅仅六次后,概率就接近50%, 这不是就是__抛硬币吗__!
|
||
|
||
为了解决这个问题,于是乎,很自然地就想,有没有一种机制可以__修正这个损失概率?__有,这种机制就是控制论。
|
||
|
||
而控制论的思想,早从__VibeCoding__时,我们就在每天下意识的使用它。
|
||
|
||
只是这个__系统=我+AI__,比如在构建Prompt的过程:
|
||
|
||
而控制论的本质一句话就可以说明白__:通过负反馈机制去收敛目标函数。__说白了,Loop Engineering就是控制论在AI领域的一次落地应用。
|
||
|
||
__1.5 控制论四大公理__
|
||
|
||
于是乎,最近又翻开了大学时候没有好好上的课程:__《反馈控制系统设计》__,温习了一下控制论中最基本的几点思想:
|
||
|
||
1. __构建负反馈闭环__
|
||
2. __可观测性__
|
||
3. __可控性约束__
|
||
4. __离散迭代纠偏__
|
||
|
||
而这些点,更好的帮助我去理解Loop Engineering,我会清晰的看到,它们__一一对应,同根同源__。
|
||
|
||
映射如下:
|
||
|
||
## 02
|
||
|
||
从"写Prompt" 到 "设计Loop"
|
||
|
||
__2.1 回到问题本身:要设计一个"无人值守"的系统,咋做?__
|
||
|
||
我常常有这样的期待:一个任务,在晚上睡觉前 设计好,我睡觉,他干活,早上起来,完事。但现实往往是早上起来一看,什么东西!借助Loop的思维,我们如何重新思考这个问题?让AI可以在一定的成本下 完成任务。我想这里关键的实践路径是:__从小闭环做起,不断扩展边界__
|
||
|
||
在设计一个Loop的时候,我们往往会陷入到一个惯性思维里:
|
||
|
||
一上来就像做__一个全自动开发、全自动修复__的万能循环,结果往往差强人意。而比较实现的做法是:
|
||
|
||
__先跑通一个最小可收敛闭环,再逐步放大自治边界,并从中建立起闭环和闭环之间的联系。把小闭环跑通,才有资格谈大闭环,大循环是在一个个小循环上长出来的。__
|
||
|
||
而不管是大小闭环,最核心的是想清楚下面几个问题:
|
||
|
||
1. 如何定义__问题__?
|
||
2. 如何定义__开始__?
|
||
3. 如何设计__反馈__?
|
||
4. 如何定义__结束__?
|
||
|
||
__"设计反馈"__的背后是说,你需要设计一个__机制__,让模型真的会__说"不"__,这种"不" 并不是在提示词里一些拒绝意图的Prompt,这种看似在否定,但其实还是在肯定,而这种"不"是基于__某种不可否认的事实__,而从这种不,就天然形成了最关键的__"负反馈"__链路。
|
||
|
||
__"如何结束"__的背后是说,你需要设计一个__机制__,保证不会__无限循环__,看看你的Token账单,你知道我在说什么吧。
|
||
|
||
按我们带着以上的问题,看看官方的__参考答案__如何。
|
||
|
||
__2.2 五大组件+记忆模块__
|
||
|
||
在《Loop Engineering 循环工程》(https://addyosmani.com/blog/loop-engineering/)一文中,详细讲解了这几个部分,如下图所示:
|
||
|
||
1. __一个唤醒机制: Automations__
|
||
|
||
以往和AI协作,__是我推一下,它动一下__。讲道理,很累人。一个唤醒机制就保证了,人不用再去__"盯着,去喊",__这是整套自动化系统运行的前提。
|
||
2. __安全独立的沙箱环境: Worktrees__
|
||
|
||
多Agent协同必然会变成一种趋势,为每个任务分配独立代码工作区,就杜绝文件覆盖、环境互相污染等问题。
|
||
3. __对抗性思维:Maker-Checker 双校验模式__
|
||
|
||
Maker-Checker模式本质上就是保证了:__让模型不要自说自话__,采用__"一方做、一方质疑"__的制衡思路,结合Skills的经验库。二者互补修正,大幅提升输出质量。
|
||
4. __通信模式:Connectors__
|
||
|
||
作为一种系统间的沟通手段,比如MCP、Functioncall等等,就是为了打通所有的上下游系统,把系统链接起来,
|
||
5. __长任务记忆系统: Memory__
|
||
|
||
防止任务"失忆"。长流程任务没法全塞进 AI 有限上下文里,记忆组件会全程记录任务进度、过往尝试,防止多轮迭代后系统忘记目标、丢失执行记录。
|
||
|
||
## 03
|
||
|
||
如何让模型说"不"?
|
||
|
||
__3.1 方法一:践行TDD!!!__
|
||
|
||
让模型说"不",最关键就是__有硬性__的__不可怀疑__的证据。
|
||
|
||
而在软件工程中,测试不过就是铁的依据。
|
||
|
||
因此,AI时代,我们需要重新思考:__TDD的价值以及如何实践?__
|
||
|
||
而从Loop的视角重新看TDD,我们会发现:
|
||
|
||
TDD的价值并不是多写几个测试用例,而是,__可以把需求翻译成反馈信号__。
|
||
|
||
这做到这里的前提,就是:落实TDD__左移__。
|
||
|
||
多少次实践中,我也常常会等到开发完之后,再给AI补一句:__请补充测试用例。__
|
||
|
||
而这种习以为常的习惯,其实已经__偏离__的TDD的本质。
|
||
|
||
所以,我们有必要在回看一下TDD的理念:__先定标准、后做开发、以结果反向驱动过程__。
|
||
|
||
构建出一个最小的Loop__:Red-Green-Refactor__
|
||
|
||
- __红__:先编写失败测试用例,定义"__什么是错、什么是对__"的终态标准。
|
||
- __绿__:迭代编写代码,直到全部测试用例通过。
|
||
- __重构__:在测试兜底前提下优化代码,保证质量不退化。
|
||
|
||
以往这个循环为什么玩不起来,因为,这个循环的控制者是人,但是到了AI时代,__控制权交给Agent__,这个结构没有发生变化,但是你变轻松了。
|
||
|
||
在分布式系统中,每个服务都是全局中的一个局部,针对局部的一个模块,测试会有三个维度,也分别对应着三个环:
|
||
|
||
1、__单元测试环__:看似容易,其实不容器做到,这里难点在于:单元测试其实是和函数耦合的,也就是说,需要先定义好骨架,顾开发的流程应该是:__定义桩函数-> 写测试用例->写实现 。__
|
||
|
||
2、__接口测试环__:需要可以让AI可以自己发包,以及收日志,这样就可以在服务维度建立Loop。
|
||
|
||
3、__流程测试环__:以功能为单位进行验证,因为它更加上层,一般都是用来回归验证,如何构建这个环,以便AI可以站在全局修复问题,仍然值得思考。
|
||
|
||
__3.1.1 反向思考:TDD不能做什么?__
|
||
|
||
虽然TDD好,但,也不是万能药,我们需要清晰的知道它的边界:
|
||
|
||
它__适合__:
|
||
|
||
- 明确的业务规则
|
||
- API的输入、输出行为
|
||
- 数据转换和边界条件
|
||
- 回归Bug修复
|
||
- 编译、lint、类型检查
|
||
|
||
它__不适合__:
|
||
|
||
- 纯体验问题
|
||
- 架构品味
|
||
- 产品决策
|
||
|
||
知道了__适不适合__,就可以更好的思考,它__应该被放在哪里__?
|
||
|
||
在开发过程中,我们都应该反问自己:__这个功能是否可以被测试表达?这部分如何变成Loop?__
|
||
|
||
__3.1.2 以"规则"为核心的构建测试用例__
|
||
|
||
上面我们主要讲了如何构建环?下面来讲讲如何设计测试用例。
|
||
|
||
测试用例的设计非常重要!!!因为一旦设计有误,所有AI生成的代码都是在错误的基础上改动代码,结果怎么改都是错。
|
||
|
||
而这里的解决思路是:__以需求为出发点,构建规则集合。__
|
||
|
||
__3.2 方法二: 证据胜于一切,建立证据链__
|
||
|
||
Maker-Checker双校验架构听起来是很不错的,但是细想,一个问题很自然的就出来了:__Checker凭什么就说Maker做的不行呢?是靠猜吗?肯定不是。__
|
||
|
||
这很像是一场辩论赛,反方选手说你不行,那不能靠感觉,要靠依据,那依据是什么呢?没事,是__证据链__。
|
||
|
||
Maker 通过事实(产品规则)推演,输出落地代码。
|
||
|
||
Cherker 使用__证据链__进行追溯,Review代码。
|
||
|
||
而这种设计,本质上就是__对抗性思维__的一种极致体现!
|
||
|
||
__3.3 方法三:预算思维__
|
||
|
||
在设计一个Loop时,不仅需要考虑技术实现,更需要考虑一个很现实的点:__预算__
|
||
|
||
预算收紧的今天,谁都不想,月初额度就用了一半!所以需要有一些策略应对:
|
||
|
||
__策略一:模型选择__
|
||
|
||
首先,预算思维的本质是:__资源倾斜 ,背后的问题是:什么样的任务我愿意投入更多的资源?__
|
||
|
||
针对高价值的任务,用聪明的模型,而针对低价值的重复任务,绝不用贵的模型。
|
||
|
||
选择不合适的模型,成本差距巨大,Opus的输出成本是GLM4-Flash的__180倍__。
|
||
|
||
__策略二:设置退出机制__
|
||
|
||
设置退出机制就是针对每个任务要设置一个阈值上线,常见的有:
|
||
|
||
1. 最大的步骤限制
|
||
2. 预算熔断机制
|
||
|
||
__策略三:上下文压缩__
|
||
|
||
面对长周期 Agent 任务的成本问题,上下文压缩,是一个常见的方式,一般的做法是:用廉价模型对全量上下文反复重压缩,但这种操作,往往会__实则会让核心规则持续稀释、过程噪音不断累积__。最终导致任务跑偏、全链路已经投入的 Token 全部作废。
|
||
|
||
而这里我个人的一些应对思路是:高密度核心规则全程人为把控(不参与压缩)+增量信息克制压缩
|
||
|
||
把人的强判断力用在不可出错的核心约束上,把模型的压缩能力用在可损耗的过程信息上,从根源上避免压缩噪音污染核心逻辑。
|
||
|
||
## 04
|
||
|
||
写在最后
|
||
|
||
Loop不是一个技术框架,而是一种思维模式。让我们更好的去思考:人和AI如何协作完成一个Loop?把人从Loop中更多的环节拔出来,把注意力真正的还给人自己。
|
||
|
||
-End-
|
||
|
||
原创作者|吕昊俣
|